

Monte Carlo सिमुलेशन के लिए Excel क्यों उपयोग करें?
एक बार जब आप Monte Carlo सिमुलेशन लागू करने का निर्णय ले लेते हैं, तो आपके पास Excel, Python, R, SAS, और MATLAB जैसे कई उपकरण होते हैं जो सिमुलेशनों में मदद करते हैं।
सबसे महत्वपूर्ण कारक, खासकर पहली बार Monte Carlo सिमुलेशन लागू करते समय, आपके द्वारा उपयोग किए जाने वाले टूल के साथ आपकी समग्र परिचितता है। Excel व्यापार जगत में सबसे व्यापक रूप से उपयोग किए जाने वाले टूल्स में से एक है, जिसका अर्थ है कि कई लोग पहले से ही इसके बुनियादी संचालन से परिचित हैं। यह प्रशिक्षण समय को कम करता है और नए सॉफ़्टवेयर को शून्य से सीखने की आवश्यकता को समाप्त करता है।
Excel चार्ट्स और ग्राफ़ बनाने के लिए उपयोग में आसान टूल भी प्रदान करता है, जो सिमुलेशनों के परिणामों को विज़ुअलाइज़ करने में उपयोगी हो सकता है। इसके अलावा, Excel के लिए कई शक्तिशाली ऐड-इन्स उपलब्ध हैं, जो जटिल Monte Carlo सिमुलेशनों को करने की इसकी क्षमता को बढ़ाते हैं।
हालाँकि, यह भी ध्यान देने योग्य है कि अधिक उन्नत सिमुलेशनों के लिए, विशेषकर वे जो बड़े डेटासेट को संभालने या बहुत अधिक संख्या में सिमुलेशन चलाने की आवश्यकता रखते हैं, Excel के अलावा अधिक विशिष्ट टूल अधिक उपयुक्त हो सकते हैं।
Monte Carlo के लिए प्रमुख Excel फ़ंक्शंस
अगले चरण में, हम दो आवश्यक Excel फ़ंक्शंस का अन्वेषण करेंगे: RAND() और NORM.INV()—इनका सिंटैक्स, पैरामीटर्स, और सामान्य उपयोग मामले। ये फ़ंक्शंस रैंडम नंबर जनरेट करने और प्रायिकता वितरणों को परिभाषित करने में मदद करते हैं, जो किसी भी सिमुलेशन के बुनियादी पहलू हैं।
RAND() फ़ंक्शन
RAND() 0 के बराबर या उससे अधिक और 1 से कम का एक रैंडम नंबर जनरेट करता है। ये नंबर समान रूप से वितरित होते हैं, अर्थात निर्दिष्ट रेंज के भीतर कोई भी संख्या आने की समान संभावना होती है।
RAND() का सिंटैक्स इस प्रकार है:
RAND()RAND() फ़ंक्शन को किसी आर्ग्युमेंट की आवश्यकता नहीं होती। इसे बस RAND() के रूप में उपयोग किया जाता है।
Monte Carlo सिमुलेशन के संदर्भ में, RAND() का उपयोग रैंडम घटनाओं के घटित होने का सिमुलेशन करने या आपके मॉडल में इनपुट्स में बदलाव लाने के लिए किया जा सकता है।
NORM.INV() फ़ंक्शन
जहाँ RAND() समान रूप से वितरित रैंडम नंबर जनरेट करता है, वहीं NORM.INV() का उपयोग नॉर्मल डिस्ट्रीब्यूशन से रैंडम नंबर जनरेट करने के लिए किया जाता है, जो Monte Carlo सिमुलेशन में एक सामान्य आवश्यकता है। यह फ़ंक्शन निर्दिष्ट औसत (mean) और मानक विचलन (standard deviation) के लिए नॉर्मल संचयी वितरण का इनवर्स लौटाता है।
NORM.INV() फ़ंक्शन का सिंटैक्स इस प्रकार है:
NORM.INV(probability, mean, standard_deviation)पैरामीटर्स इस प्रकार हैं:
-
probability: नॉर्मल डिस्ट्रीब्यूशन के अनुरूप एक प्रायिकता, जो 0 और 1 के बीच का मान होना चाहिए। यह आमतौर परRAND()फ़ंक्शन द्वारा जनरेट की जाती है। -
mean: अंकगणितीय माध्य यानी नॉर्मल डिस्ट्रीब्यूशन का औसत। -
standard_deviation: नॉर्मल डिस्ट्रीब्यूशन का मानक विचलन, जो यह मापता है कि संख्याएँ औसत के आसपास कितनी फैली हुई हैं।
NORM.INV() का उपयोग RAND() फ़ंक्शन से प्राप्त समान रूप से वितरित रैंडम नंबरों को किसी निर्दिष्ट नॉर्मल डिस्ट्रीब्यूशन का पालन करने वाले नंबरों में बदलने के लिए किया जाता है। यह उन वेरिएबल्स को मॉडल करने में उपयोगी है जिनमें नॉर्मल कर्व के अनुरूप प्राकृतिक परिवर्तनशीलता देखी जाती है।
अब जबकि हमारे पास Monte Carlo सिमुलेशन के पीछे के सभी बिल्डिंग ब्लॉक्स, फ़ंक्शंस, और अवधारणाएँ हैं, आइए इसे Microsoft Excel में लागू करें।
Microsoft Excel में Monte Carlo सिमुलेशन लागू करना: एक उदाहरण
मान लीजिए आप एक गतिशील कंज्यूमर इलेक्ट्रॉनिक्स कंपनी में डेटा विश्लेषक हैं और आपको एक नए वेयरेबल फिटनेस ट्रैकर को लॉन्च करने की वित्तीय व्यवहार्यता का आकलन करने का काम सौंपा गया है।
ऐसे उपकरणों के लिए बाज़ार प्रतिस्पर्धी है और उपभोक्ता मांग अत्यधिक परिवर्तनीय हो सकती है, जो मौसमी रुझानों, मार्केटिंग की प्रभावशीलता और प्रतिस्पर्धियों की कार्रवाइयों से प्रभावित होती है। साथ ही, इन उपकरणों के निर्माण से जुड़े खर्च सामग्री लागत में बदलाव और सप्लाई चेन की अनिश्चितताओं के कारण उतार-चढ़ाव के अधीन होते हैं।
आपने इन चुनौतियों से निपटने के लिए Excel में Monte Carlo सिमुलेशन का उपयोग करने का निर्णय लिया है। आपको विश्वास है कि यह तरीका आपको विभिन्न परिदृश्यों में संभावित लाभप्रदता का अनुमान लगाने में मदद करेगा, जिससे कंपनी को मूल्य निर्धारण रणनीतियों, उत्पादन मात्रा, और मार्केटिंग निवेश के बारे में सूचित निर्णय लेने में सहायता मिलेगी।
आपने समान उत्पाद लॉन्च और कंज्यूमर इलेक्ट्रॉनिक्स उद्योग के भीतर बाज़ार अध्ययनों के पिछले डेटा का भी विश्लेषण किया है। इस विश्लेषण से, आपने कुछ मेट्रिक्स निष्कर्षित किए हैं जो आपके सिमुलेशन को सूचित करेंगे:
- लॉन्च के पहले वर्ष में नए उपकरणों के लिए औसत 10,000 इकाइयों की मांग, 2,000 इकाइयों के मानक विचलन के साथ, जो उपभोक्ता स्वीकृति की अनिश्चितता को दर्शाता है।
- प्रति इकाई विक्रय मूल्य आमतौर पर $50 से $70 के बीच रहता है, जो प्रतिस्पर्धी मूल्य निर्धारण और बाज़ार संतृप्ति पर निर्भर करता है।
- प्रति इकाई लागत, जो अस्थिर सामग्री कीमतों और विनिर्माण दक्षता से प्रभावित होती है, औसतन $30 है, 5 डॉलर के मानक विचलन के साथ।
यह ऐतिहासिक डेटा आपके सिमुलेशन पैरामीटर्स की अंतर्निहित धारणाएँ बनाता है, जिससे वर्तमान बाज़ार स्थितियों को अधिक सटीक रूप से प्रतिबिंबित करने वाला सिमुलेशन तैयार करने में मदद मिलती है।
इस विशेष उदाहरण के लिए Monte Carlo सिमुलेशन लागू करने के लिए आप निम्नलिखित चरणों का पालन कर सकते हैं:
चरण 1: अपनी Excel शीट सेट करें
सबसे पहले, अपनी Excel वर्कशीट तैयार करें जिसमें प्रत्येक वेरिएबल के लिए कॉलम और गणना किए गए प्रॉफिट के लिए एक कॉलम शामिल हो।
शुरू में यह कुछ इस तरह दिखेगी:
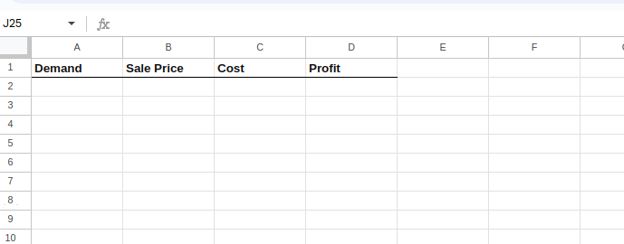
Excel शीट सेट करना।
चरण 2: वेरिएबल्स के लिए फ़ॉर्मूला दर्ज करें
प्रत्येक पंक्ति में, आप मांग, विक्रय मूल्य, और लागत के लिए रैंडम मान जनरेट करने हेतु, पहचाने गए वितरणों के आधार पर फ़ॉर्मूला दर्ज करेंगे:
- Demand: नॉर्मल डिस्ट्रीब्यूशन (औसत = 10,000 इकाइयाँ, मानक विचलन = 2,000 इकाइयाँ)
- Sale Price: यूनिफॉर्म डिस्ट्रीब्यूशन ($50 से $70)
- Cost: नॉर्मल डिस्ट्रीब्यूशन (औसत = $30, मानक विचलन = $5)
इन फ़ॉर्मूलों को एक-एक करके दर्ज करने के लिए, सेल A2 चुनें और निम्न लिखें:
=NORM.INV(RAND(), 10000, 2000)उपरोक्त समीकरण दिए गए औसत और मानक विचलन के साथ एक नॉर्मल डिस्ट्रीब्यूशन बनाता है, जैसा नीचे दिखाया गया है:
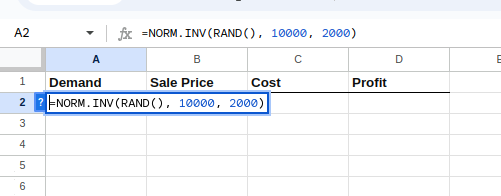
मांग के लिए वितरण बनाना।
इसके बाद, सेल B2 चुनें और निम्न टाइप करें:
=50 + (70-50) * RAND()ऊपर दिया गया समीकरण विक्रय मूल्य के लिए $50 और $70 के बीच एक यूनिफॉर्म डिस्ट्रीब्यूशन बनाता है, जैसा नीचे दिखाया गया है:
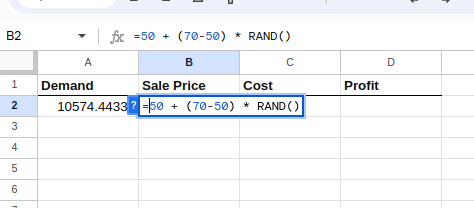
विक्रय मूल्य के लिए वितरण बनाना।
सेल C2 चुनें, और निम्न टाइप करें:
=NORM.INV(RAND(), 30, 5)ऊपर दिया गया समीकरण, मांग वाले समीकरण के समान, दिए गए औसत और मानक विचलन के साथ एक नॉर्मल डिस्ट्रीब्यूशन बनाता है, जैसा नीचे दिखाया गया है:
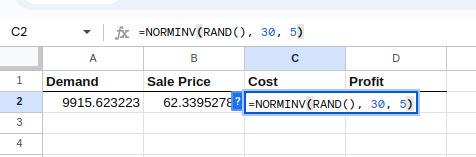
लागत के लिए वितरण बनाना।
चरण 3: आश्रित वेरिएबल की गणना करें
अब, प्रत्येक सिमुलेशन के लिए प्रॉफिट, जो आश्रित वेरिएबल है, कॉलम D में दिए गए फ़ॉर्मूला का उपयोग करके गणना करें:
=(B2 - C2) * A2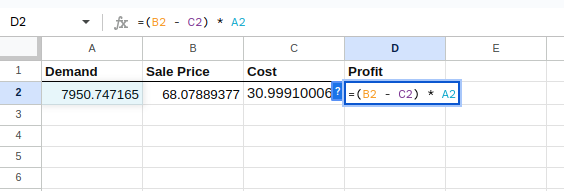
प्रॉफिट की गणना करना।
चरण 4: कई परिदृश्यों का सिमुलेशन करने के लिए फ़िल डाउन करें
अब तक हमने जो किया है वह एक एकल सिमुलेशन बनाना था। आइए इसे कई—मान लीजिए एक हज़ार—सिमुलेशनों तक बढ़ाएँ।
सेल A2 से D2 तक चुनें और फ़िल हैंडल (चयन के निचले-दाएँ कोने पर छोटा वर्ग) को नीचे खींचें, ताकि जितनी पंक्तियों तक आप सिमुलेट करना चाहते हैं, वहाँ तक फ़ॉर्मूला भर जाए (उदा., 1000 पंक्तियाँ 1000 सिमुलेशनों के लिए)।
यह कुछ इस तरह दिखेगा:
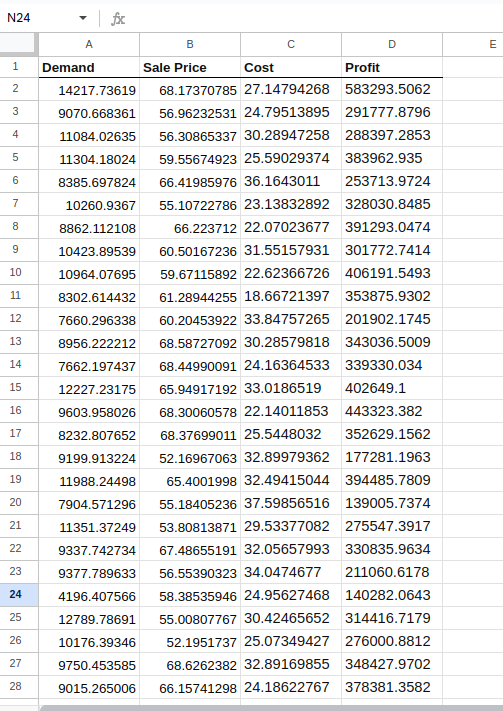
सिमुलेशन बनाना।
चरण 5: परिणामों का विश्लेषण करें
सिमुलेशन चलाने के बाद, आप न्यूनतम, अधिकतम, औसत, और मानक विचलन जैसी सांख्यिकीय फ़ंक्शनों का उपयोग करके परिणामों का विश्लेषण कर सकते हैं। अगला उपयोग करने वाले बिल्ट-इन Excel फ़ंक्शनों की जल्दी से याद ताज़ा करने के लिए Excel चीट शीट देखने में संकोच न करें।
प्रत्येक माह अपेक्षित औसत प्रॉफिट खोजने के लिए, किसी सेल में, मान लें G6, निम्न लिखें:
=AVERAGE(D2:D1001)प्रत्येक माह अपेक्षित न्यूनतम प्रॉफिट खोजने के लिए, किसी सेल में, मान लें G7, निम्न लिखें:
=MIN(D2:D1001)प्रत्येक माह अपेक्षित अधिकतम प्रॉफिट खोजने के लिए, किसी सेल में, मान लें G8, निम्न लिखें:
=MAX(D2:D1001)प्रॉफिट का मानक विचलन खोजने के लिए, किसी सेल में, मान लें G9, निम्न लिखें:
=STDEV.P(D2:D1001)इनको चलाने के बाद, Excel शीट कुछ इस तरह दिखनी चाहिए:
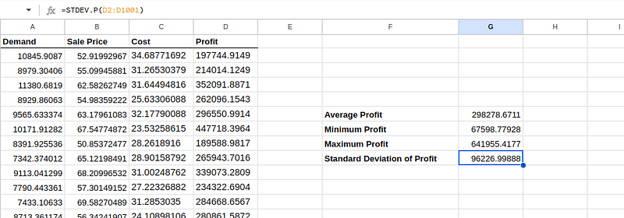
सिमुलेशन परिणामों का विश्लेषण।
हम अनुमानित परिणामों और उत्पाद लॉन्च के निहितार्थों की व्याख्या इस प्रकार कर सकते हैं:
- औसत प्रॉफिट का आँकड़ा नए फिटनेस ट्रैकर के लॉन्च से अपेक्षित लाभ का प्रतिनिधित्व करता है। यह सुझाव देता है कि औसतन, प्रत्येक सिमुलेशन रन यह अनुमान लगाता है कि हम लगभग $298,278.67 का लाभ कमा सकते हैं। यह मान, दी गई धारणाओं के अंतर्गत लाभप्रदता का केंद्रीय अनुमान प्रदान करता है।
- न्यूनतम प्रॉफिट $67,598.78 हमारे सभी सिमुलेशनों में देखा गया सबसे कम लाभ है। यह आपके मॉडल की धारणाओं के अंतर्गत सबसे बुरे हालात को दर्शाता है, जो अभी भी लाभप्रद तो है पर औसत से काफ़ी कम। यह उस विशेष सिमुलेशन में विशेष रूप से कम मांग या प्रतिकूल लागत स्थितियों के कारण हो सकता है।
- अधिकतम प्रॉफिट $641,955.42 सबसे अच्छे हालात का प्रतिनिधित्व करता है, जहाँ सभी सिमुलेशनों में मांग और कीमत संभवतः अपने उच्चतम स्तर पर थीं और लागतें अपने न्यूनतम पर। यह दिखाता है कि यदि परिस्थितियाँ अत्यंत अनुकूल रहीं तो ऊपर की संभावनाएँ क्या हो सकती हैं।
न्यूनतम और अधिकतम प्रॉफिट के बीच व्यापक रेंज और पर्याप्त मानक विचलन को देखते हुए, नए उत्पाद को लॉन्च करने से जुड़ा वित्तीय जोखिम काफ़ी है।
निर्णय-निर्माताओं को यह विचार करना चाहिए कि क्या कंपनी इस स्तर की अनिश्चितता और औसत से कम लाभ की संभाव्यता के साथ सहज है।
आगे, यद्यपि यह वैकल्पिक है, हम आपको हिस्टोग्राम जैसी विज़ुअलाइज़ेशन बनाने के लिए प्रोत्साहित करते हैं ताकि सिमुलेशनों के परिणामों की दृश्य समझ हो सके।
Excel Monte Carlo सिमुलेशनों में सुधार की तकनीकें
जब आप ऊपर जैसा ही सिमुलेशन फिर से चलाते हैं, तो आप गणनाओं में हल्का सा अंतर देख सकते हैं, जैसा नीचे दिखाया गया है:
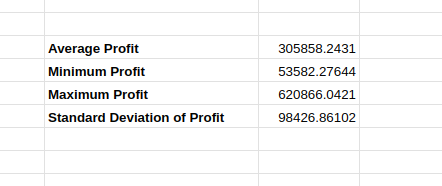
बदलते सिमुलेशन परिणाम।
ऐसा इसलिए होता है क्योंकि मूल सिमुलेशन के मान पुनरावृत्तियों के बीच बदल सकते हैं, जो परिणामी अनुमानों को प्रभावित करते हैं। यद्यपि बदलाव छोटा है, परंतु जब अनुमानित मान बदलता है, तो निर्णय-निर्माताओं के मन में सिमुलेशन की सटीकता और विश्वसनीयता के बारे में चिंता उत्पन्न हो सकती है।
आइए कुछ उन्नत तकनीकों का अन्वेषण करें जिन्हें हम सिमुलेशनों की सटीकता और विश्वसनीयता में सुधार लाने के लिए उपयोग कर सकते हैं।
सिमुलेशनों की संख्या बढ़ाना
अधिक संख्या में सिमुलेशन चलाने से रैंडम उतार-चढ़ाव औसत हो जाते हैं और परिणामों का अधिक स्थिर और सटीक अनुमान मिलता है।
उपरोक्त उदाहरण के लिए, हम सिमुलेशन रन की संख्या बढ़ा सकते हैं (उदा., 1,000 से 10,000 या अधिक), विशेषकर जब अत्यधिक परिवर्तनशील पैरामीटर्स के साथ काम कर रहे हों।
“सही” सिमुलेशनों की संख्या तय करना कई कारकों पर निर्भर करता है।
मॉडल जितना अधिक जटिल होगा (अर्थात, जितने अधिक वेरिएबल्स और उनकी अंतःक्रियाओं की रेंज जितनी व्यापक), उतने अधिक सिमुलेशनों की सामान्यतः आवश्यकता होगी ताकि सभी संभावित परिणामों को कैप्चर किया जा सके और यह सुनिश्चित हो कि परिणाम संयोगवश नहीं हैं।
यदि इनपुट्स में उच्च परिवर्तनशीलता है या वे काफ़ी स्क्यूड हैं, तो आउटकम डिस्ट्रीब्यूशनों की टेल्स (चरम मानों) का सटीक अनुमान लगाने के लिए अधिक सिमुलेशन आवश्यक होंगे।
अधिक विस्तृत विश्लेषणों के लिए, विशेषकर वित्त या जोखिम प्रबंधन में, 10,000 से 100,000 तक सिमुलेशन चलाना असामान्य नहीं है। यह रेंज आम तौर पर विभिन्न परिदृश्यों और इनपुट्स में ठोस परिणाम सुनिश्चित करने के लिए उपयोग की जाती है। बेशक, जैसा हमने पहले बताया, इतने बड़े पैमाने के विश्लेषण के लिए Excel हमेशा सबसे अच्छा टूल नहीं होता—R या Python बेहतर रहते हैं।
इनपुट डिस्ट्रीब्यूशनों को परिष्कृत करना
सिमुलेशनों की सटीकता काफी हद तक इस पर निर्भर करती है कि इनपुट प्रायिकता वितरण मूलभूत वेरिएबल्स की वास्तविक अनिश्चितता और व्यवहार को कितनी अच्छी तरह प्रतिबिंबित करते हैं। हमारे उदाहरण में, हमने मांग और लागत के लिए नॉर्मल डिस्ट्रीब्यूशन और विक्रय मूल्य के लिए यूनिफॉर्म डिस्ट्रीब्यूशन माना।
इसके अतिरिक्त, हम वितरणों को बेहतर पैरामीटराइज़ करने के लिए अधिक व्यापक ऐतिहासिक डेटा का विश्लेषण कर सकते हैं। डोमेन विशेषज्ञों के इनपुट के आधार पर हम समझ सकते हैं कि लागत, विक्रय, और मांग बाहरी कारकों पर कैसे निर्भर करते हैं। हम लॉग-नॉर्मल, बीटा, या गामा जैसे वितरणों का उपयोग करने पर भी विचार कर सकते हैं, या अनुभवजन्य डेटा पर आधारित कस्टम वितरण बना सकते हैं।
सेंसिटिविटी विश्लेषण करना
यह विश्लेषण यह समझने के लिए किया जाता है कि कौन से इनपुट वेरिएबल्स का आउटपुट पर सबसे अधिक प्रभाव है, जिसके लिए प्रत्येक इनपुट को व्यवस्थित रूप से बदला जाता है जबकि अन्य को स्थिर रखा जाता है।
हमारे उदाहरण में, हम दो वेरिएबल्स को स्थिर रख सकते हैं और एक के वितरण को बदलकर अनुमानों में होने वाले परिवर्तनों को समझ सकते हैं। फिर, यही प्रक्रिया शेष दो वेरिएबल्स पर एक-एक करके दोहराएँ। अंततः, यह तकनीक यह समझने में मदद करती है कि सटीकता में सुधार के लिए किस वेरिएबल पर ध्यान केंद्रित किया जाए।
उपरोक्त तकनीकों को क्रमिक रूप से अपनाना और परिणामों का विश्लेषण करना अधिक सटीक और विश्वसनीय निष्कर्षों तक ले जा सकता है।
निष्कर्ष
इस ट्यूटोरियल ने आपको Monte Carlo सिमुलेशन और प्रासंगिक सांख्यिकीय अवधारणाओं से परिचित कराया। संबंधित Excel फ़ंक्शनों का परिचय देने के बाद, ट्यूटोरियल ने एक वास्तविक-world उदाहरण का उपयोग करते हुए Excel में Monte Carlo सिमुलेशन लागू करने के लिए चरण-दर-चरण मार्गदर्शन प्रदान किया।
अंत में, आपने कुछ सर्वोत्तम प्रथाओं और उन्नत तकनीकों के बारे में सीखा, ताकि आपके परिणाम अधिक सटीक और विश्वसनीय हों।
यदि आप उपरोक्त Monte Carlo सिमुलेशन को Python या R जैसे अन्य टूल्स का उपयोग करके लागू करने में विशेष रुचि रखते हैं, तो ये दो संसाधन उपयोगी होंगे:
वैकल्पिक रूप से, यदि आप परिचित Microsoft Excel के साथ बने रहना चाहते हैं और व्यापक रूप से अपनाए गए इस टूल का उपयोग करके अपने कौशल में माहिर होना चाहते हैं, तो हमारा Excel Fundamentals ट्रैक अवश्य देखें।

एक वरिष्ठ डेटा वैज्ञानिक के रूप में, मैं बड़े पैमाने पर मशीन‑लर्निंग समाधान डिज़ाइन, विकसित और परिनियोजित करता/करती हूँ ताकि व्यवसाय बेहतर डेटा‑आधारित निर्णय ले सकें। डेटा साइंस लेखक के रूप में, मैं अपने सीख, करियर सलाह, और गहन व्यावहारिक ट्यूटोरियल साझा करता/करती हूँ।
Monte Carlo विधियाँ, जिनका नाम मूल रूप से मोनाको के Monte Carlo कैसीनो पर रखा गया था, वित्त, इंजीनियरिंग, सप्लाई चेन, और विज्ञान जैसे क्षेत्रों में व्यापक रूप से उपयोग की जाती हैं ताकि उन घटनाओं को मॉडल किया जा सके जिनके इनपुट में महत्वपूर्ण अनिश्चितता होती है।
लेकिन Monte Carlo सिमुलेशन क्या है? यह कैसे काम करता है? और मैं सिमुलेशन को कैसे लागू करूँ और परिणामों का विश्लेषण कैसे करूँ?
यह ट्यूटोरियल आपको Monte Carlo सिमुलेशन और इस तकनीक के पीछे के प्रासंगिक सांख्यिकीय सिद्धांतों से परिचित कराएगा। हम Excel में Monte Carlo सिमुलेशन भी लागू करेंगे, जिससे आप संबंधित Excel के बिल्ट-इन फ़ंक्शनों से परिचित हो सकें।
अंत में, ट्यूटोरियल आपको सर्वोत्तम प्रथाएँ, उन्नत तकनीकें, और आगे के संसाधन भी देगा, जिससे यह ट्यूटोरियल Microsoft Excel में Monte Carlo सिमुलेशन के बारे में सब कुछ सीखने के लिए आपका एकमात्र गाइड बन जाएगा।
Monte Carlo सिमुलेशन क्या है?
Monte Carlo सिमुलेशन एक गणितीय तकनीक है जिसका उपयोग ऐसे प्रोसेस में विभिन्न परिणामों की संभावना को मॉडल करने के लिए किया जाता है जिन्हें रैंडम वेरिएबल्स के हस्तक्षेप के कारण आसानी से पूर्वानुमानित नहीं किया जा सकता।
यह विभिन्न क्षेत्रों में जोखिम और अनिश्चितता के प्रभाव को समझने के लिए एक शक्तिशाली उपकरण है। यह विधि जटिल प्रणालियों और प्रक्रियाओं के व्यवहार का सिमुलेशन करने के लिए बार-बार रैंडम सैंपलिंग पर निर्भर करती है।
समस्या को पहले उन प्रत्येक वेरिएबल के लिए एक प्रायिकता वितरण द्वारा मॉडल किया जाता है जिनमें मूलभूत अनिश्चितता होती है। फिर इन प्रायिकता वितरणों से बड़ी संख्या में रैंडम सैंपल निकाले जाते हैं, और इन्हीं सैंपल्स का उपयोग परिणामों की गणना के लिए किया जाता है। इस प्रक्रिया को कई बार दोहराया जाता है ताकि संभावित परिणामों का एक वितरण बनाया जा सके, जिसे सांख्यिकीय रूप से विश्लेषित कर यह अनुमान लगाया जा सके कि कोई प्रणाली कैसे व्यवहार करेगी।
तो, सरल शब्दों में, Monte Carlo सिमुलेशन एक तकनीक है जो रैंडम मानों का उपयोग करके परिणामों को कई बार सिमुलेट कर यह भविष्यवाणी करती है कि जटिल प्रणालियाँ कैसे व्यवहार करेंगी। इसमें ये चरण शामिल होते हैं:
अगले चरण में, हम कुछ प्रासंगिक सांख्यिकीय अवधारणाओं में जाकर Monte Carlo सिमुलेशन की अपनी बुनियादी समझ को विकसित करेंगे।
Monte Carlo रैंडम वेरिएबल्स और डिस्ट्रीब्यूशंस
रैंडम वेरिएबल्स और उनके संबंधित प्रायिकता वितरण Monte Carlo सिमुलेशन के लिए बुनियादी हैं, क्योंकि वे जटिल प्रणालियों में निहित यादृच्छिकता और परिवर्तनशीलता को मॉडल और सिमुलेट करने के लिए गणितीय ढाँचा प्रदान करते हैं।
रैंडम वेरिएबल्स
रैंडम वेरिएबल वह वेरिएबल है जिसके मान किसी रैंडम घटना के परिणाम होते हैं।
रैंडम वेरिएबल्स दो प्रकार के होते हैं:
रैंडम वेरिएबल्स का उपयोग सिमुलेशनों में इसलिए किया जाता है क्योंकि वे वही अनिश्चितता समाहित करते हैं जिसे Monte Carlo तकनीकें खोजने और मात्रात्मक करने के लिए डिज़ाइन की गई हैं।
प्रायिकता वितरण
प्रायिकता वितरण यह बताते हैं कि किसी रैंडम वेरिएबल के मानों पर प्रायिकताएँ कैसे वितरित होती हैं।
Monte Carlo सिमुलेशन में प्रायिकता वितरणों का उपयोग यह परिभाषित करने के लिए किया जाता है कि अलग-अलग इनपुट्स या परिदृश्य कैसे व्यवहार करेंगे, जो सटीक मॉडलिंग और निर्णय लेने के लिए आवश्यक है।
नॉर्मल डिस्ट्रीब्यूशन सांख्यिकी और सिमुलेशनों में सबसे सामान्यतः उपयोग किया जाने वाला वितरण है क्योंकि कई प्राकृतिक और मानव-निर्मित घटनाएँ केंद्रीय सीमा प्रमेय के कारण इस वितरण का पालन करती हैं।
नॉर्मल डिस्ट्रीब्यूशन (स्रोत)
नॉर्मल डिस्ट्रीब्यूशन का उपयोग ऐसे वेरिएबल्स को मॉडल करने के लिए किया जाता है जो कई छोटे, स्वतंत्र प्रभावों से प्रभावित होते हैं, जैसे माप की त्रुटियाँ या स्टॉक मार्केट रिटर्न।
अन्य कुछ प्रायिकता वितरणों में यूनिफॉर्म डिस्ट्रीब्यूशन शामिल है, जिसका उपयोग तब किया जाता है जब किसी निर्दिष्ट रेंज में कोई भी परिणाम समान रूप से संभावित हो—यह तब एक सामान्य धारणा होती है जब कोई पूर्व डेटा उपलब्ध नहीं होता; और बायनोमियल डिस्ट्रीब्यूशन, जिसका उपयोग ऐसे परिदृश्यों के मॉडलिंग में किया जाता है जहाँ एक श्रृंखला में दो संभावित परिणाम (सफलता/असफलता) होते हैं, जैसे पास/फेल परीक्षण या गुणवत्ता नियंत्रण जाँच।
अब जब हमने Monte Carlo सिमुलेशनों के पीछे की अवधारणाएँ और सिद्धांत समझ लिए हैं, तो आइए कार्यान्वयन की ओर बढ़ते हैं।