

कोर्स
LangChain के साथ LLM एप्लिकेशन विकसित करना
3 घंटा
51.8K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंक्लाउड LLM APIs शक्तिशाली हैं, लेकिन उनके साथ कुछ समझौते आते हैं: उपयोग-आधारित मूल्य निर्धारण, रेट लिमिट्स, और यह निरंतर अनिश्चितता कि आपका डेटा कहाँ प्रोसेस हो रहा है। संवेदनशील डेटा के साथ काम करने वाले या भारी प्रयोग करने वाले डेवलपर्स के लिए, ये बाधाएँ जल्दी ही रुकावट बन सकती हैं।
यही वह जगह है जहाँ लोकल-फर्स्ट अप्रोच अलग दिखते हैं। Ollama Python लाइब्रेरी आपको बड़े लैंग्वेज मॉडल्स को लोकली चलाने देती है और उनसे साफ, Python-नेटिव कोड के जरिए इंटरैक्ट करने देती है—जिससे घर्षण दूर हो जाता है। इससे प्रदर्शन, लागत, और गोपनीयता पर आपका पूरा नियंत्रण रहता है।
इस लेख में, मैं आपको Ollama Python लाइब्रेरी API का पूरा वॉकथ्रू दूँगा—सरल टेक्स्ट जनरेशन (generate()) से लेकर टूल कॉलिंग और विज़न मॉडल्स तक।
मैं हमारे अन्य नवीनतम Ollama ट्यूटोरियल्स भी देखने की सलाह देता/देती हूँ:
शुरू करने से पहले, सुनिश्चित करें कि आपके डिवाइस पर निम्न सेटअप मौजूद है:
Python 3.8 या उससे ऊपर
Ollama इसकी वेबसाइट से डाउनलोड, इंस्टॉल, और रनिंग हो (ollama serve)
कम से कम एक मॉडल पुल किया हुआ (जैसे, ollama pull llama3.2)
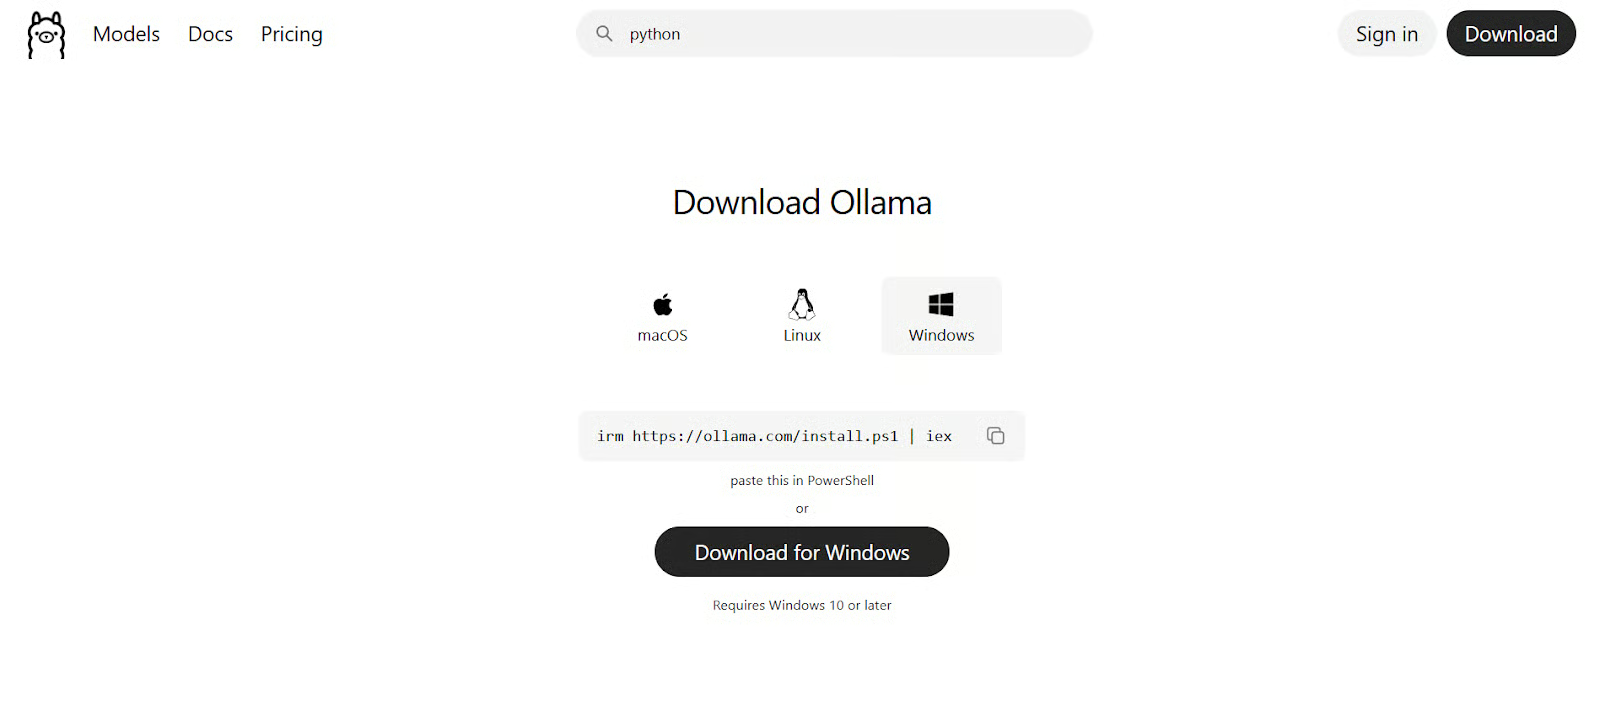
ये पूर्वापेक्षाएँ इसलिए ज़रूरी हैं क्योंकि Python SDK केवल एक क्लाइंट है; वास्तविक इंफेरेंस Ollama रनटाइम में होता है। यदि रनटाइम उपलब्ध नहीं है या कोई उपयुक्त मॉडल मौजूद नहीं है, तो कॉल्स विफल हो जाएँगी।
आप संस्करण स्थिरता के लिए Docker के साथ Ollama का उपयोग करने पर भी विचार कर सकते हैं।
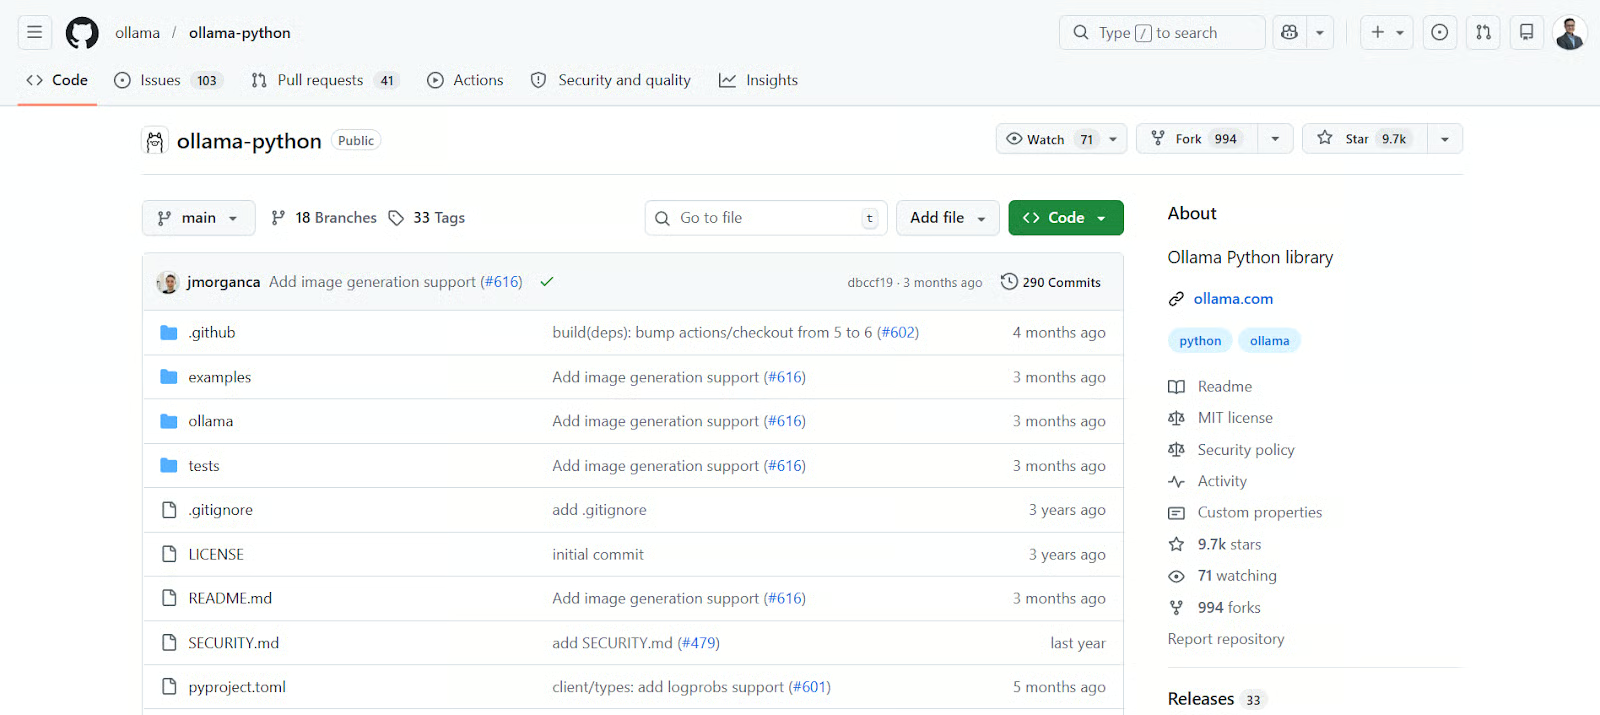
Ollama Python लाइब्रेरी आधिकारिक SDK है जो Ollama REST API को एक सरल, Pythonic इंटरफ़ेस में रैप करता है। दूसरे शब्दों में, यह लो-लेवल HTTP रिक्वेस्ट्स और JSON पेलोड्स को हाई-लेवल Python फ़ंक्शंस में बदल देता है, ताकि आप ट्रांसपोर्ट डिटेल्स की बजाय इरादे पर ध्यान दे सकें।
जैसे-जैसे आपका एप्लिकेशन बढ़ता है, यह एब्स्ट्रैक्शन बार-बार होने वाले रिक्वेस्ट कंस्ट्रक्शन को हटाता है, रिस्पॉन्स हैंडलिंग को मानकीकृत करता है, और एरर हैंडलिंग को एक ही जगह केंद्रीकृत करता है।
तुलना के लिए, एक रॉ रिक्वेस्ट कुछ ऐसा दिख सकता है:
import requests

response = requests.post(
    "http://localhost:11434/api/generate",
    json={
        "model": "llama3.2",
        "prompt": "Explain recursion"
    }
)
यह काम करता है, लेकिन जल्दी ही वर्बोज़ और एरर-प्रोन हो सकता है। SDK के साथ, वही कार्य इस तरह हो जाता है:
import ollama

response = ollama.generate(
    model='llama3.2',
    prompt='Explain recursion'
)हुड के नीचे, प्रत्येक SDK कॉल http://localhost:11434 पर Ollama सर्वर को एक HTTP रिक्वेस्ट बन जाती है। आपका Python स्क्रिप्ट एक क्लाइंट की तरह कार्य करता है, जबकि Ollama रनटाइम एक सर्वर की तरह कार्य करता है जो मॉडल्स को होस्ट और एक्ज़ीक्यूट करता है।
यह विभाजन महत्वपूर्ण है क्योंकि यह मॉडल को एक समर्पित सेवा के रूप में चलने देता है, जिससे संसाधन प्रबंधन (CPU/GPU) अधिक कुशल हो जाता है और कई एप्लिकेशंस एक ही मॉडल इंस्टेंस को साझा कर सकते हैं।
यदि आपको किसी अन्य मशीन से कनेक्ट होना है, तो आप कस्टम क्लाइंट कॉन्फ़िगर कर सकते हैं:
from ollama import Client

client = Client(host='http://remote-server:11434')
response = client.generate(model='llama3.2', prompt='Hello')इंस्टॉलेशन सीधा है और न्यूनतम डिपेंडेंसीज़ की ज़रूरत होती है:
pip install ollamaइंस्टॉल करने के बाद, उपलब्ध मॉडल्स को लिस्ट करके कनेक्टिविटी वेरिफाई करना अच्छा अभ्यास है।
यह आपको यह सुनिश्चित करने में मदद करता है कि आपका Python वातावरण, SDK, और Ollama रनटाइम सही तरह से कनेक्टेड हैं।
ऐसा करने के लिए, नीचे दिया कमांड चलाएँ:
import ollama

print(ollama.list())
generate() फ़ंक्शन स्टेटलेस टास्क्स के लिए डिज़ाइन किया गया है, यानी हर रिक्वेस्ट स्वतंत्र रूप से हैंडल होती है और पिछली इंटरैक्शंस की कोई मेमोरी नहीं रहती। यह इसे समरीकरण, रीराइटिंग, या कोड जनरेशन जैसे कार्यों के लिए आदर्श बनाता है।
क्योंकि कोई रिटेन्ड कॉन्टेक्स्ट नहीं होता, आउटपुट की गुणवत्ता पूरी तरह इस पर निर्भर करती है कि प्रॉम्प्ट कितनी स्पष्टता से लिखा गया है।
निम्न उदाहरण सबसे सरल वर्कफ़्लो दिखाता है: एक प्रॉम्प्ट भेजें, रिस्पॉन्स पाएँ, और जनरेटेड टेक्स्ट निकालें।
import ollama

response = ollama.generate(
    model='llama3.2',
    prompt='Write a Python docstring for a function that calculates factorial'
)

print(response['response'])
रिस्पॉन्स में एक्ज़ीक्यूशन टाइम और टोकन काउंट्स जैसी मेटाडेटा भी शामिल होती है, जो परफॉरमेंस ऑप्टिमाइज़ेशन के समय उपयोगी होती हैं।
जनरेशन का व्यवहार सैंपलिंग पैरामीटर्स से समायोजित किया जा सकता है, जो यह नियंत्रित करते हैं कि मॉडल टोकन कैसे चुनता है।
कम टेम्परेचर वैल्यूज़ अधिक निर्धारक आउटपुट देती हैं, जबकि अधिक वैल्यूज़ विविधता लाती हैं। आप top_p और num_predict जैसे पैरामीटर्स का उपयोग करके आउटपुट की विविधता और लंबाई को और परिष्कृत कर सकते हैं।
यहाँ कुछ महत्वपूर्ण पैरामीटर्स हैं जिनका आप उपयोग कर सकते हैं:
|
पैरामीटर |
यह क्या नियंत्रित करता है |
आउटपुट पर प्रभाव |
कब उपयोग करें |
|
|
टोकन चयन की रैंडमनेस |
कम = अधिक पूर्वानुमेय, अधिक = अधिक क्रिएटिव/रैंडम |
तथ्यात्मक कार्यों के लिए कम (0.1–0.3), रचनात्मक लेखन के लिए अधिक (0.7–1.0) का उपयोग करें |
|
|
न्यूक्लियस सैंपलिंग (probability mass cutoff) |
मॉडल केवल शीर्ष संचयी प्रायिकता p के भीतर के टोकन पर विचार करता है |
कुछ विविधता रखते हुए अजीब आउटपुट को सीमित करने के लिए उपयोग करें |
|
|
कैंडिडेट टोकन्स की संख्या सीमित करता है |
मॉडल केवल शीर्ष k सबसे संभावित टोकन्स में से चुनता है |
स्ट्रक्चर्ड आउटपुट में कड़ी कंट्रोल के लिए उपयोगी |
|
|
जनरेट करने के लिए अधिकतम टोकन्स |
रिस्पॉन्स की लंबाई नियंत्रित करता है |
लंबे विवरण के लिए बढ़ाएँ, संक्षिप्त उत्तरों के लिए घटाएँ |
यहाँ top_p, temperature, और num_predict पैरामीटर्स के उपयोग का एक उदाहरण है:
response = ollama.generate(
    model='llama3.2',
    prompt='Explain machine learning in one paragraph',
    options={
        'temperature': 0.2,
        'top_p': 0.9,
        'num_predict': 100
    }
)generate() के विपरीत, chat() API मैसेजेस की एक सीक्वेंस के साथ काम करके स्टेटफुल इंटरैक्शंस को सपोर्ट करता है। इससे मॉडल कई टर्न्स में कॉन्टेक्स्ट बनाए रख सकता है।
हर मैसेज में एक रोल होता है, जैसे user, assistant, या system, जो बातचीत की संरचना में मदद करता है।
एक सिंगल-टर्न इंटरैक्शन भी मैसेज फ़ॉर्मैट का उपयोग करता है, जो अधिक जटिल बातचीत की नींव रखता है।
response = ollama.chat(
    model='llama3.2',
    messages=[
        {'role': 'user', 'content': 'Explain Python decorators'}
    ]
)

print(response['message']['content'])कॉन्टेक्स्ट बनाए रखने के लिए, आप प्रत्येक रिक्वेस्ट के साथ संपूर्ण बातचीत इतिहास को स्पष्ट रूप से स्टोर और फिर से भेजते हैं। इससे आपको इस पर पूरा नियंत्रण मिलता है कि मॉडल क्या याद रखता है।
messages = [
    {'role': 'user', 'content': 'What is recursion?'}
]

response = ollama.chat(model='llama3.2', messages=messages)
messages.append(response['message'])

messages.append({'role': 'user', 'content': 'Give an example in Python'})
response = ollama.chat(model='llama3.2', messages=messages)सिस्टम प्रॉम्प्ट का उपयोग मॉडल के व्यवहार—जैसे टोन, बाधाएँ, या रोल—को पहले से परिभाषित करने के लिए किया जाता है।
messages = [
    {'role': 'system', 'content': 'You are a strict Python code reviewer.'},
    {'role': 'user', 'content': 'Review this code: def add(a,b): return a+b'}
]इंटरैक्टिव एप्लिकेशंस के लिए, उत्तरदायी होना शुद्धता जितना ही महत्वपूर्ण है। परफ़ॉर्मेंस और यूज़र अनुभव सुधारने के लिए Ollama स्ट्रीमिंग और असिंक्रोनस दोनों एक्ज़ीक्यूशन सपोर्ट करता है।
स्ट्रीमिंग आपको पूरे रिस्पॉन्स का इंतज़ार करने की बजाय आउटपुट को जनरेट होते ही क्रमिक रूप से प्रोसेस करने देती है।
for chunk in ollama.chat(
    model='llama3.2',
    messages=[{'role': 'user', 'content': 'Write a story'}],
    stream=True
):
print(chunk['message']['content'], end='', flush=True)असिंक्रोनस एक्ज़ीक्यूशन आपकी एप्लिकेशन को बिना ब्लॉक किए एक साथ कई रिक्वेस्ट्स हैंडल करने देता है। इसे लागू करने के लिए आपको Python की asyncio लाइब्रेरी का उपयोग करना होगा।
आइए नीचे एक उदाहरण देखते हैं:
import asyncio
from ollama import AsyncClient

async def main():
    client = AsyncClient()
    async for chunk in await client.chat(
        model='llama3.2',
        messages=[{'role': 'user', 'content': 'Explain async programming'}],
        stream=True
    ):
        print(chunk['message']['content'], end='')

asyncio.run(main())Ollama SDK प्रोग्रामेटिकली मॉडल्स को मैनेज करने के टूल्स भी प्रदान करता है, जो खासकर ऑटोमेटेड एन्वायरनमेंट्स में उपयोगी हैं।
आप उपलब्ध मॉडल्स की सूची प्राप्त कर सकते हैं और उनके गुण, जैसे साइज़ और कॉन्फ़िगरेशन, देख सकते हैं।
models = ollama.list()
print(models)

info = ollama.show('llama3.2')
print(info)मॉडल्स को सीधे Python से डाउनलोड या हटाया जा सकता है, जिससे डिपेंडेंसीज़ को डायनामिक रूप से मैनेज करना आसान हो जाता है।
ollama.pull('llama3.2')
ollama.delete('llama3.2')एंबेडिंग्स टेक्स्ट को संख्यात्मक वेक्टर्स के रूप में दर्शाती हैं जो सार्थक अर्थ को कैप्चर करती हैं। इससे आप पाठों की तुलना सटीक शब्दों के बजाय समानता के आधार पर कर सकते हैं।
निम्न उदाहरण टेक्स्ट को एक वेक्टर प्रतिनिधित्व में बदलता है जिसका उपयोग सर्च या क्लस्टरिंग के लिए किया जा सकता है।
response = ollama.embed(
    model='nomic-embed-text',
    input='Ollama is a local LLM runtime'
)

embedding = response['embeddings'][0]एंबेडिंग्स बनने के बाद, समानता को कोसाइन सिमिलैरिटी से नापा जा सकता है, जो वेक्टर्स के बीच कोण की तुलना करती है।
यहाँ सर्च फ़ंक्शन का एक सरल उदाहरण है:
import numpy as np

def cosine_similarity(a, b):
return np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b))अधिक उन्नत एप्लिकेशंस बनाने के लिए, अक्सर मॉडल्स को बाहरी फ़ंक्शंस से इंटरैक्ट करना या स्ट्रक्चर्ड डेटा लौटाना पड़ता है।
टूल कॉलिंग से मॉडल उपयोगकर्ता के इरादे के आधार पर पूर्वनिर्धारित Python फ़ंक्शंस को कॉल कर सकता है।
आइए ऐसे टूल्स का उपयोग करने वाला एक फ़ंक्शन बनाते हैं:
def get_weather(city: str) -> str:
    """Get current weather for a city"""
    return f"Weather in {city} is sunny"
response = ollama.chat(
    model='llama3.2',
    messages=[{'role': 'user', 'content': 'What is the weather in Paris?'}],
    tools=[get_weather]
)
स्ट्रक्चर्ड आउटपुट यह सुनिश्चित करते हैं कि रिस्पॉन्स लगातार, मशीन-रीडेबल फ़ॉर्मैट जैसे JSON में लौटें।
response = ollama.chat(
    model='llama3.2',
    messages=[{'role': 'user', 'content': 'Review: Great product, 5 stars!'}],
    format='json'
)Ollama उन्नत उपयोग मामलों के लिए मल्टीमॉडल मॉडल्स और क्लाउड-आधारित इंफेरेंस सपोर्ट करता है।
विज़न मॉडल्स टेक्स्ट और इमेज दोनों प्रोसेस कर सकते हैं, जिससे इमेज विवरण और विज़ुअल विश्लेषण जैसे कार्य संभव होते हैं।
response = ollama.chat(
    model='llama3.2-vision',
    messages=[{
        'role': 'user',
        'content': 'Describe this image',
        'images': ['image.jpg']
    }]
)बड़े मॉडल्स जो लोकली नहीं चल सकते, उनके लिए Ollama Cloud होस्टेड इंफेरेंस प्रदान करता है। इसके लिए आपको Ollama Cloud में साइन इन करना होगा।
ollama signinसाइन इन करने के बाद, आप क्लाउड-होस्टेड मॉडल्स के साथ इस तरह चैट कर सकते हैं:
from ollama import Client
import os

ollama.chat(model='deepseek-v3.1:671b-cloud', messages=[...])

client = Client(
    host='https://ollama.com',
    headers={'Authorization': 'Bearer YOUR_API_KEY'}
)वास्तविक एप्लिकेशंस बनाते समय, एरर्स को स्पष्ट रूप से हैंडल करना साइलेंट फेल्यर्स को रोकता है और विश्वसनीयता बढ़ाता है।
Ollama SDK सर्वर-साइड एरर्स के लिए स्ट्रक्चर्ड एक्सेप्शंस उठाता है, जिससे आप देख सकें कि गलती कहाँ हुई।
import ollama

try:
    ollama.generate(model='unknown', prompt='test')
except ollama.ResponseError as e:
print(e.status_code, e.error)आम समस्याओं में सर्वर का न चलना, मॉडल्स का न मिलना, अपर्याप्त मेमोरी, या कॉन्टेक्स्ट लिमिट्स का पार हो जाना शामिल हैं।
सर्वर रनिंग नहीं: ollama serve से शुरू करें
मॉडल नहीं मिला: ollama pull चलाएँ
मेमोरी कम है: छोटे मॉडल्स या quantization का उपयोग करें
कॉन्टेक्स्ट समस्याएँ: num_ctx समायोजित करें
num_ctx उन टोकन्स की अधिकतम संख्या नियंत्रित करता है जिन्हें मॉडल एक बार में “देख” सकता है, जिसमें शामिल हैं:
इस पैरामीटर को मैनेज करने से LLM को पहले का कंटेंट (आमतौर पर शुरुआत से) ट्रंकेट करने या महत्वपूर्ण निर्देश/डेटा चुपचाप खोने से रोका जा सकेगा।
Ollama Python लाइब्रेरी लोकल और क्लाउड LLMs के साथ काम करने के लिए एक संपूर्ण इंटरफ़ेस प्रदान करती है—सरल टेक्स्ट जनरेशन से लेकर एंबेडिंग्स, टूल कॉलिंग, और मल्टीमॉडल इनपुट जैसी उन्नत क्षमताओं तक। LLMs एक लोकल सर्विस की तरह बन जाते हैं जिन्हें आप अपनी स्टैक के किसी भी अन्य घटक की तरह स्क्रिप्ट, टेस्ट और स्केल कर सकते हैं।
मेरे Ollama उपयोग के अनुभव में मुझे लगा कि यह क्लाउड LLMs का सहारा लिए बिना एक अच्छा विकल्प है। उदाहरण के लिए, मैं ओपन सोर्स मॉडल्स का अधिक स्वतंत्र रूप से उपयोग कर सकता/सकती हूँ। यदि आप भी मॉडलों के बीच स्विच करने के अधिक विकल्प ढूँढ रहे हैं, तो Ollama इस सब तक पहुँचने का एक अच्छा माध्यम है।
यदि आप अपनी स्किल्स को गहरा करना चाहते हैं, तो मैं हमारा Developing LLM Applications with LangChain कोर्स करने या Associate AI Engineer for Developers सर्टिफिकेशन लेने की सिफारिश करता/करती हूँ।
AI Engineering Courses
कोर्स
लर्निंग पाथ
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें