
Kurs
Llama 3 ile İnce Ayar (Fine-Tuning)
2 sa
4.1K
Meta, Llama 4 serisini yeni duyurdu. Seride iki ileri seviye model bulunuyor: Llama 4 Scout ve Llama 4 Maverick. Her ikisi de açık ağırlıklı, ancak Llama 4 Scout’un ince ayarı için dört H100 GPU, Llama 4 Maverick için ise sekiz H100 GPU gerekiyor. Bu da yalnızca ciddi kaynağa sahip şirketlerin bu modelleri ince ayar yapabilecekleri anlamına geliyor.
Bu blogda, Llama 4 Scout’u RunPod platformunu kullanarak yalnızca 10 $ maliyetle nasıl ince ayar yapabileceğinizi göstereceğim. Şunları öğreneceksiniz:
Okurlarımızı, haftanın önemli haberlerini sade bir şekilde derlediğimiz ve ücretsiz olan Cuma bültenimiz The Median ile yapay zekâ dünyasındaki gelişmelerden haberdar ediyoruz. Abone olun; haftada sadece birkaç dakikada güncel kalın:
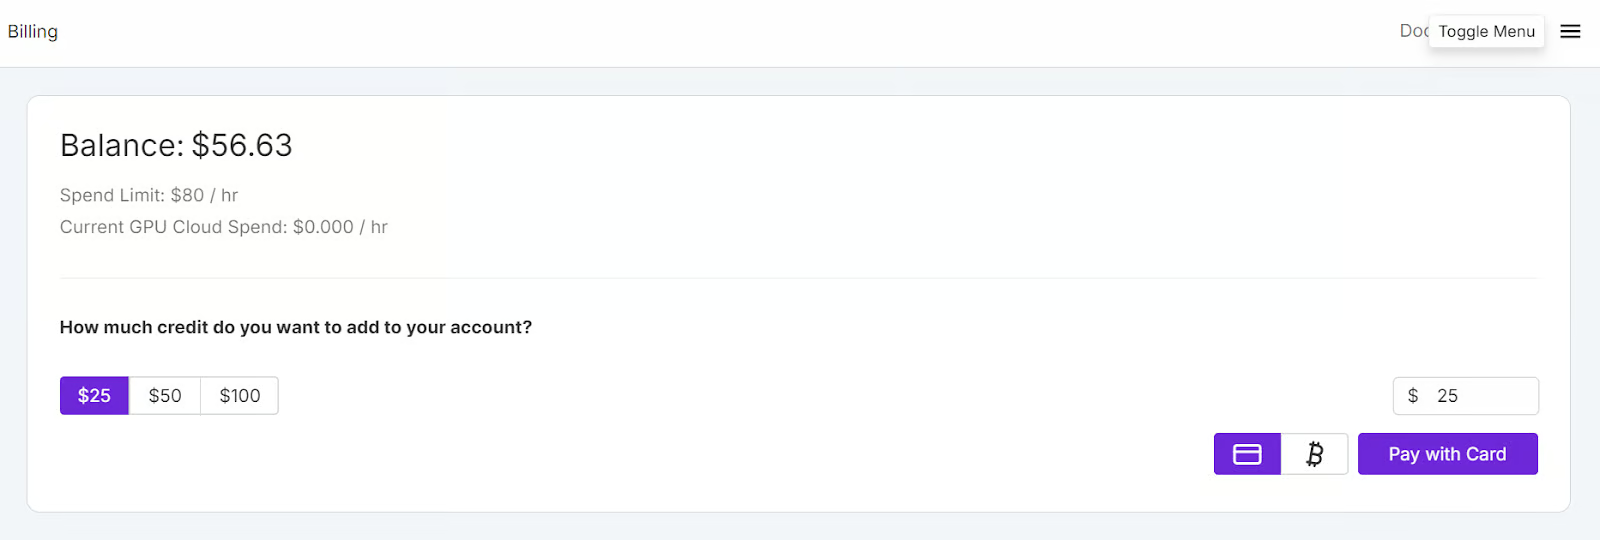
RunPod web sitesine gidin ve bir hesap oluşturun. Ardından Runpod Faturalama menüsüne giderek kredi kartıyla 25 $ ekleyin. Kripto para ile de ödeme yapabilirsiniz.
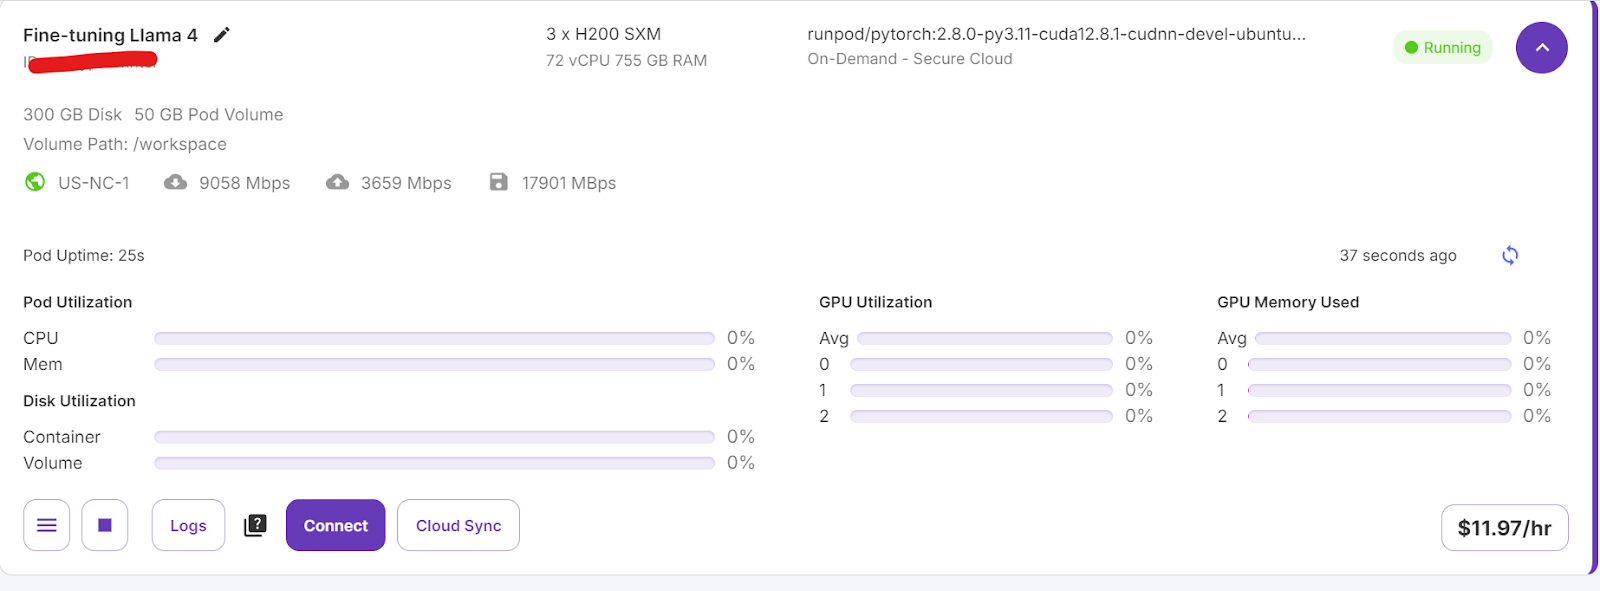
Pod’unuzu yapılandırmaya başlamak için My Pods menüsüne gidin. Pod, görevleriniz için gerekli CPU, GPU, bellek ve depolamayı sağlayan sanal bir sunucu görevi görür.
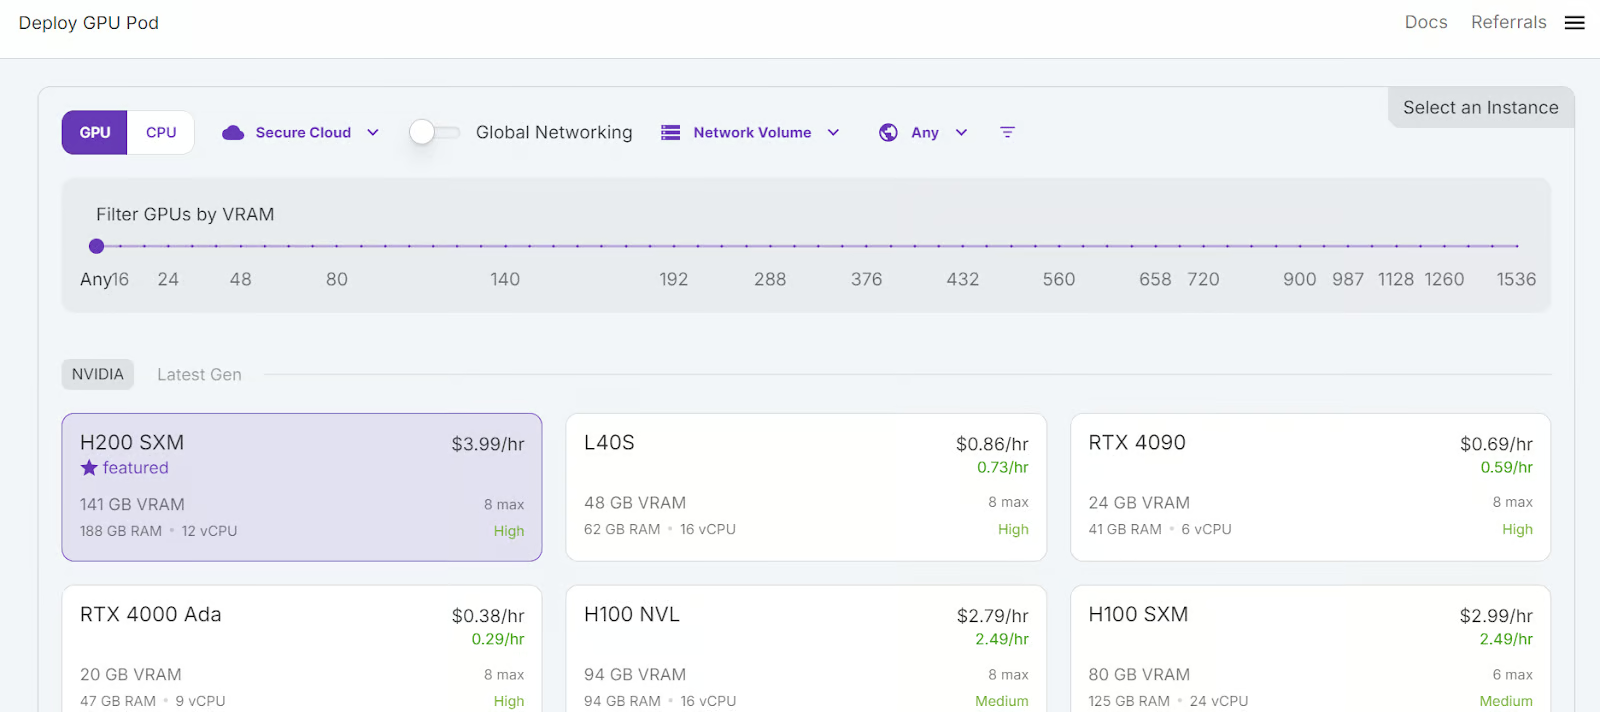
Modeli yüklemek, onu nicelemek ve yeni veri seti üzerinde ince ayar yapmak için yeterli belleği sağlayacak 3x H200 SXM GPU seçeceğiz. Alternatif olarak, modeli tek bir H100 üzerinde çalıştırmak için Unsloth çerçevesini kullanabilirsiniz—ancak bu yaklaşım benim için verimli çalışmadı.
Pod’unuzu kurmak için şu adımları izleyin:
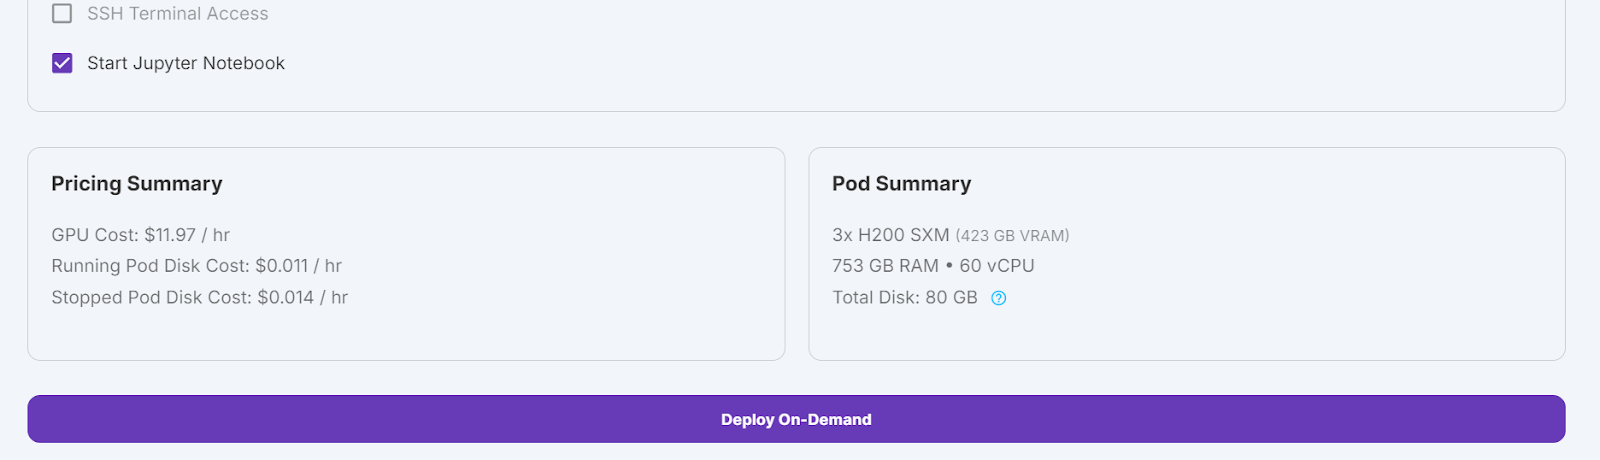
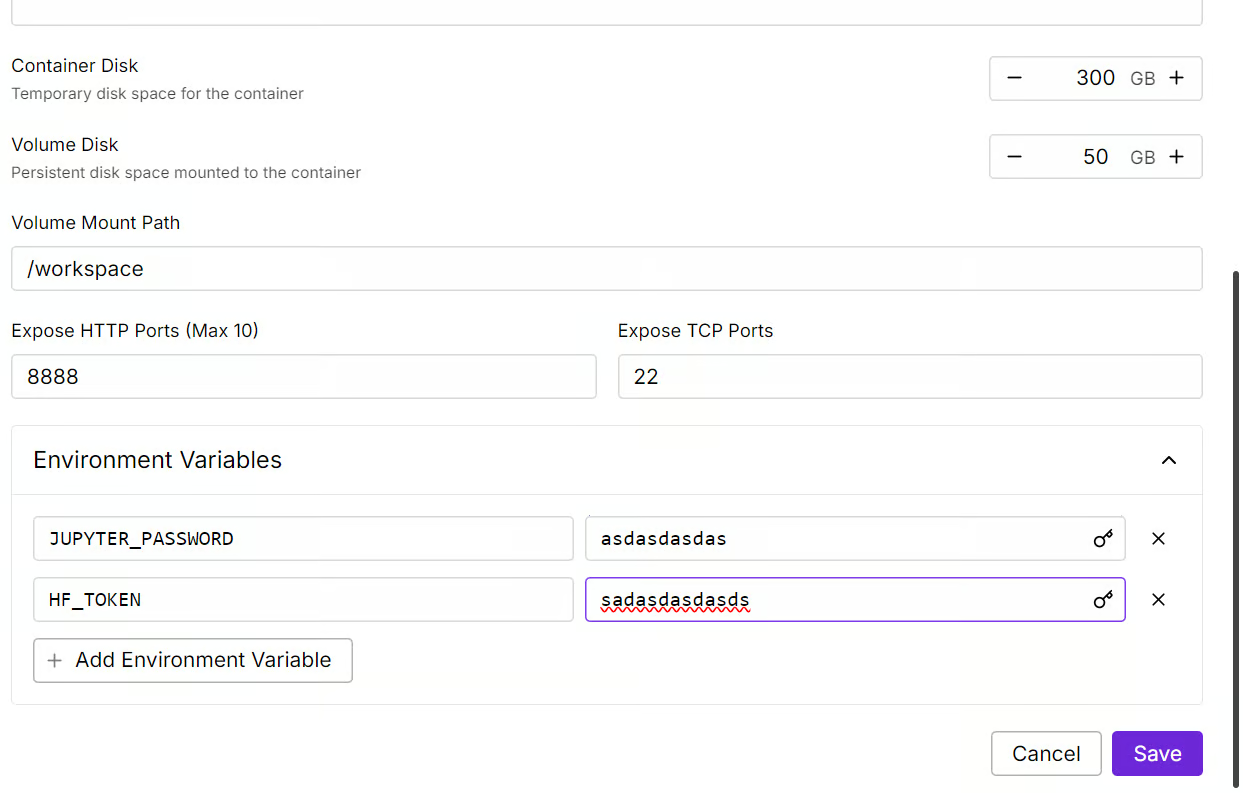
Pod’umuzu, konteyner disk boyutunu 300 GB’a çıkararak ve Hugging Face erişim belirteciniz olan HF_TOKEN ortam değişkenini ekleyerek düzenleyeceğiz. Bu belirteç, modeli etkili biçimde yüklemek ve kaydetmek için gereklidir.
Konteynerin kurulması biraz zaman alacaktır. Her şey hazır olduğunda “Connect” düğmesine tıklayın ve JupyterLab örneğini başlatın.
Yeni bir not defteri oluşturun ve yerel ortamınıza benzer şekilde bu yeni ortamı kullanmaya başlayın.
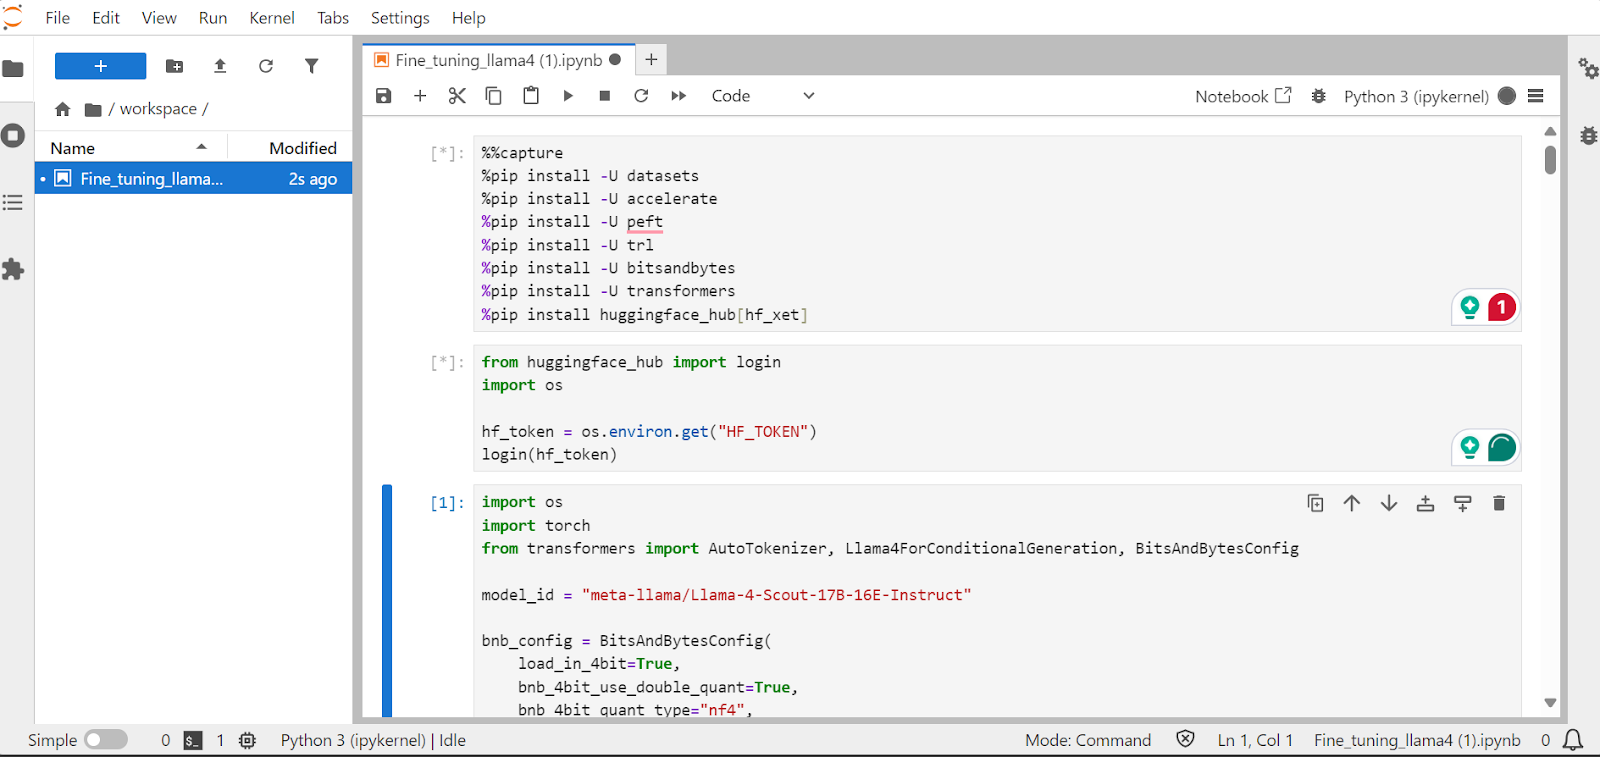
Bu bölümde, yeni Llama 4 modelini ince ayar yaparken karşılaşılan yaygın zorlukları—bellek yetersizliği sorunları ve Transformers kütüphanesindeki hatalar gibi—nasıl ele alacağımızı öğreneceğiz. Ayrıca LoRA adaptörünü sorunsuzca yükleme, ince ayar yapma ve kaydetmeyi de ele alacağız. Bu adımları izleyerek, teknik engelleri dert etmeden ince ayar sürecine odaklanabilirsiniz.
Büyük dil modellerini ince ayar yapmak için gerekli Python paketlerini kuracağız.
Not:
Git-LFS’ten daha hızlı olan xet entegrasyonuna erişim sağlar. Bu entegrasyon indirme hızını üç kat artıracaktır.%%capture
!pip install transformers==4.51.0
%pip install -U datasets
%pip install -U accelerate
%pip install -U peft
%pip install -U trl
%pip install -U bitsandbytes
%pip install huggingface_hub[hf_xet]Hugging Face’e giriş yapmak için API anahtarını ortam değişkeninden yükleyin. Giriş yaparak kapılı (gated) modellere erişebilir, ayrıca ince ayarlı modelleri ve belirteçleyicileri kaydedebilirsiniz.
from huggingface_hub import login
import os

hf_token = os.environ.get("HF_TOKEN")
login(hf_token)Bellek kullanımını verimli kılmak için Llama-4-Scout-17B-16E-Instruct modelini 4 bit niceleme ile yükleyin. Üç H200 GPU’nun tamamını kullanmak için device_map’i auto olarak ayarladığınızdan emin olun.
Not: Model kapılı olduğu için erişiminizin olduğundan emin olun; meta-llama/Llama-4-Scout-17B-16E-Instruct URL’sine gidip formu doldurmanız gerekir.
import os
import torch
from transformers import AutoTokenizer, Llama4ForConditionalGeneration, BitsAndBytesConfig


model_id = "meta-llama/Llama-4-Scout-17B-16E-Instruct"

bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_use_double_quant=False,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)


model = Llama4ForConditionalGeneration.from_pretrained(
    model_id,
    device_map="auto",
    torch_dtype=torch.bfloat16,
    quantization_config=bnb_config,
    trust_remote_code=True,
)

model.config.use_cache = False
model.config.pretraining_tp = 1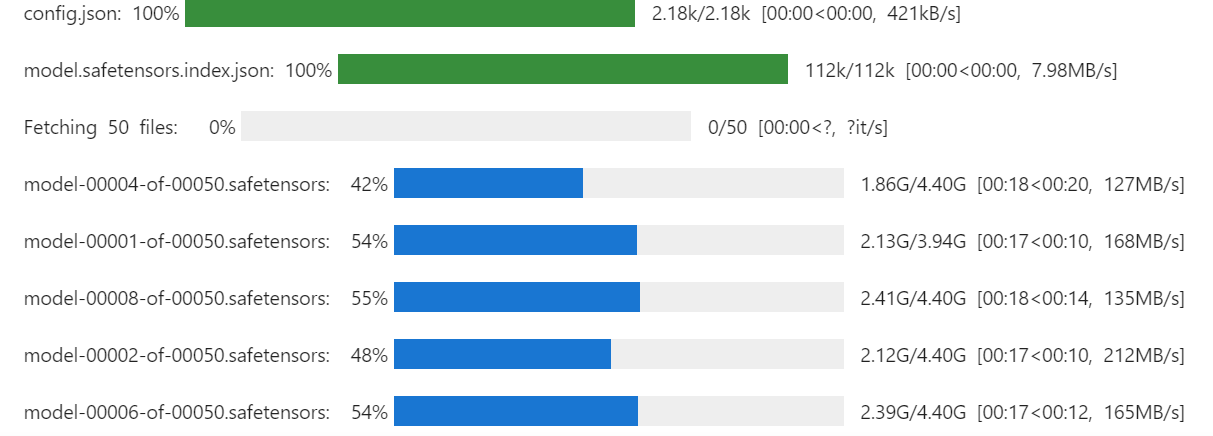
Aynı model kimliğini kullanarak belirteçleyiciyi de yükleyeceğiz.
# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(model_id, trust_remote_code=True)
Aşağıdaki komutu çalıştırarak eğiticiyi kurmak ve modeli ince ayar yapmak için ne kadar belleğimiz kaldığını kontrol edebilirsiniz.
!nvidia-smi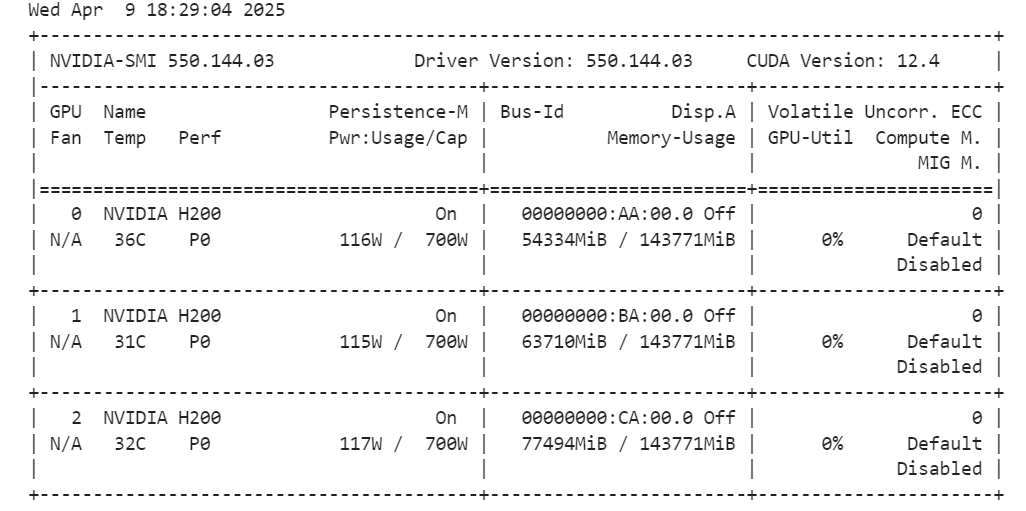
Model için bir istem stili oluşturacağız: soru, düşünce zinciri ve yanıt için yer tutucular içeren bir sistem istemi. Bu istem, modelin adım adım düşünmesine ve net, doğru yanıtlar vermesine yardımcı olacaktır.
train_prompt_style = """Below is an instruction that describes a task, paired with an input that provides further context.
Write a response that appropriately completes the request.
Before answering, think carefully about the question and create a step-by-step chain of thoughts to ensure a logical and accurate response.

### Instruction:
You are a medical expert with advanced knowledge in clinical reasoning, diagnostics, and treatment planning.
Please answer the following medical question.

### Question:
{}

### Response:
<think>
{}
</think>
{}"""
Sonraki adımda, eğitim istemi stilini ve veri setindeki sütunları kullanarak “text” sütununu üretecek Python fonksiyonunu oluşturacağız.
EOS_TOKEN = tokenizer.eos_token  # Must add EOS_TOKEN

def formatting_prompts_func(examples):
    inputs = examples["Question"]
    complex_cots = examples["Complex_CoT"]
    outputs = examples["Response"]
    texts = []
    for question, cot, response in zip(inputs, complex_cots, outputs):
        # Append the EOS token to the response if it's not already there
        if not response.endswith(tokenizer.eos_token):
            response += tokenizer.eos_token
        text = train_prompt_style.format(question, cot, response)
        texts.append(text)
    return {"text": texts}
Hugging Face Hub’da bulunan FreedomIntelligence/medical-o1-reasoning-SFT veri setinden ilk 500 örneği yükleyecek ve ardından formatting_prompts_func fonksiyonunu uygulayarak “text” sütununu oluşturacağız.
from datasets import load_dataset


dataset = load_dataset("FreedomIntelligence/medical-o1-reasoning-SFT","en", split = "train[0:500]",trust_remote_code=True)
dataset = dataset.map(formatting_prompts_func, batched = True,)
dataset["text"][0]
“text” sütununda bir sistem istemi, talimatlar, soru, düşünce zinciri ve yanıt bulunur.
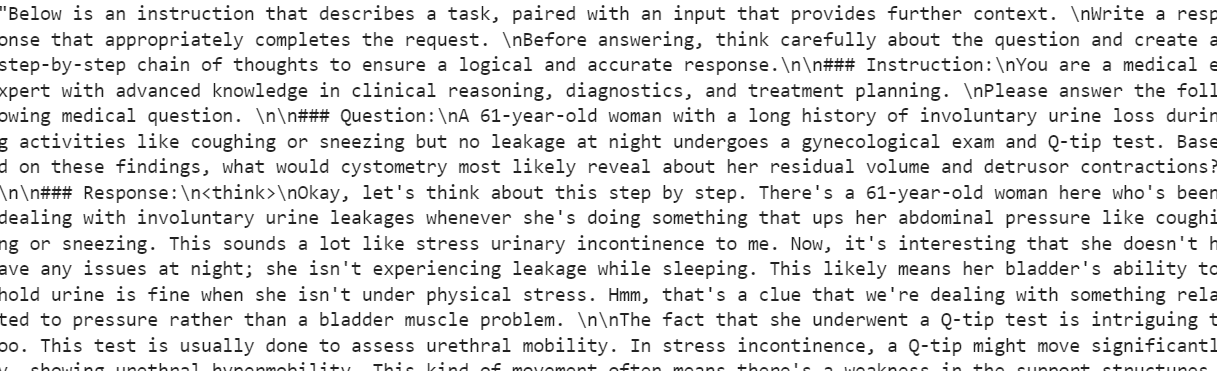
Yeni STF eğiticisi belirteçleyicileri kabul etmiyor, bu yüzden belirteçleyiciyi bir veri birleştiriciye (data collator) dönüştürüp eğiticiye belirteçleyici yerine veri birleştiriciyi sağlayacağız.
from transformers import DataCollatorForLanguageModeling

data_collator = DataCollatorForLanguageModeling(
    tokenizer=tokenizer,
    mlm=False
)Eğitim istemi stilindeki her şeyi içeren, ancak düşünce zinciri ve yanıt bölümleri olmayan bir test istemi stili oluşturacağız.
prompt_style = """Below is an instruction that describes a task, paired with an input that provides further context.
Write a response that appropriately completes the request.
Before answering, think carefully about the question and create a step-by-step chain of thoughts to ensure a logical and accurate response.

### Instruction:
You are a medical expert with advanced knowledge in clinical reasoning, diagnostics, and treatment planning.
Please answer the following medical question.

### Question:
{}

### Response:
<think>{}"""
Veri setindeki ilk soruyu alacağız, test istemi stiliyle isteme dönüştüreceğiz ve modeli yanıt üretmeye hazırlayacağız.
question = dataset[0]['Question']
inputs = tokenizer(
    [prompt_style.format(question, "") + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Modelin düşünce zinciri uzun ve verdiği cevap oldukça kısa; veri setinden belirgin şekilde farklı.
<think>assistant

To approach this question, let's break down the key elements provided and analyze them step by step:

1. **Symptoms**: The patient experiences involuntary urine loss during activities like coughing or sneezing but has no leakage at night. This pattern of urinary incontinence is suggestive of stress urinary incontinence (SUI), which is characterized by the involuntary leakage of urine on effort or exertion, or on sneezing or coughing.

2. **Diagnostic Tests Mentioned**:
   - **Gynecological Exam**: This is likely performed to assess the pelvic anatomy, including the position and support of the urethra and bladder neck, and to check for any pelvic organ prolapse.
   - **Q-tip Test**: This test is used to assess urethral mobility. A Q-tip (cotton swab) is inserted into the urethra, and its angle of movement is measured. Increased mobility (an angle change of more than 30 degrees) is often associated with stress urinary incontinence.

3. **Cystometry (Cystometrogram)**: This test measures the pressure within the bladder during filling and helps assess bladder function, including the residual volume and detrusor muscle contractions. The detrusor muscle is the smooth muscle in the wall of the bladder that contracts to allow urine to be expelled.

Given that the patient likely has stress urinary incontinence (SUI) based on her symptoms:
- **Residual Volume**: In patients with SUI, the bladder usually functions normally, and thus, the residual volume (the amount of urine left in the bladder after urination) is typically not significantly affected. Therefore, one would expect the residual volume to be normal or near-normal.

- **Detrusor Contractions**: In SUI, the problem primarily lies with the urethral sphincter mechanism and support rather than with the detrusor muscle itself. Hence, detrusor contractions are usually normal. The patient does not have symptoms suggestive of an overactive bladder (like urgency, urge incontinence, or nocturia), which would be more indicative of detrusor overactivity.

Based on this analysis, cystometry in this patient would most likely reveal:
- A **normal residual volume**, as her symptoms do not suggest a problem with bladder emptying.
- **Normal detrusor contractions**, as her condition (stress urinary incontinence) primarily involves issues with urethral support and continence mechanisms rather than detrusor function.

Therefore, cystometry would likely show that she has a normal residual volume and normal detrusor contractions.

</think>

The final answer is: $\boxed{Normal residual volume and normal detrusor contractions}$Parametre verimli ince ayar için LoRA’yı (Low-Rank Adaptation) uygulayacağız. LoRA, modelin parametrelerinin büyük kısmını dondurup yalnızca küçük bir alt kümesini eğiterek büyük dil modellerine ince ayar yapmaya yarayan bir tekniktir.
Bu yaklaşım bellek dostudur, daha hızlı ve maliyet etkindir; yine de tam ince ayara kıyasla yüksek doğruluğu korur.
from peft import LoraConfig, get_peft_model

# LoRA config
peft_config = LoraConfig(
    lora_alpha=16,                           # Scaling factor for LoRA
    lora_dropout=0.05,                       # Add slight dropout for regularization
    r=64,                                    # Rank of the LoRA update matrices
    bias="none",                             # No bias reparameterization
    task_type="CAUSAL_LM",                   # Task type: Causal Language Modeling
    target_modules=[
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj",
        "gate_proj",
        "up_proj",
        "down_proj",
    ],  # Target modules for LoRA
)

model = get_peft_model(model, peft_config)
Şimdi veri setini, modeli, veri birleştiriciyi, eğitim argümanlarını ve LoRA yapılandırmasını sağlayarak SFTTrainer’ı (Denetimli İnce Ayar Eğiticisi) yapılandırıp başlatacağız. SFTTrainer, tüm bu bileşenleri tek bir akışta birleştirerek Llama 4 gibi büyük dil modellerini LoRA ile eğitmeyi kolaylaştırır.
from trl import SFTTrainer
from transformers import TrainingArguments


# Training Arguments
training_arguments = TrainingArguments(
    output_dir="output",
    per_device_train_batch_size=1,
    per_device_eval_batch_size=1,
    gradient_accumulation_steps=2,
    optim="paged_adamw_32bit",
    num_train_epochs=1,
    logging_steps=0.2,
    warmup_steps=10,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    report_to="none"
)

# Initialize the Trainer
trainer = SFTTrainer(
    model=model,
    args=training_arguments,
    train_dataset=dataset,
    peft_config=peft_config,
    data_collator=data_collator,
)Eğitim sürecini başlatmak için aşağıdaki komutu çalıştırın:
trainer.train()Pod panonuza geçtiğinizde, eğiticinin eğitim için üç GPU’nun tamamını kullandığını göreceksiniz.
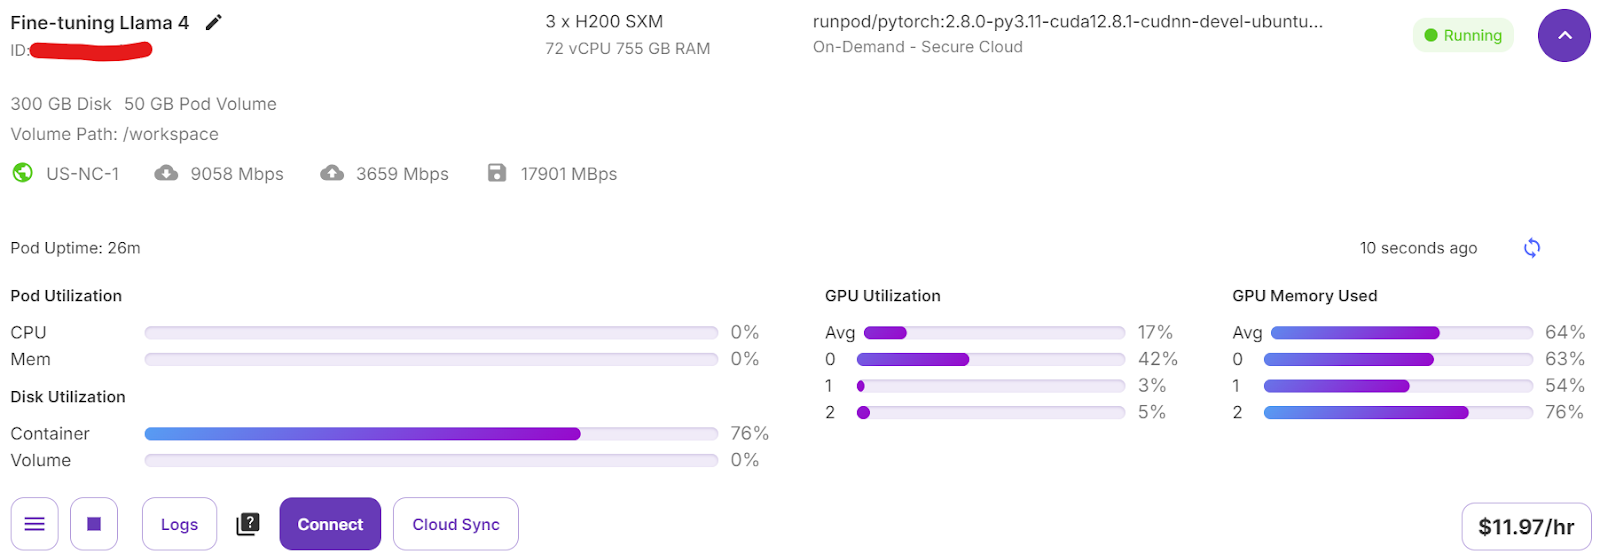
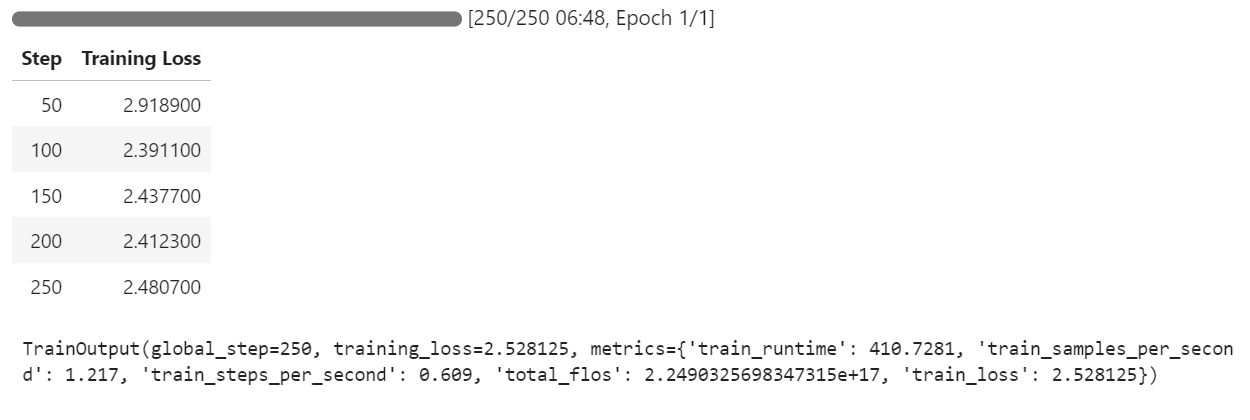
Modelin ince ayarı yalnızca 7 dakika sürdü; baştan sona tüm projeyi çalıştırmak ise toplam 30 dakika aldı.
Aynı örnekle ince ayarlı modeli test ederek ince ayar sonrası performansını karşılaştıracağız. Bu, modelin akıl yürütme ve ayrıntılı yanıt üretme becerisinin ne kadar geliştiğini değerlendirmemize yardımcı olacak.
question = dataset[0]['Question']
inputs = tokenizer(
    [prompt_style.format(question, "") + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Modelin akıl yürütme süreci isabetli ve yanıt ayrıntılı ile mantıklı:
<think>
Alright, let's think about what's going on with this 61-year-old woman. She's experiencing involuntary urine loss when she coughs or sneezes, which is classic for stress urinary incontinence. But there's no leakage at night, which is interesting. That detail might help us rule out other types of incontinence, like overactive bladder.

Now, let's think about the tests she's had. The gynecological exam and the Q-tip test are usually done to check for any anatomical issues that could be causing her symptoms. If the Q-tip test is positive, it means there's some mobility in the urethra, which can be a sign of stress incontinence.

Okay, so we've got stress urinary incontinence in mind. What does cystometry tell us? It's a test that looks at how well the bladder functions by measuring pressure and volume during filling and voiding.

For someone with stress incontinence, the cystometry would probably show that her bladder is doing its job properly. The residual volume, which is the amount of urine left in the bladder after she pees, should be normal. This means her bladder is emptying well enough.

Also, with stress incontinence, you wouldn't expect to see abnormal detrusor contractions. These are like muscle spasms in the bladder that can cause urgency and urge incontinence. But in stress incontinence, the problem is more about the urethral support and pressure control during activities, not the bladder muscle itself.

So, putting it all together, the cystometry should show a normal residual volume and no abnormal detrusor contractions. This fits perfectly with what we know about stress urinary incontinence. Yep, that's what I'd expect to see in this case.
</think>
In this scenario, the cystometry would most likely reveal a normal residual volume and no abnormal detrusor contractions. This is because stress urinary incontinence, as indicated by the patient's symptoms and the positive Q-tip test, is primarily related to issues with urethral support and pressure control during activities, not with the bladder muscle's function or emptying ability.
Modeli, performansını daha da değerlendirmek için veri setinden farklı bir örnek üzerinde test edelim.
question = dataset[10]['Question']
inputs = tokenizer(
    [prompt_style.format(question, "") + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Yanıt mantıklı, ayrıntılı ve modelin tıbbi akıl yürütmeyi etkin biçimde uyguladığını gösteriyor:
<think>
Alright, let's break this down. So, we have a 42-year-old guy who's just recovered from pneumonia, and his T3 levels are low. Now, his TSH is slightly elevated at 4.7 µU/mL, which isn't too high but is definitely not normal. T4 is at 6 µg/dL, which is kind of in the middle range, and T3 is 68 ng/dL, which is low. Hmm, these numbers make me think of a condition called sick euthyroid syndrome. It's like when the body gets sick, the thyroid function tests can get all wonky, even if the thyroid itself is working fine.

In this syndrome, T3 usually drops first, and T4 might stay normal or even rise a bit. This makes sense here because his T3 is low, but T4 is still around 6 µg/dL. Now, the TSH is slightly elevated, which is a bit puzzling, but in sick euthyroid syndrome, TSH can be normal or even slightly elevated. So, this fits.

But wait, what about the other hormones? In sick euthyroid syndrome, we often see an increase in reverse T3 (rT3). This is because the body might convert T4 to rT3 instead of T3 when it's stressed. So, if I were to guess, I'd say the reverse T3 level is probably elevated in this case.

This all makes sense because the clinical picture and lab results are lining up nicely with sick euthyroid syndrome. So, if I had to pick an additional hormone that's likely elevated, it would be the reverse T3. Yeah, that seems to fit the scenario perfectly.
</think>
In this scenario, considering the clinical context of a 42-year-old man recovering from pneumonia with decreased T3 levels and slightly elevated TSH, along with normal T4 levels, the likely condition is sick euthyroid syndrome. In this condition, the body often converts T4 to reverse T3 (rT3) instead of T3 during stress or illness. Therefore, the additional hormone level that is likely to be elevated in this patient is reverse T3 (rT3).İnce ayarlı modeli (LoRA adaptörü) ve belirteçleyiciyi Hugging Face Hub’a göndereceğiz. Bu işlem, sizin için otomatik olarak bir depo oluşturur ve gerekli tüm model dosyalarını yükler; böylece model daha fazla kullanım veya paylaşım için herkese açık hâle gelir.
model.push_to_hub("Llama-4-Scout-17B-16E-Instruct-Medical-ChatBot")
tokenizer.push_to_hub("Llama-4-Scout-17B-16E-Instruct-Medical-ChatBot")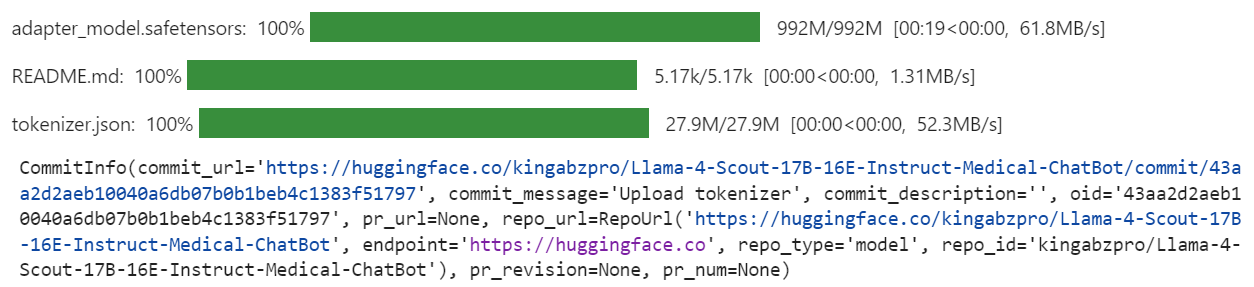
İşlem tamamlandığında, model deposuna şu bağlantıdan erişebilirsiniz: kingabzpro/Llama-4-Scout-17B-16E-Instruct-Medical-ChatBot
Tüm gerekli kodları, çıktıları ve kendi Llama 4 modelinizi ince ayar yapmanıza yardımcı olacak ayrıntılı talimatları içeren eşlik eden not defteri burada yer alıyor.
Bu eğitimi hazırlamak zorlayıcı ama bir o kadar da öğretici oldu. Llama 4 ile çalışırken, modelin kullanımındaki karmaşıklıkları ortaya koyan çeşitli sorunlarla karşılaştım. Bana göre, Llama 4 henüz yaygın kullanım için tam olarak optimize edilmemiş; özellikle de tüketici sınıfı GPU’lara güvenen bireyler için. Karşılaştığım başlıca zorluklardan bazıları şunlardı:
Buna rağmen, bu rehberi adım adım izlerseniz Llama 4’ü yeni herhangi bir veri seti üzerinde nispeten kolayca ince ayar yapabilirsiniz.
Llama 4 hakkında daha fazla bilgi edinmek için şu kaynaklara göz atın:
Bu kurslarla yapay zekâyı öğrenin!
Kurs
Program
Program
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



