
Lernpfad
Entwicklung von großen Sprachmodellen
16 Std.
Aktuell ist Gemini 2.0 Pro nur über das Google AI Studio zugänglich, wofür du dich mit einem Google-Konto anmelden musst. So legst du los:
Besuche die Website des Google AI Studio und melde dich mit deinen Google-Zugangsdaten an. Danach landest du im Dashboard des Google AI Studio.
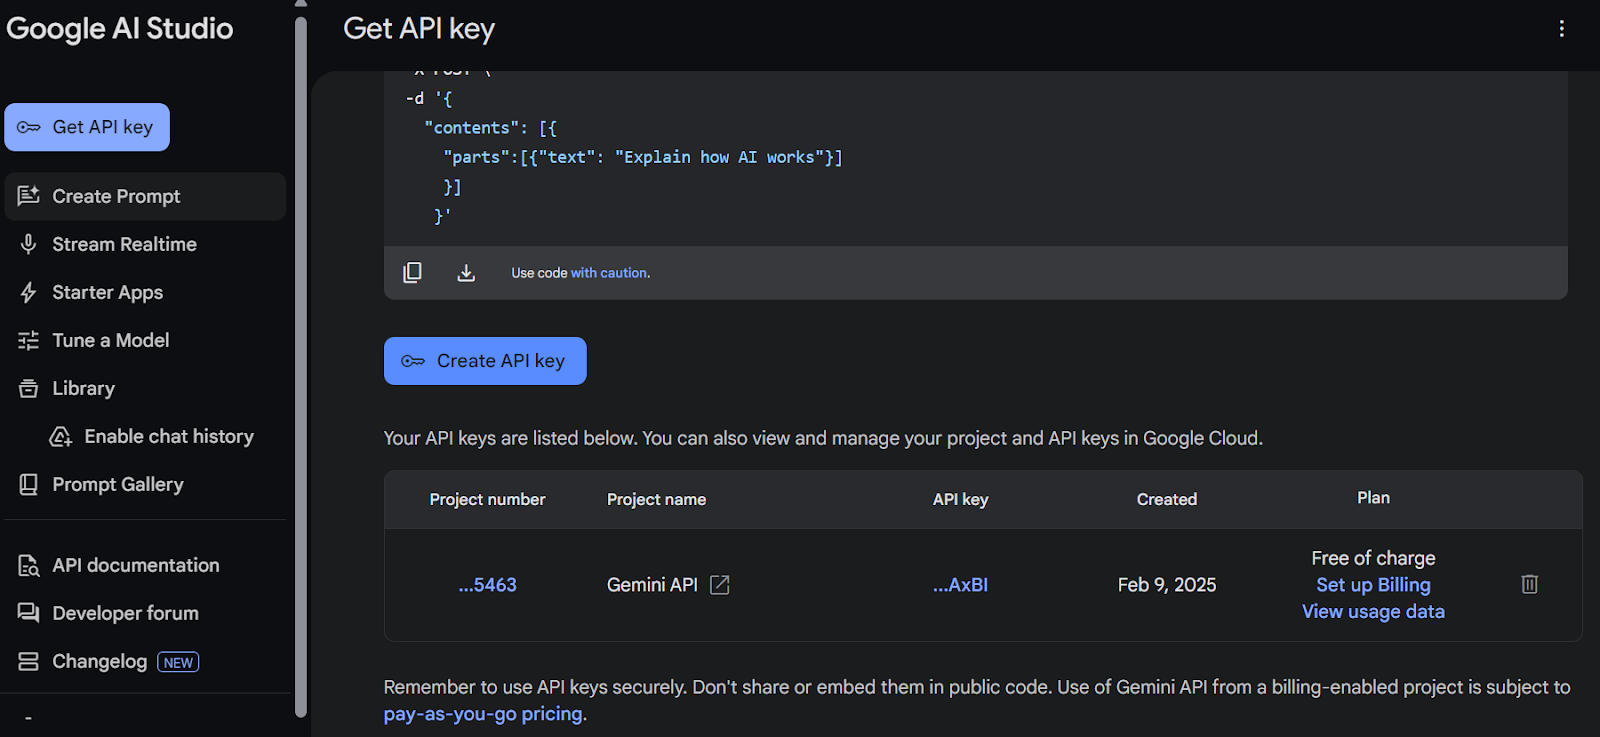
Quelle: Google AI Studio
Erstelle eine Umgebungsvariable namens GEMINI_API_KEY und weise ihr den Wert des eben erzeugten API-Schlüssels zu.
Installiere die nötigen Python-Pakete mit folgendem Befehl im Terminal:
pip install google-genai
pip install gradioJetzt nutzen wir den Gemini-Python-Client, um verschiedene Features des Gemini 2.0 Pro-Modells aufzurufen. Dazu zählen Textverständnis, Bildverarbeitung, Audioanalyse und Dokumentenverständnis.
Zusätzlich testen wir die Codeausführung: Wir lassen Code generieren und direkt im Cloud-Python-Kernel ausführen.
Wir laden den API-Schlüssel aus der Umgebungsvariablen und initialisieren damit den Client. Dieser Client ist unsere Schnittstelle zu den Modellen und Features.
Anschließend geben wir dem Modell eine Frage und erzeugen eine Streaming-Antwort. Sobald Tokens generiert werden, erscheinen sie fortlaufend im Terminal – für unmittelbares Feedback.
import os
from google import genai

API_KEY = os.environ.get("GEMINI_API_KEY")

client = genai.Client(api_key=API_KEY)

response = client.models.generate_content_stream(
    model="gemini-2.0-pro-exp-02-05",
    contents=["Explain how Stock Market works"])
for chunk in response:
    print(chunk.text, end="")
Das Modell hat eine detaillierte und treffende Antwort generiert.
The stock market is a complex system, but here's a breakdown of how it works in a simplified way, covering the key concepts:

**1. What are Stocks (Shares)?**

*   **Ownership:** Stocks, also called shares or equities, represent ownership in a company.  When you buy a stock, you're buying a tiny piece of that company.
*   **Claim on Assets and Earnings:** As a shareholder, you have a claim on the company's assets and earnings.  You're entitled to a portion of the company's profits (often distributed as dividends, though not always) and, in theory, a share of the company's value if it were to be liquidated.
*   **Voting Rights (Sometimes):**  Many stocks (but not all) come with voting rights, allowing you to have a say in certain company decisions (like electing the board of directors).

**2. Why Companies Issue Stock (Go Public)?**Für das Bildverständnis laden wir das Bild mit der Pillow-Bibliothek in Python und fügen es dem Argument contents hinzu. contents enthält die Fragen zum Bild zusammen mit dem Bildobjekt.
from google import genai
from google.genai import types

import PIL.Image

image = PIL.Image.open('image.png')

response = client.models.generate_content_stream(
    model="gemini-2.0-pro-exp-02-05",
    contents=["Explain the image", image])

for chunk in response:
    print(chunk.text, end="")
Das Modell hat das Bild präzise verstanden und sogar feine Details beschrieben.
The image is a stylized, abstract graphic. It looks like a simplified diagram or node network, with a black background.

Here's a breakdown:

*   **Nodes:**  There are four circular nodes.  Each node is a different color:
    *   Light Blue (Top Left)
    *   Light Green (Bottom Left)
    *   White (Top Right)
    *    Red (Bottom Right)
*    **Node outline:** There is a thick outline around each of the circles.
* **Shadow:** Each circle appears to be casting a white shadow.Gemini 2.0 Pro versteht Audio direkt, ohne vorherige Transkription. Lade die Audiodatei und übergib sie zusammen mit der passenden Frage im Argument content.
with open('audio.wav', 'rb') as f:
    audio_bytes = f.read()

response = client.models.generate_content_stream(
  model='gemini-2.0-pro-exp-02-05',
  contents=[
    'Describe this audio',
    types.Part.from_bytes(
      data=audio_bytes,
      mime_type='audio/wav',
    )
  ]
)

for chunk in response:
    print(chunk.text, end="")
Auch hier liefert das Modell eine sehr genaue Beschreibung der Audiodatei.
The audio appears to be a collection of short, spoken phrases or sentences. There is only one speaker, a male, and he seems to be reading or reciting these phrases, possibly as part of a list or exercise. The content focuses on food and related concepts like smell and temperature.Anstatt Langchain oder ein anderes RAG-Framework zu verwenden, kannst du Gemini 2.0 Pro direkt mit Dokumenten füttern. Es parst und indexiert sie, sodass du anschließend Fragen dazu stellen kannst.
Wir haben eine PDF-Datei geladen und Fragen dazu gestellt. So einfach ist das.
from google import genai
from google.genai import types
import pathlib

prompt = "What the document is about"
response = client.models.generate_content_stream(
  model="gemini-2.0-pro-exp-02-05",
  contents=[
      types.Part.from_bytes(
        data=pathlib.Path('cv.pdf').read_bytes(),
        mime_type='application/pdf',
      ),
      prompt])

for chunk in response:
    print(chunk.text, end="")
Das Ergebnis: eine passgenaue Beschreibung des Dokuments und seiner Inhalte.
Based on the OCR output, the document is **Abid Ali Awan's Curriculum Vitae (CV) or resume**. It details his:

*   **Contact Information:** Name, address, email, and phone number.
*   **Work Experience:** A chronological list of his professional roles, including job titles, companies, locations, dates of employment, and brief descriptions of his responsibilities. This includes experience in data science, freelancing, research, media, and network engineering.
*   **Education:** His academic background, listing degrees earned, institutions attended, graduation dates, GPAs, and areas of specialization.
*    **Gap Year:** Explaining the time that have taken for medical/personal issues.
* **Professional Skills:** A list of his technical and soft skills, categorized and ratedDas beeindruckendste Feature der Gemini-API: Du kannst Code generieren und mit derselben API ausführen. Heißt: Der Code wird erstellt und getestet; tritt ein Fehler auf, behebt das Modell ihn und führt den Code erneut aus – bis das richtige Ergebnis vorliegt.
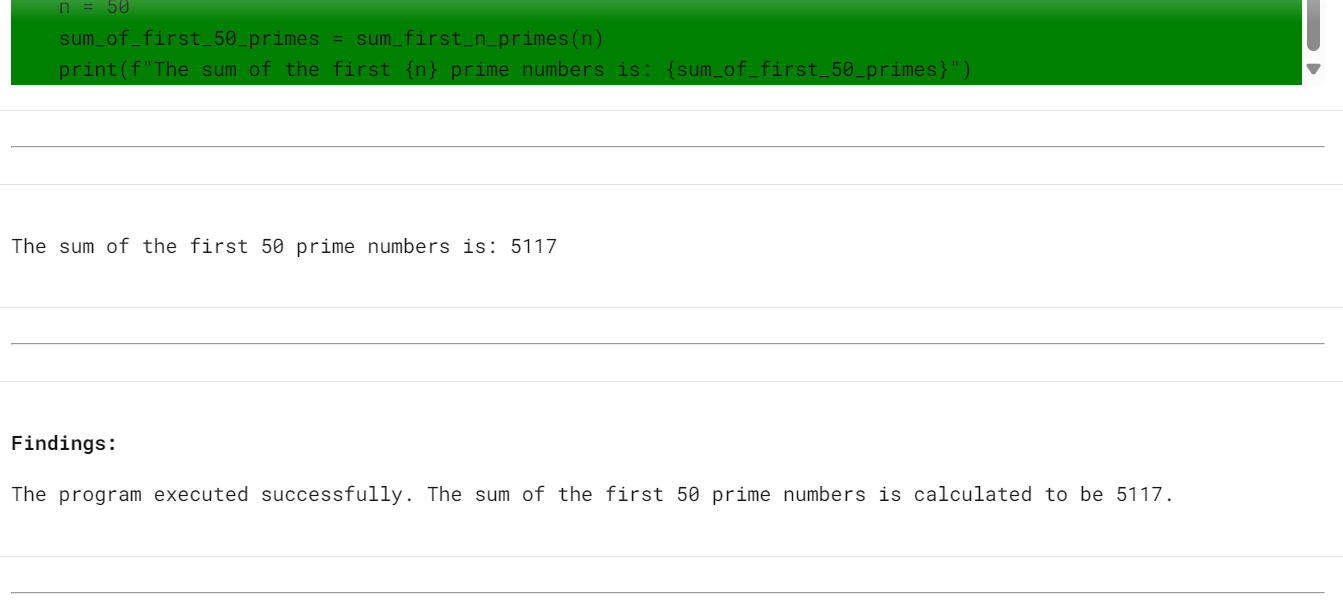
Wir haben Gemini 2.0 Pro eine Programmieraufgabe gestellt und gebeten, den Code am Ende auszuführen. Im Argument config siehst du, dass wir das Code-Execution-Tool für die Ausführung in der Cloud aktiviert haben.
from google import genai
from google.genai import types
from IPython.display import Markdown, HTML, Image, display

response = client.models.generate_content(
  model='gemini-2.0-pro-exp-02-05',
  contents="""
  Write a Python program to calculate the sum of the first 50 prime numbers. The program should:
   - Use a function to check if a number is prime.
   - Use another function to find and sum the first n prime numbers, where n is 50 in this case.
   - Ensure the code is efficient and readable.
   - Print the result clearly.
After writing the code, execute it to verify that the sum of the first 50 prime numbers is correct.
  """,
  config=types.GenerateContentConfig(
    tools=[types.Tool(
      code_execution=types.ToolCodeExecution
    )]
  )
)

def display_code_execution_result(response):
  for part in response.candidates[0].content.parts:
    if part.text is not None:
      display(Markdown(part.text))
    if part.executable_code is not None:
      code_html = f'<pre style="background-color: green;">{part.executable_code.code}</pre>' # Change code color
      display(HTML(code_html))
    if part.code_execution_result is not None:
      display(Markdown(part.code_execution_result.output))
    if part.inline_data is not None:
      display(Image(data=part.inline_data.data, format="png"))
    display(Markdown("---"))

display_code_execution_result(response)
Das Modell hat den Code generiert, konnte ihn zunächst nicht ausführen, hat die Fehler dann behoben, den Code erneut ausgeführt und die Ergebnisse erfolgreich angezeigt.
Jetzt erstellen wir eine Gradio-Web-App, die alle zuvor getesteten Funktionen bündelt. So kann jede:r Dateien hochladen, Fragen zu Bildern, Audio und Dokumenten stellen – und sogar Code ausführen.
Den Code für app.py findest du im GitHub-Repository Gemini-2-Pro-Chat. Schau rein, um zu verstehen, wie jedes Feature implementiert wurde.
Kurz zusammengefasst enthält die App:
generate_content_stream aus Google GenAI gestreamt.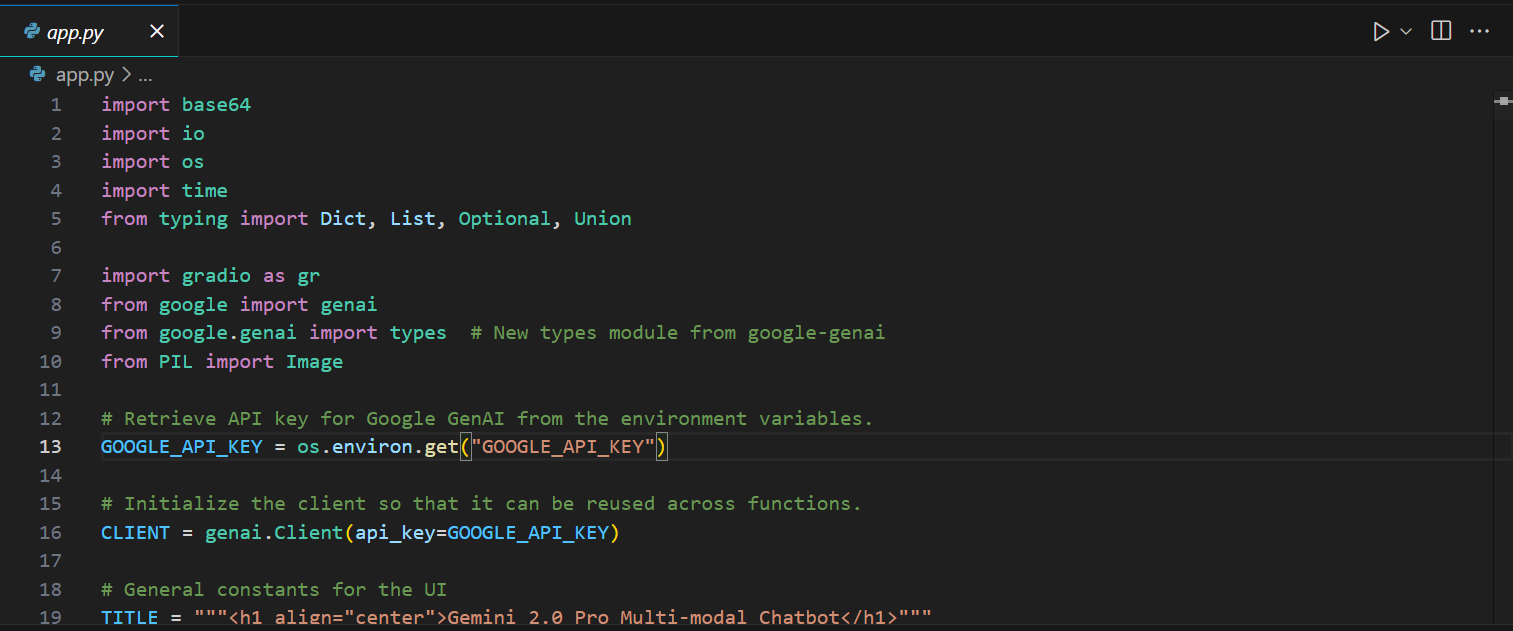
Sobald du den Code aus dem Remote-Repository in dein lokales Projekt kopiert hast, kannst du ihn lokal starten.
python app.py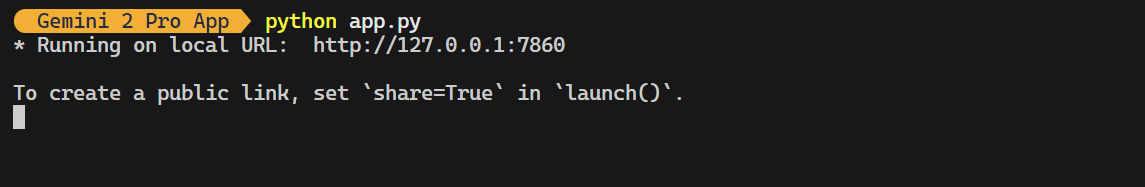
Nun prüfen wir die Web-App, damit alles reibungslos läuft. Wir gehen die Features nacheinander in der Oberfläche durch.
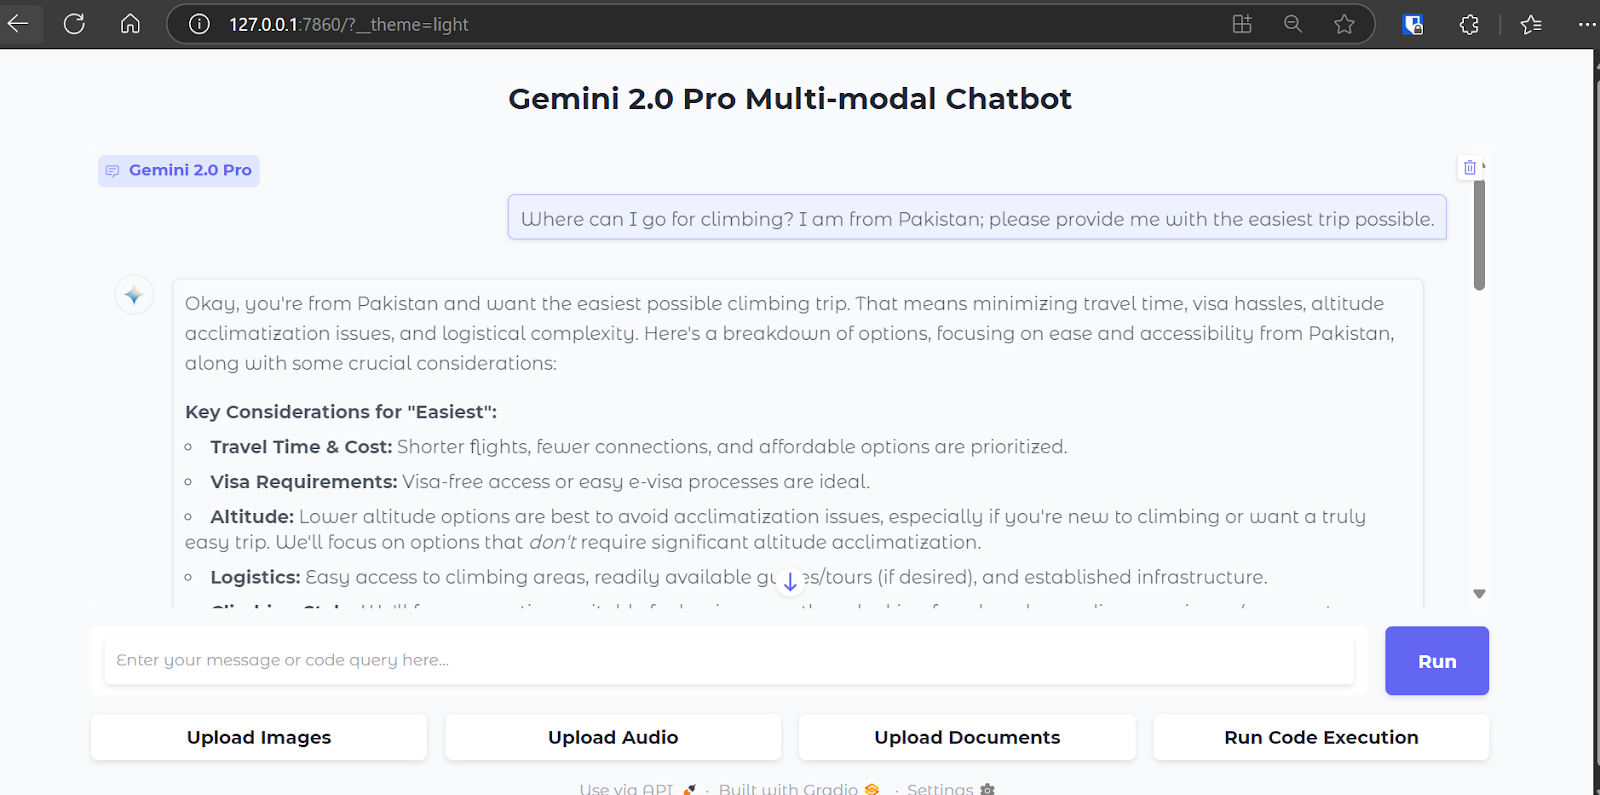
1. Tippe deine Frage ein und drücke [Enter]. Die Antwort wird sofort generiert – nach wenigen Sekunden hast du dein Ergebnis.
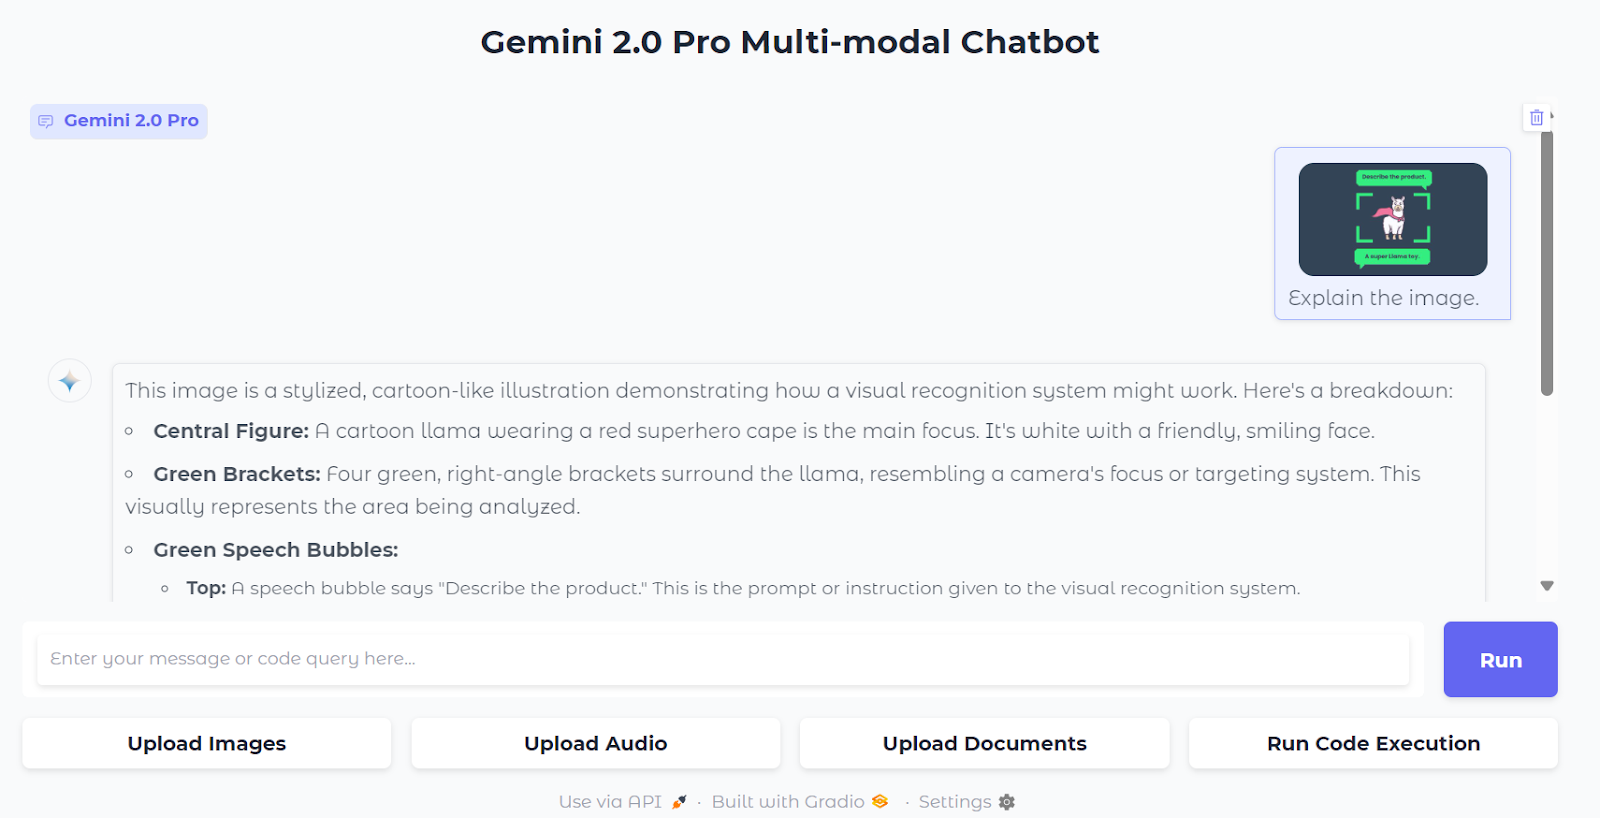
2. Um ein Bild hochzuladen, klicke auf „Upload Images“ und wähle die Datei aus. Stelle dann deine Frage zum Bild – Gemini 2.0 Pro liefert eine sehr genaue und detaillierte Antwort.
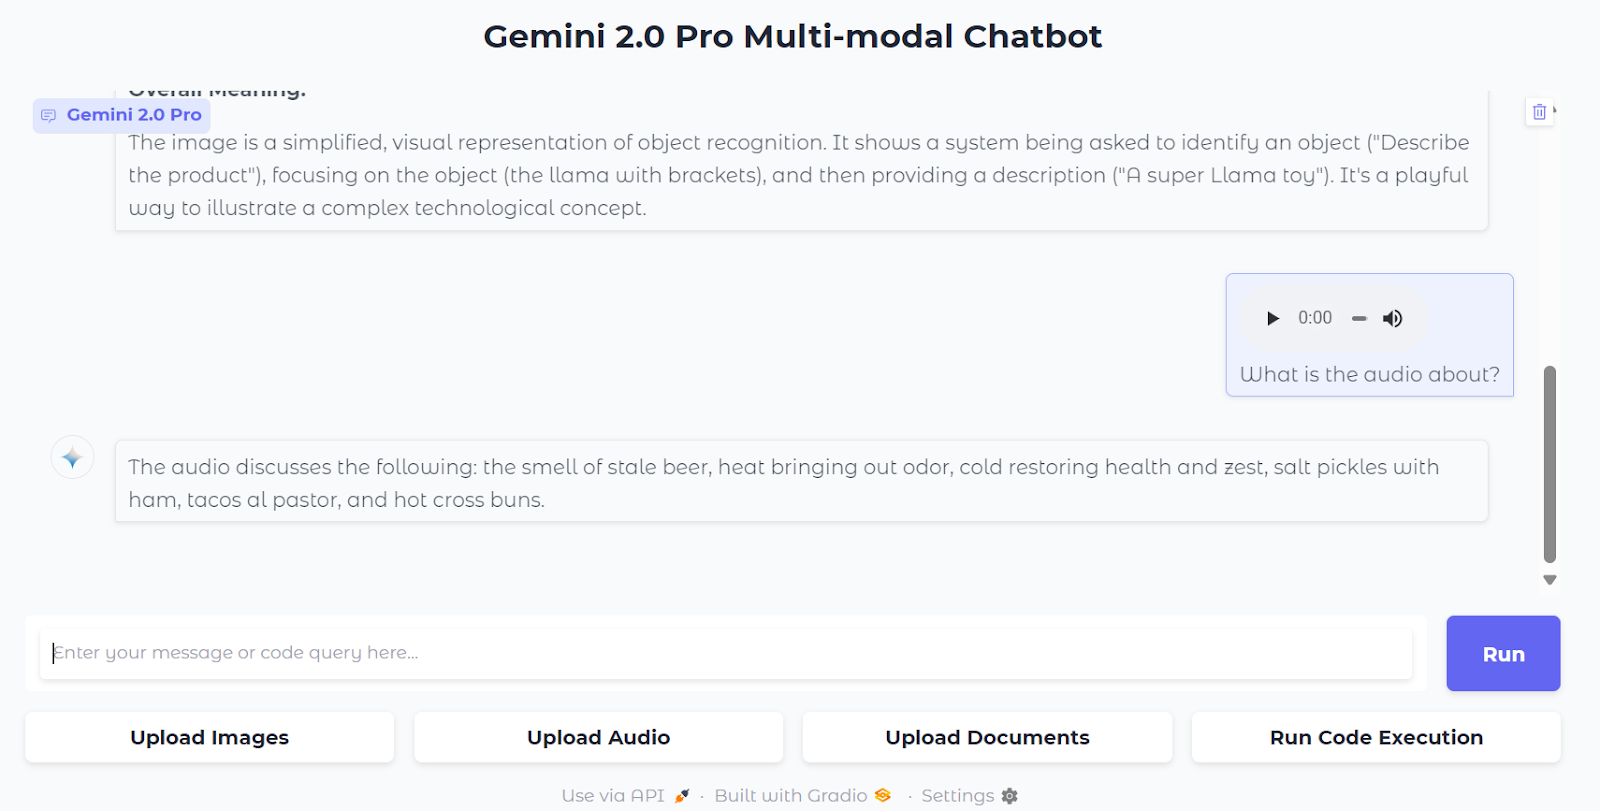
3. Lade Audio über „Upload Audio“ hoch und wähle die Datei aus. Stelle anschließend deine Frage zum Audio. Das Modell liefert sehr präzise Antworten.
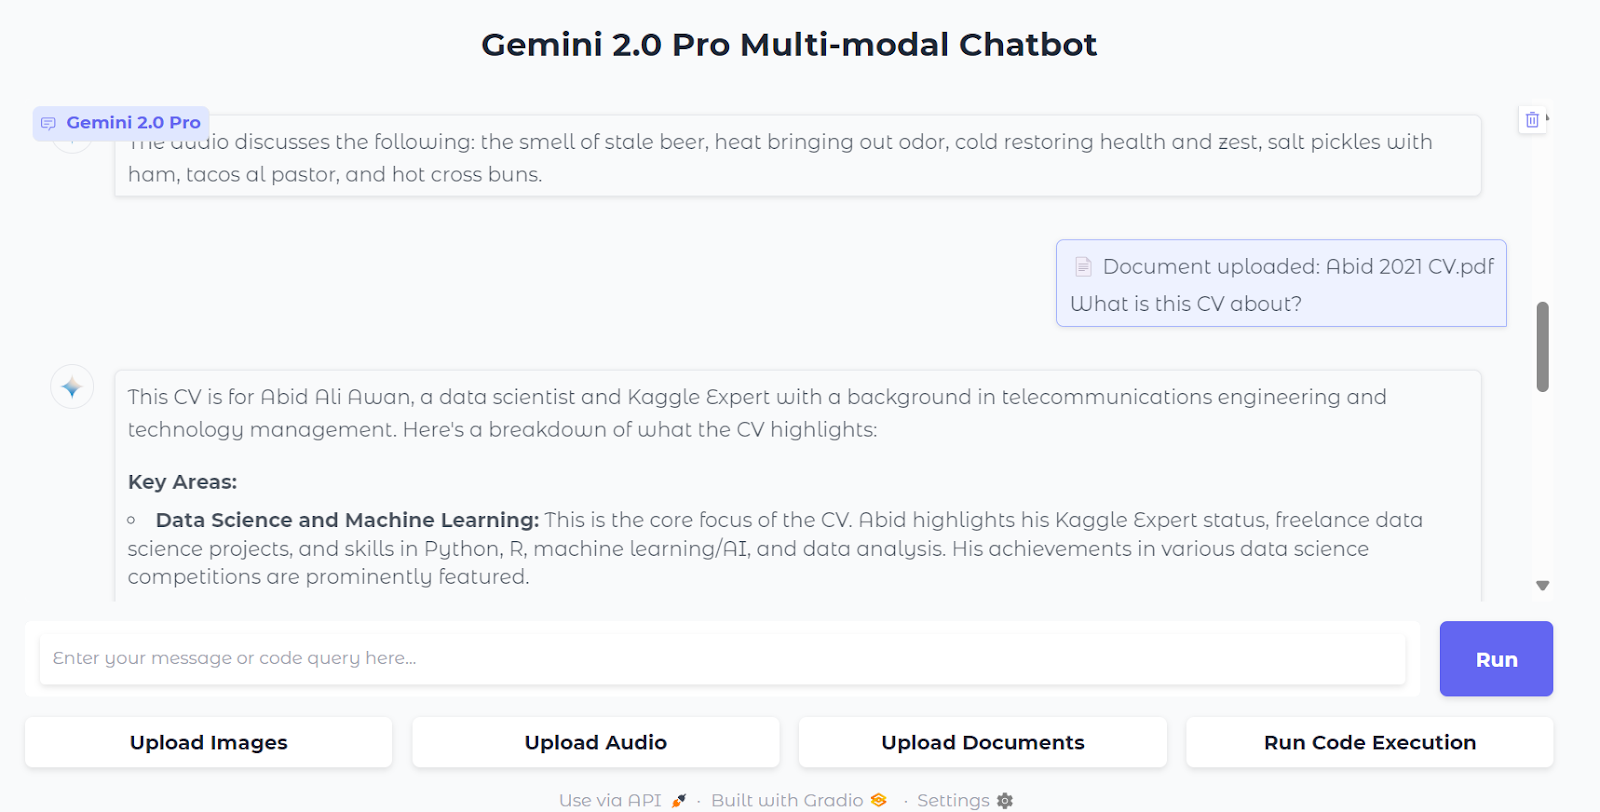
4. Du kannst auch Dokumente hochladen. Wähle per „Upload Documents“ ein PDF aus und stelle deine Frage zum Dokument.
5. Die Codeausführung funktioniert etwas anders. Es gibt keinen Verlauf, um Konflikte zu vermeiden – du musst also im selben Prompt darum bitten, den Code zu generieren und auszuführen.
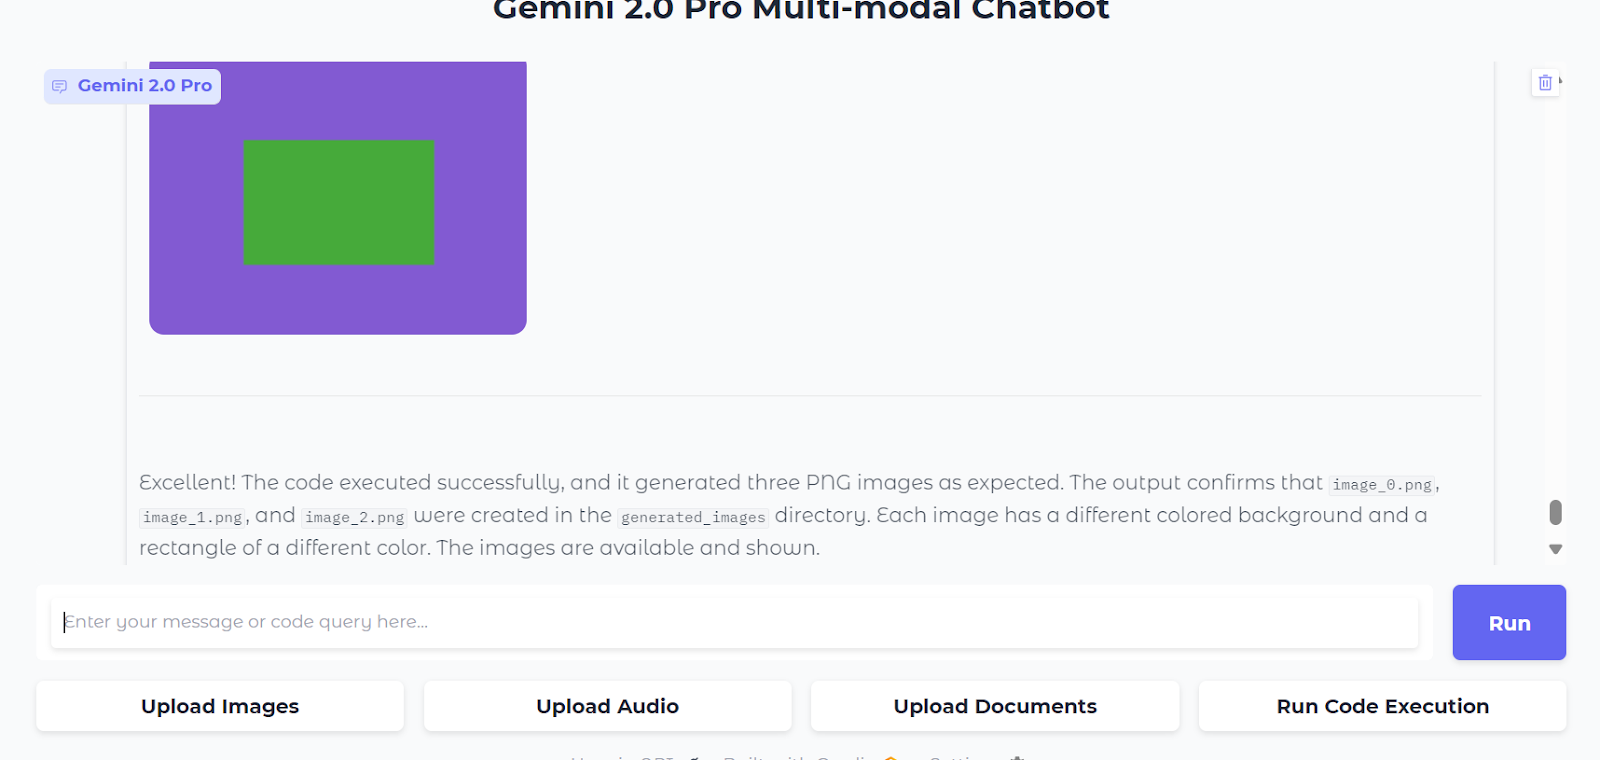
Beispiel: Wir haben gebeten, Beispiel-Python-Code zu generieren und auszuführen, der ein zufälliges PNG-Bild erzeugt, und danach auf „Run Code Execution“ geklickt.
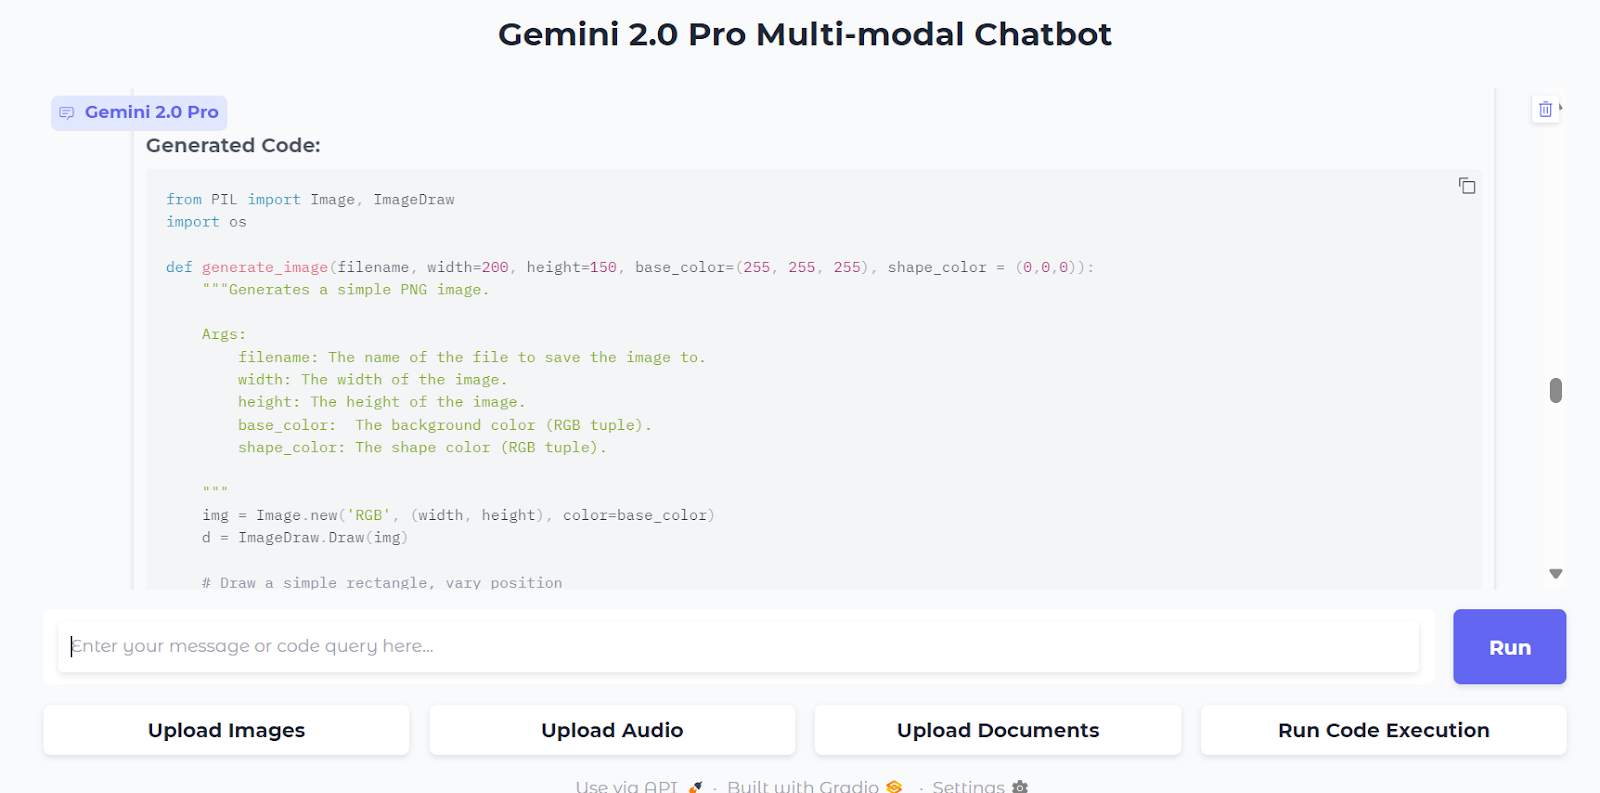
Nach wenigen Sekunden war der Code generiert, ausgeführt und die Bilder wurden direkt im Chat angezeigt.
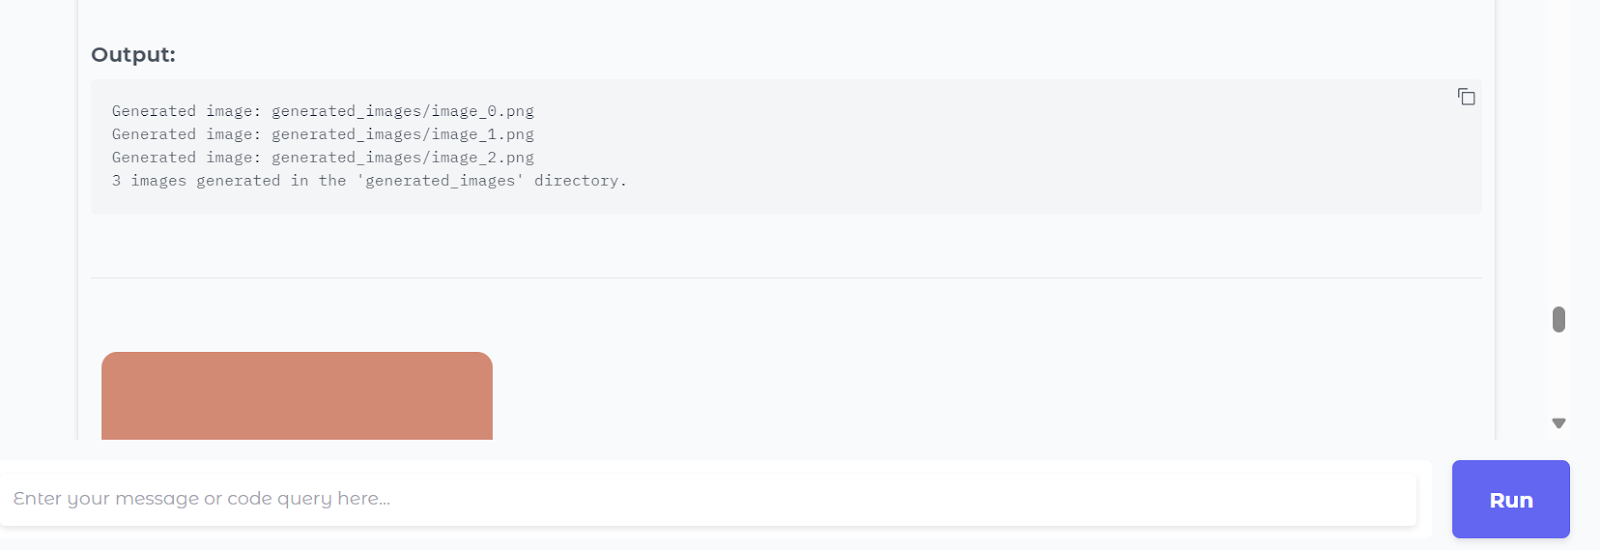
Die Codeausführung liefert am Ende außerdem eine kurze Schlussfolgerung.
Deployen wir die App in die Cloud – mit Hugging Face Spaces. Gehe zu Hugging Face Spaces und klicke auf „+ New Space“. Vergib Namen, Beschreibung und Lizenz und wähle als SDK Gradio aus.
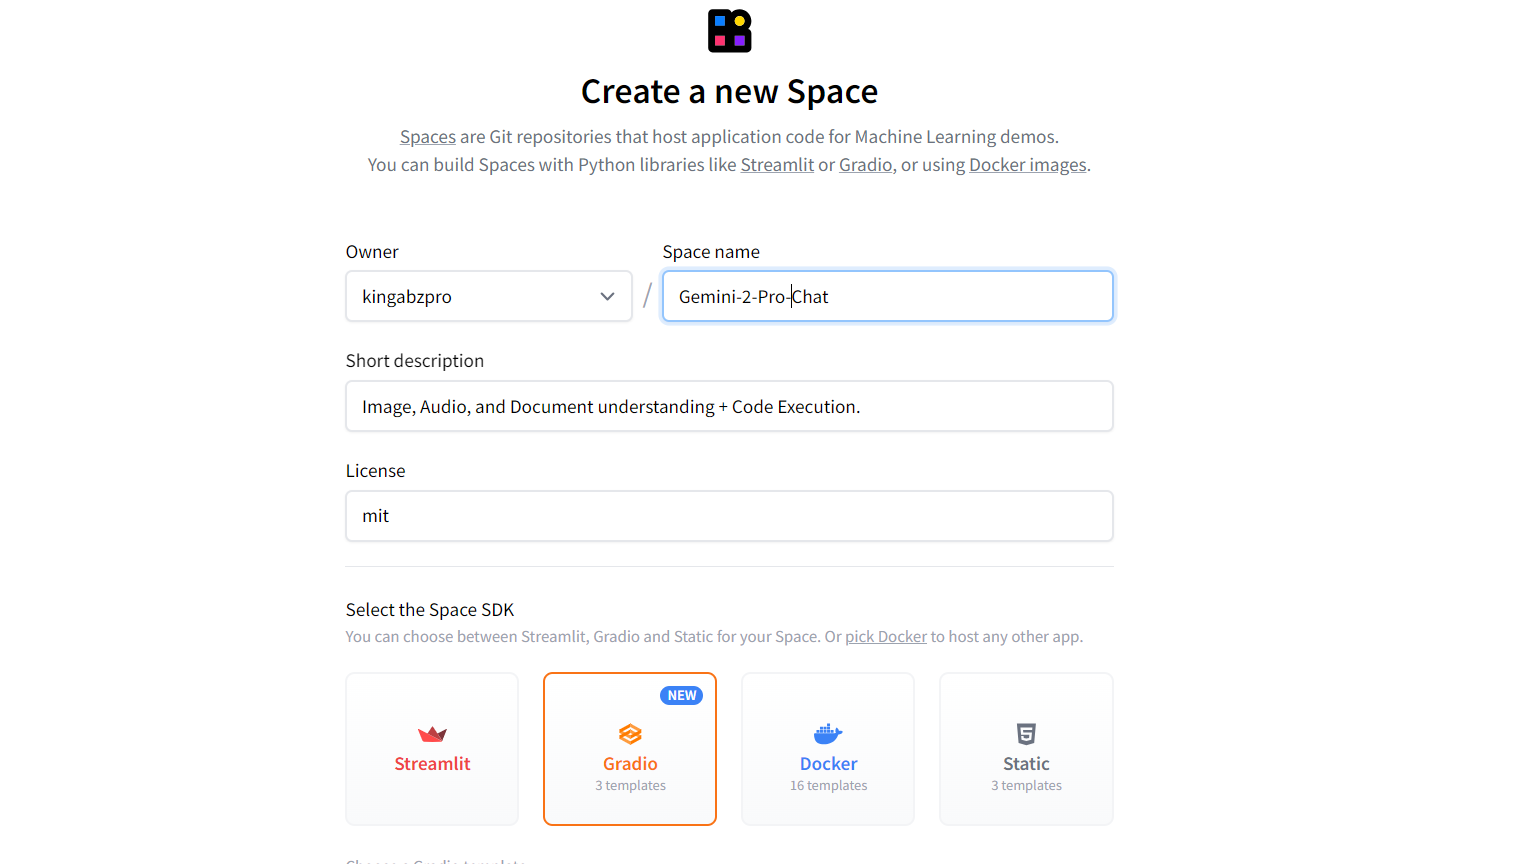
Quelle: Hugging Face
Nach dem Erstellen des Space erhältst du Anweisungen zum Klonen des Repositories:
git clone https://huggingface.co/spaces/kingabzpro/Gemini-2-Pro-Chat
cd Gemini-2-Pro-Chat
Erstelle im lokalen Repository eine Datei requirements.txt und füge folgende Python-Abhängigkeit hinzu:
google-genai==1.0.0Passe anschließend die README.md mit folgendem Inhalt an:
---
title: Gemini 2 Pro Chat
emoji: ♊💬
colorFrom: green
colorTo: pink
sdk: gradio
sdk_version: 5.15.0
app_file: app.py
pinned: false
license: mit
short_description: 'Image, Audio, and Document understanding + Code Execution. '
---
Füge dann die Datei app.py hinzu. Stage die Änderungen, committe sie und pushe sie ins Remote-Repository:
git add .
git commit -m "deploying the app"
git push
Nach dem Push siehst du, wie der Space das Docker-Image baut und die Abhängigkeiten installiert.
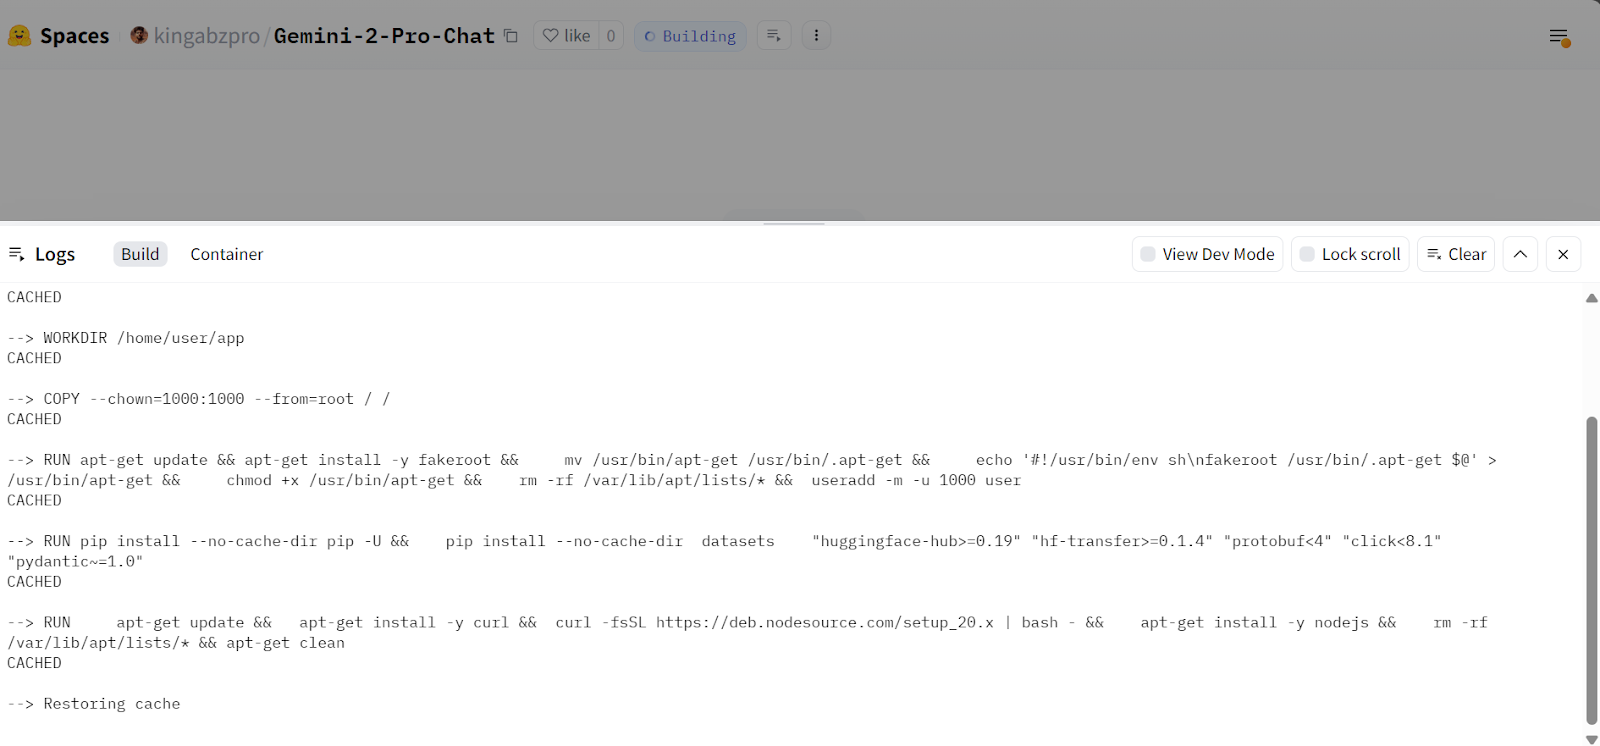
Quelle: Gemini 2 Pro Chat
Ist alles fertig, kann zunächst eine Fehlermeldung erscheinen. Kein Grund zur Sorge – es fehlen nur Umgebungsvariablen, die wir gleich in den Spaces hinterlegen.
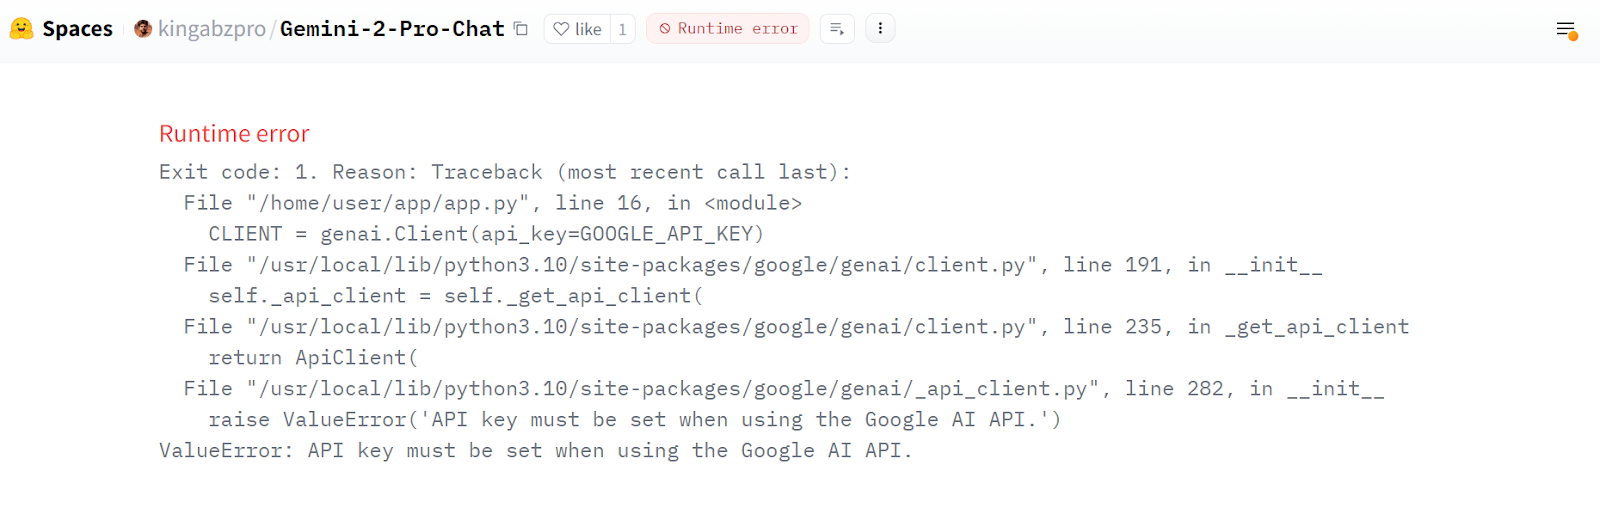
Quelle: Gemini 2 Pro Chat
Gehe in die Space-Einstellungen und scrolle zum Abschnitt „Variables and Secrets“. Klicke auf „New Secret“, vergib einen Namen und hinterlege deinen Gemini-API-Key.
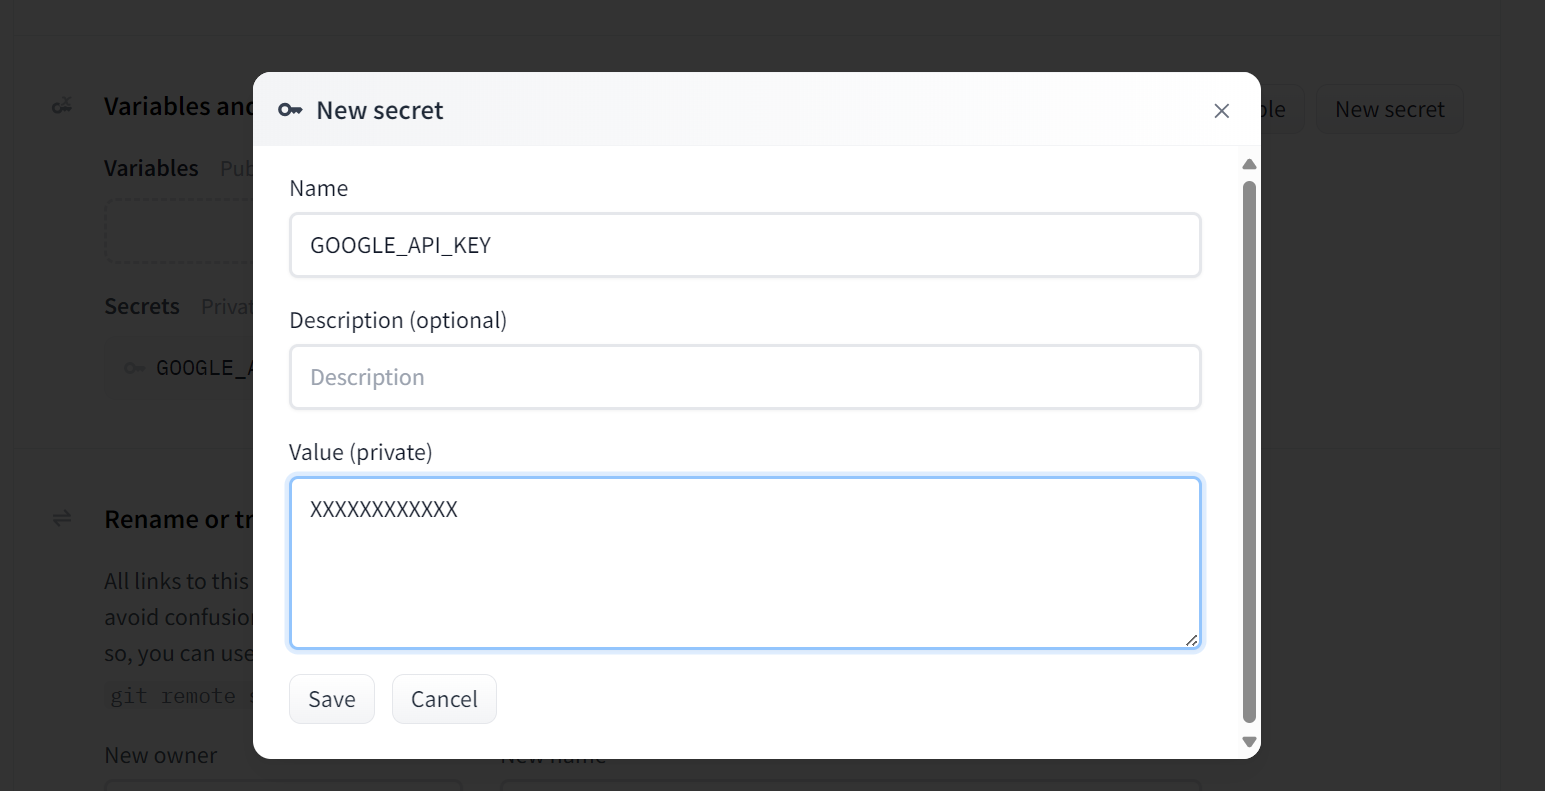
Quelle: Gemini 2 Pro Chat
Nachdem du das Secret hinzugefügt hast, startet der Space automatisch neu – und deine App läuft wie lokal.
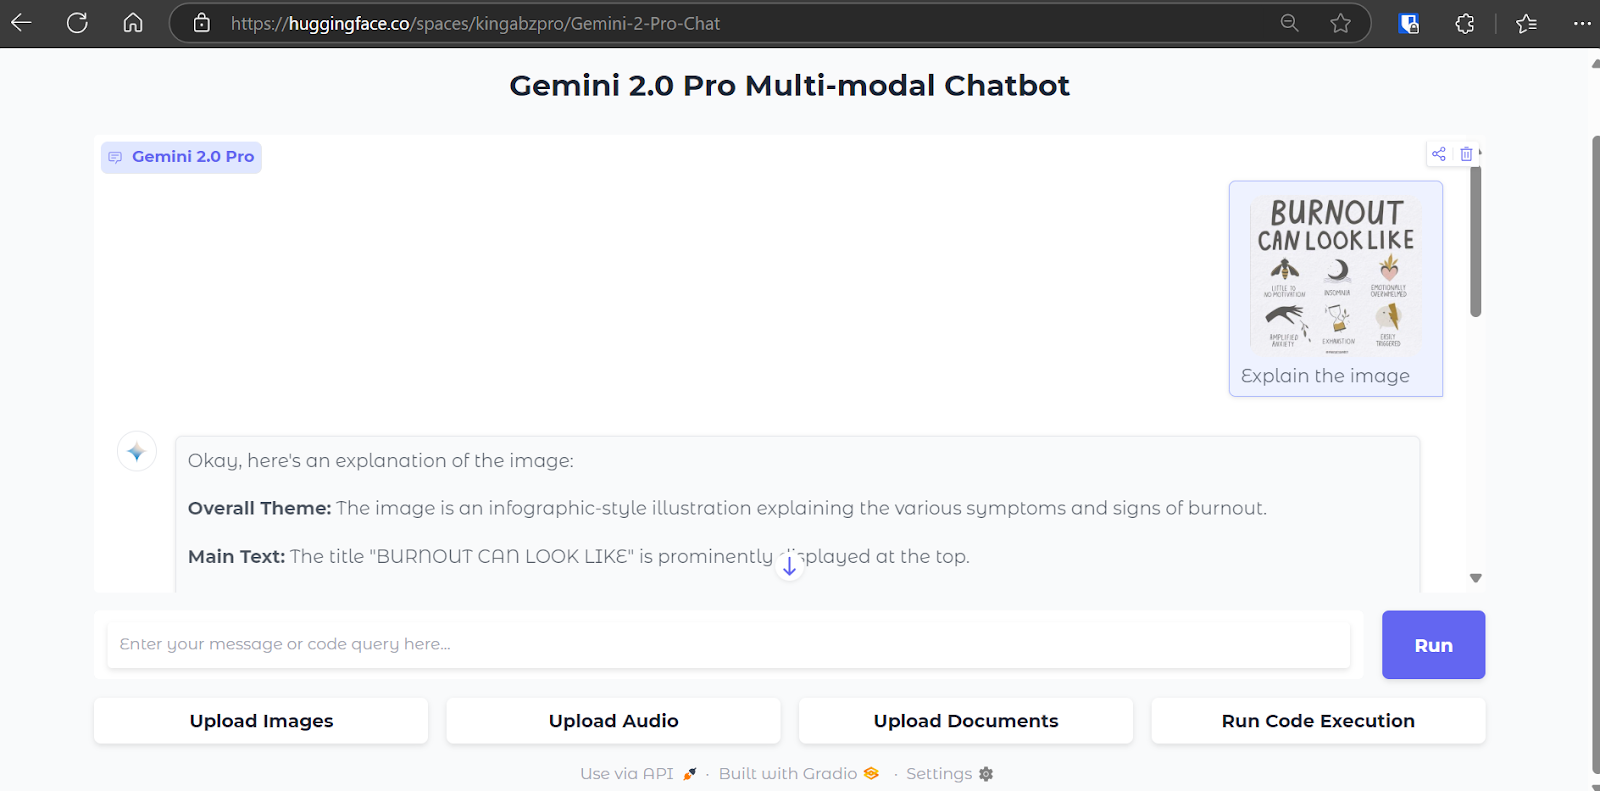
Quelle: Gemini 2 Pro Chat
Mit der neuen Gemini 2.0 Pro API und ihren fortgeschrittenen Features ist es deutlich einfacher geworden, performante KI-Anwendungen zu bauen. Statt viele Python-Pakete für Bilder, Audio oder Dokumente zu installieren, übergibst du die Inputs einfach an den API-Endpunkt. Das Modell liefert Ergebnisse in Sekunden – nahtlos und effizient.
Derzeit ist der Zugang zu Gemini 2.0 Pro kostenlos, aber auf 50 Anfragen pro Tag begrenzt. Wichtig: Die API ist nicht für kommerzielle Nutzung gedacht – sonst droht eine Sperrung des Kontos.
In diesem Tutorial haben wir das hochmoderne Gemini 2.0 Pro-Modell und seine Funktionen erkundet, sie in Jupyter Notebooks getestet, in eine Gradio-App integriert und anschließend in der Cloud bereitgestellt – öffentlich zugänglich für alle.
Wenn du mehr über das Erstellen KI-gestützter Anwendungen lernen willst, schau dir unseren Lernpfad Developing AI Applications an – dort lernst du die neuesten Tools für KI-Entwickler kennen.
Top DataCamp Courses
Lernpfad
Kurs
Lernpfad