Kurs
Google Sheets: Fortgeschrittene Funktionen
4 Std.
57.7K
Im maschinellen Lernen, Deep Learning und in der Data Science werden Daten meist in JSON- oder CSV-Dateien gespeichert. Hier konzentrieren wir uns auf CSV und erstellen damit einen Datensatz. CSV steht für Comma Separated Values. Dabei werden Datenbankfelder in ein Format exportiert, in dem jede Zeile einen Datensatz enthält und die einzelnen Felder durch Kommata getrennt sind. Dateien mit der Endung .csv ähneln einfachen Textdateien. So können auch Personen, die nicht dieselbe Datenbanksoftware verwenden, Datendateien miteinander austauschen.
Für dieses Tutorial brauchst du Folgendes:
1->Microsoft Excel
2->Ein paar Bilder
3->Notepad++(Ich empfehle es, weil es leicht zu bedienen ist. Du kannst aber auch WordPad, Notepad oder einen anderen Texteditor verwenden.)
Dann legen wir los.
Installiere jetzt "Notepad++". Besuche dazu diesen Link: https://notepad-plus-plus.org/download/v7.5.6.html und installiere die Version, die zu deinem Gerät passt.
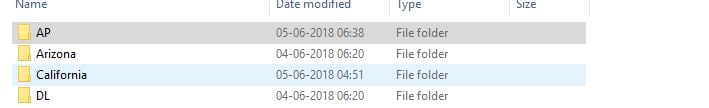
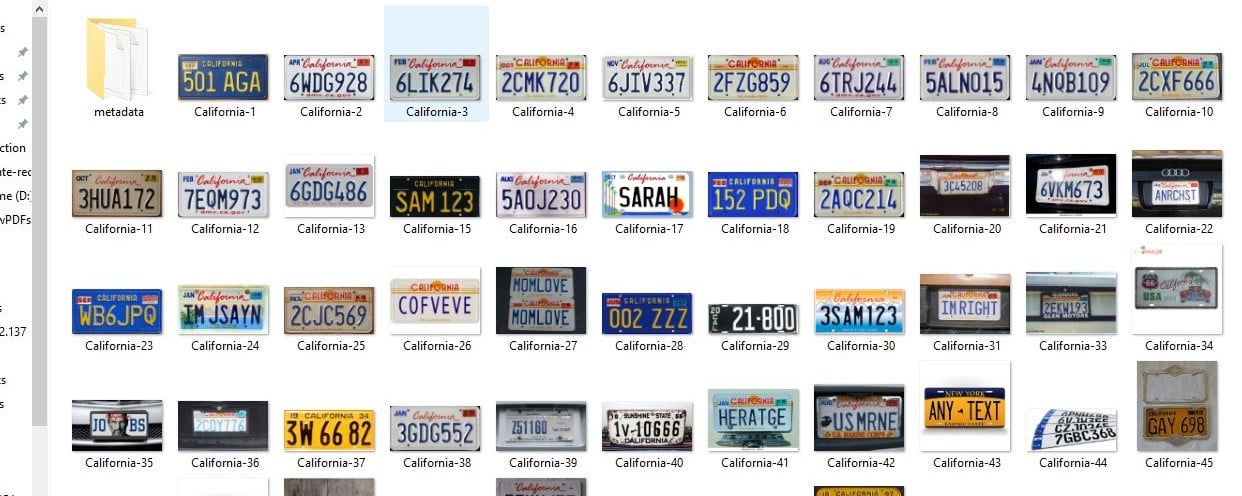
Erstelle einen neuen Ordner (ich habe ihn dataset genannt), lege darin ein paar Unterordner an und fülle sie mit Bildern. Ich habe zum Beispiel Kfz-Kennzeichen aus verschiedenen Teilen der Welt heruntergeladen und in separaten Ordnern abgelegt.
Öffne das Terminal bzw. die Eingabeaufforderung im aktuellen Verzeichnis, also im Ordner dataset, und führe die folgenden Befehle aus. Zuerst die Befehle für Windows:
Befehl, um eine Liste aller Ordner und Dateien im Verzeichnis zu erhalten: -- dir /b/s
Befehl, um Dateinamen auszulesen und in einer Textdatei zu speichern: -- dir /b/s/w *.jpg > "filename.txt"
Für Linux (Ubuntu):
Befehl, um eine Liste aller Ordner und Dateien im Verzeichnis zu erhalten: -- ls -LR
Befehl, um Dateinamen auszulesen und in einer Textdatei zu speichern: -- ls -LR *.jpg > files.txt
Für Mac OSX: macOS ist POSIX-konform und enthält die üblichen Unix-Kommandozeilentools.
Befehl, um eine Liste aller Ordner und Dateien im Verzeichnis zu erhalten: -- ls /b/s
Befehl, um Dateinamen auszulesen und in einer Textdatei zu speichern: -- ls /b/s/w*.jpg > filename.txt
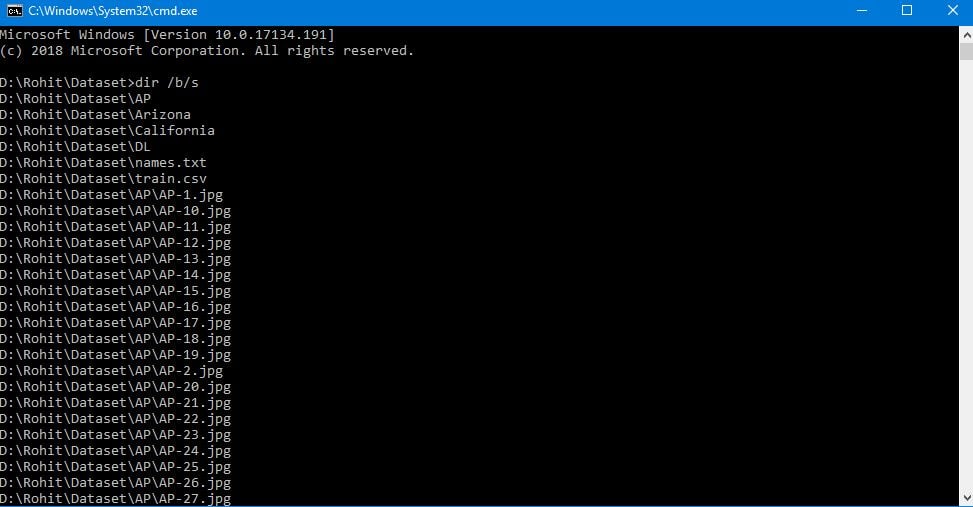
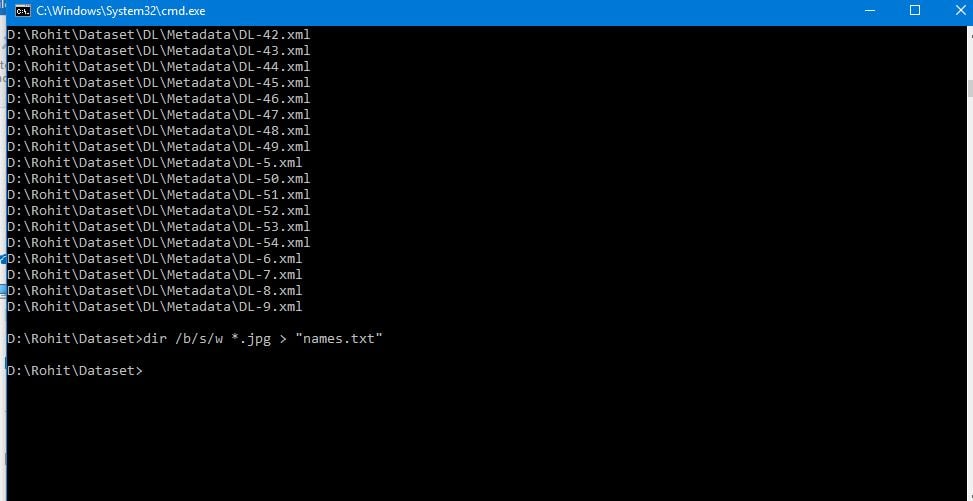
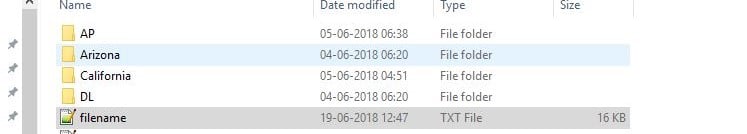
Die Datei habe ich "filename" genannt. Du kannst jeden beliebigen Namen wie "names.txt" verwenden. Sie wird im Verzeichnis gespeichert, in dem du die Eingabeaufforderung genutzt hast. (Ich wollte nur Bilder mit der Endung .JPG, daher habe ich *.jpg verwendet. Du kannst je nach Bildtyp auch .jpeg, .png oder andere Erweiterungen verwenden.)
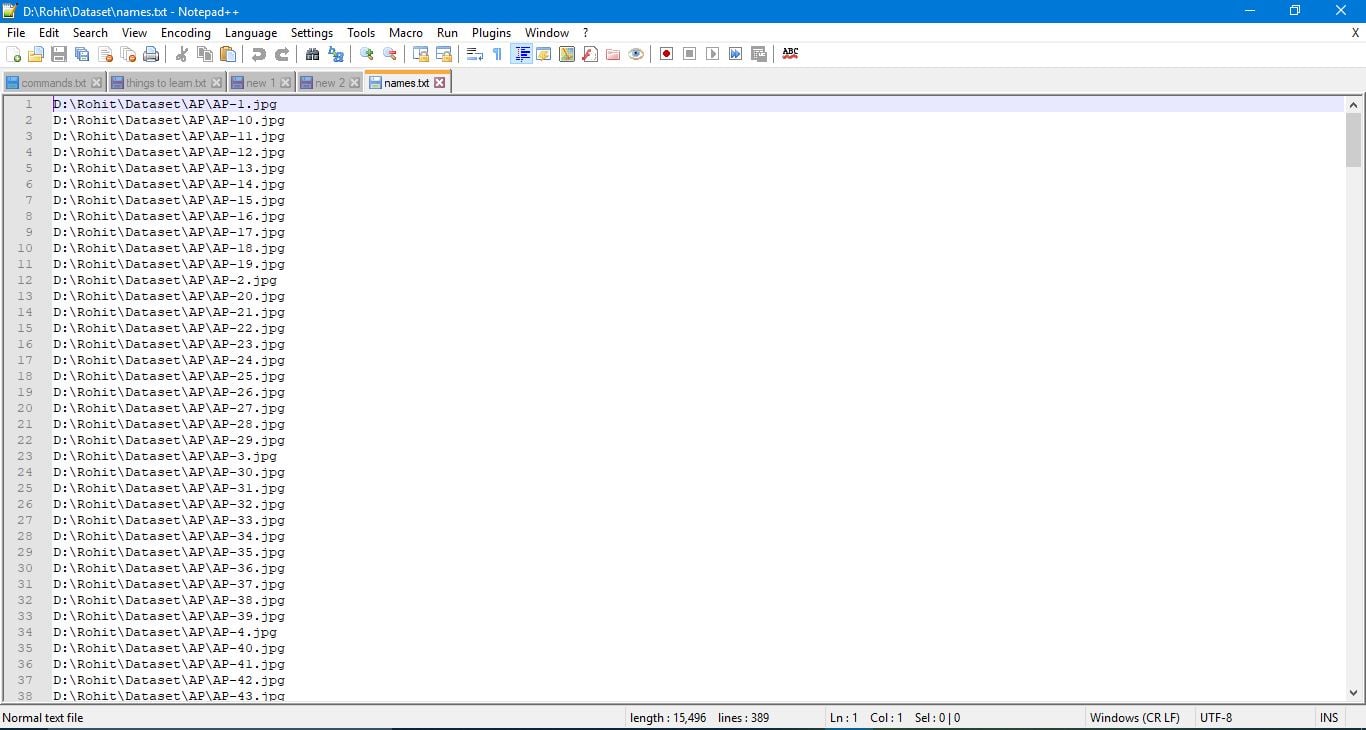
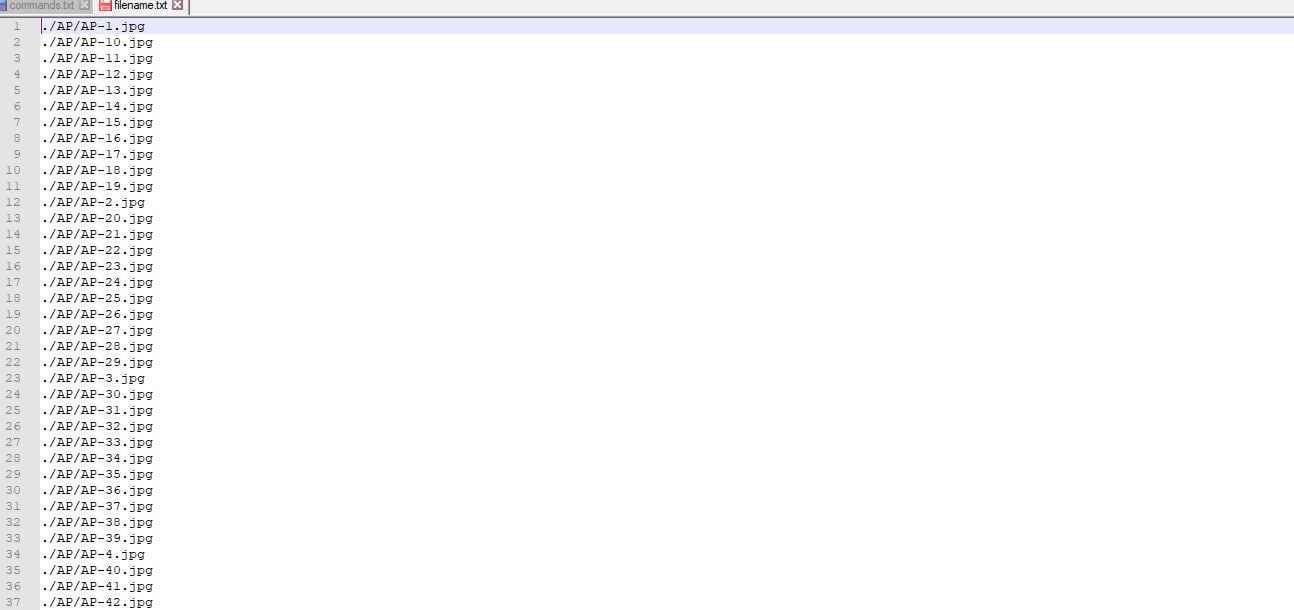
Drücke jetzt Strg+F und entferne die Details des Hauptverzeichnisses. Damit Excel die Bilder korrekt einliest, müssen die Pfade mit "./" beginnen und nur Unterverzeichnisse sowie Dateinamen enthalten. Ersetze daher den ersten Backslash \ durch ./ und den zweiten durch /.
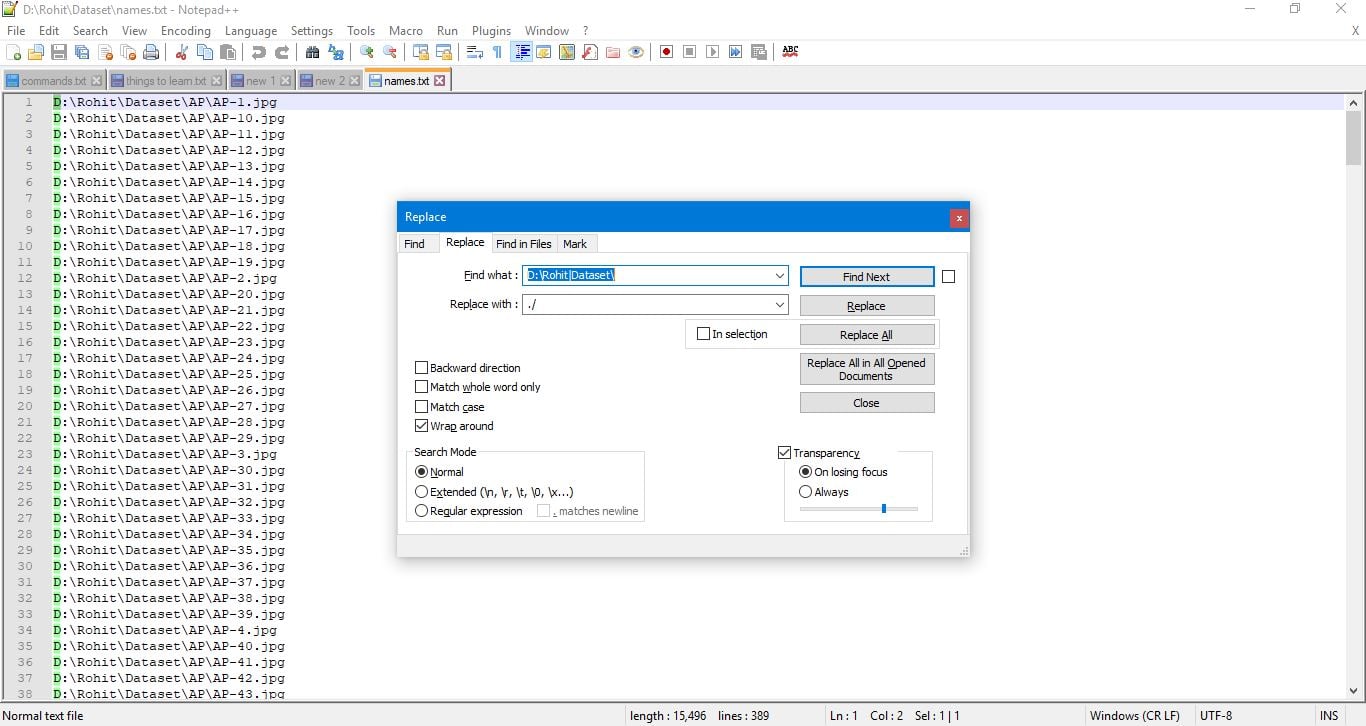
Speichere die Textdatei nach den Änderungen.
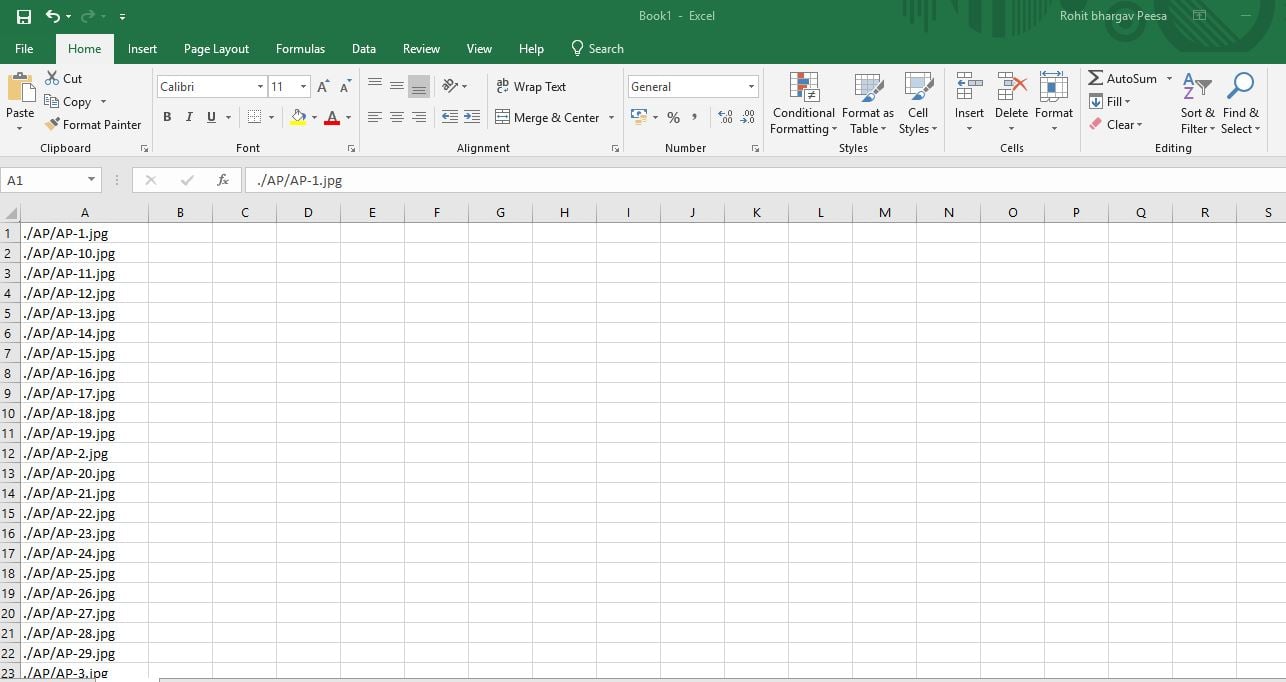
Öffne nun Microsoft Excel, kopiere alle Namen aus der Textdatei und füge sie in ein Tabellenblatt ein.
Wenn du die Bilder labeln möchtest, erstelle eine weitere Spalte namens "label" und fülle sie je nach gewünschter Kennzeichnung. Hier habe ich sie nach Ländern gelabelt.
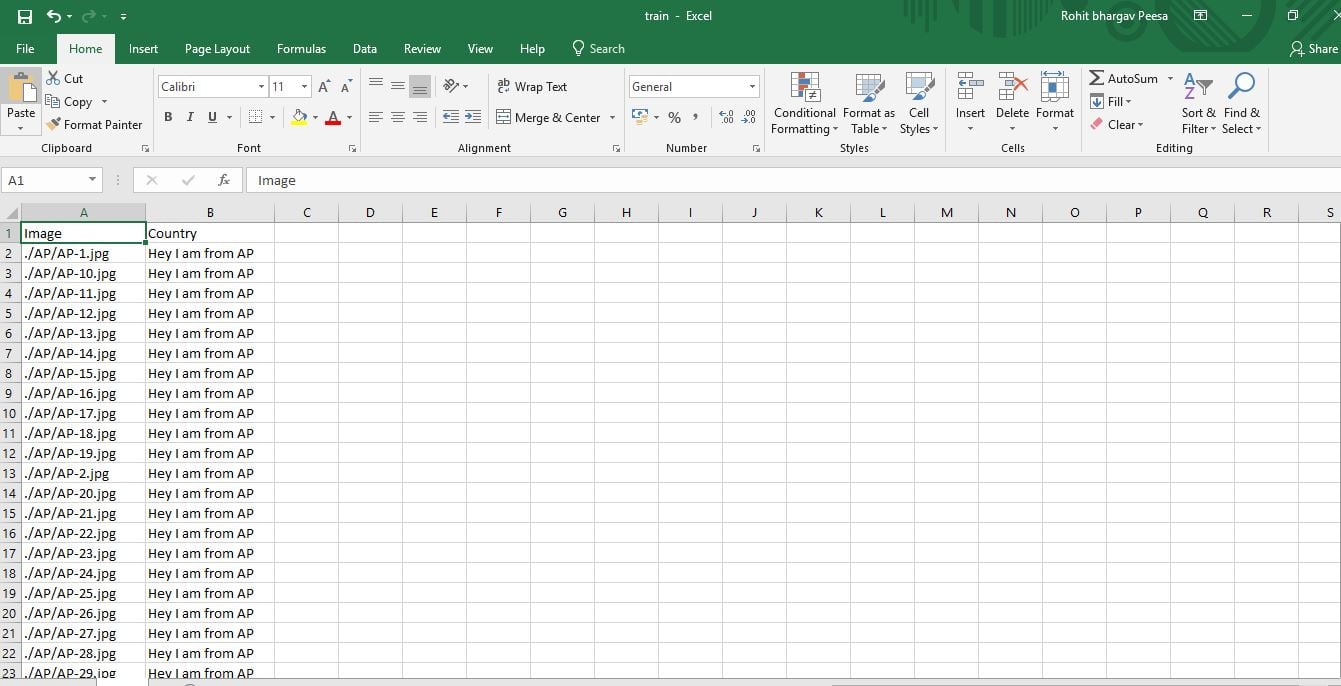
Speichere die Datei nun mit der Erweiterung CSV (durch Trennzeichen getrennt) im Ordner (dataset), der die Bildordner enthält.
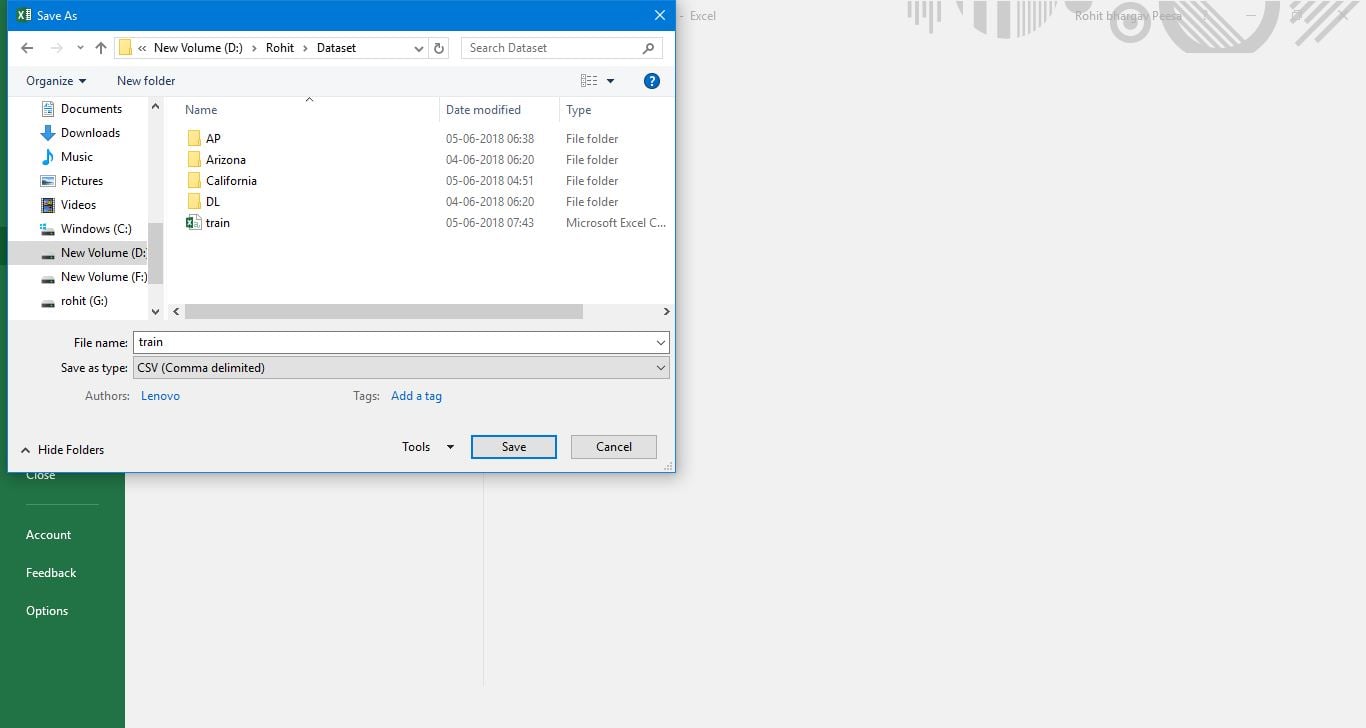
Lösche anschließend die Textdatei aus dem Ordner und komprimiere den Ordner dataset als ZIP-Datei.
Du hast erfolgreich einen Datensatz im CSV-Format erstellt.
Dieses Tutorial ist eine kurze Anleitung, wie du aus Bildern Datensätze im CSV-Format für Data-Science-Projekte erstellst. Ich hoffe, es hilft dir, wenn du deinen nächsten Datensatz zusammenstellst. Glückwunsch, du hast das Tutorial abgeschlossen! Wenn du Fragen oder Anmerkungen hast, schreib sie gern in die Kommentare.
Mehr über Tabellenkalkulationen
Kurs
Kurs