
Kurs
Transformer-Modelle mit PyTorch
2 Std.
9K
Transformer sind heute die Basis im Natural Language Processing und erobern zunehmend auch das Computer Vision. Vision Transformer (ViTs) übertragen die Prinzipien textbasierter Modelle auf Bilder – etwa von Large Language Models.
2020 stellte Google Research im Paper „An Image is Worth 16×16 Words“ erstmals ViTs vor und zeigte: Auf großen Bilddatensätzen trainierte Transformer erreichen die Leistung klassischer CNNs oder übertreffen sie. Seither haben praxisnahe Varianten wie DeiT und Swin ihren Einsatz auf viele Vision-Aufgaben ausgeweitet.
In diesem Tutorial führe ich dich durch die Kernkonzepte, Architekturbausteine und praktischen Anwendungen von Vision Transformers (der „Vanilla“/Original-Variante). Am Ende verstehst du nicht nur, wie ViTs funktionieren, sondern auch, wie du sie in eigenen Computer-Vision-Projekten umsetzt. Lies dazu gern auch meinen Leitfaden zu Multi-Head Attention.
Starten wir mit einer sanften Einführung in Vision Transformer.
Diese Modelle behandeln ein Bild als Sequenz – so wie ein Sprachmodell Wörter in einem Satz verarbeitet. Das Bild wird dazu in Patches fester Größe zerlegt, die jeweils flachgerollt und in Vektoren eingebettet werden.
Diese Vektoren laufen dann durch einen Standard-Transformer-Encoder, der mithilfe des Attention-Mechanismus globale Beziehungen zwischen Patches modelliert.
Das unterscheidet sich grundlegend von Convolutional Neural Networks (CNNs), die lokale Merkmale fokussieren und auf hierarchische Merkmalsextraktion setzen.
Wenn wir schon über CNNs sprechen, lass uns die wichtigsten Unterschiede zu ViTs durchgehen:
|
Merkmal |
Convolutional Neural Networks (CNNs) |
Vision Transformer (ViTs) |
|
Architektur |
Verwendet Convolution- und Pooling-Layer |
Verwendet Transformer-Encoder mit Self-Attention |
|
Rezeptives Feld |
Lokal, wächst mit der Tiefe |
Von Beginn an global |
|
Positionswissen |
Implizit durch die Struktur |
Explizit durch Positionsencodings |
|
Datenbedarf |
Auch mit kleineren Datensätzen effektiv |
Braucht großskalige Datensätze |
|
Induktiver Bias |
Stark |
Gering, dafür flexibler |
|
Parallelisierung |
Mittel |
Sehr hoch |
|
Modellskalierung |
Weniger gut auf sehr große Modelle skalierbar |
Hervorragend skalierbar |
|
Interpretierbarkeit |
Über Pooling-Layer, dennoch schwierig |
Per Attention-Visualisierung verbesserbar, ebenfalls anspruchsvoll |
Wir sind noch nicht in die volle Tiefe eingestiegen, aber es lohnt sich, einige Punkte vorab zu klären, die anfangs nicht intuitiv sind.
Zum Beispiel sind induktiver Bias und rezeptive Felder wichtige Begriffe, die du vielleicht noch nicht gehört hast.
Induktiver Bias bezeichnet die Annahmen, mit denen ein Modell aus Daten lernt. Das klingt abstrakt, wird aber mit dieser Analogie greifbar.
Stell dir vor, wir legen gemeinsam ein Puzzle. Wir gehen davon aus, dass Teile anhand von Form und Farbe zusammenpassen. Diese Annahme hilft uns, schneller zu lösen. So funktionieren CNNs.
Sie treffen smarte Vorannahmen: Nahe Bildbereiche hängen zusammen – wie benachbarte Puzzleteile oft zum selben Motiv gehören. Und eine Form bleibt dieselbe, auch wenn man sie verschiebt. Solche hilfreichen Vorannahmen heißen starker induktiver Bias.
Jetzt stell dir vor, wir bekommen nur einen großen Haufen Puzzleteile, kennen das Motiv nicht und wissen nicht, ob Form, Farbe oder etwas ganz anderes wichtig ist. Wir probieren aus und lernen allmählich, was funktioniert.
Genau das macht ein Transformer. Er startet mit wenig Annahmen, lernt Muster aus vielen Daten. Das nennt man minimalen induktiven Bias. Das gibt mehr Freiheit, braucht aber mehr Daten und Zeit.
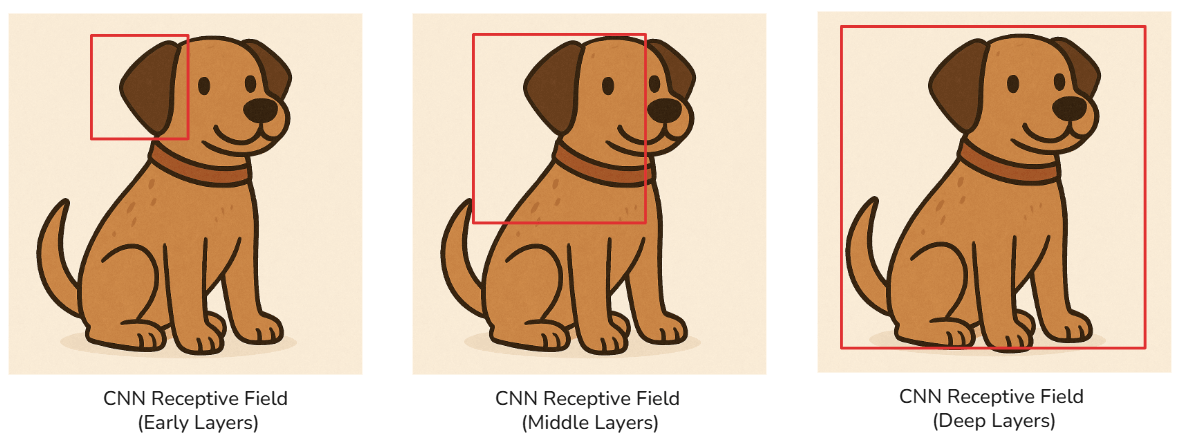
Das obige Bild zeigt, wie sich das rezeptive Feld eines CNN ändert. Ein CNN hat mehrere Convolutional Layer. Je tiefer wir gehen, desto größer wird der Eingabebereich, der jede Neuroneinheit beeinflusst.
Dieses wachsende rezeptive Feld erlaubt tieferen Schichten, komplexere und globalere Merkmale zu erkennen (vom Ohr über das Gesicht bis zum ganzen Hund).
Das unterscheidet sich deutlich vom rezeptiven Feld eines Vision Transformers:
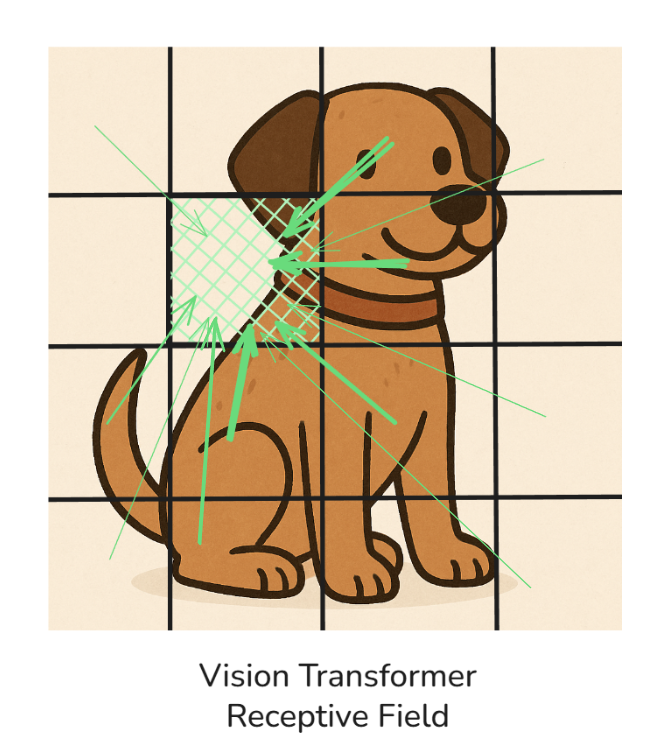
In der Illustration siehst du: Im (Vanilla-)ViT ist das rezeptive Feld global – alle Patches achten in unterschiedlicher Stärke aufeinander (dargestellt durch die Pfeildicke).
Der Übersicht halber zeige ich, dass der grüne Patch von den anderen Patches beachtet wird. In Wirklichkeit achten aber alle Patches wechselseitig aufeinander (zu unübersichtlich zum Zeichnen!).
Zu wissen, wann man ein CNN oder einen Vision Transformer einsetzt, ist entscheidend für kluge Architekturentscheidungen im Computer-Vision-Workflow.
Beide Ansätze haben Stärken und Schwächen und spielen je nach Datengröße, Rechenbudget und der Komplexität der zu modellierenden Muster ihre Stärken aus.
An diesen Punkten orientiere ich mich bei der Wahl:
Nutze CNNs, wenn:
Nutze Vision Transformer, wenn:
Kurz gesagt: In einem Low-Resource-Setting oder wenn du schnelle, verlässliche Ergebnisse mit wenig Daten brauchst, sind CNNs die sichere und effiziente Wahl.
Braucht dein Projekt dagegen tiefes globales Verständnis über den gesamten Bildraum und du hast die nötige Rechenpower, sind Vision Transformer die bessere Option.
Schauen wir uns nun die Architektur des Vision Transformers an. Es gibt fünf Stufen – gehen wir sie der Reihe nach durch.
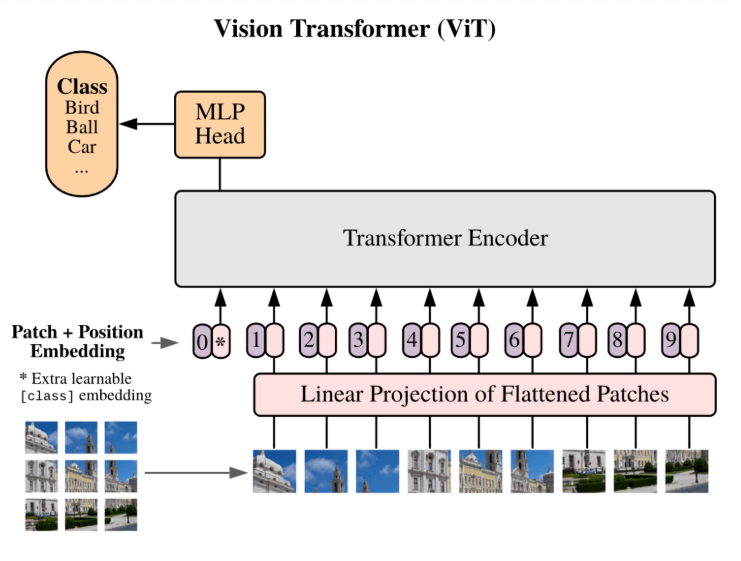
Zuerst müssen wir das Bild in eine Form bringen, die der Transformer versteht.
Angenommen, wir haben ein 224×224-Bild. Statt es komplett zu füttern, zerlegen wir es in gleich große Patches. Bei 16×16-Patches (wie im Originalpaper vorgeschlagen) entstehen 14×14 = 196 Patches (224/16 = 14).
Am einfachsten stellst du dir das wie ein Foto vor, das in perfekt gleich große Quadrate geschnitten wird. Jeder Patch enthält lokale Information und fungiert wie ein „Wort“ im Satz.
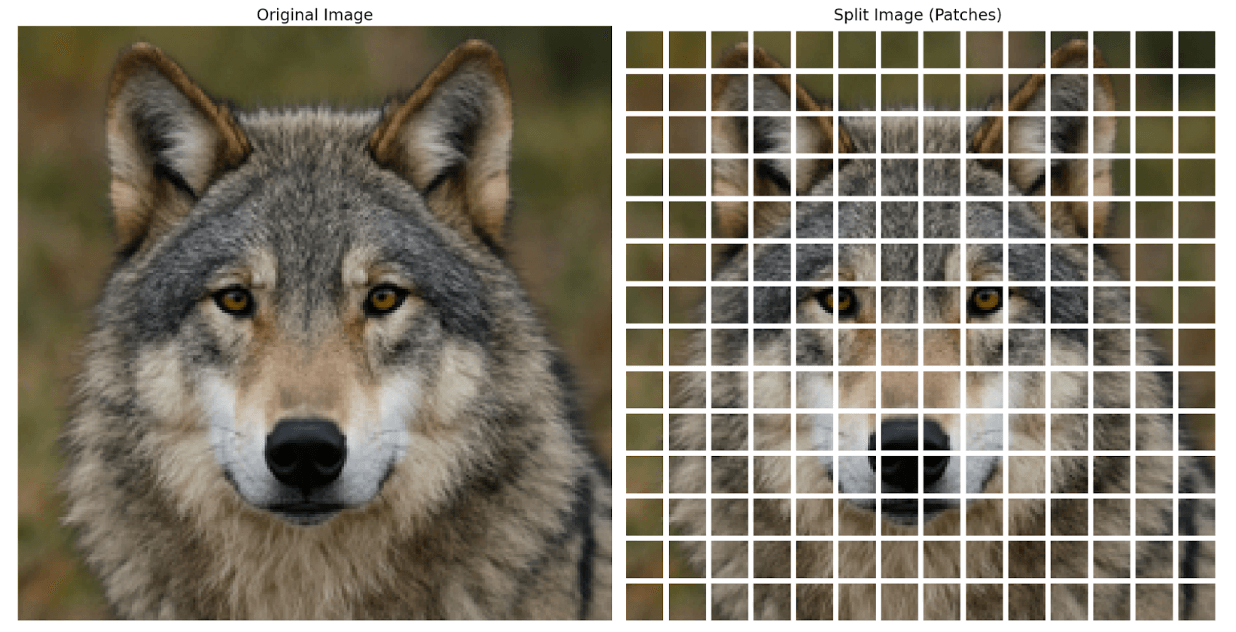
Oben siehst du, wie das Wolfsbild in gleich große Quadrate zerlegt wird – exakt 196 Stück.
Dabei stellt sich eine Frage:
„Das Bild ist RGB. Was passiert mit den 3 Farbkanälen?“
Wichtig: Jeder Patch ist ein Datenblock – hier mit der Form 16×16×3. 16×16 sind Höhe und Breite, 3 sind die Farbkanäle – also ein 3D-Tensor.
Damit repräsentiert jeder Patch kompakt sowohl räumliche als auch Farbinformationen aus einem lokalen Bildbereich.
Durch die Zerlegung in Patches wird die zweidimensionale Struktur des Bildes in eine eindimensionale Sequenz von mehrdimensionalen Daten transformiert – geeignet für Transformer.
Als Nächstes wandeln wir jeden Patch in eine numerische Darstellung um, die der Transformer nutzen kann.
Jeder 16×16-RGB-Patch wird flachgerollt zu einem Vektor. In unserem Beispiel sind 16×16×3 = 768 Werte. Wir „entrollen“ also alle Pixel- und Farbinformationen zu einer Zahlenzeile.
Diese Rohvektoren sind informativ, aber noch nicht optimal fürs Lernen. Daher schicken wir jeden durch eine trainierbare lineare Projektion. Denk daran wie an eine Dense-Layer, die den 768-dimensionalen Input in einen Embedding-Raum der Größe D abbildet (oft auch 768, aber nicht zwingend).
Warum?
Diese Projektion bringt alle Patch-Tokens in ein konsistentes, lernbares Format, das der Transformer-Encoder erwartet. Bis hierhin haben wir eine Sequenz gleichlanger Vektoren, wobei jeder Vektor einen Bild-Patch repräsentiert.
So verwandeln wir räumlich und farblich reiche Patches in eine einheitliche Sequenz aus „Tokens“ (analog zu Wort-Embeddings im NLP), sodass der Transformer das Bild als strukturierte Folge lernbarer Einheiten behandeln kann.
Bevor die Tokens in den Encoder gehen, fehlt noch etwas. Wenn du LLMs kennst, ahnst du es schon!
Transformer sind von Haus aus positionsagnostisch.
Sie sehen eine Eingabesequenz als ungeordnete Menge – ohne Mechanismus, Reihenfolge oder Position zu verstehen. In der Bildanalyse ist das problematisch, denn räumliche Struktur und Layout sind entscheidend!
Im Kontext von Bildern repräsentiert jeder Patch einen bestimmten Bildbereich. Ohne Positionshinweis wüsste das Modell nicht, ob ein Patch aus der linken oberen oder rechten unteren Ecke stammt.
Diese fehlende räumliche Orientierung würde das Verständnis von Mustern, Formen und Strukturen stark einschränken.
Die Lösung: Wir addieren zu jedem Patch-Embedding ein Positionsencoding. Dieser Vektor ist wie ein räumliches Etikett und kodiert die ursprüngliche Position des Patches im Bild. Er wird direkt zum Patch-Embedding addiert, bevor die Sequenz in den Transformer geht.
Es gibt zwei gängige Varianten:
Denk an Positionsencodings wie GPS-Koordinaten für Patches.
Sie sagen dem Transformer, woher das Token stammt. So kann Self-Attention sowohl den Inhalt eines Patches als auch seine relative oder absolute Position im Bild modellieren.
Ohne diesen Schritt könnte ein Vision Transformer die Bildstruktur nicht rekonstruieren – so stark der Attention-Mechanismus auch ist.
Jetzt beginnt das Deep Learning im eigentlichen Sinn – Mustererkennung, Kontextmodellierung, Featurefusion.
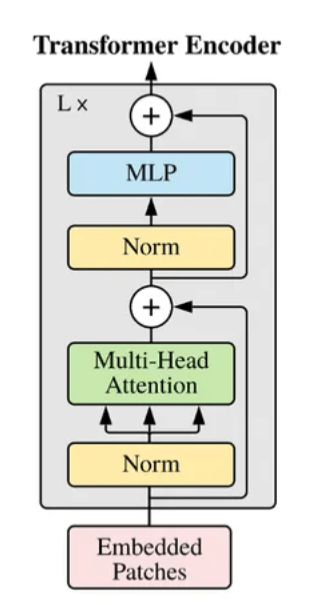
Mehrere dieser Encoder-Blöcke werden gestapelt und bilden den vollständigen ViT-Encoder. Das steckt in einem Encoder-Block:
Diese Encoder-Blöcke werden in Schichten gestapelt (z. B. 12 bei ViT-Base) und lernen mit jeder Schicht tiefere Bildrepräsentationen.
Fast geschafft! Kommen wir zur letzten Stufe des (Vanilla-)ViT.
Nach allen Encoder-Schichten brauchen wir eine Zusammenfassung, um eine Vorhersage zu treffen.
Dafür fügen wir am Anfang der Patch-Sequenz ein spezielles [CLS]-Token ein. Dieses lernbare Embedding interagiert beim Encoding mit allen anderen Tokens.
Während es die Transformer-Schichten durchläuft, sammelt es globale Information. Am Ende extrahieren wir dieses Token und schicken es durch einen Multilayer-Perceptron (MLP)-Head, in der Regel ein paar Dense-Layer plus Softmax (für Klassifikation).
Dieser letzte Schritt liefert das vorhergesagte Label, etwa „dies ist ein Hund“, basierend auf den Informationen, die das [CLS]-Token gesammelt hat. Wichtig: Nur das [CLS]-Token geht in diesen finalen MLP-Head und wird für die Klassifikation genutzt, nicht die übrigen Tokens!
Werfen wir einen Blick auf einige wegweisende ViT-Architekturen.
Oft trainieren wir keinen ViT von Grund auf. Schauen wir uns an, wie wir vortrainierte ViT-Modelle aus gängigen Deep-Learning-Bibliotheken einsetzen.
Am einfachsten nutzt du ViTs über die Hugging Face Transformers Library. Sie liefert vortrainierte ViT-Modelle, die du mit wenigen Zeilen Code verwenden kannst.
Hier ist Beispielcode, um das originale ViT-Base-Modell herunterzuladen und zu verwenden:
# Imports neededfrom transformers import ViTImageProcessor, ViTForImageClassificationfrom PIL import Imageimport torchimport requests# Here I am loading and preprocessing an image - but you can use any image of your choiceimage = Image.open(requests.get(https://huggingface.co/datasets/huggingface/cats-image?image-viewer=ED6CB286C90CF5F1FAF278077DF091477DF05416', stream=True).raw)# Here, we load and process the ViT modelprocessor = ViTImageProcessor.from_pretrained('google/vit-base-patch16-224')model = ViTForImageClassification.from_pretrained('google/vit-base-patch16-224')# Preprocessing the image so it gets it into the necessary formatinputs = processor(images=image, return_tensors='pt')# Forward pass - with no backpropagationwith torch.no_grad(): outputs = model(**inputs)# Here we get the predicted labels (since we are performing classification)logits = outputs.logits predicted_class = logits.argmax(-1) # Selects the index of the class with the highest logit score (highest predicted probability)print(f("Predicted class index: {predicted_class.item()}"))Lass uns den Code kurz aufdröseln. Zunächst siehst du zwei getrennte Komponenten – sie gehören zusammen und ergänzen sich:
ViTImageProcessor – Verantwortlich für die Bildvorverarbeitung vor der Übergabe ans Modell: Resize, Normalisierung und das passende Format für den Vision Transformer. Du kannst ihn dir als Vision-Pendant zum Tokenizer im NLP vorstellen.ViTForImageClassification – Das eigentliche Modell für die Inferenz. Es erwartet Eingaben in einem bestimmten Tensorformat und liefert Vorhersagen (z. B. Logits oder Klassenwahrscheinlichkeiten).Vielleicht fragst du dich auch, was output.logits sind und was genau Logits bedeuten.
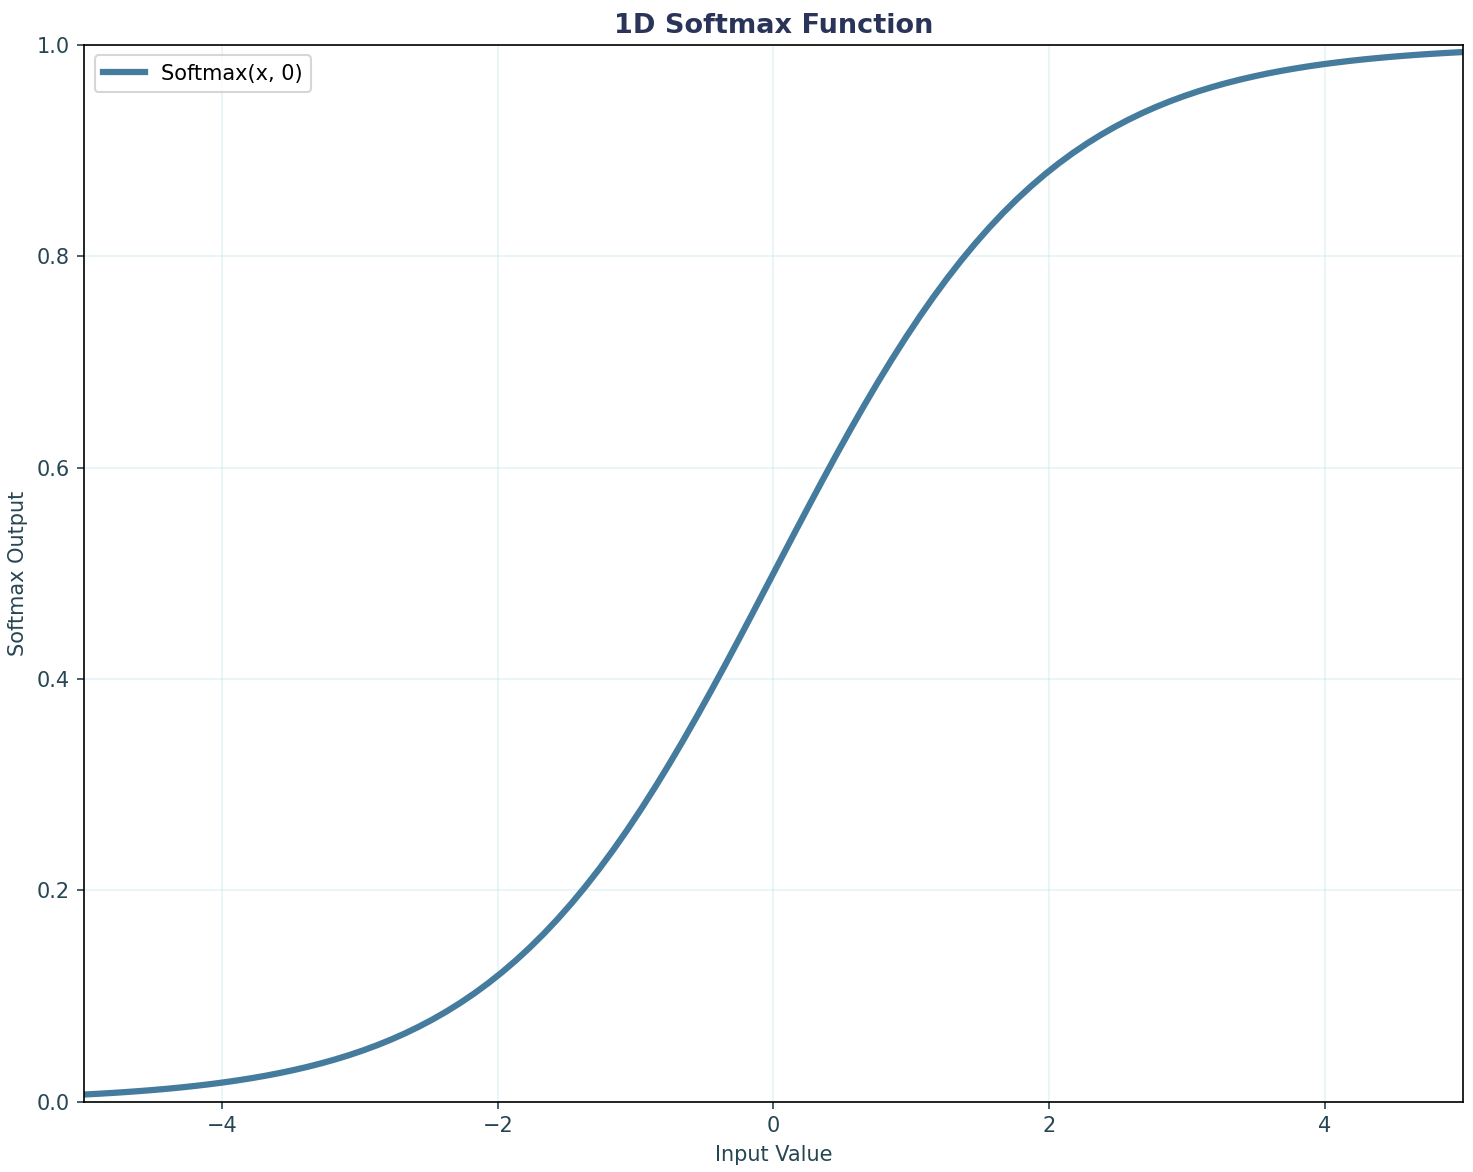
In Machine-Learning-Modellen – besonders bei Klassifikationsmodellen – sind Logits die rohen Ausgabewerte der letzten Schicht, bevor eine Aktivierungsfunktion wie Softmax angewendet wird. Sie sind unnormalisierte Scores pro Klasse.
Du kannst sie dir als interne „Zuversichtswerte“ des Modells pro Klasse vorstellen. Die Werte können positiv oder negativ sein und summieren sich nicht zu eins.
Um Logits in Wahrscheinlichkeiten umzuwandeln, wenden wir die Softmax-Funktion an, die die Werte zu einer Wahrscheinlichkeitsverteilung skaliert.
Wenn wir also argmax(logits, -1) verwenden, wählen wir schlicht den Index (die Klasse) mit dem höchsten Rohscore – meist identisch mit der höchsten Softmax-Wahrscheinlichkeit.
Eine weitere beliebte Bibliothek für Vision Transformer ist timm (von Ross Wightman). Sie bietet viele vortrainierte ViT-Varianten und eignet sich hervorragend für schnelle Experimente oder Fine-Tuning. So lädst du ein ViT-Modell für die Inferenz:
# Relevant importsimport timmimport torchfrom torchvision import transformsfrom PIL import Imageimport requests# Loading an imageurl = 'https://huggingface.co/datasets/huggingface/cats-image?image-viewer=ED6CB286C90CF5F1FAF278077DF091477DF05416'image = Image.open(requests.get(url, stream=True).raw)# Here we have defined the transformation we are going to do on the imagetransform = transforms.Compose([ transforms.Resize((224, 224)), transforms.ToTensor(), transforms.Normalize(mean=[0.5, 0.5, 0.5], std=[0.5, 0.5, 0.5])])image_tensor = transform(image).unsqueeze(0) # Adding batch dimension# Loading the ViT modelmodel = timm.create_model('vit_base_patch16_224', pretrained=True)model.eval() # Setting it to evaluation mode# Inference componentwith torch.no_grad(): outputs = model(image_tensor) predicted_class = outputs.argmax(dim=1) # Obtaining the class with the highest probabilityprint(f("Predicted class index: {predicted_class.item()}"))Du erkennst sicher die Parallelen zwischen timm und der transformers-Bibliothek. Beide liefern vortrainierte ViTs, unterstützen die Bildaufbereitung (bei timm per Standard-PyTorch-Code) und am Ende wählen wir die Klasse mit dem höchsten Logit.
Vision Transformer haben Computer Vision neu gedacht: Bilder werden in „Sätze“ aus Patches zerlegt, und Self-Attention erfasst ab der ersten Schicht globalen Kontext. In diesem Tutorial hast du gelernt:
Zum Weiterlernen empfehle ich dir diesen Artikel zu How Transformers Work, der die Theorie dahinter erklärt. Zur Vertiefung schau dir anschließend an, wie man einen Transformer from scratch baut.
Wenn du Theorie und Praxis kombiniert lernen willst, ist unser Kurs Transformer Models with PyTorch genau das Richtige.
Top-DataCamp-Kurse
Kurs
Lernpfad
Lernpfad