
कोर्स
Excel में Data Analysis
3 घंटा
154.5K
यदि आप ट्रेंड लाइनों के साथ काम करते हैं या यह मापना चाहते हैं कि दो मान-समूह कितने करीबी रूप से संबंधित हैं, तो Excel में RSQ() फ़ंक्शन एक सरल उपकरण है। RSQ() बताता है कि एक रेंज में भिन्नता का कितना हिस्सा दूसरी रेंज द्वारा समझाया जा सकता है। मूल रूप से, यह दो श्रृंखलाओं के लिए R-squared मान देता है। यह बिक्री विश्लेषण से लेकर वैज्ञानिक प्रयोगों तक हर जगह उपयोगी है।
RSQ(), जो “R-squared” का संक्षिप्त रूप है, दो arrays के बीच Pearson product-moment correlation coefficient का वर्ग वापस करता है, जो इस संदर्भ में coefficient of determination भी है। सरल शब्दों में, यह दिखाता है कि एक रेंज के मान दूसरी रेंज के मानों की कितनी अच्छी भविष्यवाणी करते हैं। यदि RSQ() का परिणाम 1 है, तो आपके पास एक परिपूर्ण रैखिक संबंध है। यदि यह 0 है, तो कोई रैखिक संबंध नहीं है।
लोग अक्सर RSQ() का उपयोग तब करते हैं जब वे देखना चाहते हैं कि कोई रेखा उनके डेटा पर कितनी अच्छी तरह फिट होती है—जैसे प्रतिगमन विश्लेषण में या ट्रेंडलाइन प्लॉट करते समय।
यह RSQ() की संरचना है:
=RSQ(known_y’s, known_x’s)known_y’s: ये आपके आश्रित मान हैं (जिन्हें आप भविष्यवाणी या समझाना चाहते हैं)।
known_x’s: ये आपके स्वतंत्र मान हैं (जिन्हें आप कारण/व्याख्यात्मक मानते हैं)।
दोनों रेंज में डेटा बिंदुओं की संख्या समान होनी चाहिए। यदि नहीं, तो RSQ() एक त्रुटि देगा।
एक महत्वपूर्ण नोट: यदि आप साधारण रैखिक प्रतिगमन और सामान्य रूप से ordinary least squares रैखिक प्रतिगमन से परिचित हैं, तो आप देखेंगे कि RSQ() केवल एक सेट x मानों का लेता है। ऐसा इसलिए है क्योंकि RSQ() बहुविध (multiple) रैखिक प्रतिगमन को हैंडल नहीं करता।
मान लीजिए आप जानना चाहते हैं कि विज्ञापन खर्च बिक्री की कितनी अच्छी भविष्यवाणी करता है।
मान लें कि आपका डेटा इस तरह दिखता है:
|
A |
B |
|
100 |
200 |
|
200 |
400 |
|
300 |
600 |
|
400 |
800 |
यदि आपका डेटा विज्ञापन के लिए A2:A5 में और बिक्री के लिए B2:B5 में है, तो आप यह दर्ज करेंगे:
=RSQ(A2:A5, B2:B5)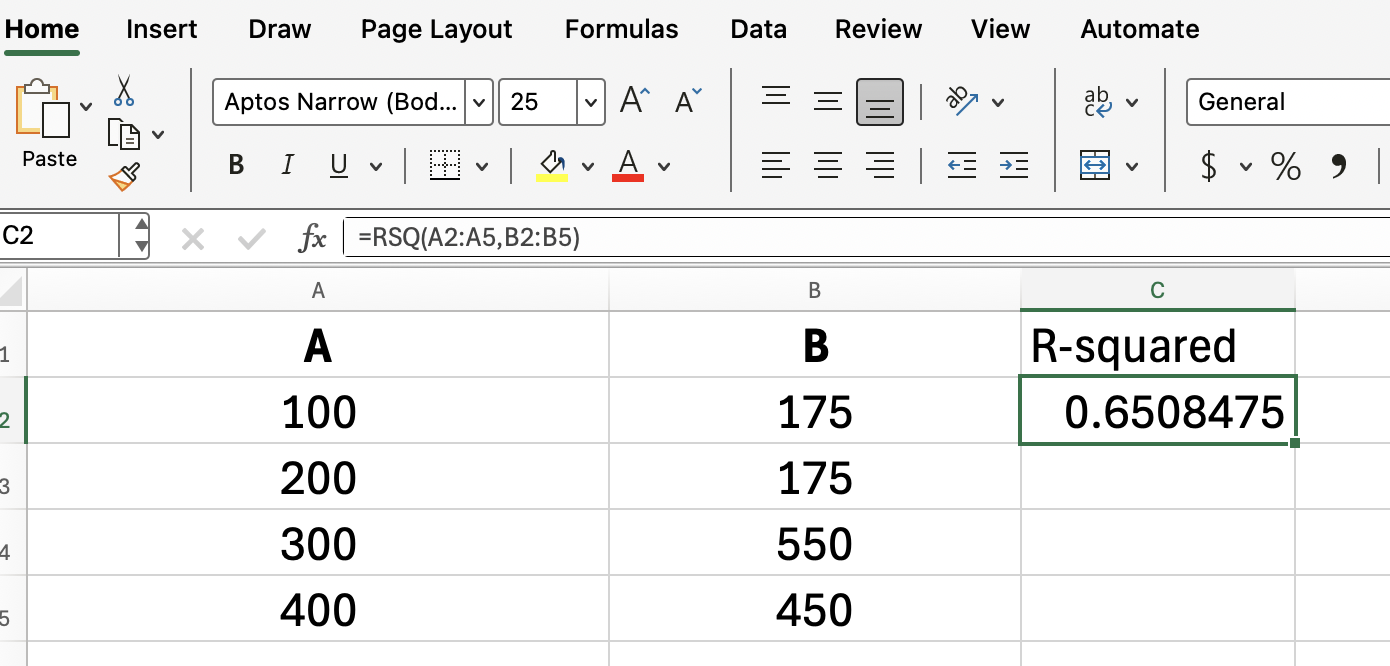
यह फ़ॉर्मूला R-squared मान लौटाएगा, जो दिखाता है कि विज्ञापन खर्च में बदलाव के कारण बिक्री में बदलाव का कितना हिस्सा समझाया जा सकता है।
यदि हम ऊपर के उदाहरण में कल्पना करें कि कॉलम B का हर संख्या, कॉलम A की संबंधित संख्या का दोगुना है, तो प्रतिगमन एक सीधी रेखा पर बैठेगा, और विज्ञापन दोगुना करने से बिक्री हमेशा दोगुनी होगी। (काश ऐसा हमेशा होता!)
यहाँ कुछ समस्याएँ हैं जो आप RSQ() के साथ झेल सकते हैं:
असमान रेंज आकार: यदि आपकी दोनों रेंज में पंक्तियों की संख्या समान नहीं है, तो RSQ() #N/A त्रुटि लौटाएगा।
खाली या गैर-संख्यात्मक कोशिकाएँ: रेंज के भीतर रिक्त कोशिकाएँ या पाठ नजरअंदाज़ कर दिए जाते हैं, पर यदि बहुत अधिक मान गायब हों, तो परिणाम भ्रामक हो सकते हैं या त्रुटियाँ आ सकती हैं। यह अधिक सूक्ष्म त्रुटि हो सकती है, इसलिए सावधानी रखें!
एकल डेटा बिंदु: RSQ() को कम से कम दो युग्म संख्याओं की आवश्यकता होती है। अन्यथा आपको #DIV/0! त्रुटि मिलेगी। ऐसा इसलिए है क्योंकि केवल एक मान के साथ variance/covariance परिभाषित नहीं होगा।
यदि कुछ गड़बड़ लगे, तो टाइपो या छूटे प्रविष्टियों के लिए अपनी रेंज दोबारा जाँचें।
आप सोच सकते हैं कि RSQ() के बजाय CORREL() क्यों उपयोग करें। अंतर यह है:
CORREL() Pearson सहसंबंध गुणांक (r) लौटाता है, जो रैखिक संबंध की दिशा और मज़बूती मापता है।
RSQ() R-squared (R²) लौटाता है, इसलिए यह हमेशा 0 और 1 के बीच का मान देता है और केवल समझाई गई वैरिएंस के अनुपात पर केंद्रित रहता है।
यदि आप केवल देखना चाहते हैं कि आपके चर साथ-साथ चलते हैं या नहीं (धनात्मक या ऋणात्मक), तो CORREL() अधिक विवरण देता है। यदि आप यह मापना चाहते हैं कि एक चर में बदलाव का कितना हिस्सा दूसरे द्वारा समझाया जाता है, तो RSQ() उपयुक्त है।
यह सब कहते हुए, क्योंकि हम साधारण रैखिक प्रतिगमन से जूझ रहे हैं, हम हमेशा CORREL() के परिणाम का वर्ग लेकर R-squared खोज सकते हैं:
=CORREL(A2:A5, B2:B5)^2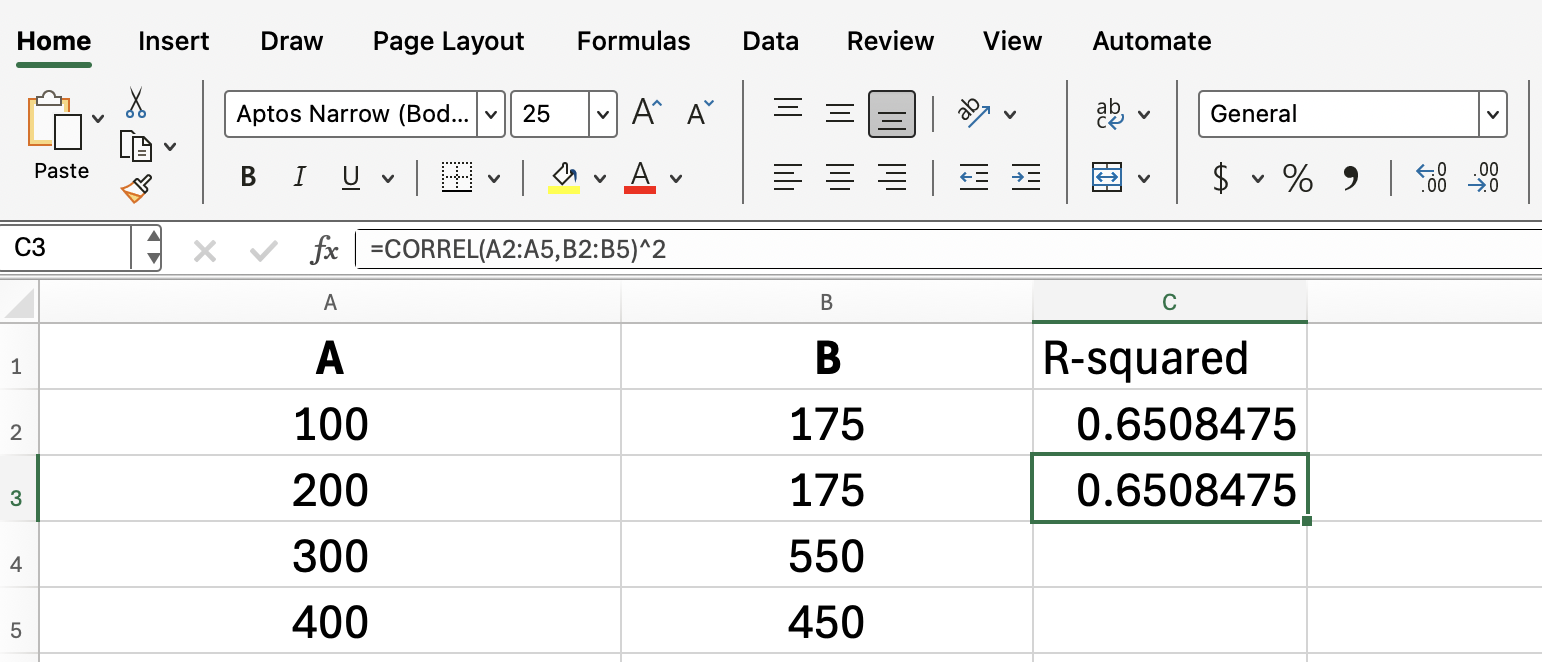
यदि आपने कभी Excel के किसी स्कैटर प्लॉट में ट्रेंडलाइन जोड़ी है, तो आपने चार्ट पर ही R-squared मान प्रदर्शित होते देखा होगा। वही मान RSQ() आपकी डेटा रेंज के साथ लौटाता है।
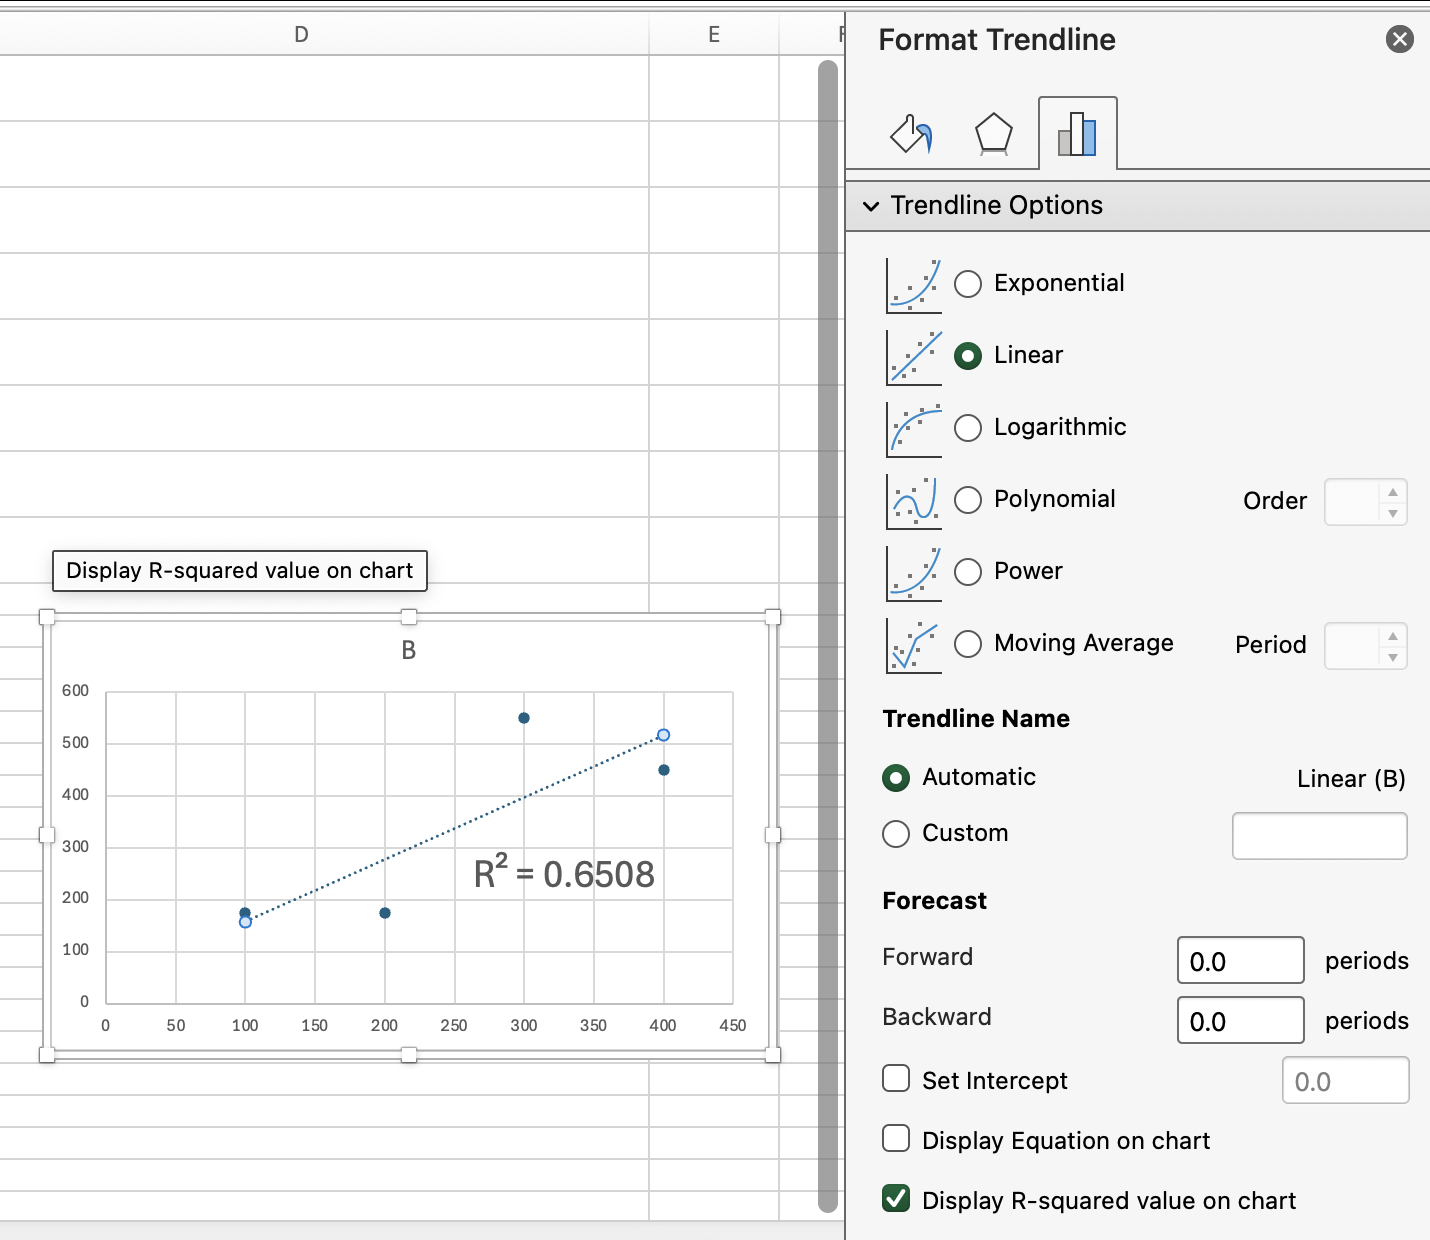
यदि आप बिना चार्ट जोड़े अपनी वर्कशीट पर R-squared दिखाना चाहते हैं, तो सीधे किसी सेल में RSQ() का उपयोग करें। इस तरह यह एक ऐसा संख्या बन जाता है जिसके साथ आप और आसानी से काम कर सकते हैं।
यदि आप Excel में प्रभावी विज़ुअल्स के साथ काम करने में पूरी तरह निपुण नहीं हैं, तो हमारे Data Visualization in Excel कोर्स में नामांकन करें, जो सभी महत्त्वपूर्ण बातों को विस्तार से कवर करता है।
तकनीकी मार्गदर्शन समेटते हुए, यहाँ कुछ व्यावहारिक सुझाव हैं:
अपने डेटा को स्पष्ट रूप से लेबल करें ताकि X और Y गड़बड़ न हों।
फ़ॉर्मूला दर्ज करने से पहले हमेशा जाँच लें कि आपकी रेंज एक ही आकार की हों।
यदि आप दो से अधिक चरों की तुलना करना चाहते हैं, तो Data Analysis Toolpak या LINEST() फ़ंक्शन जैसी प्रतिगमन विश्लेषण टूल्स का उपयोग करें। LINEST() अन्य मॉडल मेट्रिक्स भी देता है, जैसे F-statistic और standard errors।
जैसा कि आपने देखा, RSQ() Excel में यह मापने का एक सीधा, पर प्रभावी तरीका है कि एक मान-समूह दूसरे की कितनी अच्छी भविष्यवाणी करता है। आप इससे बहुत कुछ कर सकते हैं—जैसे रुझान विश्लेषण या पूर्वानुमान। अंदाज़े पर न छोड़ें।
अगले कदम के रूप में, हमारे Data Analysis in Excel और Advanced Excel Functions कोर्स करें और अपने Excel (और आँकड़ों) कौशल को अगले स्तर पर ले जाएँ!
DataCamp के साथ Excel सीखें
कोर्स
कोर्स
कोर्स