

प्राकृतिक उत्क्रांति से प्रेरित होकर, GA समाधान-स्थान की कुशलतापूर्वक पड़ताल करते हैं ताकि जटिल समस्याओं के लिए भी इष्टतम या लगभग-इष्टतम समाधान खोजे जा सकें। प्राकृतिक वरण की प्रक्रिया की नकल करके, GA समय के साथ समाधानों को विकसित कर सकते हैं और क्रमशः उनके प्रदर्शन में सुधार कर सकते हैं।
जेनेटिक एल्गोरिद्म की जैविक पृष्ठभूमि
जेनेटिक एल्गोरिद्म प्राकृतिक वरण और आनुवंशिकी की प्रक्रिया से प्रेरित हैं। वे इस बात की नकल करते हैं कि जीवधारी कैसे पीढ़ियों के साथ विकसित होकर अपने वातावरण में अनुकूलित और जीवित रहते हैं। GA के पीछे के बुनियादी जैविक सिद्धांतों को समझना हमें यह समझने में मदद करता है कि ये एल्गोरिद्म कैसे काम करते हैं और हम उन्हें अधिक रणनीतिक रूप से कैसे उपयोग कर सकते हैं।
प्राकृतिक वरण
प्राकृतिक वरण वह प्रक्रिया है जिसमें अनुकूल गुणों के बेहतर संयोजन वाले व्यक्तियों के जीवित रहने और प्रजनन करने की संभावना अधिक होती है। समय के साथ, ये लाभकारी गुण जनसंख्या में अधिक आम हो जाते हैं।
GA के संदर्भ में, इस अवधारणा का प्रतिबिंब उच्च फिटनेस स्कोर वाले व्यक्तियों का प्रजनन हेतु चयन है। इस तरह वे अपने अनुकूल गुण, या "जीन", अगली पीढ़ी को सौंपते हैं।
जीन, क्रॉसओवर, और म्यूटेशन
किसी जैविक जीव के गुण उसके जीन द्वारा एन्कोड होते हैं। जीन DNA का भाग हैं, जो क्रोमोसोम में व्यवस्थित होते हैं।
GA कई समान अवधारणाएँ और शब्दावली उधार लेते हैं। किसी समस्या के संभावित समाधानों को "क्रोमोसोम" के रूप में निरूपित किया जाता है, जिन्हें प्रायः स्ट्रिंग्स या एरे के रूप में कोड किया जाता है। क्रोमोसोम का प्रत्येक तत्व किसी जीन के अनुरूप होता है जो समाधान के किसी विशिष्ट गुण को निर्धारित करता है।
क्रॉसओवर, या पुनर्संयोजन, एक आनुवंशिक क्रिया है जो दो अभिभावक क्रोमोसोम के आनुवंशिक पदार्थ के हिस्सों को मिलाकर एक नया क्रोमोसोम बनाती है, जिसमें दोनों अभिभावकों के हिस्से होते हैं। यह नया क्रोमोसोम मिश्रण संतान को दिया जाता है। यही कारण है कि आपको अपनी माँ की आँखों का रंग और अपने पिता के बालों का रंग मिल सकता है।
GA में, क्रॉसओवर में अभिभावक क्रोमोसोम के खंडों का आदान-प्रदान करके नए व्यक्तियों का निर्माण किया जाता है। यह क्रिया विविधता लाती है और संतान को दोनों अभिभावकों से लाभकारी गुण विरासत में लेने देती है।
म्यूटेशन किसी जीव के जीन में आकस्मिक परिवर्तन लाता है, जो नए गुण उत्पन्न कर सकता है।
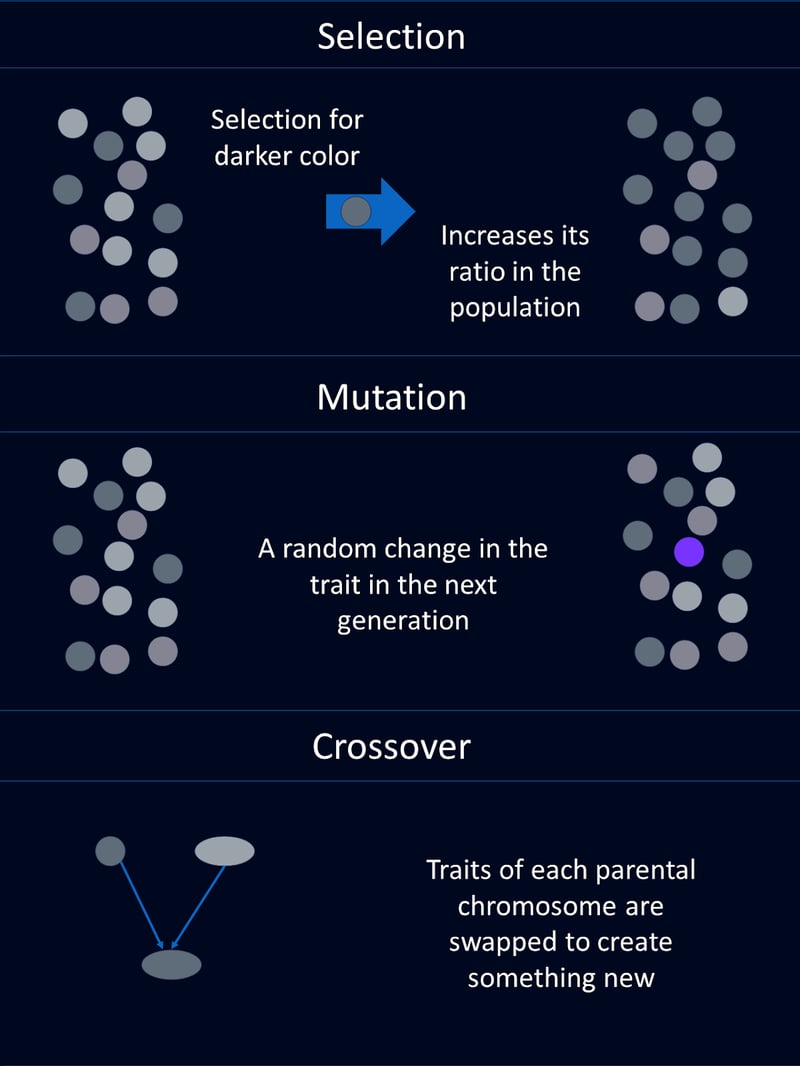
जेनेटिक एल्गोरिद्म में, म्यूटेशन का अर्थ क्रोमोसोम में एक या अधिक जीनों को यादृच्छिक रूप से बदलना है। यह जनसंख्या के भीतर आनुवंशिक विविधता बनाए रखने में मदद करता है और एल्गोरिद्म को समाधान-स्थान के नए क्षेत्रों की पड़ताल करने देता है।
फिटनेस मूल्यांकन
प्रकृति में, किसी व्यक्ति की फिटनेस उसके जीवित रहने और प्रजनन करने की क्षमता से निर्धारित होती है। यदि आप प्रजनन से पहले मर जाते हैं, तो आपकी फिटनेस शून्य है। यदि आपके 12 पोते-पोतियाँ हैं, तो आपकी फिटनेस 2 पोते-पोतियों वाले किसी व्यक्ति से अधिक होगी।
GA में, फिटनेस समान है, पर थोड़ी भिन्न। एक फिटनेस फ़ंक्शन यह मूल्याँकन करता है कि कोई समाधान दी गई समस्या को कितना अच्छी तरह सुलझाता है। उच्च फिटनेस स्कोर वाले समाधानों के प्रजनन हेतु चुने जाने की संभावना अधिक होती है, जिससे बेहतर समाधान पीढ़ियों में फैलते हैं।
जेनेटिक एल्गोरिद्म के घटक
जेनेटिक एल्गोरिद्म उत्क्रांति से प्रेरित हैं। परिणामस्वरूप, GA के घटकों के नाम और कार्य उनके जैविक समकक्षों से मिलते-जुलते हैं। आम तौर पर हर घटक को अलग फ़ंक्शन के रूप में कोड किया जाता है।
जनसंख्या (Population)
जेनेटिक एल्गोरिद्म में जनसंख्या उम्मीदवार समाधानों का एक समूह होती है, जिन्हें अक्सर व्यक्तिगत (individuals) कहा जाता है। प्रत्येक व्यक्ति को क्रोमोसोम के रूप में निरूपित किया जाता है, जिन्हें बाइनरी स्ट्रिंग्स, एरे, या अन्य डेटा स्ट्रक्चर के रूप में कोड किया जा सकता है।
उदाहरण के लिए, प्रत्येक क्रोमोसोम उस फ़ंक्शन के लिए इनपुट मानों का एक सेट दर्शा सकता है जिसे हमें अनुकूलित करना है। या प्रत्येक क्रोमोसोम डिलीवरी ड्राइवरों के लिए एक ट्रक मार्ग का प्रतिनिधित्व कर सकता है।
फिटनेस फ़ंक्शन
फिटनेस फ़ंक्शन उस समस्या को सुलझाने की प्रत्येक व्यक्ति की क्षमता का मूल्याँकन करता है जिसमें हमारी रुचि है। यह प्रत्येक व्यक्ति को एक फिटनेस मान सौंपता है, बेहतर समाधानों के लिए उच्च मान के साथ। फिटनेस फ़ंक्शन एल्गोरिद्म को बेहतर समाधानों की ओर मार्गदर्शन करता है।
उदाहरण के तौर पर, हमारे गणितीय फ़ंक्शन अनुकूलन उदाहरण में, फिटनेस फ़ंक्शन दिए गए इनपुट्स के लिए फ़ंक्शन का मान लौटा सकता है। हमारे ट्रक मार्ग उदाहरण में, फिटनेस फ़ंक्शन डिलीवरी पूर्ण होने की गति लौटा सकता है।
सेलेक्शन फ़ंक्शन
सेलेक्शन फ़ंक्शन फिटनेस के आधार पर प्रजनन हेतु जनसंख्या से व्यक्तियों का चयन करता है। उच्च फिटनेस वाले व्यक्तियों के चुने जाने की संभावना अधिक होती है। यह प्राकृतिक वरण की नकल करता है, जहाँ सर्वोत्तम अनुकूलित व्यक्तियों के जीवित रहने और प्रजनन करने की संभावना अधिक होती है।
कई अलग-अलग चयन विधियाँ हैं। सामान्य विधियों में रूलेट व्हील चयन, टूर्नामेंट चयन, और रैंक-आधारित चयन शामिल हैं।
रूलेट व्हील चयन में व्यक्तियों का चयन उनकी फिटनेस के अनुपात में संभावना के आधार पर होता है, जैसे रूलेट पहिया घुमाना।
टूर्नामेंट चयन में जनसंख्या का एक उपसमुच्चय यादृच्छिक रूप से चुना जाता है और इस उपसमुच्चय में सबसे अधिक फिटनेस वाला व्यक्ति चुना जाता है।
रैंक-आधारित चयन में व्यक्तियों को उनकी फिटनेस के आधार पर रैंक किया जाता है। फिर चयन संभावनाएँ कच्चे फिटनेस मानों के बजाय इन रैंकों के आधार पर आवंटित की जाती हैं।
हर विधि के अपने फायदे हैं और समस्या की विशिष्ट आवश्यकताओं के आधार पर इसे चुना जाना चाहिए।
क्रॉसओवर फ़ंक्शन
क्रॉसओवर दो व्यक्तियों की जानकारी को मिलाकर संतान बनाता है। लक्ष्य दोनों अभिभावकों से लाभकारी गुण विरासत में लेना है। सामान्य क्रॉसओवर तकनीकों में सिंगल-पॉइंट, मल्टी-पॉइंट, यूनिफॉर्म और ब्लेंड क्रॉसओवर शामिल हैं।
सिंगल-पॉइंट क्रॉसओवर में एक यादृच्छिक बिंदु चुना जाता है और उस बिंदु पर दो अभिभावकों के आनुवंशिक पदार्थ को अदल-बदल कर दो संततियाँ बनाई जाती हैं। मल्टी-पॉइंट क्रॉसओवर में माता-पिता के बीच सेगमेंट बदलने के लिए कई बिंदुओं का उपयोग किया जाता है, जिससे अधिक जटिल आनुवंशिक संयोजन संभव होते हैं।
यूनिफॉर्म क्रॉसओवर यादृच्छिक रूप से तय करता है कि प्रत्येक जीन कौन सा अभिभावक देगा, जिससे उच्च स्तर की आनुवंशिक विविधता मिलती है। ब्लेंड क्रॉसओवर एक यादृच्छिक ब्लेंडिंग फैक्टर का उपयोग करके अभिभावकों के जीनों को मिलाकर संतति उत्पन्न करता है। किस तकनीक का उपयोग करना है, यह समस्या की जटिलता और संतति में वांछित विविधता के स्तर पर आधारित होना चाहिए।
म्यूटेशन फ़ंक्शन
म्यूटेशन संतति के आनुवंशिक पदार्थ में यादृच्छिक बदलाव लाता है। यह जनसंख्या में विविधता बनाए रखने और समाधान-स्थान के नए क्षेत्रों की खोज करने में मदद करता है। म्यूटेशन उतना सरल हो सकता है जितना किसी बाइनरी स्ट्रिंग में एक बिट पलटना, या एन्कोडिंग स्कीम के आधार पर अधिक जटिल परिवर्तन शामिल हो सकते हैं।
जेनेटिक एल्गोरिद्म की प्रक्रिया
जेनेटिक एल्गोरिद्म इष्टतम समाधान खोजने के लिए प्राकृतिक उत्क्रांतिज प्रक्रियाओं की नकल करने वाले चरणों की एक श्रृंखला से गुजरता है। ये चरण जनसंख्या को पीढ़ियों में विकसित होने देते हैं, जिससे समाधानों की गुणवत्ता में सुधार होता है। यहाँ एक सामान्य दिशा-निर्देश है कि जेनेटिक एल्गोरिद्म कैसे आगे बढ़ता है:
चरण 1: प्रारंभिककरण
सबसे पहले, हम यादृच्छिक व्यक्तियों की एक प्रारंभिक जनसंख्या उत्पन्न करते हैं। यह चरण एल्गोरिद्म शुरू करने के लिए संभावित समाधानों का एक विविध सेट बनाता है।
चरण 2: मूल्यांकन
इसके बाद, हमें जनसंख्या के प्रत्येक व्यक्ति की फिटनेस की गणना करनी होती है। यहाँ हम फिटनेस फ़ंक्शन का उपयोग करके आकलन करते हैं कि प्रत्येक समाधान कितना अच्छा है।
चरण 3: चयन
चयन मानदंडों का उपयोग करके, हम फिटनेस के आधार पर प्रजनन के लिए व्यक्तियों का चयन करते हैं। यह चरण निर्धारित करता है कि कौन से व्यक्ति माता-पिता होंगे।
चरण 4: क्रॉसओवर
अब क्रॉसओवर आता है। चुने गए माता-पिता के आनुवंशिक पदार्थ को मिलाकर, हम नए समाधान या संतति उत्पन्न करने के लिए क्रॉसओवर तकनीकें लागू करते हैं।
चरण 5: म्यूटेशन
अपनी जनसंख्या में विविधता बनाए रखने के लिए, हमें संतति में यादृच्छिक म्यूटेशन जोड़ने की आवश्यकता होती है।
चरण 6: प्रतिस्थापन
इसके बाद हम यह निर्धारित करते हुए कि कौन से व्यक्ति अगली पीढ़ी में जाएँगे, पुरानी जनसंख्या के कुछ या सभी को नई संतति से बदलते हैं।
चरण 7: दोहराएँ
पिछले चरण 2-6 को निर्धारित संख्या की पीढ़ियों तक या तब तक दोहराया जाता है जब तक कोई समाप्ति शर्त पूरी नहीं हो जाती। यह लूप जनसंख्या को समय के साथ विकसित होने देता है, जिससे उम्मीद है कि अच्छा समाधान प्राप्त होगा।
Python उदाहरण
अब जबकि हमें यह अच्छी तरह समझ है कि जेनेटिक एल्गोरिद्म क्या हैं और वे आम तौर पर कैसे काम करते हैं, आइए एक सरल अनुकूलन समस्या को हल करने के लिए अपना खुद का जेनेटिक एल्गोरिद्म बनाते हैं।
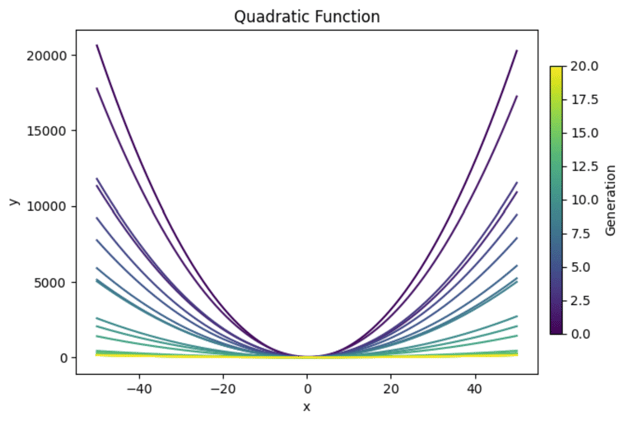
समीकरण y=ax2+bx+c, ग्राफ पर एक परबोला बनाता है। हम एक जेनेटिक एल्गोरिद्म का उपयोग a, b, और c के ऐसे मानों का संयोजन खोजने के लिए करेंगे जिससे परबोला सबसे चपटा हो। यहाँ हम क्या हासिल करेंगे उसका पूर्वावलोकन है:
लाइब्रेरी आयात करें
अपने फ़ंक्शन के शीर्ष पर, हम आवश्यक लाइब्रेरी आयात करेंगे। हम अपनी प्रारंभिक जनसंख्या के लिए यादृच्छिक मान उत्पन्न करने हेतु ‘random’ का उपयोग करेंगे। Numpy मेरे विचार में किसी भी गणना के लिए सामान्यतः उपयोगी है।
और मेरा पक्का मानना है कि आपको हमेशा प्लॉट बनाने चाहिए ताकि यह सुनिश्चित हो सके कि आपका कोड वैसा ही कर रहा है जैसा आप सोचते हैं। इसलिए हम ग्राफ बनाने के लिए ‘matplotlib.pyplot’ आयात करेंगे।
मुझे प्रत्येक पीढ़ी के महत्वपूर्ण परिणामों को प्रिंट करना भी पसंद है (मानकर चलें कि पीढ़ियों की संख्या अपेक्षाकृत कम है) ताकि यह बेहतर समझ आ सके कि सिमुलेशन के दौरान क्या हुआ। इसके लिए हम ‘PrettyTable’ आयात करेंगे।
import random
import matplotlib.pyplot as plt
import numpy as np
from prettytable import PrettyTableफिटनेस फ़ंक्शन परिभाषित करें
अगले चरण में हमें वह फिटनेस फ़ंक्शन परिभाषित करना है जो हर समाधान की फिटनेस का मूल्याँकन करेगा। इस मामले में, हम सबसे चपटा U-आकार वाला ग्राफ खोजना चाहते हैं। इसलिए मैंने शिखर (वर्टेक्स) पर y मान और x=-1 तथा x=1 पर मान की गणना की।
फिर मैंने ग्राफ की वक्रता (curviness) को इन तीन बिंदुओं पर y मानों के अंतर के रूप में परिभाषित किया। चूँकि हमें सबसे चपटी वक्र चाहिए, मैंने वक्रता को ऋणात्मक करके फिटनेस फ़ंक्शन पूरा किया।
# Define the fitness function (objective is to create the flattest U-shape)
def fitness_function(params):
a, b, c = params
if a <= 0:
return -float('inf') # Penalize downward facing u-shapes heavily
vertex_x = -b / (2 * a) #x value at vertex
vertex_y = a * (vertex_x ** 2) + b * vertex_x + c #y value at vertex
y_left = a * (-1) ** 2 + b * (-1) + c #y-coordinate at x = -1
y_right = a * (1) ** 2 + b * (1) + c #y-coordinate at x = 1
curviness = abs(y_left - vertex_y) + abs(y_right - vertex_y)
return -curviness # Negate to minimize curvinessप्रारंभिक जनसंख्या बनाएँ
हम यादृच्छिक समाधानों की जनसंख्या उत्पन्न करने के लिए ‘random’ लाइब्रेरी का उपयोग करेंगे। इस जनसंख्या में प्रत्येक व्यक्ति a, b, और c के मानों का एक सेट होता है।
# Create the initial population
def create_initial_population(size, lower_bound, upper_bound):
population = []
for _ in range(size):
individual = (random.uniform(lower_bound, upper_bound),
random.uniform(lower_bound, upper_bound),
random.uniform(lower_bound, upper_bound))
population.append(individual)
return populationसेलेक्शन फ़ंक्शन बनाएँ
सेलेक्शन फ़ंक्शन यह निर्धारित करेगा कि अगली जनसंख्या बनाने के लिए कौन से व्यक्ति प्रजनन करेंगे। इस उदाहरण में, हम टूर्नामेंट चयन प्रक्रिया का उपयोग करेंगे, जहाँ जनसंख्या में से व्यक्तियों का एक यादृच्छिक उपसमुच्चय लिया जाएगा, और उस उपसमुच्चय में सबसे अधिक फिटनेस वाले व्यक्ति को प्रजनन के लिए चुना जाएगा।
# Selection function using tournament selection
def selection(population, fitnesses, tournament_size=3):
selected = []
for _ in range(len(population)):
tournament = random.sample(list(zip(population, fitnesses)), tournament_size)
winner = max(tournament, key=lambda x: x[1])[0]
selected.append(winner)
return selectedक्रॉसओवर फ़ंक्शन बनाएँ
अगले चरण में, हम मौजूदा समाधानों के आधार पर नए समाधान बनाने के लिए क्रॉसओवर का उपयोग करने को एक त्वरित फ़ंक्शन लिखेंगे।
# Crossover function
def crossover(parent1, parent2):
alpha = random.random()
child1 = tuple(alpha * p1 + (1 - alpha) * p2 for p1, p2 in zip(parent1, parent2))
child2 = tuple(alpha * p2 + (1 - alpha) * p1 for p1, p2 in zip(parent1, parent2))
return child1, child2म्यूटेशन फ़ंक्शन डिज़ाइन करें
हमें आगामी पीढ़ियों में अनियमितता जोड़ने के लिए एक म्यूटेशन फ़ंक्शन की भी आवश्यकता है। यह सुनिश्चित करने के लिए महत्वपूर्ण है कि हर पीढ़ी में चयन हेतु पर्याप्त विविधता रहे।
# Mutation function
def mutation(individual, mutation_rate, lower_bound, upper_bound):
individual = list(individual)
for i in range(len(individual)):
if random.random() < mutation_rate:
mutation_amount = random.uniform(-1, 1)
individual[i] += mutation_amount
# Ensure the individual stays within bounds
individual[i] = max(min(individual[i], upper_bound), lower_bound)
return tuple(individual)मुख्य लूप
अब हमें मुख्य लूप बनाना है जो इन सभी हिस्सों को साथ लाकर हमारा एल्गोरिद्म चलाएगा। चूँकि हमें अपने परिणामों का प्लॉट भी बनाना है, मैं इस खंड में प्लॉटिंग का कोड और अंतिम तालिका बनाने के लिए आवश्यक कोड भी जोड़ दूँगा।
# Main genetic algorithm function
def genetic_algorithm(population_size, lower_bound, upper_bound, generations, mutation_rate):
population = create_initial_population(population_size, lower_bound, upper_bound)
# Prepare for plotting
fig, axs = plt.subplots(3, 1, figsize=(12, 18)) # 3 rows, 1 column for subplots
best_performers = []
all_populations = []
# Prepare for table
table = PrettyTable()
table.field_names = ["Generation", "a", "b", "c", "Fitness"]
for generation in range(generations):
fitnesses = [fitness_function(ind) for ind in population]
# Store the best performer of the current generation
best_individual = max(population, key=fitness_function)
best_fitness = fitness_function(best_individual)
best_performers.append((best_individual, best_fitness))
all_populations.append(population[:])
table.add_row([generation + 1, best_individual[0], best_individual[1], best_individual[2], best_fitness])
population = selection(population, fitnesses)
next_population = []
for i in range(0, len(population), 2):
parent1 = population[i]
parent2 = population[i + 1]
child1, child2 = crossover(parent1, parent2)
next_population.append(mutation(child1, mutation_rate, lower_bound, upper_bound))
next_population.append(mutation(child2, mutation_rate, lower_bound, upper_bound))
# Replace the old population with the new one, preserving the best individual
next_population[0] = best_individual
population = next_population
# Print the table
print(table)
# Plot the population of one generation (last generation)
final_population = all_populations[-1]
final_fitnesses = [fitness_function(ind) for ind in final_population]
axs[0].scatter(range(len(final_population)), [ind[0] for ind in final_population], color='blue', label='a')
axs[0].scatter([final_population.index(best_individual)], [best_individual[0]], color='cyan', s=100, label='Best Individual a')
axs[0].set_ylabel('a', color='blue')
axs[0].legend(loc='upper left')
axs[1].scatter(range(len(final_population)), [ind[1] for ind in final_population], color='green', label='b')
axs[1].scatter([final_population.index(best_individual)], [best_individual[1]], color='magenta', s=100, label='Best Individual b')
axs[1].set_ylabel('b', color='green')
axs[1].legend(loc='upper left')
axs[2].scatter(range(len(final_population)), [ind[2] for ind in final_population], color='red', label='c')
axs[2].scatter([final_population.index(best_individual)], [best_individual[2]], color='yellow', s=100, label='Best Individual c')
axs[2].set_ylabel('c', color='red')
axs[2].set_xlabel('Individual Index')
axs[2].legend(loc='upper left')
axs[0].set_title(f'Final Generation ({generations}) Population Solutions')
# Plot the values of a, b, and c over generations
generations_list = range(1, len(best_performers) + 1)
a_values = [ind[0][0] for ind in best_performers]
b_values = [ind[0][1] for ind in best_performers]
c_values = [ind[0][2] for ind in best_performers]
fig, ax = plt.subplots()
ax.plot(generations_list, a_values, label='a', color='blue')
ax.plot(generations_list, b_values, label='b', color='green')
ax.plot(generations_list, c_values, label='c', color='red')
ax.set_xlabel('Generation')
ax.set_ylabel('Parameter Values')
ax.set_title('Parameter Values Over Generations')
ax.legend()
# Plot the fitness values over generations
best_fitness_values = [fit[1] for fit in best_performers]
min_fitness_values = [min([fitness_function(ind) for ind in population]) for population in all_populations]
max_fitness_values = [max([fitness_function(ind) for ind in population]) for population in all_populations]
fig, ax = plt.subplots()
ax.plot(generations_list, best_fitness_values, label='Best Fitness', color='black')
ax.fill_between(generations_list, min_fitness_values, max_fitness_values, color='gray', alpha=0.5, label='Fitness Range')
ax.set_xlabel('Generation')
ax.set_ylabel('Fitness')
ax.set_title('Fitness Over Generations')
ax.legend()
# Plot the quadratic function for each generation
fig, ax = plt.subplots()
colors = plt.cm.viridis(np.linspace(0, 1, generations))
for i, (best_ind, best_fit) in enumerate(best_performers):
color = colors[i]
a, b, c = best_ind
x_range = np.linspace(lower_bound, upper_bound, 400)
y_values = a * (x_range ** 2) + b * x_range + c
ax.plot(x_range, y_values, color=color)
ax.set_xlabel('x')
ax.set_ylabel('y')
ax.set_title('Quadratic Function')
# Create a subplot for the colorbar
cax = fig.add_axes([0.92, 0.2, 0.02, 0.6]) # [left, bottom, width, height]
norm = plt.cm.colors.Normalize(vmin=0, vmax=generations)
sm = plt.cm.ScalarMappable(cmap='viridis', norm=norm)
sm.set_array([])
fig.colorbar(sm, ax=ax, cax=cax, orientation='vertical', label='Generation')
plt.show()
return max(population, key=fitness_function)सब कुछ चलाना
अंत में, हमें अपने एल्गोरिद्म के पैरामीटर सेट करने हैं और इसे चलाना है।
# Parameters for the genetic algorithm
population_size = 100
lower_bound = -50
upper_bound = 50
generations = 20
mutation_rate = 1
# Run the genetic algorithm
best_solution = genetic_algorithm(population_size, lower_bound, upper_bound, generations, mutation_rate)
print(f"Best solution found: a = {best_solution[0]}, b = {best_solution[1]}, c = {best_solution[2]}")समाप्ति शर्त (वैकल्पिक)
इस उदाहरण में, हमने अपने एल्गोरिद्म को चलाने के लिए एक निश्चित संख्या की पीढ़ियाँ तय की हैं। हालाँकि, हम एक ऐसी समाप्ति शर्त भी बना सकते थे जो लक्ष्य फिटनेस मान तक पहुँचने पर प्रोग्राम को रोक दे। वह कुछ इस प्रकार दिख सकती है:
def termination_condition(fitnesses, target_fitness):
return max(fitnesses) >= target_fitnessसब कुछ एक साथ रखना
यहाँ पूरा कोड एक साथ दिया गया है।
import random
import matplotlib.pyplot as plt
import numpy as np
from prettytable import PrettyTable
# Define the fitness function (objective is to create the flattest U-shape)
def fitness_function(params):
a, b, c = params
if a <= 0:
return -float('inf') # Penalize downward facing u-shapes heavily
vertex_x = -b / (2 * a) #x value at vertex
vertex_y = a * (vertex_x ** 2) + b * vertex_x + c #y value at vertex
y_left = a * (-1) ** 2 + b * (-1) + c #y-coordinate at x = -1
y_right = a * (1) ** 2 + b * (1) + c #y-coordinate at x = 1
curviness = abs(y_left - vertex_y) + abs(y_right - vertex_y)
return -curviness # Negate to minimize curviness
# Create the initial population
def create_initial_population(size, lower_bound, upper_bound):
population = []
for _ in range(size):
individual = (random.uniform(lower_bound, upper_bound),
random.uniform(lower_bound, upper_bound),
random.uniform(lower_bound, upper_bound))
population.append(individual)
return population
# Selection function using tournament selection
def selection(population, fitnesses, tournament_size=3):
selected = []
for _ in range(len(population)):
tournament = random.sample(list(zip(population, fitnesses)), tournament_size)
winner = max(tournament, key=lambda x: x[1])[0]
selected.append(winner)
return selected
# Crossover function
def crossover(parent1, parent2):
alpha = random.random()
child1 = tuple(alpha * p1 + (1 - alpha) * p2 for p1, p2 in zip(parent1, parent2))
child2 = tuple(alpha * p2 + (1 - alpha) * p1 for p1, p2 in zip(parent1, parent2))
return child1, child2
# Mutation function
def mutation(individual, mutation_rate, lower_bound, upper_bound):
individual = list(individual)
for i in range(len(individual)):
if random.random() < mutation_rate:
mutation_amount = random.uniform(-1, 1)
individual[i] += mutation_amount
# Ensure the individual stays within bounds
individual[i] = max(min(individual[i], upper_bound), lower_bound)
return tuple(individual)
# Main genetic algorithm function
def genetic_algorithm(population_size, lower_bound, upper_bound, generations, mutation_rate):
population = create_initial_population(population_size, lower_bound, upper_bound)
# Prepare for plotting
fig, axs = plt.subplots(3, 1, figsize=(12, 18)) # 3 rows, 1 column for subplots
best_performers = []
all_populations = []
# Prepare for table
table = PrettyTable()
table.field_names = ["Generation", "a", "b", "c", "Fitness"]
for generation in range(generations):
fitnesses = [fitness_function(ind) for ind in population]
# Store the best performer of the current generation
best_individual = max(population, key=fitness_function)
best_fitness = fitness_function(best_individual)
best_performers.append((best_individual, best_fitness))
all_populations.append(population[:])
table.add_row([generation + 1, best_individual[0], best_individual[1], best_individual[2], best_fitness])
population = selection(population, fitnesses)
next_population = []
for i in range(0, len(population), 2):
parent1 = population[i]
parent2 = population[i + 1]
child1, child2 = crossover(parent1, parent2)
next_population.append(mutation(child1, mutation_rate, lower_bound, upper_bound))
next_population.append(mutation(child2, mutation_rate, lower_bound, upper_bound))
# Replace the old population with the new one, preserving the best individual
next_population[0] = best_individual
population = next_population
# Print the table
print(table)
# Plot the population of one generation (last generation)
final_population = all_populations[-1]
final_fitnesses = [fitness_function(ind) for ind in final_population]
axs[0].scatter(range(len(final_population)), [ind[0] for ind in final_population], color='blue', label='a')
axs[0].scatter([final_population.index(best_individual)], [best_individual[0]], color='cyan', s=100, label='Best Individual a')
axs[0].set_ylabel('a', color='blue')
axs[0].legend(loc='upper left')
axs[1].scatter(range(len(final_population)), [ind[1] for ind in final_population], color='green', label='b')
axs[1].scatter([final_population.index(best_individual)], [best_individual[1]], color='magenta', s=100, label='Best Individual b')
axs[1].set_ylabel('b', color='green')
axs[1].legend(loc='upper left')
axs[2].scatter(range(len(final_population)), [ind[2] for ind in final_population], color='red', label='c')
axs[2].scatter([final_population.index(best_individual)], [best_individual[2]], color='yellow', s=100, label='Best Individual c')
axs[2].set_ylabel('c', color='red')
axs[2].set_xlabel('Individual Index')
axs[2].legend(loc='upper left')
axs[0].set_title(f'Final Generation ({generations}) Population Solutions')
# Plot the values of a, b, and c over generations
generations_list = range(1, len(best_performers) + 1)
a_values = [ind[0][0] for ind in best_performers]
b_values = [ind[0][1] for ind in best_performers]
c_values = [ind[0][2] for ind in best_performers]
fig, ax = plt.subplots()
ax.plot(generations_list, a_values, label='a', color='blue')
ax.plot(generations_list, b_values, label='b', color='green')
ax.plot(generations_list, c_values, label='c', color='red')
ax.set_xlabel('Generation')
ax.set_ylabel('Parameter Values')
ax.set_title('Parameter Values Over Generations')
ax.legend()
# Plot the fitness values over generations
best_fitness_values = [fit[1] for fit in best_performers]
min_fitness_values = [min([fitness_function(ind) for ind in population]) for population in all_populations]
max_fitness_values = [max([fitness_function(ind) for ind in population]) for population in all_populations]
fig, ax = plt.subplots()
ax.plot(generations_list, best_fitness_values, label='Best Fitness', color='black')
ax.fill_between(generations_list, min_fitness_values, max_fitness_values, color='gray', alpha=0.5, label='Fitness Range')
ax.set_xlabel('Generation')
ax.set_ylabel('Fitness')
ax.set_title('Fitness Over Generations')
ax.legend()
# Plot the quadratic function for each generation
fig, ax = plt.subplots()
colors = plt.cm.viridis(np.linspace(0, 1, generations))
for i, (best_ind, best_fit) in enumerate(best_performers):
color = colors[i]
a, b, c = best_ind
x_range = np.linspace(lower_bound, upper_bound, 400)
y_values = a * (x_range ** 2) + b * x_range + c
ax.plot(x_range, y_values, color=color)
ax.set_xlabel('x')
ax.set_ylabel('y')
ax.set_title('Quadratic Function')
# Create a subplot for the colorbar
cax = fig.add_axes([0.92, 0.2, 0.02, 0.6]) # [left, bottom, width, height]
norm = plt.cm.colors.Normalize(vmin=0, vmax=generations)
sm = plt.cm.ScalarMappable(cmap='viridis', norm=norm)
sm.set_array([])
fig.colorbar(sm, ax=ax, cax=cax, orientation='vertical', label='Generation')
plt.show()
return max(population, key=fitness_function)
# Parameters for the genetic algorithm
population_size = 100
lower_bound = -50
upper_bound = 50
generations = 20
mutation_rate = 1
# Run the genetic algorithm
best_solution = genetic_algorithm(population_size, lower_bound, upper_bound, generations, mutation_rate)
print(f"Best solution found: a = {best_solution[0]}, b = {best_solution[1]}, c = {best_solution[2]}")परिणामों का मूल्यांकन
आइए अपने आउटपुट का उपयोग करके देखें कि हमारा फ़ंक्शन कैसा प्रदर्शन कर पाया।
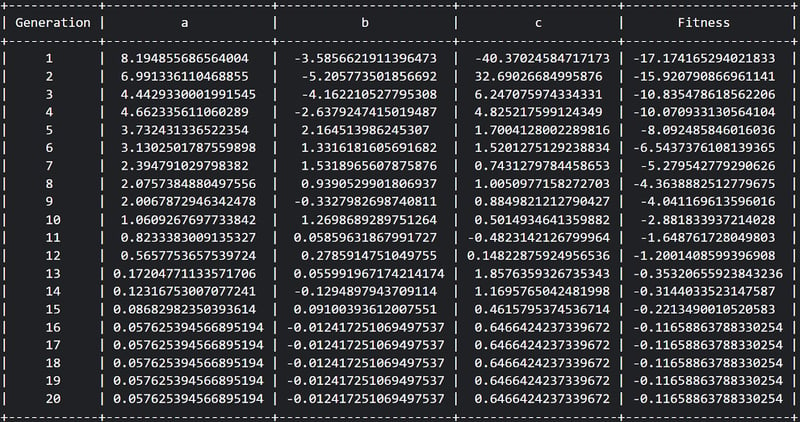
सबसे पहले, हम तालिका से देख सकते हैं कि हमने 20 पीढ़ियाँ पूरी कीं और फिटनेस प्रत्येक पीढ़ी में अपेक्षाकृत अधिक ऋणात्मक से कम ऋणात्मक होती गई। बहुत बढ़िया!
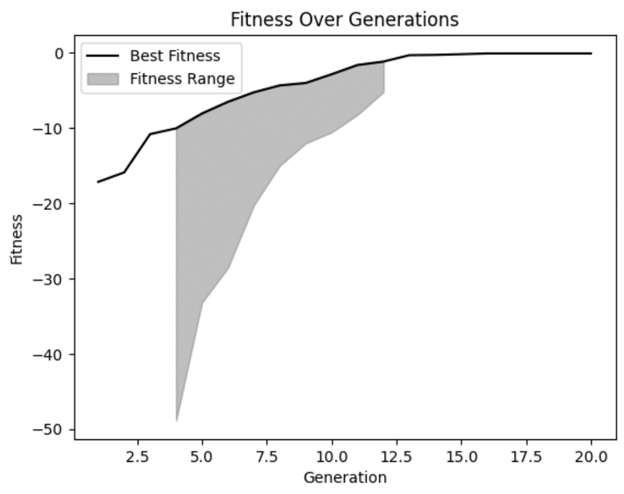
फिटनेस ग्राफ से, हम अपने संदेह की पुष्टि कर सकते हैं कि समय के साथ फिटनेस में सुधार हुआ और बाद की पीढ़ियों में कुछ हद तक समतल हो गई। लेकिन हम यह भी देख सकते हैं कि शुरुआती कुछ पीढ़ियों में बहुत खराब समाधान थे जिन्हें हमारे मॉडल ने सही रूप से अस्वीकार किया।
हम यह भी देख सकते हैं कि कई पीढ़ियों में फिटनेस रेंज में बहुत अधिक विविधता नहीं थी। यद्यपि यह आवश्यक रूप से बुरी बात नहीं है, फिर भी इस पर नज़र रखना ज़रूरी है। कुछ मामलों में, यह समय से पहले अभिसरण (premature convergence) का संकेतक हो सकता है, जो तब होता है जब आपकी जनसंख्या में पर्याप्त विविधता नहीं होती।
अगले चरण में, आइए प्रत्येक पीढ़ी से अपनी समीकरणों का प्लॉट बनाकर देखें कि क्या हमने वाकई इसे चपटा किया है।
हम देख सकते हैं कि शुरुआती पीढ़ियों के समाधान बहुत वक्राकार हैं, जो समझ में आता है। यह समीकरण U-आकार का ग्राफ बनाता है। लेकिन हम यह भी देखते हैं कि आगे की पीढ़ियाँ लगातार अधिक समतल होती गईं। यही तो हम चाहते थे!
यह ध्यान देने योग्य है कि हम स्पष्ट रूप से केवल -50 से 50 की सीमा के भीतर ही देख रहे हैं। यदि हम इस ग्राफ को ज़ूम-आउट करें, तो यह दिखाएगा कि ये दिखने में समतल रेखाएँ भी अभी U-आकार ही हैं, बस चौड़े आधार के साथ।
यह उदाहरण हमारे विश्लेषण में अपनी मान्यताओं के प्रति सावधान रहने के महत्व को रेखांकित करता है ताकि वे हमारी भविष्यवाणियों का समर्थन करें। हमारे मॉडल ने बिल्कुल वही किया जो हम चाहते थे, लेकिन केवल उन सीमाओं के भीतर जो हमने दी थीं। यदि हम ऐसे चपटी आकृति वाले मानों का संयोजन ढूँढना चाहते हैं जो और दूर तक फैला हो, तो हमें व्यापक सीमाओं के साथ मॉडल को फिर से चलाने की आवश्यकता होगी।
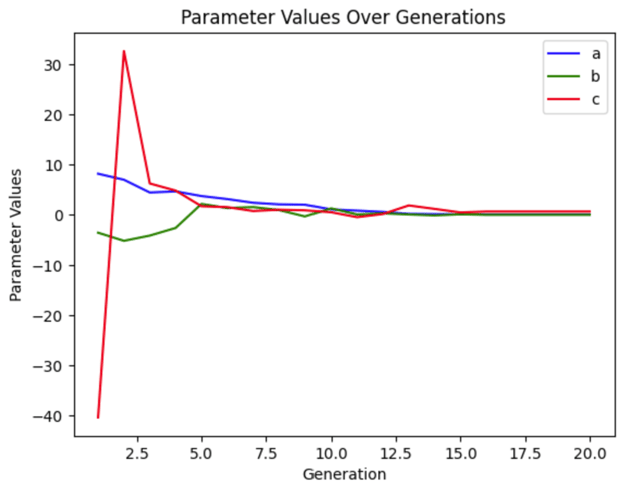
हम प्रत्येक चर का प्लॉट बनाकर देख सकते हैं कि वे पीढ़ियों में कितने बदले। हम देख सकते हैं कि इस सिमुलेशन रन में, c ने शुरुआत में बहुत उतार-चढ़ाव दिखाया जबकि a और b में बदलाव कहीं कम नाटकीय रहा। यह ग्राफ हर बार अलग दिखेगा, भले ही हम कोई पैरामीटर न बदलें, क्योंकि हमारी प्रारंभिक जनसंख्या यादृच्छिक होती है।
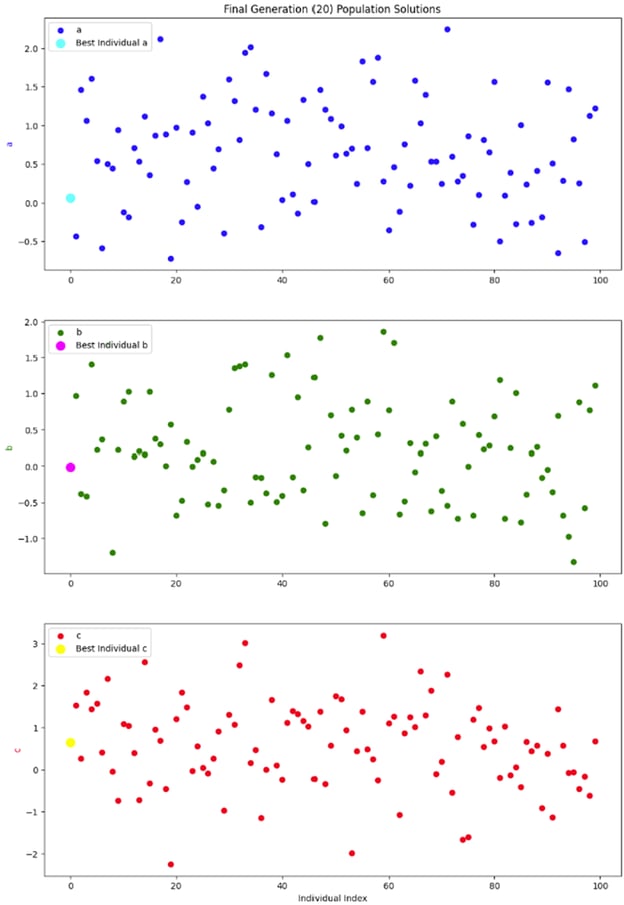
आखिरी ग्राफ जिसे मैं देखना चाहूँगा, वह एक पीढ़ी—अंतिम पीढ़ी—की पूरी जनसंख्या की झलक है। चूँकि जनसंख्या के प्रत्येक व्यक्ति के तीन पैरामीटर होते हैं, मैंने 3-आयामी प्लॉट्स में उलझने के बजाय उन्हें तीन सबप्लॉट्स में बाँटने का निर्णय लिया।
मैं इन ग्राफ़ों से वास्तव में यह देखना चाहता हूँ कि इस पीढ़ी में अच्छी विविधता है या नहीं। पर्याप्त विविधता के बिना, हम ऐसी स्थिति में फँस सकते हैं जहाँ उपलब्ध समाधान कम फिटनेस वाले ही हों, जिसके परिणामस्वरूप समय से पहले अभिसरण हो। लेकिन लगता है कि ये ग्राफ अच्छी खासी विविधता दिखाते हैं, इसलिए मैं इस परिणाम से संतुष्ट हूँ।
विचारणीय बिंदु और सुझाव
जेनेटिक एल्गोरिद्म का उपयोग कई तरह की परिस्थितियों में किया जा सकता है। लेकिन कुछ बातों का ध्यान रखना ज़रूरी है।
पैरामीटर ट्यूनिंग
किसी भी मॉडल की तरह, जेनेटिक एल्गोरिद्म का प्रदर्शन विभिन्न पैरामीटरों पर निर्भर करता है, विशेष रूप से जनसंख्या आकार, क्रॉसओवर दर, म्यूटेशन दर, और बाउंडिंग पैरामीटर। इन पैरामीटरों को बदलने से आपके मॉडल का प्रदर्शन बदल जाएगा।
एक सामान्य नियम के रूप में, बड़ी जनसंख्या आकार आपको इष्टतम समाधान जल्दी खोजने में मदद करेगा क्योंकि चुनने के लिए अधिक विकल्प होते हैं। हालाँकि, बड़ी जनसंख्या आकार को चलाने में अधिक समय और संसाधन लगते हैं।
उच्च क्रॉसओवर दर, विभिन्न व्यक्तियों के लाभकारी गुणों को अधिक बार मिलाकर, तेज अभिसरण की ओर ले जा सकती है। हालाँकि, बहुत अधिक क्रॉसओवर दर जनसंख्या की संरचना को बाधित कर सकती है, जो समय से पहले अभिसरण का कारण बन सकती है।
उच्च म्यूटेशन दर आनुवंशिक विविधता बनाए रखने में मदद करती है, जिससे एल्गोरिद्म किसी स्थानीय इष्टतम पर फँसने से बचता है। लेकिन यदि म्यूटेशन दर बहुत अधिक हो, तो यह अत्यधिक यादृच्छिकता लाकर अभिसरण प्रक्रिया को बाधित कर सकती है, जिससे एल्गोरिद्म के लिए समाधानों को परिष्कृत करना कठिन हो जाता है।
बाउंडिंग पैरामीटर उस सीमा को परिभाषित करते हैं जिसके भीतर एल्गोरिद्म समाधान खोजता है। इन्हें आपकी विशेष व्यावसायिक समस्या के अनुसार ट्यून करना महत्वपूर्ण है। बहुत संकरी सीमा आपके समस्या के इष्टतम समाधानों को मिस कर सकती है। बहुत व्यापक सीमा को चलाने में अधिक समय और संसाधन लगते हैं। लेकिन अन्य बातें भी विचारणीय हैं।
उदाहरण के लिए, हमारे ऊपर दिए गए कोडेड उदाहरण में, वह समीकरण सैद्धांतिक रूप से बिना सीमा के है। पर व्यावहारिक रूप से, हम कंप्यूटर से अनंत बड़े ग्राफ में सबसे चपटा चाप खोजने को नहीं कह सकते। इसलिए, सीमाएँ आवश्यक हैं। लेकिन उन सीमाओं को बदलने से इष्टतम उत्तर भी बदल जाएगा। मेरे विचार में, किसी भी मॉडल में आपके विशिष्ट उपयोग-केस के लिए उपयुक्त सीमाएँ निर्धारित करना अत्यावश्यक है।
आपके विशेष मॉडल में ट्यून करने के लिए अन्य महत्वपूर्ण पैरामीटर भी हो सकते हैं। अपनी समस्या के लिए सर्वोत्तम सेटिंग्स खोजने हेतु विभिन्न मानों के साथ प्रयोग करें। विशेष रूप से GA की ट्यूनिंग के बारे में जानने के लिए देखें Informed Methods: Genetic Algorithms।
एन्कोडिंग
एन्कोडिंग जेनेटिक एल्गोरिद्म सेटअप में एक महत्वपूर्ण चरण है। इसमें संभावित समाधानों को उस प्रारूप में बदलना शामिल है जिसे एल्गोरिद्म संसाधित कर सके। उदाहरण के लिए, मान लें कि हम अपने ट्रकों के लिए डिलीवरी मार्गों को अनुकूलित करने हेतु एक जेनेटिक एल्गोरिद्म डिज़ाइन कर रहे हैं। डिलीवरी स्थानों की सूची को GA में डालने के लिए आप क्रोमोसोम में कैसे बदलेंगे? एन्कोडिंग इस सूची को एक ऐसे अनुक्रम में रूपांतरित करती है जिसे एल्गोरिद्म संसाधित कर सके, जैसे स्थानों की क्रमबद्ध सूची जो एक संभावित डिलीवरी मार्ग का प्रतिनिधित्व करती है।
उचित एन्कोडिंग यह सुनिश्चित करती है कि जेनेटिक एल्गोरिद्म समाधान-स्थान का प्रभावी ढंग से अन्वेषण कर सके और अर्थपूर्ण तरीकों से समाधानों को जोड़ या परिवर्तित कर सके। इसके बिना, एल्गोरिद्म जटिल डेटा को संभाल नहीं पाएगा। डिलीवरी स्थान, शेड्यूलिंग समस्याएँ, या कस्टमर सर्विस इंटरैक्शन जैसे डेटा कंप्यूटरों के लिए केवल एन्कोडिंग के माध्यम से ही सुलभ बनते हैं।
चुनने के लिए कई एन्कोडिंग स्कीमा हैं। अपनी स्थिति के लिए कौन सा बेहतर हो सकता है यह तय करने हेतु आप अधिक जान सकते हैं Working with Categorical Data in Python या How to Convert Strings to Bytes in Python में।
समय से पहले अभिसरण
समय से पहले अभिसरण (Premature convergence) तब होता है जब जनसंख्या बहुत समान हो जाती है। इससे एल्गोरिद्म वैश्विक इष्टतम खोजने के बजाय किसी स्थानीय इष्टतम पर अटक सकता है। मूलतः, यदि जनसंख्या में पर्याप्त विविधता नहीं है, तो समाधान “इनब्रीड” हो जाते हैं और आपको सर्वश्रेष्ठ समाधान नहीं मिलता।
समय से पहले अभिसरण से बचने के लिए आप कुछ तकनीकें आजमा सकते हैं। उच्च म्यूटेशन दर जनसंख्या में अधिक विविधता ला सकती है, जिससे समाधान-स्थान के नए क्षेत्रों की खोज में मदद मिलती है। आप एक अधिक विविध प्रारंभिक जनसंख्या से शुरू करने की भी कोशिश कर सकते हैं ताकि शुरुआत से ही समाधान-स्थान का व्यापक अन्वेषण सुनिश्चित हो।
यदि फिर भी समय से पहले अभिसरण की समस्या बनी रहती है, तो आप एल्गोरिद्म की प्रगति के आधार पर म्यूटेशन दर और क्रॉसओवर दर जैसे पैरामीटरों को गतिशील रूप से समायोजित करने की कोशिश कर सकते हैं। वैकल्पिक रूप से, आप कई जनसंख्याओं (उन्हें द्वीपों की तरह सोचें) का उपयोग कर सकते हैं जो विविधता बनाए रखने के लिए समय-समय पर व्यक्तियों का आदान-प्रदान करती हैं।
समय से पहले अभिसरण और अन्य मशीन लर्निंग चूकों के बारे में अधिक जानने के लिए देखें Monitoring Machine Learning Concepts कोर्स।
एलीटिज़्म
दूसरी ओर, मजबूत क्रॉसओवर और म्यूटेशन या चयन में कोई भी यादृच्छिकता यह भी मतलब हो सकता है कि बेहतरीन समाधान प्रजनन तक नहीं पहुँच पाते। वहीं एलीटिज़्म काम आता है। एलीटिज़्म एक तकनीक है जिसमें सर्वश्रेष्ठ व्यक्तियों को सीधे अगली पीढ़ी में ले जाया जाता है ताकि अच्छे समाधान संरक्षित रहें। यह सुनिश्चित करने में मदद करता है कि उत्क्रांतिज प्रक्रिया के दौरान सर्वश्रेष्ठ समाधान खो न जाएँ।
हालाँकि, एलीटिज़्म का उपयोग करते समय सावधान रहें। यदि पर्याप्त जनसंख्या विविधता के बिना एलीटिज़्म का उपयोग किया जाए, तो आप समय से पहले अभिसरण के शिकार हो सकते हैं। यदि आपकी व्यावसायिक समस्या एलीटिज़्म तकनीकों की माँग करती है, तो सुनिश्चित करें कि आप इसे पर्याप्त रूप से मजबूत क्रॉसओवर और म्यूटेशन फ़ंक्शनों तथा बड़े जनसंख्या आकार के साथ जोड़ें। यह दृष्टिकोण ज्ञात समाधानों के दोहन और नई संभावनाओं के अन्वेषण के बीच एक स्वस्थ संतुलन बनाए रखने में मदद करता है।
निष्कर्ष
जेनेटिक एल्गोरिद्म इस बात का शानदार उदाहरण हैं कि डेटा विज्ञान प्राकृतिक दुनिया से प्रेरणा कैसे लेता है। वे प्राकृतिक वरण की प्रक्रिया की नकल करके जटिल अनुकूलन समस्याओं को हल करने की एक शक्तिशाली विधि प्रदान करते हैं।
यदि आप जीवविज्ञान से प्रेरित अन्य मॉडलों में रुचि रखते हैं, तो न्यूरल नेटवर्क और अन्य डीप लर्निंग तकनीकों के बारे में जानें Introduction to Deep Learning in Python में। आपको DataCamp का Generative AI Concepts कोर्स और AI Ethics भी रुचिकर लग सकते हैं।
यदि आप जैविक डेटा के साथ कोई प्रोजेक्ट करने के लिए प्रेरित हैं, तो देखें Analyzing Genomic Data in R या Biomedical Image Analysis in Python।

मैं एक पीएचडी हूँ, जिसके पास जैविक अनुसंधान परिवेश में डेटा के साथ काम करने का 13 वर्षों का अनुभव है। मैं Python, MATLAB और R सहित कई प्रोग्रामिंग भाषाओं में सॉफ्टवेयर बनाती/बनाता हूँ। मुझे सीखने के प्रति अपने प्रेम को दुनिया के साथ साझा करने का जुनून है।
कल्पना करें कि आप ट्रकों के लिए डिलीवरी मार्गों को अनुकूलित करने की कोशिश कर रहे हैं। हर ट्रक के पास कई संभावित मार्ग हैं, और आपके पास कई ट्रक हैं जिनके कई स्टॉप हैं। संभावित संयोजनों की संख्या इतनी अधिक है कि यह भारी लग सकती है, और सर्वश्रेष्ठ समाधान खोजना घास के ढेर में सूई ढूंढने जैसा हो सकता है।
ऐसी समस्याओं को हल करने के लिए, हम जीवविज्ञान से एक अवधारणा उधार ले सकते हैं: उत्क्रांति। जीवविज्ञान में, प्राकृतिक वरण एक शक्ति है जो उत्क्रांति को आगे बढ़ाती है। प्रकृति की समस्या यह है कि ऐसे गुणों के इष्टतम संयोजन खोजे जाएँ जो किसी जीव को जीवित रहने और प्रजनन करने दें। यह विभिन्न गुण-समुच्चयों को एक-दूसरे के विरुद्ध प्रतिस्पर्धा में रखता है और सर्वश्रेष्ठ संयोजनों का चयन करता है।
इसी तरह, हम इस अवधारणा का उपयोग ऐसा एल्गोरिद्म बनाने में कर सकते हैं जो विभिन्न समाधानों को एक-दूसरे के खिलाफ खड़ा करे और चयन का उपयोग करके उन्हें सर्वश्रेष्ठ समाधान में “विकसित” करे। ऐसा करने वाले एल्गोरिद्म को जेनेटिक एल्गोरिद्म (GA) कहा जाता है।