Last chance! 50% off DataCamp Premium
Sale ends in
GLM-5 Z.ai का नवीनतम ओपन-रीज़निंग मॉडल है, और कोडिंग, एजेंट वर्कफ़्लोज़ और लंबी संदर्भ वाली चैट में अपने मजबूत प्रदर्शन के लिए इसे तेजी से ध्यान मिला है।
कई डेवलपर्स पहले से ही इसका उपयोग वन-शॉट वेबसाइट बनाने, छोटे ऐप्स विकसित करने और लोकल AI एजेंट्स के साथ प्रयोग करने के लिए कर रहे हैं।
चुनौती यह है कि GLM-5 बहुत बड़ा मॉडल है, और इसे लोकल रूप से चलाना कंज़्यूमर हार्डवेयर पर यथार्थवादी नहीं है। क्वांटाइज़्ड संस्करणों को भी सैकड़ों गीगाबाइट मेमोरी और सक्षम GPU सेटअप की आवश्यकता होती है।
इस ट्यूटोरियल में, हम एक व्यावहारिक तरीका दिखाएंगे कि कैसे NVIDIA H200 पॉड पर 2-बिट GGUF क्वांट के साथ GLM-5 लोकल रूप से चलाएँ, उसे llama.cpp के माध्यम से सर्व करें, और Aider से कनेक्ट करें ताकि आप अपने प्रोजेक्ट्स के भीतर GLM-5 को एक वास्तविक कोडिंग एजेंट की तरह इस्तेमाल कर सकें।
मैं हमारे इस गाइड को भी देखने की सलाह देता/देती हूँ: GLM 4.7 Flash को लोकल रूप से चलाना।
GLM-5 को लोकल रूप से चलाने से पहले, आपको सही मॉडल वेरिएंट, उसे लोड करने जितनी मेमोरी, और एक कार्यरत GPU सॉफ्टवेयर स्टैक चाहिए।
हार्डवेयर आवश्यकताएँ क्वांट साइज पर निर्भर करती हैं:
सर्वोत्तम प्रदर्शन के लिए, आपकी VRAM + सिस्टम RAM का कुल योग क्वांट साइज के क़रीब होना चाहिए। यदि नहीं, तो llama.cpp SSD पर ऑफ़लोड कर सकता है, लेकिन इंफ़ेरेंस धीमा होगा। GPU उपयोग को अधिकतम करने के लिए llama.cpp में --fit का उपयोग करें।
हमारे सेटअप में, हम NVIDIA H200 पर GLM-5-UD-Q2_K_XL चलाते हैं, पर्याप्त VRAM और सिस्टम RAM के साथ ताकि मॉडल कुशलता से फिट हो सके।
सॉफ्टवेयर पूर्वापेक्षाएँ:
नीचे, आप GLM-5 को लोकल रूप से चलाने के चरण-दर-चरण निर्देश देख सकते हैं:
GLM-5 का 1-बिट संस्करण भी अधिकांश कंज़्यूमर लैपटॉप्स पर चलाने के लिए बहुत बड़ा है, इसलिए इस ट्यूटोरियल में, मैं Runpod के साथ NVIDIA H200 GPU का उपयोग करूँगा/करूँगी।
एक नया पॉड बनाकर और नवीनतम PyTorch टेम्पलेट का चयन करके शुरू करें।
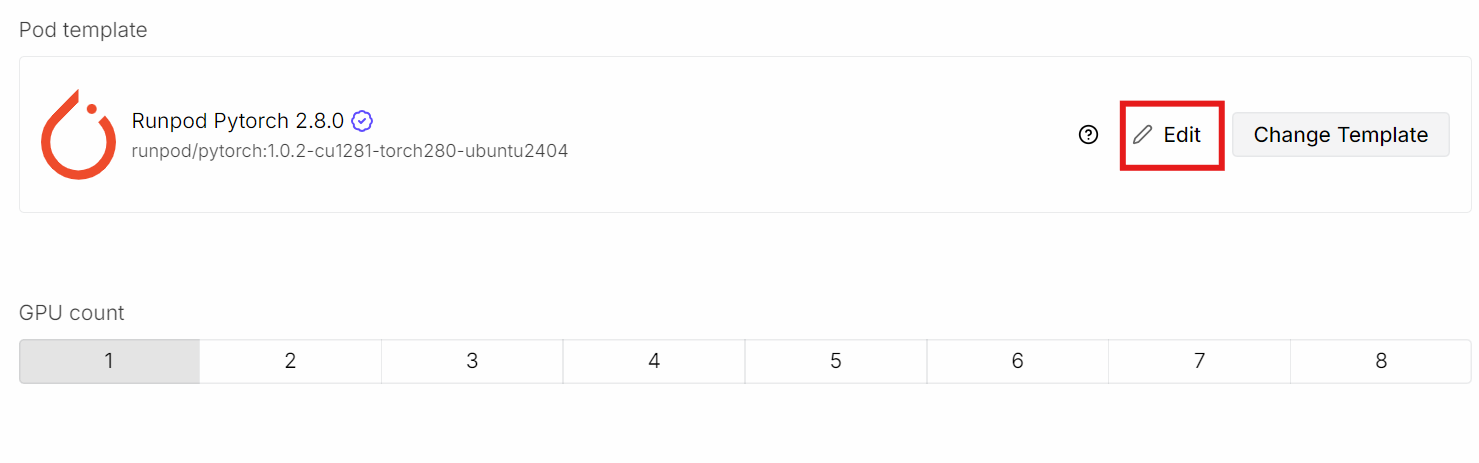
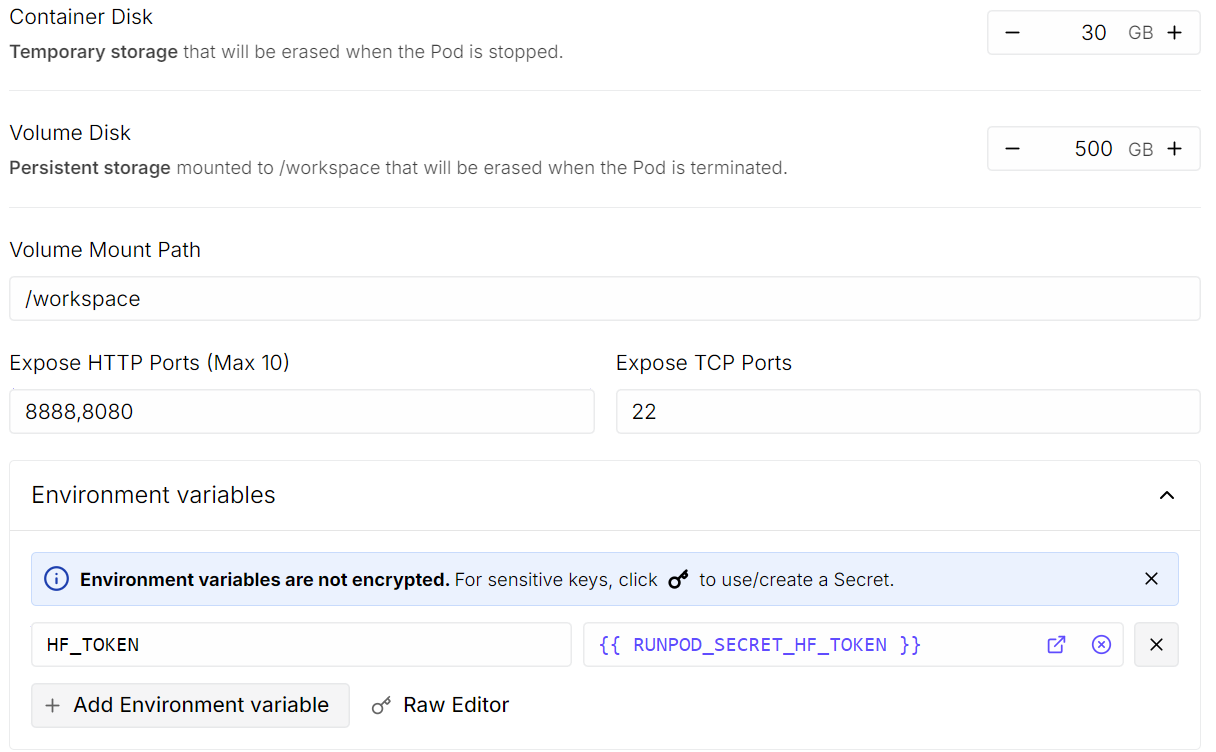
फिर पॉड सेटिंग्स समायोजित करने के लिए Edit पर क्लिक करें:
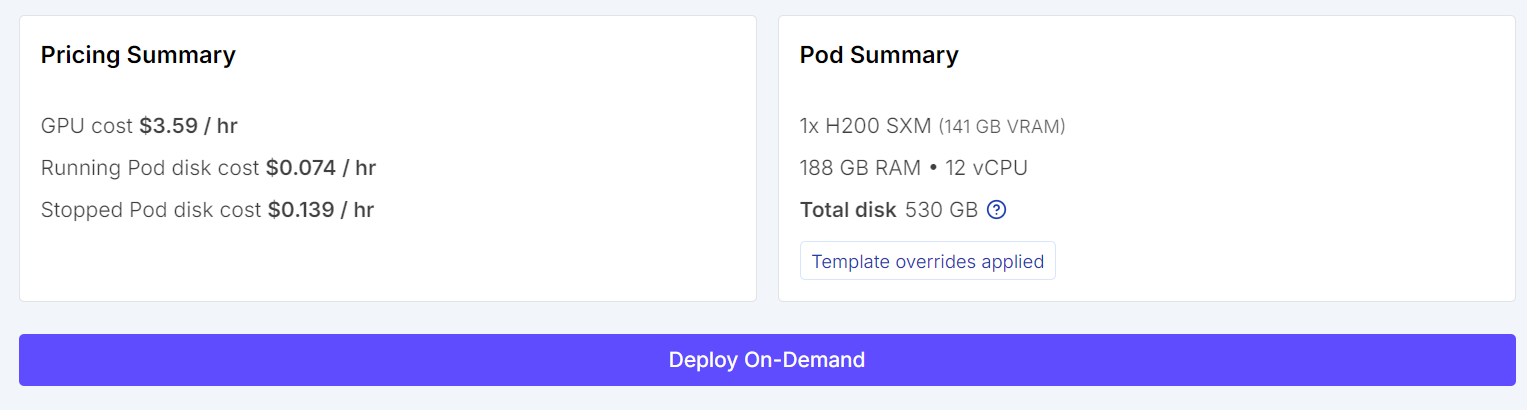
जब सब कुछ सही लगे, पॉड सारांश की समीक्षा करें और Deploy On-Demand पर क्लिक करें।
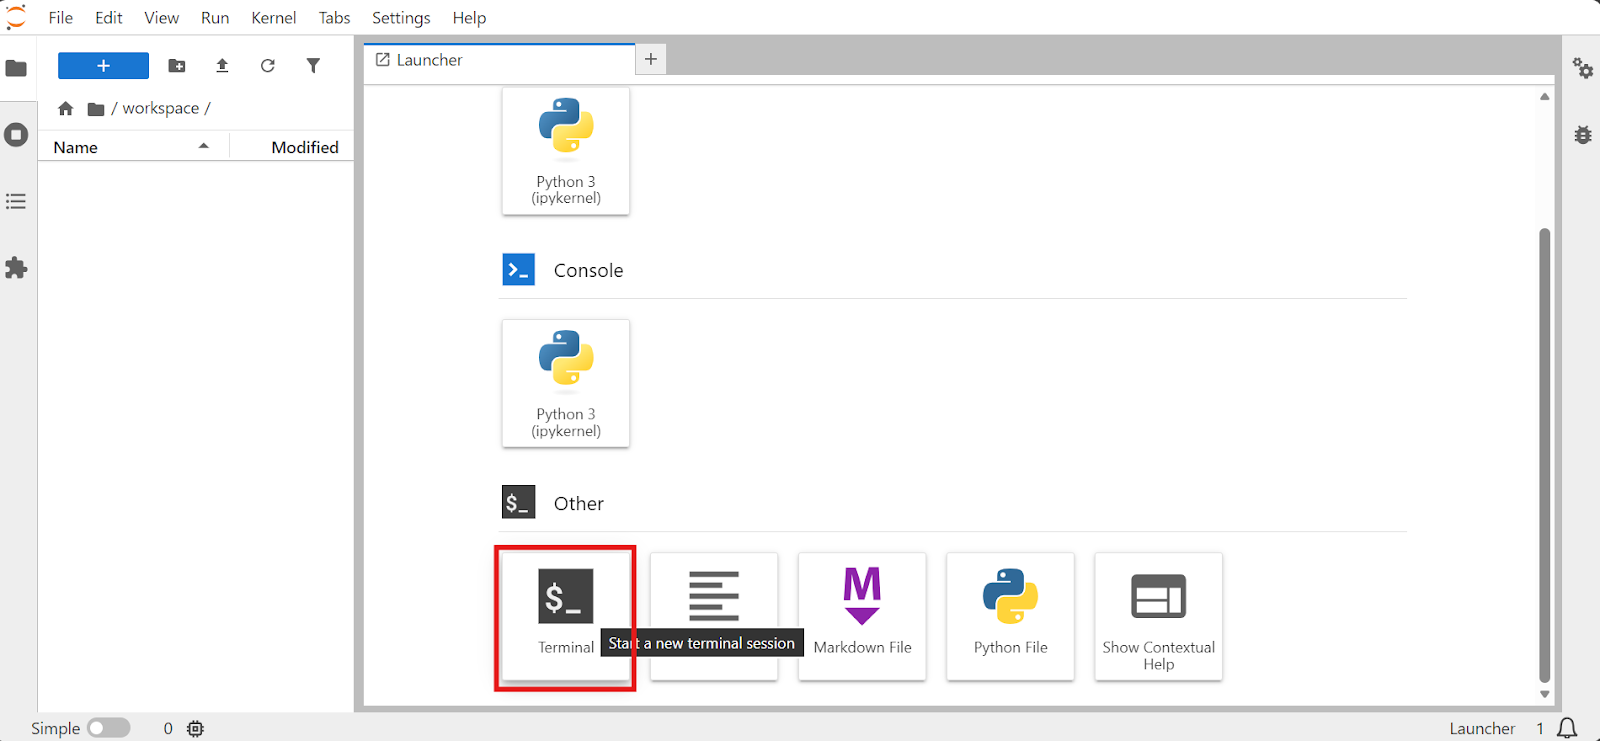
जब पॉड तैयार हो जाए, JupyterLab खोलें, एक Terminal लॉन्च करें, और वहीं से काम करें। Jupyter टर्मिनल का उपयोग सुविधाजनक है क्योंकि आप SSH पर निर्भर हुए बिना कई सेशंस आसानी से चला सकते हैं।
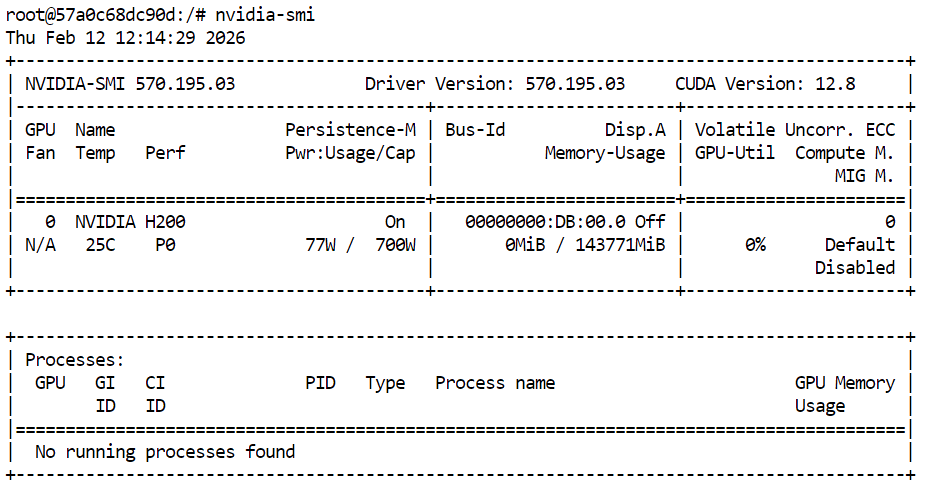
पहले, सुनिश्चित करें कि GPU उपलब्ध है:
nvidia-smi आपको आउटपुट में H200 सूचीबद्ध दिखना चाहिए।
इसके बाद, llama.cpp को क्लोन और बिल्ड करने के लिए आवश्यक Linux पैकेज इंस्टॉल करें:
sudo apt update
sudo apt install -y git cmake build-essential curl jqअब जब आपका Runpod वातावरण तैयार है और GPU काम कर रहा है, अगला कदम llama.cpp को CUDA एक्सेलेरेशन के साथ इंस्टॉल और कम्पाइल करना है ताकि GLM-5 H200 पर कुशलता से चल सके।
सबसे पहले, workspace डायरेक्टरी में जाएँ और आधिकारिक llama.cpp रिपॉजिटरी क्लोन करें:
cd /workspace
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
इस बिंदु पर यह नोट करना महत्वपूर्ण है कि नवीनतम स्थिर llama.cpp रिलीज़ अभी बॉक्स से बाहर GLM-5 को पूरी तरह सपोर्ट नहीं करती। आपको एक विशेष अपस्ट्रीम पुल रिक्वेस्ट खींचने की आवश्यकता है जिसमें उचित संगतता के लिए हालिया बदलाव शामिल हैं।
अपडेटेड ब्रांच फ़ेच और चेकआउट करें:
git fetch origin pull/19460/head:MASTER && git checkout MASTER && cd ..अगला, हम बिल्ड सिस्टम को कॉन्फ़िगर करेंगे ताकि llama.cpp CUDA सक्षम रूप में कम्पाइल हो, जिससे मॉडल पूरी तरह CPU पर चलने के बजाय GPU एक्सेलेरेशन का उपयोग कर सके।
CUDA फ़्लैग ऑन करके CMake चलाएँ:
cmake llama.cpp -B llama.cpp/build \
   -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON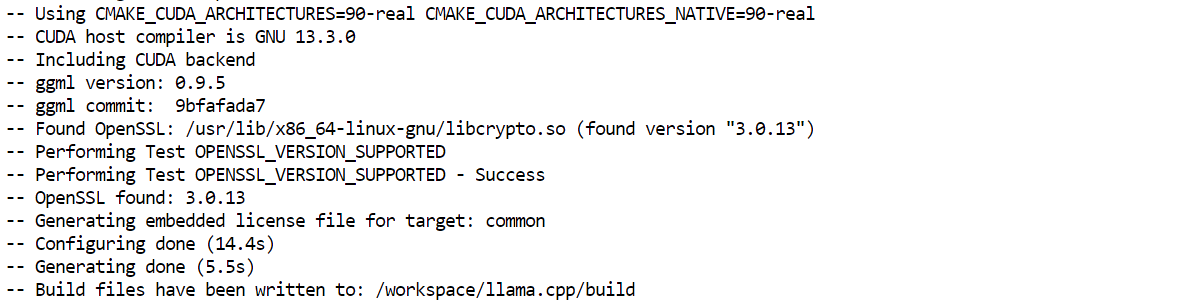
यह एक समर्पित build/ डायरेक्टरी बनाता है और यह सुनिश्चित करता है कि llama.cpp सर्वर बाइनरीज़ NVIDIA GPU निष्पादन का समर्थन करें।
जब कॉन्फ़िगरेशन पूरा हो जाए, llama-server टार्गेट को बिल्ड करें:
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-server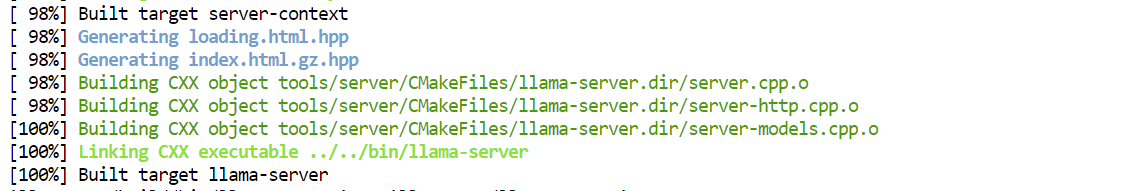
यह चरण पॉड पर निर्भर करते हुए कुछ मिनट ले सकता है, लेकिन पूरा होने पर आपके पास GLM-5 चलाने के लिए CUDA-सक्षम सर्वर बाइनरी तैयार होगी।
अंत में, कम्पाइल्ड एग्ज़िक्यूटेबल्स को आसान एक्सेस के लिए मुख्य फ़ोल्डर में कॉपी करें:
cp llama.cpp/build/bin/llama-* llama.cppllama.cpp कम्पाइल और तैयार होने के बाद, अगला कदम Hugging Face से GLM-5 GGUF मॉडल फ़ाइलें डाउनलोड करना है।
क्योंकि ये मॉडल चेकपॉइंट्स अत्यंत बड़े हैं, इसलिए उपलब्ध सबसे तेज़ डाउनलोड विधियों को सक्षम करना महत्वपूर्ण है।
Hugging Face वैकल्पिक टूल्स देता है जैसे hf_xet और hf_transfer, जो विशेषकर Runpod जैसी क्लाउड मशीनों पर डाउनलोड स्पीड में उल्लेखनीय सुधार करते हैं।
आवश्यक Hugging Face डाउनलोड यूटिलिटीज़ इंस्टॉल करके शुरू करें:
pip -q install -U "huggingface_hub[hf_xet]" hf-xet
pip -q install -U hf_transfer
ये पैकेज सैकड़ों गीगाबाइट्स के मॉडल शार्ड्स को खींचते समय तेज़ पैरेलल डाउनलोड और बेहतर प्रदर्शन सक्षम करते हैं।
अब इस ट्यूटोरियल में इस्तेमाल किए गए विशेष क्वांटाइज़्ड मॉडल वेरिएंट को डाउनलोड करें। हमें केवल UD-Q2_K_XL फ़ाइलें चाहिए, पूरी अपलोड सेट नहीं:
hf download unsloth/GLM-5-GGUF \
   --local-dir models/GLM-5-GGUF \
   --include "*UD-Q2_K_XL*"
यह मॉडल को सीधे models/GLM-5-GGUF डायरेक्टरी में सेव कर देगा।
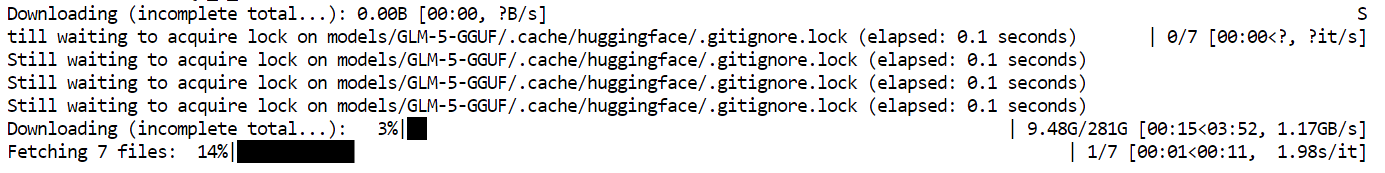
हमारे सेटअप में, डाउनलोड स्पीड लगभग 1.2 GB/s तक पहुँचती है, क्योंकि हमने hf_xet सक्षम किया और पहले Hugging Face टोकन प्रदान किया। अनाम डाउनलोड आमतौर पर बहुत धीमे होते हैं, इसलिए ऑथेंटिकेशन और ट्रांसफ़र एक्सेलेरेशन सेट करना इस स्केल के मॉडलों के साथ काम करते समय बड़ा फ़र्क लाता है।
अब जब मॉडल डाउनलोड हो गया है और llama.cpp CUDA सपोर्ट के साथ कम्पाइल है, तो हम बिल्ट-इन llama-server का उपयोग करके GLM-5 शुरू कर सकते हैं।
सर्वर लॉन्च करने के लिए निम्न कमांड चलाएँ:
./llama.cpp/llama-server \
  --model models/GLM-5-GGUF/UD-Q2_K_XL/GLM-5-UD-Q2_K_XL-00001-of-00007.gguf \
  --alias "GLM-5" \
  --host 0.0.0.0 \
  --port 8080 \
  --jinja \
  --fit on \
  --threads 32 \
  --ctx-size 16384 \
  --batch-size 512 \
  --ubatch-size 128 \
  --flash-attn auto \
  --temp 0.7 \
  --top-p 0.95
यहाँ कुछ महत्वपूर्ण आर्ग्युमेंट समझने योग्य हैं:
--host 0.0.0.0 सर्वर को एक्सपोज़ करता है ताकि आप इसे अपने ब्राउज़र से एक्सेस कर सकें--port 8080 उस पोर्ट से मेल खाता है जिसे हमने पहले Runpod में खोला था--fit on RAM में स्पिल होने से पहले अधिकतम GPU उपयोग सुनिश्चित करता है--ctx-size 16384 इंफ़ेरेंस के लिए कॉन्टेक्स्ट विंडो सेट करता है--flash-attn auto समर्थित होने पर तेज़ attention kernels सक्षम करता हैजब आप सर्वर शुरू करते हैं, तो आप नोटिस करेंगे कि llama.cpp लगभग पूरी उपलब्ध GPU मेमोरी का उपयोग करता है, और शेष मॉडल लेयर्स सिस्टम RAM में ऑफ़लोड हो जाती हैं। यह अपेक्षित है और H200 सेटअप पर अच्छी तरह काम करता है।
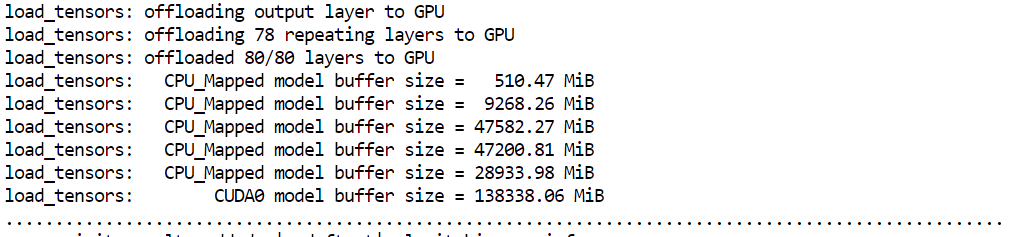
मॉडल एक मिनट से कम समय में लोड होकर सर्व करना शुरू कर देना चाहिए। यदि आपके पॉड में इससे कहीं अधिक समय लगता है, तो इंस्टेंस में कोई समस्या हो सकती है। ऐसे में, पॉड को समाप्त कर एक नया लॉन्च करना आमतौर पर तेज़ रहता है।
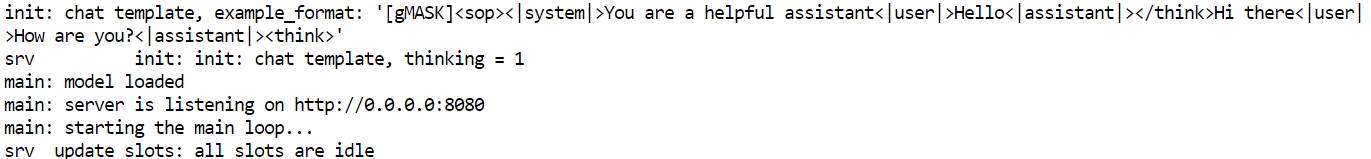
एक बार सर्वर चलने लगे, OpenAI-कम्पैटिबल endpoint को क्वेरी करके सत्यापित करें कि GLM-5 उपलब्ध है:
curl -s http://127.0.0.1:8080/v1/models | jqआपको रिस्पॉन्स में "GLM-5" सूचीबद्ध दिखना चाहिए, जो पुष्टि करता है कि मॉडल लोड हो चुका है और उपयोग के लिए तैयार है।
{
  "models": [
    {
      "name": "GLM-5",
      "model": "GLM-5",
      "modified_at": "",
      "size": "",
      "digest": "",
      "type": "model",
      "description": "",
      "tags": [
        ""
      ],
      "capabilities": [
        "completion"
      ],
      "parameters": "",
      "details": {
        "parent_model": "",
        "format": "gguf",
        "family": "",
        "families": [
          ""
        ],
        "parameter_size": "",
        "quantization_level": ""
      }
    }
  ],
  "object": "list",
  "data": [
    {
      "id": "GLM-5",
      "object": "model",
      "created": 1770900487,
      "owned_by": "llamacpp",
      "meta": {
        "vocab_type": 2,
        "n_vocab": 154880,
        "n_ctx_train": 202752,
        "n_embd": 6144,
        "n_params": 753864139008,
        "size": 281373251584
      }
    }
  ]
}एक बार सर्वर चलने लगे, आप बिल्ट-इन llama.cpp चैट UI के माध्यम से सीधे GLM-5 का परीक्षण कर सकते हैं।
आम तौर पर, WebUI लोकल रूप से यहाँ उपलब्ध होता है: http://127.0.0.1:8080
हालाँकि, चूँकि हम क्लाउड में Runpod पर चला रहे हैं, यह localhost लिंक आपकी मशीन से काम नहीं करेगा।
इसके बजाय, अपने Runpod डैशबोर्ड पर जाएँ और पोर्ट 8080 के लिए HTTP Service लिंक पर क्लिक करें। यह वह सार्वजनिक URL है जो आपके चल रहे llama-server पर ट्रैफ़िक फ़ॉरवर्ड करता है।
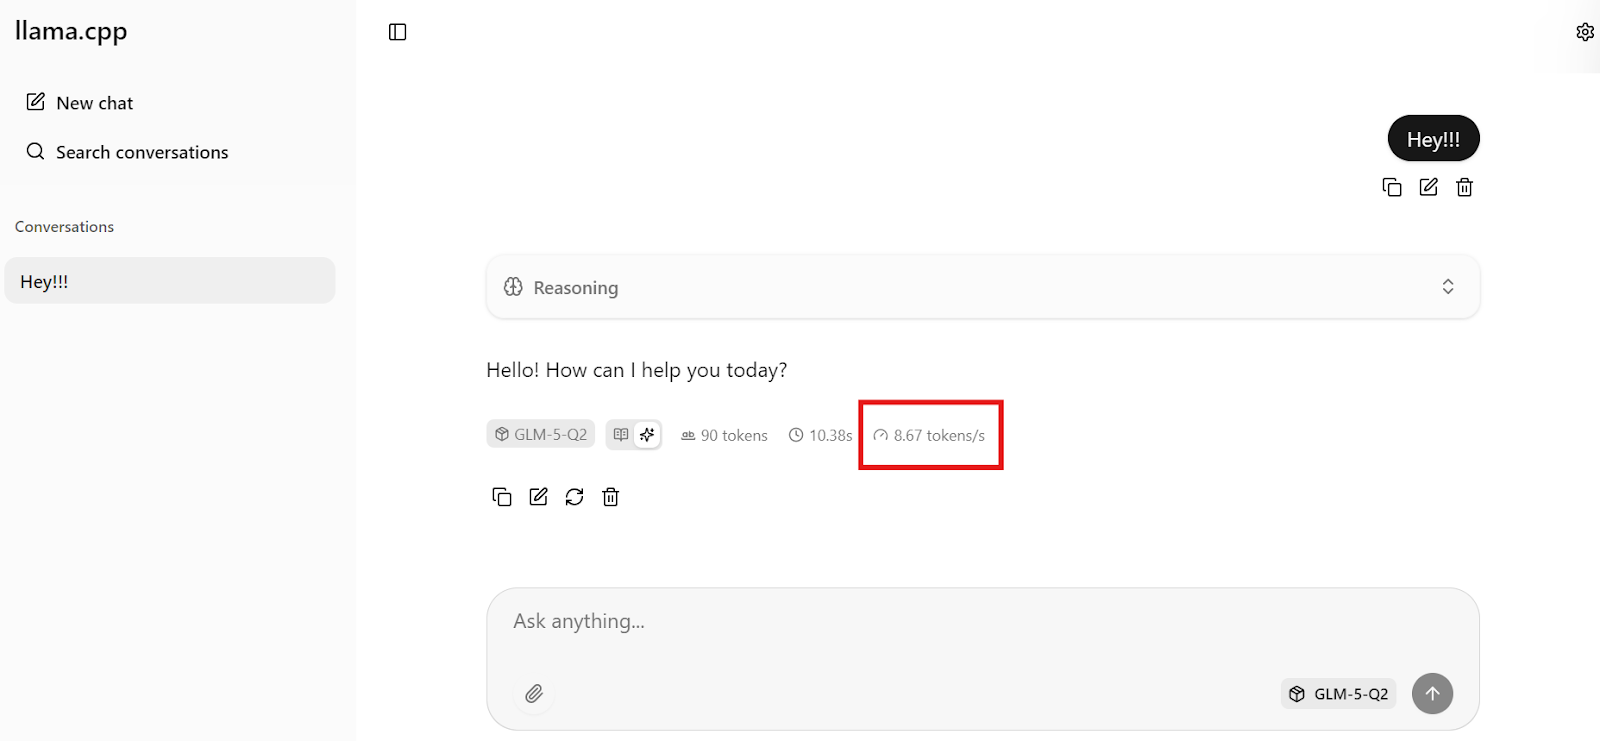
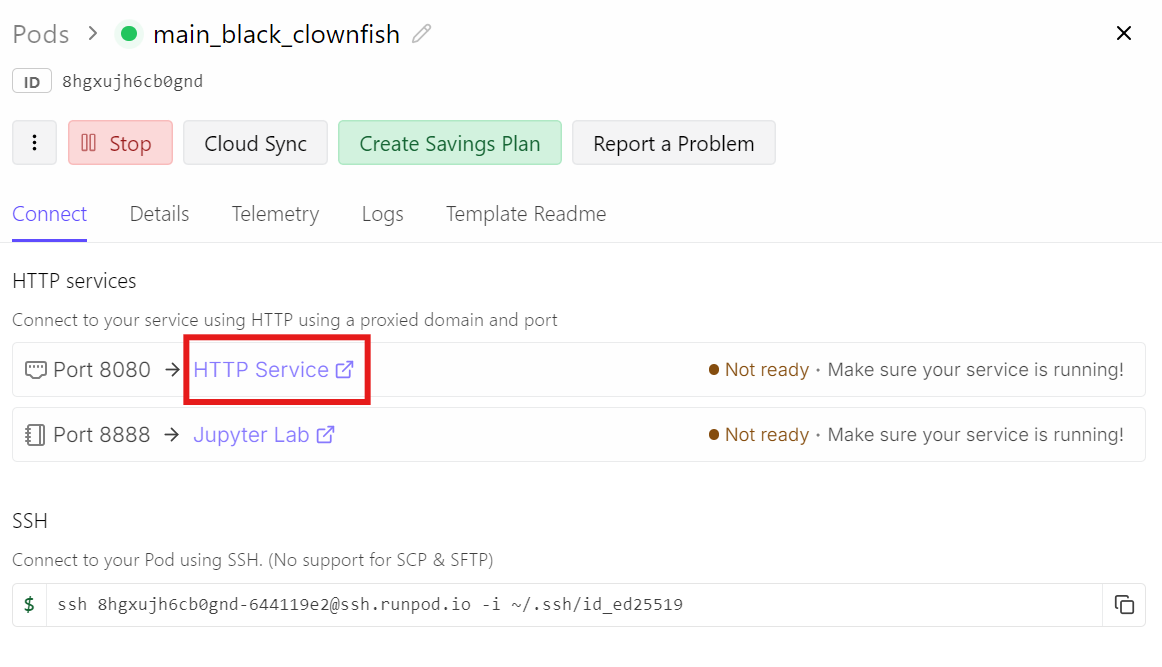 उस लिंक को खोलने से आप चैट UI पर पहुँच जाएँगे, जहाँ GLM-5 मॉडल पहले से लोड और तैयार होगा।
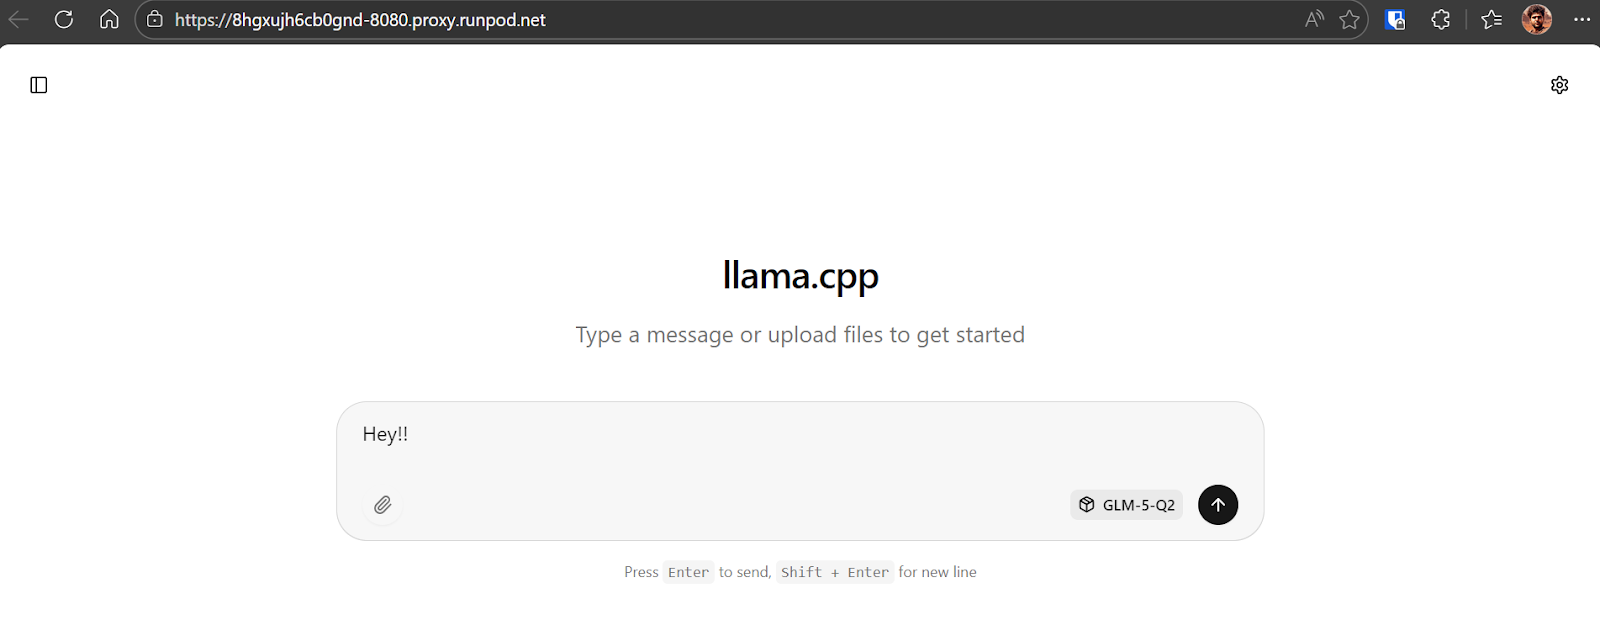
सब कुछ काम कर रहा है, यह पुष्टि करने के लिए “Hey!!” जैसा एक सरल संदेश भेजें। आपको मॉडल तुरंत प्रतिक्रिया देता दिखेगा।
हमारे मामले में, इंफ़ेरेंस लगभग 8.7 टोकन प्रति सेकंड की रफ़्तार से चलता है, जो GLM-5 के आकार और 281GB क्वांटाइज़्ड चेकपॉइंट को देखते हुए उत्कृष्ट प्रदर्शन है।
Aider एक टर्मिनल-आधारित AI पेयर प्रोग्रामिंग टूल है जो सीधे आपके प्रोजेक्ट फ़ोल्डर के भीतर काम करता है।
आप इससे एक कोडिंग पार्टनर की तरह चैट करते हैं, और यह आपके रेपो में फ़ाइलें बना, एडिट और रिफ़ैक्टर कर सकता है, सब कुछ आपकी वास्तविक कोडबेस और git वर्कफ़्लो में ग्राउंडेड रखते हुए।
यह किसी भी OpenAI-कम्पैटिबल API endpoint से कनेक्ट करने का भी समर्थन करता है, जो इसे हमारे लोकल llama.cpp सर्वर के खिलाफ चलाने के लिए एक बेहतरीन विकल्प बनाता है।
पहले, Aider इंस्टॉल करें:
pip install -U aider-chatइसके बाद, Aider को आपके लोकल llama.cpp OpenAI-कम्पैटिबल सर्वर की ओर पॉइंट करें। हम एक डमी की सेट करते हैं क्योंकि llama.cpp को वास्तविक OpenAI की की आवश्यकता नहीं होती:
export OPENAI_API_BASE=http://127.0.0.1:8080/v1
export OPENAI_API_KEY=local
export OPENAI_BASE_URL=$OPENAI_API_BASE
अब एक नया डेमो प्रोजेक्ट फ़ोल्डर बनाएँ (ताकि Aider के पास काम करने के लिए एक क्लीन रेपो हो):
mkdir -p glm5-demo-app
cd glm5-demo-app
अंत में, Aider शुरू करें और पहले एक्सपोज़ किए गए मॉडल एलियस का उपयोग करके GLM-5 से कनेक्ट करें:
aider --model openai/GLM-5 --no-show-model-warningsअब Aider के भीतर आप जो भी पूछेंगे, वह आपके लोकल GLM-5 सर्वर के माध्यम से रूट होगा, और Aider सीधे glm5-demo-app की फ़ाइलों में बदलाव लागू करेगा।
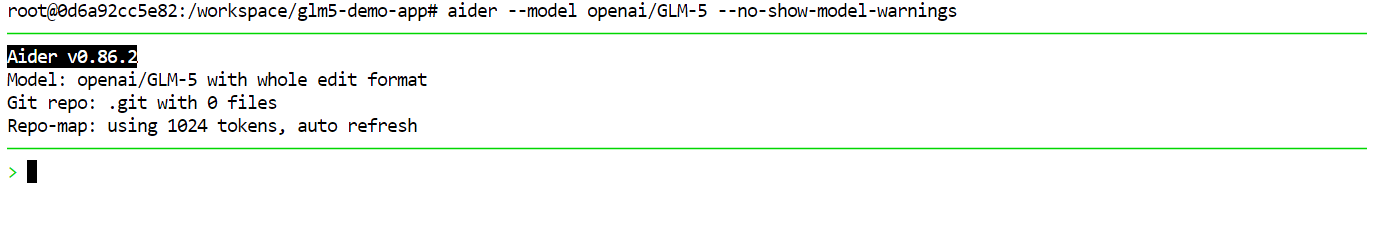 GLM-5 को अपने कोडिंग एजेंट के रूप में इस्तेमाल करें
एक बार Aider GLM-5 से कनेक्ट हो जाए, आप इसे अपने रेपो में एक कोडिंग एजेंट की तरह उपयोग कर सकते हैं। तेज़ प्रतिक्रिया की पुष्टि करने के लिए एक सरल अभिवादन से शुरू करें।
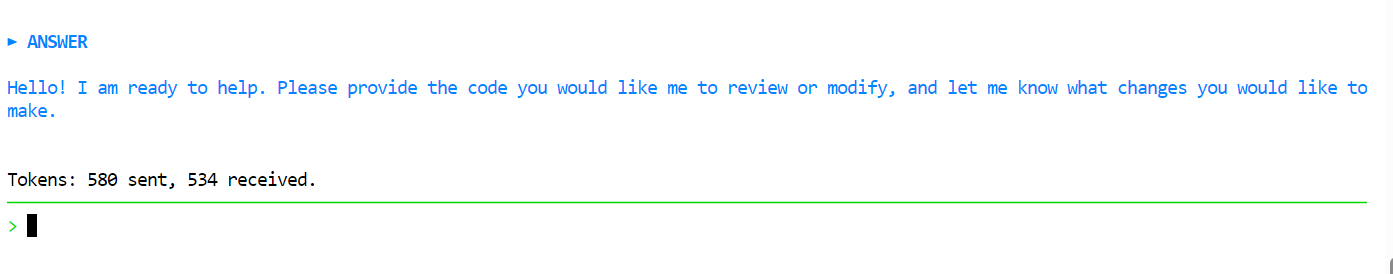
फिर, इसे इस तरह का स्पष्ट टास्क प्रॉम्प्ट दें:
Create a simple Python FastAPI project with one /health endpoint, a README, and instructions to run it locally.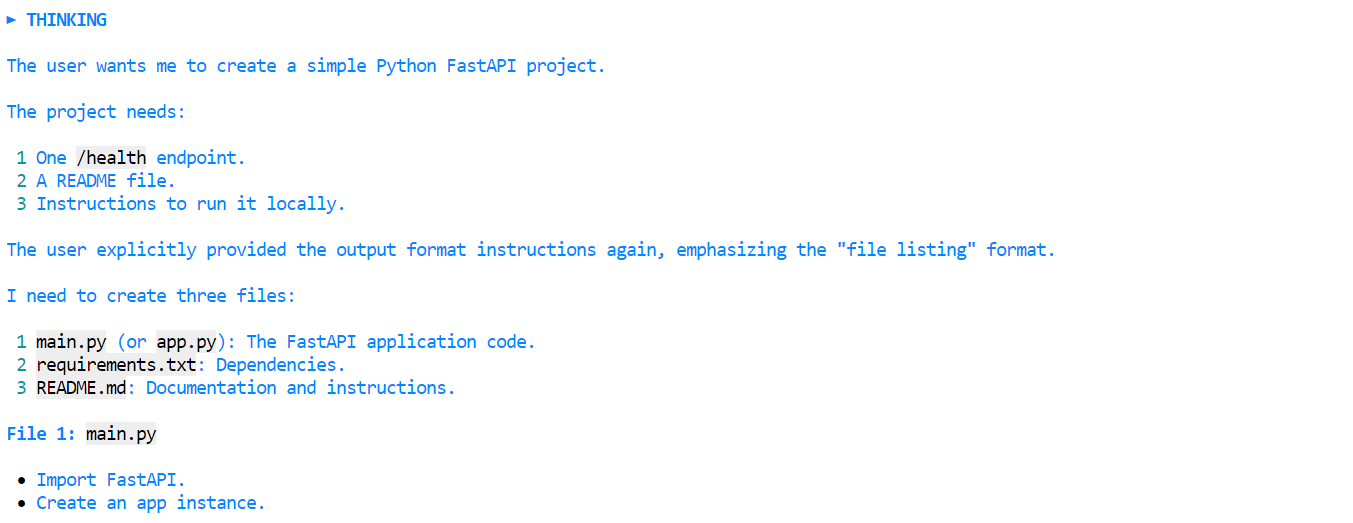
Aider पहले एक योजना प्रस्तावित करेगा, फिर एडिट्स लागू करने की अनुमति मांगेगा।
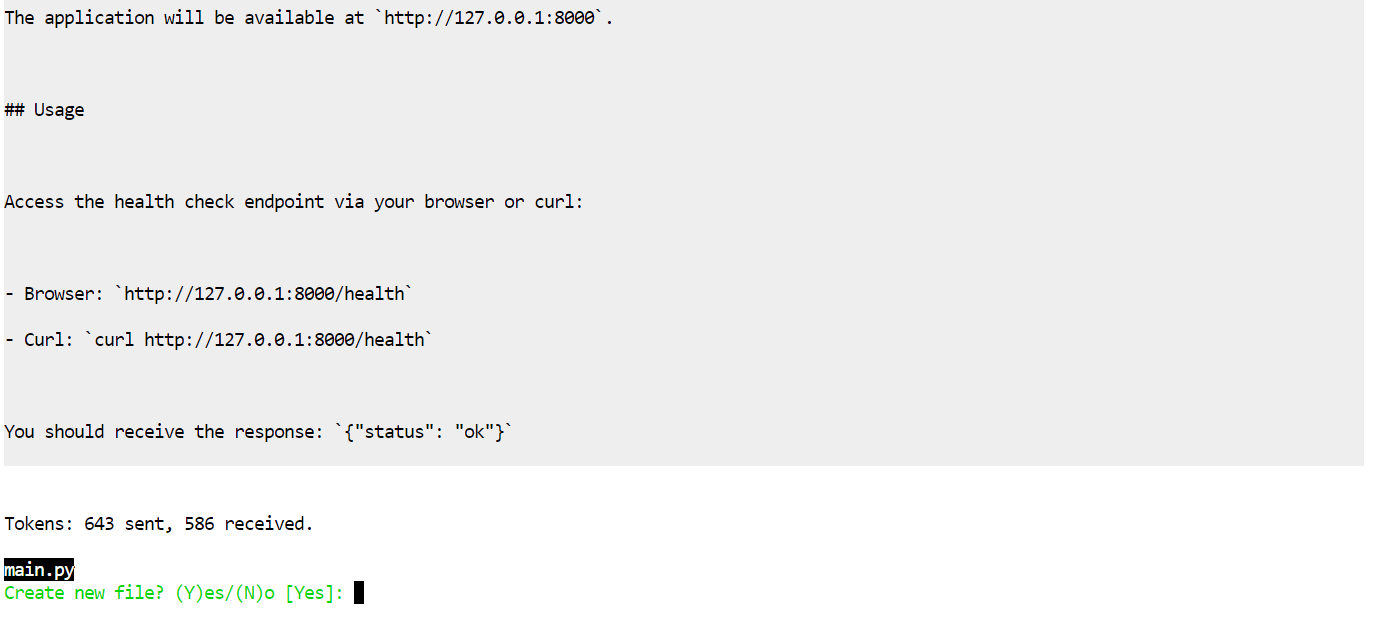
एडिट्स स्वीकार करें, और यह फ़ाइलें स्वतः जेनरेट कर देगा।
2-बिट क्वांट जैसे GLM-5-UD-Q2_K_XL पर, आपको छोटे-छोटे गलतियाँ दिख सकती हैं, उदाहरण के लिए, pip install -r requirements.txt जैसी फ़ाइल बनाना, जो एक गलती है। पूर्ण मॉडल में ऐसी त्रुटियों की संभावना कम होती है, लेकिन 2-बिट मॉडल भी त्वरित मानव समीक्षा के साथ काफी उपयोगी है।
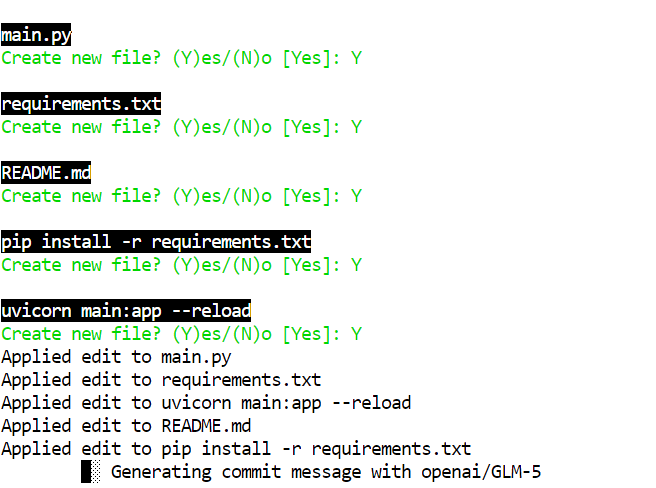
Aider द्वारा प्रोजेक्ट लिखना पूरा होने के बाद, फ़ोल्डर में जाएँ, डिपेंडेंसीज़ इंस्टॉल करें, और सर्वर चलाएँ:
cd glm5-demo-app/pip install -r requirements.txtUvicorn के साथ FastAPI ऐप शुरू करें:
uvicorn main:app --reloadसर्वर पोर्ट 8000 पर चलेगा।
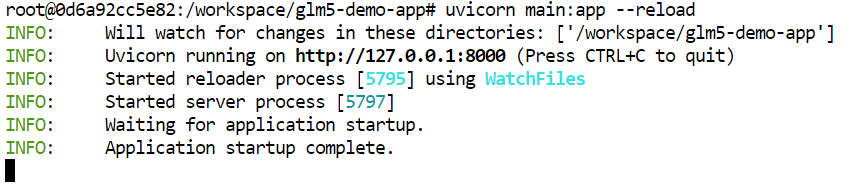
हेल्थ endpoint का परीक्षण करें:
curl -s http://127.0.0.1:8000/healthआपको यह मिलना चाहिए:
{"status":"ok"}GLM-5 तेजी से AI समुदाय में सबसे अधिक चर्चा किए जाने वाले ओपन-वेट मॉडलों में से एक बन रहा है, खासकर क्योंकि यह डीप रीज़निंग, एजेंटिक वर्कफ़्लोज़ और कोडिंग कार्यों के लिए डिज़ाइन होते हुए, ओपन-सोर्स प्रदर्शन को मालिकाना मॉडलों के क़रीब धकेल देता है।
सारी चर्चा के बावजूद, पूर्ण-स्केल मॉडलों को लोकल रूप से चलाना सामान्य उपयोगकर्ताओं के लिए अभी भी चुनौती है.
क्वांटाइज़ेशन के बावजूद, GLM-5 जैसे मॉडलों को सैकड़ों गीगाबाइट मेमोरी और तेज़ GPUs की आवश्यकता होती है—ऐसी चीजें जो कई व्यक्तियों के पास घर के मशीनों पर नहीं होतीं।
इसका मतलब है कि अधिकांश लोग या तो क्लाउड GPU पॉड्स (जैसे इस ट्यूटोरियल में H200 सेटअप) पर निर्भर करते हैं या होस्टेड API सेवाएँ उपयोग करते हैं।
GLM-5 का ओपन-वेट स्वरूप शक्तिशाली है क्योंकि यह आपको मालिकाना API प्रदाताओं पर निर्भर हुए बिना अपना स्वयं का इंस्टेंस होस्ट और नियंत्रित करने देता है, लेकिन यह यह भी रेखांकित करता है कि AI में ओपन सोर्स का अर्थ जादुई रूप से “हर किसी के लैपटॉप पर चलता है” नहीं होता।
इस ट्यूटोरियल में, हमने देखा कि कैसे Runpod H200 GPU पर GLM-5 के 2-बिट क्वांटाइज़्ड वर्शन का उपयोग करके उन हार्डवेयर बाधाओं को पार किया जा सकता है। हमने वातावरण सेटअप, CUDA सपोर्ट के साथ llama.cpp कम्पाइल करना, मॉडल को कुशलतापूर्वक डाउनलोड करना, इंफ़ेरेंस सर्वर लॉन्च करना, ब्राउज़र UI के माध्यम से उसका परीक्षण करना, और अंत में Aider जैसे कोडिंग टूल को कनेक्ट करना देखा ताकि GLM-5 को वास्तविक डेवलपमेंट कार्यों के लिए एजेंट की तरह उपयोग किया जा सके।
शीर्ष AI पाठ्यक्रम
लर्निंग पाथ