
{count, plural, one {Corso} other {Corsi}}
Distribuzioni di probabilità multivariate in R
{hours} ore
8.9K
A volte devi prevedere più cose contemporaneamente, per esempio stimare sia le vendite sia il churn dei clienti usando gli stessi dati.
In questo articolo, ti insegnerò a fare multi-tasking in questo modo. Ti parlerò della regressione lineare multivariata: cos’è, come funziona, quando usarla e come applicarla in pratica. Alla fine, sarai pronto a usarla su problemi reali.
Se sei alle prime armi con la regressione, potresti voler ripassare prima la nostra Introduzione alla regressione in R o l’Introduzione alla regressione con statsmodels in Python.
La regressione lineare multivariata è una tecnica statistica che modella la relazione tra più variabili indipendenti e più variabili dipendenti. A volte viene confusa con la regressione lineare multipla perché suona simile, e anch’io le ho confuse in passato. Ma la regressione lineare multipla usa diversi predittori per stimare un singolo esito, mentre la multivariata è pensata per situazioni in cui devi prevedere più di un esito nello stesso momento.
Ti ho appena dato una panoramica su cos’è la regressione multivariata e quando usarla. Ora passiamo a come è strutturato il modello e su quali assunzioni si basa.
La regressione multivariata usa un’impostazione basata su matrici per modellare più esiti contemporaneamente:
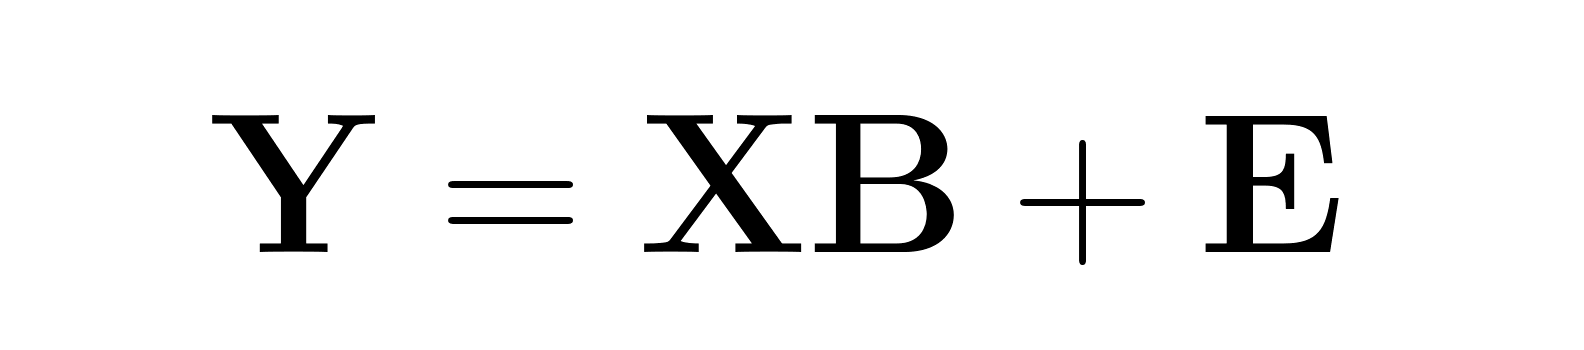
Dove:
Questo approccio riconosce che i termini di errore per diverse variabili risposta possono essere correlati, portando a una stima dei parametri più efficiente rispetto a modelli univariati separati.
Prima di usare il modello, è importante capire quali assunzioni devono valere—e cosa fare se non valgono.
Se queste assunzioni non tengono, dovrai adattarti. Ad esempio, prova a trasformare le variabili per affrontare problemi di non linearità o normalità, passa ai minimi quadrati ponderati per gestire l’eteroschedasticità, oppure usa la ridge regression per problemi di collinearità.
Se lavori con variabili categoriche, devi prima convertirle in variabili dummy.
Per una variabile categorica con k categorie, crea k-1 variabili dummy. Questo evita la ridondanza, nota come “dummy variable trap”. La categoria esclusa diventa il livello di riferimento. I coefficienti rifletteranno quindi la differenza rispetto a quella baseline. Vale la pena sceglierne una che renda l’interpretazione semplice.
Definita la struttura del modello e le assunzioni, vediamo come vengono stimati i coefficienti e come i diversi metodi si confrontano in termini di efficienza e accuratezza.
OLS è il punto di partenza predefinito e si estende naturalmente a contesti multivariati. Fornisce stime non distorte dei coefficienti finché le assunzioni sono rispettate. Sebbene le stime individuali coincidano con quelle ottenute eseguendo regressioni separate, il vantaggio qui è che i residui sono condivisi, quindi puoi testare ipotesi congiunte tra gli esiti.
Nei casi in cui gli esiti sono correlati, l’OLS multivariato cattura tali relazioni, spesso (ma non sempre) migliorando la qualità complessiva delle previsioni.
Potresti chiederti perché l’OLS sia così usato. Lo spiega il teorema di Gauss-Markov: sotto certe assunzioni, l’OLS è il Best Linear Unbiased Estimator (BLUE). Significa che ti dà la varianza minima possibile tra tutti gli stimatori lineari non distorti, assumendo che valgano le condizioni usuali come assenza di multicollinearità, relazioni lineari e varianza costante.
Ma cosa succede se quelle condizioni non tengono, in particolare quella della varianza costante? In questo caso, considero i WLS. Assegnano più peso alle osservazioni con varianza dell’errore più bassa e meno a quelle più rumorose.
I WLS modificano il processo OLS aggiungendo una matrice di pesi. Puoi stimare i pesi usando i residui di un modello OLS o basandoti su conoscenze teoriche sulla struttura d’errore dei tuoi dati.
Passiamo agli scenari con dati ad alta dimensionalità o multicollinearità. I metodi di shrinkage sono utili qui. Accettano un po’ di bias in cambio di una riduzione della varianza, il che spesso aiuta nella previsione.
La ridge regression aggiunge una penalizzazione L2 (λ||B||²), riducendo tutti i coefficienti verso zero. È utile quando ogni predittore potrebbe dare un contributo. LASSO applica una penalizzazione L1 che può azzerare del tutto alcuni coefficienti—utile per la selezione delle variabili. Elastic net combina entrambe, aiutando quando i predittori sono correlati e svolgendo al contempo selezione.
Ora che abbiamo coperto la stima, vediamo come valutare le prestazioni del modello e come trarne conclusioni significative.
L’R-quadro multivariato ti dà un’idea di quanta variabilità complessiva il tuo modello spiega sull’insieme degli esiti. A differenza della versione univariata, spesso usa il determinante della matrice di covarianza dei residui e potrebbe non restare sempre tra 0 e 1.
L’R-quadro aggiustato è particolarmente importante nei contesti multivariati perché il numero di parametri cresce rapidamente con più esiti. Aiuta a evitare l’overfitting penalizzando la complessità.
Strumenti visivi come le ellissi di confidenza possono essere utili. Queste ellissi mostrano l’incertezza nelle previsioni e come le variabili di esito si relazionano tra loro. Ellissi circolari suggeriscono indipendenza; ellissi allungate indicano forti correlazioni.
Quando vuoi sapere se il tuo modello fa più che adattarsi al rumore, i test d’ipotesi sono fondamentali.
La Lambda di Wilks verifica se specifici predittori hanno effetti significativi sull’insieme degli esiti. Confronta le matrici di covarianza degli errori del modello completo e di uno ridotto per determinare se rimuovere certi predittori aumenterebbe significativamente la varianza non spiegata.
Il T² di Hotelling funziona come un test t multivariato. Valuta se un predittore specifico influenza almeno un esito, considerando le correlazioni tra gli esiti.
I test congiunti aiutano a gestire il rischio di falsi positivi quando si testano più ipotesi contemporaneamente. Questo è utile nella regressione multivariata, dove i confronti multipli possono rapidamente sfuggire di mano.
Per decidere tra modelli, tornano utili criteri come AIC e BIC . Entrambi correggono per la complessità, cosa particolarmente importante quando si modellano esiti multipli. L’AIC punta più sulla capacità predittiva, mentre il BIC tende a favorire modelli più semplici.
Puoi anche usare i test di rapporto di verosimiglianza per confrontare modelli annidati. Verificano se aggiungere predittori migliora significativamente l’adattamento del modello.
La regressione multivariata standard funziona bene per molti problemi, ma a volte ti imbatterai in situazioni che richiedono approcci specializzati. Magari hai a che fare con centinaia di predittori, o le tue variabili si influenzano a vicenda in modi che violano le assunzioni standard. Ecco come gestire (alcuni di) questi scenari più complessi.
Quando lavori con molti predittori, la selezione delle feature diventa essenziale sia per le prestazioni sia per l’interpretabilità. LASSO (acronimo di “Least Absolute Shrinkage and Selection Operator”) spicca perché può azzerare automaticamente i predittori irrilevanti durante la stima del modello.
A differenza della ridge regression, che riduce tutti i coefficienti verso zero ma li mantiene tutti, LASSO usa una penalizzazione L1 che produce soluzioni sparse. È molto utile quando sospetti che solo un sottoinsieme dei tuoi predittori conti davvero.
A volte i tuoi predittori influenzano gli esiti mentre sono simultaneamente influenzati da essi. Penso a come l’istruzione influisca sul reddito, ma il reddito influenzi anche l’accesso all’istruzione. Questo crea la cosiddetta endogeneità, che rende inaffidabili le stime della regressione standard.
Le variabili strumentali risolvono questo con un processo in due fasi. Per prima cosa, trovi uno “strumento”, cioè una variabile che influisce sul tuo predittore problematico ma non influisce direttamente sull’esito. Poi usi questo strumento per prevedere la parte “pulita” del predittore e usi quelle previsioni nella regressione finale. Questo dovrebbe spezzare o attenuare la relazione circolare e darti stime affidabili o più affidabili.
La maggior parte dei pacchetti statistici gestisce la regressione multivariata, seppur con punti di forza diversi. In Python, sklearn.linear_model. supporta nativamente esiti multipli per una vera regressione multivariata. A mio avviso, statsmodels fornisce output statistici più dettagliati, inclusi i test d’ipotesi. Se sei uno di quei programmatori che preferisce il linguaggio R, puoi usare direttamente la funzione integrata lm() per modelli multivariati di base, oppure il pacchetto car per diagnostiche più sofisticate.
Il Partial Least Squares (PLS) torna utile quando hai più predittori che osservazioni, o quando la multicollinearità crea problemi. Invece di usare direttamente tutti i predittori, il PLS crea variabili latenti che catturano le informazioni più rilevanti per prevedere gli esiti. Questo approccio funziona particolarmente bene in campi come la chemometria e la bioinformatica, dove potresti avere centinaia o migliaia di predittori ma relativamente poche osservazioni.
Il PLS trova direzioni nello spazio dei predittori che spiegano sia la varianza dei predittori sia la covarianza degli esiti. È particolarmente utile quando l’accuratezza predittiva conta più dell’interpretazione. La regressione lineare multipla standard può diventare instabile con molti predittori correlati, mentre il PLS resta ben comportato anche in situazioni complesse.
I semplici intervalli di confidenza non funzionano bene per previsioni multivariate perché ignorano le correlazioni tra esiti. Le ellissi di confidenza mostrano l’incertezza congiunta per coppie di esiti, rivelando come gli errori di previsione siano correlati tra diverse variabili risposta. Queste ellissi dicono molto sulla struttura delle relazioni nelle tue previsioni. Ellissi circolari indicano che i tuoi esiti sono previsti in modo indipendente, mentre ellissi allungate indicano forti correlazioni.
L’orientamento delle ellissi allungate mostra quali combinazioni lineari di esiti hanno più e meno incertezza. Puoi tracciarle per previsioni individuali o per le stime dei parametri, e sono utili quando presenti i risultati perché offrono una rappresentazione visiva intuitiva di quanto dovresti essere confidente in diversi aspetti delle tue previsioni.
Passare dalla teoria alla pratica significa gestire dati disordinati e assicurarsi che il modello funzioni davvero. Ecco come affrontare il lato pratico della regressione multivariata.
Prima di adattare qualsiasi modello multivariato, devi mettere in ordine i dati. Scalare e centrare è particolarmente importante quando i predittori hanno unità diverse. Immagina di confrontare reddito (in migliaia) con età (in anni) senza standardizzazione. La maggior parte degli algoritmi funziona meglio quando le feature sono su scale simili.
I valori mancanti rappresentano un’altra sfida. Puoi eliminare le righe con dati mancanti, ma sprechi informazioni e puoi introdurre bias. Approcci migliori includono l’imputazione della media per variabili numeriche o metodi più sofisticati come l’imputazione multipla, che crea diversi dataset plausibili e combina i risultati tra di essi.
La cross-validation ti aiuta a capire quanto bene il tuo modello generalizza oltre i dati di training. Per la regressione multivariata, la k-fold cross-validation funziona dividendo i dati in k gruppi, addestrando su k-1 gruppi e testando su quello rimanente. Ripeti k volte e media i risultati per ottenere una stima robusta delle prestazioni.
Il bootstrapping offre un altro approccio di validazione che è particolarmente utile per comprendere l’incertezza dei parametri. Crea nuovi dataset campionando con reinserimento dai dati originali, adatta modelli a ciascun campione bootstrap ed esamina la distribuzione delle stime dei parametri. Questo ti dice quanto sono stabili i coefficienti e aiuta a costruire intervalli di confidenza.
Vediamo un esempio concreto usando un dataset di test sui materiali. Gli ingegneri spesso devono prevedere più proprietà del calcestruzzo—come resistenza a compressione e lavorabilità—in base ai componenti della miscela come contenuto di cemento, rapporto acqua e tipo di aggregato. Ha perfettamente senso usare la regressione multivariata, dato che questi esiti sono correlati ma distinti.
L’analisi parte dall’esplorare le correlazioni tra componenti della miscela ed esiti, verificare la multicollinearità tra i predittori ed esaminare se le relazioni appaiono lineari. Dopo il preprocessing (scalare i rapporti della miscela e gestire eventuali misurazioni mancanti), adatteresti il modello multivariato e lo valideresti con cross-validation per assicurarti che le previsioni reggano su nuove miscele di calcestruzzo.
Ecco un workflow di base che mostra i passaggi chiave in Python. Per prima cosa, impostiamo i dati e gestiamo il preprocessing:
import numpy as np
import pandas as pd
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import cross_val_score
from sklearn.metrics import mean_squared_error

# Load and prepare data (assuming concrete dataset)
# X: mixture components (cement, water, aggregate, etc.)
# y: multiple outcomes (strength, workability, durability)
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
Questo passaggio di preprocessing standardizza tutti i predittori per avere media zero e varianza unitaria, cosa che aiuta con la stabilità numerica e l’interpretazione.
Poi adatteremo il modello multivariato ed esamineremo i risultati:
# Fit multivariate regression
mlr_model = LinearRegression()
mlr_model.fit(X_scaled, y)

# Get coefficients for each outcome
for i, outcome in enumerate(['strength', 'workability', 'durability']):
   coeffs = mlr_model.coef_[:, i]
   print(f"{outcome} coefficients: {coeffs}”)
Il modello LinearRegression adatta un’unica regressione multivariata che considera le correlazioni tra tutti gli esiti contemporaneamente. I coefficienti ti dicono come ciascun componente della miscela influisce su ciascuna proprietà del calcestruzzo.
Infine, validiamo il modello per verificarne l’affidabilità:
# Cross-validation for each outcome
cv_scores = cross_val_score(mlr_model, X_scaled, y,
                           cv=5, scoring='neg_mean_squared_error')
print(f"Average CV score: {-cv_scores.mean():.3f}")

# Make predictions on new data
y_pred = mlr_model.predict(X_scaled)
mse_per_outcome = [mean_squared_error(y[:, i], y_pred[:, i])
                   for i in range(y.shape[1])]
print(f"MSE per outcome: {mse_per_outcome}")
La cross-validation ti dà una stima onesta di quanto bene il modello performa su dati non visti. Gli MSE per esito ti aiutano a capire quali proprietà del calcestruzzo sono più facili o difficili da prevedere con accuratezza.
La regressione lineare multivariata funziona bene per molti problemi, ma ha limiti chiari. Il più grande è già nel nome—presuppone relazioni lineari tra predittori ed esiti. Quando le relazioni sono curve, ricche di interazioni o comunque non lineari, la MLR produrrà risultati distorti. L’alta dimensionalità crea un altro problema: con molti predittori rispetto alle osservazioni, il modello diventa instabile e incline all’overfitting.
Diverse alternative possono gestire meglio questi limiti. I modelli lineari generalizzati (GLM) estendono il framework a esiti non normali e consentono link function diverse. L’ANCOVA funziona bene quando hai sia predittori continui sia categorici con effetti di interazione. Per problemi di overfitting, aiutano i metodi di regolarizzazione come ridge e LASSO, oppure puoi provare metodi ensemble come i random forest, che gestiscono non linearità e alta dimensionalità in modo più naturale.
La regressione lineare multivariata ti offre un modo solido per modellare simultaneamente esiti multipli correlati, catturando relazioni che modelli univariati separati perderebbero. I suoi punti di forza principali sono l’interpretabilità, le capacità di test statistici e l’efficienza nel gestire esiti correlati.
Che tu resti sulla MLR standard o passi ad approcci come la regressione regolarizzata, il partial least squares e i metodi ensemble dipende dalle caratteristiche dei dati, dalla dimensione del campione e dal fatto che per il tuo problema conti di più la previsione o l’interpretazione.
Se vuoi fare un passo avanti, il nostro corso Intermediate Regression with statsmodels in Python tratta variabili esplicative multiple ed effetti di interazione, mentre Generalized Linear Models in R amplia la tua cassetta degli attrezzi per gestire distribuzioni non normali come la distribuzione binomiale e la distribuzione di Poisson per i conteggi.
Impara con DataCamp
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min



