Stel, je wilt huizenprijzen voorspellen op basis van het woonoppervlak. Je hebt datapunten van recente verkopen, maar ze vormen geen perfect patroon. Sommige huizen verkopen voor meer dan verwacht, andere voor minder. Hoe vind je de beste trendlijn die de algemene relatie tussen grootte en prijs weergeeft, zonder je voorspelling te laten ontsporen door individuele uitschieters?
De methode van de kleinste kwadraten is misschien precies wat je nodig hebt. In dit artikel verkennen we de kernconcepten van de methode van de kleinste kwadraten, de varianten en toepassingen. Aan het eind heb je een stevig begrip van hoe je deze methode gebruikt en toepast op echte problemen.
Wat is de methode van de kleinste kwadraten?
De methode van de kleinste kwadraten is een statistische techniek om de best passende lijn of kromme voor een set datapunten te bepalen. Ze werkt door de gekwadrateerde verschillen tussen de geobserveerde en voorspelde waarden in een dataset te minimaliseren. Het verschil tussen de werkelijke datapunten en de door het model voorspelde waarden noemen we residuen. Het doel is een model te vinden dat de som van deze gekwadrateerde residuen minimaliseert, wat leidt tot zo nauwkeurig mogelijke voorspellingen.
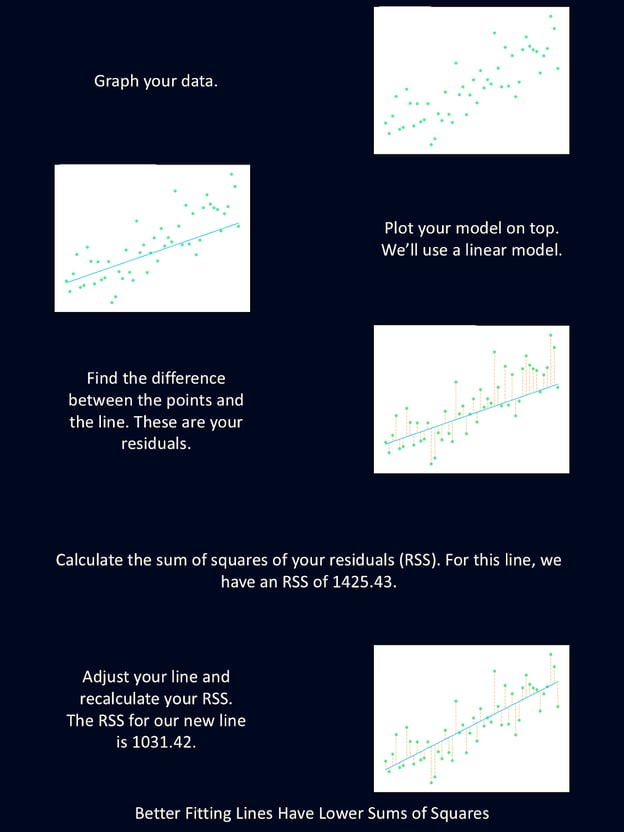
Het bovenstaande diagram geeft een korte uitleg van de stappen van de methode van de kleinste kwadraten.
Deze methode werd in 1795 afgeleid door de 18-jarige Carl Friedrich Gauss (je herkent zijn naam misschien van de Gauss-verdeling). Adrien-Marie Legendre formaliseerde de techniek later in 1805 en was de eerste die een paper schreef waarin hij de methode van de kleinste kwadraten gebruikte om de baan van een planetoïde te reconstrueren.
Hoe de methode van de kleinste kwadraten werkt
De methode van de kleinste kwadraten vindt de lijn die het best bij een set punten past door de som van de gekwadrateerde verschillen te minimaliseren tussen de geobserveerde waarden en de voorspelde waarden. Dit wordt gebruikt om de modelparameters met de best mogelijke aansluiting te vinden.
Laten we dit proberen met een extreem kleine dataset: slechts 10 punten. Eerst moeten we een model kiezen om onze data te fitten. Voor dit eenvoudige voorbeeld kiezen we een eenvoudige lineaire regressie, wat betekent dat we een regressie uitvoeren met precies één onafhankelijke en één afhankelijke variabele.
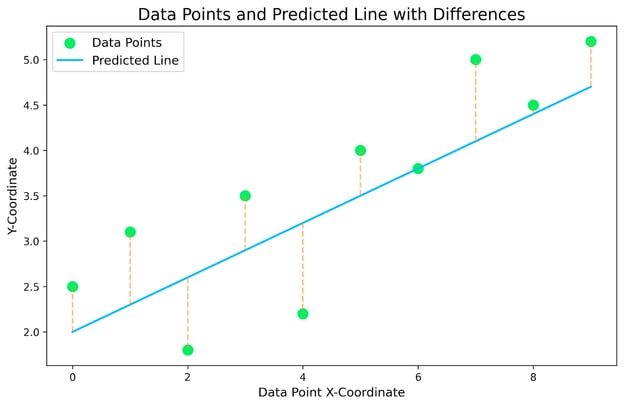
De bovenstaande grafiek toont onze kleine dataset, met daaroverheen een lineaire regressie. De gele gestippelde lijnen die de datapunten met de voorspelde lijn verbinden, zijn de residuen. Het doel is het lineaire regressiemodel te vinden dat deze gele gestippelde residulijnen minimaliseert.
Voor elk datapunt in onze dataset moeten we het verschil in y-coördinaten vinden tussen het datapunt en de lijn. Dit zijn onze residuen. Vervolgens kwadrateren we elk residu om eventuele negatieve getallen weg te nemen en nemen we de totale som. Zo krijgen we een idee van hoe goed onze lijn bij de data past. Bekijk de tabel hieronder voor de uitsplitsing voor onze specifieke grafiek.
|
X-coördinaat
|
Geobserveerde Y-coördinaat (datapunt)
|
Voorspelde Y-coördinaat (lijn)
|
Residuen (geobserveerd - voorspeld)
|
Gekwadrateerde residuen
|
|
0
|
2.5
|
2.0
|
0.5
|
0.25
|
|
1
|
3.1
|
2.3
|
0.8
|
0.64
|
|
2
|
1.8
|
2.6
|
-0.8
|
0.64
|
|
3
|
3.5
|
2.9
|
0.6
|
0.36
|
|
4
|
2.2
|
3.2
|
-1.0
|
1.0
|
|
5
|
4.0
|
3.5
|
0.5
|
0.25
|
|
6
|
3.8
|
3.8
|
0.0
|
0.0
|
|
7
|
5.0
|
4.1
|
0.9
|
0.81
|
|
8
|
4.5
|
4.4
|
0.1
|
0.01
|
|
9
|
5.2
|
4.7
|
0.5
|
0.25
|
|
Som van gekwadrateerde residuen
| | | |
4.21
|
Nu we een idee hebben hoe goed deze lijn bij onze data past, kunnen we de parameters van de lijn, de helling of het snijpunt, aanpassen en onze berekeningen opnieuw uitvoeren. De lijn met de laagste som van gekwadrateerde residuen past het best bij onze data. Die lijn levert dus de beste voorspellingen op.
De methode van de kleinste kwadraten gebruiken om de beste lijn te vinden
In het bovenstaande voorbeeld hebben we niet de best passende lijn gevonden. We hebben alleen berekend hoe goed die lijn bij de data past. We zouden nu door een heleboel mogelijke lijnen kunnen itereren en dezelfde berekening uitvoeren om te vinden welke het best past. Of we kunnen een beetje algebra gebruiken om sneller bij de beste lijn te komen. Laten we dat doen.
We beginnen met de vergelijking voor de lineaire regressie: y=mx+b, waarbij b het snijpunt met de y-as is en m de helling. Laten we nu wat data verzinnen.
|
X-coördinaat
|
Y-coördinaat
|
|
0
|
2.5
|
|
1
|
3.1
|
|
2
|
1.8
|
|
3
|
3.5
|
|
4
|
2.2
|
|
5
|
4.0
|
|
6
|
3.8
|
|
7
|
5.0
|
|
8
|
4.5
|
|
9
|
5.2
|
Eerst moeten we het gemiddelde van de X- en Y-waarden berekenen. Dit zijn onze voorspelde waarden:
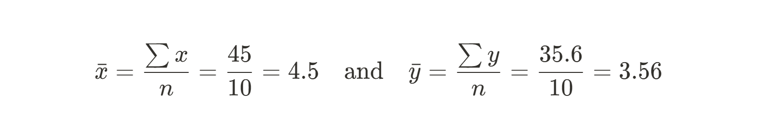
Vervolgens kunnen we de som van de kwadraten van onze residuen tussen elk datapunt en onze voorspelde waarde (het gemiddelde) gebruiken om de helling te vinden. Dit is de vergelijking die we gebruiken:
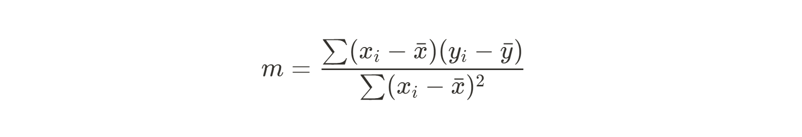
Omdat dit een vrij onhandige vergelijking is om met de hand te doen, berekenen we de teller en noemer apart. Laten we beginnen met de teller:
|
xi
|
yi
|
xi - xgemiddelde
|
yi - ygemiddelde
|
(xi - xgemiddelde)(yi -ygemiddelde)
|
|
0
|
2.5
|
-4.5
|
-1.06
|
4.77
|
|
1
|
3.1
|
-3.5
|
-0.46
|
1.61
|
|
2
|
1.8
|
-2.5
|
-1.76
|
4.40
|
|
3
|
3.5
|
-1.5
|
-0.06
|
0.09
|
|
4
|
2.2
|
-0.5
|
-1.36
|
0.68
|
|
5
|
4.0
|
0.5
|
0.44
|
0.22
|
|
6
|
3.8
|
1.5
|
0.24
|
0.36
|
|
7
|
5.0
|
2.5
|
1.44
|
3.60
|
|
8
|
4.5
|
3.5
|
0.94
|
3.29
|
|
9
|
5.2
|
4.5
|
1.64
|
7.38
|
|
Som van (xi - xgemiddelde)(yi - ygemiddelde)
| | | |
26.4
|
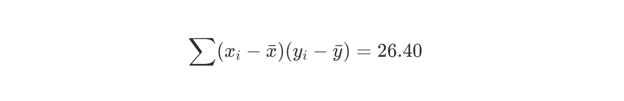
Laten we nu hetzelfde doen voor de noemer:
|
xi
|
xi - xgemiddelde
|
(xi - xgemiddelde)2
|
|
0
|
-4.5
|
20.25
|
|
1
|
-3.5
|
12.25
|
|
2
|
-2.5
|
6.25
|
|
3
|
-1.5
|
2.25
|
|
4
|
-0.5
|
0.25
|
|
5
|
0.5
|
0.25
|
|
6
|
1.5
|
2.25
|
|
7
|
2.5
|
6.25
|
|
8
|
3.5
|
12.25
|
|
9
|
4.5
|
20.25
|
|
Som van (xi - xgemiddelde)2
| |
82.50
|
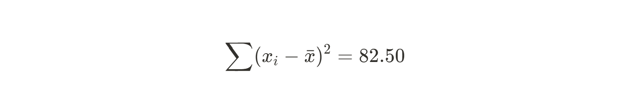
Nu kunnen we de helling voor onze best passende lijn berekenen.
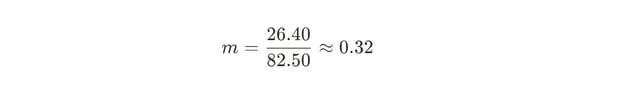
We weten nu dus de helling van de lijn die het best bij onze data past. Vervolgens moeten we het snijpunt met de y-as vinden. De formule voor het snijpunt b is eenvoudig te vinden met een beetje algebraïsch herschikken:
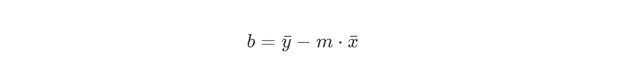
Omdat we de helling al kennen, kunnen we eenvoudig ons gemiddelde van x en y invullen en b oplossen.
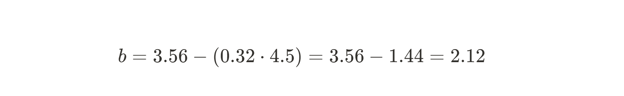
Nu we zowel m als b hebben, kunnen we de vergelijking van de best passende lijn opschrijven:
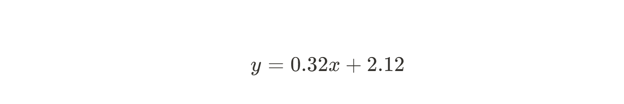
De methode van de kleinste kwadraten stelde ons in staat om snel en eenvoudig de beste lineaire regressielijn af te leiden, zelfs met de hand! Natuurlijk geldt: hoe meer data je hebt, hoe lastiger dit met de hand wordt. Gelukkig is de wiskunde vrij rechttoe-rechtaan, dus het is heel eenvoudig om deze methode te implementeren in Python of R. Voor gedetailleerde uitleg bekijk je Essentials of Linear Regression in Python en How to Do Linear Regression in R.
Wiskundige fundamenten van de methode van de kleinste kwadraten
Hierboven gebruikten we een voorbeeld met eenvoudige lineaire regressie en vonden we de helling en het snijpunt met behulp van prettige gesloten-formule vergelijkingen, en we modelleerden de afhankelijke variabele als een functie van de onafhankelijke variabele: y=mx+b.
De vergelijkingen die ik hierboven liet zien, werken echter alleen wanneer je één onafhankelijke variabele hebt. Een andere manier om de coëfficiënten voor een regressie te vinden is met de zogeheten normale vergelijking, die een matrixgebaseerde oplossing voor het probleem van de kleinste kwadraten biedt. De normale vergelijking verwijst naar de matrixvergelijking die ontstaat door de som van gekwadrateerde residuen te minimaliseren met de methode van de kleinste kwadraten. Geometrisch, en in de taal van lineaire algebra, kan de oplossing van de kleinste kwadraten worden gezien als de orthogonale projectie van de geobserveerde datavector op de kolomruimte van de modelmatrix. Simpel gezegd betekent dit dat de fouten zo worden geminimaliseerd dat de voorspelde waarden zo dicht mogelijk bij de geobserveerde data liggen, gegeven de beperkingen van het model.
In gevallen waarin de matrix niet inverteerbaar is (wat betekent dat het stelsel vergelijkingen geen unieke oplossing heeft), biedt de Moore-Penrose-pseudoinverse een manier om een oplossing in de zin van kleinste kwadraten te berekenen. Dit geeft ons de flexibiliteit om situaties aan te kunnen waarin het stelsel onderbepaald is (meer onbekenden dan vergelijkingen) of overbepaald (meer vergelijkingen dan onbekenden).
Als je je matrixalgebra wilt opfrissen, raad ik de cursus Linear Algebra for Data Science in R aan.
Soorten methoden van de kleinste kwadraten
Tot nu toe hebben we het alleen gehad over het gebruik van de methode van de kleinste kwadraten met een ordinary least squares-schatting. Het is echter een veelzijdig hulpmiddel dat kan worden aangepast aan veel scenario's, afhankelijk van de aard van het probleem dat je aanpakt. Laten we enkele soorten methoden van de kleinste kwadraten verkennen, wat ze uniek maakt en hun praktische toepassingen.
Lineaire kleinste kwadraten
Op dit punt ben je waarschijnlijk behoorlijk vertrouwd met lineaire kleinste kwadraten (ook wel bekend als ordinary least squares). Het wordt gebruikt bij modellen met lineaire coëfficiënten, zoals bij eenvoudige of meervoudige lineaire regressie. Het doel is de lijn (of het hypervlak, in het geval van meervoudige lineaire regressies) te vinden die de som van de gekwadrateerde residuen minimaliseert.
Dit type kleinste kwadraten gaat ervan uit dat de residuen een constante variantie hebben en dat er geen significante uitschieters in de data zijn. Het kan worden toegepast op de meeste zaken met een lineaire relatie. Je kunt dit bijvoorbeeld gebruiken voor relaties tussen zwangerschapsduur en geboortegewicht of tussen advertentie-uitgaven en omzet. Dit is het type kleinste kwadraten dat ik het vaakst gebruik en waar ik anderen het vaakst over hoor.
Gewogen kleinste kwadraten
Gewogen kleinste kwadraten is een uitbreiding van deze methode die werkt wanneer de variantie van de residuen niet constant is. Door gewichten toe te kennen aan elk datapunt, geeft gewogen kleinste kwadraten meer gewicht aan waarnemingen met een lagere variantie. De vergelijking hiervoor lijkt op de eerdere som van kwadraten, maar met een gewicht (wi) toegepast op elk residu:
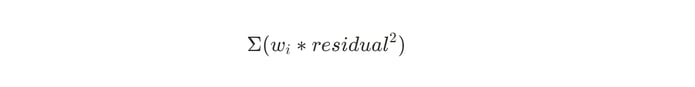
Deze methode is nuttig voor datasets waar de meetfout per waarneming verschilt, bijvoorbeeld bij het kalibreren van sensoren. Gewichten zijn doorgaans het inverse van de variantie per waarneming.
Robuuste kleinste kwadraten
Robuuste kleinste kwadraten is bedoeld voor datasets met uitschieters die de resultaten van ordinary least squares onevenredig kunnen beïnvloeden. Het gebruikt iteratieve herwegingstechnieken om de impact van uitschieters te verkleinen.
Bij robuuste kleinste kwadraten kun je methoden gebruiken zoals least absolute residuals (LAR) of bisquare-gewichten om gewichten iteratief aan te passen en de invloed van uitschieters te temperen.
Een voorbeeld waarbij je dit kunt gebruiken is financiële modellering, waar je rekening wilt houden met extreme marktcrashes. Als je een dataset hebt waarin je de uitschieters niet wilt verwijderen, maar er wel rekening mee wilt houden, kan robuuste kleinste kwadraten de juiste weg zijn.
Niet-lineaire kleinste kwadraten
Kleinste kwadraten is niet alleen voor lineaire regressies. Niet-lineaire kleinste kwadraten wordt gebruikt wanneer het model dat je toepast niet-lineair is in zijn coëfficiënten. Dit is ingewikkelder dan lineaire kleinste kwadraten en kan iteratieve optimalisatietechnieken vereisen (zoals Gauss–Newton of Levenberg–Marquardt) om de beste fit te vinden.
Wees voorzichtig met niet-lineaire kleinste kwadraten. De berekening kan gevoelig zijn voor initiële parameterinschattingen en voor convergentieproblemen. Voorbeelden waarbij je dit kunt gebruiken zijn het modelleren van de exponentiële groei van virussen in een lichaam tijdens een infectie of het modelleren van reactiesnelheden in het lab.
Totale kleinste kwadraten
Tot nu toe hadden we het vooral over gevallen waarin alleen de afhankelijke variabele fouten heeft. En we minimaliseerden de verticale afstanden tussen ons model en onze data. Maar wat als er ook fouten zitten in je onafhankelijke metingen?
Totale kleinste kwadraten is nuttig wanneer zowel de onafhankelijke als de afhankelijke variabelen meetfouten hebben. Deze methode houdt rekening met fouten in alle variabelen. Dit kan vooral nuttig zijn in vakgebieden als astronomie en geodesie (het vakgebied dat de vorm en het zwaartekrachtsveld van de aarde meet), waar meetfouten in alle dimensies aanwezig zijn vanwege de vereiste hoge precisie. Totale kleinste kwadraten wordt vaak gebruikt in combinatie met singuliere-waardedecompositie.
Gegeneraliseerde kleinste kwadraten
Gegeneraliseerde kleinste kwadraten is een uitbreiding van de methode van de kleinste kwadraten die de uitdagingen aanpakt van gecorreleerde residuen. Met gegeneraliseerde kleinste kwadraten transformeren we de data naar een vorm waarop ordinary least squares kan worden toegepast. Deze transformatie omvat het gebruik van de covariantiematrix van de residuen om hun correlatiestructuur te modelleren, waardoor nauwkeurigere parameterinschattingen mogelijk zijn.
Dit kan met name nuttig zijn bij tijdreeksanalyses, waar residuen autocorrelatie kunnen vertonen.
Toepassingen van de methode van de kleinste kwadraten
De methode van de kleinste kwadraten is een veelgebruikte statistische techniek met toepassingen in tal van vakgebieden.
In statistiek en data science wordt kleinste kwadraten gebruikt om lineaire en niet-lineaire regressiemodellen te bouwen om voorspellingen te doen op basis van bekende inputs. Het is ook nuttig bij het analyseren van trends, met name in tijdreeksdata.
In financiën wordt kleinste kwadraten gebruikt bij analyse van aandelenprestaties, om de relatie te bepalen tussen de prestaties van een aandeel en marktindices. Zo kan het worden gebruikt om de gevoeligheid van een aandeel voor marktbewegingen te berekenen. Het helpt ook bij risicomodellering door modellen te fitten op historische financiële data om risico en rendement te schatten.
Ingenieurs gebruiken kleinste kwadraten bij sensorkalibratie om modellen te fitten op geobserveerde data en meetfouten te minimaliseren. Het wordt ook toegepast in signaalverwerking voor filtering en ruisonderdrukking, wat zorgt voor een helderdere interpretatie van data.
Natuurlijk vond kleinste kwadraten zijn oorsprong in de astronomie; het werd voor het eerst gebruikt door Carl Friedrich Gauss om de baan van de planetoïde Ceres te voorspellen. Het wordt ook gebruikt in de geodesie bij het modelleren van de vorm van de aarde op basis van observatiegegevens, wat essentieel is voor nauwkeurige geografische metingen.
Als je je al eens met machine learning hebt beziggehouden, herken je de methode van de kleinste kwadraten als een methode om de verliesfunctie te minimaliseren tijdens het trainen van lineaire regressiemodellen. Je hebt het misschien ook gebruikt tijdens featureselectie om de belangrijkste variabelen voor het model te identificeren.
Het speelt ook een rol in veel andere exacte wetenschappen, zoals natuurkunde en scheikunde. Het kan worden gebruikt om krommen te fitten op experimentele data, zoals reactiesnelheden of fysieke metingen, en om fouten in experimentele opstellingen te minimaliseren.
De methode van de kleinste kwadraten is een veelzijdig statistisch hulpmiddel. Zelf heb ik deze methode gebruikt om druksensoren te kalibreren, voorspellingen te doen op basis van mijn experimentele data en tijdens machine learning-training. De mogelijkheid om relaties betrouwbaar te modelleren en fouten te minimaliseren, biedt waarde voor veel verschillende disciplines.
Aannames en diagnostiek
De methode van de kleinste kwadraten doet enkele belangrijke aannames over je data en het gebruikte model. Het is belangrijk deze aannames te begrijpen, want schendingen kunnen leiden tot vertekende of onbetrouwbare resultaten. Laten we deze aannames bespreken, evenals hoe je potentiële problemen kunt diagnosticeren en aanpakken.
Eén aanname is de onafhankelijkheid van fouten, wat betekent dat de residuen niet gecorreleerd mogen zijn. Als fouten met elkaar correleren, vooral in sequentiële of ruimtelijke data, kunnen schattingen vertekend raken. De Durbin-Watson-test kan autocorrelatie in residuen detecteren, met name voor tijdsafhankelijke datasets. Als je een correlatie vindt, kun je gegeneraliseerde kleinste kwadraten gebruiken om daarvoor te corrigeren.
Een andere aanname is dat de variantie van de residuen constant blijft over alle niveaus van de onafhankelijke variabele. Als residuen een trechtervormige spreiding vertonen wanneer ze worden uitgezet tegen de gefitte waarden, is deze aanname waarschijnlijk geschonden. Om dit probleem aan te pakken kun je gewogen kleinste kwadraten gebruiken om passende gewichten aan je waarnemingen toe te kennen. Of je kunt transformaties gebruiken, zoals logaritmische of worteltransformaties, om ongelijke variantie te stabiliseren en eventuele problemen met heteroscedasticiteit te verhelpen.
Zoals bij alle modellering is het belangrijk dat de modelstructuur de onderliggende relatie tussen de variabelen weerspiegelt. Als dat niet zo is, maakt het niet uit hoe geoptimaliseerd je fit is; de resultaten blijven misleidend. Residugrafieken en goodness-of-fit-maten zoals R² kunnen je helpen bepalen of je gekozen model de patronen in de data vastlegt.
De standaardmethode van de kleinste kwadraten gaat ervan uit dat onafhankelijke variabelen zonder meetfout zijn gemeten. Het is dus belangrijk om de precisie van je onafhankelijke meting te kennen. Je zou een idee moeten hebben van de precisie van deze meting door naar de verzamelmethoden te kijken. Als er meetfouten bestaan in je voorspeller, gebruik dan zeker totale kleinste kwadraten om onnauwkeurigheden in je modellering te beperken.
Ten slotte speelt de verdeling van residuele fouten een belangrijke rol, met name bij hypothesetoetsing en het schatten van betrouwbaarheidsintervallen. Kleinste kwadraten gaat ervan uit dat fouten een normale (Gauss-)verdeling volgen, en afwijkingen van normaliteit kunnen de inferentie beïnvloeden. Histogrammen en Q-Q-plots helpen te beoordelen of residuen overeenkomen met verwachte verdelingen. Als je aanzienlijke afwijkingen van normaliteit hebt, kunnen robuuste regressietechnieken of bootstrapping-methoden betrouwbaardere schattingen geven die minder gevoelig zijn voor uitschieters.
Voordelen en nadelen van kleinste kwadraten
De methode van de kleinste kwadraten is een veelgebruikt hulpmiddel in data-analyse. Maar dat betekent niet dat ze voor elke dataset geschikt is.
De methode van de kleinste kwadraten biedt verschillende voordelen. Ze is redelijk eenvoudig te berekenen, vooral voor lineaire modellen. Ze is gemakkelijk te interpreteren voor zowel technische als niet-technische doelgroepen. Bovendien zijn er verschillende stijlen, zoals gewogen, robuuste en niet-lineaire regressie, wat haar zeer veelzijdig maakt. En belangrijk: ze heeft een sterke theoretische basis via de Gauss-Markov-stelling. Dit alles maakt kleinste kwadraten breed toepasbaar, in vakgebieden van economie tot engineering.
De methode is echter gevoelig voor uitschieters, die de modelresultaten onevenredig kunnen beïnvloeden. Ook gaat ze ervan uit dat er geen fouten in de voorspellers zitten, wat in echte data niet altijd klopt. Daarnaast kan kleinste kwadraten worden beperkt door multicollineariteit. Dat betekent dat sterk gecorreleerde voorspellers kunnen leiden tot onstabiele coëfficiënten en dus onbetrouwbare schattingen. Er is ook constante variantie van residuen vereist, een voorwaarde die niet altijd wordt gehaald.
Het is belangrijk om je dataset en je doelstelling goed te onderzoeken voordat je besluit dat de methode van de kleinste kwadraten het beste hulpmiddel voor jouw situatie is.
|
Voordelen
|
Nadelen
|
|
Eenvoudig te berekenen
|
Gevoelig voor uitschieters
|
|
Interpretatiegemak
|
Gaat uit van foutloze voorspellers
|
|
Brede toepasbaarheid
|
Beperkt bij multicollineariteit
|
|
Sterke theoretische basis
|
Aanname van constante variantie
|
Conclusie
De methode van de kleinste kwadraten is een fundamenteel hulpmiddel voor elke data-analist. Door de best passende lijn voor onze data te vinden, kunnen we nauwkeuriger voorspellen en inzichtelijkere trends ontdekken.
Voor verdere lectuur over het meten van rechte lijnen in de Euclidische ruimte raad ik onze tutorial Understanding Euclidean Distance: From Theory to Practice aan. Schrijf je ook zeker in voor onze regressiecursussen om echt expert te worden.





Stel, je wilt huizenprijzen voorspellen op basis van het woonoppervlak. Je hebt datapunten van recente verkopen, maar ze vormen geen perfect patroon. Sommige huizen verkopen voor meer dan verwacht, andere voor minder. Hoe vind je de beste trendlijn die de algemene relatie tussen grootte en prijs weergeeft, zonder je voorspelling te laten ontsporen door individuele uitschieters?
De methode van de kleinste kwadraten is misschien precies wat je nodig hebt. In dit artikel verkennen we de kernconcepten van de methode van de kleinste kwadraten, de varianten en toepassingen. Aan het eind heb je een stevig begrip van hoe je deze methode gebruikt en toepast op echte problemen.
Wat is de methode van de kleinste kwadraten?
De methode van de kleinste kwadraten is een statistische techniek om de best passende lijn of kromme voor een set datapunten te bepalen. Ze werkt door de gekwadrateerde verschillen tussen de geobserveerde en voorspelde waarden in een dataset te minimaliseren. Het verschil tussen de werkelijke datapunten en de door het model voorspelde waarden noemen we residuen. Het doel is een model te vinden dat de som van deze gekwadrateerde residuen minimaliseert, wat leidt tot zo nauwkeurig mogelijke voorspellingen.
Het bovenstaande diagram geeft een korte uitleg van de stappen van de methode van de kleinste kwadraten.
Deze methode werd in 1795 afgeleid door de 18-jarige Carl Friedrich Gauss (je herkent zijn naam misschien van de Gauss-verdeling). Adrien-Marie Legendre formaliseerde de techniek later in 1805 en was de eerste die een paper schreef waarin hij de methode van de kleinste kwadraten gebruikte om de baan van een planetoïde te reconstrueren.
Hoe de methode van de kleinste kwadraten werkt
De methode van de kleinste kwadraten vindt de lijn die het best bij een set punten past door de som van de gekwadrateerde verschillen te minimaliseren tussen de geobserveerde waarden en de voorspelde waarden. Dit wordt gebruikt om de modelparameters met de best mogelijke aansluiting te vinden.
Laten we dit proberen met een extreem kleine dataset: slechts 10 punten. Eerst moeten we een model kiezen om onze data te fitten. Voor dit eenvoudige voorbeeld kiezen we een eenvoudige lineaire regressie, wat betekent dat we een regressie uitvoeren met precies één onafhankelijke en één afhankelijke variabele.
De bovenstaande grafiek toont onze kleine dataset, met daaroverheen een lineaire regressie. De gele gestippelde lijnen die de datapunten met de voorspelde lijn verbinden, zijn de residuen. Het doel is het lineaire regressiemodel te vinden dat deze gele gestippelde residulijnen minimaliseert.
Voor elk datapunt in onze dataset moeten we het verschil in y-coördinaten vinden tussen het datapunt en de lijn. Dit zijn onze residuen. Vervolgens kwadrateren we elk residu om eventuele negatieve getallen weg te nemen en nemen we de totale som. Zo krijgen we een idee van hoe goed onze lijn bij de data past. Bekijk de tabel hieronder voor de uitsplitsing voor onze specifieke grafiek.
X-coördinaat
Geobserveerde Y-coördinaat (datapunt)
Voorspelde Y-coördinaat (lijn)
Residuen (geobserveerd - voorspeld)
Gekwadrateerde residuen
0
2.5
2.0
0.5
0.25
1
3.1
2.3
0.8
0.64
2
1.8
2.6
-0.8
0.64
3
3.5
2.9
0.6
0.36
4
2.2
3.2
-1.0
1.0
5
4.0
3.5
0.5
0.25
6
3.8
3.8
0.0
0.0
7
5.0
4.1
0.9
0.81
8
4.5
4.4
0.1
0.01
9
5.2
4.7
0.5
0.25
Som van gekwadrateerde residuen
4.21
Nu we een idee hebben hoe goed deze lijn bij onze data past, kunnen we de parameters van de lijn, de helling of het snijpunt, aanpassen en onze berekeningen opnieuw uitvoeren. De lijn met de laagste som van gekwadrateerde residuen past het best bij onze data. Die lijn levert dus de beste voorspellingen op.
De methode van de kleinste kwadraten gebruiken om de beste lijn te vinden
In het bovenstaande voorbeeld hebben we niet de best passende lijn gevonden. We hebben alleen berekend hoe goed die lijn bij de data past. We zouden nu door een heleboel mogelijke lijnen kunnen itereren en dezelfde berekening uitvoeren om te vinden welke het best past. Of we kunnen een beetje algebra gebruiken om sneller bij de beste lijn te komen. Laten we dat doen.
We beginnen met de vergelijking voor de lineaire regressie: y=mx+b, waarbij b het snijpunt met de y-as is en m de helling. Laten we nu wat data verzinnen.
X-coördinaat
Y-coördinaat
0
2.5
1
3.1
2
1.8
3
3.5
4
2.2
5
4.0
6
3.8
7
5.0
8
4.5
9
5.2
Eerst moeten we het gemiddelde van de X- en Y-waarden berekenen. Dit zijn onze voorspelde waarden:
Vervolgens kunnen we de som van de kwadraten van onze residuen tussen elk datapunt en onze voorspelde waarde (het gemiddelde) gebruiken om de helling te vinden. Dit is de vergelijking die we gebruiken:
Omdat dit een vrij onhandige vergelijking is om met de hand te doen, berekenen we de teller en noemer apart. Laten we beginnen met de teller:
xi
yi
xi - xgemiddelde
yi - ygemiddelde
(xi - xgemiddelde)(yi -ygemiddelde)
0
2.5
-4.5
-1.06
4.77
1
3.1
-3.5
-0.46
1.61
2
1.8
-2.5
-1.76
4.40
3
3.5
-1.5
-0.06
0.09
4
2.2
-0.5
-1.36
0.68
5
4.0
0.5
0.44
0.22
6
3.8
1.5
0.24
0.36
7
5.0
2.5
1.44
3.60
8
4.5
3.5
0.94
3.29
9
5.2
4.5
1.64
7.38
Som van (xi - xgemiddelde)(yi - ygemiddelde)
26.4
Laten we nu hetzelfde doen voor de noemer:
xi
xi - xgemiddelde
(xi - xgemiddelde)2
0
-4.5
20.25
1
-3.5
12.25
2
-2.5
6.25
3
-1.5
2.25
4
-0.5
0.25
5
0.5
0.25
6
1.5
2.25
7
2.5
6.25
8
3.5
12.25
9
4.5
20.25
Som van (xi - xgemiddelde)2
82.50
Nu kunnen we de helling voor onze best passende lijn berekenen.
We weten nu dus de helling van de lijn die het best bij onze data past. Vervolgens moeten we het snijpunt met de y-as vinden. De formule voor het snijpunt b is eenvoudig te vinden met een beetje algebraïsch herschikken:
Omdat we de helling al kennen, kunnen we eenvoudig ons gemiddelde van x en y invullen en b oplossen.
Nu we zowel m als b hebben, kunnen we de vergelijking van de best passende lijn opschrijven:
De methode van de kleinste kwadraten stelde ons in staat om snel en eenvoudig de beste lineaire regressielijn af te leiden, zelfs met de hand! Natuurlijk geldt: hoe meer data je hebt, hoe lastiger dit met de hand wordt. Gelukkig is de wiskunde vrij rechttoe-rechtaan, dus het is heel eenvoudig om deze methode te implementeren in Python of R. Voor gedetailleerde uitleg bekijk je Essentials of Linear Regression in Python en How to Do Linear Regression in R.
Wiskundige fundamenten van de methode van de kleinste kwadraten
Hierboven gebruikten we een voorbeeld met eenvoudige lineaire regressie en vonden we de helling en het snijpunt met behulp van prettige gesloten-formule vergelijkingen, en we modelleerden de afhankelijke variabele als een functie van de onafhankelijke variabele: y=mx+b.
De vergelijkingen die ik hierboven liet zien, werken echter alleen wanneer je één onafhankelijke variabele hebt. Een andere manier om de coëfficiënten voor een regressie te vinden is met de zogeheten normale vergelijking, die een matrixgebaseerde oplossing voor het probleem van de kleinste kwadraten biedt. De normale vergelijking verwijst naar de matrixvergelijking die ontstaat door de som van gekwadrateerde residuen te minimaliseren met de methode van de kleinste kwadraten. Geometrisch, en in de taal van lineaire algebra, kan de oplossing van de kleinste kwadraten worden gezien als de orthogonale projectie van de geobserveerde datavector op de kolomruimte van de modelmatrix. Simpel gezegd betekent dit dat de fouten zo worden geminimaliseerd dat de voorspelde waarden zo dicht mogelijk bij de geobserveerde data liggen, gegeven de beperkingen van het model.
In gevallen waarin de matrix niet inverteerbaar is (wat betekent dat het stelsel vergelijkingen geen unieke oplossing heeft), biedt de Moore-Penrose-pseudoinverse een manier om een oplossing in de zin van kleinste kwadraten te berekenen. Dit geeft ons de flexibiliteit om situaties aan te kunnen waarin het stelsel onderbepaald is (meer onbekenden dan vergelijkingen) of overbepaald (meer vergelijkingen dan onbekenden).
Als je je matrixalgebra wilt opfrissen, raad ik de cursus Linear Algebra for Data Science in R aan.
Soorten methoden van de kleinste kwadraten
Tot nu toe hebben we het alleen gehad over het gebruik van de methode van de kleinste kwadraten met een ordinary least squares-schatting. Het is echter een veelzijdig hulpmiddel dat kan worden aangepast aan veel scenario's, afhankelijk van de aard van het probleem dat je aanpakt. Laten we enkele soorten methoden van de kleinste kwadraten verkennen, wat ze uniek maakt en hun praktische toepassingen.
Lineaire kleinste kwadraten
Op dit punt ben je waarschijnlijk behoorlijk vertrouwd met lineaire kleinste kwadraten (ook wel bekend als ordinary least squares). Het wordt gebruikt bij modellen met lineaire coëfficiënten, zoals bij eenvoudige of meervoudige lineaire regressie. Het doel is de lijn (of het hypervlak, in het geval van meervoudige lineaire regressies) te vinden die de som van de gekwadrateerde residuen minimaliseert.
Dit type kleinste kwadraten gaat ervan uit dat de residuen een constante variantie hebben en dat er geen significante uitschieters in de data zijn. Het kan worden toegepast op de meeste zaken met een lineaire relatie. Je kunt dit bijvoorbeeld gebruiken voor relaties tussen zwangerschapsduur en geboortegewicht of tussen advertentie-uitgaven en omzet. Dit is het type kleinste kwadraten dat ik het vaakst gebruik en waar ik anderen het vaakst over hoor.
Gewogen kleinste kwadraten
Gewogen kleinste kwadraten is een uitbreiding van deze methode die werkt wanneer de variantie van de residuen niet constant is. Door gewichten toe te kennen aan elk datapunt, geeft gewogen kleinste kwadraten meer gewicht aan waarnemingen met een lagere variantie. De vergelijking hiervoor lijkt op de eerdere som van kwadraten, maar met een gewicht (wi) toegepast op elk residu:
Deze methode is nuttig voor datasets waar de meetfout per waarneming verschilt, bijvoorbeeld bij het kalibreren van sensoren. Gewichten zijn doorgaans het inverse van de variantie per waarneming.
Robuuste kleinste kwadraten
Robuuste kleinste kwadraten is bedoeld voor datasets met uitschieters die de resultaten van ordinary least squares onevenredig kunnen beïnvloeden. Het gebruikt iteratieve herwegingstechnieken om de impact van uitschieters te verkleinen.
Bij robuuste kleinste kwadraten kun je methoden gebruiken zoals least absolute residuals (LAR) of bisquare-gewichten om gewichten iteratief aan te passen en de invloed van uitschieters te temperen.
Een voorbeeld waarbij je dit kunt gebruiken is financiële modellering, waar je rekening wilt houden met extreme marktcrashes. Als je een dataset hebt waarin je de uitschieters niet wilt verwijderen, maar er wel rekening mee wilt houden, kan robuuste kleinste kwadraten de juiste weg zijn.
Niet-lineaire kleinste kwadraten
Kleinste kwadraten is niet alleen voor lineaire regressies. Niet-lineaire kleinste kwadraten wordt gebruikt wanneer het model dat je toepast niet-lineair is in zijn coëfficiënten. Dit is ingewikkelder dan lineaire kleinste kwadraten en kan iteratieve optimalisatietechnieken vereisen (zoals Gauss–Newton of Levenberg–Marquardt) om de beste fit te vinden.
Wees voorzichtig met niet-lineaire kleinste kwadraten. De berekening kan gevoelig zijn voor initiële parameterinschattingen en voor convergentieproblemen. Voorbeelden waarbij je dit kunt gebruiken zijn het modelleren van de exponentiële groei van virussen in een lichaam tijdens een infectie of het modelleren van reactiesnelheden in het lab.
Totale kleinste kwadraten
Tot nu toe hadden we het vooral over gevallen waarin alleen de afhankelijke variabele fouten heeft. En we minimaliseerden de verticale afstanden tussen ons model en onze data. Maar wat als er ook fouten zitten in je onafhankelijke metingen?
Totale kleinste kwadraten is nuttig wanneer zowel de onafhankelijke als de afhankelijke variabelen meetfouten hebben. Deze methode houdt rekening met fouten in alle variabelen. Dit kan vooral nuttig zijn in vakgebieden als astronomie en geodesie (het vakgebied dat de vorm en het zwaartekrachtsveld van de aarde meet), waar meetfouten in alle dimensies aanwezig zijn vanwege de vereiste hoge precisie. Totale kleinste kwadraten wordt vaak gebruikt in combinatie met singuliere-waardedecompositie.
Gegeneraliseerde kleinste kwadraten
Gegeneraliseerde kleinste kwadraten is een uitbreiding van de methode van de kleinste kwadraten die de uitdagingen aanpakt van gecorreleerde residuen. Met gegeneraliseerde kleinste kwadraten transformeren we de data naar een vorm waarop ordinary least squares kan worden toegepast. Deze transformatie omvat het gebruik van de covariantiematrix van de residuen om hun correlatiestructuur te modelleren, waardoor nauwkeurigere parameterinschattingen mogelijk zijn.
Dit kan met name nuttig zijn bij tijdreeksanalyses, waar residuen autocorrelatie kunnen vertonen.
Toepassingen van de methode van de kleinste kwadraten
De methode van de kleinste kwadraten is een veelgebruikte statistische techniek met toepassingen in tal van vakgebieden.
In statistiek en data science wordt kleinste kwadraten gebruikt om lineaire en niet-lineaire regressiemodellen te bouwen om voorspellingen te doen op basis van bekende inputs. Het is ook nuttig bij het analyseren van trends, met name in tijdreeksdata.
In financiën wordt kleinste kwadraten gebruikt bij analyse van aandelenprestaties, om de relatie te bepalen tussen de prestaties van een aandeel en marktindices. Zo kan het worden gebruikt om de gevoeligheid van een aandeel voor marktbewegingen te berekenen. Het helpt ook bij risicomodellering door modellen te fitten op historische financiële data om risico en rendement te schatten.
Ingenieurs gebruiken kleinste kwadraten bij sensorkalibratie om modellen te fitten op geobserveerde data en meetfouten te minimaliseren. Het wordt ook toegepast in signaalverwerking voor filtering en ruisonderdrukking, wat zorgt voor een helderdere interpretatie van data.
Natuurlijk vond kleinste kwadraten zijn oorsprong in de astronomie; het werd voor het eerst gebruikt door Carl Friedrich Gauss om de baan van de planetoïde Ceres te voorspellen. Het wordt ook gebruikt in de geodesie bij het modelleren van de vorm van de aarde op basis van observatiegegevens, wat essentieel is voor nauwkeurige geografische metingen.
Als je je al eens met machine learning hebt beziggehouden, herken je de methode van de kleinste kwadraten als een methode om de verliesfunctie te minimaliseren tijdens het trainen van lineaire regressiemodellen. Je hebt het misschien ook gebruikt tijdens featureselectie om de belangrijkste variabelen voor het model te identificeren.
Het speelt ook een rol in veel andere exacte wetenschappen, zoals natuurkunde en scheikunde. Het kan worden gebruikt om krommen te fitten op experimentele data, zoals reactiesnelheden of fysieke metingen, en om fouten in experimentele opstellingen te minimaliseren.
De methode van de kleinste kwadraten is een veelzijdig statistisch hulpmiddel. Zelf heb ik deze methode gebruikt om druksensoren te kalibreren, voorspellingen te doen op basis van mijn experimentele data en tijdens machine learning-training. De mogelijkheid om relaties betrouwbaar te modelleren en fouten te minimaliseren, biedt waarde voor veel verschillende disciplines.
Aannames en diagnostiek
De methode van de kleinste kwadraten doet enkele belangrijke aannames over je data en het gebruikte model. Het is belangrijk deze aannames te begrijpen, want schendingen kunnen leiden tot vertekende of onbetrouwbare resultaten. Laten we deze aannames bespreken, evenals hoe je potentiële problemen kunt diagnosticeren en aanpakken.
Eén aanname is de onafhankelijkheid van fouten, wat betekent dat de residuen niet gecorreleerd mogen zijn. Als fouten met elkaar correleren, vooral in sequentiële of ruimtelijke data, kunnen schattingen vertekend raken. De Durbin-Watson-test kan autocorrelatie in residuen detecteren, met name voor tijdsafhankelijke datasets. Als je een correlatie vindt, kun je gegeneraliseerde kleinste kwadraten gebruiken om daarvoor te corrigeren.
Een andere aanname is dat de variantie van de residuen constant blijft over alle niveaus van de onafhankelijke variabele. Als residuen een trechtervormige spreiding vertonen wanneer ze worden uitgezet tegen de gefitte waarden, is deze aanname waarschijnlijk geschonden. Om dit probleem aan te pakken kun je gewogen kleinste kwadraten gebruiken om passende gewichten aan je waarnemingen toe te kennen. Of je kunt transformaties gebruiken, zoals logaritmische of worteltransformaties, om ongelijke variantie te stabiliseren en eventuele problemen met heteroscedasticiteit te verhelpen.
Zoals bij alle modellering is het belangrijk dat de modelstructuur de onderliggende relatie tussen de variabelen weerspiegelt. Als dat niet zo is, maakt het niet uit hoe geoptimaliseerd je fit is; de resultaten blijven misleidend. Residugrafieken en goodness-of-fit-maten zoals R² kunnen je helpen bepalen of je gekozen model de patronen in de data vastlegt.
De standaardmethode van de kleinste kwadraten gaat ervan uit dat onafhankelijke variabelen zonder meetfout zijn gemeten. Het is dus belangrijk om de precisie van je onafhankelijke meting te kennen. Je zou een idee moeten hebben van de precisie van deze meting door naar de verzamelmethoden te kijken. Als er meetfouten bestaan in je voorspeller, gebruik dan zeker totale kleinste kwadraten om onnauwkeurigheden in je modellering te beperken.
Ten slotte speelt de verdeling van residuele fouten een belangrijke rol, met name bij hypothesetoetsing en het schatten van betrouwbaarheidsintervallen. Kleinste kwadraten gaat ervan uit dat fouten een normale (Gauss-)verdeling volgen, en afwijkingen van normaliteit kunnen de inferentie beïnvloeden. Histogrammen en Q-Q-plots helpen te beoordelen of residuen overeenkomen met verwachte verdelingen. Als je aanzienlijke afwijkingen van normaliteit hebt, kunnen robuuste regressietechnieken of bootstrapping-methoden betrouwbaardere schattingen geven die minder gevoelig zijn voor uitschieters.
Voordelen en nadelen van kleinste kwadraten
De methode van de kleinste kwadraten is een veelgebruikt hulpmiddel in data-analyse. Maar dat betekent niet dat ze voor elke dataset geschikt is.
De methode van de kleinste kwadraten biedt verschillende voordelen. Ze is redelijk eenvoudig te berekenen, vooral voor lineaire modellen. Ze is gemakkelijk te interpreteren voor zowel technische als niet-technische doelgroepen. Bovendien zijn er verschillende stijlen, zoals gewogen, robuuste en niet-lineaire regressie, wat haar zeer veelzijdig maakt. En belangrijk: ze heeft een sterke theoretische basis via de Gauss-Markov-stelling. Dit alles maakt kleinste kwadraten breed toepasbaar, in vakgebieden van economie tot engineering.
De methode is echter gevoelig voor uitschieters, die de modelresultaten onevenredig kunnen beïnvloeden. Ook gaat ze ervan uit dat er geen fouten in de voorspellers zitten, wat in echte data niet altijd klopt. Daarnaast kan kleinste kwadraten worden beperkt door multicollineariteit. Dat betekent dat sterk gecorreleerde voorspellers kunnen leiden tot onstabiele coëfficiënten en dus onbetrouwbare schattingen. Er is ook constante variantie van residuen vereist, een voorwaarde die niet altijd wordt gehaald.
Het is belangrijk om je dataset en je doelstelling goed te onderzoeken voordat je besluit dat de methode van de kleinste kwadraten het beste hulpmiddel voor jouw situatie is.
Voordelen
Nadelen
Eenvoudig te berekenen
Gevoelig voor uitschieters
Interpretatiegemak
Gaat uit van foutloze voorspellers
Brede toepasbaarheid
Beperkt bij multicollineariteit
Sterke theoretische basis
Aanname van constante variantie
Conclusie
De methode van de kleinste kwadraten is een fundamenteel hulpmiddel voor elke data-analist. Door de best passende lijn voor onze data te vinden, kunnen we nauwkeuriger voorspellen en inzichtelijkere trends ontdekken.
Voor verdere lectuur over het meten van rechte lijnen in de Euclidische ruimte raad ik onze tutorial Understanding Euclidean Distance: From Theory to Practice aan. Schrijf je ook zeker in voor onze regressiecursussen om echt expert te worden.