
Kurs
Llama 3 ile İnce Ayar (Fine-Tuning)
2 sa
4.1K
Phi-4-reasoning, küratörlü veri kümeleri üzerinde titiz ince ayarlama sayesinde çok daha büyük modellere rakip olan, karmaşık akıl yürütme görevleri için tasarlanmış 14 milyar parametreli açık ağırlıklı bir modeldir. Ayrıntılı akıl yürütme zincirleri üretir ve olağanüstü performansa ulaşmak için çıkarım zamanı hesaplamasını kullanır.
Geliştirilmiş sürümü olan Phi-4-reasoning-plus, doğruluğu daha da artırmak için pekiştirmeli öğrenme ve 1,5 kat daha fazla belirteç kullanır. Daha küçük boyutlarına rağmen, her iki model de DeepSeek-R1-Distill-70B gibi daha büyük muadillerini geride bırakır ve hatta 671 milyar parametreli DeepSeek-R1’i kıyaslamalarda aşar.
Bu eğitimde, Phi-4-reasoning-plus modelini kullanacak ve Finansal Soru-Cevap akıl yürütme veri kümesi üzerinde ince ayar yapacağız. Bu kılavuz; Runpod ortamının kurulumu, modelin, belirteçleyicinin ve veri kümesinin yüklenmesi, verilerin eğitim için hazırlanması, modelin eğitime göre yapılandırılması, model değerlendirmelerinin çalıştırılması ve ince ayarlı model adaptörünün kaydedilmesini kapsar.
Phi 4 hakkında bilgi edinebilir ve aşağıdaki eğitimi takip ederek çok modlu bir dil eğitmeni oluşturabilirsiniz: Phi-4-Multimodal: Demo Projeyle Rehber.
Görsel: Yazar
Bu eğitimde, hesaplama ortamı olarak RunPod kullanacağız. Ortamınızı kurmak için şu adımları izleyin:
1. RunPod Panosuna gidin ve yeni bir pod oluşturmak için “Deploy On-Demand”e tıklayın.
2. Modeli yüklemek ve ince ayarlamak için yeterli olan A100 GPU’yu seçin.
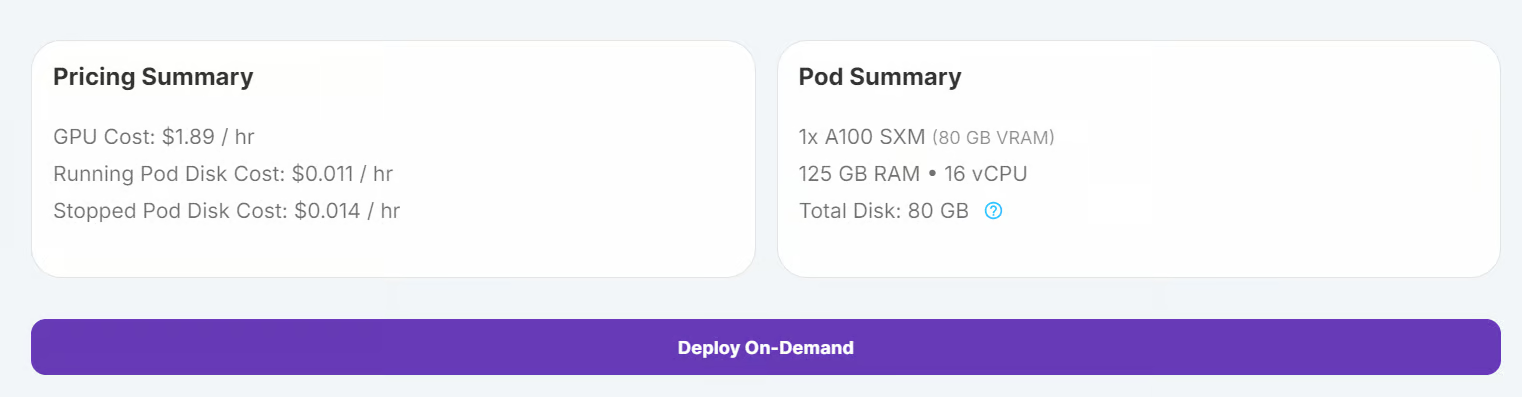
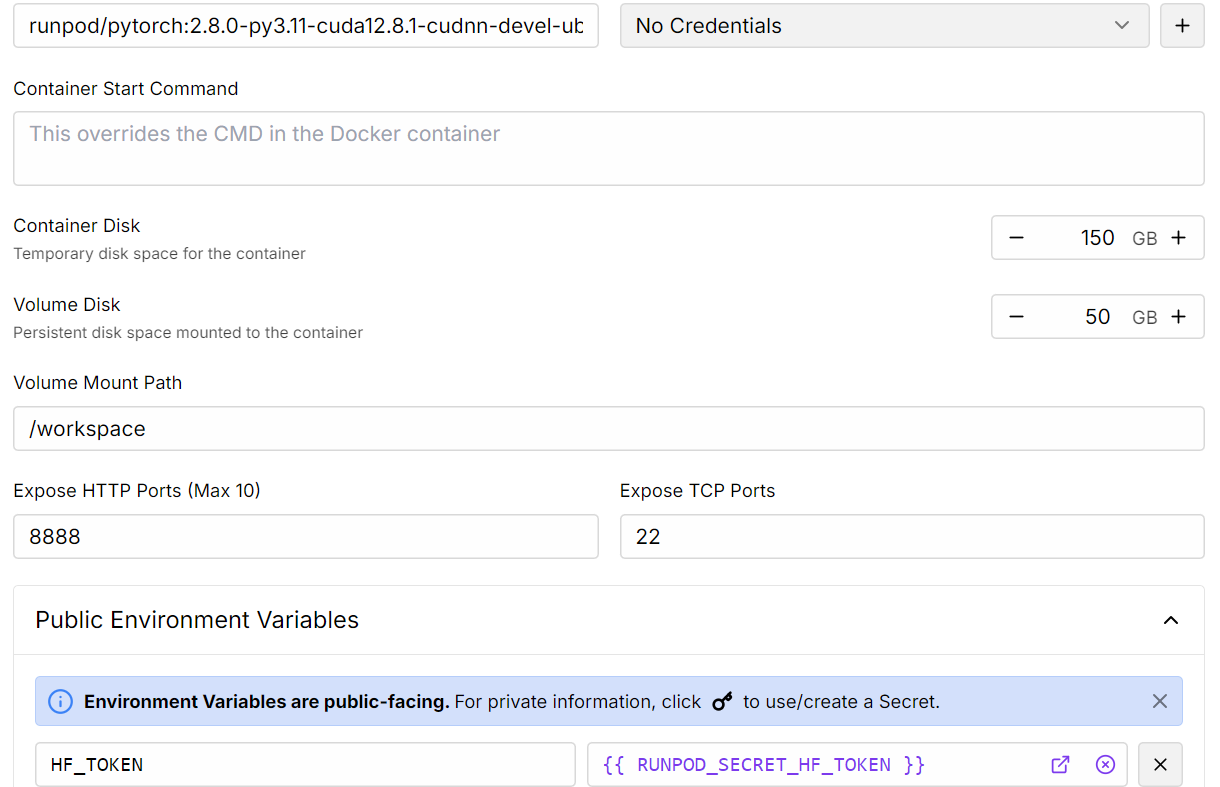
3. Dağıtımınızı özelleştirin:
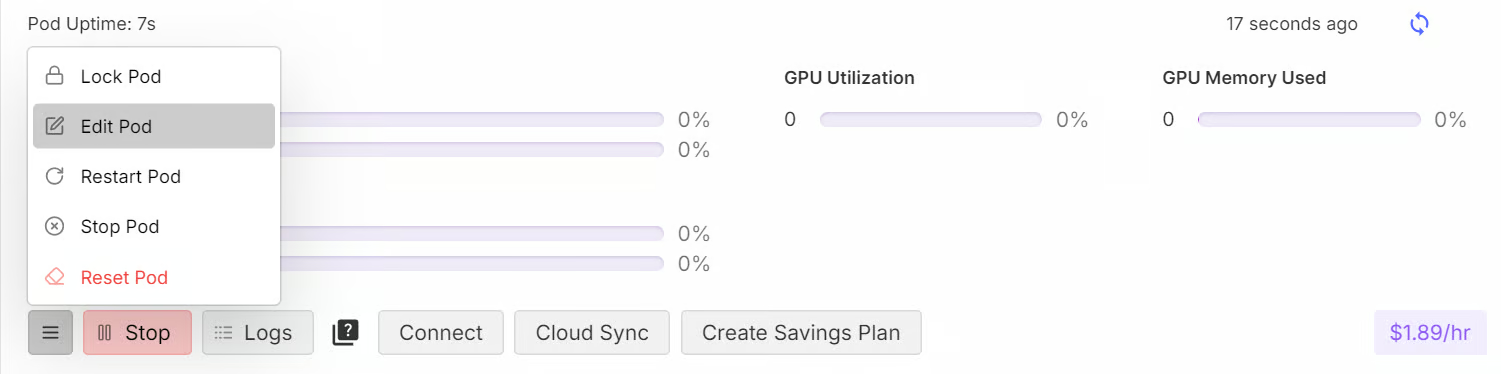
4. Pod dağıtıldıktan sonra, JupyterLab oturumunu başlatmak için Connect düğmesine tıklayın.
5. JupyterLab içinde yeni bir not defteri oluşturun ve gerekli tüm Python paketlerini yükleyin.
%%capture
%pip install -U transformers
%pip install -U datasets
%pip install -U accelerate
%pip install -U peft
%pip install -U trl
%pip install -U bitsandbytes
%pip install huggingface_hub[hf_xet]
6. Ardından, daha önce kaydettiğiniz belirteci kullanarak Hugging Face CLI’a giriş yapın.
from huggingface_hub import login
import os

hf_token = os.environ.get("HF_TOKEN")
login(hf_token)Bu rehberde, Hugging Face’ten tam microsoft/Phi-4-reasoning-plus modelini ve belirteçleyicisini yükleyeceğiz.
Donanım tam kesinlikli ağırlıkları rahatlıkla kaldırabildiği için burada 4 bit niceleme kullanmıyoruz. 80 GB VRAM’e sahip bir A100, tam Phi-4-Reasoning modelinin yalnızca yaklaşık 28 GB yer kaplaması nedeniyle geniş bir pay bırakır; böylece etkinleştirmeler, eniyileyici durumları ve diğer eğitim ek yükleri için hâlâ 50 GB’tan fazla boş alan kalır.
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch

# Load tokenizer & model
model_dir = "microsoft/Phi-4-reasoning-plus"

tokenizer = AutoTokenizer.from_pretrained(model_dir, use_fast=True)

model = AutoModelForCausalLM.from_pretrained(
    model_dir,
    device_map="auto",
    torch_dtype=torch.bfloat16,
    trust_remote_code=True
)

model.config.use_cache = False
model.config.pretraining_tp = 1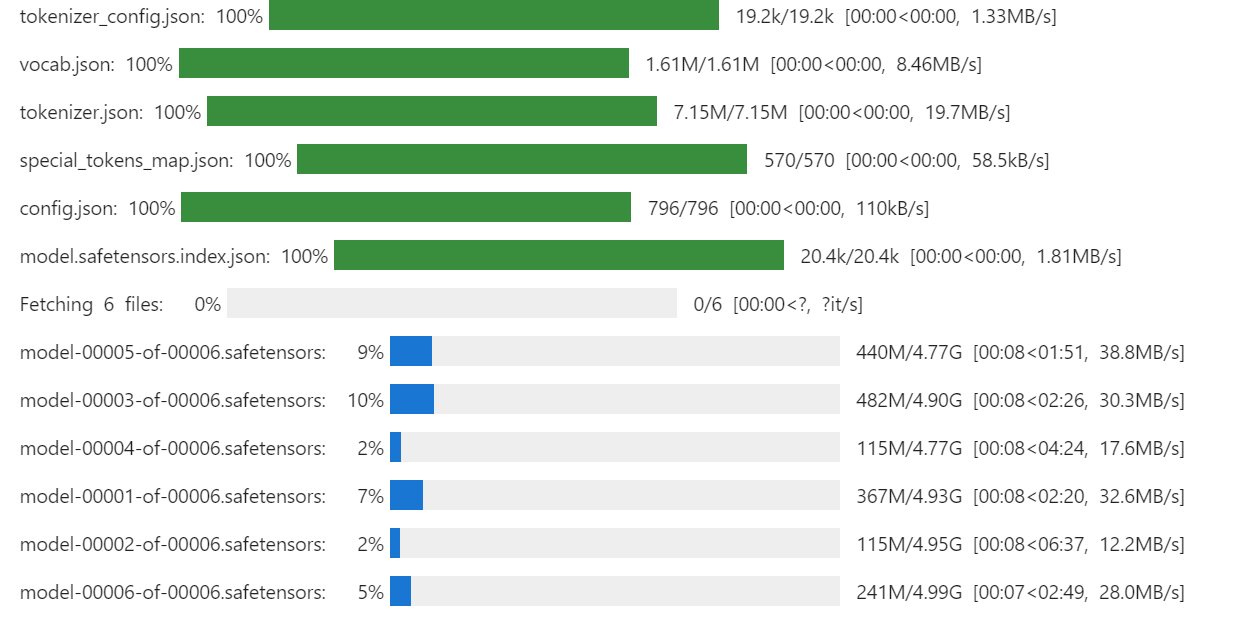
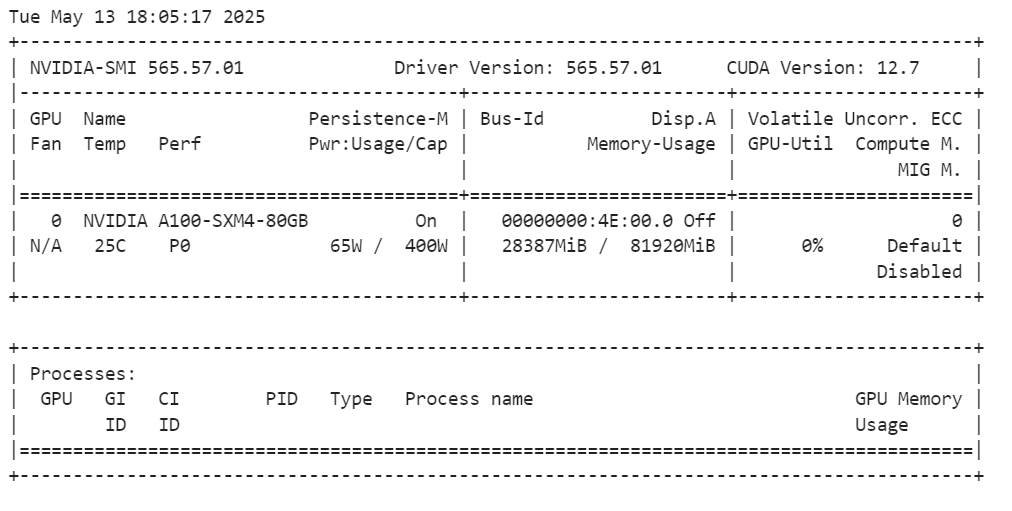
Modeli yükledikten sonra, aşağıdaki komutu çalıştırarak ne kadar GPU belleği kullandığını kontrol edebilirsiniz:
!nvidia-smiTam model yaklaşık 28 GB VRAM kullanır. A100 GPU’nun 80 GB VRAM’i vardır; dolayısıyla ince ayar görevleri için hâlâ 55 GB boş bellek mevcuttur.
Veri kümesini yüklemeden önce, bir eğitim istemi stili tanımlayacağız. Bu istem şunları içerir:
Bu istem stili, modelin eleştirel düşünmesini ve nihai yanıtla birlikte bir akıl yürütme süreci üretmesini teşvik etmek için tasarlanmıştır.
train_prompt_style="""
<|im_start|>system<|im_sep|>
Below is an instruction that describes a task, paired with an input that provides further context.
Write a response that appropriately completes the request.
Before answering, think carefully about the question and create a step-by-step chain of thoughts to ensure a logical and accurate response.
<|im_end|>
<|im_start|>user<|im_sep|>
{}<|im_end|>
<|im_start|>assistant<|im_sep|>
<think>
{}
</think>
{}
"""
Veri kümesinin sütunlarını (sorular, akıl yürütme ve yanıtlar) istem şablonuna uygulamak için bir Python işlevi oluşturacağız. Bu işlev, tüm istem bileşenlerini içeren “text” adlı yeni bir sütun oluşturacaktır.
EOS_TOKEN = tokenizer.eos_token  # Must add EOS_TOKEN

def formatting_prompts_func(examples):
    inputs = examples["Open-ended Verifiable Question"]
    complex_cots = examples["Complex_CoT"]
    outputs = examples["Response"]
    texts = []
    for input, cot, output in zip(inputs,complex_cots,outputs):
        text = train_prompt_style.format(input,cot,output) + EOS_TOKEN
        texts.append(text)
    return {
        "text": texts,
    }
Şimdi veri kümesini (TheFinAI/Fino1_Reasoning_Path_FinQA) indirecek, 1000 örnek yükleyecek, biçimlendirme işlevini uygulayacak ve yeni “text” sütununu oluşturacağız.
from datasets import load_dataset

dataset = load_dataset(
    "TheFinAI/Fino1_Reasoning_Path_FinQA", split="train[0:1000]", trust_remote_code=True
)
dataset = dataset.map(
    formatting_prompts_func,
    batched=True,
)
dataset["text"][20]
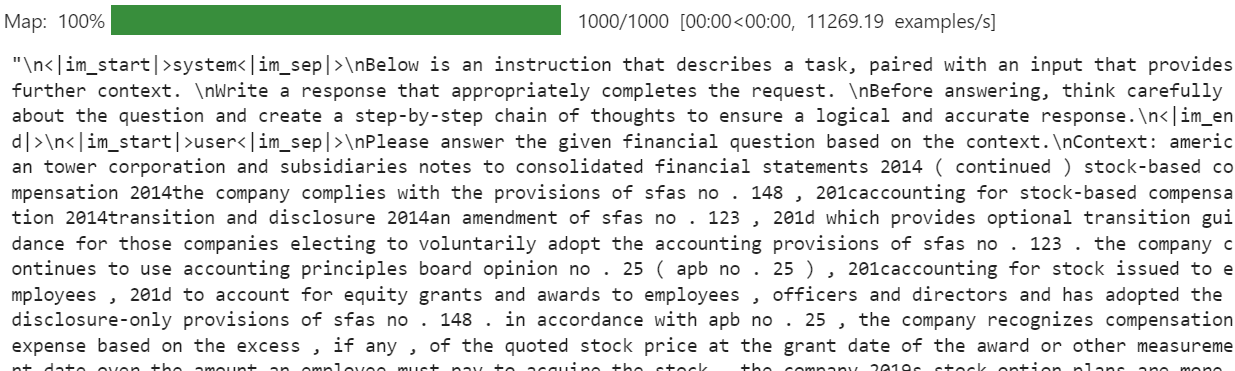
Veri kümesinin "text" sütunu; sistem talimatlarını, kullanıcı sorusunu, adım adım akıl yürütme zincirini ve nihai cevabı içerir. Bu yapılandırılmış format, modelin görevi anlamasını ve yüksek kaliteli yanıtlar üretmesini sağlar.
Yeni STF eğitici işlevi doğrudan bir belirteçleyici kabul etmez. Bu nedenle, Transformers’taki DataCollatorForLanguageModeling ile belirteçleyiciyi bir veri birleştiriciye dönüştürmemiz gerekir.
from transformers import DataCollatorForLanguageModeling

data_collator = DataCollatorForLanguageModeling(
    tokenizer=tokenizer,
    mlm=False
)İnce ayardan önce, modelin ince ayardan sonraki performansını karşılaştırmak için veri kümesinden bir soru üzerinde çıkarım yapacağız. Çıkarım istemi stili, eğitim istemi stiline benzer ancak akıl yürütme bölümünü ve cevabı içermez.
inference_prompt_style = """
<|im_start|>system<|im_sep|>
Below is an instruction that describes a task, paired with an input that provides further context.
Write a response that appropriately completes the request.
Before answering, think carefully about the question and create a step-by-step chain of thoughts to ensure a logical and accurate response.
<|im_end|>
<|im_start|>user<|im_sep|>
{}<|im_end|>
<|im_start|>assistant<|im_sep|>
<think>
{}
"""
Veri kümesinden 21. soruyu seçecek, biçimlendirecek ve çıkarım için belirteçleyeceğiz:
question = dataset[20]['Open-ended Verifiable Question']
inputs = tokenizer(
    [inference_prompt_style.format(question, "") + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs)
print(response[0].split("<|im_start|>assistant<|im_sep|>")[1])
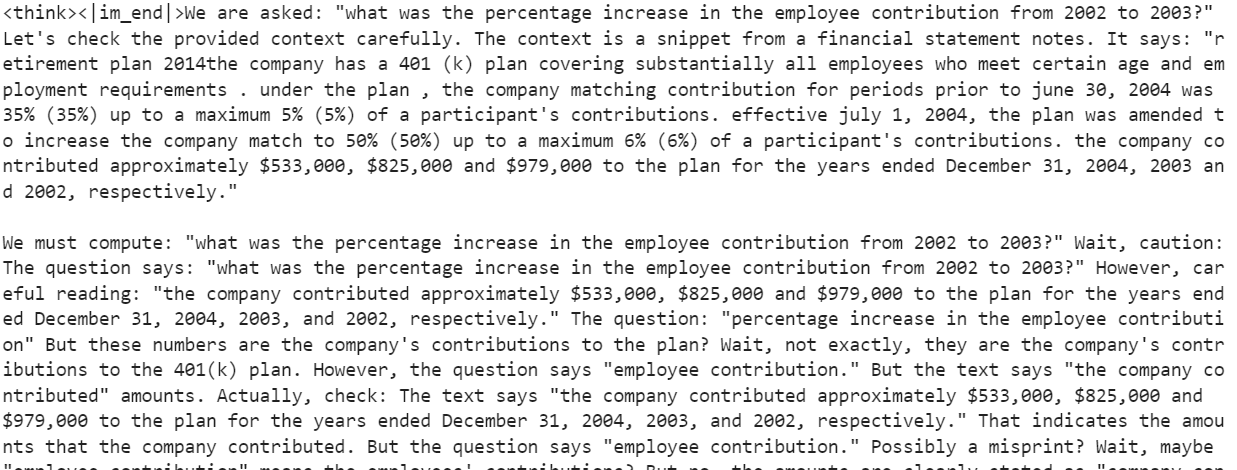
Model uzun bir akıl yürütme bölümü üretiyor ancak net bir cevap veremiyor. max_new_tokens değerini 2000’e çıkarmak bir cevap üretebilir; ancak bu yaklaşım verimsiz ve güvenilmezdir. Akıl yürütme dağınık ve sonuç isabetli değildir.
Bu bölümde, büyük dil modellerini (LLM’ler) yeni görevlere uyarlamak için tasarlanmış, parametre-verimli bir ince ayar tekniği olan LoRA (Düşük-Rank Uyarlama)’yı uygulayacağız. LoRA, modelin parametrelerinin büyük çoğunluğunu dondurup düşük-rank matrisler biçiminde küçük bir eğitilebilir parametre kümesi ekleyerek çalışır. Bu matrisler, modelin yeni görevlere uyum sağlamasına olanak tanıyan düşük-rank ayrıştırma formatında modele eklenir; böylece tüm model ağırlıklarını değiştirmeye veya saklamaya gerek kalmaz.
LoRA kullanarak, tam ince ayar ile karşılaştırılabilir doğruluğu korurken VRAM tüketimini ve eğitim süresini önemli ölçüde azaltabiliriz.
from peft import LoraConfig, get_peft_model

# LoRA config
peft_config = LoraConfig(
    lora_alpha=16,                           # Scaling factor for LoRA
    lora_dropout=0.05,                       # Add slight dropout for regularization
    r=64,                                    # Rank of the LoRA update matrices
    bias="none",                             # No bias reparameterization
    task_type="CAUSAL_LM",                   # Task type: Causal Language Modeling
    target_modules=[
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj",
        "gate_proj",
        "up_proj",
        "down_proj",
    ],  # Target modules for LoRA
)

model = get_peft_model(model, peft_config)
Şimdi SFTTrainer’ı kuracağız. Bu bileşen, veri kümesi, model, veri birleştirici, eğitim argümanları ve LoRA yapılandırması gibi temel unsurları tek ve yalın bir iş akışında bir araya getirerek ince ayar sürecini basitleştirir. Bu yaklaşım ince ayarı verimli, kullanıcı dostu ve yüksek derecede özelleştirilebilir kılar.
from trl import SFTTrainer
from transformers import TrainingArguments


# Training Arguments
training_arguments = TrainingArguments(
    output_dir="output",
    per_device_train_batch_size=1,
    per_device_eval_batch_size=1,
    gradient_accumulation_steps=2,
    optim="paged_adamw_32bit",
    num_train_epochs=1,
    logging_steps=0.2,
    warmup_steps=10,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    report_to="none"
)

# Initialize the Trainer
trainer = SFTTrainer(
    model=model,
    args=training_arguments,
    train_dataset=dataset,
    peft_config=peft_config,
    data_collator=data_collator,
)Eğitim sürecine başlamadan önce, bellek taşması (OOM) sorunlarından kaçınmak için RAM ve GPU VRAM’ini boşaltacağız. Bu, eğitim sırasında sorunsuz yürütmeyi sağlar.
import gc, torch
gc.collect()
torch.cuda.empty_cache()
model.config.use_cache = False
trainer.train()
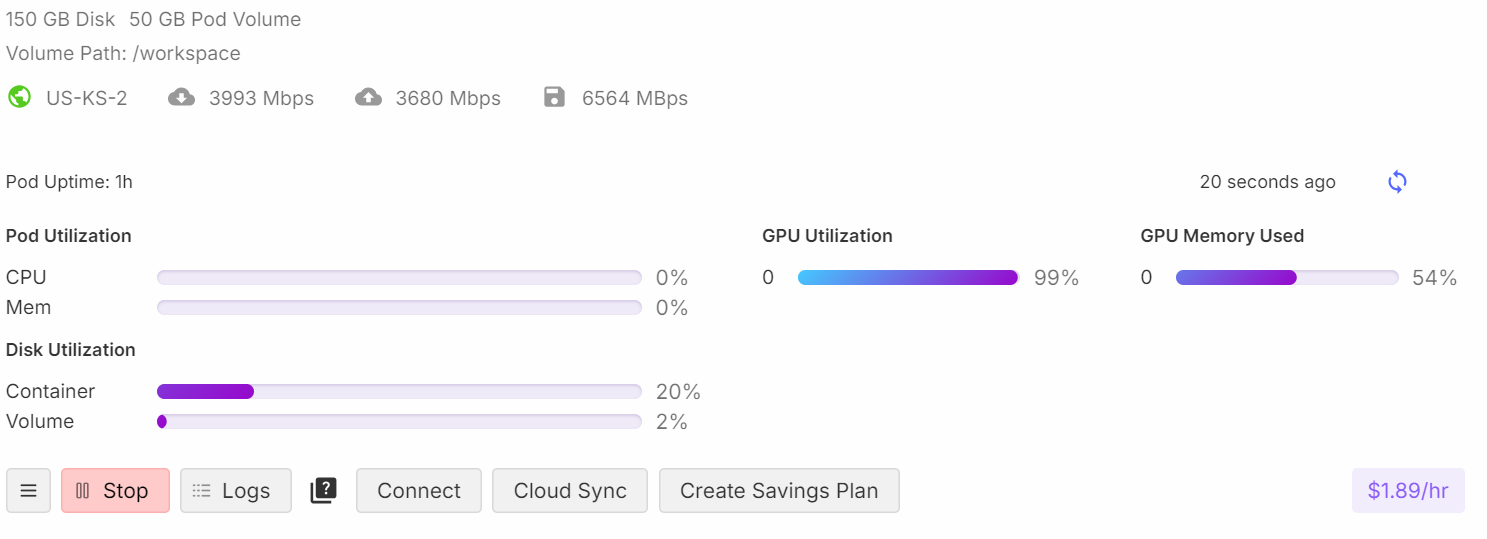
Eğitim sırasında süreç, belleğin yaklaşık %54’ünü kullanır ve %99 GPU kullanımına ulaşır; bu da kaynakların verimli kullanıldığını gösterir.
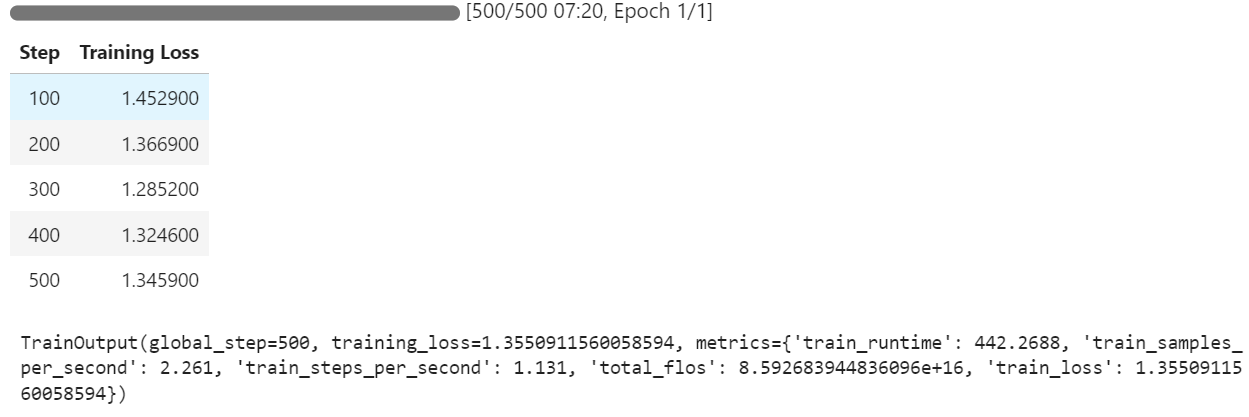
Eğitim kaybının her adımda azaldığını gözlemleyebilirsiniz; bu da modelin öğrendiğini ve etkili biçimde ince ayarlandığını gösterir.
Şimdi, modelin yanıtlarını veri kümesiyle karşılaştırarak ince ayarlı modeli test edeceğiz. Önceki bölümdeki aynı soruyu kullanarak bir yanıt üretiyoruz:
question = dataset[20]['Open-ended Verifiable Question']
inputs = tokenizer(
    [inference_prompt_style.format(question, "") + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs)
print(response[0].split("<|im_start|>assistant<|im_sep|>")[1])
Akıl yürütme bölümü ayrıntılı ve doğru; cevap veri kümesiyle büyük ölçüde örtüşüyor.
<think><|im_end|>First, I need to figure out what the employee contributions were for the years 2002 and 2003. Okay, looking at the numbers, I see that the company contributed $979,000 in 2002 and $825,000 in 2003. So, those are my two key figures.

Next, I'll calculate the change in the contribution amount. To find this, I subtract the 2003 contribution from the 2002 contribution. Let me do that: $979,000 minus $825,000 equals $154,000. So, there's a decrease of $154,000 from 2002 to 2003.

Now, I need to understand what this decrease means in terms of percentage. Percentage change is usually calculated by taking the change, dividing it by the original number, and then multiplying by 100. So, I'll take that $154,000 change and divide it by the 2002 amount, $979,000.

Let me do that math: $154,000 divided by $979,000... Hmm, this gives me a value of approximately 0.1573.

Finally, I multiply that by 100 to convert it to a percentage. That gives me about 15.73%.

Oh, wait, let me make sure everything makes sense. I calculated the change in contributions correctly by subtracting the 2003 amount from the 2002 amount. Then I used the original amount from 2002 as the base for the percentage calculation.

Yes, that all seems right. So, the employee contribution decreased by approximately 15.73% from 2002 to 2003.</think>The percentage decrease in the employee contribution from 2002 to 2003 was approximately 15.73%.<|im_end|>
Başka bir örnek deneyelim:
question = dataset[200]['Open-ended Verifiable Question']
inputs = tokenizer(
    [inference_prompt_style.format(question, "") + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs)
print(response[0].split("<|im_start|>assistant<|im_sep|>")[1])
Sonuç etkileyici; model, veri kümesinin tarzında doğru akıl yürütme ve yanıtlar üretiyor:
<think><|im_end|>Okay, let's figure out how much of the long-term debt should be considered current liabilities. So, the total long-term debt at the end of 2011 was $1859 million. Now, I remember that there's some information about the timing of cash payments related to this debt. In particular, there's a chunk of $29 million that is due in 2012. Hmm, that's the part that's likely to become a current liability.

Let’s check the table again to make sure. It says total long-term debt is $1859 million, and the breakdown of estimated cash payments includes $29 million for 2012. Yep, that seems to align. So, this $29 million should be classified as a current liability because it's due within the next year.

But wait, let me double-check. The table is pretty straightforward: long-term debt is $1859 million and the breakdown clearly shows $29 million due in 2012. So, that $29 million is the part that should be on the current liabilities section of the balance sheet.

Alright, so I'm confident that the portion of the long-term debt that's included in current liabilities as of December 31, 2011, is $29 million. That's it!</think>The portion of the long-term debt included in the current liabilities on the balance sheet as of December 31, 2011, is $29 million. This $29 million represents the amount of debt due within the next year, making it a current liability.<|im_end|>İnce ayarlı modele gelecekte erişebilmek ve başkalarının indirebilmesini sağlamak için model adaptörünü ve belirteçleyiciyi kaydedip Hugging Face Hub’a göndereceğiz:
new_model_name = "Phi-4-Reasoning-Plus-FinQA-COT"
model.push_to_hub(new_model_name)
tokenizer.push_to_hub(new_model_name)
Model artık herkese açık olarak şu adreste mevcut: kingabzpro/Phi-4-Reasoning-Plus-FinQA-COT.
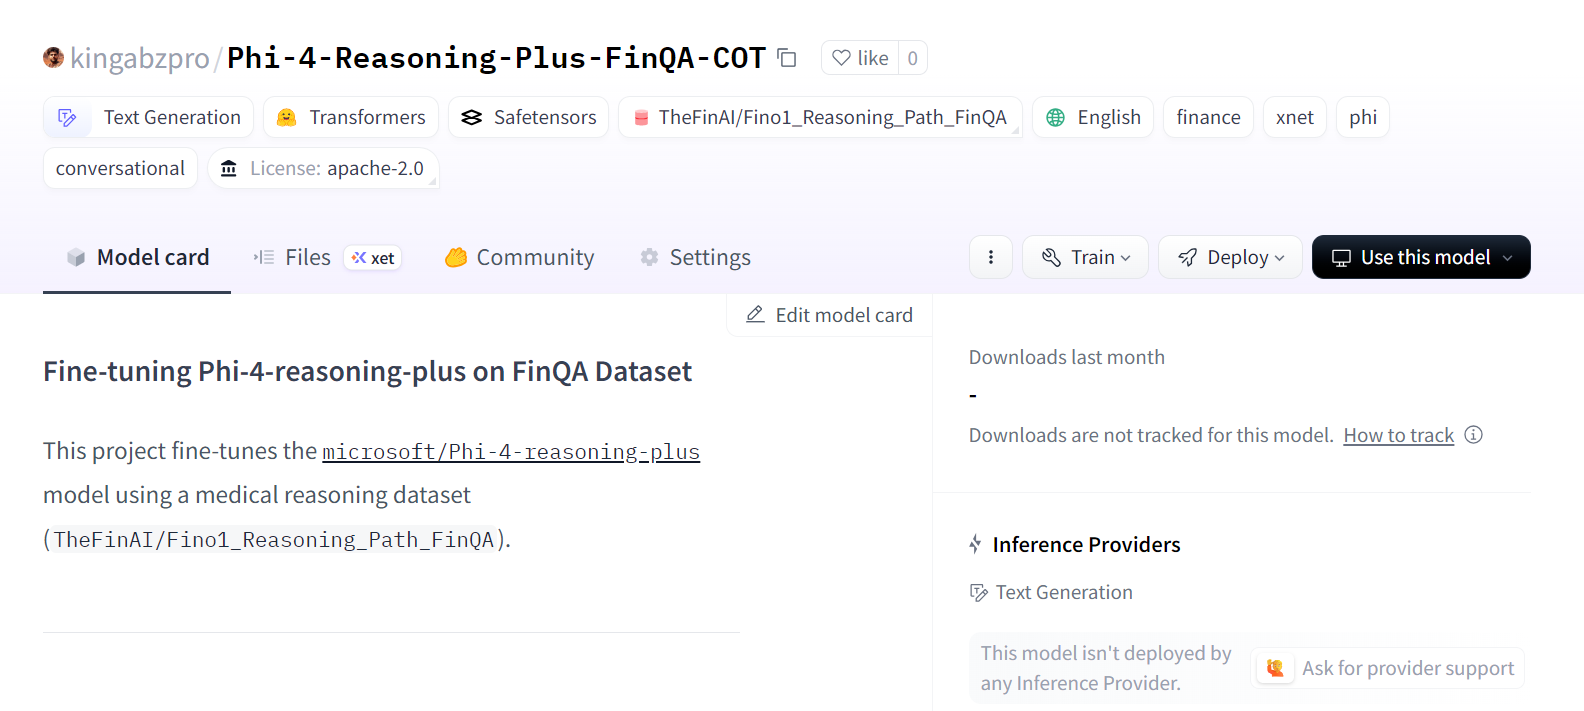
Kaynak: kingabzpro/Phi-4-Reasoning-Plus-FinQA-COT · Hugging Face
İnce ayar komut dosyasını çalıştırırken herhangi bir sorunla karşılaşırsanız, eşlik eden not defterine bakın: fine-tuning-phi-4-reasoning.ipynb.
Phi-4 Reasoning modeli, açık kaynak topluluğu için önemli bir ilerlemeyi temsil ediyor. 685B parametreli dev modellere güvenmek yerine, Phi-4 Reasoning daha küçük ve verimli bir mimariyle daha iyi sonuçlar elde ediyor. Bu da yüksek kaliteli veri kümelerine ve pekiştirmeli öğrenmeye odaklanmanın, daha küçük modellerde dahi daha iyi performans sağlayabileceğini gösteriyor.
Phi-4 Reasoning modelini ince ayarlamanın en iyi yönlerinden biri, uygun maliyetli ve verimli olmasıdır. Bu modeli 20 bin veya daha fazla örnek üzerinde ince ayarlamak, daha küçük boyutu ve optimize edilmiş mimarisi sayesinde size 10 dolardan daha aza mal olur ve yalnızca birkaç saat sürer.
Phi-4 Reasoning gibi daha küçük modeller, yalnızca ince ayar maliyetlerini düşürmekle kalmaz, aynı zamanda model çıkarımı için bulut altyapı giderlerinden de tasarruf sağlar. Bu da onları, devasa modellerin yükü olmadan yüksek performans gerektiren projeler için mükemmel bir seçenek haline getirir.
Daha fazla bilgi için çeşitli büyük dil modellerini ince ayarlamaya yönelik rehberlerimize bakın:
En İyi DataCamp Kursları
Kurs
Program
Program
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




