
Curso
Ajuste Fino com Llama 3
2 h
4K
Phi-4-reasoning é um modelo open-weight com 14 bilhões de parâmetros, projetado para tarefas de raciocínio complexas. Graças a um fine-tuning cuidadoso em datasets selecionados, ele rivaliza com modelos bem maiores. O modelo gera cadeias de raciocínio detalhadas e aproveita o compute em tempo de inferência para alcançar desempenho excepcional.
Sua versão aprimorada, Phi-4-reasoning-plus, usa aprendizado por reforço e 1,5x mais tokens para entregar ainda mais precisão. Apesar do tamanho menor, ambos superam modelos maiores como o DeepSeek-R1-Distill-70B e chegam a ultrapassar o DeepSeek-R1 com 671 bilhões de parâmetros em benchmarks.
Neste tutorial, vamos usar o modelo Phi-4-reasoning-plus e fazer fine-tuning nele com o dataset de raciocínio Financial Q&A. O guia inclui: configurar o ambiente no Runpod, carregar o modelo, o tokenizer e o dataset, preparar os dados para treino, configurar o modelo para treinamento, rodar avaliações e salvar o adaptador do modelo ajustado.
Você pode saber mais sobre o Phi 4 e criar um tutor de linguagem multimodal seguindo o tutorial Phi-4-Multimodal: um guia com projeto demo.
Imagem do autor
Neste tutorial, vamos usar o RunPod como nosso ambiente computacional. Siga estes passos para configurar seu ambiente:
1. Acesse o Dashboard do RunPod e clique em “Deploy On-Demand” para criar um novo pod.
2. Selecione a GPU A100, suficiente para carregar e fazer fine-tuning do modelo.
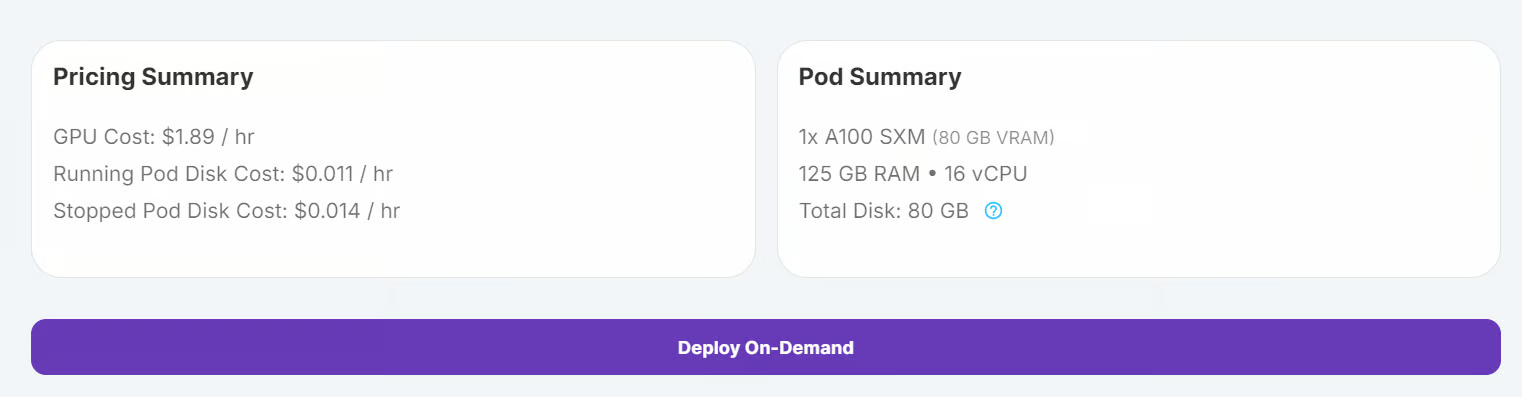
3. Personalize sua implantação:
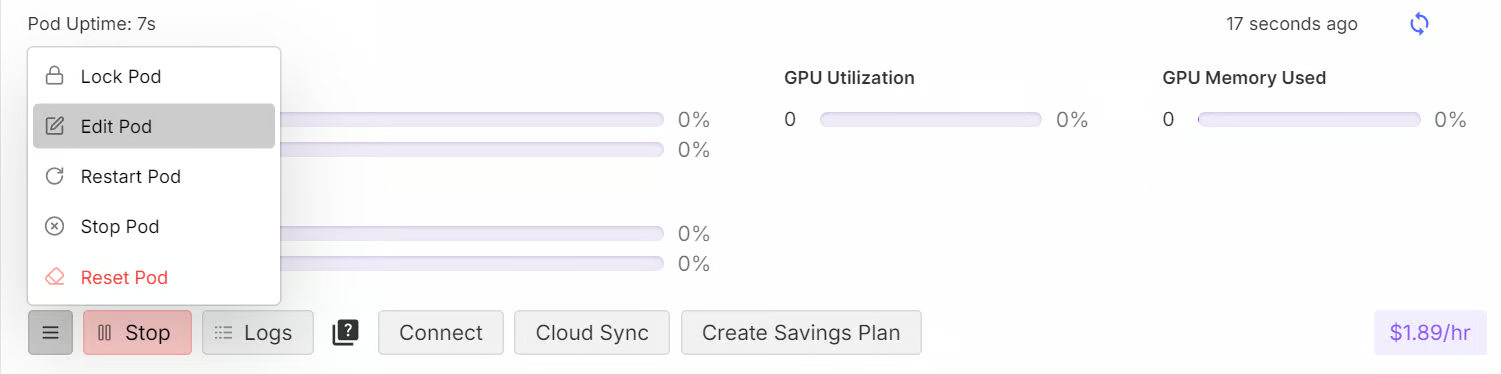
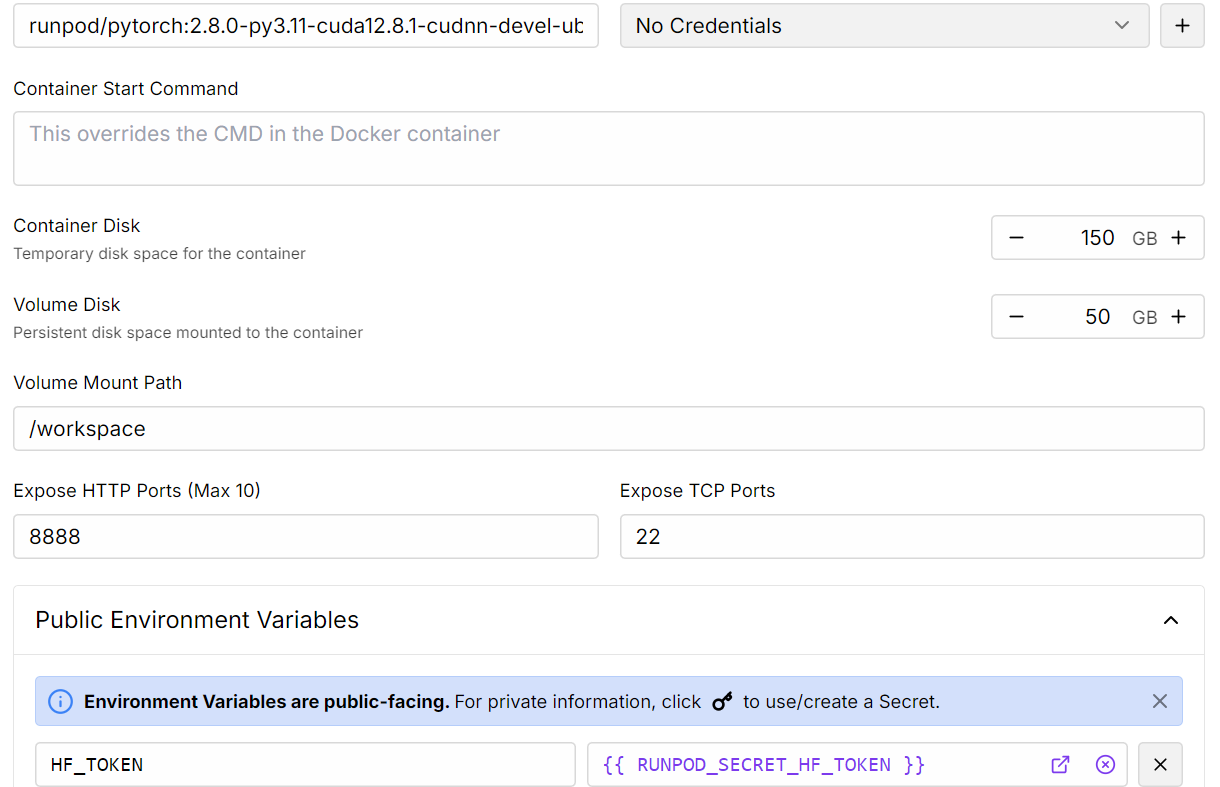
4. Quando o pod estiver no ar, clique em Connect para abrir o JupyterLab.
5. No JupyterLab, crie um novo notebook e instale todos os pacotes Python necessários.
%%capture
%pip install -U transformers
%pip install -U datasets
%pip install -U accelerate
%pip install -U peft
%pip install -U trl
%pip install -U bitsandbytes
%pip install huggingface_hub[hf_xet]
6. Em seguida, faça login na CLI do Hugging Face usando o token que você salvou.
from huggingface_hub import login
import os

hf_token = os.environ.get("HF_TOKEN")
login(hf_token)Neste guia, vamos carregar o modelo completo microsoft/Phi-4-reasoning-plus do Hugging Face, junto com o tokenizer correspondente.
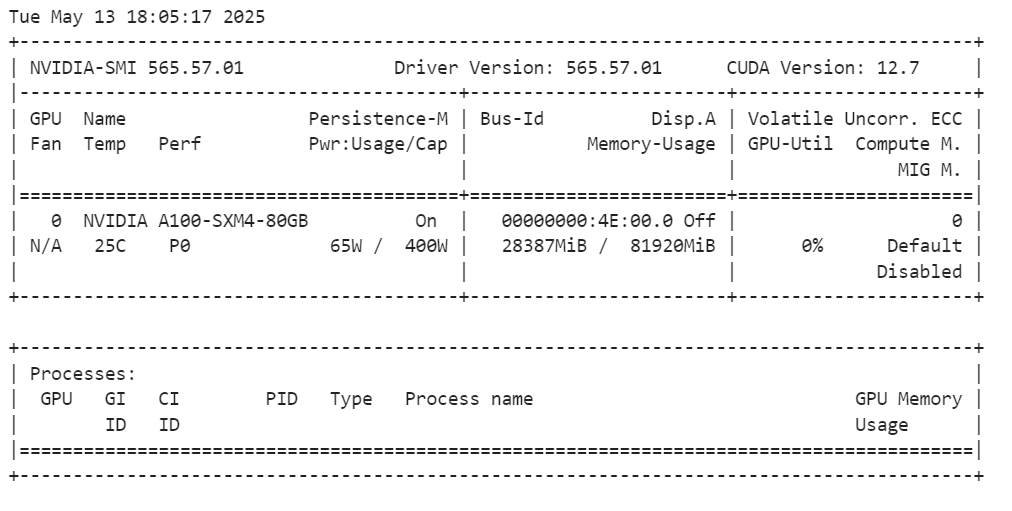
Não usamos quantização em 4 bits aqui porque o hardware lida bem com pesos em precisão total. Uma A100 com 80 GB de VRAM sobra bastante folga: o Phi-4-Reasoning completo ocupa ~28 GB, então ainda ficam mais de 50 GB livres para ativações, estados do otimizador e outras sobrecargas do treinamento.
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch

# Load tokenizer & model
model_dir = "microsoft/Phi-4-reasoning-plus"

tokenizer = AutoTokenizer.from_pretrained(model_dir, use_fast=True)

model = AutoModelForCausalLM.from_pretrained(
    model_dir,
    device_map="auto",
    torch_dtype=torch.bfloat16,
    trust_remote_code=True
)

model.config.use_cache = False
model.config.pretraining_tp = 1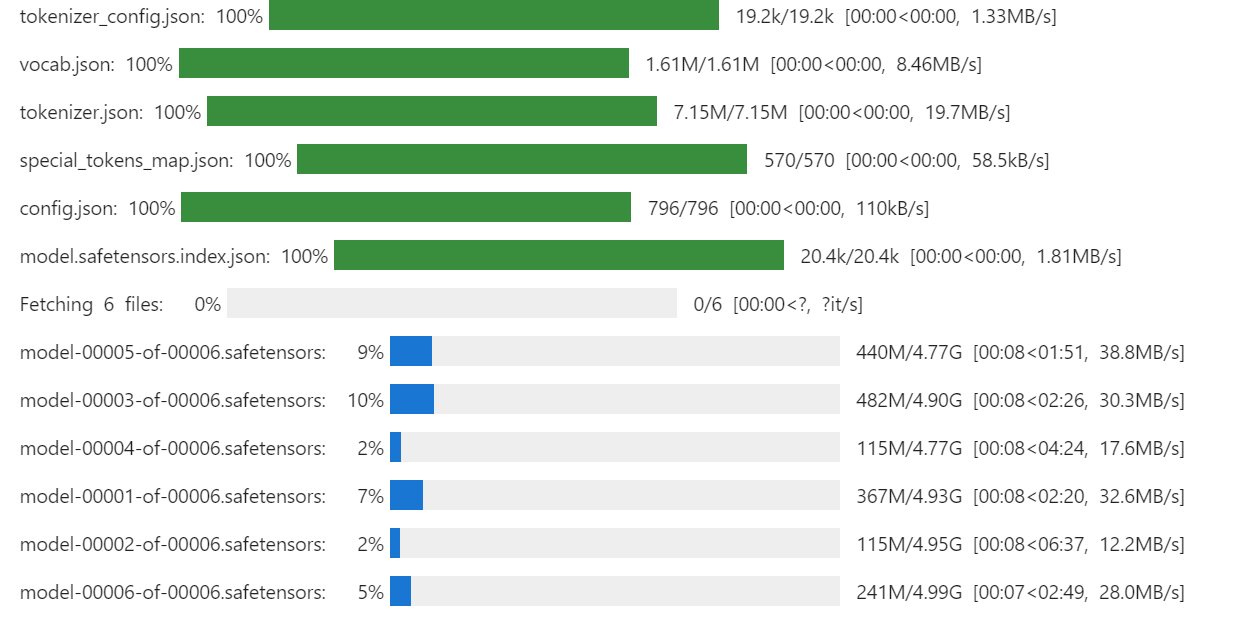
Depois de carregar o modelo, você pode verificar o consumo de memória da GPU executando:
!nvidia-smiO modelo completo usa cerca de 28 GB de VRAM. A GPU A100 tem 80 GB, então você ainda tem ~55 GB livres para tarefas de fine-tuning.
Antes de carregar o dataset, vamos definir um estilo de prompt de treinamento. Esse prompt inclui:
Esse estilo de prompt incentiva o modelo a pensar de forma crítica e produzir um processo de raciocínio junto com a resposta final.
train_prompt_style="""
<|im_start|>system<|im_sep|>
Below is an instruction that describes a task, paired with an input that provides further context.
Write a response that appropriately completes the request.
Before answering, think carefully about the question and create a step-by-step chain of thoughts to ensure a logical and accurate response.
<|im_end|>
<|im_start|>user<|im_sep|>
{}<|im_end|>
<|im_start|>assistant<|im_sep|>
<think>
{}
</think>
{}
"""
Vamos criar uma função em Python para aplicar as colunas do dataset (perguntas, raciocínios e respostas) ao template de prompt. Essa função vai gerar uma nova coluna chamada “text”, que reúne todos os componentes do prompt.
EOS_TOKEN = tokenizer.eos_token  # Must add EOS_TOKEN

def formatting_prompts_func(examples):
    inputs = examples["Open-ended Verifiable Question"]
    complex_cots = examples["Complex_CoT"]
    outputs = examples["Response"]
    texts = []
    for input, cot, output in zip(inputs,complex_cots,outputs):
        text = train_prompt_style.format(input,cot,output) + EOS_TOKEN
        texts.append(text)
    return {
        "text": texts,
    }
Agora vamos baixar o dataset (TheFinAI/Fino1_Reasoning_Path_FinQA), carregar 1000 amostras, aplicar a função de formatação e criar a nova coluna “text”.
from datasets import load_dataset

dataset = load_dataset(
    "TheFinAI/Fino1_Reasoning_Path_FinQA", split="train[0:1000]", trust_remote_code=True
)
dataset = dataset.map(
    formatting_prompts_func,
    batched=True,
)
dataset["text"][20]
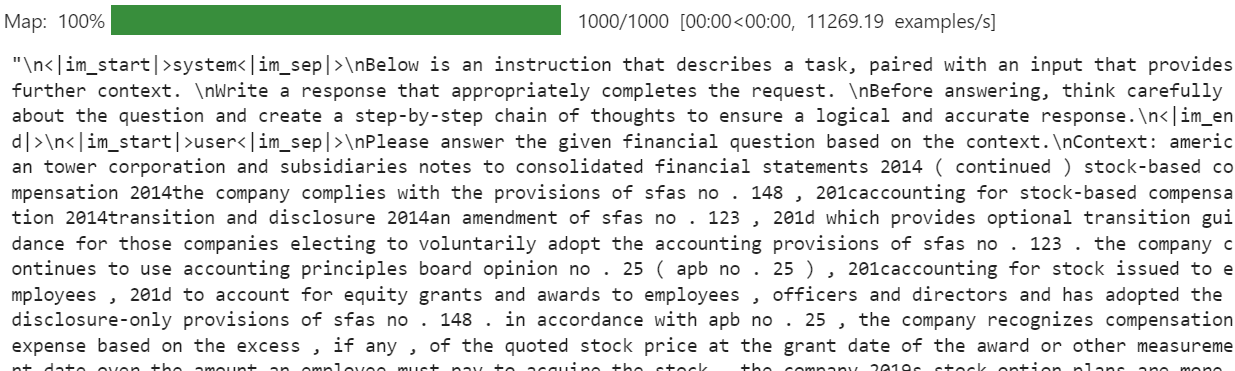
A coluna "text" do dataset inclui instruções de sistema, a pergunta do usuário, uma cadeia de raciocínio passo a passo e a resposta final. Esse formato estruturado ajuda o modelo a entender a tarefa e gerar respostas de alta qualidade.
A nova função do treinador SFT não aceita um tokenizer diretamente. Por isso, precisamos convertê-lo em um data collator usando o DataCollatorForLanguageModeling da Transformers.
from transformers import DataCollatorForLanguageModeling

data_collator = DataCollatorForLanguageModeling(
    tokenizer=tokenizer,
    mlm=False
)Antes do fine-tuning, vamos rodar a inferência em uma pergunta do dataset para comparar o desempenho após o ajuste. O prompt de inferência é similar ao do treino, mas sem a parte de raciocínio e a resposta.
inference_prompt_style = """
<|im_start|>system<|im_sep|>
Below is an instruction that describes a task, paired with an input that provides further context.
Write a response that appropriately completes the request.
Before answering, think carefully about the question and create a step-by-step chain of thoughts to ensure a logical and accurate response.
<|im_end|>
<|im_start|>user<|im_sep|>
{}<|im_end|>
<|im_start|>assistant<|im_sep|>
<think>
{}
"""
Vamos selecionar a 21ª pergunta do dataset, formatá-la e tokenizá-la para inferência:
question = dataset[20]['Open-ended Verifiable Question']
inputs = tokenizer(
    [inference_prompt_style.format(question, "") + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs)
print(response[0].split("<|im_start|>assistant<|im_sep|>")[1])
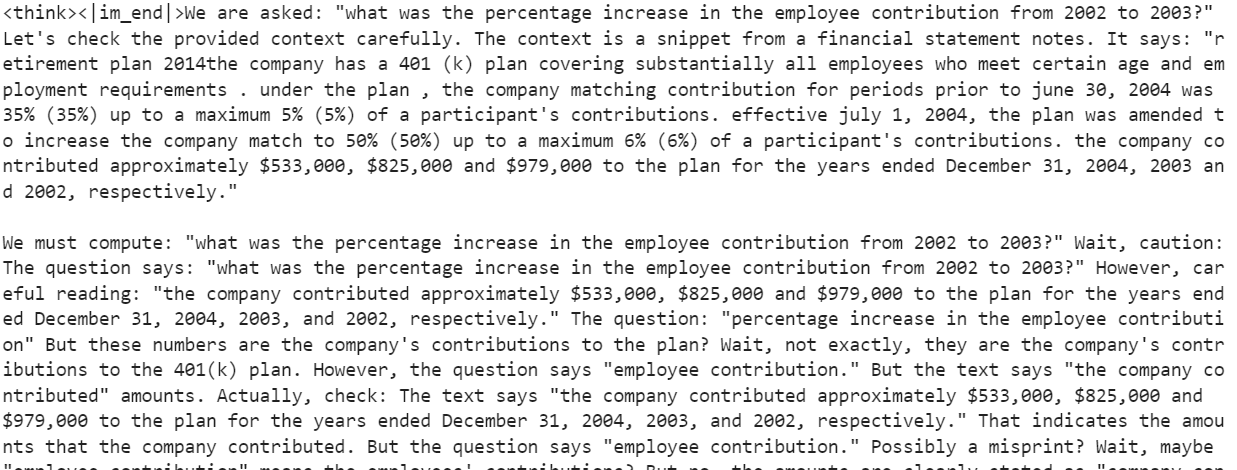
O modelo gera um raciocínio longo, mas não entrega uma resposta clara. Aumentar max_new_tokens para 2000 pode até gerar uma resposta, mas é ineficiente e pouco confiável. O raciocínio fica difuso e a conclusão, imprecisa.
Nesta seção, vamos implementar LoRA (Low-Rank Adaptation), uma técnica de fine-tuning eficiente em parâmetros para adaptar LLMs a novas tarefas. O LoRA congela a maior parte dos parâmetros e introduz um pequeno conjunto de parâmetros treináveis em forma de matrizes de baixo rank. Essas matrizes são adicionadas ao modelo em decomposição de baixo rank, permitindo adaptá-lo sem modificar ou armazenar todos os pesos originais.
Com LoRA, conseguimos reduzir significativamente o consumo de VRAM e o tempo de treino, mantendo uma acurácia próxima ao fine-tuning completo.
from peft import LoraConfig, get_peft_model

# LoRA config
peft_config = LoraConfig(
    lora_alpha=16,                           # Scaling factor for LoRA
    lora_dropout=0.05,                       # Add slight dropout for regularization
    r=64,                                    # Rank of the LoRA update matrices
    bias="none",                             # No bias reparameterization
    task_type="CAUSAL_LM",                   # Task type: Causal Language Modeling
    target_modules=[
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj",
        "gate_proj",
        "up_proj",
        "down_proj",
    ],  # Target modules for LoRA
)

model = get_peft_model(model, peft_config)
Agora, vamos configurar o SFTTrainer, que simplifica o processo ao reunir dataset, modelo, data collator, argumentos de treino e configuração de LoRA em um fluxo único e enxuto. Isso torna o fine-tuning eficiente, prático e altamente customizável.
from trl import SFTTrainer
from transformers import TrainingArguments


# Training Arguments
training_arguments = TrainingArguments(
    output_dir="output",
    per_device_train_batch_size=1,
    per_device_eval_batch_size=1,
    gradient_accumulation_steps=2,
    optim="paged_adamw_32bit",
    num_train_epochs=1,
    logging_steps=0.2,
    warmup_steps=10,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    report_to="none"
)

# Initialize the Trainer
trainer = SFTTrainer(
    model=model,
    args=training_arguments,
    train_dataset=dataset,
    peft_config=peft_config,
    data_collator=data_collator,
)Antes de iniciar o treino, vamos liberar RAM e VRAM para evitar erros de falta de memória (OOM). Isso garante uma execução mais estável.
import gc, torch
gc.collect()
torch.cuda.empty_cache()
model.config.use_cache = False
trainer.train()
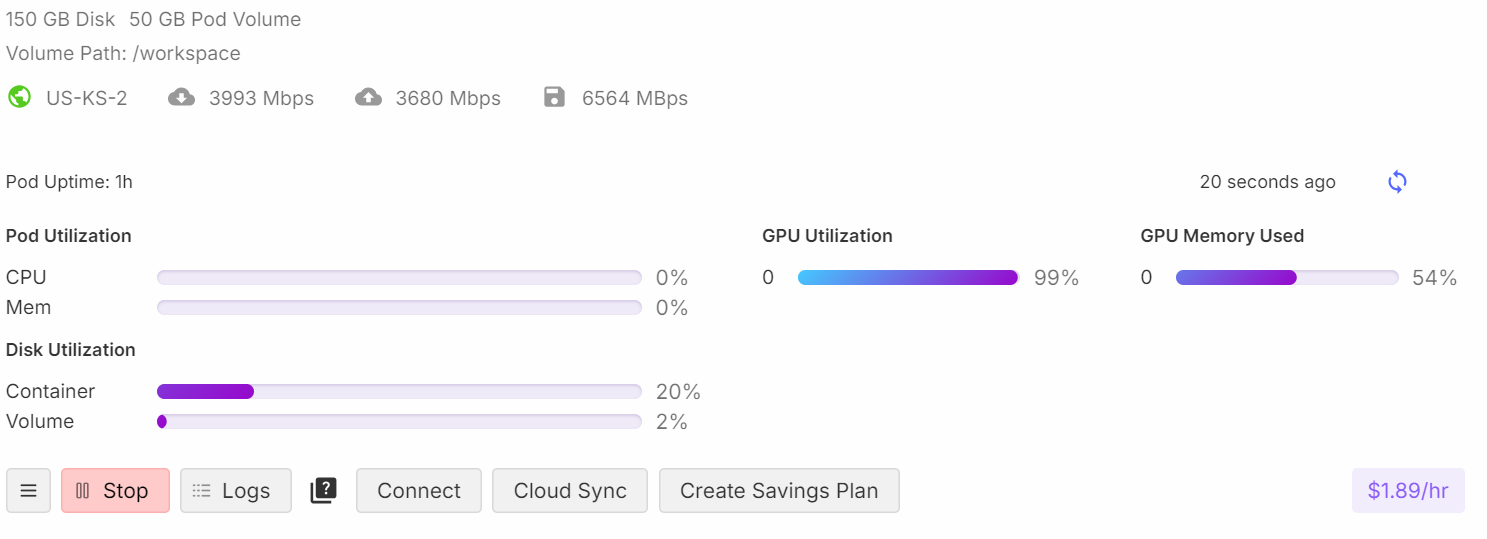
Durante o treinamento, o processo usa cerca de 54% da memória e atinge 99% de utilização de GPU, aproveitando bem os recursos.
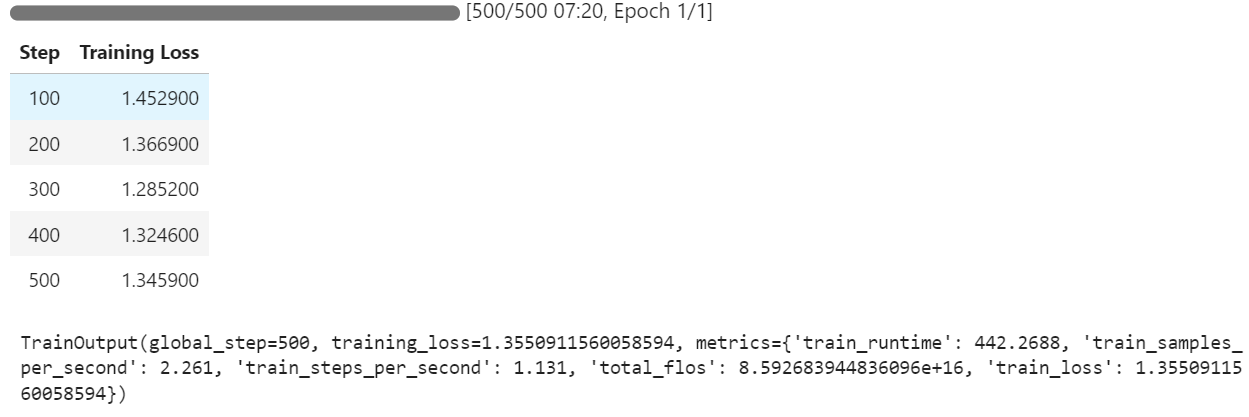
Você vai notar que a training loss cai a cada etapa, mostrando que o modelo está aprendendo e ajustando bem.
Agora vamos testar o modelo ajustado comparando suas respostas com o dataset. Usando a mesma pergunta da seção anterior, geramos uma resposta:
question = dataset[20]['Open-ended Verifiable Question']
inputs = tokenizer(
    [inference_prompt_style.format(question, "") + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs)
print(response[0].split("<|im_start|>assistant<|im_sep|>")[1])
A parte de raciocínio fica detalhada e correta, e a resposta fica muito próxima da do dataset.
<think><|im_end|>First, I need to figure out what the employee contributions were for the years 2002 and 2003. Okay, looking at the numbers, I see that the company contributed $979,000 in 2002 and $825,000 in 2003. So, those are my two key figures.

Next, I'll calculate the change in the contribution amount. To find this, I subtract the 2003 contribution from the 2002 contribution. Let me do that: $979,000 minus $825,000 equals $154,000. So, there's a decrease of $154,000 from 2002 to 2003.

Now, I need to understand what this decrease means in terms of percentage. Percentage change is usually calculated by taking the change, dividing it by the original number, and then multiplying by 100. So, I'll take that $154,000 change and divide it by the 2002 amount, $979,000.

Let me do that math: $154,000 divided by $979,000... Hmm, this gives me a value of approximately 0.1573.

Finally, I multiply that by 100 to convert it to a percentage. That gives me about 15.73%.

Oh, wait, let me make sure everything makes sense. I calculated the change in contributions correctly by subtracting the 2003 amount from the 2002 amount. Then I used the original amount from 2002 as the base for the percentage calculation.

Yes, that all seems right. So, the employee contribution decreased by approximately 15.73% from 2002 to 2003.</think>The percentage decrease in the employee contribution from 2002 to 2003 was approximately 15.73%.<|im_end|>
Vamos testar outro exemplo:
question = dataset[200]['Open-ended Verifiable Question']
inputs = tokenizer(
    [inference_prompt_style.format(question, "") + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs)
print(response[0].split("<|im_start|>assistant<|im_sep|>")[1])
O resultado impressiona: o modelo gera raciocínio e respostas corretas no estilo do dataset:
<think><|im_end|>Okay, let's figure out how much of the long-term debt should be considered current liabilities. So, the total long-term debt at the end of 2011 was $1859 million. Now, I remember that there's some information about the timing of cash payments related to this debt. In particular, there's a chunk of $29 million that is due in 2012. Hmm, that's the part that's likely to become a current liability.

Let’s check the table again to make sure. It says total long-term debt is $1859 million, and the breakdown of estimated cash payments includes $29 million for 2012. Yep, that seems to align. So, this $29 million should be classified as a current liability because it's due within the next year.

But wait, let me double-check. The table is pretty straightforward: long-term debt is $1859 million and the breakdown clearly shows $29 million due in 2012. So, that $29 million is the part that should be on the current liabilities section of the balance sheet.

Alright, so I'm confident that the portion of the long-term debt that's included in current liabilities as of December 31, 2011, is $29 million. That's it!</think>The portion of the long-term debt included in the current liabilities on the balance sheet as of December 31, 2011, is $29 million. This $29 million represents the amount of debt due within the next year, making it a current liability.<|im_end|>Para tornar o modelo ajustado acessível no futuro e para outras pessoas baixarem, vamos salvar o adaptador e o tokenizer e publicá-los no Hugging Face Hub:
new_model_name = "Phi-4-Reasoning-Plus-FinQA-COT"
model.push_to_hub(new_model_name)
tokenizer.push_to_hub(new_model_name)
O modelo está público em: kingabzpro/Phi-4-Reasoning-Plus-FinQA-COT.
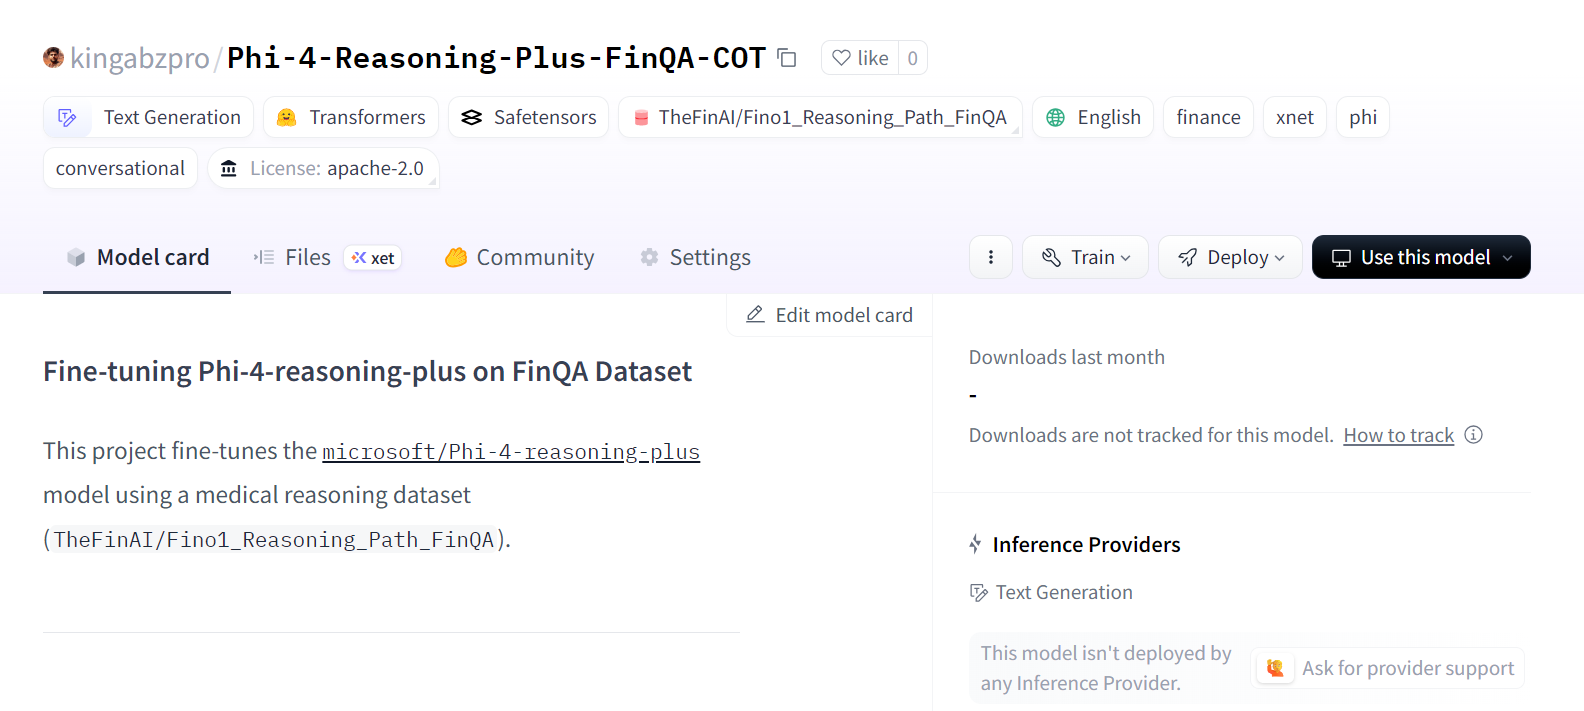
Fonte: kingabzpro/Phi-4-Reasoning-Plus-FinQA-COT · Hugging Face
Se você tiver qualquer problema ao rodar o script de fine-tuning, confira o notebook complementar: fine-tuning-phi-4-reasoning.ipynb.
O Phi-4 Reasoning representa um avanço importante para a comunidade open source. Em vez de depender de modelos gigantes com 685 bilhões de parâmetros, o Phi-4 Reasoning alcança resultados melhores com uma arquitetura menor e mais eficiente. Isso mostra que focar em datasets de alta qualidade e em aprendizado por reforço pode gerar desempenho superior em modelos compactos.
Um dos grandes destaques do fine-tuning do Phi-4 Reasoning é o custo-benefício e a eficiência. Ajustar esse modelo em 20 mil amostras (ou mais) custa menos de US$ 10 e leva só algumas horas, graças ao tamanho menor e à arquitetura otimizada.
Modelos menores como o Phi-4 Reasoning não só reduzem os custos de fine-tuning, como também economizam na infraestrutura de nuvem para inferência. É uma ótima escolha para projetos que exigem alta performance sem o peso de modelos massivos.
Para saber mais, confira nossos guias de fine-tuning de diferentes LLMs:
Principais cursos da DataCamp
Curso
Programa
Programa