

Khóa học
Nhập môn Thống kê
4 giờ
163.9K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleThành thạo các công cụ phân tích dữ liệu mà không hiểu các khái niệm phía sau chẳng khác nào có một hộp dụng cụ tua vít nhưng không biết khi nào và cách dùng từng cái. Học thống kê rất quan trọng vì sự trỗi dậy của các công cụ phân tích do AI tạo ra và hỗ trợ sẽ khiến kỹ năng kỹ thuật bớt lợi thế cạnh tranh, nhường chỗ cho năng lực thấu hiểu kiến thức và tư duy phản biện.
Tôi mong bạn đừng ngại sự phức tạp của thống kê. Bài viết này nhằm đưa ra một hướng dẫn toàn diện về các khái niệm thống kê liên quan nhất cho nhà phân tích dữ liệu và nhà khoa học dữ liệu thông qua 35 câu hỏi phỏng vấn thống kê kèm đáp án. Dù bạn có đang chuẩn bị phỏng vấn hay không, tôi tin bạn sẽ thấy những câu hỏi này hữu ích.
Cuối cùng, trước khi bắt đầu, hãy cân nhắc tham gia khóa học Giới thiệu về Thống kê trong R của chúng tôi để học các nền tảng, bao gồm cách thực hiện phân tích thống kê và diễn giải kết quả. Ngoài ra, nếu bạn đang tích cực chuẩn bị cho phỏng vấn cần hiểu biết thống kê, hai khóa học DataCamp sau bao quát tất cả chủ đề thống kê thường gặp nhất: Luyện tập Câu hỏi Phỏng vấn Thống kê bằng Python và Luyện tập Câu hỏi Phỏng vấn Thống kê trong R.
Hầu hết, nếu không muốn nói là tất cả, công việc phân tích dữ liệu đều yêu cầu hiểu biết cơ bản về thống kê, bao gồm thống kê mô tả, thống kê suy luận và xác suất. Nếu bạn cần ôn lại thống kê mô tả trước phỏng vấn, hãy tải Cheat Sheet Thống kê Mô tả của chúng tôi để tham khảo nhanh. Ngoài ra, nếu bạn muốn thực hành một số phép tính và phương pháp, hãy xem các hướng dẫn DataCamp sau để đi sâu hơn các khái niệm liên quan:
Phương sai và độ lệch chuẩn đều đo mức độ phân tán hay độ trải của một tập dữ liệu. Phương sai là trung bình của bình phương sai khác so với trung bình. Nó cho biết các giá trị trong tập dữ liệu khác trung bình bao nhiêu. Tuy nhiên, vì dùng bình phương sai khác nên đơn vị cũng bị bình phương, có thể kém trực quan hơn độ lệch chuẩn. Độ lệch chuẩn là căn bậc hai của phương sai, đưa đơn vị quay về giống dữ liệu gốc. Nó cung cấp thước đo độ phân tán dễ diễn giải hơn. Ví dụ, nếu phương sai của một tập dữ liệu là 25, độ lệch chuẩn là √25 = 5.
Độ lệch đo độ bất đối xứng của một tập dữ liệu quanh trung bình, có thể dương, âm hoặc bằng không. Dữ liệu có độ lệch dương, hay lệch phải, có đuôi phải dài hơn, nghĩa là trung bình lớn hơn trung vị. Dữ liệu có độ lệch âm, hay lệch trái, có đuôi trái dài hơn, nghĩa là trung bình nhỏ hơn trung vị. Độ lệch bằng không cho thấy phân phối đối xứng, như phân phối chuẩn, nơi trung bình, trung vị và mốt bằng nhau.
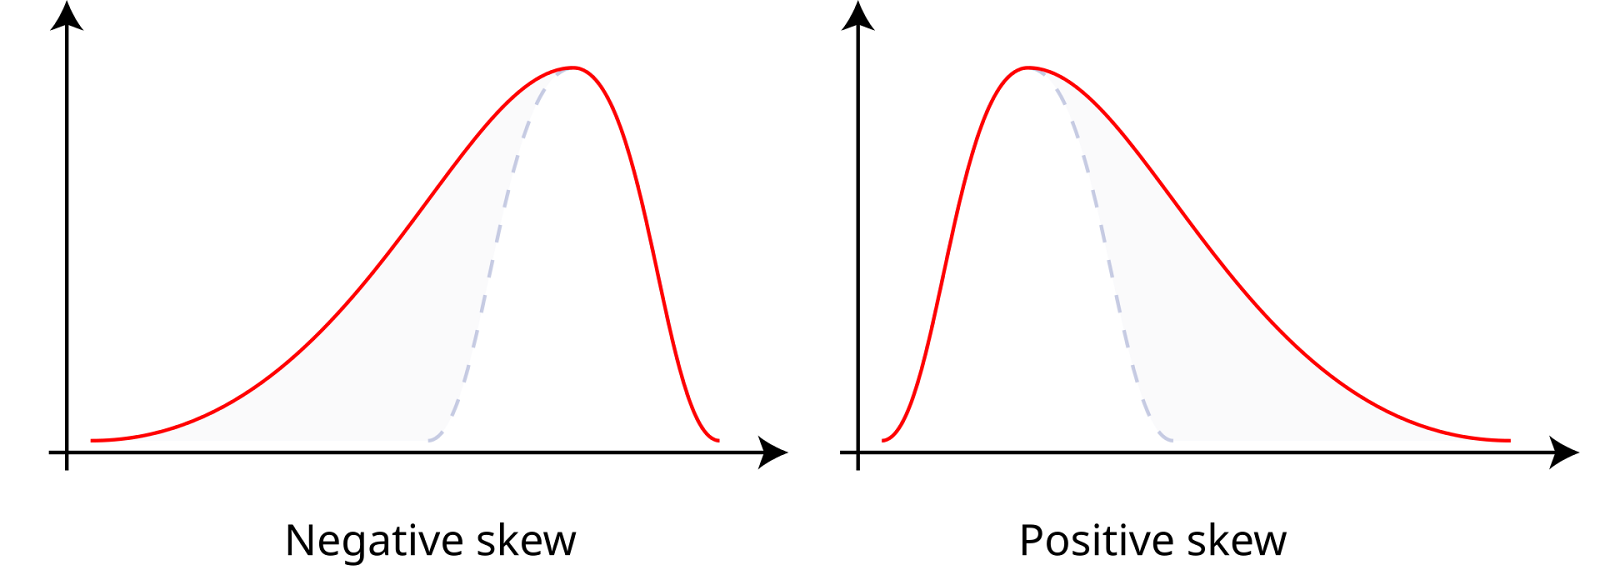
Độ lệch dương và âm. Nguồn: Wikiversity.
Histogram là biểu đồ thể hiện phân phối của một tập dữ liệu. Nó chia dữ liệu thành các ngăn (khoảng) và hiển thị tần suất (hoặc số lượng) điểm dữ liệu trong mỗi ngăn. Histogram dùng để hiểu phân phối tần suất cơ bản (hình dạng) của dữ liệu liên tục. Chúng giúp nhận diện các mẫu như độ lệch, tính đa đỉnh (số đỉnh) và sự xuất hiện của ngoại lệ.
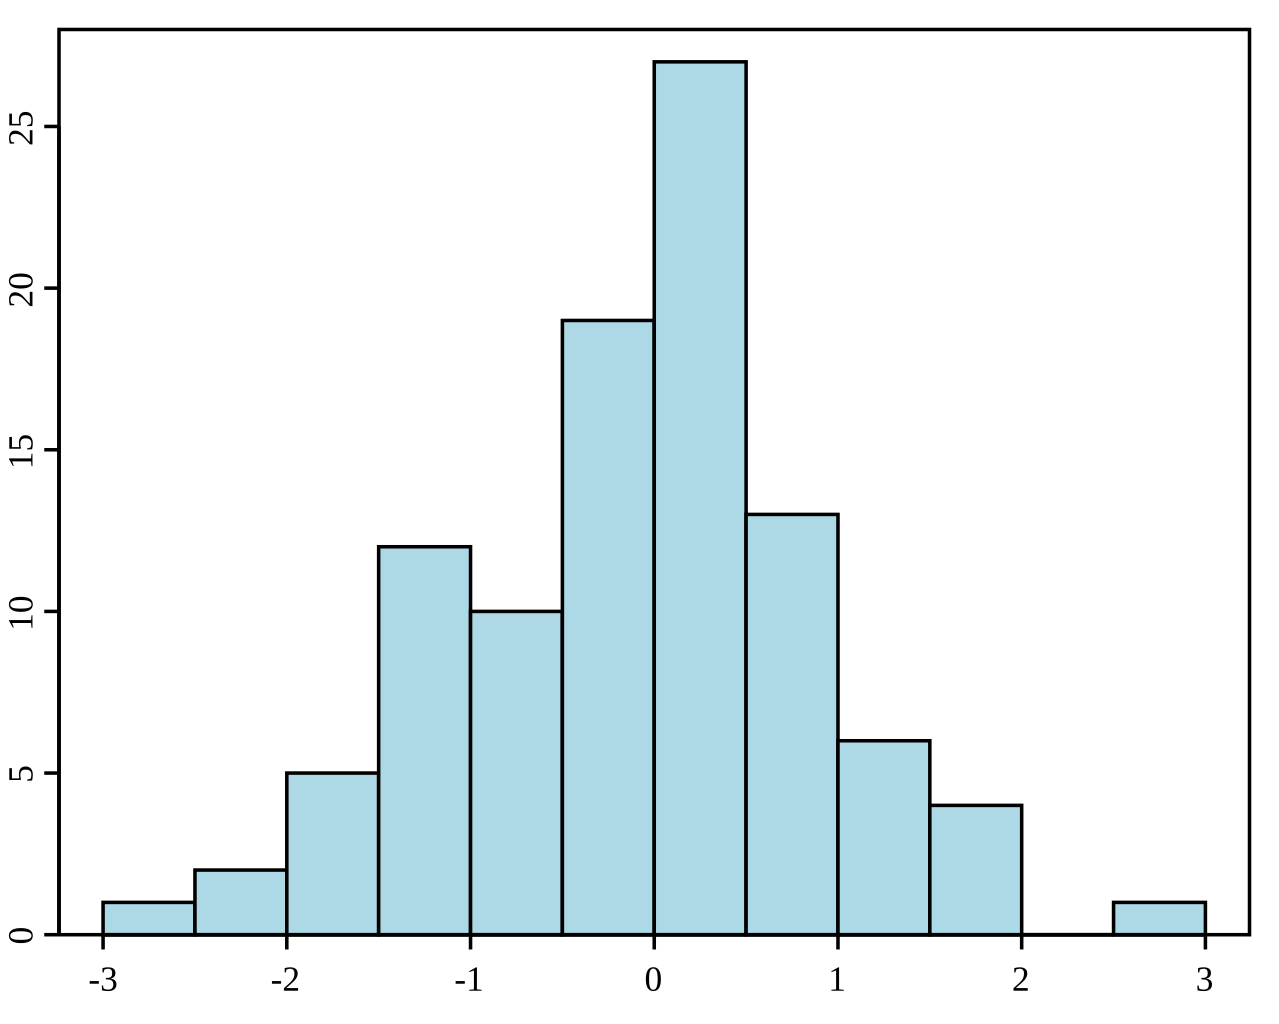
Ví dụ về histogram. Nguồn: Wikipedia.
Thống kê suy luận liên quan đến việc đưa ra dự đoán hay suy luận về một tổng thể dựa trên mẫu ngẫu nhiên lấy từ tổng thể đó. Nó dùng nhiều phương pháp để ước lượng tham số tổng thể, kiểm định giả thuyết và đưa ra dự báo. Trong khi thống kê mô tả tóm tắt và mô tả các đặc trưng của tập dữ liệu, thống kê suy luận dùng dữ liệu để khái quát hóa và rút ra kết luận về một tổng thể lớn hơn.
Các phương pháp lấy mẫu khác nhau được dùng để đảm bảo mẫu có tính đại diện và ngẫu nhiên. Lấy mẫu ngẫu nhiên đơn giản cho mọi thành viên trong tổng thể cơ hội được chọn bằng nhau. Lấy mẫu hệ thống chọn mỗi phần tử thứ k trong tổng thể, bắt đầu từ một điểm được chọn ngẫu nhiên. Lấy mẫu phân tầng chia tổng thể thành các tầng hay nhóm nhỏ, rồi lấy mẫu ngẫu nhiên từ mỗi tầng. Lấy mẫu cụm chia tổng thể thành các cụm, chọn ngẫu nhiên một số cụm và lấy mẫu tất cả thành viên trong các cụm đó.
Định lý giới hạn trung tâm phát biểu rằng phân phối lấy mẫu của trung bình mẫu sẽ tiệm cận phân phối chuẩn khi kích thước mẫu tăng, bất kể phân phối của tổng thể, miễn là các mẫu độc lập và cùng phân phối.
Xác suất biên là xác suất xảy ra của một sự kiện đơn lẻ, bất kể các sự kiện khác, ký hiệu P(A) với sự kiện A. Xác suất đồng thời là xác suất hai sự kiện xảy ra cùng lúc, ký hiệu P(A∩B) với các sự kiện A và B. Xác suất có điều kiện là xác suất một sự kiện xảy ra khi biết rằng một sự kiện khác đã xảy ra, ký hiệu P(A|B) với các sự kiện A và B.
Phân phối xác suất mô tả cách các giá trị của một biến ngẫu nhiên được phân bố. Nó cung cấp một hàm ánh xạ kết quả của biến ngẫu nhiên tới xác suất tương ứng. Có hai loại phân phối xác suất chính. Một là phân phối rời rạc cho biến ngẫu nhiên rời rạc, như phân phối nhị thức hay Poisson. Loại còn lại là phân phối liên tục cho biến ngẫu nhiên liên tục, như phân phối chuẩn hay mũ.
Phân phối chuẩn, còn gọi là phân phối Gauss, là phân phối xác suất liên tục có đường cong hình chuông, đối xứng quanh trung bình. Với phân phối chuẩn, trung bình bằng trung vị. Ngoài ra, khoảng 68% dữ liệu nằm trong một độ lệch chuẩn quanh trung bình, 95% trong hai độ lệch chuẩn, và 99,7% trong ba độ lệch chuẩn. Đây là Quy tắc 68-95-99,7.
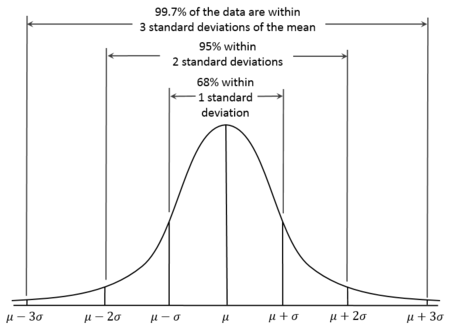
Đường cong phân phối chuẩn. Nguồn: Wikiversity.
Phân phối nhị thức là phân phối xác suất rời rạc mô hình hóa số lần thành công trong một số hữu hạn phép thử Bernoulli độc lập, mỗi phép thử có cùng xác suất thành công. Dùng khi mỗi phép thử chỉ có hai kết quả (thành công và thất bại). Ví dụ, có thể mô hình hóa số lần ra mặt ngửa trong một chuỗi tung đồng xu.
Phân phối Poisson là phân phối xác suất rời rạc mô hình hóa số sự kiện xảy ra trong một khoảng thời gian hay không gian cố định, với các sự kiện xảy ra độc lập và với tốc độ trung bình không đổi. Nó phù hợp khi bạn muốn mô hình hóa số lần xảy ra các sự kiện hiếm, như số email nhận được trong một giờ hay số trận động đất trong một năm.
Với các vai trò thống kê trung cấp, hãy tập trung vào kiểm định giả thuyết, ước lượng khoảng và mô hình hồi quy. Nếu khi đọc những câu hỏi này bạn thấy chưa tự tin với một số khái niệm, bạn có thể tham khảo tài nguyên của DataCamp. Bạn có thể học kiểm định giả thuyết qua các khóa Kiểm định Giả thuyết trong Python và Kiểm định Giả thuyết trong R. Bạn cũng có thể nắm vững kỹ thuật hồi quy với các khóa và hướng dẫn sau:
Giá trị p là xác suất thu được thống kê kiểm định ít nhất cực trị như quan sát, giả định giả thuyết không đúng. Nó được dùng trong kiểm định giả thuyết để xác định ý nghĩa của kết quả kiểm định. Nếu giá trị p nhỏ hơn hoặc bằng mức ý nghĩa (α) đã chọn, ta bác bỏ giả thuyết không. Nếu giá trị p lớn hơn α, ta không đủ cơ sở để bác bỏ giả thuyết không.
Lỗi loại I trong kiểm định giả thuyết xảy ra khi giả thuyết không là đúng nhưng ta lại bác bỏ sai, dẫn đến dương tính giả. Xác suất mắc lỗi loại I bằng mức ý nghĩa. Lỗi loại II xảy ra khi giả thuyết không là sai nhưng ta không bác bỏ, dẫn đến âm tính giả.
Kiểm định tham số giả định dữ liệu theo một phân phối cụ thể, như chuẩn, và yêu cầu một số tham số tổng thể, nên lý tưởng khi các giả định này được thỏa mãn. Một số ví dụ kiểm định tham số tôi thường dùng là t-test, Z-test và ANOVA. Kiểm định phi tham số không giả định phân phối cụ thể và dùng khi dữ liệu không đáp ứng giả định tham số, đặc biệt với mẫu nhỏ. Nhiều người quen với các kiểm định này nhưng không nhất thiết nhận ra chúng là phi tham số. Tôi đã dùng kiểm định Chi-Square, Mann-Whitney U, Wilcoxon Signed-Rank và Kruskal-Wallis, kể vài cái tiêu biểu.
Phân tích hồi quy là phương pháp thống kê dùng để xem xét mối quan hệ giữa một biến phụ thuộc và một hoặc nhiều biến độc lập. Nó giúp hiểu biến phụ thuộc thay đổi như thế nào khi một biến độc lập thay đổi, trong khi giữ các biến độc lập khác không đổi.
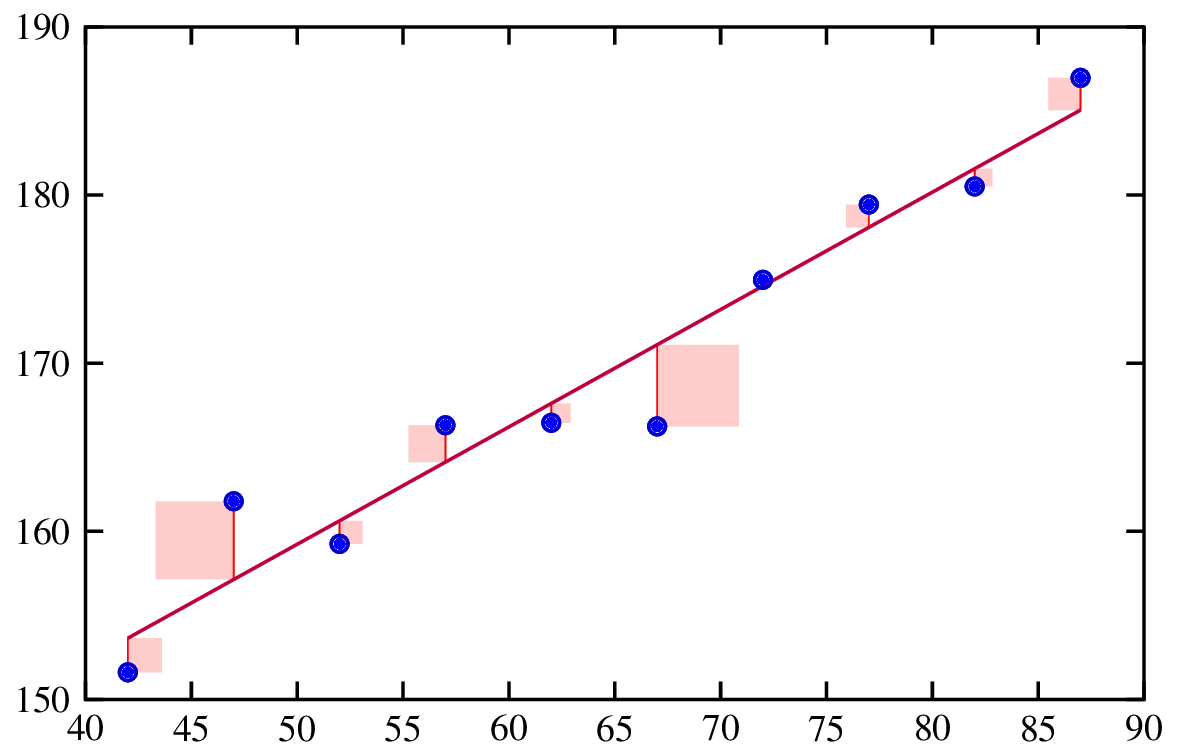
Khớp đường hồi quy. Nguồn: Risk Engineering.
Phần dư là chênh lệch giữa giá trị quan sát và giá trị dự đoán từ mô hình hồi quy. Phân tích phần dư quan trọng vì giúp kiểm tra các giả định của mô hình cũng như đánh giá độ khớp tổng thể của mô hình.
Trong mô hình hồi quy tuyến tính, mỗi hệ số biểu thị mức thay đổi kỳ vọng ở biến phụ thuộc khi biến độc lập tương ứng tăng một đơn vị, giữ các biến khác không đổi. Ví dụ, nếu hệ số của biến độc lập 𝑥𝑖 là 2, nghĩa là với mỗi lần 𝑥𝑖 tăng một đơn vị, biến phụ thuộc y dự kiến tăng 2 đơn vị, giả định các biến khác không đổi.
Khoảng tin cậy 95% nghĩa là nếu ta lấy nhiều mẫu và tính khoảng tin cậy cho mỗi mẫu, khoảng 95% số khoảng này sẽ chứa tham số tổng thể thật sự. Ta cũng có thể nói rằng chúng ta tin cậy 95% rằng giá trị tham số nằm trong khoảng ước tính.
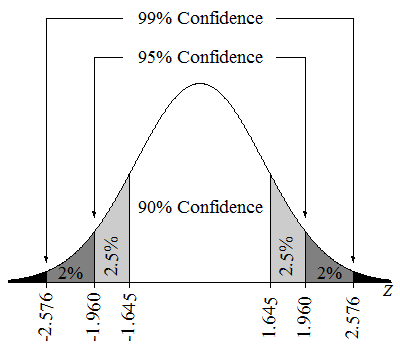
Các khoảng tin cậy trên phân phối Z. Nguồn: Lumen Learning.
Đa cộng tuyến xảy ra khi hai hay nhiều biến độc lập trong mô hình hồi quy bội có tương quan cao. Đây là vấn đề vì nó có thể khiến ước lượng hệ số không ổn định và khó diễn giải. Đa cộng tuyến cao cũng có thể làm phồng sai số chuẩn của các hệ số, dẫn đến kiểm định thống kê kém tin cậy.
Các kỹ thuật chuẩn hóa là công cụ mạnh để xử lý đa cộng tuyến trong mô hình hồi quy. Chúng cũng được dùng để ngăn quá khớp bằng cách thêm một hình phạt vào mô hình cho các hệ số lớn. Điều này giúp tạo ra mô hình khái quát hóa tốt hơn. Các kỹ thuật chuẩn hóa phổ biến gồm Hồi quy Lasso và Ridge.
Nếu tôi chuẩn bị cho một cuộc phỏng vấn đòi hỏi hiểu biết nâng cao về thống kê, tôi sẽ chắc chắn học về thống kê Bayes và máy học.
Với thống kê Bayes, hãy khám phá các khóa học: Phân tích Dữ liệu Bayes trong Python và Nền tảng Phân tích Dữ liệu Bayes trong R. Với máy học, hãy xem các lộ trình nghề nghiệp hoặc khóa học về máy học của DataCamp, bao gồm lộ trình Nhà khoa học Máy học với Python và khóa Hiểu về Máy học.
Thống kê Bayes sử dụng định lý Bayes để cập nhật xác suất của một giả thuyết khi có thêm bằng chứng hay thông tin mới. Nó kết hợp niềm tin tiên nghiệm với dữ liệu mới để tạo ra xác suất hậu nghiệm.
Markov Chain Monte Carlo là một lớp thuật toán dùng để lấy mẫu từ phân phối xác suất khi việc lấy mẫu trực tiếp là khó. Nó quan trọng trong thống kê Bayes vì cho phép ước lượng các phân phối hậu nghiệm, đặc biệt trong các mô hình phức tạp nơi lời giải giải tích không khả thi.
Đánh đổi độ chệch - phương sai trong máy học liên quan đến cân bằng hai nguồn sai số. Độ chệch là sai số do giả định mô hình quá đơn giản, gây thiếu khớp và bỏ lỡ các mẫu trong dữ liệu. Phương sai là sai số do quá nhạy với dao động của dữ liệu huấn luyện, gây quá khớp và học cả nhiễu thay vì mẫu thực.
Suy luận nhân quả là một ý tưởng quan trọng đang nhận nhiều chú ý. Suy luận nhân quả là quá trình xác định liệu và bằng cách nào một biến (nguyên nhân) tác động trực tiếp lên biến khác (kết quả), đây là đặc trưng phân biệt giữa suy luận nhân quả và chỉ tương quan. Suy luận nhân quả thực chất là một nhóm phương pháp nhằm thiết lập quan hệ nhân - quả để hiểu liệu một điều gì đó có hiệu quả không, như một can thiệp hay điều trị. Ví dụ, nếu nhà nghiên cứu cần hiểu một loại thuốc có hiệu quả không, suy luận nhân quả có thể giúp trả lời.
Mô hình Phương trình Cấu trúc là kỹ thuật phân tích mối quan hệ giữa các biến quan sát được và biến tiềm ẩn. Nó giống như kết hợp giữa hồi quy bội và phân tích nhân tố. SEM yêu cầu nhiều bước như đặc tả mô hình, ước lượng và đánh giá. SEM nổi tiếng linh hoạt nhưng đòi hỏi cỡ mẫu lớn và để sử dụng, bạn sẽ cần nền tảng lý thuyết vững chắc.
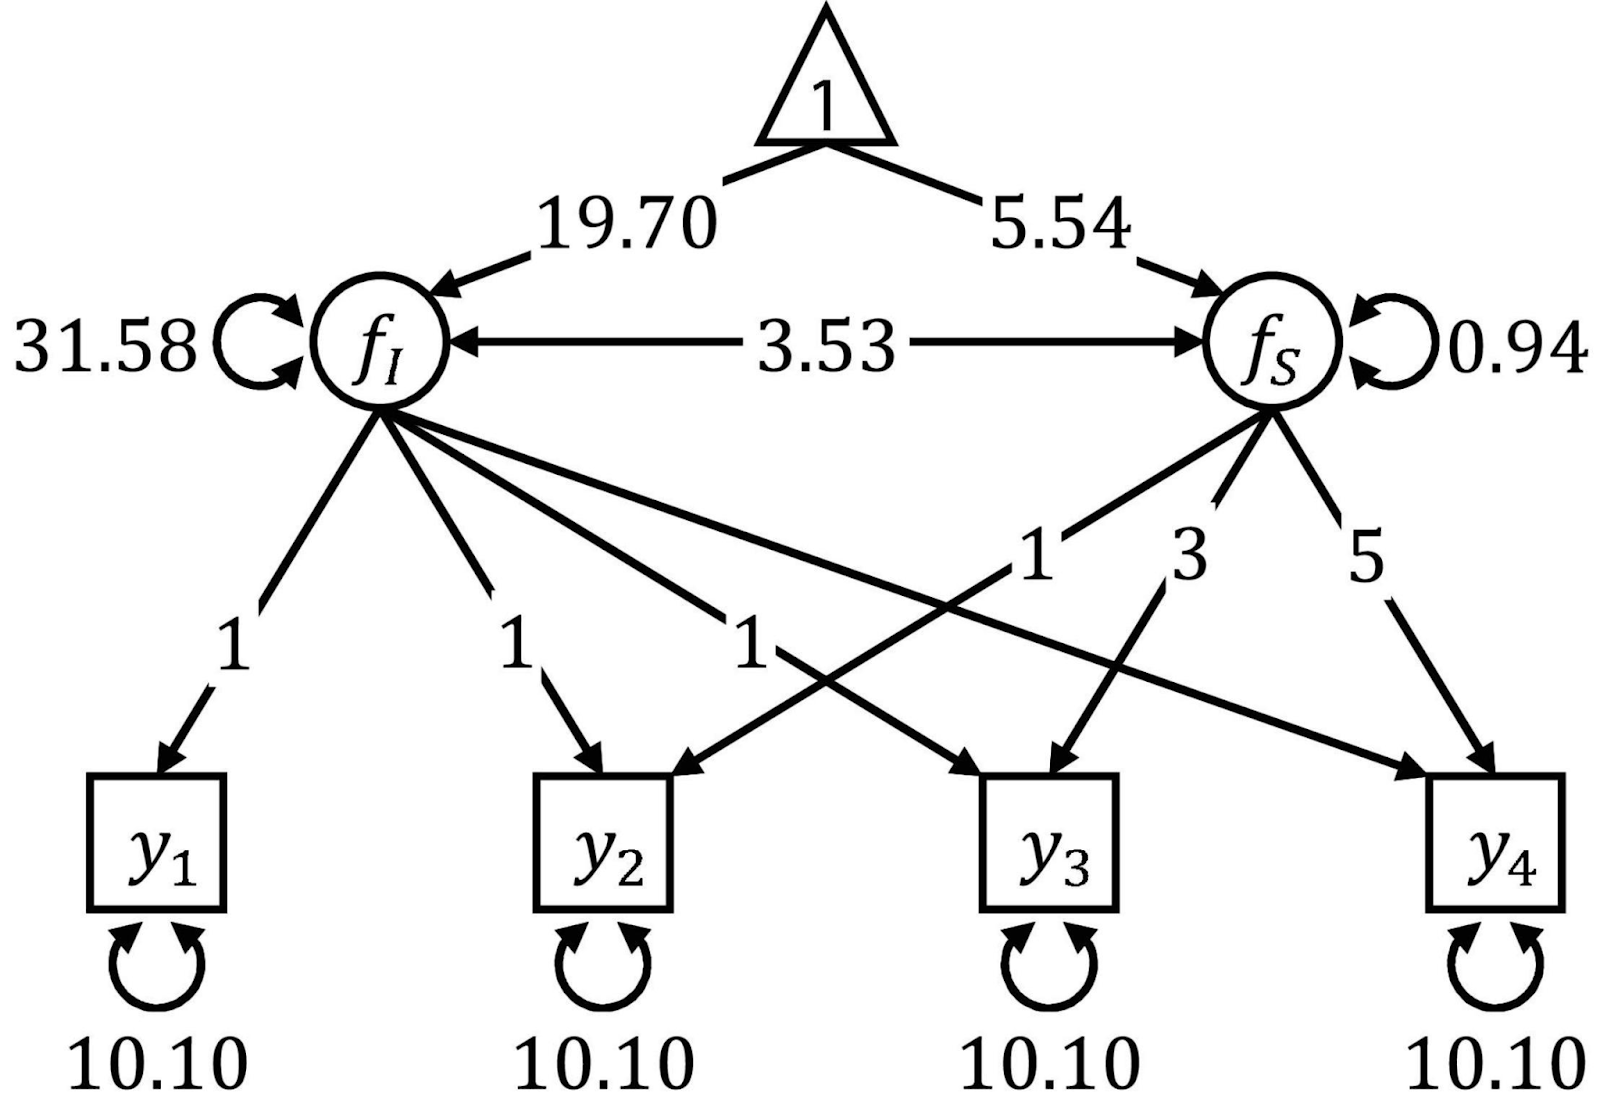
Sơ đồ đường dẫn thường dùng để trực quan hóa SEM. Nguồn: Frontiers.
Bạn sẽ thấy các câu hỏi sau hữu ích nếu bạn ứng tuyển vai trò tập trung vào giao điểm giữa khoa học dữ liệu và thống kê. Chủ đề gồm tiền xử lý và làm sạch dữ liệu, A/B testing và thiết kế thí nghiệm, dự báo chuỗi thời gian, và các kỹ thuật thống kê nâng cao.
Nếu bạn còn lung lay với các khái niệm này và thực sự nghiêm túc cải thiện quá trình phỏng vấn, hãy học các tài nguyên DataCamp về A/B testing: khóa A/B Testing trong Python hoặc A/B Testing trong R. Sau đó, để làm chủ phân tích chuỗi thời gian, chọn giữa lộ trình kỹ năng Chuỗi Thời gian với R hoặc Chuỗi Thời gian với Python để trải nghiệm thực hành.
Tách dữ liệu thành tập huấn luyện và kiểm tra giúp đánh giá hiệu suất mô hình trên dữ liệu chưa thấy. Tập huấn luyện dùng để huấn luyện mô hình, trong khi tập kiểm tra dùng để đánh giá mức độ mô hình khái quát hóa với dữ liệu mới. Thực hành này giúp phát hiện quá khớp và đảm bảo mô hình hoạt động tốt trên dữ liệu thực tế.
Quá khớp xảy ra khi mô hình học cả các mẫu cơ bản lẫn nhiễu trong dữ liệu huấn luyện, dẫn đến hiệu suất rất tốt trên dữ liệu huấn luyện nhưng kém trên dữ liệu mới. Thiếu khớp xảy ra khi mô hình quá đơn giản để nắm bắt các mẫu cơ bản trong dữ liệu, dẫn đến hiệu suất kém cả trên dữ liệu huấn luyện và dữ liệu mới.
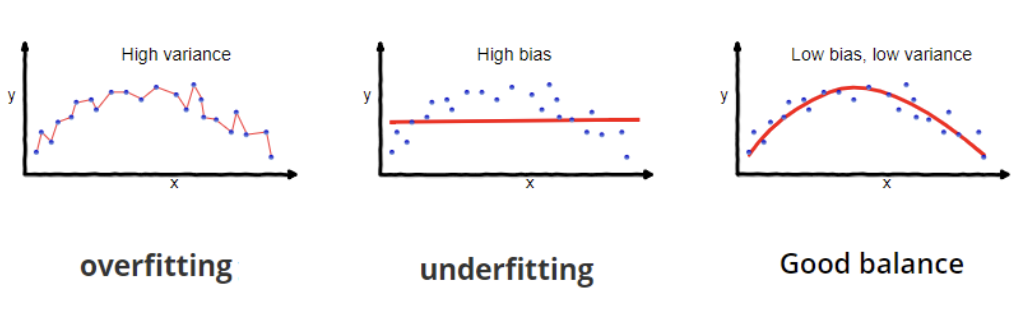
Quá khớp và thiếu khớp. Nguồn: Wikipedia.
Hiểu cơ chế thiếu dữ liệu (MCAR, MAR, MNAR) rất quan trọng vì nó định hướng lựa chọn phương pháp phù hợp để xử lý dữ liệu thiếu. Dùng kỹ thuật không phù hợp có thể gây thiên lệch, giảm độ giá trị của kết quả và dẫn đến kết luận sai. Ví dụ, phương pháp bù đơn giản có thể phù hợp với dữ liệu MCAR, trong khi các kỹ thuật tinh vi hơn như bù đa lần hoặc phương pháp dựa trên mô hình có thể cần thiết cho MAR hoặc MNAR để tạo ước lượng không thiên lệch.
Loại bỏ giá trị thiếu có thể phù hợp khi tỷ lệ dữ liệu thiếu rất nhỏ, thường dưới 5%. Ngoài ra, đó là ý tưởng hay khi dữ liệu thiếu là MCAR (Thiếu hoàn toàn ngẫu nhiên), nghĩa là việc thiếu không gây thiên lệch. Cuối cùng, tôi sẽ cân nhắc loại bỏ giá trị thiếu nếu tập dữ liệu đủ lớn để việc xóa một số hàng nhỏ không ảnh hưởng đáng kể tới phân tích.
Mỗi phương pháp bù đều có ưu và nhược điểm. Ví dụ, bù bằng trung bình/trung vị/mốt dễ triển khai nhưng có thể gây thiên lệch và làm sai lệch mối quan hệ giữa các biến. Bù bằng K láng giềng gần nhất (KNN) xét đến mối quan hệ giữa các biến và có thể cho kết quả chính xác hơn, nhưng chi phí tính toán cao.
A/B testing là phương pháp dùng trong thiết kế thí nghiệm để so sánh hai phiên bản của một biến, như trang web, tính năng ứng dụng, hoặc chiến dịch tiếp thị, nhằm xác định phiên bản nào hiệu quả hơn. Đây là chủ đề rất liên quan và thường xuất hiện ở mục “yêu cầu” trong nhiều mô tả công việc.
Tính mùa vụ là một thành phần của chuỗi thời gian, bên cạnh xu hướng và phần dư (nhiễu). Để phát hiện mùa vụ, trước tiên ta có thể quan sát trực quan chuỗi qua biểu đồ đường. Nếu nghi ngờ có mùa vụ, ta có thể tiến hành phân rã chuỗi thời gian để tìm độ lớn của tác động mùa vụ.
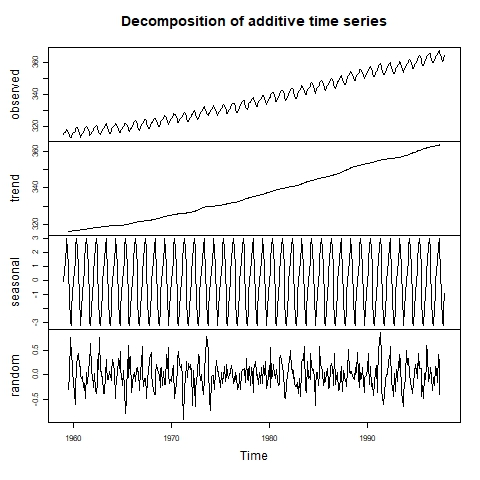
Chuỗi thời gian được phân rã trực quan. Nguồn: Lab of Environmental Informatics.
Các mô hình Làm trơn Mũ dùng trung bình có trọng số của các quan sát quá khứ cho dự báo đơn giản, ngắn hạn. Mô hình ARIMA kết hợp tự hồi quy, sai phân và thành phần trung bình trượt, phức tạp hơn nhưng phù hợp cho cả dự báo ngắn và dài hạn, đặc biệt khi có mẫu phức tạp và tự tương quan đáng kể.
Cross-validation là kỹ thuật đánh giá mức độ mô hình học máy sẽ khái quát hóa với tập dữ liệu độc lập. Nó bao gồm chia dữ liệu thành nhiều phần (fold) và thực hiện nhiều vòng huấn luyện và xác thực.
Vì hoàn thiện thống kê và kết quả phân tích sẽ chưa trọn vẹn nếu không truyền đạt kết quả cho các bên liên quan trong doanh nghiệp, nên kỹ năng mềm là điều tối quan trọng với nhà tuyển dụng cho các vai trò dữ liệu, nhất là khi việc truyền tải insight từ thống kê không hề dễ.
Để giao tiếp hiệu quả với các bên liên quan khác nhau, tôi điều chỉnh phong cách dựa trên nền tảng và mối quan tâm của họ. Ví dụ, với lãnh đạo cấp cao, tôi ưu tiên tác động kinh doanh, dùng ngôn ngữ kinh doanh và trực quan hóa để hỗ trợ ra quyết định nhanh. Ngược lại, với nhà phát triển, tôi cung cấp chi tiết kỹ thuật. Ở cả hai trường hợp, tôi đảm bảo các khái niệm liên quan được trình bày rõ ràng, dễ tiếp cận và tôi khuyến khích đặt câu hỏi, phản hồi. Cách tiếp cận này đảm bảo mỗi nhóm nhận được thông tin họ cần theo định dạng phù hợp với họ.
Học thống kê cho các vai trò phân tích dữ liệu có thể là thách thức. Nhiều người bước vào lĩnh vực này từ các nền tảng khác nhau không nhất thiết liên quan nhiều hoặc có kiến thức thống kê. Phần lớn tài nguyên trực tuyến khuyến khích người học chỉ tập trung vào công cụ, bỏ qua tầm quan trọng cốt yếu của thống kê.
Để nâng cao hơn nữa kiến thức và cơ hội nghề nghiệp, hãy khám phá thêm tài nguyên và khóa học. Để có hướng dẫn chi tiết về cách trở thành nhà thống kê, xem bài viết blog Cách Trở thành Nhà Thống kê của chúng tôi, cung cấp nhiều góc nhìn giá trị. Bạn có thể bổ sung bằng lộ trình nghề nghiệp Nhà Thống kê với R. Hãy dành thời gian kiểm tra trực giác của bạn với khóa Câu đố Xác suất trong R. Nếu bạn ưa thích Python, lộ trình kỹ năng Nền tảng Thống kê với Python là lựa chọn tuyệt vời.
Chúc bạn may mắn trong các buổi phỏng vấn sắp tới!
Học Thống kê với DataCamp
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
