

Kursus
Pengantar Statistika
4 jam
163.9K
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleMenguasai alat analitik data tanpa memahami konsep di baliknya seperti memiliki kotak peralatan obeng tetapi tidak tahu kapan dan bagaimana menggunakan setiap obeng. Statistika penting dipelajari karena meningkatnya alat analisis yang dihasilkan dan dibantu AI akan membuat keterampilan teknis menjadi kurang unggul dibandingkan pemahaman pengetahuan dan pemikiran kritis.
Saya mengajak Anda untuk tidak gentar oleh kompleksitas statistika. Artikel ini bertujuan menyajikan panduan komprehensif atas konsep-konsep statistika paling relevan bagi analis data dan ilmuwan data melalui 35 pertanyaan dan jawaban wawancara statistika. Baik Anda sedang bersiap untuk wawancara atau tidak, saya yakin Anda akan menemukan pertanyaan-pertanyaan ini informatif.
Akhirnya, sebelum kita mulai, pertimbangkan untuk mengikuti kursus Introduction to Statistics in R kami untuk mempelajari dasar-dasar, termasuk cara melakukan analisis statistika dan menafsirkan hasil. Juga, jika Anda sedang aktif mempersiapkan wawancara yang memerlukan pemahaman statistika, dua kursus DataCamp berikut mencakup semua topik statistika yang paling sering dibahas: Practicing Statistics Interview Questions in Python dan Practicing Statistics Interview Questions in R.
Sebagian besar, jika bukan semua, pekerjaan analitik data memerlukan pemahaman dasar statistika, termasuk statistika deskriptif, statistika inferensial, dan probabilitas. Jika Anda sedang menyegarkan kembali statistika deskriptif sebelum wawancara, unduh Descriptive Statistics Cheat Sheet kami untuk referensi cepat. Selain itu, jika Anda ingin mengerjakan beberapa perhitungan dan metode, lihat tutorial DataCamp berikut untuk menelaah konsep yang relevan secara lebih rinci:
Varians dan simpangan baku sama-sama mengukur penyebaran atau sebaran suatu dataset. Varians adalah rata-rata dari kuadrat selisih terhadap mean. Ini memberi gambaran seberapa besar nilai-nilai dalam dataset berbeda dari mean. Namun, karena menggunakan selisih yang dikuadratkan, satuannya juga menjadi kuadrat, yang bisa kurang intuitif dibanding simpangan baku. Simpangan baku adalah akar kuadrat dari varians, sehingga satuannya kembali sama dengan data asli. Ini memberikan ukuran sebaran yang lebih mudah ditafsirkan. Misalnya, jika varians suatu dataset adalah 25, maka simpangan bakunya adalah √25 = 5.
Skewness mengukur keasimetrian suatu dataset terhadap mean-nya, yang bisa positif, negatif, atau nol. Data dengan skewness positif, atau miring ke kanan, memiliki ekor kanan yang lebih panjang, artinya mean lebih besar daripada median. Data dengan skewness negatif, atau miring ke kiri, memiliki ekor kiri yang lebih panjang, artinya mean lebih kecil daripada median. Skewness nol menunjukkan distribusi simetris, seperti distribusi normal, di mana mean, median, dan modus sama.
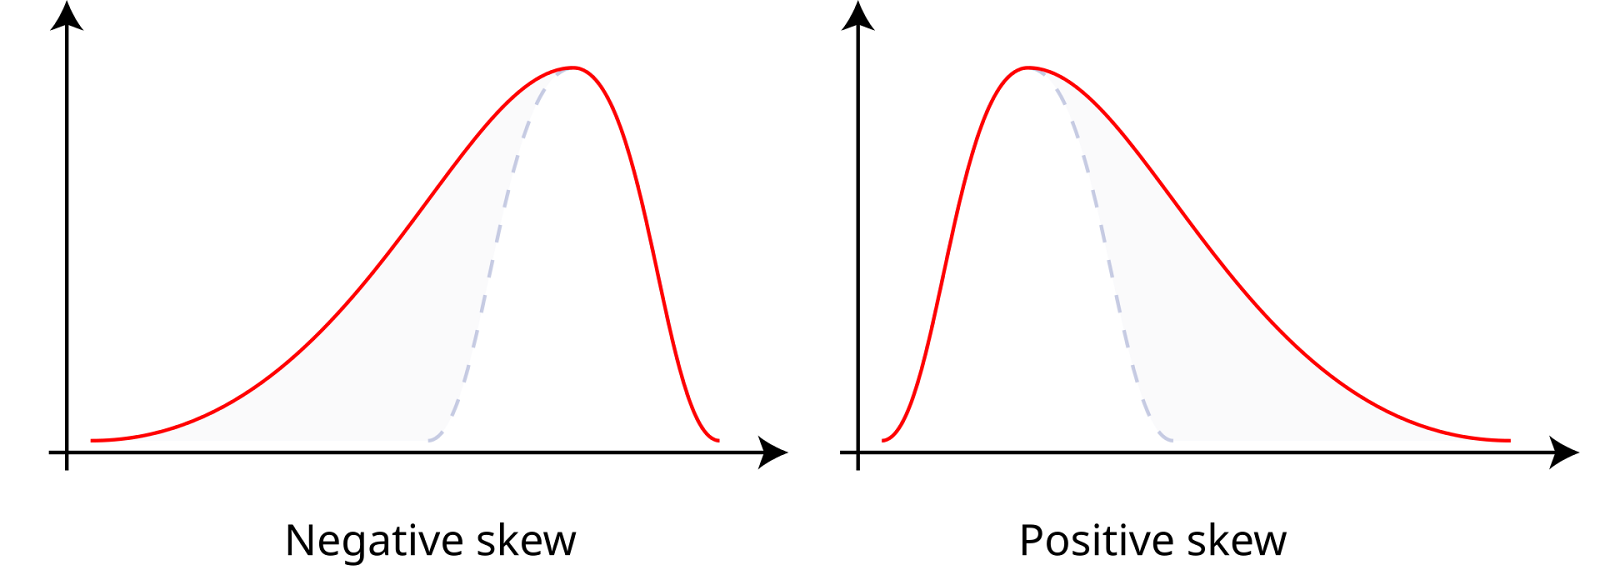
Skewness positif dan negatif. Sumber: Wikiversity.
Histogram adalah representasi grafis dari distribusi suatu dataset. Ini membagi data ke dalam bin (interval) dan menampilkan frekuensi (atau jumlah) titik data dalam setiap bin. Histogram digunakan untuk memahami distribusi frekuensi yang mendasari (bentuk) dari sekumpulan data kontinu. Histogram membantu mengidentifikasi pola seperti skewness, modalitas (jumlah puncak), dan keberadaan pencilan.
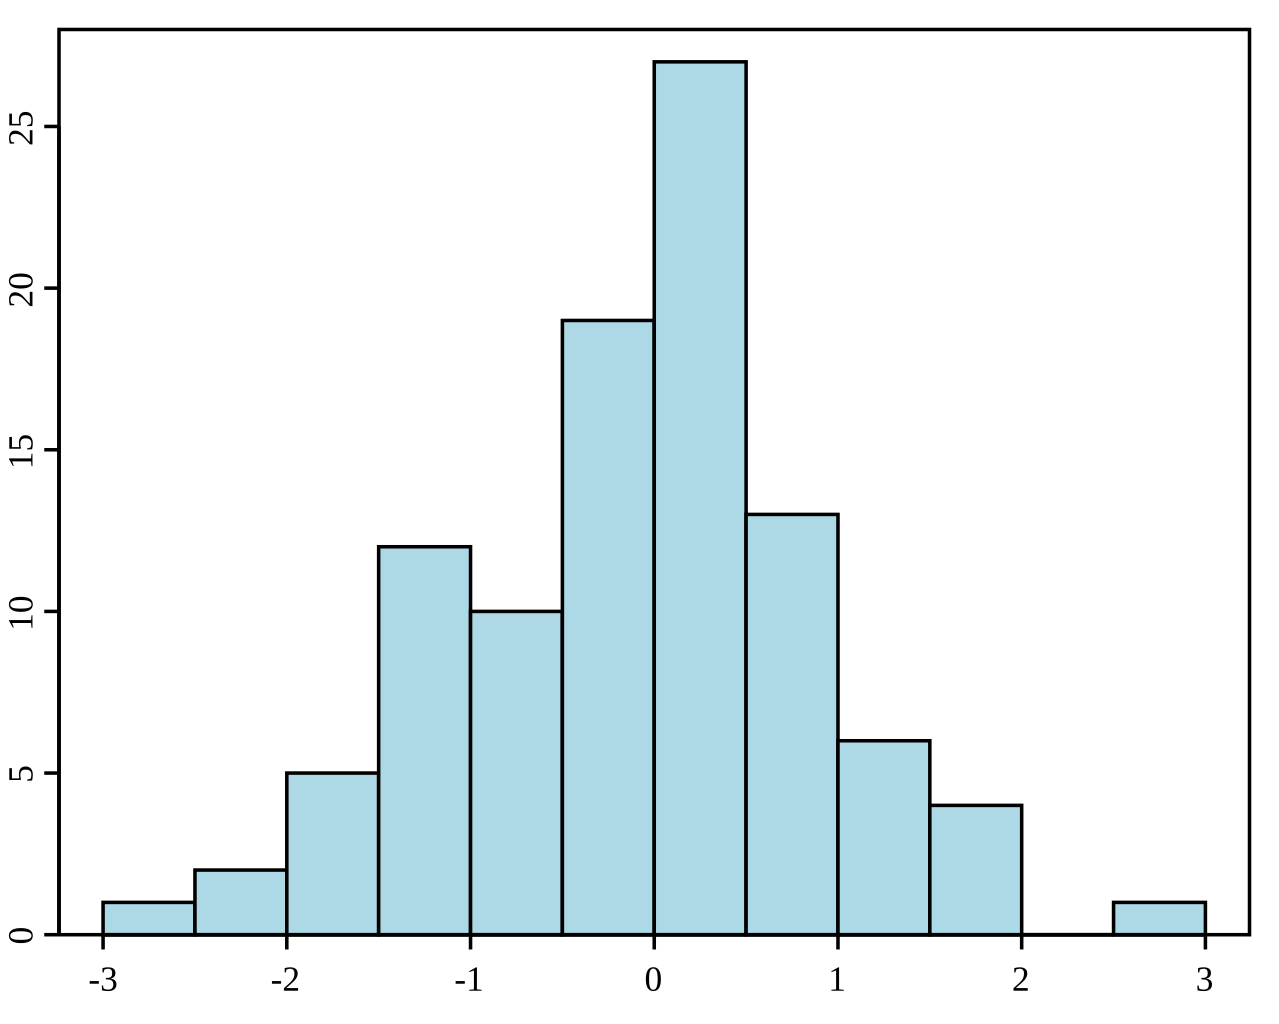
Contoh histogram. Sumber: Wikipedia.
Statistika inferensial melibatkan pembuatan prediksi atau inferensi tentang suatu populasi berdasarkan sampel acak data yang diambil dari populasi tersebut. Ini menggunakan berbagai metode untuk mengestimasi parameter populasi, menguji hipotesis, dan membuat prediksi. Sementara statistika deskriptif merangkum dan mendeskripsikan karakteristik suatu dataset, statistika inferensial menggunakan data untuk membuat generalisasi dan menarik kesimpulan tentang populasi yang lebih besar.
Berbagai metode pengambilan sampel digunakan untuk memastikan sampel bersifat representatif dan acak. Simple random sampling memberi setiap anggota populasi peluang yang sama untuk terpilih. Systematic sampling melibatkan pemilihan setiap anggota ke-k dari populasi, dimulai dari titik yang dipilih secara acak. Stratified sampling membagi populasi menjadi strata atau subkelompok, dengan sampel acak diambil dari setiap strata. Cluster sampling membagi populasi menjadi klaster, memilih beberapa klaster secara acak dan mensampel semua anggota di dalamnya.
Teorema limit pusat menyatakan bahwa distribusi penarikan sampel dari rata-rata sampel akan mendekati distribusi normal seiring bertambahnya ukuran sampel, terlepas dari distribusi populasi, asalkan sampel-sampelnya independen dan terdistribusi identik.
Probabilitas marginal mengacu pada probabilitas terjadinya satu kejadian, tanpa memedulikan kejadian lain, dilambangkan sebagai P(A) untuk kejadian A. Probabilitas gabungan adalah probabilitas dua kejadian terjadi bersama, dilambangkan sebagai P(A∩B) untuk kejadian A dan B. Probabilitas bersyarat adalah probabilitas suatu kejadian terjadi dengan syarat kejadian lain telah terjadi, dinyatakan sebagai P(A|B) untuk kejadian A dan B.
Distribusi probabilitas menjelaskan bagaimana nilai-nilai suatu peubah acak terdistribusi. Ini menyediakan fungsi yang memetakan keluaran peubah acak ke probabilitas yang bersesuaian. Ada dua tipe utama distribusi probabilitas. Pertama adalah distribusi probabilitas diskret untuk peubah acak diskret, seperti distribusi binomial atau Poisson. Kedua adalah distribusi probabilitas kontinu untuk peubah acak kontinu, seperti distribusi normal atau eksponensial.
Distribusi normal, juga dikenal sebagai distribusi Gaussian, adalah distribusi probabilitas kontinu yang dicirikan oleh kurva berbentuk lonceng, yang simetris terhadap mean. Pada distribusi normal, mean sama dengan median. Juga diketahui bahwa sekitar 68% data berada dalam satu simpangan baku dari mean, 95% dalam dua simpangan baku, dan 99,7% dalam tiga simpangan baku. Ini dikenal sebagai Aturan 68-95-99,7.
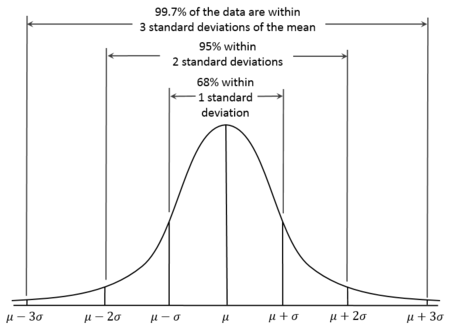
Kurva distribusi normal. Sumber: Wikiversity.
Distribusi binomial adalah distribusi probabilitas diskret yang memodelkan jumlah keberhasilan dalam sejumlah percobaan Bernoulli yang tetap, masing-masing dengan probabilitas keberhasilan yang sama. Ini digunakan ketika ada tepat dua kemungkinan hasil (berhasil dan gagal) untuk setiap percobaan. Misalnya, dapat digunakan untuk memodelkan jumlah sisi kepala dalam serangkaian lemparan koin.
Distribusi Poisson adalah distribusi probabilitas diskret yang memodelkan jumlah kejadian yang terjadi dalam interval waktu atau ruang yang tetap, di mana kejadian terjadi secara independen dan pada laju rata-rata yang konstan. Ini cocok digunakan ketika Anda ingin memodelkan jumlah kejadian langka, seperti jumlah email yang diterima dalam satu jam atau jumlah gempa bumi dalam setahun.
Untuk peran statistika tingkat menengah, fokuslah pada pengujian hipotesis, estimasi interval, dan pemodelan regresi. Jika saat membaca pertanyaan-pertanyaan ini Anda merasa kurang percaya diri dengan beberapa konsep, Anda dapat merujuk ke sumber daya DataCamp. Anda dapat mempelajari pengujian hipotesis melalui kursus Hypothesis Testing in Python dan Hypothesis Testing in R. Anda juga dapat menguasai teknik regresi dengan kursus dan tutorial berikut:
P-value adalah probabilitas untuk memperoleh statistik uji setidaknya setinggi yang diamati, dengan asumsi hipotesis nol benar. Ini digunakan dalam pengujian hipotesis untuk menentukan signifikansi hasil uji. Jika p-value kurang dari atau sama dengan tingkat signifikansi yang dipilih (α), kita menolak hipotesis nol. Jika p-value lebih besar dari α, kita gagal menolak hipotesis nol.
Galat Tipe I dalam pengujian hipotesis terjadi ketika hipotesis nol benar, tetapi kita keliru menolaknya, menghasilkan positif palsu. Probabilitas terjadinya galat Tipe I sama dengan tingkat signifikansi. Galat Tipe II terjadi ketika hipotesis nol salah, tetapi kita gagal menolaknya, yang mengarah pada negatif palsu.
Uji parametrik mengasumsikan data mengikuti distribusi tertentu, seperti normal, dan memerlukan parameter populasi tertentu, sehingga ideal ketika asumsi ini terpenuhi. Beberapa contoh uji parametrik yang sering saya gunakan adalah uji t, uji Z, dan ANOVA. Uji nonparametrik tidak mengasumsikan distribusi spesifik dan digunakan ketika data tidak memenuhi asumsi parametrik, terutama dengan sampel kecil. Banyak orang akrab dengan uji ini, tetapi tidak selalu mengidentifikasikannya sebagai nonparametrik. Saya telah menggunakan uji Chi-Square, uji Mann-Whitney U, Uji Wilcoxon Signed-Rank, dan uji Kruskal-Wallis, di antaranya.
Analisis regresi adalah metode statistika yang digunakan untuk menelaah hubungan antara satu peubah terikat dan satu atau lebih peubah bebas. Ini membantu memahami bagaimana peubah terikat berubah ketika salah satu peubah bebas divariasikan, sementara peubah bebas lainnya ditahan konstan.
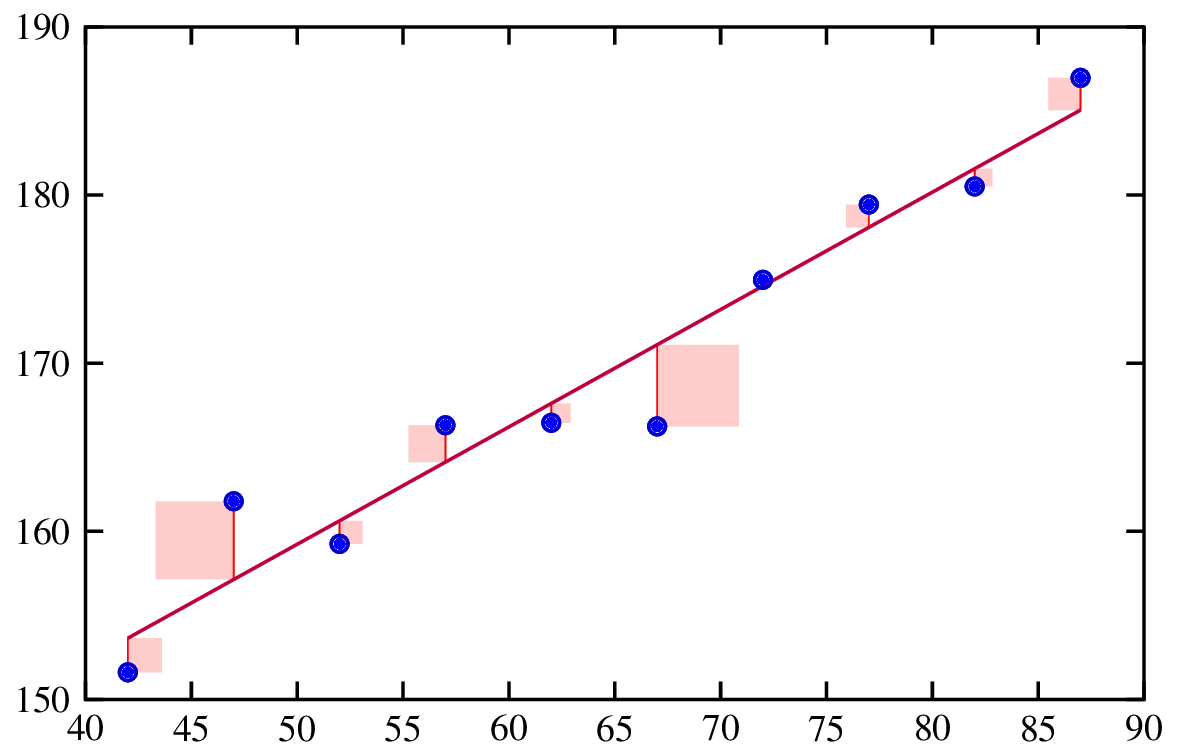
Pemasangan garis regresi. Sumber: Risk Engineering.
Residual adalah selisih antara nilai yang diamati dan nilai yang diprediksi dari model regresi. Residual penting karena analisis residual membantu memeriksa asumsi-asumsi model kita, serta memeriksa kecocokan keseluruhan model.
Dalam model regresi linear, setiap koefisien merepresentasikan perubahan yang diharapkan pada peubah terikat untuk perubahan satu unit pada peubah bebas yang bersangkutan, dengan mengendalikan peubah lain tetap konstan. Misalnya, jika koefisien dari peubah bebas 𝑥𝑖 adalah 2, artinya untuk setiap kenaikan satu unit pada 𝑥𝑖, peubah terikat y diperkirakan meningkat sebesar 2 unit, dengan asumsi peubah lain tidak berubah.
Interval kepercayaan 95% berarti jika kita mengambil banyak sampel dan menghitung interval kepercayaan untuk setiap sampel, sekitar 95% dari interval tersebut akan memuat parameter populasi yang sebenarnya. Kita juga dapat mengatakan bahwa kita 95% yakin bahwa nilai parameter berada dalam interval yang diestimasi.
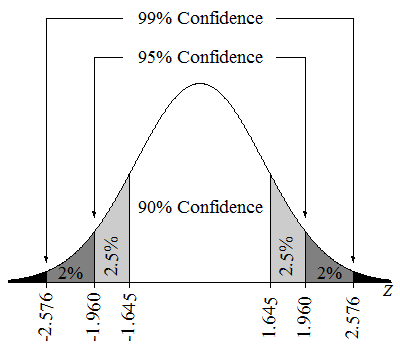
Interval kepercayaan pada distribusi Z. Sumber: Lumen Learning.
Multikolinearitas terjadi ketika dua atau lebih peubah bebas dalam model regresi berganda berkorelasi tinggi. Ini menjadi masalah karena dapat membuat estimasi koefisien tidak stabil dan sulit ditafsirkan. Multikolinearitas tinggi juga dapat memperbesar simpangan baku koefisien, yang mengarah pada uji statistik yang kurang andal.
Teknik regularisasi adalah teknik yang kuat untuk menangani multikolinearitas dalam model regresi. Teknik ini juga digunakan untuk mencegah overfitting dengan menambahkan penalti pada model karena memiliki koefisien besar. Ini membantu menciptakan model yang lebih dapat digeneralisasi. Teknik regularisasi umum termasuk Lasso dan Ridge Regression.
Jika saya sedang mempersiapkan wawancara yang memerlukan pemahaman statistika tingkat lanjut, saya akan memastikan mempelajari statistika Bayesian dan machine learning.
Untuk statistika Bayesian, jelajahi kursus kami: Bayesian Data Analysis in Python dan Fundamentals of Bayesian Data Analysis in R. Untuk machine learning, lihat jalur karier atau kursus machine learning di DataCamp, termasuk jalur karier Machine Learning Scientist with Python dan kursus Understanding Machine Learning kami.
Statistika Bayesian melibatkan penggunaan teorema Bayes untuk memperbarui probabilitas suatu hipotesis seiring tersedianya lebih banyak bukti atau informasi. Ini menggabungkan keyakinan awal dengan data baru untuk membentuk probabilitas posterior.
Markov Chain Monte Carlo adalah kelas algoritma yang digunakan untuk melakukan sampling dari suatu distribusi probabilitas ketika sampling langsung sulit dilakukan. Ini penting dalam statistika Bayesian karena memungkinkan estimasi distribusi posterior, terutama dalam model kompleks di mana solusi analitik tidak memungkinkan.
Trade-off bias-varian dalam machine learning melibatkan penyeimbangan dua sumber galat. Bias adalah galat dari asumsi model yang terlalu sederhana, menyebabkan underfitting dan melewatkan pola data. Varian adalah galat dari sensitivitas yang berlebihan terhadap fluktuasi data pelatihan, menyebabkan overfitting dan menangkap noise alih-alih pola yang sebenarnya.
Inferensi kausal adalah gagasan penting yang mendapat banyak perhatian. Inferensi kausal adalah proses menentukan apakah dan bagaimana satu peubah (sebab) secara langsung memengaruhi peubah lain (akibat), yang menjadi pembeda antara inferensi kausal dan sekadar korelasi. Inferensi kausal pada dasarnya adalah sekelompok metode yang bertujuan menetapkan hubungan sebab-akibat untuk memahami apakah sesuatu bekerja, seperti intervensi atau perlakuan tertentu. Jika peneliti perlu memahami apakah suatu obat bekerja, misalnya, inferensi kausal dapat membantu menjawab pertanyaan tersebut.
Structural Equation Modeling adalah teknik untuk menganalisis hubungan di antara apa yang disebut peubah teramati dan peubah laten. Ini semacam perpaduan antara regresi berganda dan analisis faktor. Pemodelan persamaan struktural memerlukan beberapa langkah, seperti spesifikasi model, estimasi, lalu evaluasi. SEM dikenal fleksibel tetapi memerlukan ukuran sampel besar dan, untuk menggunakannya, Anda akan memerlukan landasan teoretis yang kuat.
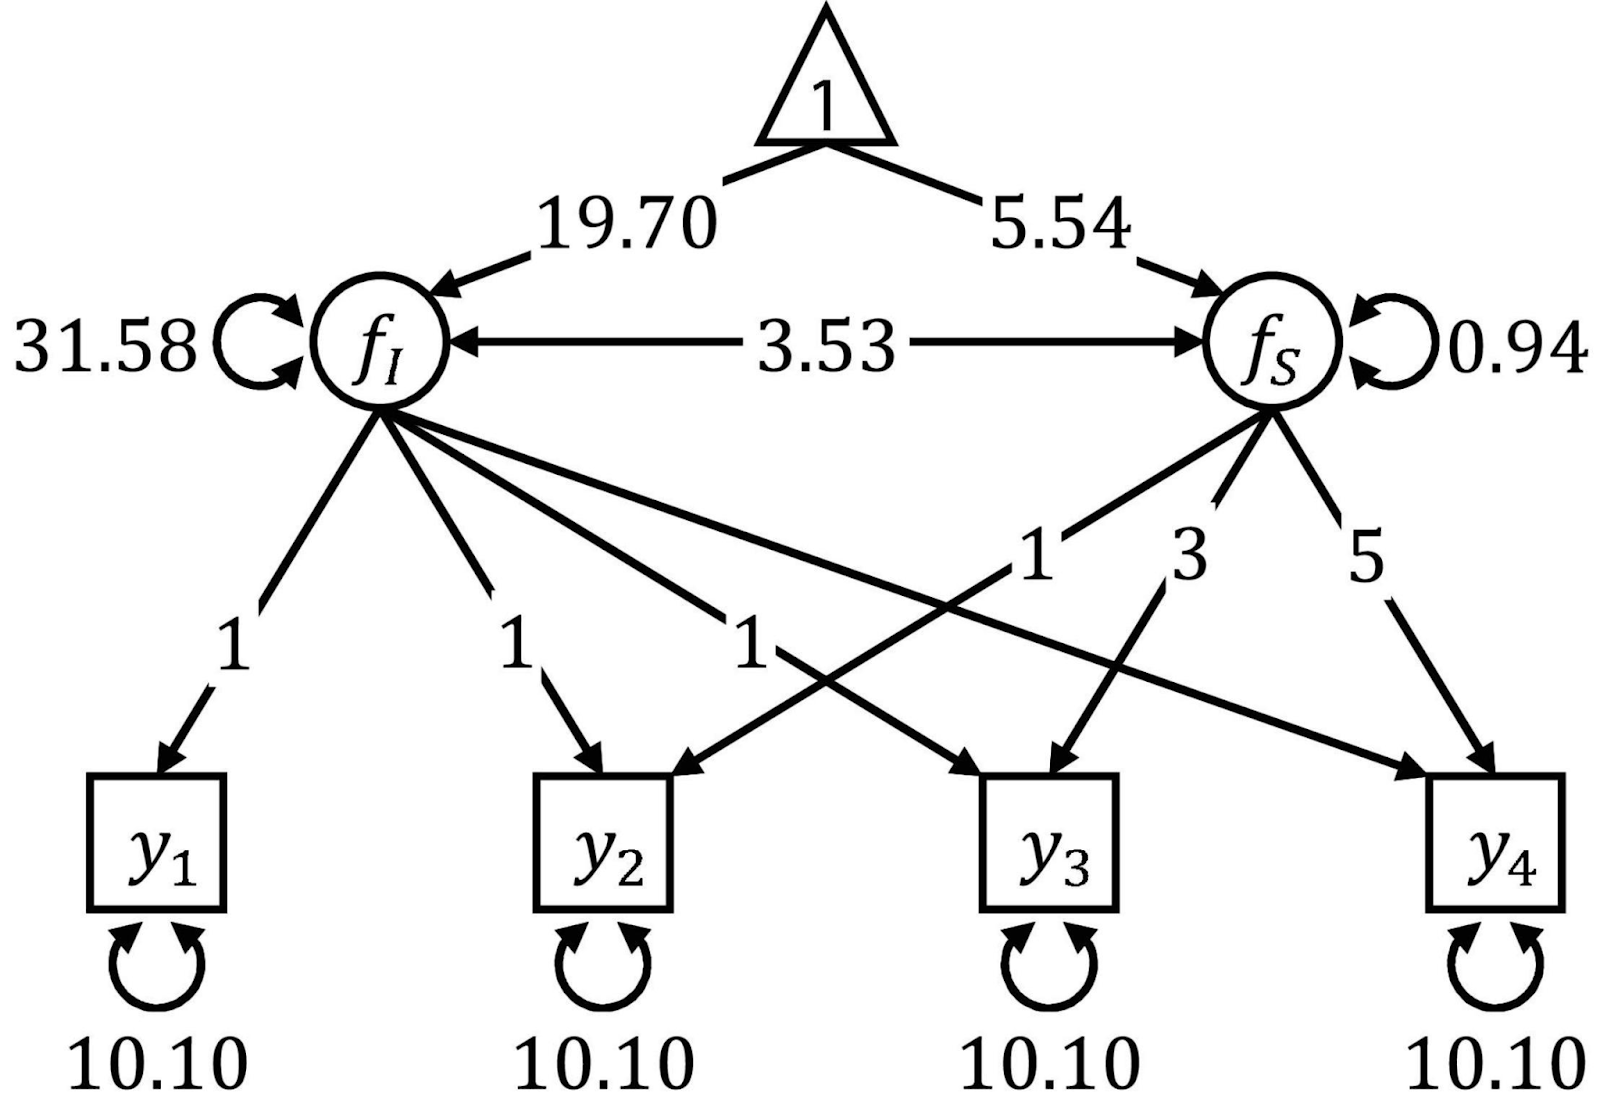
Path diagram sering digunakan untuk memvisualisasikan SEM. Sumber: Frontiers.
Anda akan menemukan pertanyaan-pertanyaan berikut bermanfaat jika Anda melamar peran yang lebih berfokus pada persinggungan data science dan statistika. Topik di sini mencakup prapemrosesan dan pembersihan data, A/B testing dan desain eksperimen, peramalan deret waktu, dan teknik statistika lanjutan.
Jika Anda merasa goyah pada konsep-konsep ini dan Anda serius ingin meningkatkan proses wawancara, ambil sumber daya DataCamp tentang A/B testing: kursus A/B Testing in Python atau kursus A/B Testing in R. Lalu, untuk menguasai analisis deret waktu, pilih antara jalur keterampilan Time Series with R atau Time Series with Python untuk mendapatkan pengalaman.
Membagi data menjadi set pelatihan dan pengujian membantu kita mengevaluasi kinerja model pada data yang belum terlihat. Set pelatihan digunakan untuk melatih model, sementara set pengujian digunakan untuk menilai seberapa baik model melakukan generalisasi ke data baru. Praktik ini membantu mendeteksi overfitting dan memastikan model dapat berkinerja baik pada data dunia nyata.
Overfitting terjadi ketika model mempelajari baik pola yang mendasari maupun noise dalam data pelatihan, sehingga kinerjanya sangat baik pada data pelatihan tetapi buruk pada data baru yang belum terlihat. Underfitting terjadi ketika model terlalu sederhana untuk menangkap pola yang mendasari dalam data, menghasilkan kinerja buruk baik pada data pelatihan maupun data baru.
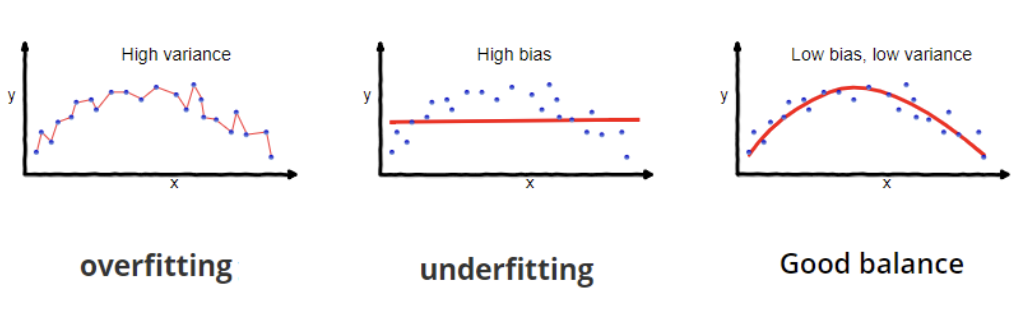
Overfitting dan underfitting. Sumber: Wikipedia.
Memahami mekanisme missingness (MCAR, MAR, MNAR) sangat penting karena hal ini memandu pemilihan metode yang tepat untuk menangani data hilang. Menggunakan teknik yang tidak tepat dapat menimbulkan bias, mengurangi validitas hasil, dan menyebabkan kesimpulan yang salah. Misalnya, metode imputasi sederhana mungkin cocok untuk data MCAR, sementara teknik yang lebih canggih seperti multiple imputation atau metode berbasis model mungkin diperlukan untuk data MAR atau MNAR guna menghasilkan estimasi yang tidak bias.
Menghapus nilai yang hilang dapat tepat dilakukan ketika proporsi data hilang sangat kecil, biasanya kurang dari 5%. Juga, ini merupakan ide yang baik ketika data hilang bersifat MCAR (Missing Completely at Random), artinya missingness tidak menimbulkan bias. Terakhir, saya akan mempertimbangkan untuk menghapus nilai yang hilang jika dataset cukup besar sehingga penghapusan sejumlah kecil baris tidak berdampak signifikan pada analisis.
Setiap metode imputasi memiliki kelebihan dan kekurangan. Misalnya, imputasi mean/median/modus mudah diterapkan tetapi dapat menimbulkan bias dan mendistorsi hubungan antar peubah. Imputasi K-nearest neighbors (KNN) mempertimbangkan hubungan antar peubah dan dapat menghasilkan hasil yang lebih akurat, tetapi dapat mahal secara komputasi.
A/B testing adalah metode yang digunakan dalam desain eksperimen untuk membandingkan dua versi suatu variabel, seperti laman web, fitur aplikasi, atau kampanye pemasaran, guna menentukan mana yang berkinerja lebih baik. Ini adalah topik yang sangat relevan dan muncul di bagian ‘wajib’ pada banyak deskripsi pekerjaan.
Musiman adalah salah satu komponen deret waktu, selain tren dan residual (noise). Untuk mendeteksi musiman, kita pertama-tama dapat memeriksa deret waktu secara visual melalui plot garis. Jika diduga ada musiman, kita dapat melanjutkan dengan melakukan dekomposisi deret waktu untuk menemukan besaran efek musiman.
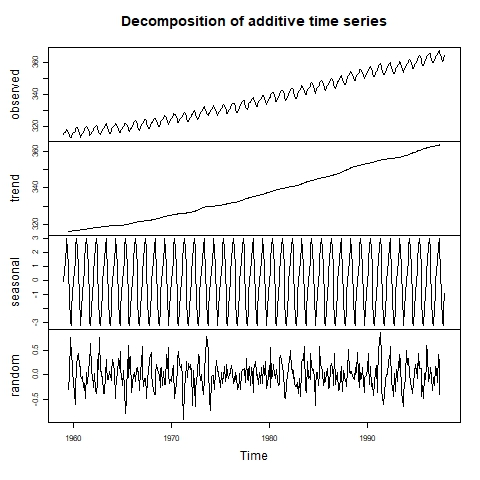
Deret waktu didekomposisi secara visual. Sumber: Lab of Environmental Informatics.
Model Exponential Smoothing menggunakan rata-rata berbobot dari pengamatan masa lalu untuk peramalan sederhana jangka pendek. Model ARIMA menggabungkan komponen autoregression, differencing, dan moving average, sehingga lebih kompleks namun cocok untuk peramalan jangka pendek maupun panjang, terutama dengan pola yang kompleks dan autokorelasi yang signifikan.
Cross-validation adalah teknik untuk menilai bagaimana model machine learning akan melakukan generalisasi ke dataset independen. Teknik ini melibatkan pembagian data menjadi beberapa lipatan (fold) dan melakukan beberapa putaran pelatihan dan validasi.
Karena menyempurnakan statistika dan hasil analisis belum lengkap tanpa mengomunikasikan hasilnya kepada pemangku kepentingan bisnis, penguasaan keterampilan lunak sangat penting bagi pemberi kerja yang merekrut untuk peran data, terutama karena mengomunikasikan wawasan dari statistika tidak pernah mudah.
Untuk berkomunikasi secara efektif dengan berbagai pemangku kepentingan, saya menyesuaikan gaya saya berdasarkan latar belakang dan minat mereka. Misalnya, untuk eksekutif, saya memprioritaskan dampak bisnis, menggunakan bahasa bisnis dan visual untuk memfasilitasi pengambilan keputusan yang cepat. Di sisi lain, untuk pengembang, saya memberikan detail teknis. Dalam kedua kasus, saya memastikan konsep yang terlibat cukup jelas dan mudah diakses, serta saya mendorong pertanyaan dan umpan balik. Pendekatan ini memastikan setiap kelompok pemangku kepentingan menerima informasi yang mereka butuhkan dalam format yang sesuai bagi mereka.
Mempelajari statistika untuk peran analitik data bisa menantang. Banyak orang masuk ke bidang ini dari berbagai latar belakang yang tidak selalu melibatkan banyak atau bahkan pengetahuan statistika. Sebagian besar sumber daya yang tersedia secara online mendorong pembelajar untuk hanya fokus pada alat, mengabaikan pentingnya statistika yang vital.
Untuk lebih meningkatkan pengetahuan dan peluang karier Anda, pertimbangkan untuk mengeksplorasi sumber daya dan kursus tambahan. Untuk panduan terperinci tentang cara menjadi ahli statistika, lihat posting blog kami, How to Become a Statistician, yang menawarkan wawasan berharga. Anda dapat melengkapinya dengan jalur karier Statistician with R kami. Luangkan waktu untuk menguji intuisi Anda dengan kursus Probability Puzzles in R. Jika Anda lebih menyukai Python, jalur keterampilan Statistics Fundamentals with Python kami adalah pilihan yang bagus.
Semoga sukses dalam wawancara Anda yang akan datang!
Pelajari Statistika bersama DataCamp
Kursus
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt




