
Lernpfad
AI Engineering with LangChain
21 Std.
Autonome KI-Coding-Agenten sind mächtig. Sie navigieren im Dateisystem, führen Shell-Befehle aus, machen Commits und ändern Dateien – ohne dass du eine einzige Zeile tippst. Diese Power wirft aber eine echte Frage auf: Was, wenn etwas schiefgeht? Was, wenn der Agent eine Config-Datei anfasst, die tabu sein sollte, oder ein Paket installiert, das mit deinem System kollidiert?
Die Antwort, auf die die meisten produktionsorientierten Developer kommen, ist Docker – und es ist dieselbe Antwort, zu der ich nach einer Session immer wieder zurückkam, in der Claude Code mir „hilfsbereit“ die .env-Datei des Projekts aufgeräumt hat, weil sie ungenutzt aussah. (War sie nicht.)
Container ziehen eine klare Grenze zwischen Agent und Hostmaschine – und genau diese Grenze sorgt dafür, dass unbeaufsichtigte Agent-Läufe entspannt statt nervös wirken.
In diesem Tutorial zeige ich dir, wie du Claude Code in Docker betreibst: von einem minimalen Basis-Image bis zur Orchestrierung einer Multi-Service-App mit Docker Compose. Am Ende hast du einen wiederholbaren, sicheren Workflow, den du für jedes Projekt nutzen kannst.
Wenn du dich für die neuesten Anthropic-Modelle interessierst, lies auch unsere Guides zu Claude Opus 4.6 und Claude Sonnet 4.6.
Um zu verstehen, warum Docker so gut zu Claude Code passt, hilft ein kurzer Blick darauf, was beide Werkzeuge eigentlich tun.
Claude Code ist das agentische Coding-CLI-Tool von Anthropic, seit Mai 2025 allgemein verfügbar. Es lebt in deinem Terminal, liest deinen Code, und erledigt Aufgaben (Refactoring, Tests schreiben, Git-Workflows) per natürlicher Sprache. Unser umfassendes Claude Code 2.1 Tutorial deckt alles ab, was du wissen musst.
Docker ist eine Plattform, um Anwendungen in leichtgewichtigen, isolierten Containern zu paketieren und auszuführen. Container teilen sich den Kernel des Host-Betriebssystems, halten aber strikte Prozess- und Dateisystemgrenzen ein. Wenn du komplett neu bei Docker bist, schau dir unser Tutorial zur kostenlosen Play with Docker-Plattform an und probiere es dort aus.
Claude Code braucht eine Laufzeitumgebung. Docker liefert eine reproduzierbare, wegwerfbare. Diese Kombination ist stark – aber um sie optimal zu nutzen, solltest du das Ausführungsmodell, die Sicherheitsdefaults und die passende Deployment-Variante für deinen Anwendungsfall verstehen.
Starten wir damit, wie eine containerisierte Claude-Code-Session auf Anfrage-Ebene funktioniert.
Entscheidend ist der Unterschied zwischen flüchtigem und persistentem Zustand. Alles, was in den Container, aber außerhalb des gemounteten Volumes geschrieben wird, wird beim Aufräumen gelöscht. Dein Workspace, der auf dem Host liegt und gemountet ist, bleibt erhalten.
Heißt: Temporäre Abhängigkeiten, Build-Artefakte und Tool-Installationen verschwinden, aber deine eigentlichen Projektdateien bleiben genau so, wie Claude sie hinterlassen hat. Diese Trennung ist wirklich beruhigend: Früher saß ich nervös vor Agent-Sessions. Heute starte ich eine Aufgabe und hole mir einen Kaffee.
Mit dem Ausführungsfluss im Kopf lohnt es sich, klar zu benennen, wovor Docker-Isolation schützt – und wovor nicht.
Dateisystem-Isolation ist der größte Sicherheitsgewinn. Claude Code kann nur in Pfaden lesen und schreiben, die du explizit mountest. Wenn du sie nicht mountest, bleiben deine SSH-Keys, ~/.aws-Zugangsdaten, Host-Umgebungsvariablen und Systemkonfigurationen für den Agenten unsichtbar – außer du legst sie bewusst offen. Dieser Schutz greift aber nur, wenn du deine Mounts sorgfältig konfigurierst.
Eine kritische Regel: Niemals den Docker-Socket des Hosts (/var/run/docker.sock) in den Claude-Code-Container mounten. Kann der Agent mit dem Docker-Daemon deines Hosts sprechen, könnte er privilegierte Container starten, aus der Sandbox ausbrechen und Root-Zugriff auf deine Maschine erlangen.
Das ist ein bekannter Privilege-Escalation-Pfad ohne gute Rechtfertigung. Ich habe das in Community-Dockerfiles schon als „praktischen“ Trick gesehen, damit der Agent „Container managen“ kann – und jedes Mal möchte ich den Autor scharf darauf hinweisen.
Abseits der Sicherheitsdefaults steht vor dem ersten Code noch eine Entscheidung an: Welches Deployment-Modell passt zu deinem Use Case? Es gibt drei Hauptoptionen, die nicht austauschbar sind.
|
Deployment-Methode |
Am besten geeignet für |
Zentraler Trade-off |
|
Docker-Sandbox (einzelner Container) |
Isolierte, einmalige Agent-Aufgaben |
Kein Service-zu-Service-Networking |
|
Docker Compose |
Multi-Service-Apps in der Entwicklung |
Mehr Setup, größere Angriffsfläche |
|
Devcontainers |
Teamweit standardisierte Umgebungen |
Erfordert VS Code oder eine kompatible IDE |
Für die meisten Aufgaben (Agent gegen ein einzelnes Repo, ein Script debuggen, ein Modul refactoren) ist eine einfache Docker-Sandbox der sicherste Default.
Docker Compose ergibt Sinn, wenn Claude Code mit einer laufenden Datenbank, API oder einem Frontend-Service interagieren muss.
Devcontainers sind die richtige Wahl für teamweit standardisierte Umgebungen mit vorinstallierten IDE-Erweiterungen. Bemerkenswert: Der offizielle Anthropic-Referenz-Devcontainer enthält eine integrierte Firewall, die ausgehende Verbindungen auf eine vertrauenswürdige Allowlist beschränkt. Diese Isolation macht es vertretbar, Claude Code mit --dangerously-skip-permissions voll unbeaufsichtigt laufen zu lassen.
In diesem Tutorial behandeln wir sowohl die Einzelcontainer-Sandbox als auch ein Compose-Setup.
Jetzt, da Architektur und Deployment-Optionen klar sind, sorgen wir für eine saubere Umgebung, bevor wir Code schreiben. Dieser Schritt wird oft übersprungen – und ist der häufigste Grund, warum Tutorials wie dieses mittendrin scheitern.
Das brauchst du, bevor du das erste docker build startest:
Docker Desktop (macOS oder Windows) oder Docker Engine (Linux) mit laufendem Daemon. Unter macOS und Windows muss Virtualisierung in BIOS/Firmware aktiviert sein. Unter Linux füge deinen Benutzer der docker-Gruppe hinzu mit sudo usermod -aG docker $USER oder setze vor jeden Docker-Befehl sudo.
Node.js v18 oder neuer auf dem Host, da das Claude-Code-CLI ein npm-Paket ist. Prüfe mit node --version.
Einen Anthropic-API-Key, den du in der Claude Console generieren kannst.
Prüfe mit einem schnellen Sanity-Check, ob Docker gesund läuft, bevor du weitermachst:
docker run --rm hello-worldWenn du Hello from Docker! siehst, antwortet dein Daemon korrekt – weiter geht's.
Ist der Daemon ok, geht es um Credentials. Deinen Anthropic-API-Key zur Laufzeit als Umgebungsvariable einzuspeisen ist deutlich sicherer, als dich interaktiv im Container einzuloggen.
Das habe ich schmerzhaft gelernt: Interaktive Logins können Zugangsdaten in Container-Layern oder Shell-Historien verewigen, die lange auf der Platte liegen bleiben.
Das richtige Muster ist, den Key zur Laufzeit mit -e zu übergeben:
docker run --rm -e ANTHROPIC_API_KEY="$ANTHROPIC_API_KEY" my-claude-imageBeachte: Ich referenziere $ANTHROPIC_API_KEY aus meiner Host-Shell. Der Key landet weder im Dockerfile, noch im Versionskontrollsystem, noch in einem Image-Layer. Setze ihn einmal in deinem Shell-Profil (~/.zshrc oder ~/.bashrc), und er fließt sauber in jeden künftigen Container-Run.
Mit geklärter Authentifizierung folgt der saubere Workspace. Ich lege für jede Agent-Session ein eigenes Verzeichnis an, statt Claude auf ein bestehendes Projekt zu zeigen – so verhinderst du, dass der Agent in angrenzenden Code gerät, den er nicht anfassen soll.
mkdir ~/claude-docker-tutorial
cd ~/claude-docker-tutorial
echo "# My Project" > README.md
echo "def hello(): return 'world'" > app.py
Halte dieses Verzeichnis sauber. Kopiere keine echte .env und keine Credentials hinein. Der Workspace sollte nur den Code enthalten, an dem der Agent arbeiten soll – sonst nichts. Damit sind wir bereit zum Bauen.
Mit der konfigurierten Umgebung geht es ans Bauen. Dieser Abschnitt führt dich durch die Schritte: zuerst ein minimales Einzelcontainer-Image, dann eine funktionierende Sandbox-Session und schließlich ein vollständiger Multi-Service-Stack mit Compose. Jeder Schritt baut auf dem vorherigen auf – ich empfehle, der Reihe nach zu gehen.
Alles hier folgt den besprochenen Sicherheitsprinzipien. Hier ein minimales Dockerfile, das sie umsetzt und das Claude-Code-CLI auf ein schlankes Node.js-Base-Image installiert:
FROM node:20-slim

# Create a non-root user for safer execution
RUN useradd -m -u 1001 claude

# Install Claude Code CLI globally
RUN npm install -g @anthropic-ai/claude-code

# Set the working directory
WORKDIR /workspace

# Switch to non-root user
USER claude

ENTRYPOINT ["claude"]
Ein paar Designentscheidungen dazu: Ich nutze node:20-slim statt node:20-alpine, weil Alpine die libc musl nutzt, was bei nativen npm-Paketen gelegentlich Probleme macht.
Genau das hatte ich beim ersten Versuch mit Alpine: CLI ließ sich installieren, aber der erste Run crashte mit einem kryptischen Linker-Fehler – Ursache: musl.
Die slim-Variante basiert auf Debian: leichtgewichtig, zuverlässig, ohne Drama. Außerdem erstelle ich einen dedizierten claude-User und wechsle vor dem Entrypoint darauf. So läuft der Agent ohne Root-Rechte und ist sogar im Container eingeschränkt.
Baue das Image mit:
docker build -t claude-code:latest .Beim ersten Build zieht Docker das Base-Image und installiert das CLI. Bei späteren Builds ohne Dockerfile-Änderungen siehst du „CACHED“ neben den Layers – Rebuilds sind dann fast instant.
Mit fertigem Image starten wir die erste echte Session.
Für reine Leseaufgaben wie Auflisten oder Zusammenfassen von Dateien reicht der Basisbefehl:
docker run --rm \
  -e ANTHROPIC_API_KEY="$ANTHROPIC_API_KEY" \
  -v $(pwd):/workspace \
  claude-code:latest \
  "List the files in this workspace and describe what each one does."
-v $(pwd):/workspace mountet dein aktuelles Verzeichnis in den Container – so funktioniert der Befehl in jedem Projektordner. --rm entfernt den Container nach Ende automatisch.
Für Schreibvorgänge brauchst du zwei zusätzliche Flags.
Mit -u $(id -u):$(id -g) übergibst du UID und GID deines Host-Users an den Container. So darf der claude-Prozess in deine gemounteten Dateien schreiben. Ohne dieses Flag bekommst du Read-only-Fehler, weil der Container-User claude nicht dem Dateibesitzer auf dem Host entspricht.
Mit --dangerously-skip-permissions überspringst du die interaktiven Bestätigungsdialoge von Claude Code – nötig im nicht-interaktiven Containermodus. Die Docker-Grenze macht das vertretbar.
docker run --rm \
  -e ANTHROPIC_API_KEY="$ANTHROPIC_API_KEY" \
  -v $(pwd):/workspace \
  -u $(id -u):$(id -g) \
  claude-code:latest \
  --dangerously-skip-permissions \
  "Add a docstring to the hello function in app.py."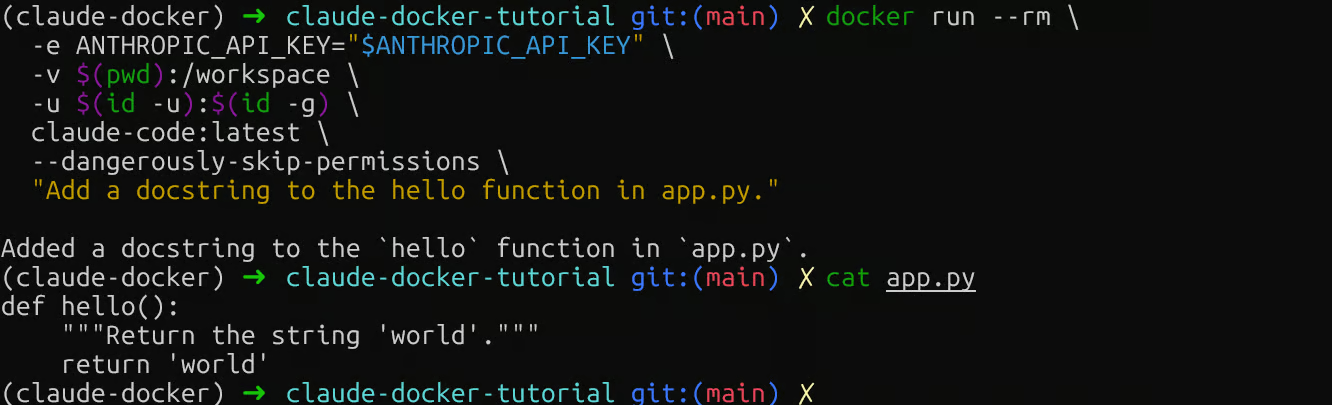
Claude Code: Schreiboperation in Docker
Prüfe dann lokal: cat app.py. Wenn du die Docstring siehst, funktioniert der Volume-Mount in beide Richtungen – bereit für Multi-Service.
Die Einzelcontainer-Sandbox ist super für isolierte Tasks, aber echte Entwicklung braucht oft mehrere parallel laufende Services. Hier spielt Docker Compose seine Stärken aus.
Die folgende Konfiguration verbindet den Claude-Agenten mit einem Web-Service und einer PostgreSQL-Datenbank – ein typisches Setup für viele Backend-Projekte:
services:
  claude:
    build: .
    environment:
      - ANTHROPIC_API_KEY=${ANTHROPIC_API_KEY}
    volumes:
      - ./workspace:/workspace
    depends_on:
      db:
        condition: service_healthy
    networks:
      - app-network

  web:
    image: python:3.12-slim
    working_dir: /app
    volumes:
      - ./workspace:/app
    command: python -m http.server 8080
    ports:
      - "8080:8080"
    networks:
      - app-network

  db:
    image: postgres:16-alpine
    environment:
      POSTGRES_DB: appdb
      POSTGRES_USER: user
      POSTGRES_PASSWORD: password
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U user -d appdb"]
      interval: 5s
      timeout: 3s
      retries: 5
    networks:
      - app-network

networks:
  app-network:
    driver: bridge
Beachte: version fehlt – in modernem Docker Compose ist das obsolet und erzeugt nur eine Warnung.
Zwei weitere Details sind wichtig:
Erstens mountet der claude-Service .:/workspace (das aktuelle Verzeichnis) statt eines Unterordners. Mit ./workspace bräuchtest du einen separaten Ordner – sonst sieht der Agent einen leeren Workspace.
Zweitens wird DATABASE_URL explizit übergeben, damit der Agent Postgres erreichen kann. Ohne Connection-String fragt dich Claude danach.
Die Zeile user: "${UID}:${GID}" setzt denselben UID/GID-Override wie bei docker run, damit Schreibrechte passen. Exportiere beides vor dem Start:
export UID=$(id -u) GID=$(id -g)Der claude-Service hat keinen persistenten command – er ist im Gegensatz zu web und db nicht für Dauerbetrieb gedacht. Starte erst die unterstützenden Services und rufe Claude bei Bedarf mit docker compose run auf:
# Datenbank und Web-Service starten
docker compose up -d web db

# Einen einmaligen Claude-Task ausführen
docker compose run --rm \
  claude \
  --dangerously-skip-permissions \
  "Check the database connection and summarize the schema in README.md."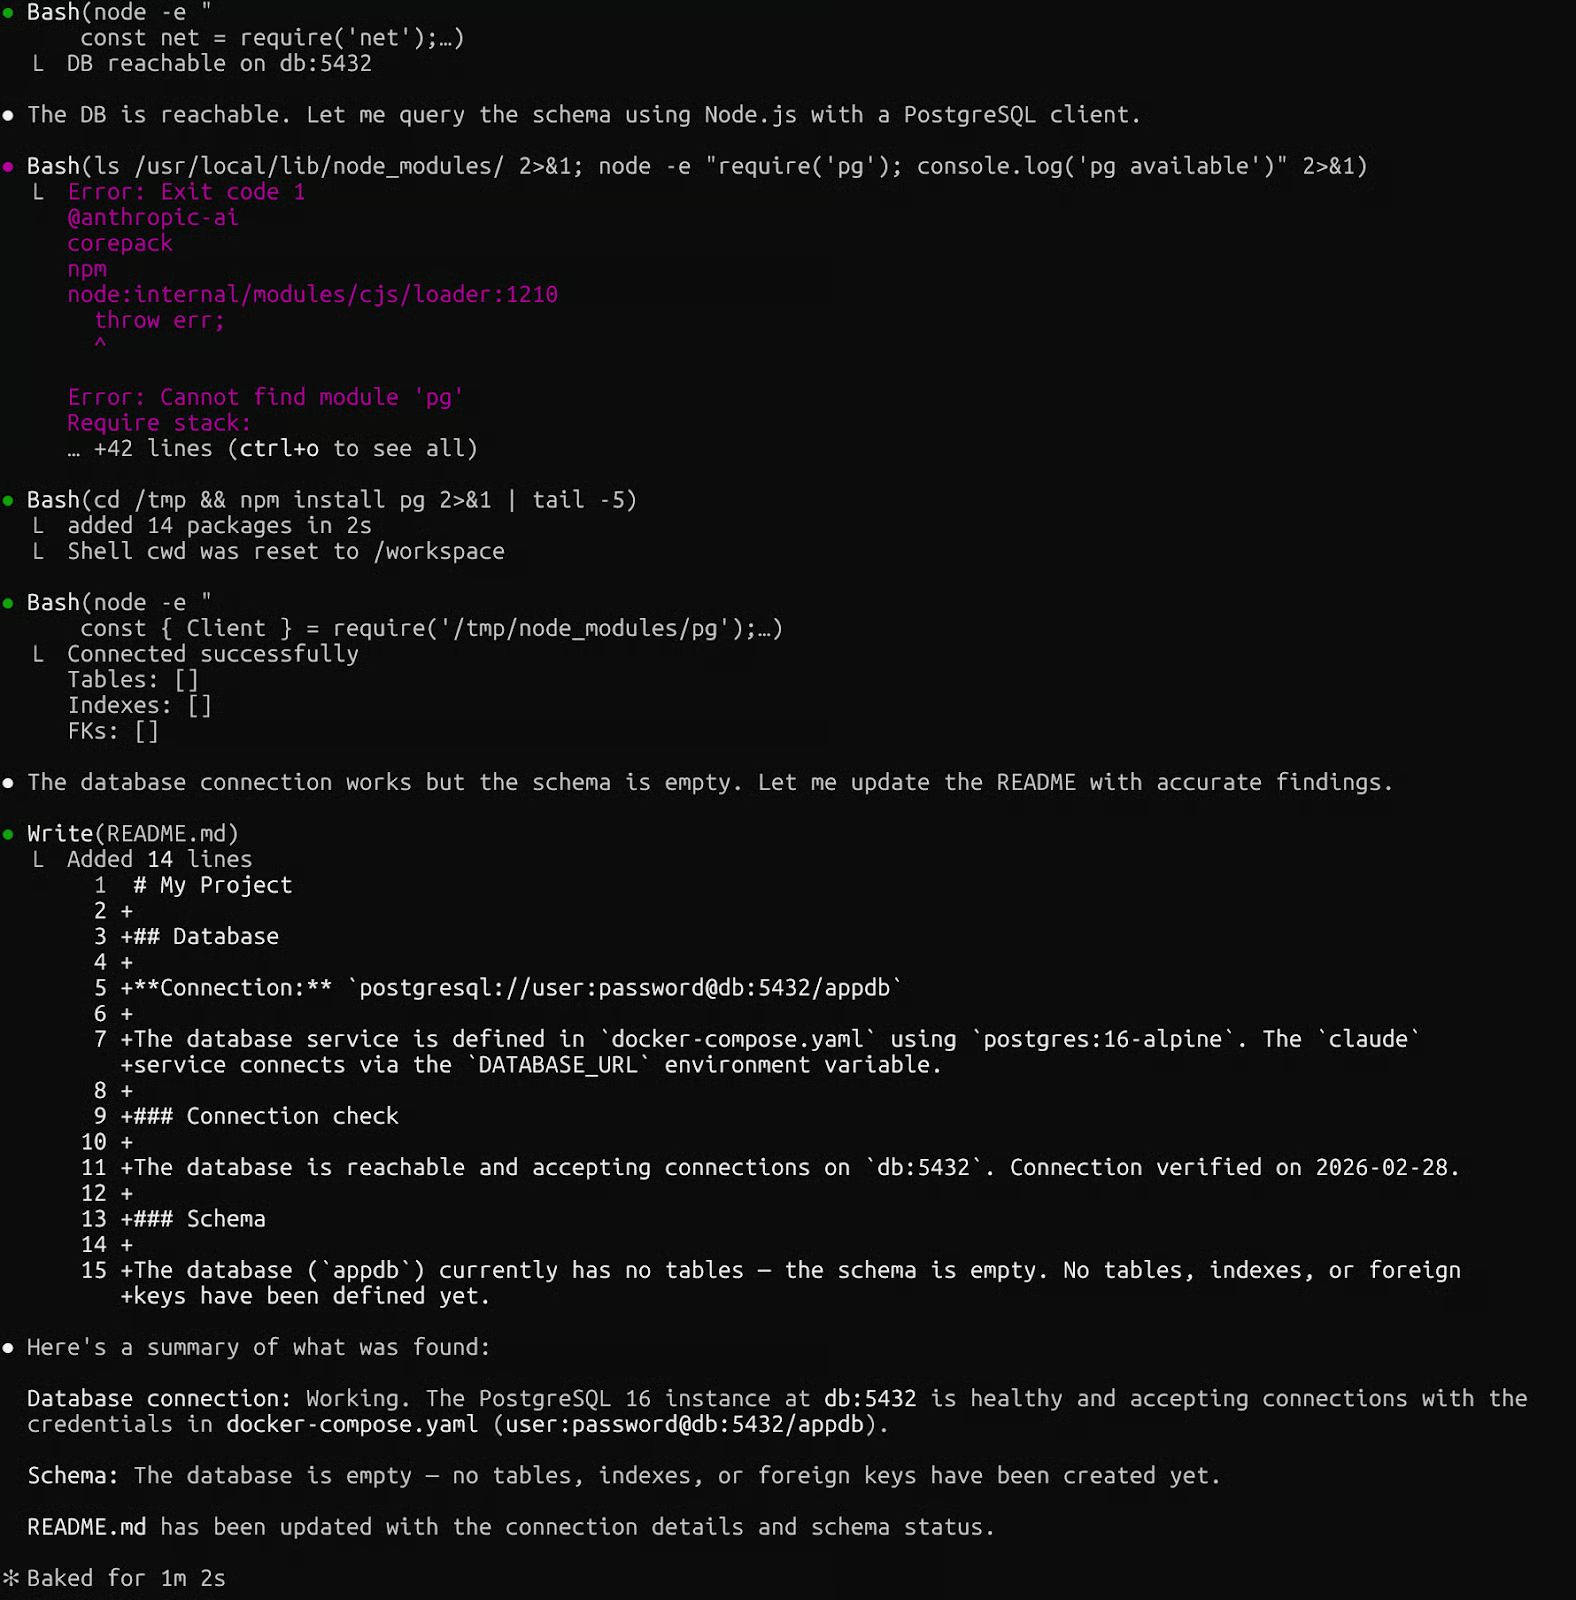
Claude Code mit Docker Compose
Starte die unterstützenden Services zuerst mit docker compose up -d web db und beobachte ihre Logs mit docker compose logs -f. Beachte depends_on mit condition: service_healthy.
Das habe ich in einem frühen Projekt weggelassen und dann 20 Minuten lang DB-Verbindungsfehler gejagt – Claude startete, bevor Postgres bereit war. Der Healthcheck kostet nichts und spart genau diesen Schmerz.
Ist die Session beendet, ist Cleanup genauso wichtig wie das Setup. Verwaiste Container verbrauchen Speicher und stören künftige Runs. Aus meiner Erfahrung wird dieser Schritt oft ignoriert – bis es seltsam wird.
Das sind die wichtigsten Befehle – plus, wann du sie nutzt:
|
Befehl |
Wirkung |
Wann einsetzen |
|
|
Stoppt und entfernt alle Container im Stack |
Nach jeder Compose-Session |
|
|
Entfernt alle gestoppten Container |
Wenn du bei Einzelruns --rm vergessen hast |
|
|
Entfernt Container, Netzwerke und benannte Volumes |
Kompletter Reset, löscht DB-Status |
|
|
Listet laufende Container |
Um sicherzugehen, dass nichts mehr aktiv ist |
Das -v-Flag bei docker compose down ist das heikle. Es löscht benannte Volumes – damit ist jeder Datenbankinhalt weg. Ich nutze es nur, wenn ich wirklich neu anfangen will. Sonst reicht docker compose down allein.
Wenn der Kern-Workflow sauber läuft, schauen wir, wie du ihn erweiterst – und was zu tun ist, wenn etwas bricht.
Claude Code kann Inferenz auf jeden Anthropic-kompatiblen lokalen Endpoint via ANTHROPIC_BASE_URL umleiten. Der in Docker Desktop integrierte Docker Model Runner stellt genau so eine API bereit – die Integration ist damit nativ im Docker-Ökosystem.
Ziehe ein Modell und richte Claude Code auf den lokalen Endpoint aus:
docker model pull ai/smollm2
ANTHROPIC_BASE_URL=http://localhost:12434 claude --model ai/smollm2 "List the files of the repository."
Das ist ein anderes Muster als die zuvor gezeigte Sandbox im Container. Hier läuft Claude Code auf dem Host und die Inferenz bleibt via Docker Model Runner lokal – es verlässt kein API-Call deine Maschine.
Über lokale Modelle hinaus kannst du die Reichweite von Claude Code mit MCP (Model Context Protocol)-Servern erweitern. Falls dir das neu ist: Unser MCP-Guide ist ein guter Start.
Das Docker MCP Toolkit liefert über 200 vorgefertigte, containerisierte MCP-Server für GitHub, Jira, Supabase und mehr. So erhält Claude Code berechtigten Zugriff auf diese Tools, ohne rohe API-Credentials offenzulegen.
Zusammen geben dir diese beiden Erweiterungspunkte echte Kontrolle darüber, wo Inferenz stattfindet und auf welche externen Services der Agent zugreifen darf.
Wenn dein Dockerfile wächst, kann die Buildzeit zum Flaschenhals werden. Multi-Stage-Builds lösen das, indem sie Installation und Runtime trennen:
# Build stage
FROM node:20-slim AS builder
RUN npm install -g @anthropic-ai/claude-code

# Runtime stage
FROM node:20-slim
COPY --from=builder /usr/local/lib/node_modules /usr/local/lib/node_modules
COPY --from=builder /usr/local/bin/claude /usr/local/bin/claude
RUN useradd -m -u 1001 claude
USER claude
WORKDIR /workspace
ENTRYPOINT ["claude"]
Die Reihenfolge der Layer ist genauso wichtig wie die Struktur – und genau das habe ich länger falsch gemacht, als mir lieb ist.
Selten ändernde Instruktionen (z. B. Systempakete installieren) gehören nach oben. Häufig ändernde (z. B. Quellcode kopieren) nach unten. So maximierst du Cache-Hits – aus 30 Sekunden Rebuild werden nahezu sofortige.
Selbst mit gutem Setup geht mal etwas kaputt. Hier ist eine wiederholbare Debug-Schleife für häufige Probleme – Symptom zuerst, dann der Befehl:
Blockierte ausgehende Verbindungen: Claude Code erreicht die Anthropic-API nicht. Führe docker run --rm alpine wget -qO- https://api.anthropic.com aus, um Egress zu prüfen. Falls das scheitert, checke docker network inspect bridge auf Proxy-Settings.
Falsche Volume-Mounts: Claude Code findet Dateien nicht. Führe docker run --rm -v $(pwd):/workspace alpine ls /workspace aus. Eine leere Liste bedeutet: Pfad falsch. Prüfe zuerst, ob der Ordner existiert.
Staler Build-Cache: Dockerfile geändert, Verhalten gleich. Erzwinge einen vollen Rebuild mit docker build --no-cache -t claude-code:latest ..
Service-zu-Service-Probleme in Compose: Ein Service erreicht den anderen nicht. Services sprechen über Servicenamen (db, web), nicht localhost. Teste mit docker compose exec web ping db. Ein Fehlschlag heißt: nicht im selben Netzwerk.
Claude Code in Docker zu betreiben, gibt dir etwas wirklich Wertvolles: die Freiheit, einen autonomen Agenten arbeiten zu lassen – mit klarer Grenze, was er berühren darf.
In dieser Anleitung habe ich ein minimales Non-Root-Image gebaut, Workspace-Volumes gemanagt, Multi-Service-Anwendungen mit Docker Compose orchestriert und die häufigsten Integrationsfehler diagnostiziert.
Das Setup hat mich einen Nachmittag gekostet – und meine Arbeitsweise mit Agenten grundlegend verändert. Ich delegiere ganze Aufgaben, statt jeden Schritt zu überwachen. Die Docker-Grenze macht das möglich.
Von hier aus lohnen sich zwei Richtungen:
Erstens: Schau dir Devcontainer-Vorlagen für dein Team an. Der Claude-Code-Referenz-Devcontainer auf GitHub bringt eine vorkonfigurierte Firewall mit, die ausgehende Verbindungen auf vertrauenswürdige Domains beschränkt. Zweitens: Experimentiere mit dem Docker MCP Toolkit, um Claude Code strukturierten Zugriff auf deine bstehenden Tools zu geben: GitHub, Datenbanken, Projektmanagement-Systeme und mehr.
Und schließlich: Setze dir eine Erinnerung, deine Base-Images regelmäßig zu aktualisieren. Docker-Images sammeln mit der Zeit Schwachstellen an – ein schnelles docker pull node:20-slim plus Rebuild dauert nur Minuten.
Wenn du dich für die Entwicklung von KI-Anwendungen interessierst, kann ich dir unseren AI Engineering with LangChain-Lernpfad wärmstens empfehlen. Die Kurse sind AI-native – du bekommst eine:n persönliche:n Tutor:in, der/die dich genau auf deinem Niveau abholt und dich in deinem Tempo zu deinen Zielen bringt.
Top-Kurse zu KI
Lernpfad
Kurs
Kurs
Blog
Blog
Hesam Sheikh Hassani
15 Min.
Tutorial
Kurtis Pykes
15 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Derrick Mwiti
10 Min.
Tutorial
Laiba Siddiqui
6 Min.



