
Cursus
AI Engineering with LangChain
21 h
Les agents IA pour le code autonomes sont puissants. Ils explorent votre système de fichiers, exécutent des commandes shell, font des commits et modifient des fichiers, sans que vous ayez à taper une seule ligne de code. Mais cette puissance soulève une vraie question : que se passe-t-il si quelque chose déraille ? Et si l’agent modifie un fichier de configuration qu’il ne devrait pas toucher, ou installe un paquet en conflit avec votre système ?
La réponse sur laquelle convergent la plupart des développeurs orientés production, c’est Docker. Et c’est exactement la conclusion à laquelle je suis revenu après une session où Claude Code a « nettoyé » le fichier .env de mon projet parce qu’il paraissait inutilisé. (Il ne l’était pas.)
Les conteneurs tracent une frontière nette entre l’agent et votre machine hôte, et c’est cette frontière qui rend les exécutions non surveillées rassurantes plutôt qu’angoissantes.
Dans ce tutoriel, je vous montre comment exécuter Claude Code dans Docker : de la création d’une image minimale de base à l’orchestration d’une application multi-services avec Docker Compose. À la fin, vous disposerez d’un flux de travail reproductible et sécurisé, applicable à n’importe quel projet.
Si les tout derniers modèles d’Anthropic vous intéressent, je vous recommande nos guides sur Claude Opus 4.6 et Claude Sonnet 4.6.
Pour comprendre pourquoi Docker se marie si bien avec Claude Code, il faut d’abord rappeler brièvement ce que fait chaque outil.
Claude Code est l’outil en ligne de commande d’Anthropic pour le développement assisté par agent, disponible en version générale depuis mai 2025. Il vit dans votre terminal, lit votre base de code et exécute des tâches (refactorisation, écriture de tests, gestion de workflows git) à partir d’instructions en langage naturel. Notre tutoriel complet Claude Code 2.1 couvre tout ce qu’il faut savoir.
Docker est une plateforme pour empaqueter et exécuter des applications dans des conteneurs légers et isolés qui partagent le noyau de l’OS hôte tout en maintenant des frontières strictes de processus et de système de fichiers. Si vous débutez totalement avec Docker, je vous conseille notre guide sur la plateforme gratuite Play with Docker pour faire vos premiers essais.
Claude Code a besoin d’un environnement d’exécution. Docker en fournit un, reproductible et jetable. L’ensemble est puissant, mais pour en tirer le meilleur, il faut comprendre le modèle d’exécution, les paramètres de sécurité par défaut et le mode de déploiement adapté à votre cas.
Commençons par voir comment fonctionne concrètement une session de Claude Code conteneurisée, à l’échelle de la requête.
La distinction clé se fait entre l’état éphémère et l’état persistant. Tout ce qui est écrit dans le conteneur en dehors du volume monté est supprimé au nettoyage. Votre espace de travail, qui vit sur l’hôte et est monté dans le conteneur, persiste.
Concrètement, les dépendances temporaires, artefacts de build et installations d’outils disparaissent, mais vos fichiers de projet restent exactement dans l’état où Claude les a laissés. Cette séparation est réellement rassurante : avant de la comprendre, je regardais nerveusement les sessions de l’agent. Aujourd’hui, je lance une tâche et je pars me faire un café.
Avec le déroulé en tête, précisons ce que l’isolation de Docker protège réellement… et ce qu’elle ne protège pas.
L’isolation du système de fichiers est le principal gain de sécurité. Claude Code ne peut lire/écrire que dans les chemins que vous montez explicitement. Si vous ne les montez pas dans le conteneur, vos clés SSH, identifiants ~/.aws, variables d’environnement de l’hôte et fichiers de configuration système sont invisibles pour l’agent, sauf si vous les exposez volontairement. Cette protection vaut toutefois uniquement si vous configurez vos montages avec soin.
Règle critique : ne montez jamais le socket Docker de l’hôte (/var/run/docker.sock) dans le conteneur de Claude Code. Si l’agent peut parler au démon Docker de votre machine, il peut potentiellement lancer des conteneurs privilégiés, sortir du bac à sable et obtenir un accès de niveau root à votre machine.
C’est une voie d’escalade de privilèges bien connue, sans vraie justification. Je l’ai vue suggérée dans quelques Dockerfiles de communauté pour « laisser l’agent gérer des conteneurs », et à chaque fois, j’ai envie d’écrire à l’auteur un message bien senti.
Au-delà des paramètres de sécurité, il reste une décision avant d’écrire la moindre ligne : quel modèle de déploiement convient à votre usage ? Trois grandes options, non interchangeables.
|
Méthode de déploiement |
Idéal pour |
Compromis clé |
|
Bac à sable Docker (conteneur unique) |
Tâches ponctuelles d’agent, isolées |
Pas de réseau inter-services |
|
Docker Compose |
Apps multi-services en développement |
Plus de configuration, surface d’attaque élargie |
|
Devcontainers |
Environnements standardisés à l’échelle de l’équipe |
Nécessite VS Code ou un IDE compatible |
Pour la plupart des tâches (lancer l’agent sur un seul dépôt, déboguer un script, refactorer un module), un simple bac à sable Docker est l’option par défaut la plus sûre.
Docker Compose prend tout son sens lorsque Claude Code doit interagir avec une base de données, une API ou un service frontend en cours d’exécution.
Les devcontainers sont le bon choix pour des environnements standardisés d’équipe, avec extensions d’IDE préconfigurées. Notamment, le devcontainer de référence Anthropic intègre un pare-feu limitant les connexions sortantes à une liste de domaines de confiance : c’est ce qui rend sûr l’usage de Claude Code avec --dangerously-skip-permissions en mode totalement non supervisé.
Dans ce tutoriel, nous couvrirons à la fois le bac à sable mono-conteneur et une configuration Compose.
Maintenant que l’architecture et les options de déploiement sont claires, assurons-nous que l’environnement est correctement configuré avant d’écrire la moindre ligne. J’ai vu cette étape ignorée bien trop souvent, et c’est la cause la plus fréquente d’échec en cours de tutoriel.
Voici tout ce qu’il faut en place avant le premier docker build :
Docker Desktop (macOS ou Windows) ou Docker Engine (Linux), avec le démon actif. Sur macOS et Windows, la virtualisation doit être activée dans le BIOS/firmware. Sur Linux, ajoutez votre utilisateur au groupe docker avec sudo usermod -aG docker $USER, ou préfixez chaque commande Docker par sudo.
Node.js v18 ou supérieur sur votre machine hôte, car le CLI Claude Code est un package npm. Vérifiez avec node --version.
Une clé d’API Anthropic, à générer dans la Claude Console.
Vérifiez rapidement que Docker est en bonne santé avant d’aller plus loin :
docker run --rm hello-worldSi vous voyez Hello from Docker!, votre démon répond correctement et vous pouvez continuer.
Une fois le démon validé, la prochaine étape critique concerne les identifiants. Injecter votre clé d’API Anthropic comme variable d’environnement au moment de l’exécution est nettement plus sûr que de se connecter de manière interactive dans le conteneur.
Je l’ai appris à mes dépens : les connexions interactives peuvent graver des identifiants dans les couches du conteneur ou dans l’historique du shell, qui persistent sur le disque bien après que vous les ayez oubliés.
La bonne pratique consiste à passer la clé à l’exécution avec -e :
docker run --rm -e ANTHROPIC_API_KEY="$ANTHROPIC_API_KEY" my-claude-imageNotez que je référence $ANTHROPIC_API_KEY depuis mon shell hôte. La clé n’est jamais écrite dans le Dockerfile, jamais versionnée et n’apparaît dans aucune couche d’image. Définissez-la une fois dans votre profil de shell (~/.zshrc ou ~/.bashrc) et elle sera transmise proprement à chaque exécution de conteneur.
Une fois l’authentification réglée, dernière étape : créer un espace de travail propre. Je crée toujours un répertoire dédié pour chaque session d’agent plutôt que de pointer Claude vers un projet existant, afin d’éliminer le risque qu’il s’aventure dans du code adjacent non visé.
mkdir ~/claude-docker-tutorial
cd ~/claude-docker-tutorial
echo "# My Project" > README.md
echo "def hello(): return 'world'" > app.py
Gardez ce répertoire propre. Ne copiez pas votre vrai fichier .env ni aucun identifiant. L’espace de travail ne doit contenir que le code sur lequel vous souhaitez que l’agent opère, rien d’autre. On peut construire.
Avec l’environnement prêt et les concepts clairs, passons à la construction. Cette section détaille les étapes : d’abord une image minimale mono-conteneur, puis une session de bac à sable fonctionnelle, et enfin un stack Compose multi-services. Chaque étape s’appuie sur la précédente ; je vous recommande de suivre l’ordre.
Tout ce qui suit repose sur les principes de sécurité évoqués plus haut. Voici un Dockerfile minimal qui les met en pratique, en installant le CLI Claude Code sur une image Node.js allégée :
FROM node:20-slim

# Create a non-root user for safer execution
RUN useradd -m -u 1001 claude

# Install Claude Code CLI globally
RUN npm install -g @anthropic-ai/claude-code

# Set the working directory
WORKDIR /workspace

# Switch to non-root user
USER claude

ENTRYPOINT ["claude"]
Quelques choix de conception méritent explication. J’utilise node:20-slim plutôt que node:20-alpine car Alpine s’appuie sur la libc musl, qui provoque parfois des incompatibilités avec des packages npm natifs.
Je suis tombé exactement sur ce cas lors d’un premier essai avec Alpine : le CLI Claude Code s’installait correctement mais plantait au premier lancement avec une erreur de l’éditeur de liens, que j’ai mis une heure à rattacher à musl.
La variante slim est basée sur Debian : légère et fiable, sans drama. J’ajoute également un utilisateur dédié claude et je bascule dessus avant l’entrypoint, de sorte que le processus agent n’a pas les privilèges root, limitant ce qu’il peut faire même dans le conteneur.
Construisez l’image avec :
docker build -t claude-code:latest .Au premier build, Docker récupère l’image de base et installe le CLI. Aux builds suivants sans changement du Dockerfile, vous verrez « CACHED » à côté de chaque couche : les reconstructions deviennent quasi instantanées une fois la base en place.
L’image est prête, lançons une première vraie session.
Pour des tâches en lecture seule comme lister ou résumer des fichiers, la commande de base suffit :
docker run --rm \
  -e ANTHROPIC_API_KEY="$ANTHROPIC_API_KEY" \
  -v $(pwd):/workspace \
  claude-code:latest \
  "List the files in this workspace and describe what each one does."
L’option -v $(pwd):/workspace monte votre répertoire courant dans le conteneur, donc la commande fonctionne depuis n’importe quel projet. L’option --rm supprime automatiquement le conteneur après sa sortie.
Les opérations en écriture exigent deux options supplémentaires.
L’option -u $(id -u):$(id -g) transmet l’UID et le GID de votre utilisateur hôte dans le conteneur, donnant au processus claude les droits d’écriture sur vos fichiers montés. Sans cela, vous obtiendrez une erreur de système de fichiers en lecture seule, car l’utilisateur claude du conteneur ne correspond pas au propriétaire des fichiers de l’hôte.
L’option --dangerously-skip-permissions ignore les demandes d’approbation interactives de Claude Code, nécessaires en mode non interactif dans un conteneur. La frontière Docker est précisément ce qui rend cela sûr.
docker run --rm \
  -e ANTHROPIC_API_KEY="$ANTHROPIC_API_KEY" \
  -v $(pwd):/workspace \
  -u $(id -u):$(id -g) \
  claude-code:latest \
  --dangerously-skip-permissions \
  "Add a docstring to the hello function in app.py."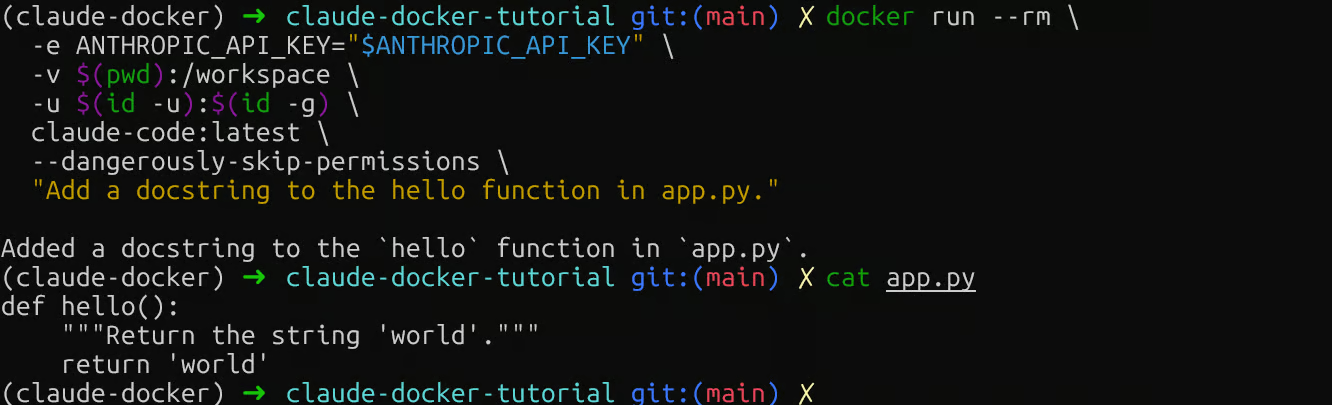
Opération d’écriture avec Claude Code dans Docker
Vérifiez ensuite votre fichier local : cat app.py. Si vous voyez la docstring, le montage de volume fonctionne dans les deux sens et vous pouvez passer à une configuration multi-services.
Le bac à sable mono-conteneur est efficace pour des tâches isolées, mais en développement réel, plusieurs services tournent souvent en parallèle. C’est là que Docker Compose s’impose.
La configuration ci-dessous relie l’agent Claude Code à un service web et une base PostgreSQL : un schéma représentatif de nombreux projets backend :
services:
  claude:
    build: .
    environment:
      - ANTHROPIC_API_KEY=${ANTHROPIC_API_KEY}
    volumes:
      - ./workspace:/workspace
    depends_on:
      db:
        condition: service_healthy
    networks:
      - app-network

  web:
    image: python:3.12-slim
    working_dir: /app
    volumes:
      - ./workspace:/app
    command: python -m http.server 8080
    ports:
      - "8080:8080"
    networks:
      - app-network

  db:
    image: postgres:16-alpine
    environment:
      POSTGRES_DB: appdb
      POSTGRES_USER: user
      POSTGRES_PASSWORD: password
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U user -d appdb"]
      interval: 5s
      timeout: 3s
      retries: 5
    networks:
      - app-network

networks:
  app-network:
    driver: bridge
Remarquez que version est omis : il est obsolète dans Docker Compose moderne et génère un avertissement s’il est inclus.
Deux autres détails à noter :
Premièrement, le service claude monte .:/workspace (le répertoire courant) plutôt qu’un sous-dossier. Utiliser ./workspace imposerait l’existence d’un sous-dossier séparé et l’agent verrait un espace vide.
Deuxièmement, DATABASE_URL doit être passée explicitement pour que l’agent sache joindre Postgres. Sans cela, Claude n’a pas de chaîne de connexion et vous la demandera.
La ligne user: "${UID}:${GID}" applique le même override UID/GID hôte que dans les commandes docker run autonomes, afin que les écritures de fichiers fonctionnent correctement. Exportez-les avant d’exécuter :
export UID=$(id -u) GID=$(id -g)Le service claude n’a pas de command persistante, donc contrairement à web et db, il n’est pas destiné à tourner en continu. Démarrez d’abord les services de support, puis invoquez Claude à la demande avec docker compose run :
# Start the database and web service
docker compose up -d web db

# Run a one-off Claude task
docker compose run --rm \
  claude \
  --dangerously-skip-permissions \
  "Check the database connection and summarize the schema in README.md."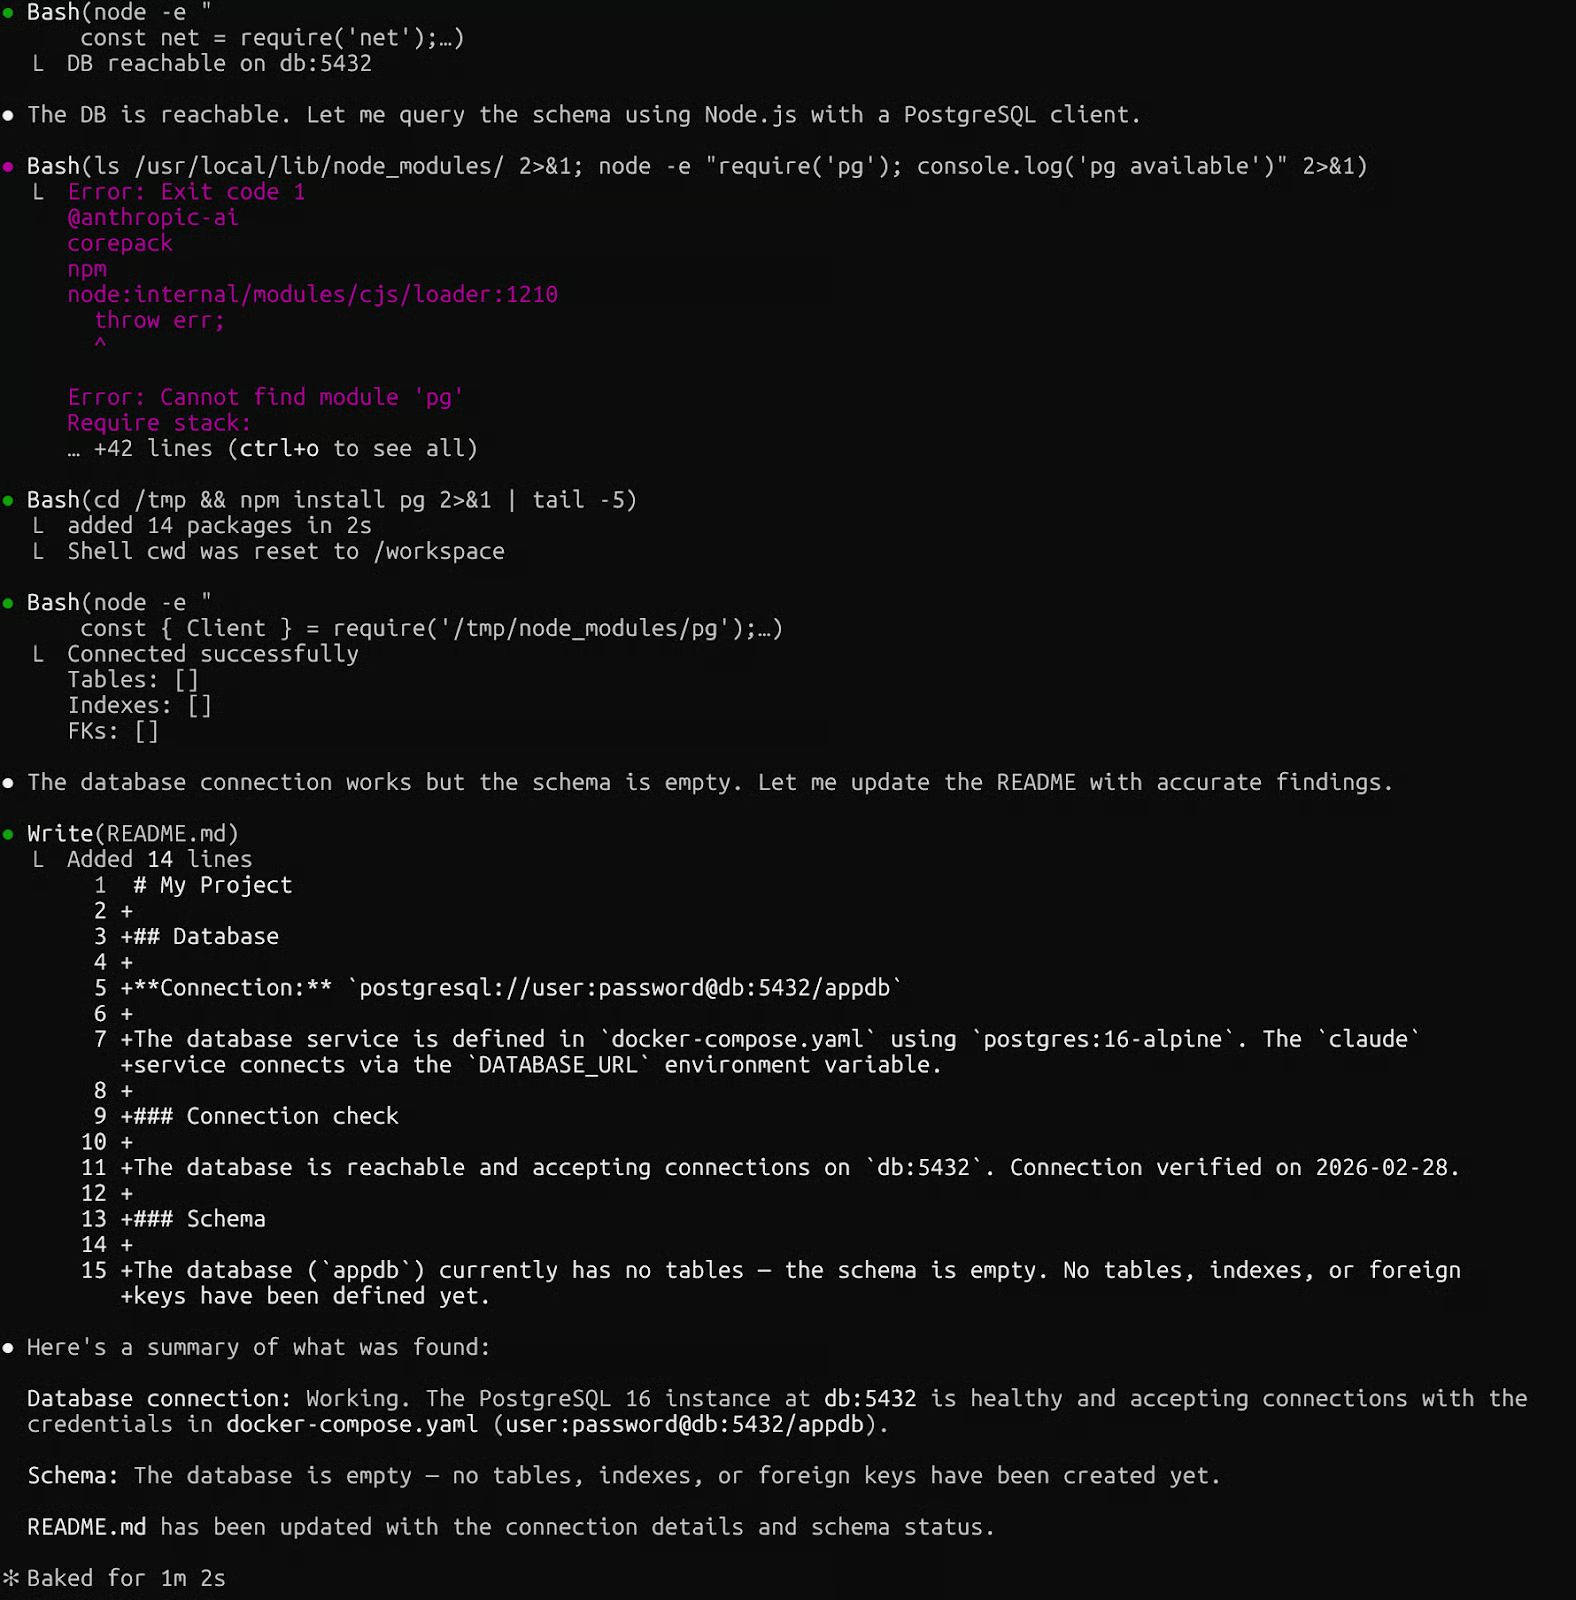
Claude Code avec Docker Compose
Démarrez d’abord les services de support avec docker compose up -d web db, puis suivez leurs journaux avec docker compose logs -f. Notez le depends_on avec condition: service_healthy.
J’ai zappé cela sur un projet au début et perdu 20 minutes à traquer des erreurs de connexion à la base avant de réaliser que Claude démarrait avant que Postgres soit prêt. Le healthcheck ne coûte rien et évite exactement ce casse-tête.
Une fois la session terminée, le nettoyage est aussi important que la mise en place. Des conteneurs orphelins consomment de la mémoire et perturbent les exécutions futures. D’expérience, c’est l’étape que beaucoup omettent jusqu’à ce que quelque chose se comporte étrangement.
Voici les commandes les plus utiles, et quand les utiliser :
|
Commande |
Ce qu’elle fait |
Quand l’utiliser |
|
|
Arrête et supprime tous les conteneurs du stack |
Après chaque session Compose |
|
|
Supprime tous les conteneurs arrêtés |
Si vous avez oublié --rm sur une exécution autonome |
|
|
Supprime conteneurs, réseaux et volumes nommés |
Réinitialisation complète, efface l’état de la base |
|
|
Liste les conteneurs en cours d’exécution |
Pour confirmer qu’il ne reste rien d’actif |
L’option -v sur docker compose down est celle à manier avec précaution. Elle supprime les volumes nommés, donc toutes les données accumulées dans Postgres disparaîtront. Je ne l’utilise que lorsque je veux vraiment repartir de zéro. Sinon, docker compose down suffit largement.
Avec le flux principal bien en place, voyons comment l’étendre et comment le déboguer quand quelque chose casse.
Claude Code permet de rediriger l’inférence vers tout endpoint local compatible Anthropic via ANTHROPIC_BASE_URL. Docker Model Runner, intégré à Docker Desktop, expose précisément une telle API, rendant l’intégration native à l’écosystème Docker.
Récupérez un modèle et pointez Claude Code vers l’endpoint local :
docker model pull ai/smollm2
ANTHROPIC_BASE_URL=http://localhost:12434 claude --model ai/smollm2 "List the files of the repository."
C’est un modèle différent de l’approche bac à sable couverte plus haut. Ici, Claude Code tourne sur votre hôte et l’inférence reste locale via Docker Model Runner : aucun appel d’API ne sort de votre machine.
Au-delà des modèles locaux, vous pouvez étendre la portée de Claude Code avec des serveurs MCP (Model Context Protocol). Si vous ne le connaissez pas, notre guide MCP est une excellente porte d’entrée.
Le MCP Toolkit de Docker propose plus de 200 serveurs MCP préconçus et conteneurisés couvrant GitHub, Jira, Supabase et bien d’autres, donnant à Claude Code un accès sous contrôle à ces outils, sans exposer directement vos identifiants d’API.
Ensemble, ces deux points d’extension vous donnent la main à la fois sur le lieu d’inférence et sur les services externes accessibles à l’agent.
À mesure que votre Dockerfile s’étoffe, le temps de build peut devenir un goulot d’étranglement. Les builds multi-étapes corrigent cela en séparant l’installation de l’image d’exécution :
# Build stage
FROM node:20-slim AS builder
RUN npm install -g @anthropic-ai/claude-code

# Runtime stage
FROM node:20-slim
COPY --from=builder /usr/local/lib/node_modules /usr/local/lib/node_modules
COPY --from=builder /usr/local/bin/claude /usr/local/bin/claude
RUN useradd -m -u 1001 claude
USER claude
WORKDIR /workspace
ENTRYPOINT ["claude"]
L’ordre des couches compte autant que la structure, et j’ai mis plus de temps que je ne l’avoue à l’apprendre.
Les instructions qui changent rarement (installation de paquets système) vont en haut. Celles qui changent fréquemment (copie de sources) vont en bas. Vous maximisez ainsi l’usage du cache et transformez des reconstructions de 30 secondes en exécutions quasi instantanées.
Même avec une configuration propre, des problèmes surviennent. Voici une boucle de débogage reproductible pour les cas que je rencontre le plus souvent. Symptôme d’abord, commande ensuite :
Sortie réseau bloquée : Claude Code n’atteint pas l’API Anthropic. Lancez docker run --rm alpine wget -qO- https://api.anthropic.com pour vérifier la sortie. Si cela échoue, examinez docker network inspect bridge pour des paramètres de proxy.
Volumes mal montés : Claude Code ne trouve pas les fichiers. Lancez docker run --rm -v $(pwd):/workspace alpine ls /workspace. Si la liste est vide, le chemin est erroné. Confirmez d’abord l’existence du répertoire.
Cache de build obsolète : Vous avez modifié le Dockerfile mais le comportement n’a pas changé. Forcez une reconstruction complète avec docker build --no-cache -t claude-code:latest ..
Échecs de connexion inter-services sous Compose : Un service n’atteint pas un autre. Les services communiquent via leurs noms (db, web), pas via localhost. Testez avec docker compose exec web ping db. Un ping en échec signifie que les services ne partagent pas le même réseau.
Exécuter Claude Code dans Docker vous apporte quelque chose de précieux : la liberté de laisser un agent autonome travailler sereinement, avec des périmètres d’action strictement maîtrisés.
Dans ce tutoriel, j’ai présenté la construction d’une image non-root minimale, la gestion des volumes d’espace de travail, l’orchestration d’applications multi-services avec Docker Compose, et le diagnostic des pannes d’intégration les plus courantes.
La mise en place m’a pris un après-midi, et elle a complètement changé ma façon d’aborder le développement assisté par agent. Je délègue des tâches entières au lieu de surveiller chaque étape, et la frontière Docker rend cela possible.
À partir d’ici, deux pistes à explorer :
D’abord, penchez-vous sur les modèles de devcontainer pour votre équipe. Le devcontainer de référence Claude Code sur GitHub inclut un pare-feu préconfiguré qui limite les connexions sortantes aux domaines de confiance. Ensuite, testez Docker MCP Toolkit pour donner à Claude Code un accès structuré à vos outils existants : GitHub, bases de données, outils de gestion de projet, et plus encore.
Enfin, programmez un rappel pour mettre à jour régulièrement vos images de base. Les images Docker accumulent des vulnérabilités avec le temps, et un simple docker pull node:20-slim suivi d’une reconstruction prend quelques minutes.
Si vous êtes intéressé par le développement d’applications IA, nous vous recommandons vivement de vous inscrire à notre parcours de compétences AI Engineering with LangChain. Les cours qui le composent sont natifs IA : vous bénéficiez d’un enseignant personnel qui vous prend exactement à votre niveau et vous aide à atteindre vos objectifs à votre rythme.
Les meilleurs cours en IA
Cursus
Cours
Cours
blog
blog
Kurtis Pykes
9 min
blog
Kurtis Pykes
15 min
Tutoriel
Tutoriel
Kurtis Pykes
15 min
Tutoriel
DataCamp Team
3 min


