La distance euclidienne, un concept qui remonte aux mathématiques grecques antiques, est devenue un outil indispensable en data science, en apprentissage automatique et en analyse spatiale. Baptisée d’après le célèbre Euclide, cette mesure fournit un moyen fondamental d’évaluer la distance en ligne droite entre des points dans l’espace, en deux dimensions comme en dimension supérieure.
Qu’est-ce que la distance euclidienne ?
La distance euclidienne représente le plus court chemin entre deux points dans un espace euclidien. C’est la distance que vous mesureriez à la règle, généralisée à n’importe quel nombre de dimensions. Cette notion s’ancre dans le théorème de Pythagore, qui énonce que, dans un triangle rectangle, le carré de la longueur de l’hypoténuse est égal à la somme des carrés des deux autres côtés.
« Philosopher teaching Euclidean distance. » Image by Dall-E
La formule de la distance euclidienne
Décomposons la formule de la distance euclidienne selon les dimensions :
Distance euclidienne en 2D
Dans un plan bidimensionnel, la distance euclidienne entre les points A(x₁, y₁) et B(x₂, y₂) est donnée par :
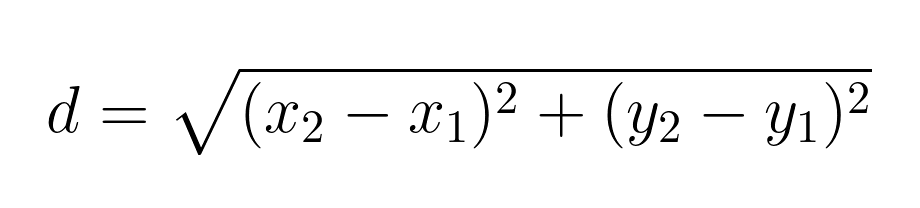
Par exemple, calculons la distance entre les points A(1, 2) et B(4, 6) :
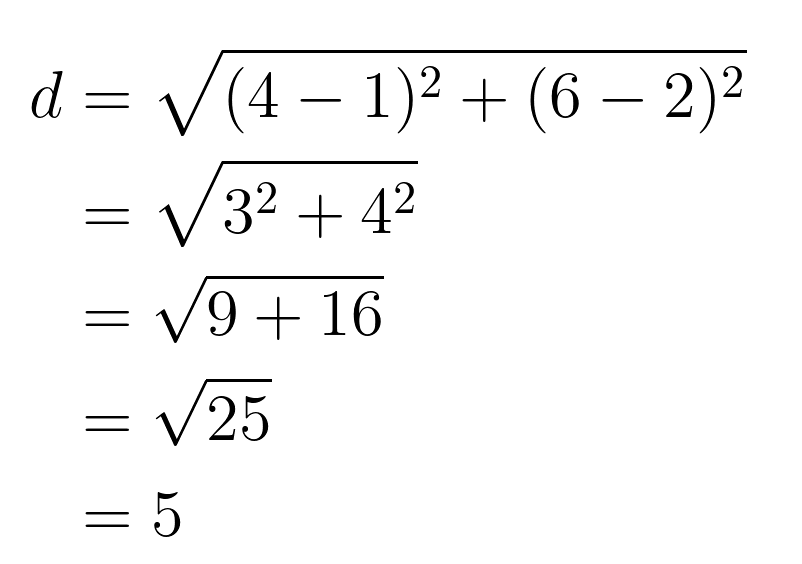
Visualisation de la distance euclidienne en 2D
Pour mieux comprendre la distance euclidienne en 2D, visualisons-la :
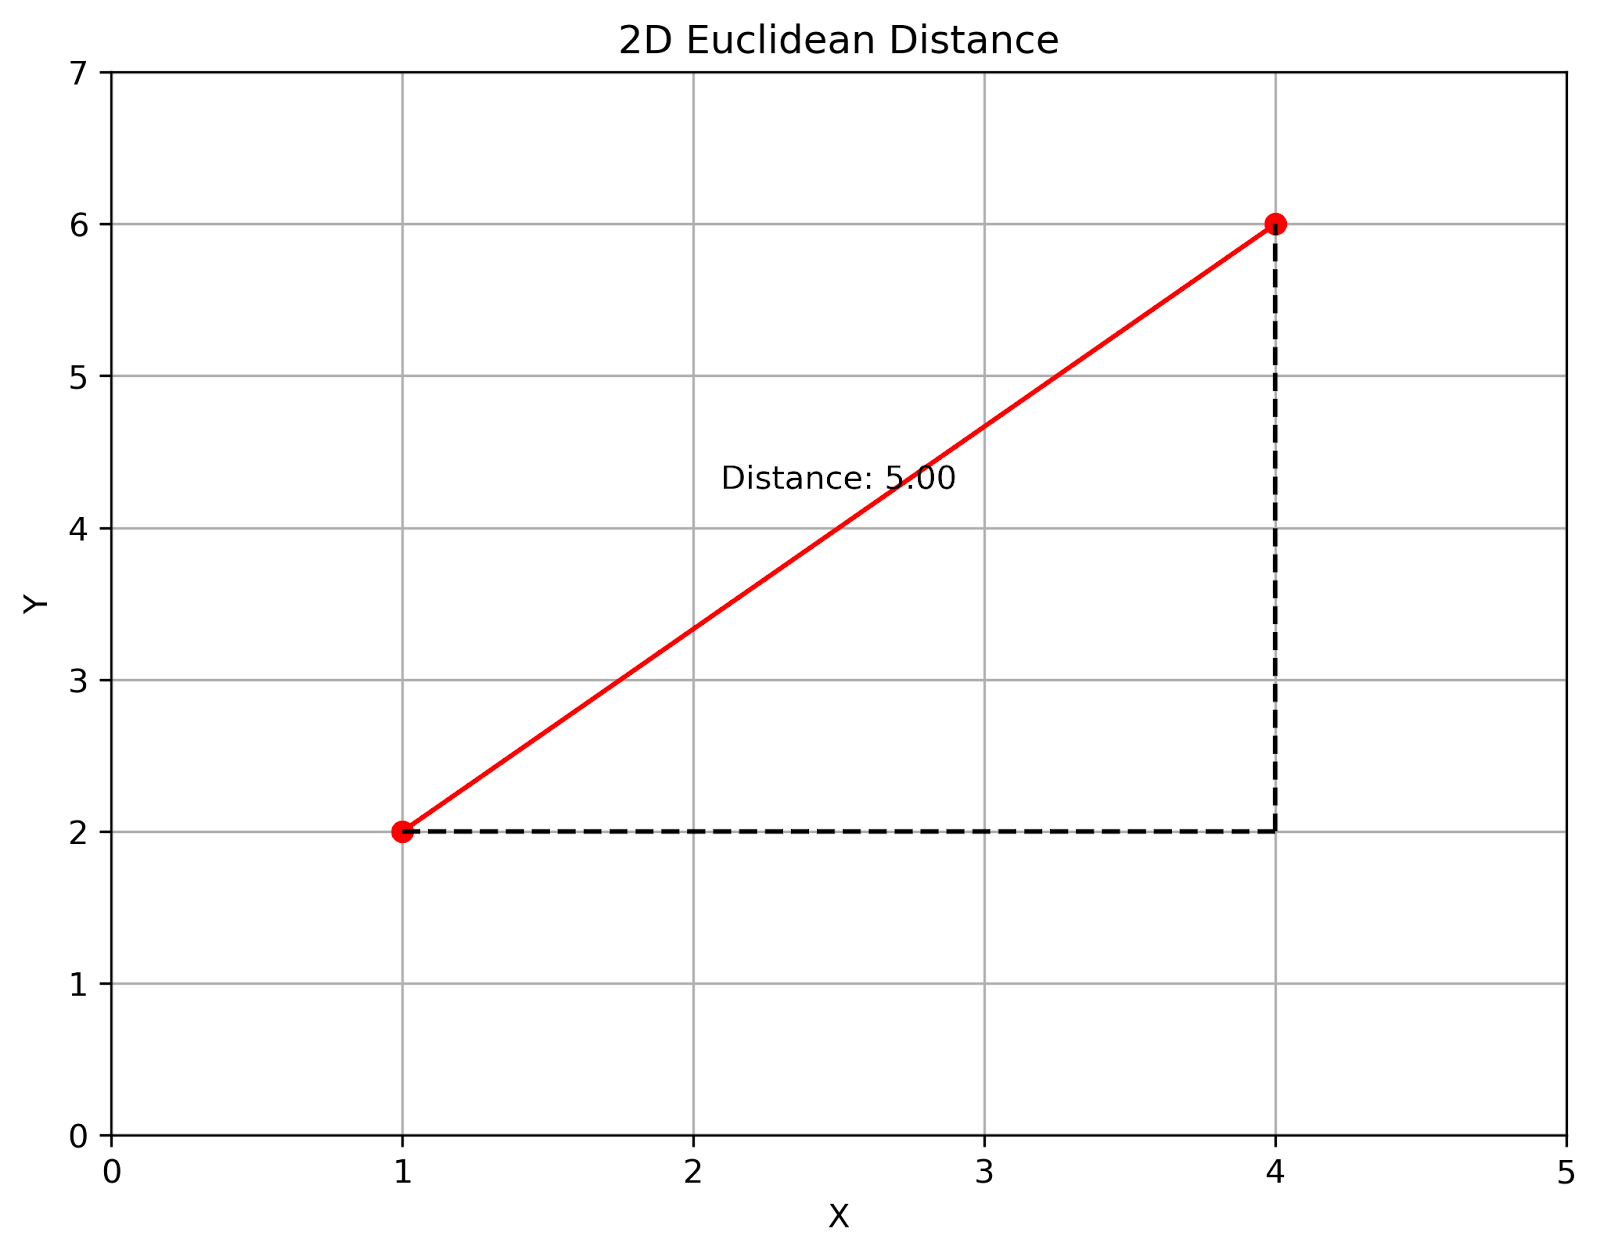
Distance euclidienne en 2D. Image by Author
Cette représentation montre la distance euclidienne entre deux points dans un plan 2D. La ligne rouge représente la distance directe, tandis que les pointillés forment un triangle rectangle, illustrant le théorème de Pythagore en action.
Distance euclidienne en 3D
En trois dimensions, pour les points A(x₁, y₁, z₁) et B(x₂, y₂, z₂), la formule devient :
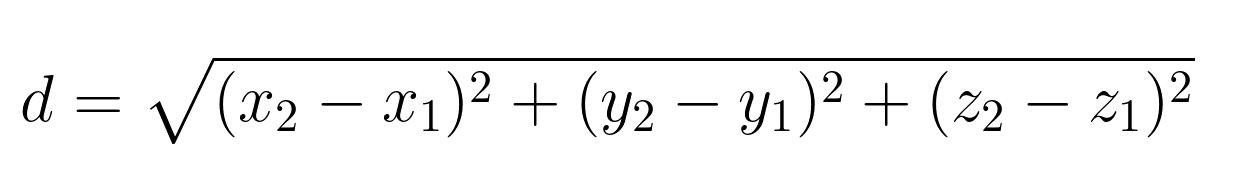
Visualisation de la distance euclidienne en 3D
Visualisons maintenant la distance euclidienne en 3D :
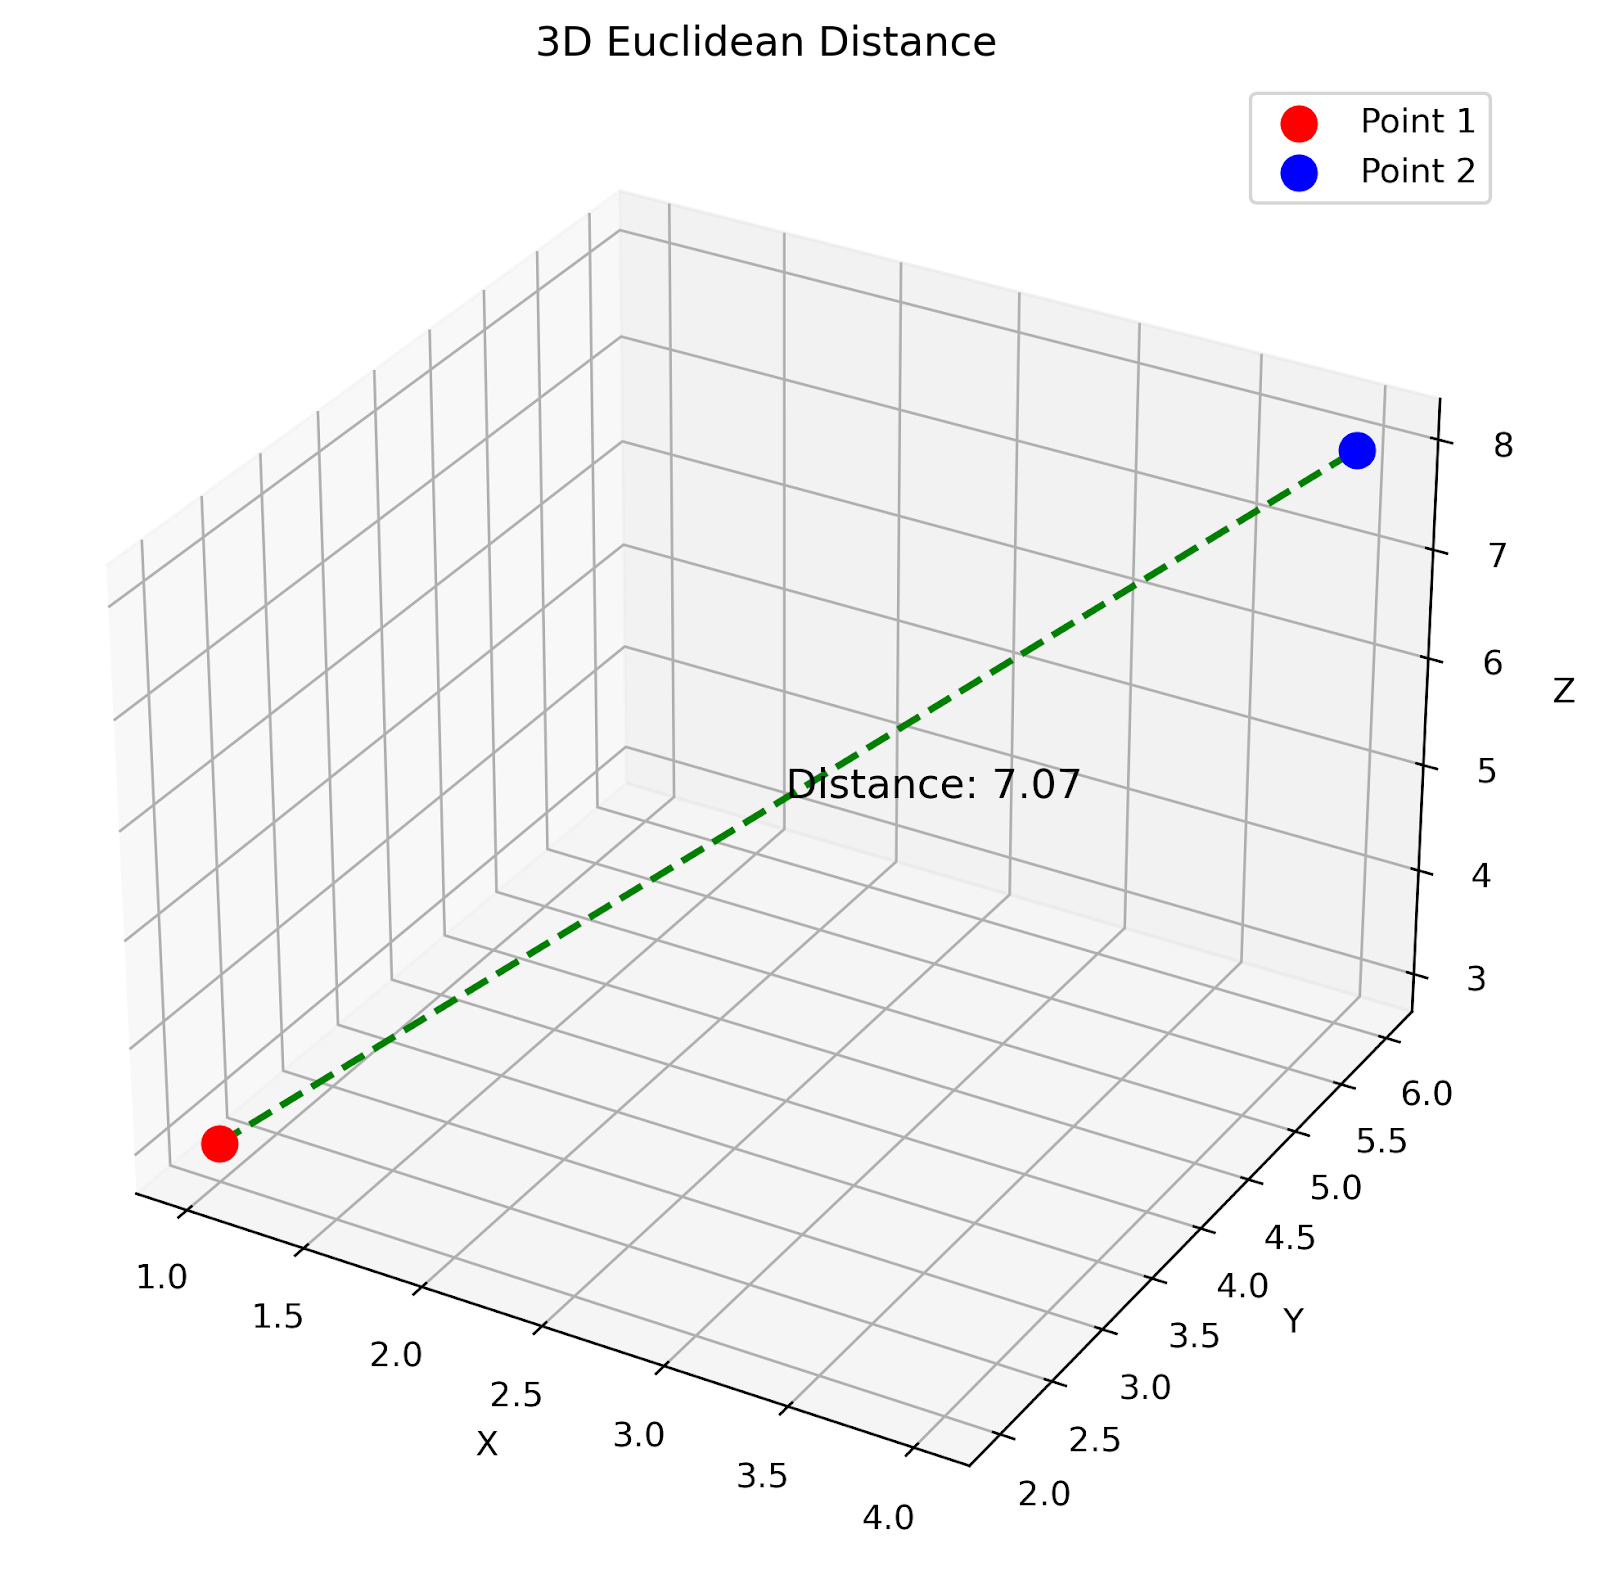
Distance euclidienne en 3D. Image by Author
Ce graphique 3D montre la distance euclidienne entre deux points dans un espace tridimensionnel. La ligne verte en pointillés représente la distance directe entre les points.
Distance euclidienne en n dimensions
Dans un espace à n dimensions, la distance euclidienne entre les points A(a₁, a₂, ..., aₙ) et B(b₁, b₂, ..., bₙ) est :
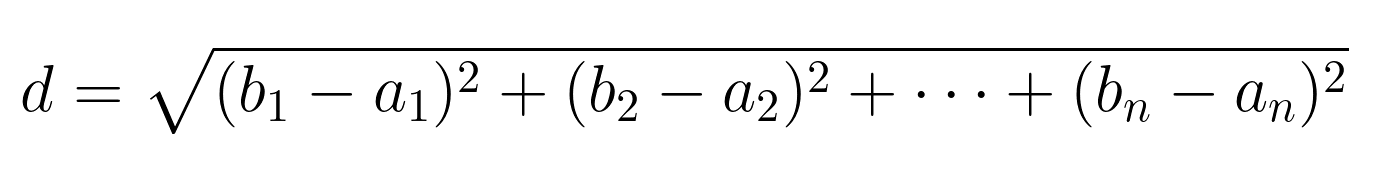
On peut l’écrire plus succinctement à l’aide de la notation sommatoire :
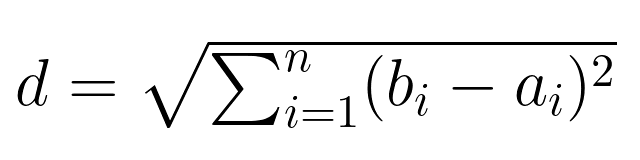
Lien avec l’algèbre linéaire
Comprendre la distance euclidienne ne se limite pas à savoir mesurer le plus court chemin entre deux points. Il s’agit aussi de l’appréhender à travers le prisme de l’algèbre linéaire, qui permet de décrire et de résoudre des problèmes d’espace et de dimensions via les vecteurs et leurs propriétés. Pour aller plus loin, explorez le cours Linear Algebra for Data Science in R, qui couvre ces notions de manière approfondie.
Distance euclidienne comme norme vectorielle
La distance euclidienne mesure à quel point deux points sont éloignés dans l’espace. Imaginez un point au départ d’un sentier de randonnée et un autre au sommet d’une colline. Le chemin en ligne droite entre le départ et le sommet correspond à la distance euclidienne. En algèbre linéaire, cela revient à trouver la longueur d’une flèche (ou vecteur) qui va directement du point de départ (point A) au sommet (point B). Cette longueur est appelée la « norme » du vecteur : c’est tout simplement la longueur de ce trajet en ligne droite.
Produit scalaire et cosinus de l’angle
Lorsqu’on s’intéresse aux directions, le produit scalaire aide à comprendre l’angle entre deux flèches. Par exemple, à l’intersection de deux routes, le produit scalaire indique dans quelle mesure une route « pointe » vers l’autre. Il se calcule à partir des longueurs de chaque route (comme les normes évoquées) et de l’angle entre elles. Plus cette valeur est proche de 0, plus les routes se rapprochent de la perpendicularité. Reliée à la distance, la formule du produit scalaire permet de décomposer la distance euclidienne en composantes plus faciles à gérer, et de voir comment les changements de direction influencent la distance totale.
Distance euclidienne et soustraction de vecteurs
Pour trouver la distance euclidienne entre deux points à l’aide des vecteurs, on soustrait l’un de l’autre pour créer un nouveau vecteur. Ce vecteur pointe directement d’un point vers l’autre, et sa longueur est précisément la distance euclidienne recherchée. C’est comme tracer un itinéraire direct sur une carte entre votre domicile et l’épicerie la plus proche : la soustraction de leurs coordonnées donne une droite (un vecteur) qui matérialise le plus court chemin.
Calculer la distance euclidienne en Python et en R
Explorons maintenant des implémentations en Python et en R. Nous verrons comment créer des fonctions personnalisées et utiliser des bibliothèques pour gagner en efficacité.
Exemple Python
En Python, nous pouvons tirer parti de NumPy pour des opérations efficaces sur les tableaux et de SciPy pour des calculs de distances spécialisés. Voici comment implémenter la distance euclidienne :
import numpy as np
from scipy.spatial.distance import euclidean
def euclidean_distance(point1, point2):
return np.sqrt(np.sum((np.array(point1) - np.array(point2))**2))
# 2D example
point_a = (1, 2)
point_b = (4, 6)
distance_2d = euclidean_distance(point_a, point_b)
print(f"2D Euclidean distance: {distance_2d:.2f}")
# 3D example
point_c = (1, 2, 3)
point_d = (4, 6, 8)
distance_3d = euclidean_distance(point_c, point_d)
print(f"3D Euclidean distance: {distance_3d:.2f}")
# Using SciPy for efficiency
distance_scipy = euclidean(point_c, point_d)
print(f"3D Euclidean distance (SciPy): {distance_scipy:.2f}")
À l’exécution, vous devriez obtenir une sortie similaire :
2D Euclidean distance: 5.00
3D Euclidean distance: 7.07
3D Euclidean distance (SciPy): 7.07
La fonction SciPy est généralement plus rapide et mieux optimisée, notamment en haute dimension, tandis que notre fonction personnalisée illustre le calcul sous-jacent.

Devenez un scientifique ML
Exemple R
R propose plusieurs façons de calculer la distance euclidienne. Nous allons créer une fonction personnalisée et la comparer à la fonction dist() de la bibliothèque stats.
euclidean_distance <- function(point1, point2) {
sqrt(sum((point1 - point2)^2))
}
# 2D example
point_a <- c(1, 2)
point_b <- c(4, 6)
distance_2d <- euclidean_distance(point_a, point_b)
print(paste("2D Euclidean distance:", round(distance_2d, 2)))
# 3D example
point_c <- c(1, 2, 3)
point_d <- c(4, 6, 8)
distance_3d <- euclidean_distance(point_c, point_d)
print(paste("3D Euclidean distance:", round(distance_3d, 2)))
# Using the dist() function from stats
distance_builtin <- stats::dist(rbind(point_c, point_d), method = "euclidean")
print(paste("3D Euclidean distance (built-in):", round(as.numeric(distance_builtin), 2)))
L’exécution de ce code R devrait produire une sortie du type :
[1] "2D Euclidean distance: 5"
[1] "3D Euclidean distance: 7.07"
[1] "3D Euclidean distance (built-in): 7.07"
Notre fonction euclidean_distance s’appuie sur les opérations vectorisées de R : concise et efficace. La fonction dist() de stats renvoie le même résultat, validant notre approche. Les deux méthodes renvoient une matrice.
Applications de la distance euclidienne
La distance euclidienne est une façon simple de mesurer l’éloignement. Elle s’emploie dans de nombreux domaines pour traiter des problèmes d’espace et de distance.
K-nearest neighbors (KNN)
Dans l’algorithme des k plus proches voisins, la distance euclidienne sert à trouver les voisins les plus proches d’un point. Cela aide à classifier de nouvelles données — par exemple déterminer si un e‑mail est un spam d’après des e‑mails similaires, ou recommander des produits proches de ceux qu’un client apprécie déjà.
K-means clustering
Dans le k-means clustering, la distance euclidienne rapproche chaque point du centre de cluster le plus proche. Elle permet ainsi d’organiser les données en groupes partageant des similarités, utile pour la segmentation client ou en recherche pour regrouper des sujets proches.
Analyse multidimensionnelle (MDS)
Le multidimensional scaling utilise la distance euclidienne pour simplifier des données complexes afin de mieux les visualiser et les interpréter. Il réduit des données riches en dimensions pour les rendre plus lisibles, ce qui facilite l’identification des tendances et des motifs.
Traitement d’images
Pour des tâches comme la détection de contours ou la reconnaissance d’objets, la distance euclidienne mesure l’écart entre couleurs de pixels, ce qui aide à délimiter des objets ou à repérer des caractéristiques clés. C’est utile, par exemple, en imagerie médicale pour identifier des pathologies, ou en sécurité pour reconnaître des visages ou des objets.
Robotique
Pour les robots, comme les drones ou les voitures autonomes, la distance euclidienne aide à calculer l’itinéraire le plus simple entre deux points. Elle permet un déplacement efficace et sûr, en évitant les obstacles et en choisissant les trajets les plus directs vers la destination.
Comparaison avec d’autres mesures de distance
La distance euclidienne est l’une des nombreuses façons de mesurer l’éloignement entre des points, mais chaque situation peut exiger une approche différente. Voici comment elle se compare à d’autres métriques courantes :
Distance de Manhattan
Également appelée distance « à blocs », la distance de Manhattan mesure la somme des différences absolues le long de chaque dimension. Imaginez marcher dans une ville en damier : la distance parcourue bloc par bloc est la distance de Manhattan. Cette méthode est particulièrement utile dans des environnements en grille, comme la navigation urbaine ou certains jeux. Elle est aussi pertinente avec des données de très grande dimension, où la distance euclidienne peut perdre en pertinence. Pour en savoir plus, consultez notre tutoriel sur la distance de Manhattan.
Distance cosinus
La distance cosinus s’intéresse à l’angle entre deux points ou vecteurs. Au lieu de se focaliser sur la longueur de la ligne qui les relie, elle considère leur orientation relative. Elle est particulièrement utile en analyse de texte ou dans les systèmes de recommandation, où la direction des données (par exemple les fréquences de mots ou les préférences utilisateurs) compte davantage que leur magnitude. Pour approfondir, voir notre article sur la distance cosinus.
Distance de Chebyshev
La distance de Chebyshev mesure l’écart maximal le long d’une dimension quelconque. C’est l’analogie du roi aux échecs : il atteint la case la plus éloignée en un nombre minimal de coups, qu’ils soient horizontaux, verticaux ou diagonaux. Cette métrique est utile lorsque vous devez considérer la plus grande des différences possibles. Pour en savoir plus, lisez notre tutoriel sur la distance de Chebyshev.
Limites de la distance euclidienne
Bien que très répandue car intuitive et simple à calculer, la distance euclidienne présente des limites notables. Les connaître aide à choisir la bonne mesure de distance ou à ajuster les données pour en atténuer les effets.
Sensibilité à l’échelle
La distance euclidienne peut être fortement influencée par l’échelle des variables. Par exemple, dans un jeu de données avec revenu et âge, le revenu varie souvent sur une plage bien plus large (par milliers ou dizaines de milliers) que l’âge (généralement jusqu’à ~100). Cette disparité peut faire dominer le revenu dans le calcul de distance et biaiser les résultats vers son échelle.
Atténuation : la normalisation ou la standardisation des données permet d’harmoniser les échelles et d’éviter qu’une variable n’influence indûment le calcul.
Malédiction de la dimensionnalité
La malédiction de la dimensionnalité recouvre divers phénomènes qui apparaissent quand le nombre de dimensions augmente. L’un d’eux est que la notion de « proximité » perd de sa pertinence : les distances tendent à se rapprocher, rendant difficile la distinction entre points proches et lointains.
Atténuation : des techniques comme l’analyse en composantes principales (ACP/PCA) ou t-distributed stochastic neighbor embedding (t‑SNE) réduisent la dimension des données en extrayant les caractéristiques essentielles à plus forte variance.
Sensibilité aux valeurs aberrantes
Les calculs de distance euclidienne sont également sensibles aux valeurs aberrantes. En haute dimension, un seul outlier peut modifier fortement les distances, donnant l’illusion de similarités ou de différences exagérées.
En réalité, la sensibilité de la régression linéaire aux outliers est liée à la distance euclidienne : le modèle minimise la somme des résidus au carré (écarts observé‑prédit), ce qui revient à mesurer la distance euclidienne entre les points observés et la droite de régression. Les grandes déviations pèsent davantage, car leur carré croît plus vite.
Atténuation : utiliser des métriques plus robustes, moins sensibles aux outliers (comme la distance de Manhattan dans certains cas). En complément, un prétraitement pour détecter et traiter les valeurs aberrantes — ajustement ou suppression — limite leur impact.
Approche alternative : la distance euclidienne pondérée assigne des poids différents aux dimensions, permettant de sous‑pondérer celles sensibles au bruit ou aux outliers.
Conclusion
Comme nous l’avons vu, la distance euclidienne est une mesure fondamentale dans de nombreux domaines analytiques et technologiques : elle offre un moyen direct de quantifier la distance en ligne droite entre des points. Bien la comprendre et l’utiliser peut améliorer la précision et l’efficacité de nombreuses applications, des algorithmes de machine learning à l’analyse spatiale.
Nous vous invitons à expérimenter la distance euclidienne dans vos projets et à approfondir le sujet avec des cours comme Designing Machine Learning Workflows in Python et Anomaly Detection in Python Course.
Devenez un scientifique ML
Vinod Chugani a débuté sa carrière à Tokyo comme plus jeune responsable du desk ventes hedge funds de JPMorgan, puis a signé un record de ventes individuel chez Lehman Brothers, avant de développer une activité de distribution d’électronique présente dans 30 pays, dépassant les 100 millions SG$ de chiffre d’affaires, puis de se tourner vers la data. Diplômé en économie de Duke et ancien élève de la NYC Data Science Academy, il a fait partie des trois lauréats de bourse sur plus de 100 candidatures pour le cours Building AI Applications de Hugo Bowne-Anderson sur Maven. Aujourd’hui, il écrit pour DataCamp, KDnuggets, Machine Learning Mastery et Statology, sur des sujets allant des statistiques à l’IA agentique, et accompagne des professionnels de la data à la NYC Data Science Academy, avec plus de 1 000 séances individuelles à son actif.
FAQ sur la distance euclidienne
Pourquoi la distance euclidienne est‑elle importante en apprentissage automatique ?
La distance euclidienne soutient de nombreux algorithmes de machine learning en quantifiant la similarité ou la différence entre des points de données, ce qui est clé pour la classification, le clustering et la détection d’anomalies.
La distance euclidienne est‑elle toujours le meilleur choix pour mesurer des distances en data science ?
Pas toujours. La meilleure métrique dépend du type de données et du problème. Par exemple, la distance de Manhattan peut être plus adaptée en très haute dimension ou lorsque des déplacements en grille sont plus représentatifs.
Comment la distance euclidienne gère‑t‑elle des coordonnées négatives ?
La distance euclidienne prend en compte les différences absolues entre coordonnées correspondantes, en traitant toutes les composantes de façon égale, qu’elles soient positives ou négatives.
Peut‑on utiliser la distance euclidienne avec des données catégorielles ?
Non. La distance euclidienne requiert généralement des entrées numériques. Pour des données catégorielles, on privilégie des méthodes comme la distance de Hamming ou d’autres mesures de similarité adaptées.
Quel est l’impact du choix de la distance euclidienne sur la performance d’algorithmes de clustering comme k‑means ?
Dans les algorithmes de clustering comme k‑means, la distance euclidienne structure directement la forme des clusters, souvent sphériques, avec la moyenne comme centre. Si les clusters naturels ne sont pas sphériques, la performance peut s’en trouver affectée.
