Of je nu student bent, een beginnende data scientist, of een professional die van carrière wil switchen: als je een ervaren data scientist wilt worden, volg je een pad. Dat is niet altijd gemakkelijk, want het data science-landschap is behoorlijk breed geworden. Daardoor bestaan er verschillende typen data science-professionals met uiteenlopende activiteiten en skillsets.
Om een mogelijke route voor data science te schetsen, geeft dit artikel een overzicht van het data science-landschap zodat je kunt zien welke rollen bij jouw ambities passen. Daarnaast krijg je aanwijzingen om in verschillende rollen binnen dat landschap te stappen of daarin te groeien, met antwoorden op vragen als: Welke skills moet je ontwikkelen en met welke methoden moet je vertrouwd raken?
Laten we beginnen met onze data science-roadmap.
Kort samengevat: een data science-roadmap
In dit artikel duiken we diep in alle onderdelen van de roadmap. Zoek je een snelle samenvatting van de opzet, bekijk die dan hieronder:
- Data science begrijpen: Begrijp de basis van data science en het brede landschap.
- Bekend raken met de projectlevenscyclus: Begin met een businessprobleem, ontwikkel voorspellende modellen en zet ze in productie, met begrip van de bijdragen van verschillende rollen (Data Analyst, Data Scientist, Machine Learning Engineer, Data Engineer, Data Architect).
- Data-analyse en visualisatie: Voer exploratieve data-analyse (EDA) uit en beheers tools voor datavisualisatie (bijv. Python’s matplotlib, R’s ggplot2, PowerBI, Tableau).
- Basis in statistiek en wiskunde: Leer beschrijvende en inferentiële statistiek en begrijp kernconcepten in de wiskunde, vooral voor machinelearningtoepassingen.
- Geavanceerde onderwerpen: machine learning en AI: Train en evalueer modellen, verdiep je in deep learning en begrijp AI-feedbackloops.
- Praktische toepassingen en projecten: Implementeer en toon projecten met publieke of eigen datasets, doe mee aan hackathons en bouw een portfolio om je expertise te laten zien.
- Carrière navigeren: Identificeer rollen die bij je skills passen, bereid je voor op relevante interviewvragen en blijf op de hoogte van trends en bronnen in de sector.
Door deze roadmap te volgen, kun je effectief door het data science-landschap navigeren, essentiële vaardigheden opbouwen en een waardevolle carrière in het vakgebied nastreven.
1. De basis van data science begrijpen
Wat is data science?
Om de context van een data science-roadmap te begrijpen, is het cruciaal een idee te hebben van wat Data Science is. We hebben een volledige gids met definities en uitleg over data science, maar voor dit artikel beschouwen we data science als het geheel aan activiteiten gericht op het oplossen van problemen met behulp van data.
Een veelvoorkomend probleem is: “Ik heb een vraag, maar weet het antwoord niet.” Als je dus een SQL-query uitvoert op een salesdatabase om te achterhalen hoeveel omzet een organisatie vorige maand heeft gedraaid, dan ben je een data scientist!
Vaak zijn problemen/oplossingen complexer en is er een diversere skillset nodig. Om deze brede waaier aan data science-rollen en -skills in deze roadmap te bespreken, gebruiken we een data science-projectlevenscyclus als kapstok. Zo kunnen we de verschillende activiteiten en rollen in kaart brengen en hebben we een basis om het data science-landschap uit te tekenen.
2. Vertrouwd raken met de projectlevenscyclus van data science
Data science-projecten beginnen meestal met een businessvraag of -probleem. Een probleem triggert een initiatie-fase, waarin mogelijke oplossingen worden gedefinieerd en de eerste haalbaarheid wordt beoordeeld. Er wordt initiële data verzameld of een exploratieve data-analyse op beschikbare data gedaan om te zien wat wel en niet mogelijk is. Is de data rijk genoeg? Bevat deze voldoende features?
Initiatie en verkenning
Als alle lichten op groen staan, beginnen we met het ontwikkelen van een voorspellend model. Het model gebruikt input om uitkomsten te voorspellen. In eerste instantie kan dit een one-shotmodel zijn, getraind, getest en gevalideerd met k-fold cross-validatie (een machinelearningtechniek om in te schatten hoe goed een model zal presteren op onzichtbare data). Dit is typisch werk voor de klassieke data scientist. Zodra het model goed genoeg presteert, is het tijd om het te productionizen en in een pipeline binnen de bestaande infrastructuur te plaatsen, waar performance wordt gemonitord en het model indien nodig wordt hertraind.
Elke fase vereist andere skills. Tijdens de initiatie-fase heb je businessgevoel nodig, plus bekendheid met datatransformatie, opschonen, beschrijvende statistiek en basis inferentiële statistiek. Dit werk kan gedaan worden door een data-analist en/of een data scientist.
Modelontwikkeling en productionizen
In de modelleringsfase moeten voorspellende modellen worden gebouwd. Eenvoudige modellen, zoals regressies, kunnen door een data-analist worden gebouwd, maar zodra het complexer wordt heb je een data scientist nodig om een model te bouwen op basis van een bestaand algoritme, of zelfs een machine learning engineer om algoritmen aan te passen of nieuwe te creëren.
Bij het deployen en productionizen van het model kom je in het domein van de machine learning engineer of de data engineer. In tegenstelling tot de eerdere fases is er niet per se een nauwe link met de business; de taak draait erom een pipeline rond het voorspellende model te bouwen en te monitoren om betrouwbare output aan de juiste doelsystemen te leveren.
Gedurende het hele proces moet alle data op de juiste plekken met de juiste metainformatie beschikbaar zijn — dat is de rol van de data-architect. Wanneer nieuwe data wordt ingeladen of bestaande data wordt getransformeerd naar nieuwe informatie, zorgen zij er eveneens voor dat de data op de juiste plek terechtkomt.
Rolintegratie en crossfunctionele samenwerking
Hoe de verschillende rollen bijdragen in de verschillende fases van de levenscyclus is geïllustreerd in de afbeelding hieronder. Omdat rollen in verschillende stadia bijdragen, hebben ze andere skills nodig.
Rollen aan het begin van de levenscyclus vragen meer businessgevoel en minder engineering, terwijl latere fases minder businessgevoel en meer engineering en algoritme-optimalisatie vereisen. Ter illustratie: als data scientist kun je wegkomen met suboptimale rekencapaciteit om de waarde en performance van je model te tonen. Maar zodra je verantwoordelijk bent voor het productionizen van modellen, moet je de computationele complexiteit kunnen optimaliseren om te zorgen dat je pipeline (kosten)efficiënt is.
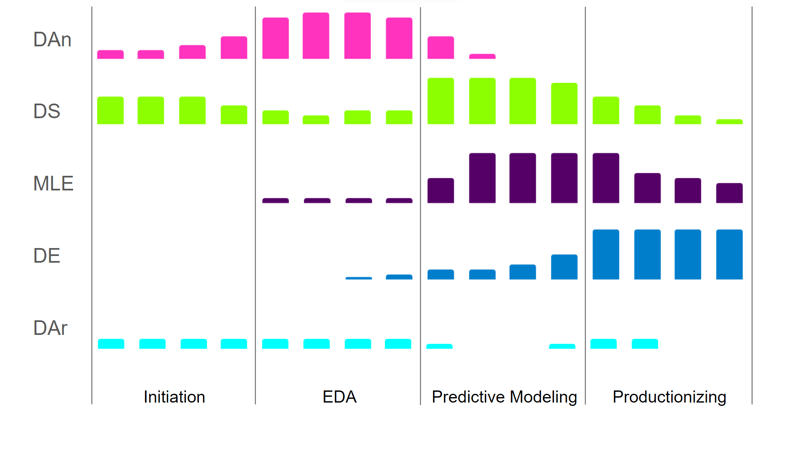
De mate van bijdrage van de verschillende data science-rollen gedurende een data science-project (DAn - Data Analyst, DS - Data Scientist, MLE - Machine Learning Engineer, DE - Data Engineer, DAr - Data Architect - Afbeelding door de auteur
Belangrijk om te weten: de grenzen tussen rollen zijn niet strikt. Veel data scientists denken al na over de juiste bron-/doelsystemen en rekenefficiëntie en houden daar in hun code rekening mee. Een machine learning engineer kan inzien dat bepaalde featuregeneratie-aanpakken de modelperformance verbeteren. Een data-analist kan goed advies geven over waar in de datacatalogus de gegenereerde features voor de data-architect moeten worden opgeslagen. Met andere woorden: alle rollen zouden tot op zekere hoogte op de hoogte moeten zijn van elkaars werk, maar hoeven elkaars verantwoordelijkheden niet diepgaand te begrijpen.
Qua skills en tools is er een duidelijke basis. Ongeacht waar je in de levenscyclus van een data science-project bijdraagt, heb je basisbegrip nodig van wiskunde en statistiek, collaboratieve softwareontwikkeling en datamanipulatie. In grote lijnen bestaat het begin van elke data science-roadmap uit:
- Datamanipulatie (denk aan Extract-Transform-Load-werk, zoals geleerd in SQL, Python of R),
- (Statistische) data-analyse (zoals geleerd in beschrijvende en enige correlatiestatistiek),
- Machine learning (zoals geleerd in supervised learning in Python of R), en
- Versiebeheer voor collaboratieve software-engineering (zoals geleerd in Git).
Er zijn verschillende soorten data science-rollen met verschillende skillvereisten: een Data Analyst heeft diepere SQL-kennis nodig dan een Data Engineer. Een Data Scientist moet Machine Learning beter kennen dan een Data Architect. Hier splitst de roadmap zich dus: afhankelijk van waar je ambities in het data science-landschap liggen, moet je verschillende skills leren. De volgende secties beschrijven de verschillende takken in de roadmap waar je aan kunt denken.
3. Dieper duiken in data-analyse en visualisatie
Exploratieve data-analyse (EDA)
Ongeacht hoever je op de roadmap bent — doorgewinterde rot of absolute beginner — alle data science-projecten beginnen met je data begrijpen.
Een grondig begrip van je data is cruciaal om de haalbaarheid van je project te beoordelen. Je start met basisvragen als ‘welke variabelen heb ik?’ en ‘hoeveel observaties heb ik?’ en eindigt met complexere vragen als ‘wat zijn de relaties tussen variabelen?’
Vaak kunnen de resultaten van een EDA op zichzelf al het antwoord zijn op de vragen van je stakeholder. Wanneer je ze goed visualiseert en samenhangend presenteert, bijvoorbeeld in een dashboard, kunnen de uitkomsten van een eenvoudige data-analyse worden gebruikt om complexe vragen te beantwoorden. Dit vereist echter wel de skill datavisualisatie.
Maar zelfs door in je EDA te laten zien dat er bijvoorbeeld verschillende segmenten websitebezoekers bestaan, lever je op de manier van een data scientist waarde.
Er zijn meerdere manieren om je uitkomsten te visualiseren. Ofwel in visualisatiebibliotheken/pakketten in de taal die je gebruikt (zoals ggplot2 in R en matplotlib in Python), of in speciale tools voor datavisualisatie (zoals PowerBI, Tableau of zelfs Excel)
Meesterschap in datavisualisatie
Zeker als we ons meer richten op de taken van een Data Analyst, helpt een dieper begrip van datavisualisatie.
Voor de meeste data science-rollen kunnen visualisaties dienen om aannames te checken via scatterplots en histogrammen, maar wanneer de analyse zelf het eindproduct is — zoals bij een Data Analyst — kom je in situaties waarin je wilt dat de uitkomsten van de analyse prettig te verwerken zijn.
Denk aan eigen huisstijlen, nieuwe visualisaties of infographics als input voor een besluitvormend orgaan. In die situaties helpt het als je een datavisualisatie kunt maken die praktisch een kunstwerk is. Understanding Data Visualization is een cursus die je dataviz-competenties echt verdiept.
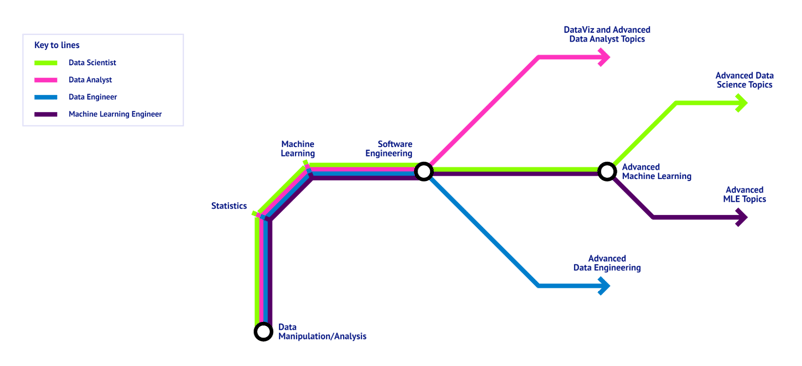
Een data science-roadmap, gevisualiseerd als metromap, met de basis die alle data science-rollen gemeen hebben en de skills die specifiek zijn voor de verschillende rollen. - Afbeelding door de auteur
4. Een basis bouwen in statistiek en wiskunde
Beschrijvende en inferentiële statistiek
Een van de eerste haltes op een data science-roadmap is statistiek. Een aantal basisconcepten in statistiek moeten voor elke soort data scientist vanzelfsprekend zijn.
Je moet altijd je data en subgroepen in je data kunnen beschrijven. Wat is het gemiddelde inkomen in je dataset? Wat zijn het minimum en maximum? Wat is de standaarddeviatie, of wat zijn andere spreidingsmaten? En als je categorische waarden hebt: hoeveel unieke waarden zijn er? Welke komt het meest voor? Komen alle waarden even vaak voor, of is de verdeling minder uniform?
Vragen beantwoorden met beschrijvende analyses over groepen/subgroepen kan al waardevolle inzichten opleveren, maar vaak moet je kijken naar de relatie tussen variabelen in je dataset en richting inferentiële statistiek gaan.
Het uitdagende en interessante deel van inferentiële statistiek zijn de verschillende typen categorische en numerieke waarden en de relaties daartussen. Voorbeelden zijn:
- Correlaties; de relatie tussen numerieke waarden, zoals “hoe hangen leeftijd en inkomen samen?”.
- De relatie tussen categorisch en numeriek om de vraag te onderzoeken: “Hoe verhoudt het inkomen zich voor mannen en vrouwen?” (met gender als categorische input en inkomen als numerieke target),
- Of andersom: “Zijn oudere mensen vaker gescheiden?” (met leeftijd als numerieke input en gescheiden als categorische target).
- Relaties tussen categorische variabelen: “Zijn mannen vaker gescheiden dan vrouwen?”
Om deze vragen te beantwoorden, moet je de verschillende soorten statistische toetsen kennen, van de eenvoudigste t-toets tot complexere methoden zoals multivariate lineaire regressies of tijdreeksanalyse.
Je kunt relevante cursussen volgen om je statistische begrip te verdiepen in: Python, R en zelfs toolonafhankelijk. Deze cursussen bieden een degelijke basis om met machine learning te gaan werken. Door statistisch de relatie tussen voorspellers en targetvariabelen te begrijpen, begrijp je de principes van de algoritmen die worden gebruikt om supervised learning-modellen te maken.
Hoe diep je hierin duikt, hangt opnieuw af van waar je op de data science-roadmap naartoe wilt. Als je Data Analyst wilt worden, kan begrip van de basisstatistiek volstaan. Data-architecten hebben mogelijk helemaal geen statistische kennis nodig. Maar data scientists en machine learning engineers komen zeker situaties tegen waarin ze op hun statistische expertise moeten vertrouwen.
Wiskundige concepten voor data science
Data science draait om getallen en berekeningen en dus speelt wiskunde een grote rol. Een gevorderde wiskundeopleiding is geen vereiste halte op de roadmap, maar inzicht in algebra en calculus helpt je conceptueel een aantal methoden te begrijpen die vaak in data science worden gebruikt. De meeste dimensionaliteitsreductie-methoden (zoals PCA en matrixfactorisatie) leunen op lineaire algebra, en veel optimalisatiealgoritmen (zoals gradient descent) op calculus.
Net als bij statistiek en data-analyse is deze kennis niet per se relevant voor alle data science-rollen. Als je machine learning engineer wilt worden, kun je niet om wiskunde heen. Maar de meeste andere rollen — zelfs een data scientist — kunnen vaak uit de voeten zonder diepgaande kennis van algebra en calculus.
Wil je meer leren over en inzicht krijgen in algebraïsche concepten, bekijk dan onze cursus Linear Algebra for Data Science in R
5. Geavanceerde onderwerpen verkennen: machine learning en AI
Introductie in machine learning
Machine learning is de kunst om software te maken die leert van data. Het is het dagelijks brood voor data scientists, machine learning engineers en zelfs data engineers. Het deel van je oplossing dat de verwachte omzet voor je bedrijf geeft op basis van je voorraad en prijzen? Dat is gebouwd met machine learning!
De minimale kennis die je als data scientist nodig hebt, is dat je modellen kunt trainen en evalueren. In sommige situaties wil je dieper gaan en leren hoe je bestaande algoritmen aanpast of zelfs nieuwe schrijft — dan betreed je het domein van de machine learning engineer.
Je hebt veel vrijheid in hoe je je machine learning doet. Je kunt alles zelf coderen (in Python, R, of C# of Java, met relevante libraries), je kunt lokale softwarepakketten gebruiken (zoals Weka en RapidMiner), of je kunt cloudoplossingen gebruiken (zoals Databricks en AWS SageMaker). Dat maakt het lastig om te kiezen wat je moet leren, maar je opgebouwde expertise is redelijk overdraagbaar. Een goed idee om te beslissen met welke toolkit je start, is óf uit te gaan van een taal die je al kent, óf te kijken welke tools worden gebruikt in de industrie die jou interesseert.
Je kunt beginnen met onze Machine Learning Scientist with Python-carrièretrack, die veel van de basis behandelt die je nodig hebt om te starten.
De diepte in met deep learning en AI
De relatie tussen machine learning, deep learning en AI is onderwerp van discussie.
Toen ik machine learning gaf, begon mijn eerste college altijd met een levendig debat over de stelling: “Machine learning is een vorm van AI.” Hoewel de termen soms door elkaar worden gebruikt, geloof ik sterk dat machine learning AI mogelijk maakt, maar dat je niet per se AI creëert als je machine learning gebruikt.
Voor een data-applicatie om AI te zijn, is een feedbackloop essentieel waarin de applicatie of het model leert van zijn output. In dat geval is een one-shot supervised learning-algoritme niet per se AI. Als je de output van het model terugkoppelt naar het model (zoals bij reinforcement learning), dán krijg je AI, omdat je een systeem hebt dat automatisch blijft leren van correcte en foute voorspellingen.
Deep learning is niet veel meer dan neurale netwerken op steroïden. Wat de toepassingen interessant maakt, is dat deep learning heel tastbare uitkomsten mogelijk maakt, omdat deze modellen tekst, beelden en spraak kunnen genereren. Werk je aan een project waar het essentieel is dat modellen iets opleveren dat door eindgebruikers kan worden waargenomen of ervaren, dan is begrip van deep learning echt een voordeel. Een goede start is de cursus Introduction to Deep Learning in Python.
6. Praktische toepassingen en real-world projecten
Data science-projecten implementeren
Geen enkele data science-inspanning staat op zichzelf. Terwijl je vordert, is het belangrijk om de artefacten die je maakt te bewaren en te tonen. Een deel van data scientist zijn is kunnen laten zien wat je kunt.
Het mooiste aan data science vind ik dat je niet veel nodig hebt. Je hebt alleen een publieke dataset en wat creativiteit nodig om met een interessante vraag te komen en die vervolgens met data te beantwoorden. Of je stapt op DataLab of Kaggle en begint aan opdrachten en/of wedstrijden, waarbij je inspiratie opdoet uit andere inzendingen.
Je kunt ook je eigen data verzamelen en gebruiken. Ik heb mijn wielrendata van Strava geanalyseerd en vastgoeddata gescrapet om me te helpen bij mijn zoektocht op de woningmarkt.
Het belangrijkste is dat je documenteert wat je doet. Probeer je werk reproduceerbaar te maken, leg de stappen uit die je nam, deel je code en deel de output van je analyse of systeem. Wie weet is jouw oefenproject precies de oplossing voor iemands probleem.
Voorbeeldprojecten
De interessantste projecten komen wat mij betreft voort uit je eigen passie en interesses. Als je een dataset gebruikt uit een domein dat je goed kent, is de kans groot dat je met unieke en interessante vragen komt. Je kent het domein en je kent de data... Maar als je echt vanaf nul begint, zijn er genoeg onderwerpen om mee te starten, zoals datingapps, trading, sport.
Je vindt ook een enorme variëteit aan data science-projecten op DataCamp, waarmee je vertrouwd raakt met het soort werk. Of je nu begint met data-analyticsprojecten of werkt aan specifieke Python-projecten, je kunt toewerken naar machine learning en zelfs AI-projecten. Er zijn genoeg opties om te beginnen.
Als je ondanks alles geen startpunt kunt vinden, kan deelnemen aan hackathons een goed alternatief zijn. Veel onderzoeksinstituten en grote bedrijven organiseren periodieke hackathons.
Deze hackathons hebben vaak als doel dat teams van data scientists meedenken over een relevant probleem en bieden daarmee de kans om samen te werken met en te leren van andere professionals. Zo kun je een netwerk opbouwen en opvallen bij potentiële werkgevers, terwijl je waardevolle ervaring opdoet.
Portfolio opbouwen
Tegenwoordig is een data scientist zonder GitHub, DataCamp-portfolio of een Medium-pagina of blog met code nauwelijks voor te stellen. Een portfolio is cruciaal in data science, net als in andere creatieve sectoren.
Het kunnen tonen van eerdere projecten is een geweldige manier om mensen te overtuigen dat je het in je hebt. Daarom loont het om je werk te documenteren in een portfolio. Je kunt je werk en inzichten ook vastleggen in blogposts of zelfs als academische publicaties. Bekijk onze post over je data-expertise tonen met een portfolio voor inspiratie.
Wat je ook kiest, zorg voor een representatief overzicht van de projecten waaraan je hebt gewerkt.
7. Navigeren door het data science-carrièrelandschap
Carrièremogelijkheden in data science
Deze hele post heeft de verschillende skills, kennis en tools belicht die een data scientist tot zijn beschikking heeft. Maar waar begin je bij het kiezen van een carrière?
Volgens mij hangt dit echt af van je ambities. Uit dit stuk zou duidelijk moeten zijn dat ik niet geloof in één universele data science-roadmap.
Natuurlijk bouwen alle data science-rollen op een basis van statistiek, datamanipulatie, machine learning en software-engineering. Maar verder: het hangt ervan af.
Een data scientist gebruikt algoritmen, terwijl een machine learning engineer algoritmen aanpast of creëert. De data scientist kan dus volstaan met het kennen van veel algoritmen en wanneer je ze toepast, terwijl de machine learning engineer de wiskundige concepten achter de algoritmen echt moet begrijpen.
Evenzo: als je energie krijgt van het delen van analyse-uitkomsten, zoals bij een data scientist of data-analist, profiteer je waarschijnlijk meer van grondige kennis van datavisualisatie en EDA dan van heel sterk zijn in datamodellering.
De data science-roadmap kent dus de nodige vertakkingen en je kunt zelf beslissen hoe diep je in de verschillende takken gaat.
Voorbereiden op data science-sollicitaties
Ondanks de verschillen tussen rollen word je in elk interview getest op hard en soft skills. Die tests verschillen per rol waar je voor gaat.
Als je niet solliciteert naar een rol als machine learning- of data engineer, krijg je waarschijnlijk geen vragen als “Hoe zou je algoritme A of B optimaliseren?”. Focus dus op de skills — en dus vragen — waar je in die rol mee te maken krijgt en mee aan de slag wilt. Krijg je vragen over onderwerpen die je niet kent, dan kan dat een teken zijn dat de rol niet bij je past.
Zeker in dit relatief nieuwe vakgebied — vooral bij bedrijven waar data nog relatief nieuw is — bestaan er veel misvattingen over wat data scientists zijn of doen.
Ik heb zelf gesolliciteerd op een data scientist-rol waarbij de interviewer data scientist en machine learning engineer door elkaar gebruikte. Het is dus goed mogelijk dat de hiring manager zich vergist heeft als je vragen krijgt die je niet kunt beantwoorden. Een data engineer zou bijvoorbeeld zelden gevraagd moeten worden hoe die stakeholdermanagement in een project zou doen.
Gelukkig zijn er verschillende bronnen om je voor te bereiden op interviews in het vakgebied, afhankelijk van de rol waarop je solliciteert:
8. Blijven leren: bijblijven en een leven lang ontwikkelen
Op de hoogte blijven van trends
Het gebied van data science is zeer dynamisch en het is cruciaal om bij te blijven met de nieuwste trends. Met ChatGPT werd Generative AI mainstream en het is nu lastig je een data scientist voor te stellen die geen idee heeft van token-embeddings en/of attention-modellen. Evenzo maakt de introductie van MLOps het moeilijk voor te stellen dat een data engineer handmatig modelperformance en drift checkt.
Met deze dynamische groei worden verschillende aspecten van AI belangrijk. Op dit moment gaat veel aandacht uit naar de ethische en juridische kanten van AI, zoals blijkt uit diverse academische en politieke debatten die onder meer hebben geleid tot nieuwe regels en regelgeving.
Ongeacht wat overheden besluiten rond AI, niemand wil verantwoordelijk zijn voor het volgende dataschandaal. De enige manier om dit te voorkomen is bewust te blijven van ethische en juridische grenzen. Of beter nog: draag als data science-professional bij aan deze ontwikkelingen door je achtergrond te gebruiken en een mening te vormen en te delen.
Er zijn veel manieren om up-to-date te blijven. Natuurlijk is er DataCamp als platform, maar je kunt ook op zoek gaan naar inspirerende data science-practitioners in jouw veld. Kijk of ze blogs, X- of Medium-posts hebben, of iets anders waarmee je een inkijkje krijgt in hoe zij het veranderende en dynamische landschap zien.
Geavanceerde leerbronnen
Zoals we in dit artikel hebben benadrukt, zijn er veel bronnen voor iedereen die wil starten of doorgroeien in data science. Wil je echt dicht bij de bron zitten, kijk dan naar technische conferenties zoals NeurIPS, ICML of KDD. Bekijk deze en meer in onze lijst met de Top data science-conferenties voor 2026.
Conclusie en volgende stappen
Hoewel er veel haltes zijn op de data science-roadmap, is er niet één enkel pad. Navigeren door het data science-landschap vraagt dat je 1) een idee hebt van het landschap (wat je hopelijk uit deze post haalt) en 2) een beeld hebt van je sterke en zwakke punten en interesses, zodat je kunt beslissen wat je wilt nastreven.
Als je dat hebt, kun je dit artikel gebruiken om je de juiste richting op te sturen en te bepalen op welke skills je tijdens je training de nadruk legt. Gelukkig zijn er handige bronnen om je op weg te helpen, zoals de carrièretracks van DataCamp, die je uitrusten met de skills die je nodig hebt om verschillende beroepen te verkennen:


Of je nu student bent, een beginnende data scientist, of een professional die van carrière wil switchen: als je een ervaren data scientist wilt worden, volg je een pad. Dat is niet altijd gemakkelijk, want het data science-landschap is behoorlijk breed geworden. Daardoor bestaan er verschillende typen data science-professionals met uiteenlopende activiteiten en skillsets.
Om een mogelijke route voor data science te schetsen, geeft dit artikel een overzicht van het data science-landschap zodat je kunt zien welke rollen bij jouw ambities passen. Daarnaast krijg je aanwijzingen om in verschillende rollen binnen dat landschap te stappen of daarin te groeien, met antwoorden op vragen als: Welke skills moet je ontwikkelen en met welke methoden moet je vertrouwd raken?
Laten we beginnen met onze data science-roadmap.
Kort samengevat: een data science-roadmap
In dit artikel duiken we diep in alle onderdelen van de roadmap. Zoek je een snelle samenvatting van de opzet, bekijk die dan hieronder:
Door deze roadmap te volgen, kun je effectief door het data science-landschap navigeren, essentiële vaardigheden opbouwen en een waardevolle carrière in het vakgebied nastreven.
1. De basis van data science begrijpen
Wat is data science?
Om de context van een data science-roadmap te begrijpen, is het cruciaal een idee te hebben van wat Data Science is. We hebben een volledige gids met definities en uitleg over data science, maar voor dit artikel beschouwen we data science als het geheel aan activiteiten gericht op het oplossen van problemen met behulp van data.
Een veelvoorkomend probleem is: “Ik heb een vraag, maar weet het antwoord niet.” Als je dus een SQL-query uitvoert op een salesdatabase om te achterhalen hoeveel omzet een organisatie vorige maand heeft gedraaid, dan ben je een data scientist!
Vaak zijn problemen/oplossingen complexer en is er een diversere skillset nodig. Om deze brede waaier aan data science-rollen en -skills in deze roadmap te bespreken, gebruiken we een data science-projectlevenscyclus als kapstok. Zo kunnen we de verschillende activiteiten en rollen in kaart brengen en hebben we een basis om het data science-landschap uit te tekenen.
2. Vertrouwd raken met de projectlevenscyclus van data science
Data science-projecten beginnen meestal met een businessvraag of -probleem. Een probleem triggert een initiatie-fase, waarin mogelijke oplossingen worden gedefinieerd en de eerste haalbaarheid wordt beoordeeld. Er wordt initiële data verzameld of een exploratieve data-analyse op beschikbare data gedaan om te zien wat wel en niet mogelijk is. Is de data rijk genoeg? Bevat deze voldoende features?
Initiatie en verkenning
Als alle lichten op groen staan, beginnen we met het ontwikkelen van een voorspellend model. Het model gebruikt input om uitkomsten te voorspellen. In eerste instantie kan dit een one-shotmodel zijn, getraind, getest en gevalideerd met k-fold cross-validatie (een machinelearningtechniek om in te schatten hoe goed een model zal presteren op onzichtbare data). Dit is typisch werk voor de klassieke data scientist. Zodra het model goed genoeg presteert, is het tijd om het te productionizen en in een pipeline binnen de bestaande infrastructuur te plaatsen, waar performance wordt gemonitord en het model indien nodig wordt hertraind.
Elke fase vereist andere skills. Tijdens de initiatie-fase heb je businessgevoel nodig, plus bekendheid met datatransformatie, opschonen, beschrijvende statistiek en basis inferentiële statistiek. Dit werk kan gedaan worden door een data-analist en/of een data scientist.
Modelontwikkeling en productionizen
In de modelleringsfase moeten voorspellende modellen worden gebouwd. Eenvoudige modellen, zoals regressies, kunnen door een data-analist worden gebouwd, maar zodra het complexer wordt heb je een data scientist nodig om een model te bouwen op basis van een bestaand algoritme, of zelfs een machine learning engineer om algoritmen aan te passen of nieuwe te creëren.
Bij het deployen en productionizen van het model kom je in het domein van de machine learning engineer of de data engineer. In tegenstelling tot de eerdere fases is er niet per se een nauwe link met de business; de taak draait erom een pipeline rond het voorspellende model te bouwen en te monitoren om betrouwbare output aan de juiste doelsystemen te leveren.
Gedurende het hele proces moet alle data op de juiste plekken met de juiste metainformatie beschikbaar zijn — dat is de rol van de data-architect. Wanneer nieuwe data wordt ingeladen of bestaande data wordt getransformeerd naar nieuwe informatie, zorgen zij er eveneens voor dat de data op de juiste plek terechtkomt.
Rolintegratie en crossfunctionele samenwerking
Hoe de verschillende rollen bijdragen in de verschillende fases van de levenscyclus is geïllustreerd in de afbeelding hieronder. Omdat rollen in verschillende stadia bijdragen, hebben ze andere skills nodig.
Rollen aan het begin van de levenscyclus vragen meer businessgevoel en minder engineering, terwijl latere fases minder businessgevoel en meer engineering en algoritme-optimalisatie vereisen. Ter illustratie: als data scientist kun je wegkomen met suboptimale rekencapaciteit om de waarde en performance van je model te tonen. Maar zodra je verantwoordelijk bent voor het productionizen van modellen, moet je de computationele complexiteit kunnen optimaliseren om te zorgen dat je pipeline (kosten)efficiënt is.
De mate van bijdrage van de verschillende data science-rollen gedurende een data science-project (DAn - Data Analyst, DS - Data Scientist, MLE - Machine Learning Engineer, DE - Data Engineer, DAr - Data Architect - Afbeelding door de auteur
Belangrijk om te weten: de grenzen tussen rollen zijn niet strikt. Veel data scientists denken al na over de juiste bron-/doelsystemen en rekenefficiëntie en houden daar in hun code rekening mee. Een machine learning engineer kan inzien dat bepaalde featuregeneratie-aanpakken de modelperformance verbeteren. Een data-analist kan goed advies geven over waar in de datacatalogus de gegenereerde features voor de data-architect moeten worden opgeslagen. Met andere woorden: alle rollen zouden tot op zekere hoogte op de hoogte moeten zijn van elkaars werk, maar hoeven elkaars verantwoordelijkheden niet diepgaand te begrijpen.
Essentiële skills en tools
Qua skills en tools is er een duidelijke basis. Ongeacht waar je in de levenscyclus van een data science-project bijdraagt, heb je basisbegrip nodig van wiskunde en statistiek, collaboratieve softwareontwikkeling en datamanipulatie. In grote lijnen bestaat het begin van elke data science-roadmap uit:
Er zijn verschillende soorten data science-rollen met verschillende skillvereisten: een Data Analyst heeft diepere SQL-kennis nodig dan een Data Engineer. Een Data Scientist moet Machine Learning beter kennen dan een Data Architect. Hier splitst de roadmap zich dus: afhankelijk van waar je ambities in het data science-landschap liggen, moet je verschillende skills leren. De volgende secties beschrijven de verschillende takken in de roadmap waar je aan kunt denken.
3. Dieper duiken in data-analyse en visualisatie
Exploratieve data-analyse (EDA)
Ongeacht hoever je op de roadmap bent — doorgewinterde rot of absolute beginner — alle data science-projecten beginnen met je data begrijpen.
Een grondig begrip van je data is cruciaal om de haalbaarheid van je project te beoordelen. Je start met basisvragen als ‘welke variabelen heb ik?’ en ‘hoeveel observaties heb ik?’ en eindigt met complexere vragen als ‘wat zijn de relaties tussen variabelen?’
Vaak kunnen de resultaten van een EDA op zichzelf al het antwoord zijn op de vragen van je stakeholder. Wanneer je ze goed visualiseert en samenhangend presenteert, bijvoorbeeld in een dashboard, kunnen de uitkomsten van een eenvoudige data-analyse worden gebruikt om complexe vragen te beantwoorden. Dit vereist echter wel de skill datavisualisatie.
Maar zelfs door in je EDA te laten zien dat er bijvoorbeeld verschillende segmenten websitebezoekers bestaan, lever je op de manier van een data scientist waarde.
Er zijn meerdere manieren om je uitkomsten te visualiseren. Ofwel in visualisatiebibliotheken/pakketten in de taal die je gebruikt (zoals ggplot2 in R en matplotlib in Python), of in speciale tools voor datavisualisatie (zoals PowerBI, Tableau of zelfs Excel)
Meesterschap in datavisualisatie
Zeker als we ons meer richten op de taken van een Data Analyst, helpt een dieper begrip van datavisualisatie.
Voor de meeste data science-rollen kunnen visualisaties dienen om aannames te checken via scatterplots en histogrammen, maar wanneer de analyse zelf het eindproduct is — zoals bij een Data Analyst — kom je in situaties waarin je wilt dat de uitkomsten van de analyse prettig te verwerken zijn.
Denk aan eigen huisstijlen, nieuwe visualisaties of infographics als input voor een besluitvormend orgaan. In die situaties helpt het als je een datavisualisatie kunt maken die praktisch een kunstwerk is. Understanding Data Visualization is een cursus die je dataviz-competenties echt verdiept.
Een data science-roadmap, gevisualiseerd als metromap, met de basis die alle data science-rollen gemeen hebben en de skills die specifiek zijn voor de verschillende rollen. - Afbeelding door de auteur
4. Een basis bouwen in statistiek en wiskunde
Beschrijvende en inferentiële statistiek
Een van de eerste haltes op een data science-roadmap is statistiek. Een aantal basisconcepten in statistiek moeten voor elke soort data scientist vanzelfsprekend zijn.
Je moet altijd je data en subgroepen in je data kunnen beschrijven. Wat is het gemiddelde inkomen in je dataset? Wat zijn het minimum en maximum? Wat is de standaarddeviatie, of wat zijn andere spreidingsmaten? En als je categorische waarden hebt: hoeveel unieke waarden zijn er? Welke komt het meest voor? Komen alle waarden even vaak voor, of is de verdeling minder uniform?
Vragen beantwoorden met beschrijvende analyses over groepen/subgroepen kan al waardevolle inzichten opleveren, maar vaak moet je kijken naar de relatie tussen variabelen in je dataset en richting inferentiële statistiek gaan.
Het uitdagende en interessante deel van inferentiële statistiek zijn de verschillende typen categorische en numerieke waarden en de relaties daartussen. Voorbeelden zijn:
Om deze vragen te beantwoorden, moet je de verschillende soorten statistische toetsen kennen, van de eenvoudigste t-toets tot complexere methoden zoals multivariate lineaire regressies of tijdreeksanalyse.
Je kunt relevante cursussen volgen om je statistische begrip te verdiepen in: Python, R en zelfs toolonafhankelijk. Deze cursussen bieden een degelijke basis om met machine learning te gaan werken. Door statistisch de relatie tussen voorspellers en targetvariabelen te begrijpen, begrijp je de principes van de algoritmen die worden gebruikt om supervised learning-modellen te maken.
Hoe diep je hierin duikt, hangt opnieuw af van waar je op de data science-roadmap naartoe wilt. Als je Data Analyst wilt worden, kan begrip van de basisstatistiek volstaan. Data-architecten hebben mogelijk helemaal geen statistische kennis nodig. Maar data scientists en machine learning engineers komen zeker situaties tegen waarin ze op hun statistische expertise moeten vertrouwen.
Wiskundige concepten voor data science
Data science draait om getallen en berekeningen en dus speelt wiskunde een grote rol. Een gevorderde wiskundeopleiding is geen vereiste halte op de roadmap, maar inzicht in algebra en calculus helpt je conceptueel een aantal methoden te begrijpen die vaak in data science worden gebruikt. De meeste dimensionaliteitsreductie-methoden (zoals PCA en matrixfactorisatie) leunen op lineaire algebra, en veel optimalisatiealgoritmen (zoals gradient descent) op calculus.
Net als bij statistiek en data-analyse is deze kennis niet per se relevant voor alle data science-rollen. Als je machine learning engineer wilt worden, kun je niet om wiskunde heen. Maar de meeste andere rollen — zelfs een data scientist — kunnen vaak uit de voeten zonder diepgaande kennis van algebra en calculus.
Wil je meer leren over en inzicht krijgen in algebraïsche concepten, bekijk dan onze cursus Linear Algebra for Data Science in R
5. Geavanceerde onderwerpen verkennen: machine learning en AI
Introductie in machine learning
Machine learning is de kunst om software te maken die leert van data. Het is het dagelijks brood voor data scientists, machine learning engineers en zelfs data engineers. Het deel van je oplossing dat de verwachte omzet voor je bedrijf geeft op basis van je voorraad en prijzen? Dat is gebouwd met machine learning!
De minimale kennis die je als data scientist nodig hebt, is dat je modellen kunt trainen en evalueren. In sommige situaties wil je dieper gaan en leren hoe je bestaande algoritmen aanpast of zelfs nieuwe schrijft — dan betreed je het domein van de machine learning engineer.
Je hebt veel vrijheid in hoe je je machine learning doet. Je kunt alles zelf coderen (in Python, R, of C# of Java, met relevante libraries), je kunt lokale softwarepakketten gebruiken (zoals Weka en RapidMiner), of je kunt cloudoplossingen gebruiken (zoals Databricks en AWS SageMaker). Dat maakt het lastig om te kiezen wat je moet leren, maar je opgebouwde expertise is redelijk overdraagbaar. Een goed idee om te beslissen met welke toolkit je start, is óf uit te gaan van een taal die je al kent, óf te kijken welke tools worden gebruikt in de industrie die jou interesseert.
Je kunt beginnen met onze Machine Learning Scientist with Python-carrièretrack, die veel van de basis behandelt die je nodig hebt om te starten.
De diepte in met deep learning en AI
De relatie tussen machine learning, deep learning en AI is onderwerp van discussie.
Toen ik machine learning gaf, begon mijn eerste college altijd met een levendig debat over de stelling: “Machine learning is een vorm van AI.” Hoewel de termen soms door elkaar worden gebruikt, geloof ik sterk dat machine learning AI mogelijk maakt, maar dat je niet per se AI creëert als je machine learning gebruikt.
Voor een data-applicatie om AI te zijn, is een feedbackloop essentieel waarin de applicatie of het model leert van zijn output. In dat geval is een one-shot supervised learning-algoritme niet per se AI. Als je de output van het model terugkoppelt naar het model (zoals bij reinforcement learning), dán krijg je AI, omdat je een systeem hebt dat automatisch blijft leren van correcte en foute voorspellingen.
Deep learning is niet veel meer dan neurale netwerken op steroïden. Wat de toepassingen interessant maakt, is dat deep learning heel tastbare uitkomsten mogelijk maakt, omdat deze modellen tekst, beelden en spraak kunnen genereren. Werk je aan een project waar het essentieel is dat modellen iets opleveren dat door eindgebruikers kan worden waargenomen of ervaren, dan is begrip van deep learning echt een voordeel. Een goede start is de cursus Introduction to Deep Learning in Python.
6. Praktische toepassingen en real-world projecten
Data science-projecten implementeren
Geen enkele data science-inspanning staat op zichzelf. Terwijl je vordert, is het belangrijk om de artefacten die je maakt te bewaren en te tonen. Een deel van data scientist zijn is kunnen laten zien wat je kunt.
Het mooiste aan data science vind ik dat je niet veel nodig hebt. Je hebt alleen een publieke dataset en wat creativiteit nodig om met een interessante vraag te komen en die vervolgens met data te beantwoorden. Of je stapt op DataLab of Kaggle en begint aan opdrachten en/of wedstrijden, waarbij je inspiratie opdoet uit andere inzendingen.
Je kunt ook je eigen data verzamelen en gebruiken. Ik heb mijn wielrendata van Strava geanalyseerd en vastgoeddata gescrapet om me te helpen bij mijn zoektocht op de woningmarkt.
Het belangrijkste is dat je documenteert wat je doet. Probeer je werk reproduceerbaar te maken, leg de stappen uit die je nam, deel je code en deel de output van je analyse of systeem. Wie weet is jouw oefenproject precies de oplossing voor iemands probleem.
Voorbeeldprojecten
De interessantste projecten komen wat mij betreft voort uit je eigen passie en interesses. Als je een dataset gebruikt uit een domein dat je goed kent, is de kans groot dat je met unieke en interessante vragen komt. Je kent het domein en je kent de data... Maar als je echt vanaf nul begint, zijn er genoeg onderwerpen om mee te starten, zoals datingapps, trading, sport.
Je vindt ook een enorme variëteit aan data science-projecten op DataCamp, waarmee je vertrouwd raakt met het soort werk. Of je nu begint met data-analyticsprojecten of werkt aan specifieke Python-projecten, je kunt toewerken naar machine learning en zelfs AI-projecten. Er zijn genoeg opties om te beginnen.
Als je ondanks alles geen startpunt kunt vinden, kan deelnemen aan hackathons een goed alternatief zijn. Veel onderzoeksinstituten en grote bedrijven organiseren periodieke hackathons.
Deze hackathons hebben vaak als doel dat teams van data scientists meedenken over een relevant probleem en bieden daarmee de kans om samen te werken met en te leren van andere professionals. Zo kun je een netwerk opbouwen en opvallen bij potentiële werkgevers, terwijl je waardevolle ervaring opdoet.
Portfolio opbouwen
Tegenwoordig is een data scientist zonder GitHub, DataCamp-portfolio of een Medium-pagina of blog met code nauwelijks voor te stellen. Een portfolio is cruciaal in data science, net als in andere creatieve sectoren.
Het kunnen tonen van eerdere projecten is een geweldige manier om mensen te overtuigen dat je het in je hebt. Daarom loont het om je werk te documenteren in een portfolio. Je kunt je werk en inzichten ook vastleggen in blogposts of zelfs als academische publicaties. Bekijk onze post over je data-expertise tonen met een portfolio voor inspiratie.
Wat je ook kiest, zorg voor een representatief overzicht van de projecten waaraan je hebt gewerkt.
7. Navigeren door het data science-carrièrelandschap
Carrièremogelijkheden in data science
Deze hele post heeft de verschillende skills, kennis en tools belicht die een data scientist tot zijn beschikking heeft. Maar waar begin je bij het kiezen van een carrière?
Volgens mij hangt dit echt af van je ambities. Uit dit stuk zou duidelijk moeten zijn dat ik niet geloof in één universele data science-roadmap.
Natuurlijk bouwen alle data science-rollen op een basis van statistiek, datamanipulatie, machine learning en software-engineering. Maar verder: het hangt ervan af.
Een data scientist gebruikt algoritmen, terwijl een machine learning engineer algoritmen aanpast of creëert. De data scientist kan dus volstaan met het kennen van veel algoritmen en wanneer je ze toepast, terwijl de machine learning engineer de wiskundige concepten achter de algoritmen echt moet begrijpen.
Evenzo: als je energie krijgt van het delen van analyse-uitkomsten, zoals bij een data scientist of data-analist, profiteer je waarschijnlijk meer van grondige kennis van datavisualisatie en EDA dan van heel sterk zijn in datamodellering.
De data science-roadmap kent dus de nodige vertakkingen en je kunt zelf beslissen hoe diep je in de verschillende takken gaat.
Voorbereiden op data science-sollicitaties
Ondanks de verschillen tussen rollen word je in elk interview getest op hard en soft skills. Die tests verschillen per rol waar je voor gaat.
Als je niet solliciteert naar een rol als machine learning- of data engineer, krijg je waarschijnlijk geen vragen als “Hoe zou je algoritme A of B optimaliseren?”. Focus dus op de skills — en dus vragen — waar je in die rol mee te maken krijgt en mee aan de slag wilt. Krijg je vragen over onderwerpen die je niet kent, dan kan dat een teken zijn dat de rol niet bij je past.
Zeker in dit relatief nieuwe vakgebied — vooral bij bedrijven waar data nog relatief nieuw is — bestaan er veel misvattingen over wat data scientists zijn of doen.
Ik heb zelf gesolliciteerd op een data scientist-rol waarbij de interviewer data scientist en machine learning engineer door elkaar gebruikte. Het is dus goed mogelijk dat de hiring manager zich vergist heeft als je vragen krijgt die je niet kunt beantwoorden. Een data engineer zou bijvoorbeeld zelden gevraagd moeten worden hoe die stakeholdermanagement in een project zou doen.
Gelukkig zijn er verschillende bronnen om je voor te bereiden op interviews in het vakgebied, afhankelijk van de rol waarop je solliciteert:
8. Blijven leren: bijblijven en een leven lang ontwikkelen
Op de hoogte blijven van trends
Het gebied van data science is zeer dynamisch en het is cruciaal om bij te blijven met de nieuwste trends. Met ChatGPT werd Generative AI mainstream en het is nu lastig je een data scientist voor te stellen die geen idee heeft van token-embeddings en/of attention-modellen. Evenzo maakt de introductie van MLOps het moeilijk voor te stellen dat een data engineer handmatig modelperformance en drift checkt.
Met deze dynamische groei worden verschillende aspecten van AI belangrijk. Op dit moment gaat veel aandacht uit naar de ethische en juridische kanten van AI, zoals blijkt uit diverse academische en politieke debatten die onder meer hebben geleid tot nieuwe regels en regelgeving.
Ongeacht wat overheden besluiten rond AI, niemand wil verantwoordelijk zijn voor het volgende dataschandaal. De enige manier om dit te voorkomen is bewust te blijven van ethische en juridische grenzen. Of beter nog: draag als data science-professional bij aan deze ontwikkelingen door je achtergrond te gebruiken en een mening te vormen en te delen.
Er zijn veel manieren om up-to-date te blijven. Natuurlijk is er DataCamp als platform, maar je kunt ook op zoek gaan naar inspirerende data science-practitioners in jouw veld. Kijk of ze blogs, X- of Medium-posts hebben, of iets anders waarmee je een inkijkje krijgt in hoe zij het veranderende en dynamische landschap zien.
Geavanceerde leerbronnen
Zoals we in dit artikel hebben benadrukt, zijn er veel bronnen voor iedereen die wil starten of doorgroeien in data science. Wil je echt dicht bij de bron zitten, kijk dan naar technische conferenties zoals NeurIPS, ICML of KDD. Bekijk deze en meer in onze lijst met de Top data science-conferenties voor 2026.
Conclusie en volgende stappen
Hoewel er veel haltes zijn op de data science-roadmap, is er niet één enkel pad. Navigeren door het data science-landschap vraagt dat je 1) een idee hebt van het landschap (wat je hopelijk uit deze post haalt) en 2) een beeld hebt van je sterke en zwakke punten en interesses, zodat je kunt beslissen wat je wilt nastreven.
Als je dat hebt, kun je dit artikel gebruiken om je de juiste richting op te sturen en te bepalen op welke skills je tijdens je training de nadruk legt. Gelukkig zijn er handige bronnen om je op weg te helpen, zoals de carrièretracks van DataCamp, die je uitrusten met de skills die je nodig hebt om verschillende beroepen te verkennen: