Dù bạn là sinh viên, một nhà khoa học dữ liệu tương lai, hay một chuyên gia đang muốn chuyển hướng nghề nghiệp, nếu muốn trở thành một nhà khoa học dữ liệu dày dạn kinh nghiệm, bạn cần đi theo một lộ trình. Điều này không phải lúc nào cũng dễ dàng, vì bức tranh khoa học dữ liệu đã trở nên khá rộng và do đó xuất hiện những kiểu chuyên gia khác nhau với các hoạt động và bộ kỹ năng khác nhau.
Để phác thảo một lộ trình khoa học dữ liệu, bài viết này cung cấp cái nhìn tổng quan về toàn cảnh lĩnh vực, giúp bạn xem vai trò nào phù hợp với tham vọng của mình. Ngoài ra, bài viết còn gợi ý cách chuyển sang hoặc phát triển theo các vai trò khác nhau trong hệ sinh thái đó, trả lời những câu hỏi như: Bạn nên phát triển kỹ năng gì và nên làm quen với những phương pháp nào?
Hãy bắt đầu với lộ trình khoa học dữ liệu của chúng ta.
Tóm tắt: Lộ trình Khoa học Dữ liệu
Trong bài viết này, chúng tôi đi sâu vào mọi khía cạnh của lộ trình. Tuy nhiên, nếu bạn muốn xem nhanh phần dàn ý, hãy tham khảo bên dưới:
- Hiểu về Khoa học Dữ liệu: Nắm bắt các nguyên lý cơ bản và bức tranh tổng thể của lĩnh vực.
- Quen thuộc với Vòng đời Dự án: Bắt đầu từ bài toán kinh doanh, phát triển mô hình dự đoán và triển khai vào sản xuất, hiểu đóng góp của các vai trò khác nhau (Data Analyst, Data Scientist, Machine Learning Engineer, Data Engineer, Data Architect).
- Phân tích và Trực quan hóa Dữ liệu: Thực hiện EDA (phân tích khám phá dữ liệu) và thành thạo các công cụ trực quan hóa (ví dụ: matplotlib của Python, ggplot2 của R, PowerBI, Tableau).
- Nền tảng Thống kê và Toán học: Học thống kê mô tả và suy luận, hiểu các khái niệm toán học trọng yếu, đặc biệt cho ứng dụng học máy.
- Chủ đề Nâng cao: Machine Learning và AI: Huấn luyện và đánh giá mô hình, đào sâu học sâu, và hiểu vòng phản hồi trong AI.
- Ứng dụng Thực tiễn và Dự án: Triển khai và giới thiệu các dự án dùng dữ liệu công khai hoặc cá nhân, tham gia hackathon, và xây dựng danh mục để chứng minh chuyên môn.
- Định hướng Nghề nghiệp: Xác định vai trò phù hợp với kỹ năng của bạn, chuẩn bị cho các câu hỏi phỏng vấn liên quan, và luôn cập nhật xu hướng, nguồn lực trong ngành.
Bằng cách đi theo lộ trình này, bạn có thể định hướng hiệu quả trong lĩnh vực khoa học dữ liệu, xây dựng các kỹ năng cốt lõi, và theo đuổi một sự nghiệp xứng đáng.
1. Nắm vững Những điều Cơ bản của Khoa học Dữ liệu
Khoa học dữ liệu là gì?
Để hiểu ngữ cảnh của một lộ trình khoa học dữ liệu, điều cốt yếu là phải có khái niệm về Khoa học Dữ liệu. Chúng tôi có một hướng dẫn đầy đủ bao quát các định nghĩa và giải thích về khoa học dữ liệu, nhưng trong phạm vi bài viết này, chúng ta coi khoa học dữ liệu là tập hợp các hoạt động nhằm giải quyết vấn đề bằng dữ liệu.
Một vấn đề thường gặp là “Tôi có câu hỏi nhưng không biết câu trả lời”, vì vậy nếu bạn chạy một truy vấn SQL trên cơ sở dữ liệu bán hàng để tìm xem tổ chức kiếm được bao nhiêu doanh thu tháng trước, thì bạn đang làm công việc của một nhà khoa học dữ liệu!
Thường thì vấn đề/giải pháp phức tạp hơn và đòi hỏi bộ kỹ năng đa dạng hơn. Để có thể bàn luận về dải vai trò và kỹ năng rộng này xuyên suốt lộ trình, chúng ta sẽ dùng vòng đời dự án khoa học dữ liệu như một cấu trúc khái quát. Cách này cho phép chúng ta ánh xạ các hoạt động và vai trò khác nhau, làm nền tảng để phác thảo toàn cảnh lĩnh vực.
2. Làm quen với Vòng đời Dự án Khoa học Dữ liệu
Các dự án khoa học dữ liệu phần lớn bắt đầu từ một câu hỏi hay vấn đề kinh doanh. Vấn đề kích hoạt giai đoạn khởi động, trong đó xác định tập các giải pháp khả dĩ và đánh giá tính khả thi ban đầu. Thu thập dữ liệu sơ bộ hoặc phân tích khám phá dữ liệu hiện có được thực hiện để xem điều gì có thể và điều gì không. Dữ liệu có đủ phong phú không? Có đủ đặc trưng không?
Khởi động và khám phá
Khi mọi điều kiện đều thuận lợi, chúng ta bắt đầu phát triển mô hình dự đoán. Mô hình sẽ dùng đầu vào để dự đoán đầu ra. Ban đầu, đó có thể chỉ là một mô hình chạy một lần, được huấn luyện, kiểm thử và thẩm định trên tập cross-validation k-fold (một kỹ thuật học máy để đánh giá khả năng mô hình hoạt động trên dữ liệu chưa thấy). Đây là công việc thường do nhà khoa học dữ liệu “cổ điển” đảm trách. Khi mô hình đạt hiệu năng đủ tốt, đã đến lúc đưa vào sản xuất và đặt trong pipeline của hạ tầng hiện có, nơi hiệu năng sẽ được giám sát và mô hình được huấn luyện lại khi cần.
Mỗi giai đoạn đòi hỏi các kỹ năng khác nhau. Trong giai đoạn khởi động, cần có hiểu biết kinh doanh, quen thuộc với biến đổi dữ liệu, làm sạch, thống kê mô tả và một số thống kê suy luận cơ bản. Đây là công việc mà một nhà phân tích dữ liệu và/hoặc nhà khoa học dữ liệu có thể thực hiện.
Phát triển mô hình và đưa vào sản xuất
Trong giai đoạn mô hình hóa, cần xây dựng các mô hình dự đoán. Những mô hình đơn giản như hồi quy có thể do nhà phân tích dữ liệu xây dựng, nhưng nếu trở nên phức tạp hơn, bạn sẽ cần nhà khoa học dữ liệu để xây mô hình dùng thuật toán hiện có, hoặc thậm chí kỹ sư học máy để điều chỉnh hay tạo thuật toán mới.
Khi triển khai và đưa mô hình vào sản xuất, bạn bước vào phạm vi của kỹ sư học máy hoặc kỹ sư dữ liệu. Khác với các giai đoạn trước, không nhất thiết gắn chặt với kinh doanh; nhiệm vụ xoay quanh việc tạo và giám sát một pipeline bao quanh mô hình dự đoán nhằm cung cấp đầu ra tin cậy cho các hệ thống đích phù hợp.
Xuyên suốt quá trình, toàn bộ dữ liệu cần có mặt đúng nơi với siêu dữ liệu phù hợp, đó là vai trò của kiến trúc sư dữ liệu. Khi dữ liệu mới được nạp vào hoặc dữ liệu hiện có được chuyển hóa thành thông tin mới, họ cũng đảm bảo dữ liệu đến đúng chỗ.
Tích hợp vai trò và hợp tác liên chức năng
Cách các vai trò khác nhau đóng góp qua các giai đoạn của vòng đời được minh họa trong hình dưới. Vì các vai trò tham gia ở các giai đoạn khác nhau, nên họ cần những kỹ năng khác nhau.
Các vai trò ở giai đoạn đầu vòng đời đòi hỏi hiểu biết kinh doanh nhiều hơn và ít thiên về kỹ thuật, trong khi các giai đoạn sau cần ít hiểu biết kinh doanh hơn nhưng nhiều kỹ thuật và tối ưu thuật toán hơn. Ví dụ, là một nhà khoa học dữ liệu, bạn có thể chấp nhận hiệu năng tính toán chưa tối ưu để chứng minh giá trị và hiệu quả của mô hình. Nhưng một khi bạn chịu trách nhiệm đưa mô hình vào sản xuất, bạn phải tối ưu độ phức tạp tính toán để đảm bảo pipeline hiệu quả (và tiết kiệm chi phí).
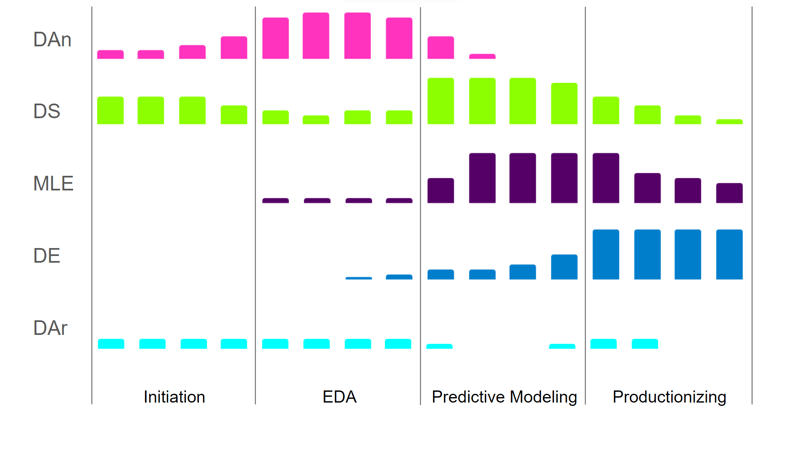
Mức độ đóng góp của các vai trò Khoa học Dữ liệu khác nhau trong suốt một Dự án (DAn - Data Analyst, DS - Data Scientist, MLE - Machine Learning Engineer, DE - Data Engineer, DAr - Data Architect - Ảnh: Tác giả
Điều quan trọng là ranh giới giữa các vai trò không cứng nhắc. Nhiều nhà khoa học dữ liệu đã nghĩ đến hệ thống nguồn/đích phù hợp và hiệu quả tính toán, và cân nhắc những điều đó trong mã của họ. Một kỹ sư học máy có thể nhận ra rằng các cách tạo đặc trưng nhất định có thể cải thiện hiệu năng mô hình. Một nhà phân tích dữ liệu có thể đưa ra lời khuyên hay về nơi trong danh mục dữ liệu nên lưu trữ các đặc trưng được tạo cho kiến trúc sư dữ liệu. Nói cách khác, ở mức độ nào đó, mọi vai trò đều nên nhận biết công việc của vai trò khác, nhưng không nhất thiết phải hiểu sâu trách nhiệm của nhau.
Kỹ năng và công cụ thiết yếu
Về các kỹ năng và công cụ bạn cần, có một nền tảng rõ ràng. Bất kể bạn đóng góp ở đâu trong vòng đời dự án, bạn sẽ cần hiểu cơ bản về toán và thống kê, phát triển phần mềm cộng tác, và thao tác dữ liệu. Nhìn chung, phần mở đầu của bất kỳ lộ trình khoa học dữ liệu nào gồm có:
Có nhiều kiểu vai trò khoa học dữ liệu với yêu cầu kỹ năng khác nhau: Nhà phân tích dữ liệu sẽ cần hiểu SQL sâu hơn Kỹ sư dữ liệu. Nhà khoa học dữ liệu cần biết Học máy tốt hơn Kiến trúc sư dữ liệu. Đây là điểm lộ trình tách nhánh: tùy theo hoài bão của bạn trong lĩnh vực này, bạn sẽ cần học các kỹ năng khác nhau. Các phần tiếp theo sẽ mô tả những nhánh mà bạn có thể cân nhắc.
3. Đi sâu vào Phân tích và Trực quan hóa Dữ liệu
Phân tích khám phá dữ liệu (EDA)
Bất kể bạn đã đi được bao xa trên lộ trình, dù là người dày dạn hay mới bắt đầu, mọi dự án đều khởi đầu bằng việc hiểu dữ liệu của bạn.
Hiểu thấu dữ liệu là chìa khóa để đánh giá tính khả thi của dự án. Bắt đầu bằng các câu hỏi cơ bản như ‘mình có những biến nào?’ và ‘mình có bao nhiêu quan sát?’ rồi tiến đến những câu hỏi phức tạp hơn như ‘mối quan hệ giữa các biến là gì?’
Rất thường xuyên, kết quả của EDA tự nó đã là câu trả lời cho câu hỏi của các bên liên quan. Khi được trực quan hóa đúng cách và trình bày mạch lạc, ví dụ qua một bảng điều khiển, kết quả của một phân tích dữ liệu đơn giản có thể dùng để trả lời câu hỏi phức tạp. Tuy nhiên, điều này phụ thuộc vào kỹ năng trực quan hóa dữ liệu.
Chỉ cần thông qua EDA cho thấy, chẳng hạn, tồn tại các phân khúc khác nhau của khách truy cập website, là bạn đã tạo giá trị theo cách của một nhà khoa học dữ liệu.
Có nhiều cách để trực quan hóa kết quả. Có thể dùng thư viện/gói trực quan trong ngôn ngữ bạn dùng (như ggplot2 của R và matplotlib của Python) hoặc các công cụ chuyên dụng (như PowerBI, Tableau, hoặc thậm chí Excel)
Làm chủ Trực quan hóa Dữ liệu
Đặc biệt khi tập trung nhiều hơn vào nhiệm vụ của Nhà phân tích dữ liệu, hiểu sâu về trực quan hóa dữ liệu rất hữu ích.
Với hầu hết vai trò khoa học dữ liệu, biểu đồ có thể dùng để kiểm tra giả định qua biểu đồ phân tán và histogram, nhưng khi bản thân phân tích là sản phẩm bàn giao, như với Nhà phân tích dữ liệu, bạn sẽ gặp những tình huống muốn khiến kết quả phân tích trở nên “dễ nuốt”.
Hãy nghĩ đến phong cách thương hiệu tùy biến, biểu đồ mới, hoặc infographic làm đầu vào cho đơn vị ra quyết định. Trong những tình huống đó, khả năng tạo trực quan hóa dữ liệu gần như mang tính nghệ thuật là một lợi thế. Khóa học Understanding Data Visualization sẽ giúp bạn đào sâu năng lực dataviz.
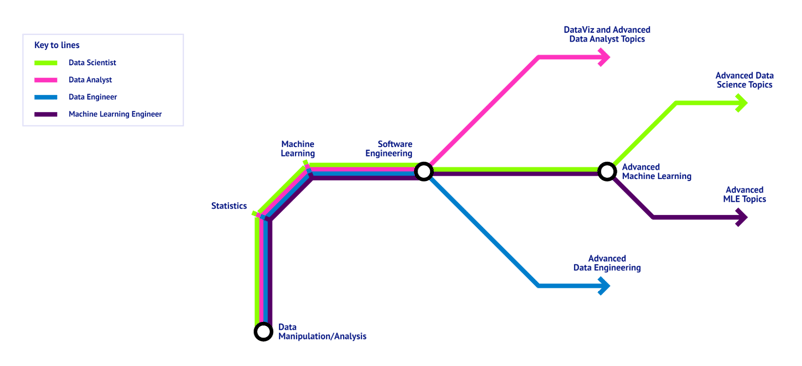
Lộ trình Khoa học Dữ liệu, minh họa như bản đồ metro, cho thấy nền tảng chung của mọi vai trò và các kỹ năng đặc thù cho từng vai trò. - Ảnh: Tác giả
4. Xây nền tảng Thống kê và Toán học
Thống kê mô tả và suy luận
Một trong những điểm dừng đầu tiên trên lộ trình là thống kê. Một số khái niệm thống kê cơ bản nên trở thành phản xạ tự nhiên đối với bất kỳ kiểu nhà khoa học dữ liệu nào.
Bất kỳ lúc nào, bạn cũng cần mô tả dữ liệu và các nhóm con trong dữ liệu. Thu nhập trung bình trong tập dữ liệu là bao nhiêu? Thu nhập tối thiểu và tối đa? Độ lệch chuẩn hay các thước đo độ phân tán khác? Nếu là biến phân loại, có bao nhiêu giá trị duy nhất? Giá trị nào xuất hiện nhiều nhất? Các giá trị có xuất hiện đồng đều không, hay phân bố không đều?
Trả lời các câu hỏi bằng phân tích mô tả trên các nhóm/nhóm con đã có thể mang lại insight giá trị, nhưng thường bạn cần xem xét mối quan hệ giữa các biến và tiến tới thống kê suy luận.
Phần vừa thách thức vừa thú vị của thống kê suy luận là các kiểu biến phân loại và số, cùng mối quan hệ giữa chúng. Ví dụ như:
- Tương quan: mối quan hệ giữa các giá trị số, như “tuổi và thu nhập liên quan thế nào?”.
- Mối quan hệ giữa biến phân loại và số để khảo sát câu hỏi, “Thu nhập của nam và nữ khác nhau ra sao?” (giới tính là đầu vào phân loại, thu nhập là biến đích số),
- Hoặc ngược lại, “Người lớn tuổi có dễ ly hôn hơn không?” (tuổi là đầu vào số, ly hôn là đích phân loại).
- Mối quan hệ giữa các biến phân loại, “Nam có thường ly hôn hơn nữ không?”
Để trả lời các câu hỏi này, bạn cần biết các loại kiểm định thống kê, từ T-Test đơn giản đến các phương pháp phức tạp như hồi quy tuyến tính đa biến hay phân tích chuỗi thời gian.
Bạn có thể theo các khóa học phù hợp để đào sâu hiểu biết thống kê bằng: Python, R, và thậm chí độc lập với công cụ. Những khóa này cung cấp nền tảng đúng đắn để bắt đầu làm việc với học máy. Khi hiểu thống kê về mối quan hệ giữa biến dự báo và biến đích, bạn sẽ nắm nguyên lý của các thuật toán dùng trong mô hình học có giám sát.
Mức độ bạn muốn đào sâu lại tùy vào điểm đến trên lộ trình. Nếu nhắm đến nhà phân tích dữ liệu, hiểu cơ bản về thống kê có thể là đủ. Kiến trúc sư dữ liệu có thể không cần thống kê. Nhưng nhà khoa học dữ liệu và kỹ sư học máy chắc chắn sẽ gặp tình huống cần dựa vào chuyên môn thống kê.
Các khái niệm toán học cho khoa học dữ liệu
Khoa học dữ liệu xoay quanh con số và tính toán, do đó toán học đóng vai trò lớn. Dù không cần bằng toán cao cấp cho lộ trình này, hiểu đại số và giải tích sẽ giúp bạn nắm khái niệm nhiều phương pháp thường dùng. Hầu hết các phương pháp giảm chiều (như PCA và Ma trận Phân rã) dựa trên Đại số tuyến tính, và nhiều thuật toán tối ưu (như gradient descent) dựa trên Giải tích.
Và cũng như thống kê và phân tích dữ liệu, kiến thức này không nhất thiết liên quan đến mọi vai trò. Nếu bạn hướng đến kỹ sư học máy, toán học là điều không thể tránh. Nhưng đa số vai trò khác – kể cả nhà khoa học dữ liệu – có thể vẫn làm tốt mà không cần nắm sâu đại số và giải tích.
Để học thêm và hiểu các khái niệm đại số, hãy xem khóa Linear Algebra for Data Science in R
5. Khám phá Chủ đề Nâng cao: Machine Learning và AI
Nhập môn học máy
Học máy là nghệ thuật tạo phần mềm học từ dữ liệu. Đây thực sự là “miếng cơm manh áo” cho nhà khoa học dữ liệu, kỹ sư học máy, và thậm chí kỹ sư dữ liệu. Phần trong giải pháp của bạn đưa ra doanh thu kỳ vọng dựa trên tồn kho và định giá? Đó là nhờ học máy!
Mức hiểu biết tối thiểu bạn cần với vai trò nhà khoa học dữ liệu là khả năng huấn luyện và đánh giá mô hình. Trong một số tình huống, bạn có thể muốn đào sâu để biết cách điều chỉnh thuật toán hiện có hoặc viết thuật toán mới, bước vào địa hạt của kỹ sư học máy.
Bạn có rất nhiều tự do trong cách làm học máy. Bạn có thể tự viết mã tất cả (bằng Python, R, C# hoặc Java, với các thư viện phù hợp), dùng phần mềm cục bộ (như Weka và RapidMiner), hoặc dùng giải pháp đám mây (như Databricks và AWS SageMaker). Dù điều này khiến việc chọn học gì trở nên khó, chuyên môn bạn phát triển có thể chuyển đổi khá dễ. Ý tưởng hay để quyết định bộ công cụ khởi đầu là bắt đầu từ ngôn ngữ bạn đã biết hoặc xem công cụ nào phổ biến trong ngành bạn quan tâm.
Bạn có thể bắt đầu với lộ trình nghề nghiệp Machine Learning Scientist with Python của chúng tôi, bao quát nhiều nền tảng cần thiết để khởi nghiệp.
Đào sâu Học sâu và AI
Mối quan hệ giữa học máy, học sâu và AI còn gây tranh luận.
Khi tôi dạy học máy, bài giảng đầu tiên luôn là một cuộc tranh luận sôi nổi về nhận định “Học máy là một dạng AI.” Dù đôi khi dùng thay thế nhau, tôi tin rằng học máy là công cụ cho AI, nhưng dùng học máy không đồng nghĩa bạn đã tạo ra AI.
Để một ứng dụng dữ liệu trở thành AI, điều cốt lõi là phải có vòng phản hồi nơi ứng dụng hoặc mô hình học từ đầu ra của chính nó. Khi đó, một thuật toán học có giám sát chạy một lần không nhất thiết là AI. Nếu bạn đưa phản hồi đầu ra của mô hình quay lại mô hình (như với học tăng cường), bạn sẽ có AI, vì hệ thống tự động liên tục học từ dự đoán đúng và sai.
Học sâu về bản chất là mạng nơ-ron “tăng lực”. Điều thú vị là học sâu cho phép đầu ra rất trực quan, vì các mô hình có thể tạo văn bản, hình ảnh, và giọng nói. Nếu dự án đòi hỏi mô hình tạo ra thứ gì đó mà người dùng có thể cảm nhận hoặc trải nghiệm, hiểu học sâu là lợi thế lớn. Một khóa học khởi đầu tuyệt vời là Introduction to Deep Learning in Python.
6. Ứng dụng Thực tiễn và Dự án Thế giới Thực
Triển khai dự án khoa học dữ liệu
Không nỗ lực khoa học dữ liệu nào tồn tại trong chân không. Khi bạn tiến bộ, điều quan trọng là lưu lại và giới thiệu các sản phẩm bạn tạo ra. Một phần của công việc nhà khoa học dữ liệu là chứng minh bạn có thể làm gì.
Điều khiến tôi hứng thú nhất ở khoa học dữ liệu là bạn không cần quá nhiều. Bạn chỉ cần một bộ dữ liệu công khai và chút sáng tạo để nghĩ ra một câu hỏi thú vị rồi dùng dữ liệu để trả lời. Hoặc bạn có thể vào DataLab hoặc Kaggle để bắt tay vào các bài tập/cuộc thi, lấy cảm hứng từ các bài nộp khác.
Ngoài ra, bạn có thể thu thập và dùng dữ liệu của chính mình. Tôi đã phân tích dữ liệu đạp xe tải xuống từ Strava và đã thu thập dữ liệu bất động sản để hỗ trợ tìm kiếm nhà ở.
Điều quan trọng nhất là bạn ghi chép lại những gì mình làm. Cố gắng làm cho công việc có thể tái lập, giải thích các bước bạn thực hiện, chia sẻ mã nguồn và kết quả phân tích hay hệ thống. Biết đâu bài tập thực hành của bạn lại là lời giải chính xác cho vấn đề của ai đó.
Ví dụ dự án
Theo tôi, những dự án thú vị nhất là dự án xuất phát từ đam mê và sở thích của chính bạn. Nếu bạn dùng bộ dữ liệu trong một lĩnh vực mình hiểu rõ, khả năng cao bạn sẽ nghĩ ra các câu hỏi độc đáo và thú vị. Bạn hiểu miền, và bạn hiểu dữ liệu... Nhưng nếu thực sự bắt đầu từ con số 0, có rất nhiều hướng để bắt tay vào, như ứng dụng hẹn hò, giao dịch, thể thao.
Bạn cũng có thể tìm thấy một loạt dự án khoa học dữ liệu trên DataCamp để làm quen với dạng công việc này. Dù bắt đầu bằng một số dự án phân tích dữ liệu hay làm các dự án Python cụ thể, bạn có thể tiến lên dự án học máy và thậm chí dự án AI. Có rất nhiều lựa chọn để bạn bắt đầu.
Nếu, bất chấp tất cả tài nguyên sẵn có, bạn vẫn chưa tìm được cách khởi động, một lựa chọn hữu ích khác là tham gia các hackathon. Nhiều viện nghiên cứu và công ty lớn tổ chức hackathon định kỳ.
Các hackathon này thường nhằm mục tiêu để các đội ngũ nhà khoa học dữ liệu cùng góp sức vào một vấn đề phù hợp, từ đó tạo cơ hội hợp tác và học hỏi lẫn nhau. Điều này giúp bạn xây dựng mạng lưới và được nhà tuyển dụng tiềm năng chú ý trong khi tích lũy kinh nghiệm hữu ích.
Phát triển danh mục (portfolio)
Ngày nay thật khó hình dung một nhà khoa học dữ liệu không có GitHub, DataCamp portfolio, hoặc một trang Medium hay blog kèm mã nguồn. Danh mục là thứ tối quan trọng trong khoa học dữ liệu, cũng như ở các ngành sáng tạo khác.
Khả năng trình bày các dự án đã làm là cách tuyệt vời để thuyết phục mọi người rằng bạn có đủ năng lực. Vì vậy, đáng để bạn bắt đầu ghi chép công việc trong một portfolio. Ngoài ra, bạn có thể ghi chép công việc và quan điểm dưới dạng bài blog hoặc thậm chí bài báo học thuật. Xem bài viết của chúng tôi về trình diễn chuyên môn dữ liệu qua portfolio để lấy cảm hứng.
Dù chọn cách nào, hãy đảm bảo bạn luôn có một bản tổng quan chỉn chu về những dự án đã thực hiện.
7. Định hướng Bức tranh Nghề nghiệp trong Khoa học Dữ liệu
Cơ hội nghề nghiệp trong khoa học dữ liệu
Toàn bộ bài viết đã nêu bật những kỹ năng, kiến thức và công cụ sẵn có cho một nhà khoa học dữ liệu. Nhưng bắt đầu từ đâu khi quyết định sự nghiệp?
Theo tôi, điều này thật sự phụ thuộc vào hoài bão của bạn. Cho đến đây, bài viết hẳn đã làm rõ rằng tôi không tin có một lộ trình khoa học dữ liệu “một cỡ cho tất cả”.
Dĩ nhiên, mọi vai trò đều xây trên nền tảng thống kê, thao tác dữ liệu, học máy, và kỹ nghệ phần mềm. Nhưng ngoài ra, mọi thứ đều tùy vào bạn.
Nhà khoa học dữ liệu sử dụng thuật toán, trong khi kỹ sư học máy điều chỉnh hoặc tạo thuật toán. Vì vậy nhà khoa học dữ liệu có thể chỉ cần biết nhiều thuật toán và khi nào áp dụng, còn kỹ sư học máy cần thật sự hiểu các khái niệm toán học đằng sau thuật toán.
Tương tự, nếu bạn có năng lượng từ việc chia sẻ kết quả phân tích, như một nhà khoa học dữ liệu hoặc nhà phân tích dữ liệu, bạn có khả năng hưởng lợi nhiều hơn từ kiến thức vững vàng về trực quan hóa dữ liệu và EDA thay vì rất giỏi mô hình hóa dữ liệu.
Do đó, lộ trình có khá nhiều ngã rẽ, và bạn có thể tự quyết định đi sâu đến mức nào ở các nhánh khác nhau.
Chuẩn bị cho phỏng vấn khoa học dữ liệu
Bất chấp khác biệt giữa các vai trò, trong mọi cuộc phỏng vấn bạn sẽ được kiểm tra kỹ năng cứng và mềm. Các bài kiểm tra sẽ khác nhau tùy vai trò bạn theo đuổi.
Nếu bạn không nhắm đến vai trò như kỹ sư học máy hay kỹ sư dữ liệu, bạn có thể sẽ không bị hỏi những câu như “Bạn sẽ tối ưu thuật toán A hoặc B thế nào?”. Vì vậy, điều quan trọng là tập trung vào các kỹ năng — và vì thế là các câu hỏi — bạn kỳ vọng và sẵn sàng làm việc. Bị hỏi về chủ đề bạn không quen có thể là dấu hiệu vai trò đó không dành cho bạn.
Bởi vì trong lĩnh vực còn khá mới này, đặc biệt ở các công ty còn mới với dữ liệu, tồn tại nhiều hiểu lầm về nhà khoa học dữ liệu là ai và họ làm gì.
Tôi từng ứng tuyển vị trí nhà khoa học dữ liệu nơi người phỏng vấn dùng lẫn lộn hai thuật ngữ nhà khoa học dữ liệu và kỹ sư học máy. Vì thế, nếu bạn bị hỏi những câu không thể trả lời, có khả năng nhà tuyển dụng đã nhầm. Ví dụ, kỹ sư dữ liệu hầu như không nên bị hỏi cách họ làm quản lý các bên liên quan trong một dự án.
May mắn là có nhiều tài nguyên giúp bạn chuẩn bị phỏng vấn tùy theo vai trò bạn ứng tuyển:
8. Học tập Liên tục và Trọn đời
Cập nhật xu hướng
Lĩnh vực khoa học dữ liệu rất năng động và điều quan trọng là luôn cập nhật các xu hướng mới nhất. Với ChatGPT, AI sinh tạo đã trở nên phổ biến đại trà, và giờ thật khó hình dung một nhà khoa học dữ liệu mà không có chút khái niệm về token embeddings và/hoặc mô hình attention. Tương tự, sự xuất hiện của MLOps khiến khó có thể tưởng tượng kỹ sư dữ liệu kiểm tra thủ công hiệu năng và drift của mô hình.
Cùng với tăng trưởng năng động này, các khía cạnh khác nhau của AI trở nên quan trọng. Hiện tại, có rất nhiều sự chú ý dành cho khía cạnh đạo đức và pháp lý của AI, thể hiện qua nhiều tranh luận học thuật và chính trị, đã dẫn đến các quy tắc và quy định mới.
Bất kể quyết định của chính phủ về AI ra sao, không ai muốn chịu trách nhiệm cho vụ bê bối tiếp theo trong khoa học dữ liệu. Cách duy nhất để tránh là luôn nhận thức về giới hạn đạo đức và pháp lý. Hoặc tốt hơn, với tư cách chuyên gia, bạn có thể bắt đầu đóng góp cho các diễn tiến này bằng nền tảng của mình, hình thành và thể hiện quan điểm.
Có nhiều cách để luôn cập nhật. Tất nhiên có DataCamp như một nền tảng, nhưng bạn cũng có thể tìm và theo dõi các chuyên gia truyền cảm hứng trong lĩnh vực của mình. Hãy xem họ có blog, bài đăng trên X hay Medium, hoặc bất cứ nơi nào giúp bạn lướt qua cách họ nhìn nhận bức tranh đang thay đổi.
Nguồn học nâng cao
Như đã nhấn mạnh xuyên suốt bài viết, có vô số tài nguyên cho bất kỳ ai muốn bắt đầu hoặc phát triển trong lĩnh vực khoa học dữ liệu. Ngoài ra, nếu muốn ở rất gần nguồn, bạn có thể xem các hội nghị kỹ thuật như NeurIPS, ICML, hoặc KDD. Xem những sự kiện này và hơn nữa trong danh sách Top hội nghị Khoa học Dữ liệu cho năm 2026.
Kết luận và Bước tiếp theo
Dù có nhiều điểm dừng trên lộ trình khoa học dữ liệu, không có một con đường duy nhất. Định hướng trong lĩnh vực này đòi hỏi bạn 1) có hình dung về toàn cảnh (hy vọng bạn đã có từ bài viết này) và 2) hiểu điểm mạnh, điểm yếu, sở thích của mình để quyết định theo đuổi điều gì.
Khi có hai điều này, bạn có thể dựa vào bài viết để được định hướng đúng và biết kỹ năng nào cần nhấn mạnh trong quá trình học tập. May mắn thay, có những nguồn lực hữu ích để bắt đầu, như các lộ trình nghề nghiệp của DataCamp, giúp bạn trang bị những kỹ năng cần có để khám phá các nghề khác nhau:


Dù bạn là sinh viên, một nhà khoa học dữ liệu tương lai, hay một chuyên gia đang muốn chuyển hướng nghề nghiệp, nếu muốn trở thành một nhà khoa học dữ liệu dày dạn kinh nghiệm, bạn cần đi theo một lộ trình. Điều này không phải lúc nào cũng dễ dàng, vì bức tranh khoa học dữ liệu đã trở nên khá rộng và do đó xuất hiện những kiểu chuyên gia khác nhau với các hoạt động và bộ kỹ năng khác nhau.
Để phác thảo một lộ trình khoa học dữ liệu, bài viết này cung cấp cái nhìn tổng quan về toàn cảnh lĩnh vực, giúp bạn xem vai trò nào phù hợp với tham vọng của mình. Ngoài ra, bài viết còn gợi ý cách chuyển sang hoặc phát triển theo các vai trò khác nhau trong hệ sinh thái đó, trả lời những câu hỏi như: Bạn nên phát triển kỹ năng gì và nên làm quen với những phương pháp nào?
Hãy bắt đầu với lộ trình khoa học dữ liệu của chúng ta.
Tóm tắt: Lộ trình Khoa học Dữ liệu
Trong bài viết này, chúng tôi đi sâu vào mọi khía cạnh của lộ trình. Tuy nhiên, nếu bạn muốn xem nhanh phần dàn ý, hãy tham khảo bên dưới:
Bằng cách đi theo lộ trình này, bạn có thể định hướng hiệu quả trong lĩnh vực khoa học dữ liệu, xây dựng các kỹ năng cốt lõi, và theo đuổi một sự nghiệp xứng đáng.
1. Nắm vững Những điều Cơ bản của Khoa học Dữ liệu
Khoa học dữ liệu là gì?
Để hiểu ngữ cảnh của một lộ trình khoa học dữ liệu, điều cốt yếu là phải có khái niệm về Khoa học Dữ liệu. Chúng tôi có một hướng dẫn đầy đủ bao quát các định nghĩa và giải thích về khoa học dữ liệu, nhưng trong phạm vi bài viết này, chúng ta coi khoa học dữ liệu là tập hợp các hoạt động nhằm giải quyết vấn đề bằng dữ liệu.
Một vấn đề thường gặp là “Tôi có câu hỏi nhưng không biết câu trả lời”, vì vậy nếu bạn chạy một truy vấn SQL trên cơ sở dữ liệu bán hàng để tìm xem tổ chức kiếm được bao nhiêu doanh thu tháng trước, thì bạn đang làm công việc của một nhà khoa học dữ liệu!
Thường thì vấn đề/giải pháp phức tạp hơn và đòi hỏi bộ kỹ năng đa dạng hơn. Để có thể bàn luận về dải vai trò và kỹ năng rộng này xuyên suốt lộ trình, chúng ta sẽ dùng vòng đời dự án khoa học dữ liệu như một cấu trúc khái quát. Cách này cho phép chúng ta ánh xạ các hoạt động và vai trò khác nhau, làm nền tảng để phác thảo toàn cảnh lĩnh vực.
2. Làm quen với Vòng đời Dự án Khoa học Dữ liệu
Các dự án khoa học dữ liệu phần lớn bắt đầu từ một câu hỏi hay vấn đề kinh doanh. Vấn đề kích hoạt giai đoạn khởi động, trong đó xác định tập các giải pháp khả dĩ và đánh giá tính khả thi ban đầu. Thu thập dữ liệu sơ bộ hoặc phân tích khám phá dữ liệu hiện có được thực hiện để xem điều gì có thể và điều gì không. Dữ liệu có đủ phong phú không? Có đủ đặc trưng không?
Khởi động và khám phá
Khi mọi điều kiện đều thuận lợi, chúng ta bắt đầu phát triển mô hình dự đoán. Mô hình sẽ dùng đầu vào để dự đoán đầu ra. Ban đầu, đó có thể chỉ là một mô hình chạy một lần, được huấn luyện, kiểm thử và thẩm định trên tập cross-validation k-fold (một kỹ thuật học máy để đánh giá khả năng mô hình hoạt động trên dữ liệu chưa thấy). Đây là công việc thường do nhà khoa học dữ liệu “cổ điển” đảm trách. Khi mô hình đạt hiệu năng đủ tốt, đã đến lúc đưa vào sản xuất và đặt trong pipeline của hạ tầng hiện có, nơi hiệu năng sẽ được giám sát và mô hình được huấn luyện lại khi cần.
Mỗi giai đoạn đòi hỏi các kỹ năng khác nhau. Trong giai đoạn khởi động, cần có hiểu biết kinh doanh, quen thuộc với biến đổi dữ liệu, làm sạch, thống kê mô tả và một số thống kê suy luận cơ bản. Đây là công việc mà một nhà phân tích dữ liệu và/hoặc nhà khoa học dữ liệu có thể thực hiện.
Phát triển mô hình và đưa vào sản xuất
Trong giai đoạn mô hình hóa, cần xây dựng các mô hình dự đoán. Những mô hình đơn giản như hồi quy có thể do nhà phân tích dữ liệu xây dựng, nhưng nếu trở nên phức tạp hơn, bạn sẽ cần nhà khoa học dữ liệu để xây mô hình dùng thuật toán hiện có, hoặc thậm chí kỹ sư học máy để điều chỉnh hay tạo thuật toán mới.
Khi triển khai và đưa mô hình vào sản xuất, bạn bước vào phạm vi của kỹ sư học máy hoặc kỹ sư dữ liệu. Khác với các giai đoạn trước, không nhất thiết gắn chặt với kinh doanh; nhiệm vụ xoay quanh việc tạo và giám sát một pipeline bao quanh mô hình dự đoán nhằm cung cấp đầu ra tin cậy cho các hệ thống đích phù hợp.
Xuyên suốt quá trình, toàn bộ dữ liệu cần có mặt đúng nơi với siêu dữ liệu phù hợp, đó là vai trò của kiến trúc sư dữ liệu. Khi dữ liệu mới được nạp vào hoặc dữ liệu hiện có được chuyển hóa thành thông tin mới, họ cũng đảm bảo dữ liệu đến đúng chỗ.
Tích hợp vai trò và hợp tác liên chức năng
Cách các vai trò khác nhau đóng góp qua các giai đoạn của vòng đời được minh họa trong hình dưới. Vì các vai trò tham gia ở các giai đoạn khác nhau, nên họ cần những kỹ năng khác nhau.
Các vai trò ở giai đoạn đầu vòng đời đòi hỏi hiểu biết kinh doanh nhiều hơn và ít thiên về kỹ thuật, trong khi các giai đoạn sau cần ít hiểu biết kinh doanh hơn nhưng nhiều kỹ thuật và tối ưu thuật toán hơn. Ví dụ, là một nhà khoa học dữ liệu, bạn có thể chấp nhận hiệu năng tính toán chưa tối ưu để chứng minh giá trị và hiệu quả của mô hình. Nhưng một khi bạn chịu trách nhiệm đưa mô hình vào sản xuất, bạn phải tối ưu độ phức tạp tính toán để đảm bảo pipeline hiệu quả (và tiết kiệm chi phí).
Mức độ đóng góp của các vai trò Khoa học Dữ liệu khác nhau trong suốt một Dự án (DAn - Data Analyst, DS - Data Scientist, MLE - Machine Learning Engineer, DE - Data Engineer, DAr - Data Architect - Ảnh: Tác giả
Điều quan trọng là ranh giới giữa các vai trò không cứng nhắc. Nhiều nhà khoa học dữ liệu đã nghĩ đến hệ thống nguồn/đích phù hợp và hiệu quả tính toán, và cân nhắc những điều đó trong mã của họ. Một kỹ sư học máy có thể nhận ra rằng các cách tạo đặc trưng nhất định có thể cải thiện hiệu năng mô hình. Một nhà phân tích dữ liệu có thể đưa ra lời khuyên hay về nơi trong danh mục dữ liệu nên lưu trữ các đặc trưng được tạo cho kiến trúc sư dữ liệu. Nói cách khác, ở mức độ nào đó, mọi vai trò đều nên nhận biết công việc của vai trò khác, nhưng không nhất thiết phải hiểu sâu trách nhiệm của nhau.
Kỹ năng và công cụ thiết yếu
Về các kỹ năng và công cụ bạn cần, có một nền tảng rõ ràng. Bất kể bạn đóng góp ở đâu trong vòng đời dự án, bạn sẽ cần hiểu cơ bản về toán và thống kê, phát triển phần mềm cộng tác, và thao tác dữ liệu. Nhìn chung, phần mở đầu của bất kỳ lộ trình khoa học dữ liệu nào gồm có:
Có nhiều kiểu vai trò khoa học dữ liệu với yêu cầu kỹ năng khác nhau: Nhà phân tích dữ liệu sẽ cần hiểu SQL sâu hơn Kỹ sư dữ liệu. Nhà khoa học dữ liệu cần biết Học máy tốt hơn Kiến trúc sư dữ liệu. Đây là điểm lộ trình tách nhánh: tùy theo hoài bão của bạn trong lĩnh vực này, bạn sẽ cần học các kỹ năng khác nhau. Các phần tiếp theo sẽ mô tả những nhánh mà bạn có thể cân nhắc.
3. Đi sâu vào Phân tích và Trực quan hóa Dữ liệu
Phân tích khám phá dữ liệu (EDA)
Bất kể bạn đã đi được bao xa trên lộ trình, dù là người dày dạn hay mới bắt đầu, mọi dự án đều khởi đầu bằng việc hiểu dữ liệu của bạn.
Hiểu thấu dữ liệu là chìa khóa để đánh giá tính khả thi của dự án. Bắt đầu bằng các câu hỏi cơ bản như ‘mình có những biến nào?’ và ‘mình có bao nhiêu quan sát?’ rồi tiến đến những câu hỏi phức tạp hơn như ‘mối quan hệ giữa các biến là gì?’
Rất thường xuyên, kết quả của EDA tự nó đã là câu trả lời cho câu hỏi của các bên liên quan. Khi được trực quan hóa đúng cách và trình bày mạch lạc, ví dụ qua một bảng điều khiển, kết quả của một phân tích dữ liệu đơn giản có thể dùng để trả lời câu hỏi phức tạp. Tuy nhiên, điều này phụ thuộc vào kỹ năng trực quan hóa dữ liệu.
Chỉ cần thông qua EDA cho thấy, chẳng hạn, tồn tại các phân khúc khác nhau của khách truy cập website, là bạn đã tạo giá trị theo cách của một nhà khoa học dữ liệu.
Có nhiều cách để trực quan hóa kết quả. Có thể dùng thư viện/gói trực quan trong ngôn ngữ bạn dùng (như ggplot2 của R và matplotlib của Python) hoặc các công cụ chuyên dụng (như PowerBI, Tableau, hoặc thậm chí Excel)
Làm chủ Trực quan hóa Dữ liệu
Đặc biệt khi tập trung nhiều hơn vào nhiệm vụ của Nhà phân tích dữ liệu, hiểu sâu về trực quan hóa dữ liệu rất hữu ích.
Với hầu hết vai trò khoa học dữ liệu, biểu đồ có thể dùng để kiểm tra giả định qua biểu đồ phân tán và histogram, nhưng khi bản thân phân tích là sản phẩm bàn giao, như với Nhà phân tích dữ liệu, bạn sẽ gặp những tình huống muốn khiến kết quả phân tích trở nên “dễ nuốt”.
Hãy nghĩ đến phong cách thương hiệu tùy biến, biểu đồ mới, hoặc infographic làm đầu vào cho đơn vị ra quyết định. Trong những tình huống đó, khả năng tạo trực quan hóa dữ liệu gần như mang tính nghệ thuật là một lợi thế. Khóa học Understanding Data Visualization sẽ giúp bạn đào sâu năng lực dataviz.
Lộ trình Khoa học Dữ liệu, minh họa như bản đồ metro, cho thấy nền tảng chung của mọi vai trò và các kỹ năng đặc thù cho từng vai trò. - Ảnh: Tác giả
4. Xây nền tảng Thống kê và Toán học
Thống kê mô tả và suy luận
Một trong những điểm dừng đầu tiên trên lộ trình là thống kê. Một số khái niệm thống kê cơ bản nên trở thành phản xạ tự nhiên đối với bất kỳ kiểu nhà khoa học dữ liệu nào.
Bất kỳ lúc nào, bạn cũng cần mô tả dữ liệu và các nhóm con trong dữ liệu. Thu nhập trung bình trong tập dữ liệu là bao nhiêu? Thu nhập tối thiểu và tối đa? Độ lệch chuẩn hay các thước đo độ phân tán khác? Nếu là biến phân loại, có bao nhiêu giá trị duy nhất? Giá trị nào xuất hiện nhiều nhất? Các giá trị có xuất hiện đồng đều không, hay phân bố không đều?
Trả lời các câu hỏi bằng phân tích mô tả trên các nhóm/nhóm con đã có thể mang lại insight giá trị, nhưng thường bạn cần xem xét mối quan hệ giữa các biến và tiến tới thống kê suy luận.
Phần vừa thách thức vừa thú vị của thống kê suy luận là các kiểu biến phân loại và số, cùng mối quan hệ giữa chúng. Ví dụ như:
Để trả lời các câu hỏi này, bạn cần biết các loại kiểm định thống kê, từ T-Test đơn giản đến các phương pháp phức tạp như hồi quy tuyến tính đa biến hay phân tích chuỗi thời gian.
Bạn có thể theo các khóa học phù hợp để đào sâu hiểu biết thống kê bằng: Python, R, và thậm chí độc lập với công cụ. Những khóa này cung cấp nền tảng đúng đắn để bắt đầu làm việc với học máy. Khi hiểu thống kê về mối quan hệ giữa biến dự báo và biến đích, bạn sẽ nắm nguyên lý của các thuật toán dùng trong mô hình học có giám sát.
Mức độ bạn muốn đào sâu lại tùy vào điểm đến trên lộ trình. Nếu nhắm đến nhà phân tích dữ liệu, hiểu cơ bản về thống kê có thể là đủ. Kiến trúc sư dữ liệu có thể không cần thống kê. Nhưng nhà khoa học dữ liệu và kỹ sư học máy chắc chắn sẽ gặp tình huống cần dựa vào chuyên môn thống kê.
Các khái niệm toán học cho khoa học dữ liệu
Khoa học dữ liệu xoay quanh con số và tính toán, do đó toán học đóng vai trò lớn. Dù không cần bằng toán cao cấp cho lộ trình này, hiểu đại số và giải tích sẽ giúp bạn nắm khái niệm nhiều phương pháp thường dùng. Hầu hết các phương pháp giảm chiều (như PCA và Ma trận Phân rã) dựa trên Đại số tuyến tính, và nhiều thuật toán tối ưu (như gradient descent) dựa trên Giải tích.
Và cũng như thống kê và phân tích dữ liệu, kiến thức này không nhất thiết liên quan đến mọi vai trò. Nếu bạn hướng đến kỹ sư học máy, toán học là điều không thể tránh. Nhưng đa số vai trò khác – kể cả nhà khoa học dữ liệu – có thể vẫn làm tốt mà không cần nắm sâu đại số và giải tích.
Để học thêm và hiểu các khái niệm đại số, hãy xem khóa Linear Algebra for Data Science in R
5. Khám phá Chủ đề Nâng cao: Machine Learning và AI
Nhập môn học máy
Học máy là nghệ thuật tạo phần mềm học từ dữ liệu. Đây thực sự là “miếng cơm manh áo” cho nhà khoa học dữ liệu, kỹ sư học máy, và thậm chí kỹ sư dữ liệu. Phần trong giải pháp của bạn đưa ra doanh thu kỳ vọng dựa trên tồn kho và định giá? Đó là nhờ học máy!
Mức hiểu biết tối thiểu bạn cần với vai trò nhà khoa học dữ liệu là khả năng huấn luyện và đánh giá mô hình. Trong một số tình huống, bạn có thể muốn đào sâu để biết cách điều chỉnh thuật toán hiện có hoặc viết thuật toán mới, bước vào địa hạt của kỹ sư học máy.
Bạn có rất nhiều tự do trong cách làm học máy. Bạn có thể tự viết mã tất cả (bằng Python, R, C# hoặc Java, với các thư viện phù hợp), dùng phần mềm cục bộ (như Weka và RapidMiner), hoặc dùng giải pháp đám mây (như Databricks và AWS SageMaker). Dù điều này khiến việc chọn học gì trở nên khó, chuyên môn bạn phát triển có thể chuyển đổi khá dễ. Ý tưởng hay để quyết định bộ công cụ khởi đầu là bắt đầu từ ngôn ngữ bạn đã biết hoặc xem công cụ nào phổ biến trong ngành bạn quan tâm.
Bạn có thể bắt đầu với lộ trình nghề nghiệp Machine Learning Scientist with Python của chúng tôi, bao quát nhiều nền tảng cần thiết để khởi nghiệp.
Đào sâu Học sâu và AI
Mối quan hệ giữa học máy, học sâu và AI còn gây tranh luận.
Khi tôi dạy học máy, bài giảng đầu tiên luôn là một cuộc tranh luận sôi nổi về nhận định “Học máy là một dạng AI.” Dù đôi khi dùng thay thế nhau, tôi tin rằng học máy là công cụ cho AI, nhưng dùng học máy không đồng nghĩa bạn đã tạo ra AI.
Để một ứng dụng dữ liệu trở thành AI, điều cốt lõi là phải có vòng phản hồi nơi ứng dụng hoặc mô hình học từ đầu ra của chính nó. Khi đó, một thuật toán học có giám sát chạy một lần không nhất thiết là AI. Nếu bạn đưa phản hồi đầu ra của mô hình quay lại mô hình (như với học tăng cường), bạn sẽ có AI, vì hệ thống tự động liên tục học từ dự đoán đúng và sai.
Học sâu về bản chất là mạng nơ-ron “tăng lực”. Điều thú vị là học sâu cho phép đầu ra rất trực quan, vì các mô hình có thể tạo văn bản, hình ảnh, và giọng nói. Nếu dự án đòi hỏi mô hình tạo ra thứ gì đó mà người dùng có thể cảm nhận hoặc trải nghiệm, hiểu học sâu là lợi thế lớn. Một khóa học khởi đầu tuyệt vời là Introduction to Deep Learning in Python.
6. Ứng dụng Thực tiễn và Dự án Thế giới Thực
Triển khai dự án khoa học dữ liệu
Không nỗ lực khoa học dữ liệu nào tồn tại trong chân không. Khi bạn tiến bộ, điều quan trọng là lưu lại và giới thiệu các sản phẩm bạn tạo ra. Một phần của công việc nhà khoa học dữ liệu là chứng minh bạn có thể làm gì.
Điều khiến tôi hứng thú nhất ở khoa học dữ liệu là bạn không cần quá nhiều. Bạn chỉ cần một bộ dữ liệu công khai và chút sáng tạo để nghĩ ra một câu hỏi thú vị rồi dùng dữ liệu để trả lời. Hoặc bạn có thể vào DataLab hoặc Kaggle để bắt tay vào các bài tập/cuộc thi, lấy cảm hứng từ các bài nộp khác.
Ngoài ra, bạn có thể thu thập và dùng dữ liệu của chính mình. Tôi đã phân tích dữ liệu đạp xe tải xuống từ Strava và đã thu thập dữ liệu bất động sản để hỗ trợ tìm kiếm nhà ở.
Điều quan trọng nhất là bạn ghi chép lại những gì mình làm. Cố gắng làm cho công việc có thể tái lập, giải thích các bước bạn thực hiện, chia sẻ mã nguồn và kết quả phân tích hay hệ thống. Biết đâu bài tập thực hành của bạn lại là lời giải chính xác cho vấn đề của ai đó.
Ví dụ dự án
Theo tôi, những dự án thú vị nhất là dự án xuất phát từ đam mê và sở thích của chính bạn. Nếu bạn dùng bộ dữ liệu trong một lĩnh vực mình hiểu rõ, khả năng cao bạn sẽ nghĩ ra các câu hỏi độc đáo và thú vị. Bạn hiểu miền, và bạn hiểu dữ liệu... Nhưng nếu thực sự bắt đầu từ con số 0, có rất nhiều hướng để bắt tay vào, như ứng dụng hẹn hò, giao dịch, thể thao.
Bạn cũng có thể tìm thấy một loạt dự án khoa học dữ liệu trên DataCamp để làm quen với dạng công việc này. Dù bắt đầu bằng một số dự án phân tích dữ liệu hay làm các dự án Python cụ thể, bạn có thể tiến lên dự án học máy và thậm chí dự án AI. Có rất nhiều lựa chọn để bạn bắt đầu.
Nếu, bất chấp tất cả tài nguyên sẵn có, bạn vẫn chưa tìm được cách khởi động, một lựa chọn hữu ích khác là tham gia các hackathon. Nhiều viện nghiên cứu và công ty lớn tổ chức hackathon định kỳ.
Các hackathon này thường nhằm mục tiêu để các đội ngũ nhà khoa học dữ liệu cùng góp sức vào một vấn đề phù hợp, từ đó tạo cơ hội hợp tác và học hỏi lẫn nhau. Điều này giúp bạn xây dựng mạng lưới và được nhà tuyển dụng tiềm năng chú ý trong khi tích lũy kinh nghiệm hữu ích.
Phát triển danh mục (portfolio)
Ngày nay thật khó hình dung một nhà khoa học dữ liệu không có GitHub, DataCamp portfolio, hoặc một trang Medium hay blog kèm mã nguồn. Danh mục là thứ tối quan trọng trong khoa học dữ liệu, cũng như ở các ngành sáng tạo khác.
Khả năng trình bày các dự án đã làm là cách tuyệt vời để thuyết phục mọi người rằng bạn có đủ năng lực. Vì vậy, đáng để bạn bắt đầu ghi chép công việc trong một portfolio. Ngoài ra, bạn có thể ghi chép công việc và quan điểm dưới dạng bài blog hoặc thậm chí bài báo học thuật. Xem bài viết của chúng tôi về trình diễn chuyên môn dữ liệu qua portfolio để lấy cảm hứng.
Dù chọn cách nào, hãy đảm bảo bạn luôn có một bản tổng quan chỉn chu về những dự án đã thực hiện.
7. Định hướng Bức tranh Nghề nghiệp trong Khoa học Dữ liệu
Cơ hội nghề nghiệp trong khoa học dữ liệu
Toàn bộ bài viết đã nêu bật những kỹ năng, kiến thức và công cụ sẵn có cho một nhà khoa học dữ liệu. Nhưng bắt đầu từ đâu khi quyết định sự nghiệp?
Theo tôi, điều này thật sự phụ thuộc vào hoài bão của bạn. Cho đến đây, bài viết hẳn đã làm rõ rằng tôi không tin có một lộ trình khoa học dữ liệu “một cỡ cho tất cả”.
Dĩ nhiên, mọi vai trò đều xây trên nền tảng thống kê, thao tác dữ liệu, học máy, và kỹ nghệ phần mềm. Nhưng ngoài ra, mọi thứ đều tùy vào bạn.
Nhà khoa học dữ liệu sử dụng thuật toán, trong khi kỹ sư học máy điều chỉnh hoặc tạo thuật toán. Vì vậy nhà khoa học dữ liệu có thể chỉ cần biết nhiều thuật toán và khi nào áp dụng, còn kỹ sư học máy cần thật sự hiểu các khái niệm toán học đằng sau thuật toán.
Tương tự, nếu bạn có năng lượng từ việc chia sẻ kết quả phân tích, như một nhà khoa học dữ liệu hoặc nhà phân tích dữ liệu, bạn có khả năng hưởng lợi nhiều hơn từ kiến thức vững vàng về trực quan hóa dữ liệu và EDA thay vì rất giỏi mô hình hóa dữ liệu.
Do đó, lộ trình có khá nhiều ngã rẽ, và bạn có thể tự quyết định đi sâu đến mức nào ở các nhánh khác nhau.
Chuẩn bị cho phỏng vấn khoa học dữ liệu
Bất chấp khác biệt giữa các vai trò, trong mọi cuộc phỏng vấn bạn sẽ được kiểm tra kỹ năng cứng và mềm. Các bài kiểm tra sẽ khác nhau tùy vai trò bạn theo đuổi.
Nếu bạn không nhắm đến vai trò như kỹ sư học máy hay kỹ sư dữ liệu, bạn có thể sẽ không bị hỏi những câu như “Bạn sẽ tối ưu thuật toán A hoặc B thế nào?”. Vì vậy, điều quan trọng là tập trung vào các kỹ năng — và vì thế là các câu hỏi — bạn kỳ vọng và sẵn sàng làm việc. Bị hỏi về chủ đề bạn không quen có thể là dấu hiệu vai trò đó không dành cho bạn.
Bởi vì trong lĩnh vực còn khá mới này, đặc biệt ở các công ty còn mới với dữ liệu, tồn tại nhiều hiểu lầm về nhà khoa học dữ liệu là ai và họ làm gì.
Tôi từng ứng tuyển vị trí nhà khoa học dữ liệu nơi người phỏng vấn dùng lẫn lộn hai thuật ngữ nhà khoa học dữ liệu và kỹ sư học máy. Vì thế, nếu bạn bị hỏi những câu không thể trả lời, có khả năng nhà tuyển dụng đã nhầm. Ví dụ, kỹ sư dữ liệu hầu như không nên bị hỏi cách họ làm quản lý các bên liên quan trong một dự án.
May mắn là có nhiều tài nguyên giúp bạn chuẩn bị phỏng vấn tùy theo vai trò bạn ứng tuyển:
8. Học tập Liên tục và Trọn đời
Cập nhật xu hướng
Lĩnh vực khoa học dữ liệu rất năng động và điều quan trọng là luôn cập nhật các xu hướng mới nhất. Với ChatGPT, AI sinh tạo đã trở nên phổ biến đại trà, và giờ thật khó hình dung một nhà khoa học dữ liệu mà không có chút khái niệm về token embeddings và/hoặc mô hình attention. Tương tự, sự xuất hiện của MLOps khiến khó có thể tưởng tượng kỹ sư dữ liệu kiểm tra thủ công hiệu năng và drift của mô hình.
Cùng với tăng trưởng năng động này, các khía cạnh khác nhau của AI trở nên quan trọng. Hiện tại, có rất nhiều sự chú ý dành cho khía cạnh đạo đức và pháp lý của AI, thể hiện qua nhiều tranh luận học thuật và chính trị, đã dẫn đến các quy tắc và quy định mới.
Bất kể quyết định của chính phủ về AI ra sao, không ai muốn chịu trách nhiệm cho vụ bê bối tiếp theo trong khoa học dữ liệu. Cách duy nhất để tránh là luôn nhận thức về giới hạn đạo đức và pháp lý. Hoặc tốt hơn, với tư cách chuyên gia, bạn có thể bắt đầu đóng góp cho các diễn tiến này bằng nền tảng của mình, hình thành và thể hiện quan điểm.
Có nhiều cách để luôn cập nhật. Tất nhiên có DataCamp như một nền tảng, nhưng bạn cũng có thể tìm và theo dõi các chuyên gia truyền cảm hứng trong lĩnh vực của mình. Hãy xem họ có blog, bài đăng trên X hay Medium, hoặc bất cứ nơi nào giúp bạn lướt qua cách họ nhìn nhận bức tranh đang thay đổi.
Nguồn học nâng cao
Như đã nhấn mạnh xuyên suốt bài viết, có vô số tài nguyên cho bất kỳ ai muốn bắt đầu hoặc phát triển trong lĩnh vực khoa học dữ liệu. Ngoài ra, nếu muốn ở rất gần nguồn, bạn có thể xem các hội nghị kỹ thuật như NeurIPS, ICML, hoặc KDD. Xem những sự kiện này và hơn nữa trong danh sách Top hội nghị Khoa học Dữ liệu cho năm 2026.
Kết luận và Bước tiếp theo
Dù có nhiều điểm dừng trên lộ trình khoa học dữ liệu, không có một con đường duy nhất. Định hướng trong lĩnh vực này đòi hỏi bạn 1) có hình dung về toàn cảnh (hy vọng bạn đã có từ bài viết này) và 2) hiểu điểm mạnh, điểm yếu, sở thích của mình để quyết định theo đuổi điều gì.
Khi có hai điều này, bạn có thể dựa vào bài viết để được định hướng đúng và biết kỹ năng nào cần nhấn mạnh trong quá trình học tập. May mắn thay, có những nguồn lực hữu ích để bắt đầu, như các lộ trình nghề nghiệp của DataCamp, giúp bạn trang bị những kỹ năng cần có để khám phá các nghề khác nhau: