चाहे आप छात्र हों, उभरते डेटा वैज्ञानिक हों, या करियर बदलने की सोच रहे किसी पेशेवर—यदि आप अनुभवी डेटा वैज्ञानिक बनना चाहते हैं, तो आपको एक रास्ते का अनुसरण करना होगा। यह हमेशा आसान नहीं होता, क्योंकि डेटा साइंस का परिदृश्य काफी व्यापक हो गया है और परिणामस्वरूप, अलग-अलग प्रकार के डेटा साइंस पेशेवर अलग-अलग गतिविधियों और कौशल-सेट के साथ मौजूद हैं।
डेटा साइंस का मार्ग रेखांकित करने के लिए, यह लेख डेटा साइंस परिदृश्य का एक अवलोकन देता है ताकि आप देख सकें कि कौन-सी भूमिकाएँ आपकी महत्वाकांक्षाओं से मेल खाती हैं। साथ ही, यह इस पर संकेत देता है कि उस परिदृश्य के भीतर अलग-अलग भूमिकाओं में कैसे प्रवेश करें या उनकी ओर कैसे बढ़ें—जैसे: आपको कौन-से कौशल विकसित करने चाहिए और किन विधियों से परिचित होना चाहिए?
आइए, हमारे डेटा साइंस रोडमैप के साथ शुरुआत करते हैं।
संक्षेप में: डेटा साइंस रोडमैप
इस लेख में, हम रोडमैप के सभी पहलुओं में गहराई से उतरते हैं। हालांकि, यदि आप रूपरेखा का एक त्वरित सार देख रहे हैं, तो वह नीचे दिया गया है:
- डेटा साइंस को समझना: डेटा साइंस और उसके व्यापक परिदृश्य की बुनियादी समझ हासिल करें।
- प्रोजेक्ट जीवनचक्र से परिचय: एक व्यावसायिक समस्या से शुरुआत करें, प्रेडिक्टिव मॉडल विकसित करें, और उन्हें प्रोडक्शन में तैनात करें—विभिन्न भूमिकाओं (Data Analyst, Data Scientist, Machine Learning Engineer, Data Engineer, Data Architect) के योगदान को समझते हुए।
- डेटा विश्लेषण और विज़ुअलाइज़ेशन: Exploratory Data Analysis (EDA) करें और डेटा विज़ुअलाइज़ेशन टूल्स (जैसे Python का matplotlib, R का ggplot2, PowerBI, Tableau) में दक्ष बनें।
- सांख्यिकी और गणित में नींव: वर्णनात्मक और अनुमानात्मक सांख्यिकी सीखें, और प्रमुख गणितीय अवधारणाओं को समझें, विशेषकर मशीन लर्निंग अनुप्रयोगों के लिए।
- उन्नत विषय: मशीन लर्निंग और AI: मॉडल को प्रशिक्षित और मूल्यांकित करें, डीप लर्निंग में उतरें, और AI के फीडबैक लूप्स को समझें।
- व्यावहारिक अनुप्रयोग और प्रोजेक्ट्स: सार्वजनिक या निजी डेटासेट्स का उपयोग कर प्रोजेक्ट लागू करें और प्रदर्शित करें, हैकाथॉन में भाग लें, और विशेषज्ञता दिखाने के लिए पोर्टफोलियो विकसित करें।
- करियर नेविगेशन: ऐसी भूमिकाएँ पहचानें जो आपके कौशल से मेल खाती हों, प्रासंगिक इंटरव्यू प्रश्नों की तैयारी करें, और उद्योग के रुझानों व संसाधनों से अपडेट रहें।
इस रोडमैप का पालन करके, आप डेटा साइंस परिदृश्य में प्रभावी ढंग से आगे बढ़ सकते हैं, आवश्यक कौशल बना सकते हैं, और इस क्षेत्र में एक फलदायी करियर का पीछा कर सकते हैं।
1. डेटा साइंस की बुनियाद समझना
डेटा साइंस क्या है?
डेटा साइंस रोडमैप के संदर्भ को समझने के लिए यह जानना अहम है कि डेटा साइंस क्या है। हमारे पास डेटा साइंस की परिभाषाएँ और व्याख्याएँ कवर करने वाली एक पूरी गाइड है, लेकिन इस लेख के उद्देश्य से, हम डेटा साइंस को उन गतिविधियों के समूह के रूप में मानेंगे जिनका लक्ष्य डेटा का उपयोग करके समस्याओं को हल करना है।
अक्सर अनुभव की जाने वाली समस्या होती है—“मेरे पास एक सवाल है, लेकिन जवाब नहीं मालूम।” तो यदि आप यह पता करने के लिए कि किसी संगठन ने पिछले महीने कितनी आय अर्जित की, सेल्स डेटाबेस पर एक SQL क्वेरी चलाते हैं, तो आप डेटा वैज्ञानिक हैं!
अक्सर समस्याएँ/समाधान अधिक जटिल होते हैं और अधिक विविध कौशल-सेट की आवश्यकता होती है। इस डेटा साइंस रोडमैप में डेटा साइंस की भूमिकाओं और कौशलों की इस विस्तृत श्रृंखला पर चर्चा करने के लिए, हम एक डेटा साइंस प्रोजेक्ट जीवनचक्र को एक समग्र ढाँचे के रूप में लेंगे। इससे हमें विभिन्न गतिविधियों और भूमिकाओं को मैप करने में मदद मिलेगी और डेटा साइंस के परिदृश्य को रेखांकित करने का आधार मिलेगा।
2. डेटा साइंस प्रोजेक्ट जीवनचक्र से परिचित होना
डेटा साइंस प्रोजेक्ट प्रायः किसी व्यावसायिक प्रश्न या समस्या से शुरू होते हैं। एक समस्या आरंभिक चरण को ट्रिगर करती है, जिसमें संभावित समाधानों का एक सेट परिभाषित किया जाता है और प्रारंभिक व्यवहार्यता का आकलन किया जाता है। यह देखने के लिए प्रारंभिक डेटा संग्रह या उपलब्ध डेटा का EDA किया जाता है कि क्या संभव है और क्या नहीं। क्या डेटा पर्याप्त समृद्ध है? क्या इसमें पर्याप्त फीचर्स हैं?
आरंभ और अन्वेषण
जब सभी संकेत हरे हों, तो हम एक प्रेडिक्टिव मॉडल विकसित करना शुरू करते हैं। मॉडल इनपुट का उपयोग करके आउटकम्स की भविष्यवाणी करेगा। शुरू में, यह सिर्फ एक वन-शॉट मॉडल हो सकता है, जिसे k-fold क्रॉस-वैलिडेशन सेट पर ट्रेन, टेस्ट और वैलिडेट किया जाता है (एक मशीन लर्निंग तकनीक जो यह आकलन करती है कि अनदेखे डेटा पर मॉडल कितना अच्छा प्रदर्शन करेगा)। यह काम आमतौर पर क्लासिक डेटा वैज्ञानिकों द्वारा किया जाता है। जब मॉडल पर्याप्त अच्छा प्रदर्शन करने लगे, तो उसे प्रोडक्शन में लगाना और मौजूदा इन्फ्रास्ट्रक्चर में एक पाइपलाइन में रखना शुरू होता है, जहाँ प्रदर्शन की निगरानी की जाएगी और आवश्यकता पड़ने पर मॉडल को पुनः प्रशिक्षित किया जाएगा।
इन प्रत्येक चरणों के लिए अलग-अलग कौशलों की आवश्यकता होती है। आरंभिक चरण के दौरान, लोगों में व्यावसायिक समझ होनी चाहिए, डेटा ट्रांसफॉर्मेशन, क्लीनिंग, वर्णनात्मक सांख्यिकी, और बुनियादी अनुमानात्मक सांख्यिकी से परिचित होना चाहिए। यह काम डेटा एनालिस्ट और/या डेटा वैज्ञानिक कर सकते हैं।
मॉडल विकास और प्रोडक्शनाइज़ेशन
मॉडलिंग चरण में, प्रेडिक्टिव मॉडल बनाने होते हैं। सरल मॉडल, जैसे रिग्रेशन, डेटा एनालिस्ट द्वारा बनाए जा सकते हैं, लेकिन जटिलता बढ़ने पर, आपको एक डेटा वैज्ञानिक की आवश्यकता होगी जो मौजूदा एल्गोरिद्म का उपयोग करके मॉडल बनाए, या यहां तक कि एक मशीन लर्निंग इंजीनियर की जो वर्तमान एल्गोरिद्म में बदलाव करे या नए एल्गोरिद्म बनाए।
मॉडल को डिप्लॉय और प्रोडक्शनाइज़ करते समय, आप मशीन लर्निंग इंजीनियर या डेटा इंजीनियर के दायरे में प्रवेश करते हैं। पहले के चरणों के विपरीत, यहाँ बिज़नेस से जरूरी नहीं कि कड़ा संबंध हो; कार्य प्रेडिक्टिव मॉडल के इर्द-गिर्द एक पाइपलाइन बनाने और उसकी निगरानी करने पर केंद्रित होता है ताकि सही लक्ष्य प्रणालियों को विश्वसनीय आउटपुट मिल सके।
पूरे प्रोसेस में डेटा सही स्थानों पर सही मेटा जानकारी के साथ उपलब्ध होना चाहिए—यही डेटा आर्किटेक्ट की भूमिका है। जैसे-जैसे नया डेटा इन्गेस्ट होता है या मौजूदा डेटा नई जानकारी में परिवर्तित होता है, वे यह सुनिश्चित करते हैं कि डेटा सही जगह पहुँचे।
भूमिका एकीकरण और क्रॉस-फ़ंक्शनल सहयोग
जीवनचक्र के विभिन्न चरणों में अलग-अलग भूमिकाएँ कैसे योगदान देती हैं, यह नीचे की छवि में दर्शाया गया है। चूँकि अलग-अलग भूमिकाएँ अलग-अलग चरणों में योगदान देती हैं, उन्हें अलग-अलग कौशलों की आवश्यकता होती है।
जीवनचक्र की शुरुआत में भूमिकाओं को अधिक व्यावसायिक समझ और कम इंजीनियरिंग की जरूरत होती है, जबकि बाद के चरणों में कम व्यावसायिक समझ और अधिक इंजीनियरिंग व एल्गोरिद्म अनुकूलन की। उदाहरण के लिए, एक डेटा वैज्ञानिक के रूप में, आप अपने मॉडल का मूल्य और प्रदर्शन दिखाने के लिए कम-से-कम आदर्श संगणकीय प्रदर्शन के साथ काम चला सकते हैं। लेकिन जैसे ही आप मॉडलों को प्रोडक्शनाइज़ करने के जिम्मेदार होते हैं, आपको संगणकीय जटिलता को अनुकूलित करने में सक्षम होना चाहिए, ताकि आपकी पाइपलाइन (लागत-)प्रभावी रहे।
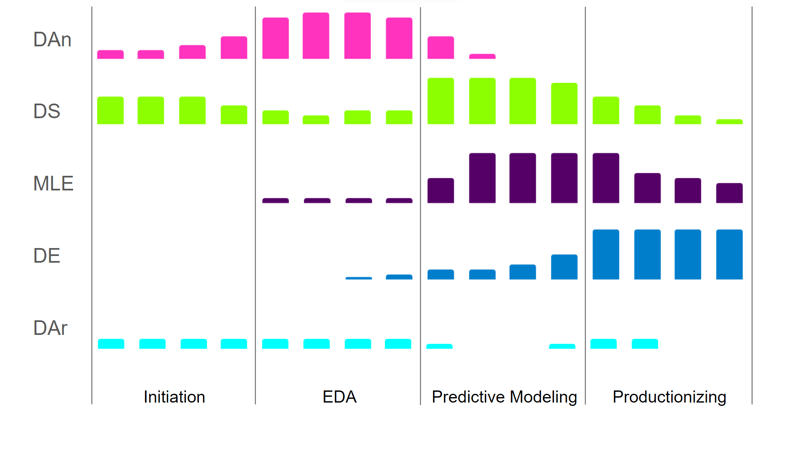
एक डेटा साइंस प्रोजेक्ट के दौरान विभिन्न डेटा साइंस भूमिकाओं का योगदान स्तर (DAn - Data Analyst, DS - Data Scientist, MLE - Machine Learning Engineer, DE - Data Engineer, DAr - Data Architect - लेखक द्वारा छवि
यह जानना महत्वपूर्ण है कि भूमिकाओं के बीच सीमाएँ सख्त नहीं हैं। कई डेटा वैज्ञानिक सही सोर्स/टार्गेट सिस्टम और संगणकीय दक्षता के बारे में पहले से सोचते हैं और उन्हें अपने कोड में शामिल करते हैं। कोई मशीन लर्निंग इंजीनियर यह महसूस कर सकता है कि कुछ फीचर जनरेशन तरीकों से मॉडल का प्रदर्शन बेहतर हो सकता है। कोई डेटा एनालिस्ट डेटा आर्किटेक्ट के लिए यह सलाह दे सकता है कि जनरेट हुए फीचर्स को डेटा कैटलॉग में कहाँ स्टोर किया जाए। यानी, सभी भूमिकाओं को कुछ हद तक दूसरी भूमिकाओं के काम के बारे में जागरूक होना चाहिए, पर उन्हें एक-दूसरे की जिम्मेदारियों को गहराई से समझने की आवश्यकता नहीं है।
जरूरी कौशल और उपकरण
कौशल और टूल्स के संदर्भ में एक स्पष्ट नींव है। डेटा साइंस प्रोजेक्ट के जीवनचक्र में आप जहाँ भी योगदान दें, आपको गणित और सांख्यिकी, सहयोगी सॉफ्टवेयर विकास, और डेटा हेरफेर की बुनियादी समझ चाहिए। व्यापक रूप से, किसी भी डेटा साइंस रोडमैप की शुरुआत में शामिल होते हैं:
- डेटा हेरफेर (ETL जैसे कार्य—जैसा कि SQL, Python या R में सिखाया जाता है),
- (सांख्यिकीय) डेटा विश्लेषण (जैसा कि वर्णनात्मक और कुछ सहसम्बंधीय सांख्यिकी में सिखाया जाता है),
- मशीन लर्निंग (जैसा कि Python या R में सुपरवाइज़्ड लर्निंग में सिखाया जाता है), और
- सहयोगी सॉफ्टवेयर इंजीनियरिंग के लिए वर्ज़निंग (जैसा कि Git में सिखाया जाता है)।
डेटा साइंस की अलग-अलग भूमिकाओं के लिए अलग-अलग कौशल आवश्यकताएँ होती हैं: एक डेटा एनालिस्ट को डेटा इंजीनियर से अधिक गहरी SQL जानकारी चाहिए। एक डेटा वैज्ञानिक को डेटा आर्किटेक्ट से बेहतर मशीन लर्निंग जाननी चाहिए। यहीं से डेटा साइंस रोडमैप विभाजित होता है: डेटा साइंस परिदृश्य में आपकी महत्वाकांक्षाएँ जहाँ भी हों, आपको अलग-अलग कौशल सीखने होंगे। निम्नलिखित अनुभागों में रोडमैप की वे शाखाएँ वर्णित हैं जिन पर आप विचार कर सकते हैं।
3. डेटा विश्लेषण और विज़ुअलाइज़ेशन में गहराई से उतरना
Exploratory Data Analysis (EDA)
आप डेटा साइंस रोडमैप में कितनी भी दूर हों—चाहे आप अनुभवी हों या अभी शुरुआत कर रहे हों—सभी डेटा साइंस प्रोजेक्ट आपकी डेटा को समझने से शुरू होते हैं।
अपने डेटा की गहन समझ आपके प्रोजेक्ट की व्यवहार्यता का आकलन करने के लिए महत्वपूर्ण है। बुनियादी प्रश्नों—‘मेरे पास कौन-से वेरिएबल हैं?’ और ‘मेरे पास कितने ऑब्ज़र्वेशन हैं?’—से शुरुआत करते हुए, अधिक जटिल सवालों तक—‘वेरिएबल्स के बीच संबंध क्या हैं?’—पहुंचें।
अक्सर EDA के परिणाम ही आपके स्टेकहोल्डर्स के सवालों का उत्तर बन सकते हैं। जब उन्हें ठीक से विज़ुअलाइज़ किया जाए और, उदाहरण के लिए, किसी डैशबोर्ड में सुसंगत ढंग से प्रस्तुत किया जाए, तो साधारण डेटा विश्लेषण के नतीजे जटिल प्रश्नों का उत्तर दे सकते हैं। हालाँकि, इसके लिए डेटा विज़ुअलाइज़ेशन कौशल पर निर्भर रहना पड़ता है।
लेकिन केवल अपनी EDA के माध्यम से यह दिखा देना कि, उदाहरण के लिए, वेबसाइट विज़िटर्स के अलग-अलग सेगमेंट मौजूद हैं—आपने डेटा वैज्ञानिक की तरह मूल्य जोड़ा है।
अपने परिणामों को विज़ुअलाइज़ करने के कई तरीके हैं। आप अपनी भाषा की विज़ुअलाइज़ेशन लाइब्रेरी/पैकेज (जैसे R का ggplot2 और Python का matplotlib) का उपयोग कर सकते हैं या समर्पित डेटा विज़ुअलाइज़ेशन टूल्स (जैसे PowerBI, Tableau, या Excel) का।
डेटा विज़ुअलाइज़ेशन में निपुणता
खासकर जब हम डेटा एनालिस्ट के कार्यों पर अधिक ध्यान देते हैं, तो डेटा विज़ुअलाइज़ेशन की गहरी समझ मदद करती है।
अधिकांश डेटा साइंस भूमिकाओं के लिए, विज़ुअलाइज़ेशन स्कैटर प्लॉट्स और हिस्टोग्राम्स के जरिए मान्यताओं की जाँच करने का काम कर सकते हैं, लेकिन जब विश्लेषण स्वयं ही डिलिवरेबल हो—जैसे डेटा एनालिस्ट के लिए—तो आप ऐसी स्थितियों में आएँगे जहाँ आप चाहेंगे कि विश्लेषण के परिणाम आसानी से ग्रहणीय हों।
कस्टम हाउस स्टाइल, नई विज़ुअलाइज़ेशन, या इन्फोग्राफिक्स के बारे में सोचें जो किसी निर्णय लेने वाली इकाई के इनपुट के रूप में काम करें। ऐसी स्थितियों में, ऐसा डेटा विज़ुअलाइज़ेशन बनाने में सक्षम होना उपयोगी है जो व्यावहारिक रूप से एक कलाकृति हो। Understanding Data Visualization एक ऐसा कोर्स है जो आपकी डेटाविज़ क्षमताओं को गहरा करने में वास्तव में मदद करता है।
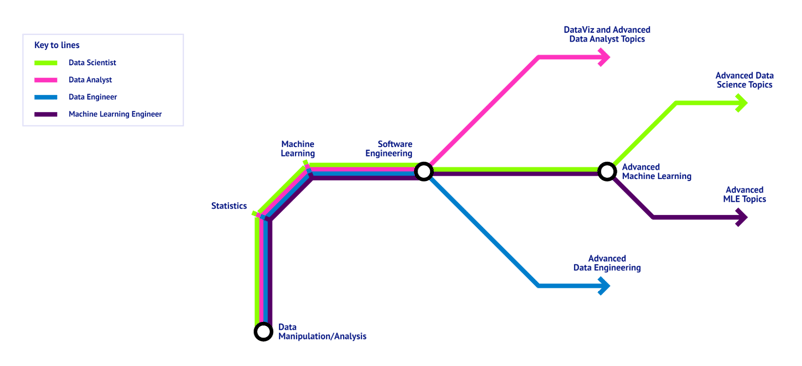
एक डेटा साइंस रोडमैप, मेट्रो मैप के रूप में दृश्यीकृत—जो सभी डेटा साइंस भूमिकाओं की साझा नींव और अलग-अलग भूमिकाओं के विशिष्ट कौशल दिखाता है। - लेखक द्वारा छवि
4. सांख्यिकी और गणित में नींव बनाना
वर्णनात्मक और अनुमानात्मक सांख्यिकी
डेटा साइंस रोडमैप के शुरुआती ठहरावों में से एक सांख्यिकी है। कुछ बुनियादी सांख्यिकीय अवधारणाएँ किसी भी प्रकार के डेटा वैज्ञानिक के लिए सहज होनी चाहिए।
किसी भी समय, आपको अपने डेटा और डेटा के उपसमूहों का वर्णन करने में सक्षम होना चाहिए। आपके डेटासेट में औसत आय क्या है? न्यूनतम और अधिकतम आय क्या है? मानक विचलन क्या है, या फैलाव के अन्य उपाय क्या हैं? और यदि आपके पास श्रेणीबद्ध मान हैं, तो कितने अद्वितीय मान हैं? सबसे अधिक बार कौन-सा आता है? क्या सभी मान समान आवृत्ति से आते हैं, या वितरण कम समान होता है?
समूहों/उप-समूहों पर वर्णनात्मक एनालिटिक्स के साथ प्रश्नों के उत्तर देना पहले से ही मूल्यवान अंतर्दृष्टि दे सकता है, लेकिन अधिकांश समय, आपको अपने डेटासेट में वेरिएबल्स के बीच संबंध देखना होता है और अनुमानात्मक सांख्यिकी की ओर बढ़ना होता है।
अनुमानात्मक सांख्यिकी का चुनौतीपूर्ण और दिलचस्प भाग अलग-अलग प्रकार के श्रेणीबद्ध और संख्यात्मक मान और उनके बीच के संबंध हैं। ऐसे उदाहरण शामिल हैं:
- कोरिलेशन; संख्यात्मक मानों के बीच संबंध, जैसे “उम्र और आय कैसे संबंधित हैं?”
- श्रेणीबद्ध और संख्यात्मक के बीच संबंध, यह जाँचने के लिए: “पुरुषों और महिलाओं की आय कैसे तुलना करती है?” (जहाँ जेंडर श्रेणीबद्ध इनपुट और आय संख्यात्मक लक्ष्य मान है),
- या उल्टा, “क्या अधिक उम्र के लोग तलाकशुदा होने के अधिक सम्भावित हैं?” (जहाँ उम्र संख्यात्मक इनपुट है और तलाकशुदा श्रेणीबद्ध लक्ष्य मान)।
- श्रेणीबद्ध वेरिएबल्स के बीच संबंध, “क्या पुरुषों में तलाक का अनुपात महिलाओं से अधिक है?”
इन प्रश्नों का उत्तर देने के लिए, आपको अलग-अलग प्रकार के सांख्यिकीय परीक्षणों का ज्ञान होना चाहिए—सबसे आसान T-Test से लेकर अधिक जटिल तरीकों जैसे मल्टीवेरिएट लीनियर रिग्रेशन या टाइम सीरीज़ विश्लेषण तक।
आप अपनी सांख्यिकी समझ को गहरा करने के लिए इन प्रासंगिक कोर्सेज़ का अनुसरण कर सकते हैं: Python, R, और यहाँ तक कि टूल-स्वतंत्र। ये कोर्सेज़ मशीन लर्निंग के साथ काम शुरू करने के लिए उपयुक्त आधार प्रदान करते हैं। प्रेडिक्टर्स और टार्गेट वेरिएबल्स के बीच संबंध को सांख्यिकीय रूप से समझकर, आप सुपरवाइज़्ड लर्निंग मॉडल बनाने में प्रयुक्त एल्गोरिद्म के सिद्धांतों को समझते हैं।
आप इस क्षेत्र में कितनी गहराई तक जाना चाहते हैं, यह फिर इस पर निर्भर करता है कि आप डेटा साइंस रोडमैप पर कहाँ जाना चाहते हैं। यदि आपका लक्ष्य डेटा एनालिस्ट बनना है, तो सांख्यिकी की बुनियादी समझ पर्याप्त हो सकती है। डेटा आर्किटेक्ट्स को संभवतः सांख्यिकी का कोई ज्ञान आवश्यक न हो। लेकिन डेटा वैज्ञानिकों और मशीन लर्निंग इंजीनियरों को निश्चित रूप से ऐसी स्थितियाँ मिलेंगी जहाँ उन्हें अपनी सांख्यिकीय विशेषज्ञता पर निर्भर होना पड़ेगा।
डेटा साइंस के लिए गणितीय अवधारणाएँ
डेटा साइंस संख्याओं और गणनाओं के इर्द-गिर्द निर्मित है, और परिणामस्वरूप, गणित की बड़ी भूमिका है। जबकि उन्नत गणित की डिग्री डेटा साइंस रोडमैप पर आवश्यक पड़ाव नहीं है, बीजगणित और कलन (कैलकुलस) को समझना डेटा साइंस में अक्सर प्रयुक्त कई तरीकों को वैचारिक रूप से समझने में मदद करेगा। अधिकांश डाइमेंशनेलिटी रिडक्शन तरीके (जैसे PCA और मैट्रिक्स फैक्टराइज़ेशन) लीनियर अल्जेब्रा पर आधारित हैं, और बहुत से ऑप्टिमाइज़ेशन एल्गोरिद्म (जैसे ग्रेडिएंट डीसेंट) कैलकुलस पर निर्भर करते हैं।
और ठीक वैसे ही जैसे सांख्यिकी और डेटा विश्लेषण के साथ, यह ज्ञान सभी डेटा साइंस भूमिकाओं के लिए जरूरी नहीं है। यदि आपका लक्ष्य मशीन लर्निंग इंजीनियर बनना है, तो गणित से बचना संभव नहीं। लेकिन अधिकांश अन्य भूमिकाएँ—यहाँ तक कि डेटा वैज्ञानिक—बिना गहरे अल्जेब्रा और कैलकुलस ज्ञान के भी काम चला सकते हैं।
बीजगणितीय अवधारणाओं के बारे में और सीखने के लिए हमारा Linear Algebra for Data Science in R कोर्स देखें।
5. उन्नत विषयों की खोज: मशीन लर्निंग और AI
मशीन लर्निंग का परिचय
मशीन लर्निंग वह कला है जिसमें ऐसा सॉफ्टवेयर बनाया जाता है जो डेटा से सीखता है। यह वास्तव में डेटा वैज्ञानिकों, मशीन लर्निंग इंजीनियरों और यहाँ तक कि डेटा इंजीनियरों के लिए मूलभूत साधन है। आपकी समाधान का वह हिस्सा जो आपकी इन्वेंटरी और प्राइसिंग के आधार पर आपकी फर्म के अपेक्षित सेल्स रेवेन्यू देता है? वह मशीन लर्निंग से बना है!
एक डेटा वैज्ञानिक के रूप में आपको न्यूनतम रूप से मॉडल को प्रशिक्षित और मूल्यांकित करने में सक्षम होना चाहिए। कुछ स्थितियों में, आप गहराई में जाकर मौजूदा एल्गोरिद्म में बदलाव करना या नए एल्गोरिद्म लिखना सीखना चाहेंगे—जो मशीन लर्निंग इंजीनियर के दायरे में आता है।
मशीन लर्निंग करने के तरीके में आपके पास काफी आज़ादी है। आप सब कुछ खुद कोड कर सकते हैं (Python, R, C#, या Java में, प्रासंगिक लाइब्रेरी के साथ), आप लोकल सॉफ्टवेयर पैकेज (जैसे Weka और RapidMiner) का उपयोग कर सकते हैं, या क्लाउड समाधान (जैसे Databricks और AWS SageMaker) ले सकते हैं। जबकि इससे यह तय करना मुश्किल हो सकता है कि क्या सीखें, पर जो विशेषज्ञता आप विकसित करते हैं, वह आसानी से ट्रांसफर हो जाती है। तय करने का अच्छा तरीका यह होगा कि या तो उस भाषा से शुरू करें जिसे आप पहले से जानते हैं, या उस उद्योग में देख लें जिसमें आपकी रुचि है कि लोग कौन-से टूल्स उपयोग करते हैं।
आप हमारे Machine Learning Scientist with Python करियर ट्रैक से शुरुआत कर सकते हैं, जो आपके करियर शुरू करने के लिए आवश्यक कई बुनियादों को कवर करता है।
डीप लर्निंग और AI में और गहराई
मशीन लर्निंग, डीप लर्निंग और AI के बीच संबंध बहस का विषय है।
जब मैं मशीन लर्निंग पढ़ाता था, तो मेरी पहली लेक्चर में हमेशा यह कथन—“मशीन लर्निंग AI का एक रूप है”—पर एक जीवंत कक्षा बहस होती थी। जबकि इन्हें कभी-कभी एक-दूसरे के स्थान पर प्रयोग किया जाता है, मैं दृढ़ता से मानता हूँ कि मशीन लर्निंग AI को सक्षम बनाती है, पर इसका यह अर्थ नहीं कि यदि आपने मशीन लर्निंग का उपयोग किया, तो आपने AI बना लिया।
किसी डेटा एप्लिकेशन के AI बनने के लिए यह आवश्यक है कि एक फीडबैक लूप हो जिसमें एप्लिकेशन या मॉडल अपने आउटपुट से सीखता रहे। इस स्थिति में, एक वन-शॉट सुपरवाइज़्ड लर्निंग एल्गोरिद्म जरूरी नहीं कि AI हो। यदि आप मॉडल के आउटपुट को मॉडल में ही फीडबैक करते हैं (जैसे रीइन्फोर्समेंट लर्निंग में), तो आपको AI मिलता है, क्योंकि आपके पास एक ऐसा सिस्टम है जो अपनी सही और गलत भविष्यवाणियों से स्वतः सीखता रहता है।
डीप लर्निंग मूलतः न्यूरल नेटवर्क्स का अधिक शक्तिशाली रूप है। जो चीज़ इसे रोचक बनाती है, वह यह कि डीप लर्निंग बेहद ठोस आउटपुट दे सकता है—ये मॉडल टेक्स्ट, इमेज, और स्पीच आउटपुट कर सकते हैं। यदि आप किसी ऐसे डेटा साइंस प्रोजेक्ट पर काम कर रहे हैं जहाँ यह जरूरी है कि मॉडल ऐसा आउटपुट दे जिसे मानव उपयोगकर्ता देख/सुन/अनुभव कर सकें, तो डीप लर्निंग समझना वास्तविक लाभ हो सकता है। एक शानदार शुरुआती कोर्स है Introduction to Deep Learning in Python।
6. व्यावहारिक अनुप्रयोग और वास्तविक-जीवन प्रोजेक्ट्स
डेटा साइंस प्रोजेक्ट लागू करना
कोई भी डेटा साइंस प्रयास निर्वात में नहीं होता। जैसे-जैसे आप अपने मार्ग पर आगे बढ़ते हैं, यह महत्वपूर्ण है कि आप बनाए गए आर्टिफैक्ट्स को सँभालें और प्रदर्शित करें। डेटा वैज्ञानिक होने का एक हिस्सा यह दिखाने में सक्षम होना है कि आप क्या कर सकते हैं।
मेरे लिए, डेटा साइंस का सबसे रोमांचक हिस्सा यह है कि आपको बहुत कुछ नहीं चाहिए। आपको बस एक सार्वजनिक डेटासेट और एक दिलचस्प सवाल सोचने की रचनात्मकता चाहिए—और फिर डेटा का उपयोग करके उस सवाल का जवाब देना। या आप सीधे DataLab या Kaggle पर जा सकते हैं और असाइनमेंट्स/कॉन्टेस्ट्स पर काम शुरू कर सकते हैं, अन्य सबमिशन से प्रेरणा लेते हुए।
वैकल्पिक रूप से, आप अपना डेटा एकत्र कर सकते हैं और उपयोग कर सकते हैं। मैंने Strava से डाउनलोड किए अपने साइकलिंग डेटा का विश्लेषण किया है और रियल एस्टेट डेटा स्क्रैप किया है ताकि हाउसिंग मार्केट में अपनी खोज में मदद मिल सके।
सबसे महत्वपूर्ण हिस्सा यह है कि आप जो करते हैं उसे डॉक्यूमेंट करें। अपने काम को पुनरुत्पादनीय बनाने की कोशिश करें, जो चरण आपने लिए उन्हें समझाएँ, अपना कोड साझा करें, और अपने विश्लेषण या सिस्टम का आउटपुट साझा करें। कौन जाने—आपका अभ्यास किसी के वास्तविक समस्या का सटीक समाधान हो।
उदाहरण प्रोजेक्ट्स
मेरी राय में सबसे दिलचस्प प्रोजेक्ट वे होते हैं जो आपकी अपनी रुचियों और जुनून से आते हैं। यदि आप किसी ऐसे स्रोत से डेटासेट का उपयोग करते हैं जिसे आप अच्छी तरह जानते हैं, तो संभव है कि आप अनोखे और रोचक सवाल सोच सकें। आप डोमेन जानते हैं, और डेटा भी... लेकिन यदि आप सच में शून्य से शुरू कर रहे हैं, तो शुरू करने के लिए बहुत-सी चीज़ें हैं—जैसे डेटिंग एप्लिकेशन, ट्रेडिंग, खेल।
आप DataCamp पर डेटा साइंस प्रोजेक्ट्स की एक बड़ी रेंज भी पा सकते हैं, जो आपको काम के प्रकार से परिचित कराती है। चाहे कुछ डेटा एनालिटिक्स प्रोजेक्ट्स से शुरुआत करें या विशेष Python प्रोजेक्ट्स पर काम करें, आप आगे चलकर मशीन लर्निंग और यहाँ तक कि AI प्रोजेक्ट्स तक पहुँच सकते हैं। शुरू करने में मदद के लिए पर्याप्त विकल्प हैं।
यदि, उपलब्ध संसाधनों के बावजूद, आप शुरुआत करने का तरीका नहीं ढूँढ पा रहे हैं, तो एक और उपयोगी विकल्प हैकाथॉन में भाग लेना हो सकता है। कई शोध संस्थान और बड़ी कंपनियाँ समय-समय पर हैकाथॉन आयोजित करती हैं।
इन हैकाथॉन का लक्ष्य अक्सर यह होता है कि डेटा वैज्ञानिकों की टीमें किसी प्रासंगिक समस्या पर इनपुट दें, और इस तरह वे अन्य डेटा साइंस पेशेवरों के साथ सहयोग और उनसे सीखने का अवसर प्रदान करते हैं। इससे आप नेटवर्क बना सकते हैं और संभावित नियोक्ताओं की नज़र में आ सकते हैं, साथ ही उपयोगी अनुभव भी मिल सकता है।
पोर्टफोलियो विकास
आजकल ऐसे डेटा वैज्ञानिक की कल्पना करना कठिन है जिसके पास GitHub, DataCamp पोर्टफोलियो, या Medium पेज या कोड के साथ ब्लॉग न हो। जैसे अन्य क्रिएटिव इंडस्ट्रीज़ में, डेटा साइंस में भी पोर्टफोलियो अत्यंत महत्वपूर्ण है।
पिछले प्रोजेक्ट्स प्रदर्शित करना लोगों को यह विश्वास दिलाने का शानदार तरीका है कि आपके पास आवश्यक क्षमताएँ हैं। इसलिए अपने काम को पोर्टफोलियो पर डॉक्यूमेंट करना सार्थक है। वैकल्पिक रूप से, आप अपने काम और विचारों को ब्लॉग पोस्ट्स या यहाँ तक कि अकादमिक प्रकाशनों के रूप में डॉक्यूमेंट कर सकते हैं। प्रेरणा के लिए हमारा पोस्ट देखें: पोर्टफोलियो के साथ अपनी डेटा विशेषज्ञता प्रदर्शित करना।
आप जो भी चुनें, यह सुनिश्चित करें कि आपने जिन प्रोजेक्ट्स पर काम किया है, उनका एक प्रस्तुत करने योग्य अवलोकन बनाए रखें।
7. डेटा साइंस करियर परिदृश्य में मार्गदर्शन
डेटा साइंस में करियर के अवसर
इस पूरे पोस्ट ने डेटा वैज्ञानिक के लिए उपलब्ध अलग-अलग कौशल, ज्ञान, और टूल्स को उजागर किया है। लेकिन करियर तय करते समय कहाँ से शुरू करें?
मेरी राय में, यह वास्तव में आपकी महत्वाकांक्षाओं पर निर्भर करता है। अब तक इस पोस्ट से स्पष्ट होना चाहिए कि मैं एक “वन-साइज़-फिट्स-ऑल” डेटा साइंस रोडमैप में विश्वास नहीं करता।
बेशक, हर डेटा साइंस भूमिका सांख्यिकी, डेटा हेरफेर, मशीन लर्निंग, और सॉफ्टवेयर इंजीनियरिंग की नींव पर आधारित होती है। पर इसके अलावा, वास्तव में यह निर्भर करता है।
एक डेटा वैज्ञानिक एल्गोरिद्म का उपयोग करता है, जबकि मशीन लर्निंग इंजीनियर एल्गोरिद्म में बदलाव करता है या नए एल्गोरिद्म बनाता है। इसलिए डेटा वैज्ञानिक के लिए बहुत-से एल्गोरिद्म और उनके प्रयोजन जानना पर्याप्त हो सकता है, जबकि मशीन लर्निंग इंजीनियर को एल्गोरिद्म के पीछे के गणितीय सिद्धांतों को भली-भाँति समझना होता है।
इसी तरह, यदि आपको विश्लेषण के नतीजे साझा करने से ऊर्जा मिलती है—जैसे डेटा वैज्ञानिक या डेटा एनालिस्ट—तो आपको डेटा विज़ुअलाइज़ेशन और EDA के गहरे ज्ञान से अधिक लाभ होगा, बनिस्बत डेटा मॉडलिंग में अत्यंत कुशल होने के।
इस प्रकार, डेटा साइंस रोडमैप में कई फोर्क्स हैं, और आप खुद तय कर सकते हैं कि डेटा साइंस की अलग-अलग शाखाओं में आप कितनी गहराई तक जाना चाहते हैं।
डेटा साइंस इंटरव्यू की तैयारी
भूमिकाओं के बीच भिन्नताओं के बावजूद, किसी भी इंटरव्यू में आपके हार्ड और सॉफ्ट स्किल्स की जाँच होगी। ये परीक्षण उस भूमिका के अनुरूप अलग-अलग होंगे, जिसके लिए आप आवेदन कर रहे हैं।
यदि आप मशीन लर्निंग या डेटा इंजीनियर जैसी भूमिका नहीं देख रहे हैं, तो आपसे संभवतः ऐसे प्रश्न नहीं पूछे जाएँगे: “आप एल्गोरिद्म A या B को कैसे ऑप्टिमाइज़ करेंगे?” इसलिए यह महत्वपूर्ण है कि आप उन कौशलों पर फोकस करें—और इस प्रकार उन प्रश्नों पर—जिन पर आपसे काम करने की अपेक्षा है और जिन पर आप काम करना चाहते हैं। जिन विषयों से आप परिचित नहीं हैं, उन पर प्रश्न मिलना इस बात का संकेत हो सकता है कि यह भूमिका आपके लिए नहीं है।
क्योंकि इस अपेक्षाकृत नए क्षेत्र में—खासकर उन फर्मों में जहाँ डेटा अपेक्षाकृत नया है—डेटा वैज्ञानिकों के बारे में और वे क्या करते हैं, इस बारे में कई गलत धारणाएँ हैं।
मैंने ऐसे डेटा वैज्ञानिक की भूमिका के लिए आवेदन किया है जहाँ इंटरव्यूअर ने डेटा वैज्ञानिक और मशीन लर्निंग इंजीनियर शब्दों का परस्पर विनिमय किया। यदि आपसे ऐसे प्रश्न पूछे जाते हैं जिनका आप उत्तर नहीं दे पाते, तो यह संभव है कि हायरिंग मैनेजर ने भूमिका को गड़बड़ परिभाषित किया हो। उदाहरण के लिए, किसी डेटा इंजीनियर से शायद ही कभी पूछा जाना चाहिए कि वे किसी प्रोजेक्ट में स्टेकहोल्डर मैनेजमेंट कैसे करेंगे।
सौभाग्य से, जिस भूमिका के लिए आप आवेदन कर रहे हैं, उसके अनुसार इंटरव्यू की तैयारी में मदद के लिए कई संसाधन उपलब्ध हैं:
8. सतत शिक्षा और आजीवन सीखना
रुझानों से अपडेट रहना
डेटा साइंस का क्षेत्र बहुत गतिशील है, और नवीनतम रुझानों से अपडेट रहना महत्वपूर्ण है। ChatGPT के साथ, Generative AI मुख्यधारा में आ गया, और अब ऐसे डेटा वैज्ञानिक की कल्पना करना कठिन है जिसे टोकन एम्बेडिंग्स और/या अटेंशन मॉडल्स की कम-से-कम कुछ समझ न हो। इसी तरह, MLOps के आने से यह सोचना कठिन है कि कोई डेटा इंजीनियर मैन्युअली मॉडल परफॉर्मेंस और ड्रिफ्ट जाँचे।
इस गतिशील विकास के साथ, AI के अलग-अलग पहलू महत्वपूर्ण हो जाते हैं। वर्तमान में, AI के नैतिक और कानूनी पहलुओं पर बहुत ध्यान जा रहा है, जैसा कि कई अकादमिक और राजनीतिक बहसों से स्पष्ट है—जो, अन्य बातों के अलावा, नए नियमों और विनियमों में परिणत हुई हैं।
सरकारों के AI संबंधी निर्णयों से परे, कोई भी डेटा साइंस के अगले घोटाले के लिए जिम्मेदार नहीं बनना चाहता। इससे बचने का एकमात्र तरीका है नैतिक और कानूनी सीमाओं के प्रति जागरूक रहना। या इससे भी बेहतर, एक डेटा साइंस पेशेवर के रूप में, आप अपनी पृष्ठभूमि का उपयोग करके इन विकासों में योगदान दे सकते हैं—राय बनाकर और उसे व्यक्त करके।
अपडेट रहने के कई तरीके हैं। बेशक, DataCamp एक प्लेटफ़ॉर्म के रूप में मौजूद है, पर आप अपने क्षेत्र में प्रेरणादायक डेटा साइंस प्रैक्टिशनर्स को ढूँढकर उन्हें फॉलो भी कर सकते हैं। देखें कि क्या उनके ब्लॉग्स, X या Medium पोस्ट्स हैं—या कुछ और—जहाँ से आप इस बदलते और गतिशील परिदृश्य पर उनकी दृष्टि की झलक पा सकें।
उन्नत सीखने के संसाधन
जैसा कि हमने इस लेख में रेखांकित किया है, डेटा साइंस क्षेत्र में शुरुआत करने या आगे बढ़ने के इच्छुक किसी भी व्यक्ति के लिए कई संसाधन उपलब्ध हैं। वैकल्पिक रूप से, यदि आप वास्तव में सोर्स के करीब रहना चाहते हैं, तो आप NeurIPS, ICML, या KDD जैसी तकनीकी कॉन्फ्रेंस देख सकते हैं। हमारी सूची देखें: 2026 के शीर्ष डेटा साइंस कॉन्फ्रेंस।
निष्कर्ष और अगले कदम
हालाँकि डेटा साइंस रोडमैप पर कई ठहराव हैं, कोई एकल डेटा साइंस पाथवे नहीं है। डेटा साइंस परिदृश्य में नेविगेट करने के लिए आपको 1) परिदृश्य का एक बोध होना चाहिए (जो उम्मीद है कि इस पोस्ट से मिला होगा) और 2) अपनी ताकतों, कमजोरियों और रुचियों का बोध, ताकि आप तय कर सकें कि क्या आगे बढ़ाना है।
यदि आपके पास ये हैं, तो आप इस लेख पर भरोसा कर सकते हैं कि यह आपको सही दिशा में धकेलेगा और आपके प्रशिक्षण के दौरान किन कौशलों पर जोर देना है। सौभाग्य से, शुरू करने के लिए कुछ सहायक संसाधन उपलब्ध हैं, जैसे DataCamp के करियर ट्रैक्स, जो आपको अलग-अलग पेशों की खोज शुरू करने के लिए आवश्यक कौशलों से लैस करते हैं:


चाहे आप छात्र हों, उभरते डेटा वैज्ञानिक हों, या करियर बदलने की सोच रहे किसी पेशेवर—यदि आप अनुभवी डेटा वैज्ञानिक बनना चाहते हैं, तो आपको एक रास्ते का अनुसरण करना होगा। यह हमेशा आसान नहीं होता, क्योंकि डेटा साइंस का परिदृश्य काफी व्यापक हो गया है और परिणामस्वरूप, अलग-अलग प्रकार के डेटा साइंस पेशेवर अलग-अलग गतिविधियों और कौशल-सेट के साथ मौजूद हैं।
डेटा साइंस का मार्ग रेखांकित करने के लिए, यह लेख डेटा साइंस परिदृश्य का एक अवलोकन देता है ताकि आप देख सकें कि कौन-सी भूमिकाएँ आपकी महत्वाकांक्षाओं से मेल खाती हैं। साथ ही, यह इस पर संकेत देता है कि उस परिदृश्य के भीतर अलग-अलग भूमिकाओं में कैसे प्रवेश करें या उनकी ओर कैसे बढ़ें—जैसे: आपको कौन-से कौशल विकसित करने चाहिए और किन विधियों से परिचित होना चाहिए?
आइए, हमारे डेटा साइंस रोडमैप के साथ शुरुआत करते हैं।
संक्षेप में: डेटा साइंस रोडमैप
इस लेख में, हम रोडमैप के सभी पहलुओं में गहराई से उतरते हैं। हालांकि, यदि आप रूपरेखा का एक त्वरित सार देख रहे हैं, तो वह नीचे दिया गया है:
इस रोडमैप का पालन करके, आप डेटा साइंस परिदृश्य में प्रभावी ढंग से आगे बढ़ सकते हैं, आवश्यक कौशल बना सकते हैं, और इस क्षेत्र में एक फलदायी करियर का पीछा कर सकते हैं।
1. डेटा साइंस की बुनियाद समझना
डेटा साइंस क्या है?
डेटा साइंस रोडमैप के संदर्भ को समझने के लिए यह जानना अहम है कि डेटा साइंस क्या है। हमारे पास डेटा साइंस की परिभाषाएँ और व्याख्याएँ कवर करने वाली एक पूरी गाइड है, लेकिन इस लेख के उद्देश्य से, हम डेटा साइंस को उन गतिविधियों के समूह के रूप में मानेंगे जिनका लक्ष्य डेटा का उपयोग करके समस्याओं को हल करना है।
अक्सर अनुभव की जाने वाली समस्या होती है—“मेरे पास एक सवाल है, लेकिन जवाब नहीं मालूम।” तो यदि आप यह पता करने के लिए कि किसी संगठन ने पिछले महीने कितनी आय अर्जित की, सेल्स डेटाबेस पर एक SQL क्वेरी चलाते हैं, तो आप डेटा वैज्ञानिक हैं!
अक्सर समस्याएँ/समाधान अधिक जटिल होते हैं और अधिक विविध कौशल-सेट की आवश्यकता होती है। इस डेटा साइंस रोडमैप में डेटा साइंस की भूमिकाओं और कौशलों की इस विस्तृत श्रृंखला पर चर्चा करने के लिए, हम एक डेटा साइंस प्रोजेक्ट जीवनचक्र को एक समग्र ढाँचे के रूप में लेंगे। इससे हमें विभिन्न गतिविधियों और भूमिकाओं को मैप करने में मदद मिलेगी और डेटा साइंस के परिदृश्य को रेखांकित करने का आधार मिलेगा।
2. डेटा साइंस प्रोजेक्ट जीवनचक्र से परिचित होना
डेटा साइंस प्रोजेक्ट प्रायः किसी व्यावसायिक प्रश्न या समस्या से शुरू होते हैं। एक समस्या आरंभिक चरण को ट्रिगर करती है, जिसमें संभावित समाधानों का एक सेट परिभाषित किया जाता है और प्रारंभिक व्यवहार्यता का आकलन किया जाता है। यह देखने के लिए प्रारंभिक डेटा संग्रह या उपलब्ध डेटा का EDA किया जाता है कि क्या संभव है और क्या नहीं। क्या डेटा पर्याप्त समृद्ध है? क्या इसमें पर्याप्त फीचर्स हैं?
आरंभ और अन्वेषण
जब सभी संकेत हरे हों, तो हम एक प्रेडिक्टिव मॉडल विकसित करना शुरू करते हैं। मॉडल इनपुट का उपयोग करके आउटकम्स की भविष्यवाणी करेगा। शुरू में, यह सिर्फ एक वन-शॉट मॉडल हो सकता है, जिसे k-fold क्रॉस-वैलिडेशन सेट पर ट्रेन, टेस्ट और वैलिडेट किया जाता है (एक मशीन लर्निंग तकनीक जो यह आकलन करती है कि अनदेखे डेटा पर मॉडल कितना अच्छा प्रदर्शन करेगा)। यह काम आमतौर पर क्लासिक डेटा वैज्ञानिकों द्वारा किया जाता है। जब मॉडल पर्याप्त अच्छा प्रदर्शन करने लगे, तो उसे प्रोडक्शन में लगाना और मौजूदा इन्फ्रास्ट्रक्चर में एक पाइपलाइन में रखना शुरू होता है, जहाँ प्रदर्शन की निगरानी की जाएगी और आवश्यकता पड़ने पर मॉडल को पुनः प्रशिक्षित किया जाएगा।
इन प्रत्येक चरणों के लिए अलग-अलग कौशलों की आवश्यकता होती है। आरंभिक चरण के दौरान, लोगों में व्यावसायिक समझ होनी चाहिए, डेटा ट्रांसफॉर्मेशन, क्लीनिंग, वर्णनात्मक सांख्यिकी, और बुनियादी अनुमानात्मक सांख्यिकी से परिचित होना चाहिए। यह काम डेटा एनालिस्ट और/या डेटा वैज्ञानिक कर सकते हैं।
मॉडल विकास और प्रोडक्शनाइज़ेशन
मॉडलिंग चरण में, प्रेडिक्टिव मॉडल बनाने होते हैं। सरल मॉडल, जैसे रिग्रेशन, डेटा एनालिस्ट द्वारा बनाए जा सकते हैं, लेकिन जटिलता बढ़ने पर, आपको एक डेटा वैज्ञानिक की आवश्यकता होगी जो मौजूदा एल्गोरिद्म का उपयोग करके मॉडल बनाए, या यहां तक कि एक मशीन लर्निंग इंजीनियर की जो वर्तमान एल्गोरिद्म में बदलाव करे या नए एल्गोरिद्म बनाए।
मॉडल को डिप्लॉय और प्रोडक्शनाइज़ करते समय, आप मशीन लर्निंग इंजीनियर या डेटा इंजीनियर के दायरे में प्रवेश करते हैं। पहले के चरणों के विपरीत, यहाँ बिज़नेस से जरूरी नहीं कि कड़ा संबंध हो; कार्य प्रेडिक्टिव मॉडल के इर्द-गिर्द एक पाइपलाइन बनाने और उसकी निगरानी करने पर केंद्रित होता है ताकि सही लक्ष्य प्रणालियों को विश्वसनीय आउटपुट मिल सके।
पूरे प्रोसेस में डेटा सही स्थानों पर सही मेटा जानकारी के साथ उपलब्ध होना चाहिए—यही डेटा आर्किटेक्ट की भूमिका है। जैसे-जैसे नया डेटा इन्गेस्ट होता है या मौजूदा डेटा नई जानकारी में परिवर्तित होता है, वे यह सुनिश्चित करते हैं कि डेटा सही जगह पहुँचे।
भूमिका एकीकरण और क्रॉस-फ़ंक्शनल सहयोग
जीवनचक्र के विभिन्न चरणों में अलग-अलग भूमिकाएँ कैसे योगदान देती हैं, यह नीचे की छवि में दर्शाया गया है। चूँकि अलग-अलग भूमिकाएँ अलग-अलग चरणों में योगदान देती हैं, उन्हें अलग-अलग कौशलों की आवश्यकता होती है।
जीवनचक्र की शुरुआत में भूमिकाओं को अधिक व्यावसायिक समझ और कम इंजीनियरिंग की जरूरत होती है, जबकि बाद के चरणों में कम व्यावसायिक समझ और अधिक इंजीनियरिंग व एल्गोरिद्म अनुकूलन की। उदाहरण के लिए, एक डेटा वैज्ञानिक के रूप में, आप अपने मॉडल का मूल्य और प्रदर्शन दिखाने के लिए कम-से-कम आदर्श संगणकीय प्रदर्शन के साथ काम चला सकते हैं। लेकिन जैसे ही आप मॉडलों को प्रोडक्शनाइज़ करने के जिम्मेदार होते हैं, आपको संगणकीय जटिलता को अनुकूलित करने में सक्षम होना चाहिए, ताकि आपकी पाइपलाइन (लागत-)प्रभावी रहे।
एक डेटा साइंस प्रोजेक्ट के दौरान विभिन्न डेटा साइंस भूमिकाओं का योगदान स्तर (DAn - Data Analyst, DS - Data Scientist, MLE - Machine Learning Engineer, DE - Data Engineer, DAr - Data Architect - लेखक द्वारा छवि
यह जानना महत्वपूर्ण है कि भूमिकाओं के बीच सीमाएँ सख्त नहीं हैं। कई डेटा वैज्ञानिक सही सोर्स/टार्गेट सिस्टम और संगणकीय दक्षता के बारे में पहले से सोचते हैं और उन्हें अपने कोड में शामिल करते हैं। कोई मशीन लर्निंग इंजीनियर यह महसूस कर सकता है कि कुछ फीचर जनरेशन तरीकों से मॉडल का प्रदर्शन बेहतर हो सकता है। कोई डेटा एनालिस्ट डेटा आर्किटेक्ट के लिए यह सलाह दे सकता है कि जनरेट हुए फीचर्स को डेटा कैटलॉग में कहाँ स्टोर किया जाए। यानी, सभी भूमिकाओं को कुछ हद तक दूसरी भूमिकाओं के काम के बारे में जागरूक होना चाहिए, पर उन्हें एक-दूसरे की जिम्मेदारियों को गहराई से समझने की आवश्यकता नहीं है।
जरूरी कौशल और उपकरण
कौशल और टूल्स के संदर्भ में एक स्पष्ट नींव है। डेटा साइंस प्रोजेक्ट के जीवनचक्र में आप जहाँ भी योगदान दें, आपको गणित और सांख्यिकी, सहयोगी सॉफ्टवेयर विकास, और डेटा हेरफेर की बुनियादी समझ चाहिए। व्यापक रूप से, किसी भी डेटा साइंस रोडमैप की शुरुआत में शामिल होते हैं:
डेटा साइंस की अलग-अलग भूमिकाओं के लिए अलग-अलग कौशल आवश्यकताएँ होती हैं: एक डेटा एनालिस्ट को डेटा इंजीनियर से अधिक गहरी SQL जानकारी चाहिए। एक डेटा वैज्ञानिक को डेटा आर्किटेक्ट से बेहतर मशीन लर्निंग जाननी चाहिए। यहीं से डेटा साइंस रोडमैप विभाजित होता है: डेटा साइंस परिदृश्य में आपकी महत्वाकांक्षाएँ जहाँ भी हों, आपको अलग-अलग कौशल सीखने होंगे। निम्नलिखित अनुभागों में रोडमैप की वे शाखाएँ वर्णित हैं जिन पर आप विचार कर सकते हैं।
3. डेटा विश्लेषण और विज़ुअलाइज़ेशन में गहराई से उतरना
Exploratory Data Analysis (EDA)
आप डेटा साइंस रोडमैप में कितनी भी दूर हों—चाहे आप अनुभवी हों या अभी शुरुआत कर रहे हों—सभी डेटा साइंस प्रोजेक्ट आपकी डेटा को समझने से शुरू होते हैं।
अपने डेटा की गहन समझ आपके प्रोजेक्ट की व्यवहार्यता का आकलन करने के लिए महत्वपूर्ण है। बुनियादी प्रश्नों—‘मेरे पास कौन-से वेरिएबल हैं?’ और ‘मेरे पास कितने ऑब्ज़र्वेशन हैं?’—से शुरुआत करते हुए, अधिक जटिल सवालों तक—‘वेरिएबल्स के बीच संबंध क्या हैं?’—पहुंचें।
अक्सर EDA के परिणाम ही आपके स्टेकहोल्डर्स के सवालों का उत्तर बन सकते हैं। जब उन्हें ठीक से विज़ुअलाइज़ किया जाए और, उदाहरण के लिए, किसी डैशबोर्ड में सुसंगत ढंग से प्रस्तुत किया जाए, तो साधारण डेटा विश्लेषण के नतीजे जटिल प्रश्नों का उत्तर दे सकते हैं। हालाँकि, इसके लिए डेटा विज़ुअलाइज़ेशन कौशल पर निर्भर रहना पड़ता है।
लेकिन केवल अपनी EDA के माध्यम से यह दिखा देना कि, उदाहरण के लिए, वेबसाइट विज़िटर्स के अलग-अलग सेगमेंट मौजूद हैं—आपने डेटा वैज्ञानिक की तरह मूल्य जोड़ा है।
अपने परिणामों को विज़ुअलाइज़ करने के कई तरीके हैं। आप अपनी भाषा की विज़ुअलाइज़ेशन लाइब्रेरी/पैकेज (जैसे R का ggplot2 और Python का matplotlib) का उपयोग कर सकते हैं या समर्पित डेटा विज़ुअलाइज़ेशन टूल्स (जैसे PowerBI, Tableau, या Excel) का।
डेटा विज़ुअलाइज़ेशन में निपुणता
खासकर जब हम डेटा एनालिस्ट के कार्यों पर अधिक ध्यान देते हैं, तो डेटा विज़ुअलाइज़ेशन की गहरी समझ मदद करती है।
अधिकांश डेटा साइंस भूमिकाओं के लिए, विज़ुअलाइज़ेशन स्कैटर प्लॉट्स और हिस्टोग्राम्स के जरिए मान्यताओं की जाँच करने का काम कर सकते हैं, लेकिन जब विश्लेषण स्वयं ही डिलिवरेबल हो—जैसे डेटा एनालिस्ट के लिए—तो आप ऐसी स्थितियों में आएँगे जहाँ आप चाहेंगे कि विश्लेषण के परिणाम आसानी से ग्रहणीय हों।
कस्टम हाउस स्टाइल, नई विज़ुअलाइज़ेशन, या इन्फोग्राफिक्स के बारे में सोचें जो किसी निर्णय लेने वाली इकाई के इनपुट के रूप में काम करें। ऐसी स्थितियों में, ऐसा डेटा विज़ुअलाइज़ेशन बनाने में सक्षम होना उपयोगी है जो व्यावहारिक रूप से एक कलाकृति हो। Understanding Data Visualization एक ऐसा कोर्स है जो आपकी डेटाविज़ क्षमताओं को गहरा करने में वास्तव में मदद करता है।
एक डेटा साइंस रोडमैप, मेट्रो मैप के रूप में दृश्यीकृत—जो सभी डेटा साइंस भूमिकाओं की साझा नींव और अलग-अलग भूमिकाओं के विशिष्ट कौशल दिखाता है। - लेखक द्वारा छवि
4. सांख्यिकी और गणित में नींव बनाना
वर्णनात्मक और अनुमानात्मक सांख्यिकी
डेटा साइंस रोडमैप के शुरुआती ठहरावों में से एक सांख्यिकी है। कुछ बुनियादी सांख्यिकीय अवधारणाएँ किसी भी प्रकार के डेटा वैज्ञानिक के लिए सहज होनी चाहिए।
किसी भी समय, आपको अपने डेटा और डेटा के उपसमूहों का वर्णन करने में सक्षम होना चाहिए। आपके डेटासेट में औसत आय क्या है? न्यूनतम और अधिकतम आय क्या है? मानक विचलन क्या है, या फैलाव के अन्य उपाय क्या हैं? और यदि आपके पास श्रेणीबद्ध मान हैं, तो कितने अद्वितीय मान हैं? सबसे अधिक बार कौन-सा आता है? क्या सभी मान समान आवृत्ति से आते हैं, या वितरण कम समान होता है?
समूहों/उप-समूहों पर वर्णनात्मक एनालिटिक्स के साथ प्रश्नों के उत्तर देना पहले से ही मूल्यवान अंतर्दृष्टि दे सकता है, लेकिन अधिकांश समय, आपको अपने डेटासेट में वेरिएबल्स के बीच संबंध देखना होता है और अनुमानात्मक सांख्यिकी की ओर बढ़ना होता है।
अनुमानात्मक सांख्यिकी का चुनौतीपूर्ण और दिलचस्प भाग अलग-अलग प्रकार के श्रेणीबद्ध और संख्यात्मक मान और उनके बीच के संबंध हैं। ऐसे उदाहरण शामिल हैं:
इन प्रश्नों का उत्तर देने के लिए, आपको अलग-अलग प्रकार के सांख्यिकीय परीक्षणों का ज्ञान होना चाहिए—सबसे आसान T-Test से लेकर अधिक जटिल तरीकों जैसे मल्टीवेरिएट लीनियर रिग्रेशन या टाइम सीरीज़ विश्लेषण तक।
आप अपनी सांख्यिकी समझ को गहरा करने के लिए इन प्रासंगिक कोर्सेज़ का अनुसरण कर सकते हैं: Python, R, और यहाँ तक कि टूल-स्वतंत्र। ये कोर्सेज़ मशीन लर्निंग के साथ काम शुरू करने के लिए उपयुक्त आधार प्रदान करते हैं। प्रेडिक्टर्स और टार्गेट वेरिएबल्स के बीच संबंध को सांख्यिकीय रूप से समझकर, आप सुपरवाइज़्ड लर्निंग मॉडल बनाने में प्रयुक्त एल्गोरिद्म के सिद्धांतों को समझते हैं।
आप इस क्षेत्र में कितनी गहराई तक जाना चाहते हैं, यह फिर इस पर निर्भर करता है कि आप डेटा साइंस रोडमैप पर कहाँ जाना चाहते हैं। यदि आपका लक्ष्य डेटा एनालिस्ट बनना है, तो सांख्यिकी की बुनियादी समझ पर्याप्त हो सकती है। डेटा आर्किटेक्ट्स को संभवतः सांख्यिकी का कोई ज्ञान आवश्यक न हो। लेकिन डेटा वैज्ञानिकों और मशीन लर्निंग इंजीनियरों को निश्चित रूप से ऐसी स्थितियाँ मिलेंगी जहाँ उन्हें अपनी सांख्यिकीय विशेषज्ञता पर निर्भर होना पड़ेगा।
डेटा साइंस के लिए गणितीय अवधारणाएँ
डेटा साइंस संख्याओं और गणनाओं के इर्द-गिर्द निर्मित है, और परिणामस्वरूप, गणित की बड़ी भूमिका है। जबकि उन्नत गणित की डिग्री डेटा साइंस रोडमैप पर आवश्यक पड़ाव नहीं है, बीजगणित और कलन (कैलकुलस) को समझना डेटा साइंस में अक्सर प्रयुक्त कई तरीकों को वैचारिक रूप से समझने में मदद करेगा। अधिकांश डाइमेंशनेलिटी रिडक्शन तरीके (जैसे PCA और मैट्रिक्स फैक्टराइज़ेशन) लीनियर अल्जेब्रा पर आधारित हैं, और बहुत से ऑप्टिमाइज़ेशन एल्गोरिद्म (जैसे ग्रेडिएंट डीसेंट) कैलकुलस पर निर्भर करते हैं।
और ठीक वैसे ही जैसे सांख्यिकी और डेटा विश्लेषण के साथ, यह ज्ञान सभी डेटा साइंस भूमिकाओं के लिए जरूरी नहीं है। यदि आपका लक्ष्य मशीन लर्निंग इंजीनियर बनना है, तो गणित से बचना संभव नहीं। लेकिन अधिकांश अन्य भूमिकाएँ—यहाँ तक कि डेटा वैज्ञानिक—बिना गहरे अल्जेब्रा और कैलकुलस ज्ञान के भी काम चला सकते हैं।
बीजगणितीय अवधारणाओं के बारे में और सीखने के लिए हमारा Linear Algebra for Data Science in R कोर्स देखें।
5. उन्नत विषयों की खोज: मशीन लर्निंग और AI
मशीन लर्निंग का परिचय
मशीन लर्निंग वह कला है जिसमें ऐसा सॉफ्टवेयर बनाया जाता है जो डेटा से सीखता है। यह वास्तव में डेटा वैज्ञानिकों, मशीन लर्निंग इंजीनियरों और यहाँ तक कि डेटा इंजीनियरों के लिए मूलभूत साधन है। आपकी समाधान का वह हिस्सा जो आपकी इन्वेंटरी और प्राइसिंग के आधार पर आपकी फर्म के अपेक्षित सेल्स रेवेन्यू देता है? वह मशीन लर्निंग से बना है!
एक डेटा वैज्ञानिक के रूप में आपको न्यूनतम रूप से मॉडल को प्रशिक्षित और मूल्यांकित करने में सक्षम होना चाहिए। कुछ स्थितियों में, आप गहराई में जाकर मौजूदा एल्गोरिद्म में बदलाव करना या नए एल्गोरिद्म लिखना सीखना चाहेंगे—जो मशीन लर्निंग इंजीनियर के दायरे में आता है।
मशीन लर्निंग करने के तरीके में आपके पास काफी आज़ादी है। आप सब कुछ खुद कोड कर सकते हैं (Python, R, C#, या Java में, प्रासंगिक लाइब्रेरी के साथ), आप लोकल सॉफ्टवेयर पैकेज (जैसे Weka और RapidMiner) का उपयोग कर सकते हैं, या क्लाउड समाधान (जैसे Databricks और AWS SageMaker) ले सकते हैं। जबकि इससे यह तय करना मुश्किल हो सकता है कि क्या सीखें, पर जो विशेषज्ञता आप विकसित करते हैं, वह आसानी से ट्रांसफर हो जाती है। तय करने का अच्छा तरीका यह होगा कि या तो उस भाषा से शुरू करें जिसे आप पहले से जानते हैं, या उस उद्योग में देख लें जिसमें आपकी रुचि है कि लोग कौन-से टूल्स उपयोग करते हैं।
आप हमारे Machine Learning Scientist with Python करियर ट्रैक से शुरुआत कर सकते हैं, जो आपके करियर शुरू करने के लिए आवश्यक कई बुनियादों को कवर करता है।
डीप लर्निंग और AI में और गहराई
मशीन लर्निंग, डीप लर्निंग और AI के बीच संबंध बहस का विषय है।
जब मैं मशीन लर्निंग पढ़ाता था, तो मेरी पहली लेक्चर में हमेशा यह कथन—“मशीन लर्निंग AI का एक रूप है”—पर एक जीवंत कक्षा बहस होती थी। जबकि इन्हें कभी-कभी एक-दूसरे के स्थान पर प्रयोग किया जाता है, मैं दृढ़ता से मानता हूँ कि मशीन लर्निंग AI को सक्षम बनाती है, पर इसका यह अर्थ नहीं कि यदि आपने मशीन लर्निंग का उपयोग किया, तो आपने AI बना लिया।
किसी डेटा एप्लिकेशन के AI बनने के लिए यह आवश्यक है कि एक फीडबैक लूप हो जिसमें एप्लिकेशन या मॉडल अपने आउटपुट से सीखता रहे। इस स्थिति में, एक वन-शॉट सुपरवाइज़्ड लर्निंग एल्गोरिद्म जरूरी नहीं कि AI हो। यदि आप मॉडल के आउटपुट को मॉडल में ही फीडबैक करते हैं (जैसे रीइन्फोर्समेंट लर्निंग में), तो आपको AI मिलता है, क्योंकि आपके पास एक ऐसा सिस्टम है जो अपनी सही और गलत भविष्यवाणियों से स्वतः सीखता रहता है।
डीप लर्निंग मूलतः न्यूरल नेटवर्क्स का अधिक शक्तिशाली रूप है। जो चीज़ इसे रोचक बनाती है, वह यह कि डीप लर्निंग बेहद ठोस आउटपुट दे सकता है—ये मॉडल टेक्स्ट, इमेज, और स्पीच आउटपुट कर सकते हैं। यदि आप किसी ऐसे डेटा साइंस प्रोजेक्ट पर काम कर रहे हैं जहाँ यह जरूरी है कि मॉडल ऐसा आउटपुट दे जिसे मानव उपयोगकर्ता देख/सुन/अनुभव कर सकें, तो डीप लर्निंग समझना वास्तविक लाभ हो सकता है। एक शानदार शुरुआती कोर्स है Introduction to Deep Learning in Python।
6. व्यावहारिक अनुप्रयोग और वास्तविक-जीवन प्रोजेक्ट्स
डेटा साइंस प्रोजेक्ट लागू करना
कोई भी डेटा साइंस प्रयास निर्वात में नहीं होता। जैसे-जैसे आप अपने मार्ग पर आगे बढ़ते हैं, यह महत्वपूर्ण है कि आप बनाए गए आर्टिफैक्ट्स को सँभालें और प्रदर्शित करें। डेटा वैज्ञानिक होने का एक हिस्सा यह दिखाने में सक्षम होना है कि आप क्या कर सकते हैं।
मेरे लिए, डेटा साइंस का सबसे रोमांचक हिस्सा यह है कि आपको बहुत कुछ नहीं चाहिए। आपको बस एक सार्वजनिक डेटासेट और एक दिलचस्प सवाल सोचने की रचनात्मकता चाहिए—और फिर डेटा का उपयोग करके उस सवाल का जवाब देना। या आप सीधे DataLab या Kaggle पर जा सकते हैं और असाइनमेंट्स/कॉन्टेस्ट्स पर काम शुरू कर सकते हैं, अन्य सबमिशन से प्रेरणा लेते हुए।
वैकल्पिक रूप से, आप अपना डेटा एकत्र कर सकते हैं और उपयोग कर सकते हैं। मैंने Strava से डाउनलोड किए अपने साइकलिंग डेटा का विश्लेषण किया है और रियल एस्टेट डेटा स्क्रैप किया है ताकि हाउसिंग मार्केट में अपनी खोज में मदद मिल सके।
सबसे महत्वपूर्ण हिस्सा यह है कि आप जो करते हैं उसे डॉक्यूमेंट करें। अपने काम को पुनरुत्पादनीय बनाने की कोशिश करें, जो चरण आपने लिए उन्हें समझाएँ, अपना कोड साझा करें, और अपने विश्लेषण या सिस्टम का आउटपुट साझा करें। कौन जाने—आपका अभ्यास किसी के वास्तविक समस्या का सटीक समाधान हो।
उदाहरण प्रोजेक्ट्स
मेरी राय में सबसे दिलचस्प प्रोजेक्ट वे होते हैं जो आपकी अपनी रुचियों और जुनून से आते हैं। यदि आप किसी ऐसे स्रोत से डेटासेट का उपयोग करते हैं जिसे आप अच्छी तरह जानते हैं, तो संभव है कि आप अनोखे और रोचक सवाल सोच सकें। आप डोमेन जानते हैं, और डेटा भी... लेकिन यदि आप सच में शून्य से शुरू कर रहे हैं, तो शुरू करने के लिए बहुत-सी चीज़ें हैं—जैसे डेटिंग एप्लिकेशन, ट्रेडिंग, खेल।
आप DataCamp पर डेटा साइंस प्रोजेक्ट्स की एक बड़ी रेंज भी पा सकते हैं, जो आपको काम के प्रकार से परिचित कराती है। चाहे कुछ डेटा एनालिटिक्स प्रोजेक्ट्स से शुरुआत करें या विशेष Python प्रोजेक्ट्स पर काम करें, आप आगे चलकर मशीन लर्निंग और यहाँ तक कि AI प्रोजेक्ट्स तक पहुँच सकते हैं। शुरू करने में मदद के लिए पर्याप्त विकल्प हैं।
यदि, उपलब्ध संसाधनों के बावजूद, आप शुरुआत करने का तरीका नहीं ढूँढ पा रहे हैं, तो एक और उपयोगी विकल्प हैकाथॉन में भाग लेना हो सकता है। कई शोध संस्थान और बड़ी कंपनियाँ समय-समय पर हैकाथॉन आयोजित करती हैं।
इन हैकाथॉन का लक्ष्य अक्सर यह होता है कि डेटा वैज्ञानिकों की टीमें किसी प्रासंगिक समस्या पर इनपुट दें, और इस तरह वे अन्य डेटा साइंस पेशेवरों के साथ सहयोग और उनसे सीखने का अवसर प्रदान करते हैं। इससे आप नेटवर्क बना सकते हैं और संभावित नियोक्ताओं की नज़र में आ सकते हैं, साथ ही उपयोगी अनुभव भी मिल सकता है।
पोर्टफोलियो विकास
आजकल ऐसे डेटा वैज्ञानिक की कल्पना करना कठिन है जिसके पास GitHub, DataCamp पोर्टफोलियो, या Medium पेज या कोड के साथ ब्लॉग न हो। जैसे अन्य क्रिएटिव इंडस्ट्रीज़ में, डेटा साइंस में भी पोर्टफोलियो अत्यंत महत्वपूर्ण है।
पिछले प्रोजेक्ट्स प्रदर्शित करना लोगों को यह विश्वास दिलाने का शानदार तरीका है कि आपके पास आवश्यक क्षमताएँ हैं। इसलिए अपने काम को पोर्टफोलियो पर डॉक्यूमेंट करना सार्थक है। वैकल्पिक रूप से, आप अपने काम और विचारों को ब्लॉग पोस्ट्स या यहाँ तक कि अकादमिक प्रकाशनों के रूप में डॉक्यूमेंट कर सकते हैं। प्रेरणा के लिए हमारा पोस्ट देखें: पोर्टफोलियो के साथ अपनी डेटा विशेषज्ञता प्रदर्शित करना।
आप जो भी चुनें, यह सुनिश्चित करें कि आपने जिन प्रोजेक्ट्स पर काम किया है, उनका एक प्रस्तुत करने योग्य अवलोकन बनाए रखें।
7. डेटा साइंस करियर परिदृश्य में मार्गदर्शन
डेटा साइंस में करियर के अवसर
इस पूरे पोस्ट ने डेटा वैज्ञानिक के लिए उपलब्ध अलग-अलग कौशल, ज्ञान, और टूल्स को उजागर किया है। लेकिन करियर तय करते समय कहाँ से शुरू करें?
मेरी राय में, यह वास्तव में आपकी महत्वाकांक्षाओं पर निर्भर करता है। अब तक इस पोस्ट से स्पष्ट होना चाहिए कि मैं एक “वन-साइज़-फिट्स-ऑल” डेटा साइंस रोडमैप में विश्वास नहीं करता।
बेशक, हर डेटा साइंस भूमिका सांख्यिकी, डेटा हेरफेर, मशीन लर्निंग, और सॉफ्टवेयर इंजीनियरिंग की नींव पर आधारित होती है। पर इसके अलावा, वास्तव में यह निर्भर करता है।
एक डेटा वैज्ञानिक एल्गोरिद्म का उपयोग करता है, जबकि मशीन लर्निंग इंजीनियर एल्गोरिद्म में बदलाव करता है या नए एल्गोरिद्म बनाता है। इसलिए डेटा वैज्ञानिक के लिए बहुत-से एल्गोरिद्म और उनके प्रयोजन जानना पर्याप्त हो सकता है, जबकि मशीन लर्निंग इंजीनियर को एल्गोरिद्म के पीछे के गणितीय सिद्धांतों को भली-भाँति समझना होता है।
इसी तरह, यदि आपको विश्लेषण के नतीजे साझा करने से ऊर्जा मिलती है—जैसे डेटा वैज्ञानिक या डेटा एनालिस्ट—तो आपको डेटा विज़ुअलाइज़ेशन और EDA के गहरे ज्ञान से अधिक लाभ होगा, बनिस्बत डेटा मॉडलिंग में अत्यंत कुशल होने के।
इस प्रकार, डेटा साइंस रोडमैप में कई फोर्क्स हैं, और आप खुद तय कर सकते हैं कि डेटा साइंस की अलग-अलग शाखाओं में आप कितनी गहराई तक जाना चाहते हैं।
डेटा साइंस इंटरव्यू की तैयारी
भूमिकाओं के बीच भिन्नताओं के बावजूद, किसी भी इंटरव्यू में आपके हार्ड और सॉफ्ट स्किल्स की जाँच होगी। ये परीक्षण उस भूमिका के अनुरूप अलग-अलग होंगे, जिसके लिए आप आवेदन कर रहे हैं।
यदि आप मशीन लर्निंग या डेटा इंजीनियर जैसी भूमिका नहीं देख रहे हैं, तो आपसे संभवतः ऐसे प्रश्न नहीं पूछे जाएँगे: “आप एल्गोरिद्म A या B को कैसे ऑप्टिमाइज़ करेंगे?” इसलिए यह महत्वपूर्ण है कि आप उन कौशलों पर फोकस करें—और इस प्रकार उन प्रश्नों पर—जिन पर आपसे काम करने की अपेक्षा है और जिन पर आप काम करना चाहते हैं। जिन विषयों से आप परिचित नहीं हैं, उन पर प्रश्न मिलना इस बात का संकेत हो सकता है कि यह भूमिका आपके लिए नहीं है।
क्योंकि इस अपेक्षाकृत नए क्षेत्र में—खासकर उन फर्मों में जहाँ डेटा अपेक्षाकृत नया है—डेटा वैज्ञानिकों के बारे में और वे क्या करते हैं, इस बारे में कई गलत धारणाएँ हैं।
मैंने ऐसे डेटा वैज्ञानिक की भूमिका के लिए आवेदन किया है जहाँ इंटरव्यूअर ने डेटा वैज्ञानिक और मशीन लर्निंग इंजीनियर शब्दों का परस्पर विनिमय किया। यदि आपसे ऐसे प्रश्न पूछे जाते हैं जिनका आप उत्तर नहीं दे पाते, तो यह संभव है कि हायरिंग मैनेजर ने भूमिका को गड़बड़ परिभाषित किया हो। उदाहरण के लिए, किसी डेटा इंजीनियर से शायद ही कभी पूछा जाना चाहिए कि वे किसी प्रोजेक्ट में स्टेकहोल्डर मैनेजमेंट कैसे करेंगे।
सौभाग्य से, जिस भूमिका के लिए आप आवेदन कर रहे हैं, उसके अनुसार इंटरव्यू की तैयारी में मदद के लिए कई संसाधन उपलब्ध हैं:
8. सतत शिक्षा और आजीवन सीखना
रुझानों से अपडेट रहना
डेटा साइंस का क्षेत्र बहुत गतिशील है, और नवीनतम रुझानों से अपडेट रहना महत्वपूर्ण है। ChatGPT के साथ, Generative AI मुख्यधारा में आ गया, और अब ऐसे डेटा वैज्ञानिक की कल्पना करना कठिन है जिसे टोकन एम्बेडिंग्स और/या अटेंशन मॉडल्स की कम-से-कम कुछ समझ न हो। इसी तरह, MLOps के आने से यह सोचना कठिन है कि कोई डेटा इंजीनियर मैन्युअली मॉडल परफॉर्मेंस और ड्रिफ्ट जाँचे।
इस गतिशील विकास के साथ, AI के अलग-अलग पहलू महत्वपूर्ण हो जाते हैं। वर्तमान में, AI के नैतिक और कानूनी पहलुओं पर बहुत ध्यान जा रहा है, जैसा कि कई अकादमिक और राजनीतिक बहसों से स्पष्ट है—जो, अन्य बातों के अलावा, नए नियमों और विनियमों में परिणत हुई हैं।
सरकारों के AI संबंधी निर्णयों से परे, कोई भी डेटा साइंस के अगले घोटाले के लिए जिम्मेदार नहीं बनना चाहता। इससे बचने का एकमात्र तरीका है नैतिक और कानूनी सीमाओं के प्रति जागरूक रहना। या इससे भी बेहतर, एक डेटा साइंस पेशेवर के रूप में, आप अपनी पृष्ठभूमि का उपयोग करके इन विकासों में योगदान दे सकते हैं—राय बनाकर और उसे व्यक्त करके।
अपडेट रहने के कई तरीके हैं। बेशक, DataCamp एक प्लेटफ़ॉर्म के रूप में मौजूद है, पर आप अपने क्षेत्र में प्रेरणादायक डेटा साइंस प्रैक्टिशनर्स को ढूँढकर उन्हें फॉलो भी कर सकते हैं। देखें कि क्या उनके ब्लॉग्स, X या Medium पोस्ट्स हैं—या कुछ और—जहाँ से आप इस बदलते और गतिशील परिदृश्य पर उनकी दृष्टि की झलक पा सकें।
उन्नत सीखने के संसाधन
जैसा कि हमने इस लेख में रेखांकित किया है, डेटा साइंस क्षेत्र में शुरुआत करने या आगे बढ़ने के इच्छुक किसी भी व्यक्ति के लिए कई संसाधन उपलब्ध हैं। वैकल्पिक रूप से, यदि आप वास्तव में सोर्स के करीब रहना चाहते हैं, तो आप NeurIPS, ICML, या KDD जैसी तकनीकी कॉन्फ्रेंस देख सकते हैं। हमारी सूची देखें: 2026 के शीर्ष डेटा साइंस कॉन्फ्रेंस।
निष्कर्ष और अगले कदम
हालाँकि डेटा साइंस रोडमैप पर कई ठहराव हैं, कोई एकल डेटा साइंस पाथवे नहीं है। डेटा साइंस परिदृश्य में नेविगेट करने के लिए आपको 1) परिदृश्य का एक बोध होना चाहिए (जो उम्मीद है कि इस पोस्ट से मिला होगा) और 2) अपनी ताकतों, कमजोरियों और रुचियों का बोध, ताकि आप तय कर सकें कि क्या आगे बढ़ाना है।
यदि आपके पास ये हैं, तो आप इस लेख पर भरोसा कर सकते हैं कि यह आपको सही दिशा में धकेलेगा और आपके प्रशिक्षण के दौरान किन कौशलों पर जोर देना है। सौभाग्य से, शुरू करने के लिए कुछ सहायक संसाधन उपलब्ध हैं, जैसे DataCamp के करियर ट्रैक्स, जो आपको अलग-अलग पेशों की खोज शुरू करने के लिए आवश्यक कौशलों से लैस करते हैं: