Kurs
Einführung in die Claude-Modelle
3 Std.
14.7K
Ein Claude-Cowork-Plugin ist ein installierbares Paket, das alles bündelt, was Claude braucht, um wie ein Spezialist zu arbeiten. Es enthält zum Beispiel Workflow-Skills, Slash-Befehle, passende Connectoren sowie nötige Sub-Agents und Hooks. Anthropics Launch-Post fasst es in einem Satz zusammen:
"Plugins let you bundle any skills, connectors, slash commands, and sub-agents together to turn Claude into a specialist for your role, team, and company."
Plugins kamen am 30. Januar 2026 als Research Preview für zahlende Nutzer in Cowork, zusammen mit 11 Open-Source-Plugins aus Anthropics eigenen Teams. Eine zweite Welle am 24. Februar 2026 brachte Plugins für HR, Design, Engineering, Operations und Finanzanalyse, 4 Plugins für Finanzdienstleistungen, Partner-Plugins von Slack, S&P Global und LSEG sowie strukturierte Formulare für Slash-Befehle. Cowork selbst verließ die Preview-Phase und wurde am 9. April 2026 allgemein verfügbar.
Wo Plugins laufen, führt oft zu Verwirrung, daher hier die aktuelle Antwort aus Anthropics Help-Center-Artikel zu Plugins. Ein Plugin, das du hinzufügst, wird in deinem Claude-Account gespeichert, nicht auf deinem Computer. Es begleitet dich also in den Webchat, in die Desktop-App, nach Cowork und in Claude Code (ab Version 2.1.273 wird es automatisch synchronisiert). Skills und Commands funktionieren überall, während Hooks und Sub-Agents nur in Cowork und Claude Code laufen und im Chat ausgegraut erscheinen.
Wenn du Cowork selbst noch nicht genutzt hast, führt dich unser Claude-Cowork-Tutorial durch die App, und der Vergleich Claude Cowork vs. Claude Code erklärt, warum dasselbe Plugin in einem der beiden mehr kann. Cowork erkläre ich hier nicht erneut.
Die Tabelle unten listet die 5 Komponenten, die ein Plugin enthalten kann, was sie tun und wann sie ausgelöst werden.
|
Komponente |
Aufgabe |
Auslöser |
|
Skill |
Eine |
Automatisch, wenn Claude die Aufgabe als passend zur Skill-Beschreibung einstuft. Du kannst ihn auch per Namen nach |
|
Slash-Befehl |
Eine benannte Aktion mit eigenen Anweisungen, z. B. |
Manuell, wenn du ihn tippst. In Cowork kann Claude vor dem Start eine strukturierte Frage stellen. |
|
Connector (MCP) |
Eine Anbindung an einen externen Dienst über das Model Context Protocol (MCP): Snowflake, BigQuery, Slack und Hunderte mehr |
Wenn Claude eines der Tools des Dienstes aufruft, nachdem du den Dienst einmal verbunden hast. |
|
Sub-Agent |
Ein Spezialist, an den Claude einen Teil einer Aufgabe delegieren kann, mit eigenem Prompt und eigener Tool-Liste |
Wenn Claude zu delegieren entscheidet. Nur in Cowork und Claude Code. |
|
Hook |
Ein Skript oder Prompt, der bei einem Session-Ereignis läuft, z. B. direkt vor einem Tool-Aufruf |
Bei jedem Auftreten dieses Ereignisses. Nur in Cowork und Claude Code. |
Skills werden ausgelöst, wenn Claude sie als relevant einstuft, und Commands, wenn du / tippst. Diese Unterscheidung entscheidet, was du prüfen solltest, wenn ein Plugin scheinbar nichts tut – dazu komme ich im Verifizierungs-Abschnitt zurück. Wenn Sub-Agents neu für dich sind, deckt unser Kurs Introduction to AI Agents das Delegationsmuster ohne Code ab.
Ein Skill bringt Claude eine einzelne Aufgabe in einer SKILL.md-Datei bei. Ein Plugin ist das paketierte Set aus Skills, Befehlen und Connectoren für eine ganze Rolle. So enthält das Data-Plugin 10 Skills; installiert wird das Plugin, bearbeiten wirst du in der Regel den einzelnen Skill. Unser Leitfaden zu Claude Skills geht bei Bedarf detailliert auf das Skill-Format ein.
Cowork-Plugins kommen aus 3 Quellen, und die erste nutzt du für den Großteil dieses Artikels:
Zwei weitere Installationswege gibt es: Füge jede Git-Repository-URL als Marketplace hinzu (per URL oder owner/repo-Kurzform; GitHub, GitHub Enterprise sowie öffentliche GitLab- und Bitbucket-Repos funktionieren) oder lade ein Plugin direkt als .zip- oder .plugin-Archiv bis 200 MB hoch.
Die Rollenpalette deckt vieles ab: Produktivität, Vertrieb, Kundensupport, Produktmanagement, Marketing, Legal, Finanzen, Data, Enterprise Search, HR, Design, Engineering, Operations, Bioforschung und KMU – plus Partner-Plugins. Das hier ist kein Roundup: Wähle das passende für deinen Job und lies weiter.
Ein Cowork-Plugin ist ein Ordner mit einem Manifest in einem versteckten Unterordner und allen übrigen Dateien auf Top-Level. Hier ist die komplette Struktur, mit den Komponenten; nur einige Oberflächen werden wie markiert geladen:
my-plugin/
├── .claude-plugin/
│   └── plugin.json          # manifest (required)
├── skills/
│   └── <name>/SKILL.md      # skills: auto-triggered knowledge & named actions
├── commands/
│   └── <name>.md            # legacy single-file slash commands (still work)
├── agents/
│   └── <name>.md            # sub-agents (Cowork and Claude Code only)
├── hooks/
│   └── hooks.json           # hooks (Cowork and Claude Code only)
├── .mcp.json                # connectors
└── README.md
Behalte diesen Baum im Kopf, denn in Schritt 4 bauen wir die obere Hälfte Datei für Datei. Die Abbildung unten verknüpft den Baum mit den Laufumgebungen, basierend auf Anthropics Plattform-Support-Tabelle.
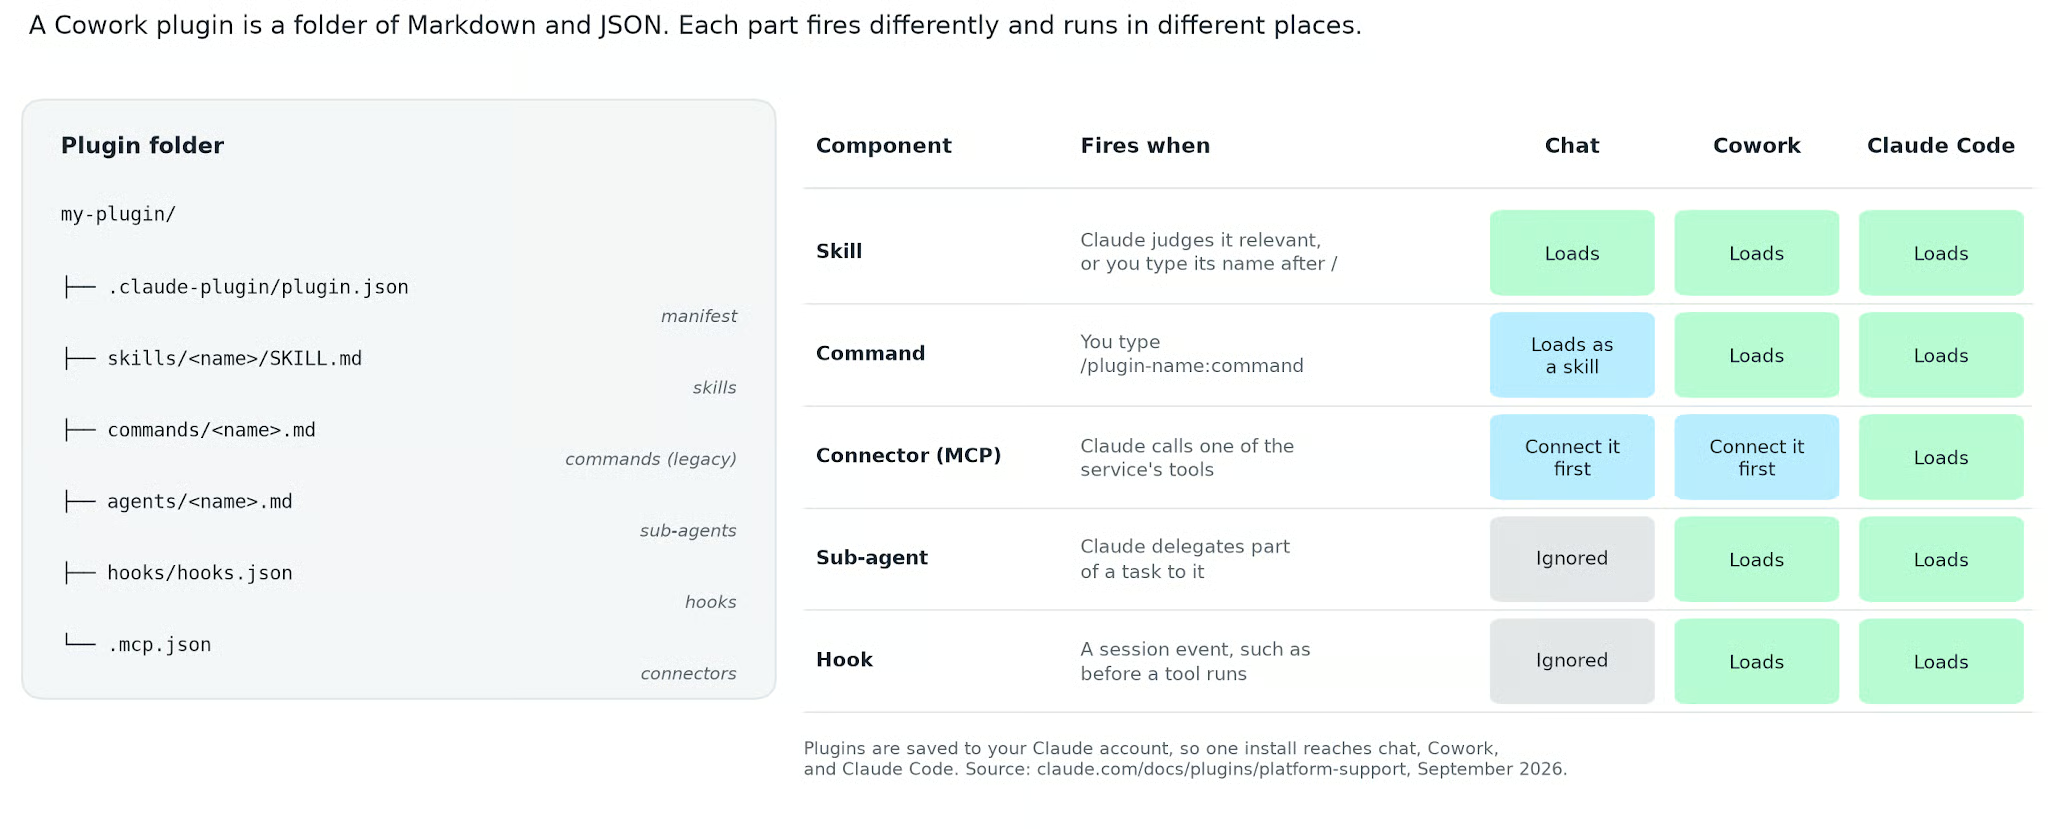
Abbildung 1. Links der Plugin-Ordner; rechts je Komponente, wann sie auslöst und ob Chat, Cowork oder Claude Code sie lädt. Bild: Autor.
Das Manifest liegt unter .claude-plugin/plugin.json, und name ist das einzige Pflichtfeld. Hier ist das echte Manifest von Anthropics Data-Plugin (aus dem Repository):
{
  "name": "data",
  "version": "1.1.0",
  "description": "Write SQL, explore datasets, and generate insights faster. Build visualizations and dashboards, and turn raw data into clear stories for stakeholders.",
  "author": {
    "name": "Anthropic"
  }
}
Drei Dinge sind wichtig:
name ist die dauerhafte Identität des Plugins und präfixiert jede Komponente. Der Skill write-query wird z. B. zu /data:write-query.
version ist die sichtbare Release-Nummer des Plugins. Anthropics Build-Guide sagt, sie bei jedem Release zu erhöhen.
Optionale Felder sind u. a. displayName, license, homepage und keywords.
Ein Skill liegt unter skills/<name>/SKILL.md: oben ein kurzer Block mit Einstellungen zwischen --- (YAML-Frontmatter), darunter Anweisungen für Claude. Hier ist der Anfang des write-query-Skills des Data-Plugins, den ich in Schritt 2 ausführe:
---
name: write-query
description: Write optimized SQL for your dialect with best practices. Use when translating a natural-language data need into SQL, building a multi-CTE query with joins and aggregations, optimizing a query against a large partitioned table, or getting dialect-specific syntax for Snowflake, BigQuery, Postgres, etc.
argument-hint: "<description of what data you need>"
---

# /write-query - Write Optimized SQL
Die description liest Claude, um zu entscheiden, ob der Skill geladen wird, und der argument-hint sagt dir, welche Eingabe erwartet ist. Zwei Frontmatter-Flags ändern, wie ein Skill auslöst:
user-invocable: false versteckt ihn im /-Menü, sodass nur Claude ihn lädt (beim Plugin ist z. B. sql-queries so gesetzt)
disable-model-invocation: true kehrt es um: Der Skill läuft nur, wenn du seinen Namen tippst.
Commands sind das ältere Format: eine Markdown-Datei unter commands/<name>.md mit description in der Frontmatter. Anthropics eigener Authoring-Skill weist Claude inzwischen an, „neue Plugins mit skills/*/SKILL.md zu erstellen“, und nennt den Ordner commands/ „Legacy“, weil Cowork beide unter Skills zusammenführt. Commands laden weiterhin überall, du wirst sie also in älteren Plugins oft sehen – in Schritt 4 nutzen wir Skills.
Die Datei .mcp.json im Plugin-Root listet die externen Dienste, die das Plugin erreichen kann, jeweils als MCP-Server-URL. Hier sind die ersten 3 Einträge aus der Data-Plugin-Datei:
{
  "mcpServers": {
    "snowflake": {
      "type": "http",
      "url": ""
    },
    "databricks": {
      "type": "http",
      "url": ""
    },
    "bigquery": {
      "type": "http",
      "url": "https://bigquery.googleapis.com/mcp"
    },
Die leeren URLs sind Platzhalter: Anthropic liefert den BigQuery-Endpunkt mit, lässt Snowflake und Databricks aber offen, damit du deine Serveradresse einträgst. Falls MCP neu ist, zeigt unser Model-Context-Protocol-Guide, wie man einen Server von Grund auf baut.
Eine nicht offensichtliche Einschränkung: Das Help Center sagt, „in Cowork greifen Connectoren über Anthropics Cloud auf externe Dienste zu, nicht über dein lokales Netzwerk.“ Ein Custom-Connector muss daher auf einen Server zeigen, der „aus dem öffentlichen Internet von Anthropics IP-Bereichen erreichbar ist“. Ein Warehouse hinter Firewall oder VPN verbindet erst, wenn euer Netzwerkteam Anthropics Adressen allowlistet.
Lokale MCP-Server, die ein Programm auf deinem Rechner starten, sind die Ausnahme: Sie laufen in Claude Code und in Cowork-Sessions, die auf deinem Computer laufen; der Chat ignoriert sie.
Seit dem 6. Oktober 2026 laufen neue Pro- und Max-Aufgaben nur in Anthropics Cloud. Lokale Sessions sind damit vor allem ein Feature für Team und Enterprise.
Die Installation eines Cowork-Plugins dauert 6 kurze Schritte auf der Customize-Seite, identisch für jedes Plugin im Katalog – Vertrieb oder Legal können einfach ihr Plugin wählen. Ich nutze das Data-Plugin, weil es das SQL-Beispiel in Schritt 2 vorbereitet.
1. Öffne Customize in der linken Sidebar der Claude-Desktop-App. Wenn deine App noch einen Cowork-Tab hat, öffne den zuerst.
2. Öffne den Tab Plugins.
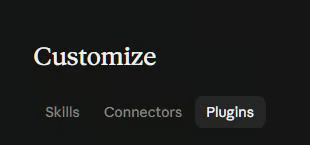
3. Stelle sicher, dass du den Knowledge-Work-Marketplace hast. Klicke + Add, dann Add marketplace und Browse Anthropic sources.
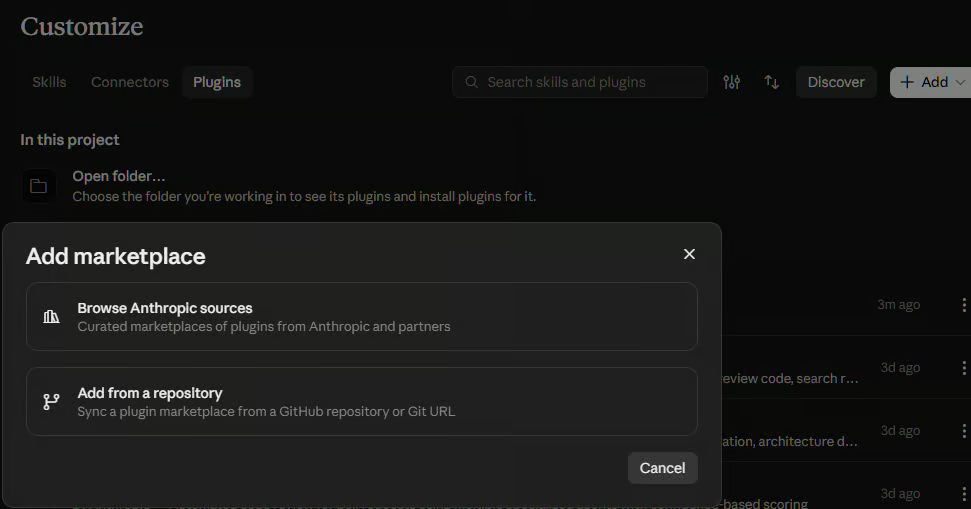
4. Wähle die Knowledge-Work-Plugins aus und füge sie hinzu.
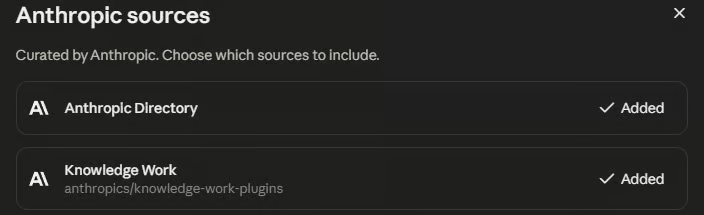
5. Öffne den Tab Discover. Der Knowledge-Work-Marketplace sollte bereits sichtbar sein. Klicke den Filter Code.
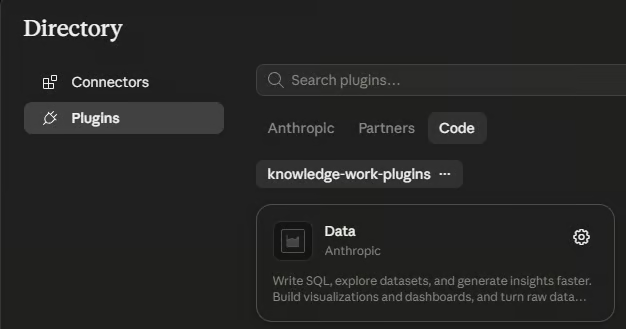
6. Wähle Data und klicke Add. In manchen Builds heißt der Button Install.
Auf der Plugin-Seite siehst du dann, was enthalten ist: Unter Skills stehen 10 Skills, von denen du 7 namentlich starten kannst (analyze, explore-data, write-query, create-viz, build-dashboard, validate-data und data-context-extractor) und 3, die im Hintergrund laden (sql-queries, data-visualization und statistical-analysis). Die Connector-Datei im Repository listet Snowflake, Databricks, BigQuery, Definite, Hex, Amplitude (mit separatem EU-Eintrag) und Atlassian – keiner ist verbunden, bis du dich anmeldest. Die Verzeichnis-Seite des Data-Plugins zeigte am 28. September 2026 insgesamt 7.655 Installationen.
Wenn du dich im Terminal wohlfühlst, installierst du dasselbe Plugin in Claude Code mit 2 Befehlen aus dem Repository-README:
claude plugin marketplace add anthropics/knowledge-work-plugins
claude plugin install data@knowledge-work-plugins
Ein Unterschied ist wichtig: Ein Plugin, das du über Customize hinzufügst, synchronisiert sich in Claude Code. Ein Plugin, das du per Kommandozeile installierst, bleibt auf dieser Maschine und landet nie in deinem Account. Unser Guide für Claude-Code-Plugins deckt den Terminal-Workflow ausführlich ab, daher bleibe ich hier beim Desktop-Weg.
In Team- und Enterprise-Plänen setzt ein Owner jedes Plugin auf einen von 4 Zuständen: not available, available to install, installed by default oder required. Enterprise-Admins können das gruppenweise überschreiben. Das Help Center weist darauf hin, dass „die Plugins, die du im Katalog siehst, von denen abweichen können, die Kolleginnen in anderen Gruppen sehen“. Fehlt Data im Discover-Tab, frag einen Owner, bevor du einen Marketplace-Fehler annimmst.
Ein Plugin ohne verbundenes Warehouse kann nur SQL schreiben, das du anderswo einfügst. Also ist der erste echte Schritt: eine Datenquelle verbinden. Dann übernimmt der Slash-Befehl den Rest.
Ein Plugin hinzuzufügen bedeutet keine Anmeldung bei Diensten. Öffne den Tab Connectors des Plugins: Jeder Eintrag zeigt einen von 3 Zuständen – Connected, Not connected (Connector ist in deinem Account, aber du hast dich nicht angemeldet) oder Not added. Klicke wo nötig auf Add, dann Connect und schließe die Anmeldung im Browser ab.
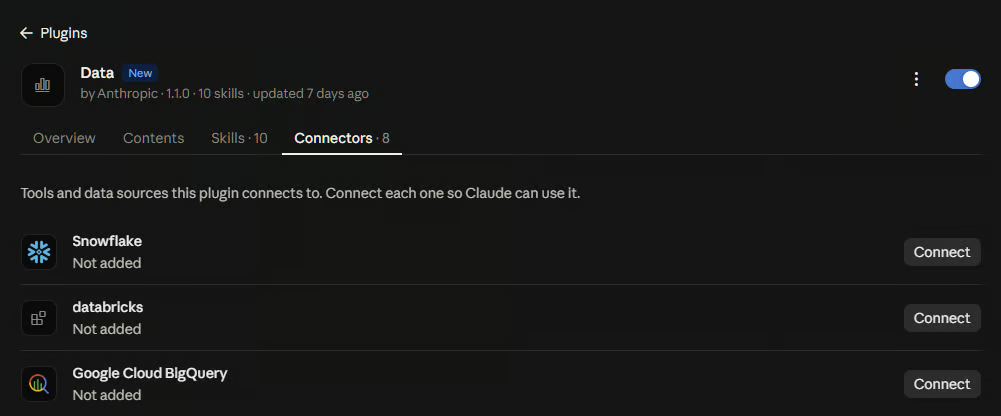
In Team- und Enterprise-Plänen fügt zunächst ein Owner den Connector für die Organisation hinzu; anschließend verbindest du ihn mit deinem eigenen Account.
Nutze Read-only-Credentials fürs Warehouse, denn ein schreibfähiger Connector erlaubt Claude das Ausführen jeder Anweisung, die seine Tools bereitstellen – und im Auto-Modus von Cowork entscheidet Claude selbst, ob er sie aufruft. Das heißt konkret:
Für Snowflake eine Rolle mit ausschließlich SELECT
Für BigQuery ein Service-Account mit der Rolle Data Viewer
Für Databricks ein Token, das auf ein Read-only-SQL-Warehouse scoped ist
Wenn du auf der jeweiligen Plattform neu bist: Unser Snowflake-Einsteiger-Guide und das BigQuery-Tutorial bringen dich beide an einem Nachmittag zur ersten Abfrage.
Die Verbindung liegt in deinem Account unter Customize > Connectors. Du autorisierst jeden Dienst einmal, und jedes andere Plugin mit derselben Server-URL – z. B. der BigQuery-Eintrag des Finance-Plugins – nutzt sie mit.
Der Befehl write-query verwandelt eine Frage in Umgangssprache in SQL für deinen Dialekt, und genau dieses Artefakt möchte ich, dass du dir anschaust, denn im Verifizierungs-Abschnitt kommen wir darauf zurück.
Ich habe eine kleine SQLite-Datenbank shop.db gebaut – mit den 4 Tabellen, die ein E-Commerce-Warehouse hätte, und 1.600 Bestellungen vom 5. Januar bis 27. September 2026. Die Tabelle unten beschreibt das Schema; jede Abfrage in diesem Artikel läuft darauf.
|
Tabelle |
Spalten |
Eine Zeile ist |
|
|
|
Ein Kunde (240 Zeilen) |
|
|
|
Ein Katalogprodukt in 1 von 5 Kategorien (40 Zeilen) |
|
|
|
Eine Bestellung mit Status completed, refunded oder canceled (1.600 Zeilen) |
|
|
|
Eine Produktzeile in einer Bestellung, bepreist vor einem Rabatt von 0 bis 25% (2.647 Zeilen) |
Um den Befehl auszuführen, tippe / in das Nachrichtenfeld und wähle write-query aus dem Data-Plugin – oder tippe /data:write-query.
Seit dem Update vom 24. Februar 2026 setzt das Tippen eines Befehls seinen Hint-Text in das Nachrichtenfeld, und Claude kann vor dem Start eine strukturierte Frage mit nummerierten Optionen stellen, wie Anthropics Screenshot unten mit dem Befehl /dashboard zeigt.
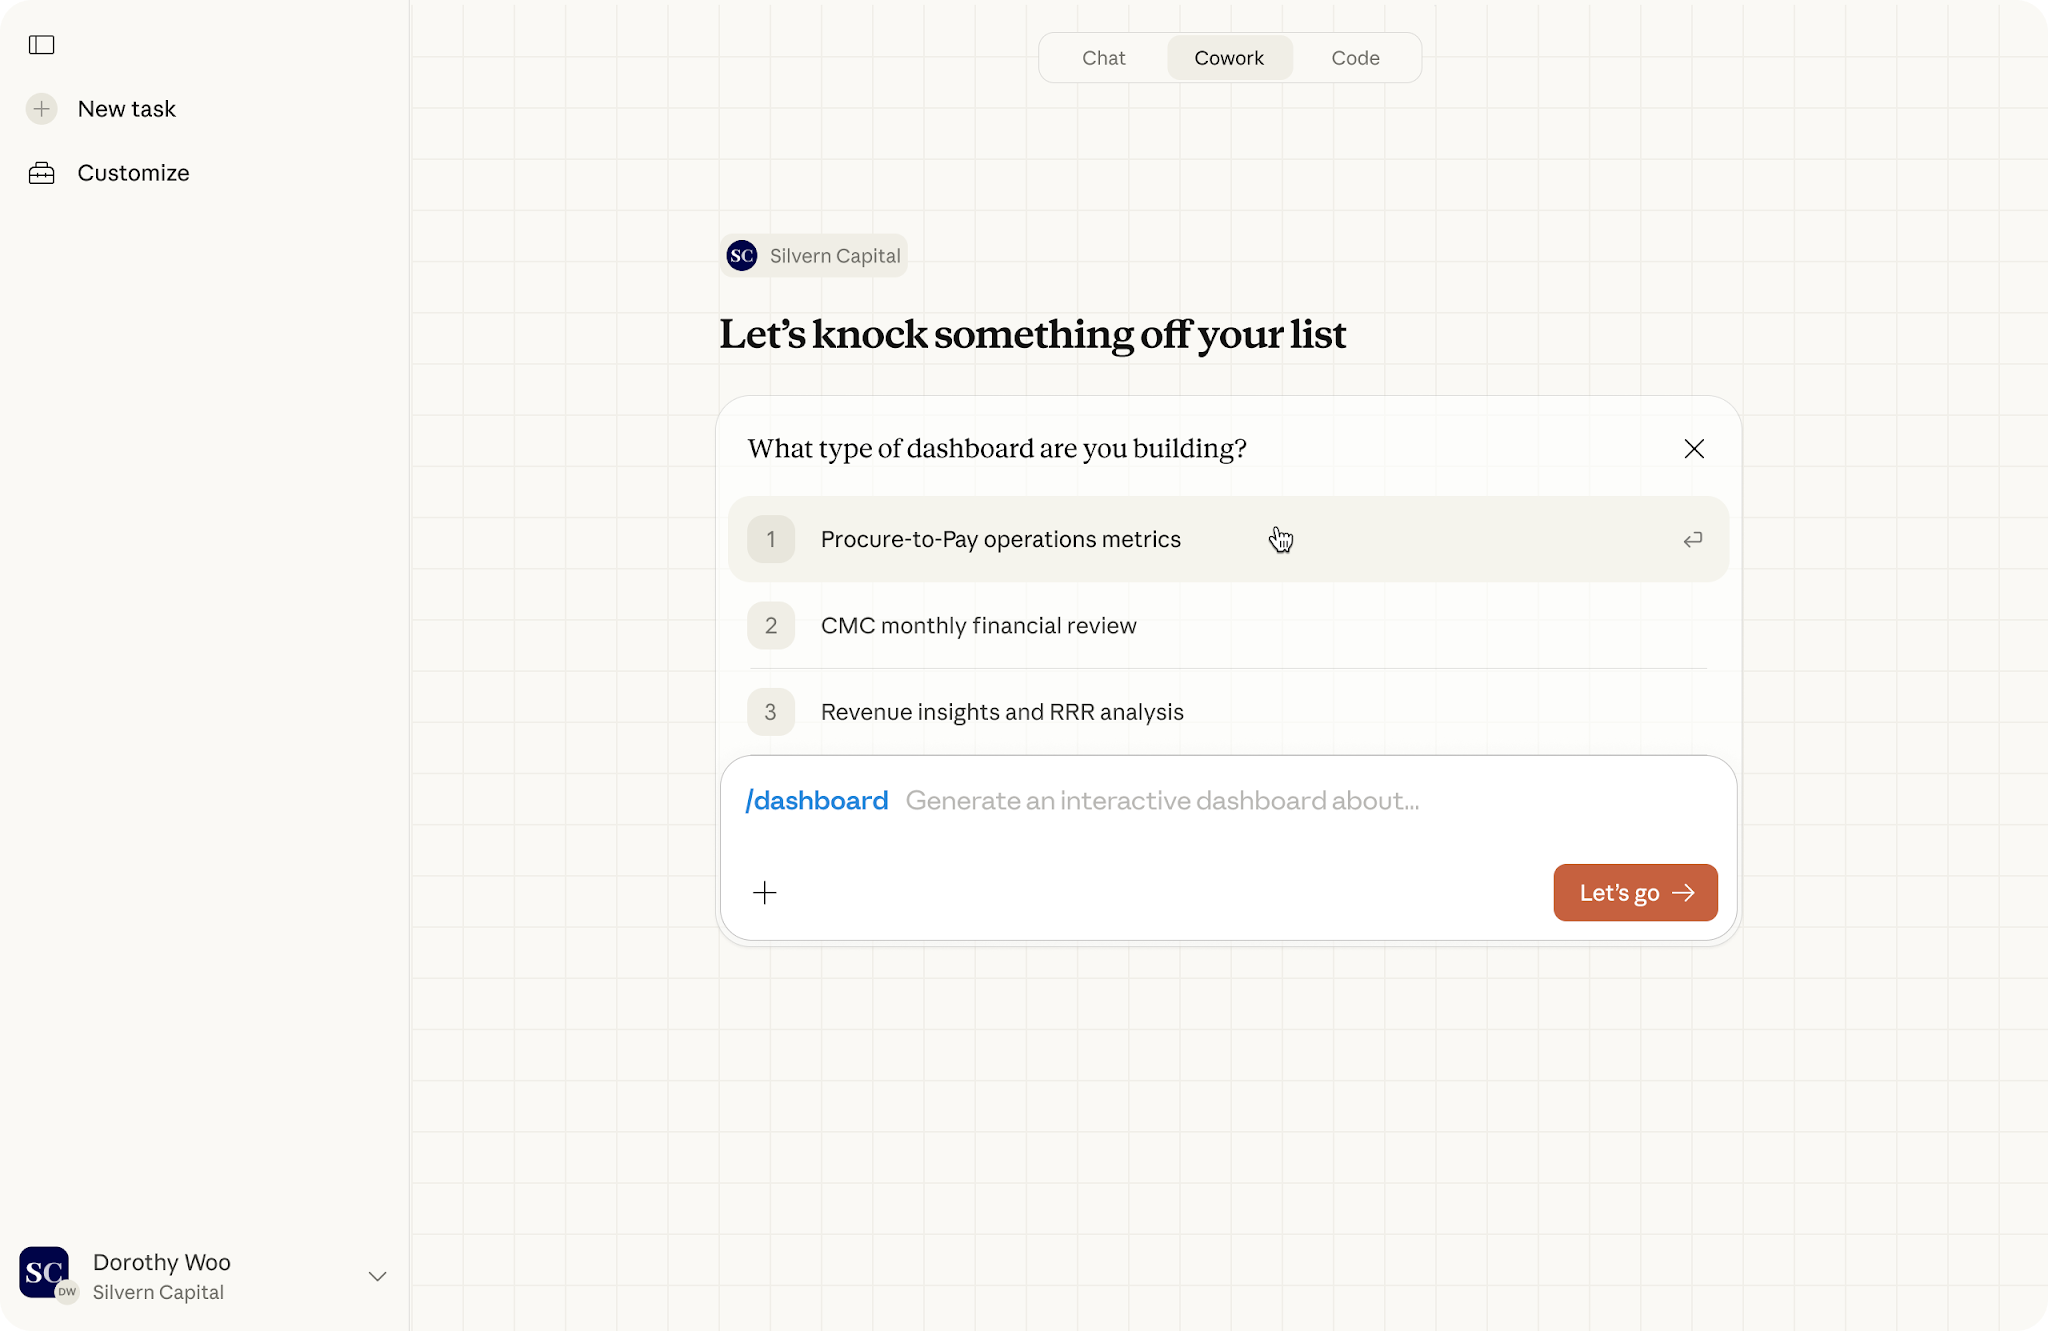
Das strukturierte Formular zum Start eines Slash-Befehls in Cowork, gezeigt mit /dashboard. Bildquelle: Anthropic, 24. Februar 2026.
Meine Anfrage lautete: Net Revenue nach Produktkategorie für jede der letzten 8 Wochen, nur abgeschlossene Bestellungen, mit Abzug der Artikelrabatte, in SQLite, mit dem Schema darunter.
Hier ist das unveränderte SQL-Ergebnis:
-- Net revenue by product category, last 8 complete weeks (Mon–Sun), completed orders only
-- Dialect: SQLite
WITH RECURSIVE
params AS (
    SELECT
        -- Monday of the current week; 'weekday 0' jumps forward to Sunday, -6 days lands on Monday
        date('2026-09-28', 'weekday 0', '-6 days')              AS current_week_start,  -- 2026-09-28
        date('2026-09-28', 'weekday 0', '-6 days', '-56 days')  AS range_start          -- 2026-08-03
),

-- One row per week, so weeks with no sales still show up
weeks AS (
    SELECT range_start AS week_start
    FROM params
    UNION ALL
    SELECT date(w.week_start, '+7 days')
    FROM weeks AS w
    CROSS JOIN params AS pr
    WHERE date(w.week_start, '+7 days') < pr.current_week_start
),

categories AS (
    SELECT DISTINCT category
    FROM products
),

-- Filter and aggregate at the line-item level before building the grid
weekly_category_revenue AS (
    SELECT
        date(o.order_date, 'weekday 0', '-6 days')                          AS week_start,
        p.category,
        -- discount_pct is stored as 0–25 (a percent), not as a 0–0.25 fraction
        SUM(oi.quantity * oi.unit_price * (1 - oi.discount_pct / 100.0))    AS net_revenue
    FROM orders AS o
    CROSS JOIN params AS pr
    INNER JOIN order_items AS oi ON oi.order_id = o.order_id
    INNER JOIN products    AS p  ON p.product_id = oi.product_id
    WHERE o.status = 'completed'
      -- Plain string comparison, so an index on order_date can be used; works for ISO-8601 dates
      AND o.order_date >= pr.range_start
      AND o.order_date <  pr.current_week_start
    GROUP BY 1, 2
)

SELECT
    w.week_start,
    date(w.week_start, '+6 days')             AS week_end,
    c.category,
    ROUND(COALESCE(r.net_revenue, 0), 2)      AS net_revenue
FROM weeks AS w
CROSS JOIN categories AS c
LEFT JOIN weekly_category_revenue AS r
       ON r.week_start = w.week_start
      AND r.category   = c.category
ORDER BY w.week_start, net_revenue DESC, c.category;
Das ist länger, als ich es von Hand tippen würde – und genau in der Länge steckt der Mehrwert. Jeder Block (CTE) hat eine klare Aufgabe:
params verankert alles an einem Datum, damit die Abfrage leicht umgestellt werden kann.
weeks ist rekursiv und garantiert auch eine Zeile für Wochen ohne Verkäufe.
weekly_category_revenue behält nur status = 'completed' und wendet den Rabatt als 1 - discount_pct / 100.0 an, weil die Spalte laut Schema ganze Prozente 0–25 speichert.
Das finale SELECT füllt Lücken mit 0 – ideal fürs Charting.
Der Skill listet unter der Abfrage auch Annahmen, z. B. dass order_date als ISO-8601-Text (YYYY-MM-DD) vorliegen muss, damit der Range-Filter greift, und dass refunded Orders vollständig entfallen.
Ich habe die Abfrage gegen shop.db ausgeführt und 40 Zeilen erhalten – pro Woche und Kategorie eine. Hier ist die pivotierte Ansicht, bei der jede Kategorie eine Spalte ist:
|
Woche ab |
Audio |
Fitness |
Home Office |
Kitchen |
Outdoor |
|
2026-08-03 |
12,714.80 |
9,187.23 |
13,542.08 |
7,925.04 |
7,621.21 |
|
2026-08-10 |
12,017.26 |
6,467.39 |
5,380.54 |
12,444.47 |
6,386.67 |
|
2026-08-17 |
8,808.47 |
4,669.72 |
6,675.32 |
7,513.97 |
4,485.65 |
|
2026-08-24 |
15,634.67 |
8,055.81 |
8,716.85 |
7,730.55 |
7,047.96 |
|
2026-08-31 |
11,402.99 |
11,517.37 |
14,252.59 |
9,954.80 |
7,226.14 |
|
2026-09-07 |
14,853.85 |
5,509.74 |
5,639.71 |
4,926.32 |
4,162.98 |
|
2026-09-14 |
8,780.41 |
4,893.28 |
7,864.22 |
7,344.70 |
6,204.45 |
|
2026-09-21 |
12,937.24 |
4,149.27 |
12,715.72 |
9,618.61 |
7,353.57 |
Audio ist in 5 der 8 Wochen die größte Kategorie und fällt nie unter 8.780. Home Office schwankte am stärksten, von 5.380 in der Woche ab 10. August auf 14.252 in der Woche ab 31. August. Fitness endet den Zeitraum auf seinem Tief bei 4.149 – eine Bewegung, die in einem Wochenreport auffallen sollte und die das Plugin aus Schritt 4 auch hervorhebt.
Das folgende Chart zeigt dieselben 40 Werte, ein Panel pro Kategorie.
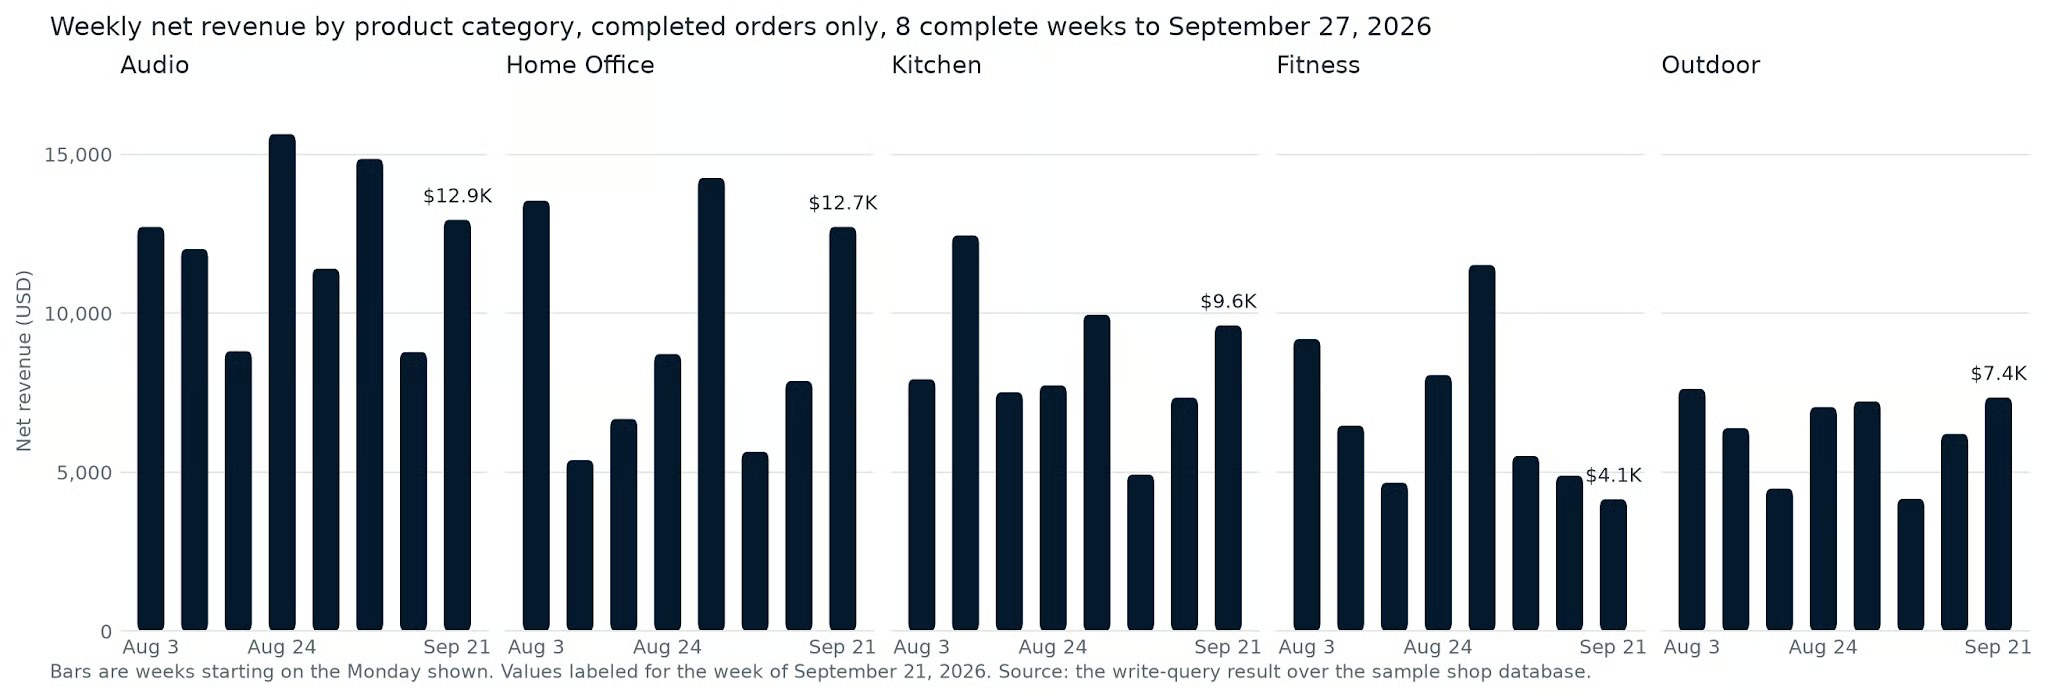
Abbildung 2. Wöchentliche Net Revenue für abgeschlossene Bestellungen nach Produktkategorie über die 8 vollständigen Wochen bis 27. September 2026, basierend auf write-query. Bild: Autor.
Installieren dauert 2 Minuten. Richtig wertvoll wird ein Plugin durch die Anpassung – Anthropics Plugins sind für eine generische Firma geschrieben, deine ist es nicht. Es gibt 2 Wege.
Ein Klick auf Edit with Claude öffnet eine Cowork-Task, in der Claude das Plugin gemeinsam mit dir bearbeitet.
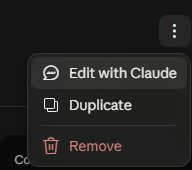
Im Help Center heißt der Button noch Customize. In der aktuellen App öffnest du das Plugin-Menü oben rechts und wählst Edit with Claude. Das „öffnet eine neue Cowork-Task mit einem Prompt, der Claude bittet, das gewählte Plugin zu personalisieren“. Klicke dann auf Let's go. Unter der Haube läuft der Skill cowork-plugin-customizer aus Anthropics Plugin-Management-Plugin.
Der Skill sucht zuerst im Plugin nach ~~-Platzhaltern, z. B. ~~data warehouse, prüft dann verbundene Slack- oder Dokument-Tools auf die echten Namen und fragt dich zuletzt nach dem Rest.
Eine konkrete Anpassung betrifft eure Tabellennamen: Sag ihm, dass kanonische Tabellen im Schema analytics liegen, dass fct_orders die einzige Order-Tabelle für Abfragen ist und dass alles mit Präfix stg_ tabu ist. Claude schreibt diese Regeln in den SQL-Skill und zeigt dir das angepasste Plugin im Verlauf; du übernimmst es mit dem Button am Ergebnis.
Der zweite Weg: Öffne die Dateien des Plugins und bearbeite sie selbst – ideal für Änderungen, die du ohnehin formulieren kannst. Drei Anpassungen zahlen sich am meisten aus:
Unternehmenskontext in einem Skill ergänzen. Hänge deine Metrikdefinitionen, kanonischen Tabellen und No-Go-Tabellen unten an skills/sql-queries/SKILL.md an. Der Block, den ich nutze, wird in Schritt 4 ein eigener Skill; 4 seiner Zeilen sehen so aus:
- orders: one row per order. status is completed, refunded, or canceled. order_date is ISO 8601 (YYYY-MM-DD).
- order_items: one row per product line. unit_price is the price charged before discount. discount_pct is a whole-number percentage from 0 to 25.
- products: one row per product, with its category.
- Never compute revenue from products.list_price. It is the catalog price, not what the customer paid.
Connectoren in .mcp.json tauschen. Lösche Einträge für Dienste, die ihr nicht nutzt, und trage die leere Snowflake- oder Databricks-URL mit eurer eigenen Serveradresse ein – oder füge euer Warehouse als Custom-Connector unter Customize > Connectors hinzu.
Version erhöhen. Ändere die Version in plugin.json bei jeder Anpassung, damit du deine Kopie vom Original unterscheiden kannst.
Wichtig: Anthropics Cowork-Plugin-Guide sagt, Cowork prüfe Marketplaces auf Updates und „warnt dich, wenn lokale Änderungen durch ein Update überschrieben würden“. Organisationsverwaltete Plugins und von Kolleginnen geteilte Plugins lassen sich gar nicht bearbeiten – kopiere sie vorher in dein eigenes Plugin.
Noch ein Hinweis für Windows-Nutzer: Ein Bug-Report vom 11. September 2026 beschreibt ein selbst hochgeladenes Plugin, das auf seiner ersten installierten Version „einfriert“ – neue Uploads, Uninstalls und Reinstalls springen nach einem Neustart zurück. Der Issue war am 6. Oktober 2026 ohne Workaround offen. Wenn deine Änderungen unter Windows plötzlich nicht mehr „kleben“, prüfe diesen Thread, statt in einer Upload-Schleife zu enden.
Ein Custom-Plugin ist die Lösung, wenn kein Marketplace-Plugin deinen Workflow kennt. Gehen wir einen Beispielbau durch: ein wöchentlicher Metrikreport mit 1 Wissens-Skill, 1 Command und 1 Connector.
Alle Dateien sind vollständig enthalten – denn der Ordner ist das Produkt. Die Abbildung zeigt die Schleife, der du folgst.
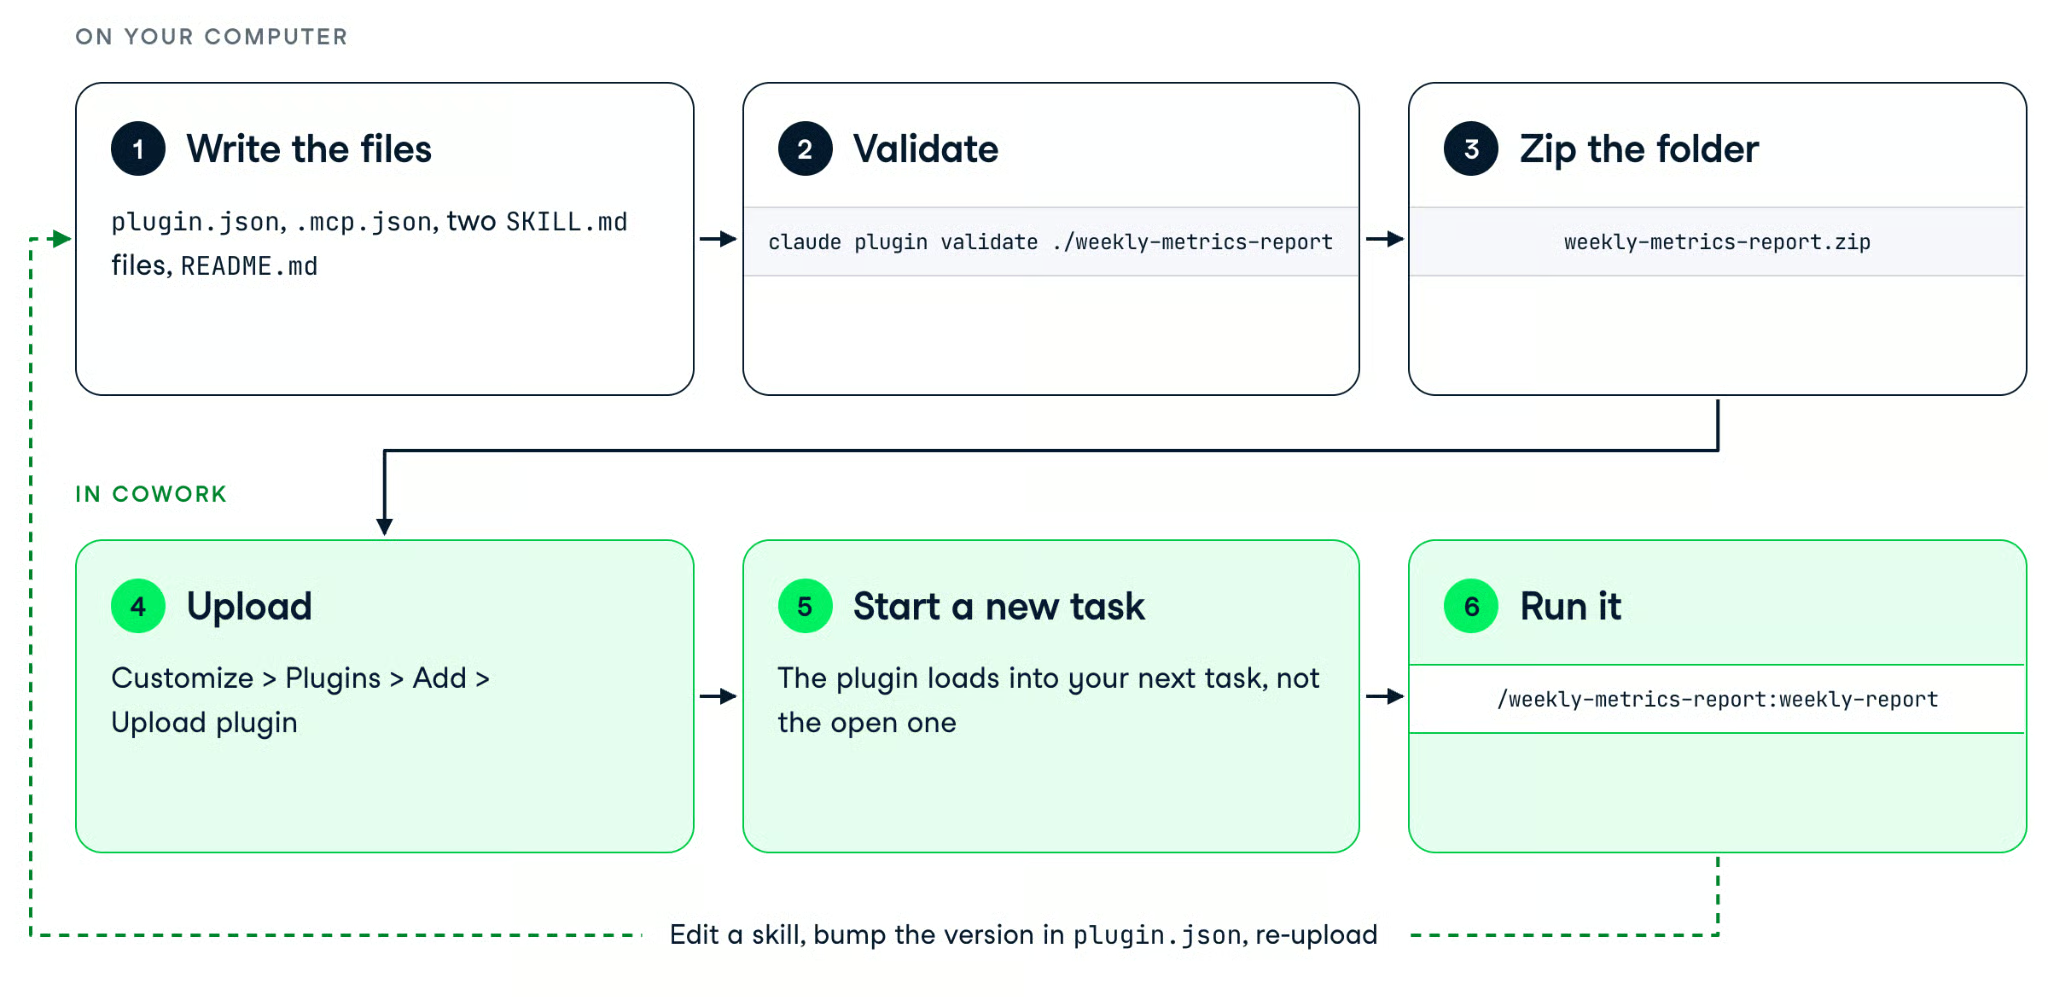
Abbildung 3. Ein Custom-Plugin bauen: Dateien lokal schreiben und validieren, zippen und hochladen, dann den Command in einer neuen Task ausführen und für Änderungen zurück zu den Dateien. Bild: Autor.
Plugin Create ist Anthropics geführte Route und lebt im September 2026 im Add-Menü. Gehe zu Customize, Plugins, Add, dann Create with Claude. Das öffnet eine Cowork-Task mit vorausgefüllter Anfrage.
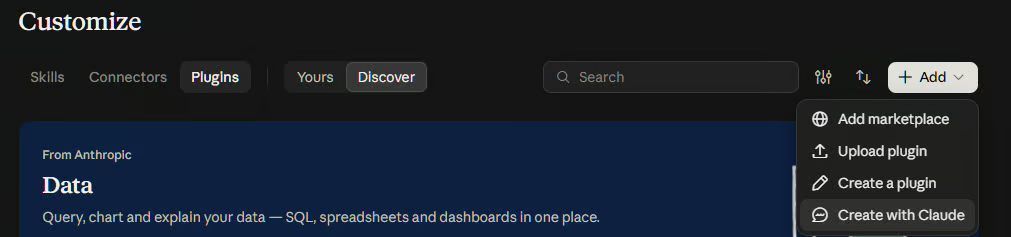
Beschreibe den Job so, wie du es einem Kollegen erklären würdest, beantworte Claudes Fragen zu Connectoren und klicke Save plugin auf der Kartenvorschau. Im selben Menü findest du auch Create a plugin – Formular und Editor für alle, die schon wissen, was in welche Datei gehört.
Für das Plugin in diesem Artikel würde ich den folgenden Briefing-Text tippen. Er benennt den einen Command, den einen Hintergrund-Skill, den einen Connector und die Regeln – genau die Infos, die die Skill-Discovery-Fragen sonst einzeln abfragen würden.
Build me a plugin called Weekly Metrics Report for our online store's data team.

What it does: every Monday, compare the most recent complete week (Monday to Sunday) with the week before it and write a short Markdown report. Keep it to one command, /weekly-report, that runs the whole thing, and one background skill that holds our metric definitions so Claude never guesses them.

The definitions: net revenue is quantity times unit price after the line discount, for completed orders only. Completed orders are counted by distinct order ID. Average order value is net revenue divided by completed orders. Refund rate is refunded orders divided by completed plus refunded orders, as a percentage with one decimal. Cancelled orders never count toward anything.

The data: the canonical tables are orders, order_items, and products in our BigQuery warehouse. Never use products.list_price for revenue; it is the catalog price, not what the customer paid. Bundle the BigQuery connector and nothing else.

The report: a three-sentence summary that names the biggest mover and says whether it went up or down, a table of net revenue by product category (this week, last week, percentage change with one decimal and a sign), a second table with the overall metrics for both weeks, and the SQL at the end so a reader can check it. If either week has fewer than 20 completed orders, say the comparison is noisy.

Do not add agents, hooks, or any other skills.
Die geführte Route nutzt den Skill create-cowork-plugin aus dem Plugin-Management-Plugin im Knowledge-Work-Marketplace. Du kannst dieses Plugin installieren und den Skill beim Namen ausführen. Er fragt nach Job, Komponenten und Connectoren und packt das Ergebnis in eine .plugin-Datei.
Am Ende hast du folgende Ordnerstruktur:
weekly-metrics-report/
├── .claude-plugin/
│   └── plugin.json
├── .mcp.json
├── README.md
└── skills/
    ├── metric-definitions/
    │   └── SKILL.md
    └── weekly-report/
        └── SKILL.md
Das Manifest benennt das Plugin und pinnt die Version:
{
  "name": "weekly-metrics-report",
  "displayName": "Weekly Metrics Report",
  "version": "0.1.0",
  "description": "Builds the store's weekly metrics report from the warehouse, using the team's own metric definitions.",
  "author": { "name": "Tim Lu" },
  "license": "MIT"
}
Die Connector-Datei listet genau einen Server – denselben BigQuery-Endpunkt wie das Data-Plugin –, sodass alle, die in Schritt 2 BigQuery verbunden haben, nichts neu autorisieren müssen:
{
  "mcpServers": {
    "bigquery": {
      "type": "http",
      "url": "https://bigquery.googleapis.com/mcp"
    }
  }
}
Das README ist für ein privates Plugin optional, für eine Einreichung ins Verzeichnis erforderlich – daher schreibe ich es direkt:
# Weekly Metrics Report
A small Cowork plugin that turns "how did last week go?" into a consistent report. It holds the store's metric definitions in one skill and the report workflow in another, and it bundles the BigQuery connector so Claude can query the warehouse directly.

## Use it
Run /weekly-metrics-report:weekly-report, or ask for the weekly numbers in plain words. Claude compares the most recent complete week with the week before, writes a Markdown report with per-category and overall tables, and includes the SQL it ran.

## Data
The plugin reads the orders, order_items, and products tables through the connector you sign in to. It stores nothing itself.Der Wissens-Skill hält den Kontext, der sonst jeden Montag eingefügt wird. Hier ist skills/metric-definitions/SKILL.md in voller Länge:
---
name: metric-definitions
description: The store's definitions of net revenue, completed orders, average order value, and refund rate, plus which warehouse tables are canonical. Use whenever a request involves revenue, sales, orders, refunds, discounts, or which table to query, even if it does not name a metric.
user-invocable: false
---

# Metric definitions for the store warehouse
Follow these definitions whenever you compute or report a store metric. If a request conflicts with them, follow the definitions and say so.

## Canonical tables
- orders: one row per order. status is completed, refunded, or cancelled. order_date is ISO 8601 (YYYY-MM-DD).
- order_items: one row per product line. unit_price is the price charged before discount. discount_pct is a whole-number percentage from 0 to 25.
- products: one row per product, with its category.
- Never compute revenue from products.list_price. It is the catalog price, not what the customer paid.

## Metrics
- Net revenue: SUM(quantity * unit_price * (1 - discount_pct / 100.0)) over order_items, for orders with status = 'completed'.
- Completed orders: COUNT(DISTINCT order_id) where status = 'completed'.
- Average order value: net revenue divided by completed orders.
- Refund rate: refunded orders divided by completed plus refunded orders, as a percentage with one decimal.
- Cancelled orders never count toward revenue, order counts, or the refund rate.

## Weeks
- A week runs Monday to Sunday. Label a week by its Monday.
- "Last week" means the most recent complete week, not the last 7 days.
Die Beschreibung sorgt dafür, dass dieser Skill zuverlässig feuert; eine vage Beschreibung ist der häufigste Grund, warum ein Skill nie lädt. Claude liest nur die Frontmatter, bis ein Skill geladen wird, und die Claude-Code-Skills-Referenz empfiehlt, den wichtigsten Use Case zuerst zu nennen.
Formuliere die Beschreibung als Situationen, in denen sich die Lesenden befinden („Anfrage betrifft Umsatz, Sales, Orders, Refunds, Discounts“), statt als Dateizusammenfassung – und nutze die Wörter, die Menschen sagen, denn Claude matched deine Beschreibung gegen deren Nachricht.
Zwei bewusste Entscheidungen: user-invocable: false hält diesen Skill aus dem /-Menü, denn niemand „startet“ Definitionen. Der Body ist im Imperativ an Claude gerichtet („Never compute revenue from products.list_price“), so wie es Anthropics eigener Authoring-Skill vorgibt. Den Tabellenteil ersetzt du durch eure Warehouse-Namen.
Der Command ist ebenfalls eine Skill-Datei – so definieren neue Plugins benannte Aktionen. Hier ist skills/weekly-report/SKILL.md komplett:
---
name: weekly-report
description: Build the store's weekly metrics report. Use when the user asks for the weekly report, the weekly numbers, week-over-week metrics, or how last week went.
argument-hint: "[a date inside the week to report on]"
---

# Weekly metrics report

Produce a short report comparing the most recent complete week with the week before it, using the definitions in the metric-definitions skill.

## Steps

1. Work out the reporting week. If the user gave a date, use the Monday-to-Sunday week that contains it. Otherwise use the most recent complete week before today.
2. Get the data. If a warehouse connector is connected, query it directly. If not, ask the user for a database file or an export and query that instead. Never estimate a number.
3. For the reporting week and the week before it, compute net revenue, completed orders, average order value, and refund rate, overall and per product category.
4. Write the report to a Markdown file named weekly_report_<week start>.md containing:
   - A three-sentence summary that names the biggest mover and says whether it went up or down.
   - A table with one row per category: net revenue this week, last week, and the percentage change.
   - A second table with the overall metrics for both weeks.
   - The SQL you ran, in a code block at the end, so the reader can check it.
5. Show the summary in the conversation and say where the file is.

## Rules

- Follow the metric-definitions skill for every metric. Do not invent new ones.
- Report percentage changes with one decimal place and a sign.
- If either week has fewer than 20 completed orders, say the comparison is noisy.
Dieser Skill ist standardmäßig user-invocable und erscheint im /-Menü als /weekly-metrics-report:weekly-report. Der argument-hint dokumentiert das eine Argument.
Der Body nennt den Skill metric-definitions zweimal – im Einstieg und unter Rules. So „ruft“ der Command den Skill auf: Claude lädt die Definitionen, weil sie genannt werden und weil ihre Beschreibung zu einer Revenue-Anfrage passt.
Wenn du das Legacy-Format bevorzugst, funktioniert derselbe Body als commands/weekly-report.md mit nur der description-Zeile in der Frontmatter.
Validiere vor dem Upload den Ordner relativ zu seinem Parent-Verzeichnis mit claude plugin validate ./weekly-metrics-report (Claude Code muss installiert sein). Auf meiner Maschine kam ✔ Validation passed zurück; bei Fehlern wird das Feld genannt.
Zippe als Nächstes den Plugin-Ordner. Beide Layouts gehen: der Ordner als Top-Level-Eintrag oder seine Inhalte direkt – wichtig ist, dass genau ein .claude-plugin/plugin.json enthalten ist (meins hatte 3.067 Bytes). Gehe dann zu Customize, Plugins, Add, Upload plugin und wähle die Zip-Datei.
Ein neu hinzugefügtes Plugin lädt in deine nächste Cowork-Task, nicht in die aktuell offene. Starte also eine neue Task, bevor du danach suchst. Wenn es dort immer noch nicht erscheint, beende und öffne die Desktop-App neu, bevor du die Dateien debuggt.
Ich habe das Plugin über Claude Code getestet mit claude --plugin-dir ./weekly-metrics-report, auf shop.db gezeigt und /weekly-metrics-report:weekly-report getippt. Claude erkannte, dass der 28. September 2026 ein Montag ist, berichtete die Woche ab 21. September und schrieb weekly_report_2026-09-21.md. Das ist die unveränderte Zusammenfassung:
Net revenue rose to $46,774.42, up +33.3% from $35,087.07 the week before. Completed orders went from 61 to 78, and average order value rose slightly to $599.67 (+4.3%).
The biggest mover was Home Office: its net revenue went up +61.7% ($7,864.22 → $12,715.72), the largest gain in both dollars and percent.
Fitness was the only category that fell (-15.2%).
The refund rate rose from 10.3% to 12.4%, and Home Office's refund rate reached 27.6% (8 refunded orders), which is worth a closer look.
Und hier ist die Kategorientabelle aus derselben Datei:
|
Kategorie |
Diese Woche (2026-09-21) |
Letzte Woche (2026-09-14) |
Veränderung |
|
Audio |
$12,937.24 |
$8,780.41 |
+47.3% |
|
Fitness |
$4,149.27 |
$4,893.28 |
-15.2% |
|
Home Office |
$12,715.72 |
$7,864.22 |
+61.7% |
|
Kitchen |
$9,618.61 |
$7,344.70 |
+31.0% |
|
Outdoor |
$7,353.57 |
$6,204.45 |
+18.5% |
|
Total |
$46,774.42 |
$35,087.07 |
+33.3% |
Vergleiche die letzte Zeile der Pivot-Tabelle aus Schritt 2 mit der Spalte „Diese Woche“ hier: dieselben 5 Zahlen, aus 2 unterschiedlichen Plugins – weil beide dieselbe Net-Revenue-Definition nutzten.
Claude tat außerdem 2 Dinge, die ich nicht explizit verlangt habe: Es markierte, dass 4 der 5 Kategorien in mindestens 1 Woche weniger als 20 abgeschlossene Bestellungen hatten (meine „noisy comparison“-Regel pro Kategorie). Und es merkte an, dass meine Regel „Veränderungen als Prozent melden“ für die Refund-Rate unklar ist (sie ist ja bereits Prozent) – und berichtete die Änderung daher in Prozentpunkten.
Beides würde ich als nächste Änderung im Skill festschreiben – das ist die Schleife in Abbildung 3: Eine Zeile ändern, Version erhöhen, erneut hochladen.
Wenn der Report steht, tippe /schedule in einer Cowork-Task, damit er jeden Montagmorgen automatisch läuft – Scheduled Tasks laufen in Anthropics Cloud. Seit dem 1. Oktober 2026 steht bei von Claude erstellten Scheduled Tasks standardmäßig „Automatically approve“, sofern deine Organisation das erlaubt. Das ist ein weiterer Grund für Read-only-Connectoren. Unser Cowork-Dispatch-Tutorial zeigt die Alternative, Aufgaben vom Handy anzustoßen.
Der Ordner ist die Verteiler-Einheit. Lege ihn in ein GitHub-Repository mit einer marketplace.json, die ihn listet. Jede Person mit der URL kann das Repo unter Add und dann Add marketplace hinzufügen.
In Team- und Enterprise-Plänen kann ein Owner stattdessen ein privates Repository synchronisieren oder Zips in einen Organisations-Marketplace hochladen und jedes Plugin auf available, installed by default oder required setzen – für alle oder bestimmte Gruppen. Members können ein von ihnen gebautes Plugin über das Drei-Punkte-Menü teilen oder per Publish to org einreichen; der Help-Center-Leitfaden für Organisations-Plugins deckt den Rest ab.
Prüfe die Query, bevor du dem Chart vertraust. Beschränke, worauf das Plugin zugreifen kann. Und wisse, wo du hinschaust, wenn ein Skill nicht auslöst. Dafür brauchst du kein Security-Team – nur 5 Minuten Routine.
Eine plausibel aussehende Query kann eine leicht andere Frage beantworten als die, die du gestellt hast. Hier ist eine Query, die ich für dieselbe Frage aus Schritt 2 von Hand geschrieben habe – sie läuft fehlerfrei:
SELECT p.category,
       ROUND(SUM(oi.quantity * p.list_price), 2) AS revenue
FROM orders AS o
JOIN order_items AS oi ON oi.order_id = o.order_id
JOIN products AS p ON p.product_id = oi.product_id
WHERE o.order_date >= '2026-08-03' AND o.order_date < '2026-09-28'
GROUP BY p.category
ORDER BY p.category;
Sie bepreist jede Zeile mit dem Katalog-list_price statt dem tatsächlichen Preis, ignoriert Rabatte und zählt refunded sowie stornierte Bestellungen, weil nie auf status gefiltert wird. Gegen shop.db ergibt das die Summen unten; die letzte Spalte zeigt, wieviel die Abkürzung die Net Revenue überzeichnet.
|
Kategorie |
Plugin-Query (netto, completed) |
Shortcut-Query (Listpreis, alle Orders) |
Überzeichnung |
|
Audio |
97,149.69 |
128,770.97 |
+32.5% |
|
Fitness |
54,449.81 |
71,237.81 |
+30.8% |
|
Home Office |
74,787.03 |
99,157.55 |
+32.6% |
|
Kitchen |
67,458.46 |
83,908.32 |
+24.4% |
|
Outdoor |
50,488.63 |
64,366.84 |
+27.5% |
|
Total |
344,333.62 |
447,441.49 |
+29.9% |
Jede Kategorie ist um 24% bis 33% überzeichnet, und ein Balkendiagramm sähe in beiden Fällen plausibel aus. Die Plugin-Query lag richtig, weil der Skill sie zu frühem Filtern und zur Schema-Beachtung anwies.
Wenn das Lesen einer 50-zeiligen Query noch zäh ist: Unser Associate Data Analyst in SQL-Lernpfad bringt dich am schnellsten auf Level. Der Guide zur SQL-Optimierung erklärt die Practices, denen der write-query-Skill folgt – etwa Filtern vor dem Joinen und den Verzicht auf SELECT *.
Ein schreibfähiger Warehouse-Connector birgt Risiken aus zwei Richtungen: Claude kann eine Anfrage („räum die Testbestellungen auf“) als Löschbefehl missverstehen, und Prompt-Injection – Text in Dokumenten oder Webseiten, die Claude liest, trägt eigene Anweisungen. In Team- und Enterprise-Plänen ist die Einstellung, die das Überspringen der pro-Task-Genehmigung für schreibfähige Connector-Tools erlaubt, standardmäßig aus.
Als harte Leitplanke: Hooks laufen vor jedem Tool-Call in Cowork und Claude Code. Ein Hook, der den SQL-Text eines Connectors prüft und alles außer SELECT ablehnt, ist das richtige Muster. Unser Claude-Code-Hooks-Guide zeigt, wie du einen schreibst. Ich habe diesen Hook für den Artikel nicht gebaut – teste ihn mit deinem Connector, bevor du dich darauf verlässt.
Claude entscheidet anhand der Frontmatter. Öffne den Skill und prüfe, ob seine Beschreibung die Situation und die Wörter nennt, die du verwendet hast. Falls nicht, ergänze sie.
Starte dann den Skill manuell mit /, um zu bestätigen, dass der Body funktioniert. Prüfe, dass das Plugin eingeschaltet ist und der Connector „Connected“ zeigt. Denk daran: Ein Plugin lädt in die nächste Task, nicht die aktuelle. Häufigste Ursache ist eine Beschreibung, die die Datei zusammenfasst statt die Anfrage zu beschreiben.
Cowork ist seit dem 9. April 2026 allgemein verfügbar. Plugins starteten am 30. Januar 2026 als Research Preview und sind inzwischen auf allen bezahlten Plänen verfügbar. Am 11. August 2026 erweiterte Anthropic die Compliance-API auf Cowork-Sessions auf Desktop, Web und Mobile.
Zwei Lücken nennt das aktuelle Help Center: Transkripte lokaler Desktop-Sessions haben noch keinen Lösch-Endpunkt, und OpenTelemetry-Monitoring „ersetzt keine Audit-Logs für Compliance-Zwecke“.
Wenn eure Organisation US-Gesundheitsdaten auf einem HIPAA-fähigen Enterprise-Plan verarbeitet, ist Cowork erst durch die HIPAA-Konfiguration des Admins von eurer BAA abgedeckt – und läuft dann nicht in der Cloud. Bei regulierten Daten hol dir das Go der Compliance, bevor ein Plugin Produktionstabellen berührt.
Du hast jetzt 3 Plugins: das installierte Data-Plugin, deine angepasste Kopie mit eigenen Tabellennamen und den wöchentlichen Report, den du aus 5 Dateien gebaut hast. Das dritte würde ich behalten – es enthält die 40 Zeilen Kontext, die bisher jeden Montag neu eingefügt wurden, und das genau einmal.
Das Entscheidungsprinzip für Plugins ist kurz: Ein Plugin lohnt sich, wenn sich der Workflow wiederholt und der Kontext stabil bleibt – z. B. Wochenreport, Contract-Review-Checkliste oder Sales-Call-Prep. Eine einmalige Analyse braucht keines – Kontext einfügen und weiter.
Und wenn du abwägst, welche wiederkehrenden Workflows in deiner Firma zuerst dran sind, passt unser Kurs Generative AI for Business genau dazu. Um tiefer ins Modell dahinter einzusteigen, deckt der Kurs Introduction to Claude Models Prompting und Multi-Turn-Arbeit mit der Claude-API ab.
Lerne KI mit DataCamp!
Kurs
Kurs
Lernpfad
Blog
Blog
Nathaniel Taylor-Leach
4 Min.
Blog
Hesam Sheikh Hassani
15 Min.
Tutorial
Kurtis Pykes
15 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Matt Crabtree
5 Min.