कोर्स
Data Science for Business
2 घंटा
116.2K
आइए ARIMA पर नज़र डालते हैं, जो समय श्रृंखला पूर्वानुमान तकनीकों में सबसे लोकप्रिय (यदि सबसे लोकप्रिय नहीं) में से एक है। ARIMA लोकप्रिय है क्योंकि यह ऑटोरिग्रेसिव (AR) और मूविंग एवरेज (MA) दोनों घटकों को पकड़कर समय श्रृंखला डेटा का प्रभावी ढंग से मॉडल करता है, साथ ही डिफरेंसिंग (I) के माध्यम से गैर-स्टेशनैरिटी को भी संबोधित करता है। यह संयोजन ARIMA मॉडलों को विशेष रूप से लचीला बनाता है, इसी कारण वे वित्त और मौसम पूर्वानुमान जैसे बहुत अलग उद्योगों में उपयोग होते हैं।
ARIMA मॉडल अत्यधिक तकनीकी होते हैं, लेकिन मैं इनके हिस्सों को तोड़कर समझाऊंगा ताकि आप ठोस समझ विकसित कर सकें। शुरू करने से पहले, कुछ बुनियादी टूल्स से खुद को परिचित करना अच्छा होता है। DataCamp बहुत से अच्छे संसाधन प्रदान करता है, जैसे हमारे ARIMA Models in Python या ARIMA Models in R कोर्स। आप अपनी पसंद की भाषा के अनुसार किसी एक को चुन सकते हैं।
वित्त, अर्थशास्त्र और पर्यावरण विज्ञान आदि में, ARIMA में काफी रुचि है क्योंकि यह हमारी पिछली टिप्पणियों के कई जटिल पैटर्न की पहचान कर सकता है और भविष्य की ज़रूरतों के साथ उन्हें जोड़ सकता है, जिससे यह एक अत्याधुनिक तकनीक बन जाती है। स्टॉक्स की कीमतों का पूर्वानुमान लगाने से लेकर मौसम के पैटर्न का पूर्वानुमान करने और उपभोक्ता मांग का अंदाजा लगाने तक, ARIMA सटीक और क्रियान्वयन योग्य प्रेडिक्टिव विश्लेषण करने का एक बेहतरीन तरीका है।
ARIMA का उपयोग करके, हम पैटर्न, रुझान और मौसमीपन को ध्यान में रखते हुए समय श्रृंखला डेटा का परिष्कृत ढंग से विश्लेषण और पूर्वानुमान कर सकते हैं। यह अंतर्निहित गतिशीलताओं का 360-डिग्री दृश्य प्रदान करता है, जिससे सूचित निर्णय लेना आसान होता है।
ARIMA को वास्तव में समझने के लिए, हमें इसके निर्माण खंडों को समझना होगा। एक बार जब हम घटकों को समझ लेते हैं, तो यह देखना आसान हो जाएगा कि यह समय श्रृंखला पूर्वानुमान विधि समग्र रूप से कैसे काम करती है। यहां, मैं हर घटक की विस्तृत व्याख्या दूंगा।
ऑटोरिग्रेसिव (AR) घटक प्रेडिक्टिव मॉडलों के लिए AR फ्रेमवर्क में पिछले मानों से एक रुझान बनाता है। स्पष्ट करने के लिए, 'ऑटोरिग्रेशन फ्रेमवर्क' एक रिग्रेशन मॉडल की तरह काम करता है जहां आप समय श्रृंखला के अपने ही पिछले मानों के लैग्स को रिग्रेसर के रूप में उपयोग करते हैं।
इंटीग्रेटेड (I) भाग में समय श्रृंखला को डिफरेंस करना शामिल होता है, ध्यान रखते हुए कि हमारी समय श्रृंखला स्टेशनरी होनी चाहिए, जिसका अर्थ है कि औसत और वैरिएंस समय के साथ स्थिर रहें। मूल रूप से, हम एक अवलोकन को दूसरे से घटाते हैं ताकि रुझान और मौसमीपन हट जाएं। डिफरेंसिंग करके हमें स्टेशनैरिटी मिलती है। यह कदम आवश्यक है क्योंकि यह मॉडल को डेटा के अनुरूप फिट होने में मदद करता है, शोर के नहीं।
मूविंग एवरेज (MA) घटक एक अवलोकन और अवशिष्ट त्रुटि के बीच संबंध पर केंद्रित होता है। यह देखते हुए कि वर्तमान अवलोकन का संबंध पिछली त्रुटियों से कैसे है, हम अपने डेटा में किसी संभावित रुझान के बारे में कुछ उपयोगी जानकारी निकाल सकते हैं।
हम अवशेषों को इन त्रुटियों में से एक मान सकते हैं, और मूविंग एवरेज मॉडल की अवधारणा उनके प्रभाव का हमारे नवीनतम अवलोकन पर अनुमान लगाती है या उसे ध्यान में रखती है। यह विशेष रूप से डेटा में अल्पकालिक परिवर्तनों या यादृच्छिक झटकों को ट्रैक और पकड़ने के लिए उपयोगी है। समय श्रृंखला के (MA) भाग में, हम इसके व्यवहार के बारे में मूल्यवान जानकारी प्राप्त कर सकते हैं, जो बदले में हमें अधिक सटीकता से पूर्वानुमान लगाने की अनुमति देती है।
सोने की कीमतों जैसे फोरकास्टिंग के लिए ARIMA मॉडल बनाने के लिए, आप इन चरणों का पालन कर सकते हैं। आइए इसे साथ में तोड़कर समझते हैं।
पहला कदम एक उपयुक्त डेटासेट जुटाना और अपना वातावरण तैयार करना है।
डेटा स्रोत प्लेटफ़ॉर्म से कोई डेटासेट एकत्र करें या खोजें। आपको ऐसा डेटासेट चाहिए जिसमें समय के साथ ऐतिहासिक डेटा हो। यहां सोने के फ्यूचर प्राइस से संबंधित Kaggle डेटासेट का एक लिंक है।
हम जिन पैकेजों की ज़रूरत है, उन्हें इंस्टॉल करते हैं, जिनमें statsmodels और sklearn शामिल हैं।
import pandas as pdimport matplotlib.pyplot as pltfrom statsmodels.tsa.stattools import adfullerfrom statsmodels.graphics.tsaplots import plot_acf, plot_pacffrom statsmodels.tsa.arima.model import ARIMAfrom sklearn.metrics import mean_squared_errorइसके बाद हम डेटा को अपने लोकल वातावरण में पढ़ते हैं। मैं यह अतिरिक्त कदम उठाता हूं ताकि सुनिश्चित कर सकूं कि तारीखें क्रम में पहचानी जा रही हैं।
# Define the path to your CSV file# You may have to make this path more specific to the location of your file.csv_path = "future-gc00-daily-prices.csv"# Read the CSV, parse 'Date' column as datetime, and set it as the indexdata = pd.read_csv( csv_path, parse_dates=["Date"], dayfirst=False, index_col="Date")# Sort the DataFrame by the Date index in ascending orderdata.sort_index(inplace=True)हमारा डेटासेट काफ़ी साफ़ है, लेकिन अन्य संदर्भों में हमें इंडेक्सिंग से जुड़ी समस्याओं को संभालना पड़ता, जो समय श्रृंखला पूर्वानुमान में महत्वपूर्ण हैं। उदाहरण के लिए, यदि हम किसी विशेष एक्सचेंज पर किसी स्टॉक के क्लोज़िंग मान का पूर्वानुमान लगा रहे हैं, तो हमें यह मानना होगा कि सप्ताहांत पर स्टॉक मार्केट खुला नहीं होता।
आगे बढ़ने से पहले, मैं Close वेरिएबल से कॉमा हटाने का भी त्वरित कदम उठा रहा हूं, जिसका मैं उपयोग करूंगा।
# Clean the "Close" columndata["Close"] = data["Close"].replace(',', '', regex=True)data["Close"] = pd.to_numeric(data["Close"], errors='coerce')data["Close"].replace([np.inf, -np.inf], np.nan, inplace=True)data.dropna(subset=["Close"], inplace=True)डेटा प्रीप्रोसेसिंग के हिस्से के रूप में, हमें अक्सर मिसिंग वैल्यूज़ को कैसे हैंडल करें इस पर विचार करना पड़ता है, जैसे फॉरवर्ड फिलिंग या औसत प्रतिस्थापन जैसी इम्प्यूटेशन विधि का उपयोग करके। यह जान लें कि एक भी NA मान, प्रोग्रामिंग भाषा और उपयोग की जा रही लाइब्रेरी पर निर्भर करते हुए, ARIMA को चलने से रोक सकता है।
मैंने उल्लेख किया था कि सप्ताहांत के दिन NA के रूप में पहचाने जा सकते हैं। ऐसा हो सकता है, और तब एक अतिरिक्त कदम की ज़रूरत होगी। सौभाग्य से, statsmodels डेटा को एक श्रेणीबद्ध इंडेक्स के रूप में मानता है और नियमित समय अंतराल को सख्ती से लागू नहीं करता, जिससे हमारा मॉडल सप्ताहांत के गैप्स के बावजूद भी कंपाइल हो जाता है।
अब टाइम प्लॉट बनाने का अच्छा समय है ताकि हम उस श्रृंखला को देख सकें जिस पर हम काम कर रहे हैं:
# Plotting the original Close priceplt.figure(figsize=(14, 7))plt.plot(data.index, data["Close"], label='Close Price')plt.title('Close Price Over Time')plt.xlabel('Date')plt.ylabel('Close Price')plt.legend()plt.show()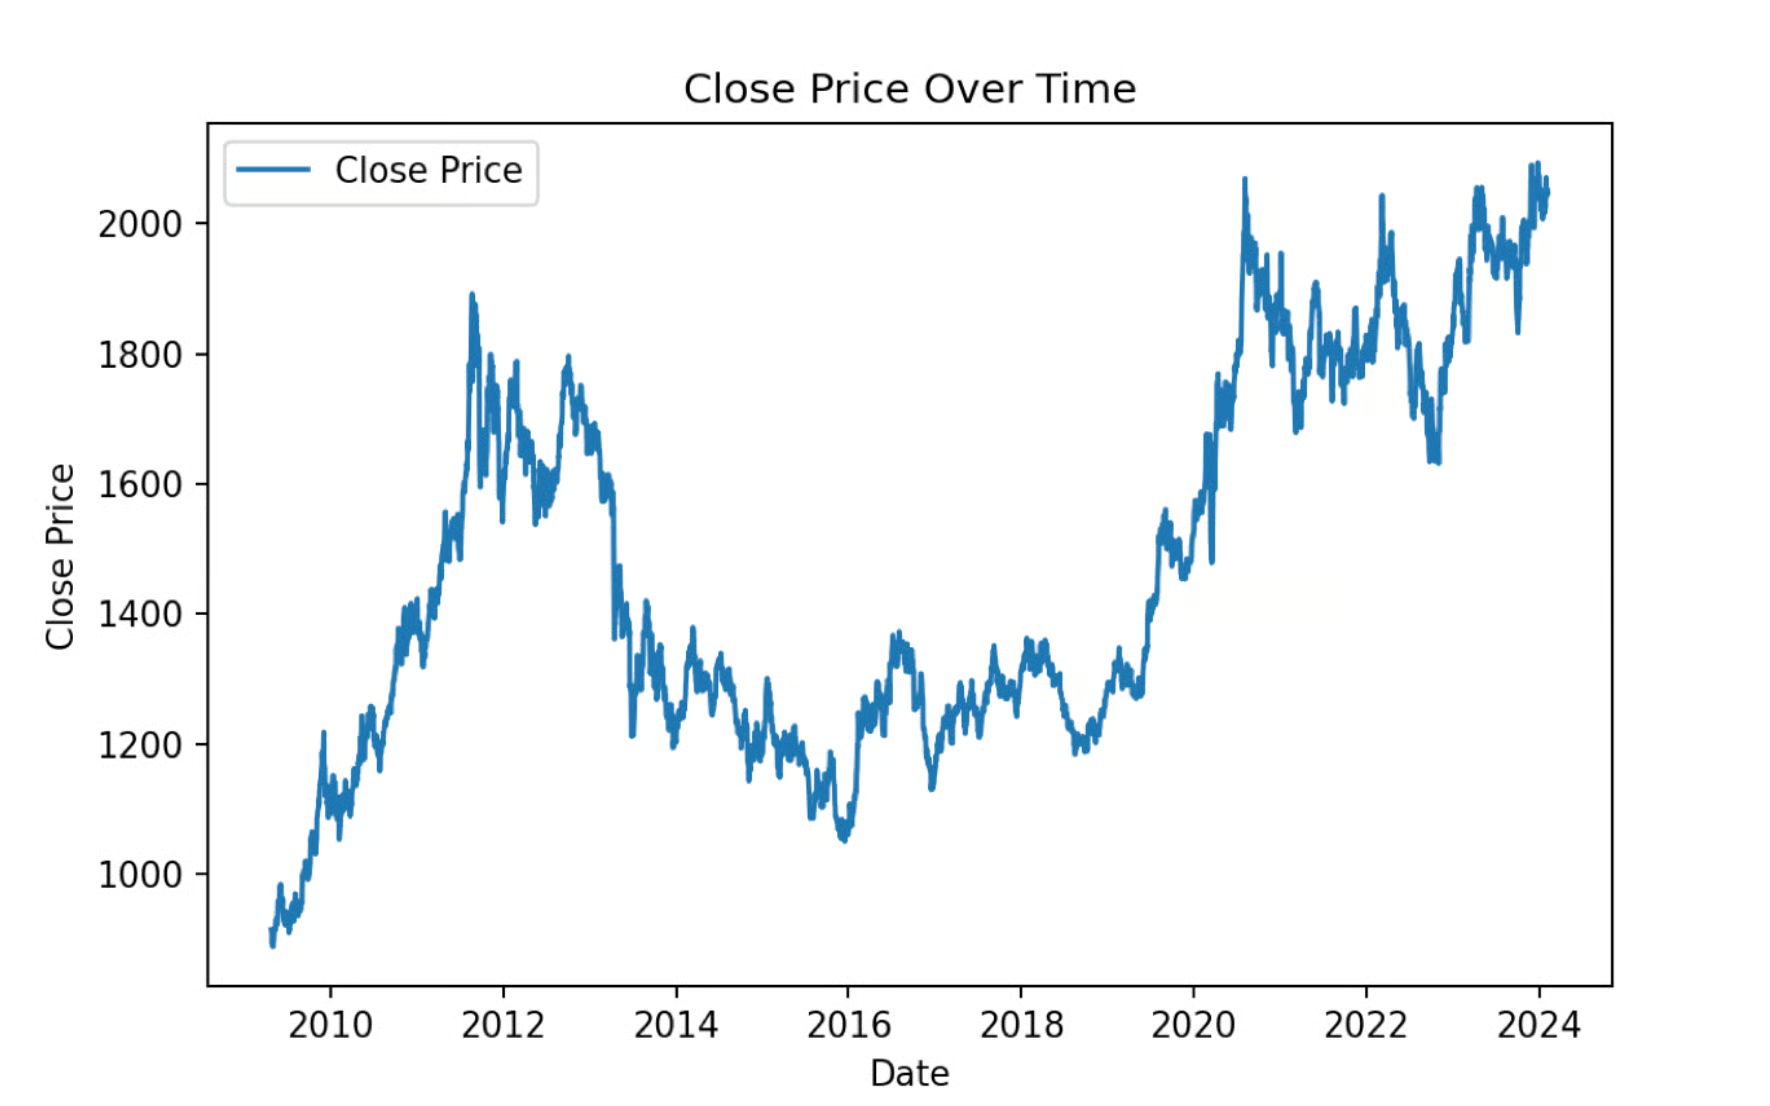
हालांकि ARIMA मॉडल एक हद तक गैर-स्टेशनैरिटी से निपट सकते हैं, वे समय-परिवर्ती वैरिएंस का प्रभावी रूप से हिसाब नहीं कर सकते। दूसरे शब्दों में, ARIMA मॉडल के वास्तव में काम करने के लिए, डेटा स्टेशनरी होना चाहिए।
ऊपर दिए गए प्लॉट को देखते हुए, हम देख सकते हैं कि डेटा वास्तव में स्टेशनरी नहीं है क्योंकि एक स्पष्ट ट्रेंड है। साथ ही, अलग-अलग समय बिंदुओं पर वैरिएंस भी अस्थिर दिखती है। हम ऑगमेंटेड डिक्की-फुलर टेस्ट का उपयोग करके अपनी सहज समझ की जांच कर सकते हैं और देख सकते हैं कि क्या हमारे डेटा में स्थिर औसत और वैरिएंस है, और इसे संख्याओं में व्यक्त कर सकते हैं।
# Perform the Augmented Dickey-Fuller test on the original seriesresult_original = adfuller(data["Close"])print(f"ADF Statistic (Original): {result_original[0]:.4f}")print(f"p-value (Original): {result_original[1]:.4f}")if result_original[1] < 0.05: print("Interpretation: The original series is Stationary.\n")else: print("Interpretation: The original series is Non-Stationary.\n")# Apply first-order differencingdata['Close_Diff'] = data['Close'].diff()# Perform the Augmented Dickey-Fuller test on the differenced seriesresult_diff = adfuller(data["Close_Diff"].dropna())print(f"ADF Statistic (Differenced): {result_diff[0]:.4f}")print(f"p-value (Differenced): {result_diff[1]:.4f}")if result_diff[1] < 0.05: print("Interpretation: The differenced series is Stationary.")else: print("Interpretation: The differenced series is Non-Stationary.")ADF Statistic (Original): -1.4367p-value (Original): 0.5646Interpretation: The original series is Non-Stationary.ADF Statistic (Differenced): -19.1308p-value (Differenced): 0.0000Interpretation: The differenced series is Stationary.हमारे ऑगमेंटेड डिक्की-फुलर टेस्ट के परिणाम दर्शाते हैं कि हमारी मूल श्रृंखला वास्तव में गैर-स्टेशनरी है, इसलिए मूल डेटा पर सीधे ARIMA लागू करना गलती होगी।
हालांकि, डेटा के डिफरेंस्ड संस्करण पर ADF टेस्ट संकेत करता है कि डिफरेंस्ड संस्करण स्टेशनरी है।
डिफरेंसिंग पर एक त्वरित टिप्पणी। मैं इसे समझाने के लिए समय लेना चाहता हूं, क्योंकि परदे के पीछे बहुत कुछ हो रहा होता है। डिफरेंसिंग करने के लिए, हम हर अवलोकन को पिछले वाले से घटाते हैं ताकि हमें फर्स्ट डिफरेंसेज़ की एक नई समय श्रृंखला मिले। (नई समय श्रृंखला अब मूल से एक तत्व छोटी हो जाती है।) यदि डिफरेंस्ड श्रृंखला अभी भी स्टेशनरी नहीं है, तो हम मूल श्रृंखला को दोबारा डिफरेंस करके सेकंड डिफरेंस ले सकते हैं, और हम इस प्रक्रिया को तब तक जारी रख सकते हैं जब तक कि श्रृंखला स्टेशनरी न हो जाए। आवश्यक डिफरेंसिंग का क्रम वह न्यूनतम संख्या है जो किसी श्रृंखला में आत्म सहसंबंध न रहे।
अंत में मैं यह कहना चाहता हूं—ज़रूरत से ज़्यादा डिफरेंसिंग न करें, अन्यथा आप अपने डेटा में झूठी गतिशीलताएं पैदा कर सकते हैं। साथ ही, यदि आप मौसमी ARIMA मॉडल करने जा रहे होते, जो हम इस ट्यूटोरियल में नहीं कर रहे, तो आप हमेशा फर्स्ट डिफरेंस से पहले सीज़नल डिफरेंस पर विचार करते।
# Plotting the differenced Close priceplt.figure(figsize=(14, 7))plt.plot(data.index, data['Close_Diff'], label='Differenced Close Price', color='orange')plt.title('Differenced Close Price Over Time')plt.xlabel('Date')plt.ylabel('Differenced Close Price')plt.legend()plt.show()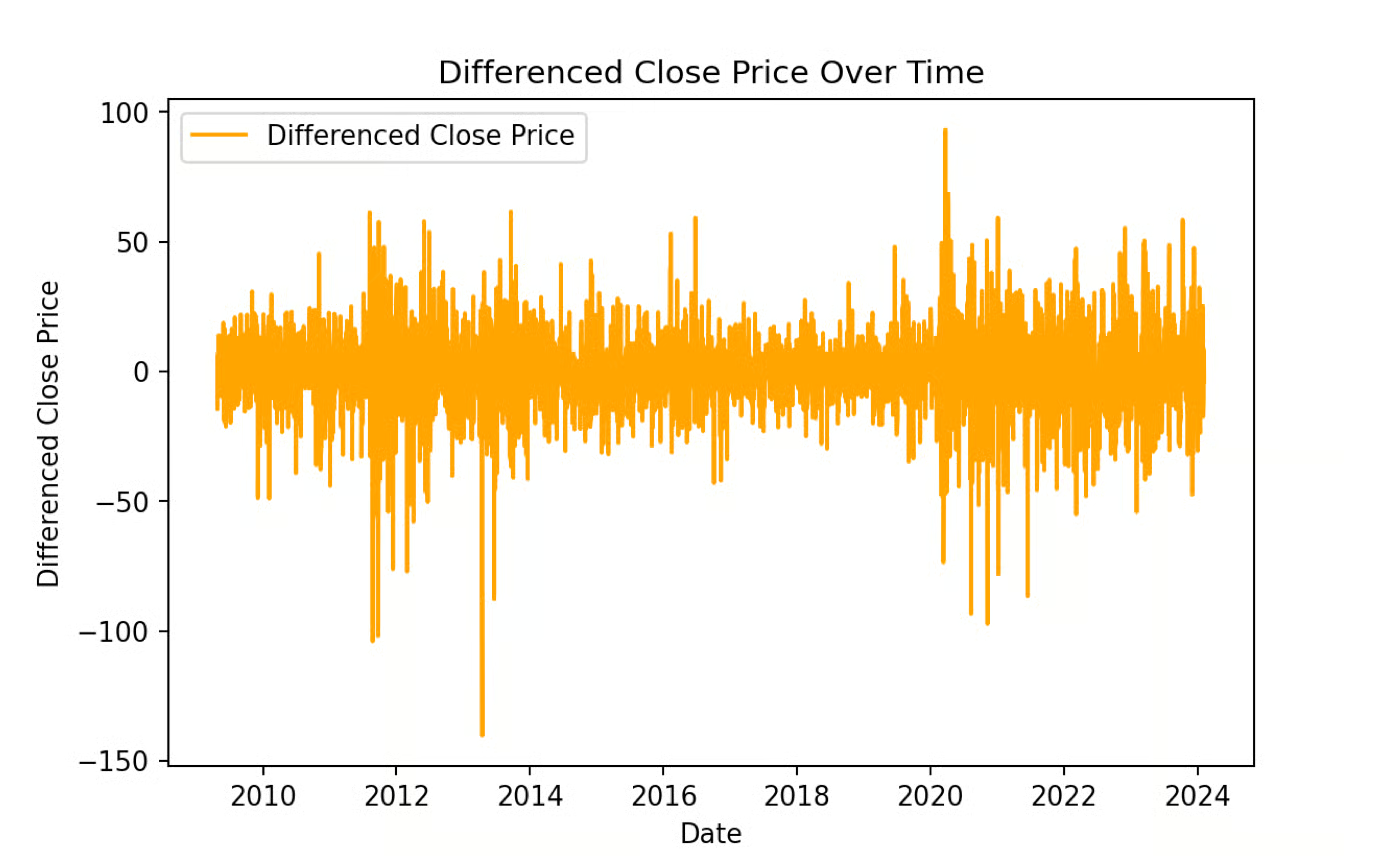
जब हम ARIMA मॉडल बनाते हैं, तो हमें अपने ARIMA मॉडल में जाने वाले p, d, और q पदों पर विचार करना पड़ता है।
हम p, d, और q के मान निर्धारित करने के लिए ACF (Autocorrelation Function) और PACF (Partial Autocorrelation Function) जैसे टूल का उपयोग करते हैं। जहां ACF कट ऑफ होता है वहां लैग्स की संख्या q होती है, और जहां PACF कट ऑफ होता है वहां p होता है। हमें d का उपयुक्त मान भी चुनना होता है, ताकि डिफरेंसिंग के बाद डेटा व्हाइट नॉइज़ जैसा दिखे। हमारे डेटा के लिए, हम p और q दोनों के लिए 1 चुनते हैं क्योंकि प्रत्येक के पहले लैग पर एक महत्वपूर्ण स्पाइक दिखाई देता है।
from statsmodels.graphics.tsaplots import plot_acf, plot_pacfimport matplotlib.pyplot as plt# Plot ACF and PACF for the differenced seriesfig, axes = plt.subplots(1, 2, figsize=(16, 4))# ACF plotplot_acf(data['Close_Diff'].dropna(), lags=40, ax=axes[0])axes[0].set_title('Autocorrelation Function (ACF)')# PACF plotplot_pacf(data['Close_Diff'].dropna(), lags=40, ax=axes[1])axes[1].set_title('Partial Autocorrelation Function (PACF)')plt.tight_layout()plt.show()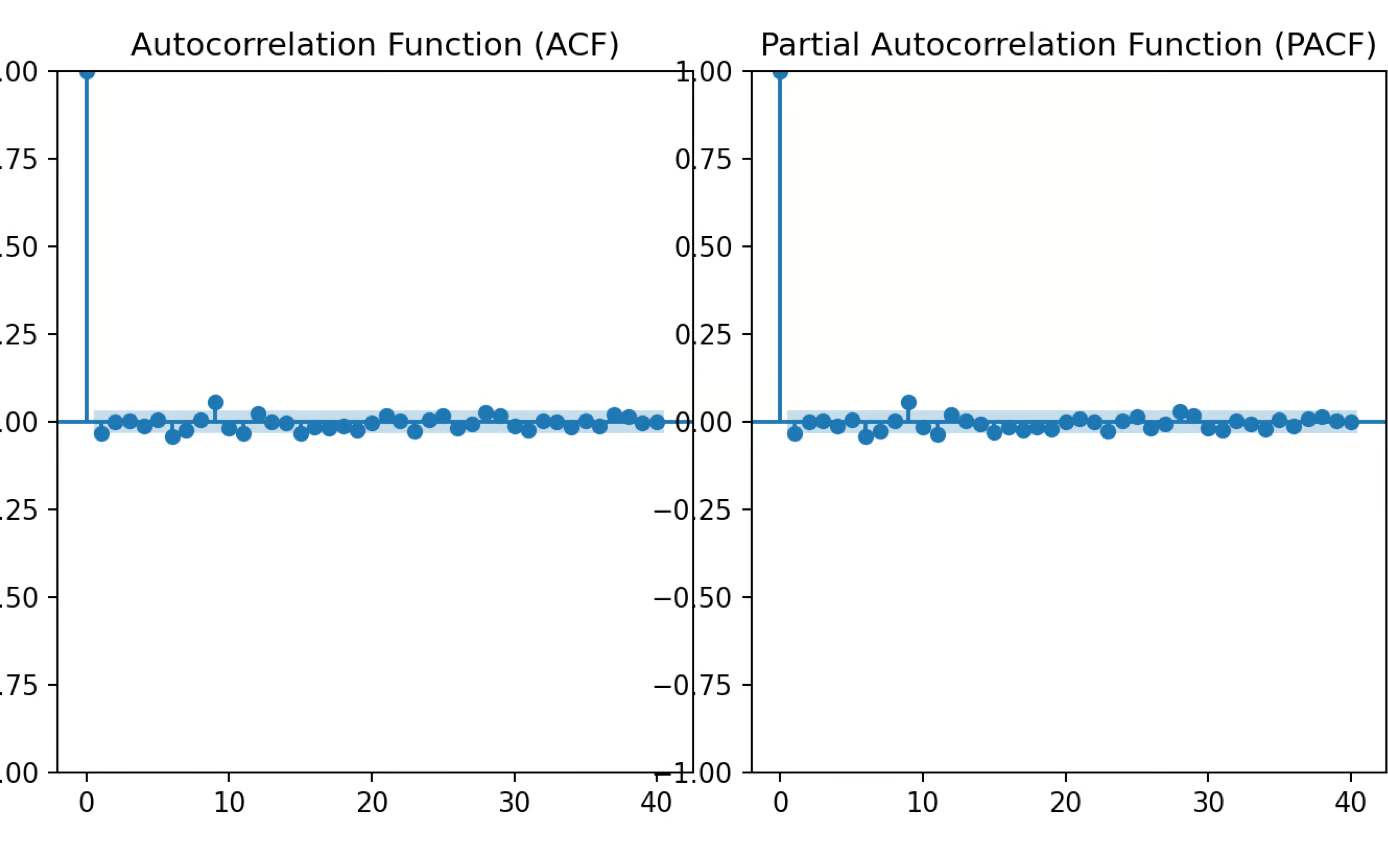
स्पष्ट करने के लिए, ARIMA में p, d, और q मान मॉडल के ऑर्डर का प्रतिनिधित्व करते हैं (ऑटोरिग्रेशन के लिए लैग्स, डिफरेंसिंग, और मूविंग एवरेज टर्म), लेकिन ये वास्तविक अनुमानित पैरामीटर नहीं होते। एक बार p, d, और q के मान चुन लिए जाने पर, मॉडल मैक्सिमम लाइकलिहुड एस्टीमेशन (MLE) के माध्यम से ऑटोरिग्रेसिव और मूविंग एवरेज टर्म्स के गुणांक जैसे अतिरिक्त पैरामीटरों का अनुमान लगाता है।
ARIMA मॉडल का उपयोग करके फोरकास्ट करने के लिए, फिट किए गए मॉडल से डेटा के आधार पर भविष्य के मानों की भविष्यवाणी करना शुरू करें। एक बार भविष्यवाणियां कर लेने के बाद, वास्तविक मानों के साथ पूर्वानुमानित मानों को प्लॉट करके उन्हें विज़ुअलाइज़ करना सहायक होता है। यह इसलिए संभव है क्योंकि हम ट्रेन/टेस्ट वर्कफ़्लो का उपयोग करते हैं, जहां डेटा को प्रशिक्षण और परीक्षण सेट में विभाजित किया जाता है। ऐसा करने से हमें यह देखने में मदद मिलती है कि मॉडल अनदेखे डेटा पर कितना अच्छा प्रदर्शन करता है। यदि यह स्पष्ट नहीं है, तो हमारा Model Validation in Python कोर्स लें, जो प्रशिक्षण और परीक्षण की बारीकियों को सीखने का बढ़िया साधन है।
पहला कदम डेटा को प्रशिक्षण और परीक्षण संस्करणों में विभाजित करना है।
# Split data into train and testtrain_size = int(len(data) * 0.8)train, test = data.iloc[:train_size], data.iloc[train_size:]# Fit ARIMA modelmodel = ARIMA(train["Close"], order=(1,1,1))model_fit = model.fit()अगला कदम हमारा पूर्वानुमान बनाना और उसका दृश्य निरीक्षण करना है। हम देख सकते हैं कि हमारा पूर्वानुमान हमारे डेटा के परीक्षण संस्करण के मुकाबले कैसा प्रदर्शन करता है।
# Forecastforecast = model_fit.forecast(steps=len(test))# Plot the results with specified colorsplt.figure(figsize=(14,7))plt.plot(train.index, train["Close"], label='Train', color='#203147')plt.plot(test.index, test["Close"], label='Test', color='#01ef63')plt.plot(test.index, forecast, label='Forecast', color='orange')plt.title('Close Price Forecast')plt.xlabel('Date')plt.ylabel('Close Price')plt.legend()plt.show()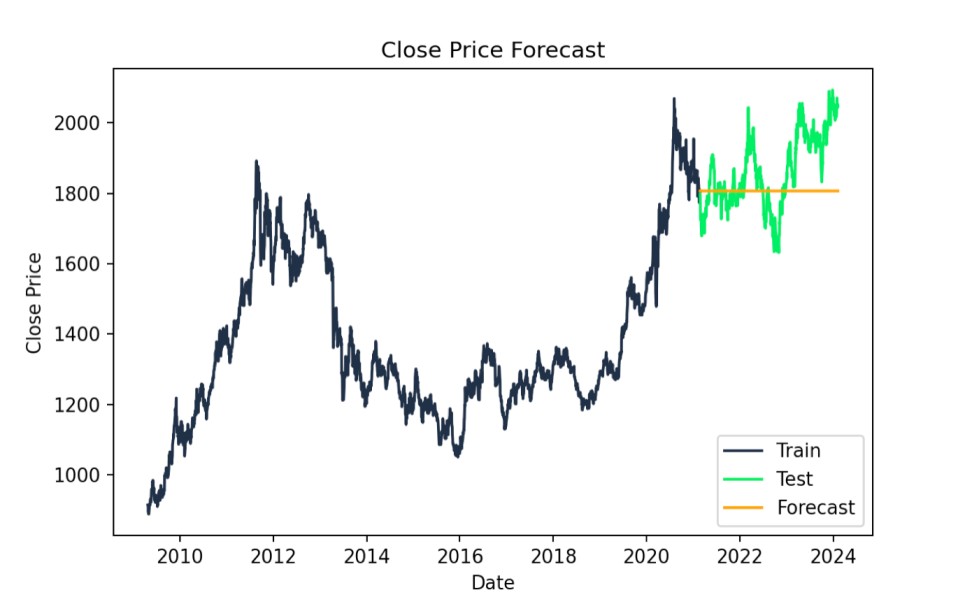
ARIMA पूर्वानुमान: वास्तविक बनाम अनुमानित मान। इमेज लेखक द्वारा
हम AIC और BIC मॉडल सांख्यिकी देखते हैं। कम मान बेहतर फिट का संकेत देते हैं, लेकिन ओवरफिटिंग से बचने के लिए हम परिणामों की तुलना सरल मॉडलों से भी कर सकते हैं। मैं यहां संख्याएं प्रिंट कर रहा हूं, लेकिन वे सबसे अधिक समझ तब आती हैं जब हम उसी डेटा पर अन्य ARIMA मॉडलों से तुलना करते हैं, ताकि सबसे अच्छा काम करने वाला ARIMA मॉडल खोजा जा सके।
print(f"AIC: {model_fit.aic}")print(f"BIC: {model_fit.bic}")AIC: 24602.97426066606BIC: 24620.97128230579हम मीन स्क्वेयर्ड एरर का भी मूल्यांकन कर सकते हैं, ताकि अपने मॉडल के फिट का आकलन कर सकें। यह एक प्रैक्टिकल मीट्रिक है। कम RMSE एक बेहतर ARIMA मॉडल को दर्शाता है, जो वास्तविक और पूर्वानुमानित मानों के बीच छोटे अंतर को परिलक्षित करता है, और यह डेटा के स्केल पर होता है। यानी, 118.5339 का RMSE दर्शाता है कि औसतन, हमारे मॉडल की भविष्यवाणियां वास्तविक Close कीमतों से लगभग $118.53 तक भिन्न होती हैं।
forecast = forecast[:len(test)]test_close = test["Close"][:len(forecast)]# Calculate RMSErmse = np.sqrt(mean_squared_error(test_close, forecast))print(f"RMSE: {rmse:.4f}")RMSE: 118.5339DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स