

डेटा को ट्रेनिंग सेट और टेस्ट सेट में विभाजित करना
आप मिड-प्राइस का उपयोग करेंगे, जिसे किसी दिन दर्ज उच्चतम और न्यूनतम कीमतों के औसत से निकाला जाता है।
# First calculate the mid prices from the highest and lowest
high_prices = df.loc[:,'High'].as_matrix()
low_prices = df.loc[:,'Low'].as_matrix()
mid_prices = (high_prices+low_prices)/2.0
अब, आप ट्रेनिंग डेटा और टेस्ट डेटा को विभाजित कर सकते हैं। ट्रेनिंग डेटा टाइम सीरीज़ के पहले 11,000 डेटा पॉइंट होंगे, और शेष टेस्ट डेटा होगा।
train_data = mid_prices[:11000]
test_data = mid_prices[11000:]
डेटा को नॉर्मलाइज़ करना
अब, आपको डेटा को नॉर्मलाइज़ करने के लिए एक स्केलर परिभाषित करने की आवश्यकता है। MinMaxScalar सभी डेटा को 0 और 1 के बीच स्केल करता है। आप ट्रेनिंग और टेस्ट डेटा को [data_size, num_features] के आकार में भी रीशेप कर सकते हैं।
# Scale the data to be between 0 and 1
# When scaling remember! You normalize both test and train data with respect to training data
# Because you are not supposed to have access to test data
scaler = MinMaxScaler()
train_data = train_data.reshape(-1,1)
test_data = test_data.reshape(-1,1)
आपके पहले के अवलोकन के अनुसार कि अलग-अलग समय अवधियों के डेटा के मान-रेंज अलग-अलग हैं, आप पूरी श्रंखला को विंडोज़ में बाँटकर डेटा को नॉर्मलाइज़ करते हैं। यदि आप ऐसा नहीं करेंगे, तो पहले के डेटा 0 के क़रीब होंगे और लर्निंग प्रक्रिया में अधिक मूल्य नहीं जोड़ेंगे। यहाँ, आप 2500 की विंडो साइज चुनते हैं।
टिप: विंडो साइज चुनते समय, सुनिश्चित करें कि यह बहुत छोटा न हो। जब आप विंडो-बेस्ड नॉर्मलाइज़ेशन करते हैं, तो प्रत्येक विंडो के बिल्कुल अंत में एक ब्रेक आ सकता है, क्योंकि हर विंडो को स्वतंत्र रूप से नॉर्मलाइज़ किया जाता है।
इस उदाहरण में, 4 डेटा पॉइंट प्रभावित होंगे। लेकिन चूँकि आपके पास 11,000 डेटा पॉइंट हैं, 4 पॉइंट कोई समस्या नहीं पैदा करेंगे।
# Train the Scaler with training data and smooth data
smoothing_window_size = 2500
for di in range(0,10000,smoothing_window_size):
scaler.fit(train_data[di:di+smoothing_window_size,:])
train_data[di:di+smoothing_window_size,:] = scaler.transform(train_data[di:di+smoothing_window_size,:])
# You normalize the last bit of remaining data
scaler.fit(train_data[di+smoothing_window_size:,:])
train_data[di+smoothing_window_size:,:] = scaler.transform(train_data[di+smoothing_window_size:,:])
डेटा को फिर से [data_size] के आकार में रीशेप करें
# Reshape both train and test data
train_data = train_data.reshape(-1)
# Normalize test data
test_data = scaler.transform(test_data).reshape(-1)
अब आप एक्स्पोनेंशियल मूविंग एवरेज का उपयोग करके डेटा को स्मूद कर सकते हैं। इससे स्टॉक कीमतों की अंतर्निहित खुरदुराहट कम होती है और एक स्मूद कर्व बनता है।
नोट कि आपको केवल ट्रेनिंग डेटा को ही स्मूद करना चाहिए।
# Now perform exponential moving average smoothing
# So the data will have a smoother curve than the original ragged data
EMA = 0.0
gamma = 0.1
for ti in range(11000):
EMA = gamma*train_data[ti] + (1-gamma)*EMA
train_data[ti] = EMA
# Used for visualization and test purposes
all_mid_data = np.concatenate([train_data,test_data],axis=0)
एवरेजिंग के जरिए एक-स्टेप-एहेड प्रेडिक्शन
एवरेजिंग मेकेनिज़्म आपको भविष्य की स्टॉक कीमत को पहले देखी गई स्टॉक कीमतों के औसत के रूप में दर्शाकर (अक्सर एक समय-चरण आगे) अनुमान लगाने देते हैं। इसे एक से अधिक समय-चरणों के लिए करना काफ़ी खराब परिणाम दे सकता है। आप दो एवरेजिंग तकनीकों को देखेंगे: नीचे मानक एवरेजिंग और एक्स्पोनेंशियल मूविंग एवरेज। आप दोनों एल्गोरिद्म द्वारा दिए गए परिणामों का गुणात्मक (विज़ुअल इंस्पेक्शन) और मात्रात्मक (Mean Squared Error) मूल्यांकन करेंगे।
मीन स्क्वायर्ड एरर (MSE) को एक-स्टेप-एहेड पर सच्चे मान और प्रेडिक्टेड मान के बीच का स्क्वायर्ड एरर लेकर और उसे सभी भविष्यवाणियों पर औसत करके निकाला जा सकता है।
मानक औसत
आप इस समस्या की कठिनाई को पहले इसे औसत गणना समस्या के रूप में मॉडल करने की कोशिश करके समझ सकते हैं। पहले, आप भविष्य की स्टॉक मार्केट कीमतों (उदाहरण के लिए, xt+1) को एक निश्चित आकार की विंडो (उदाहरण के लिए, xt-N, ..., xt) (मान लें पिछले 100 दिन) के भीतर पहले देखी गई स्टॉक मार्केट कीमतों के औसत के रूप में प्रेडिक्ट करने की कोशिश करेंगे। उसके बाद, आप थोड़ा अधिक उन्नत "एक्स्पोनेंशियल मूविंग एवरेज" तरीके को आज़माएँगे और देखेंगे कि वह कैसा करता है। फिर, आप टाइम-सीरीज़ प्रेडिक्शन के "अमर स्रोत" पर जाएँगे: Long Short-Term Memory मॉडल्स।
पहले, आप देखेंगे कि सामान्य एवरेजिंग कैसे काम करती है। यानी, आप कहते हैं,

दूसरे शब्दों में, आप कहते हैं कि $t+1$ पर प्रेडिक्शन उन सभी स्टॉक कीमतों के औसत के बराबर है जिन्हें आपने $t$ से $t-N$ की विंडो में देखा है।
window_size = 100
N = train_data.size
std_avg_predictions = []
std_avg_x = []
mse_errors = []
for pred_idx in range(window_size,N):
if pred_idx >= N:
date = dt.datetime.strptime(k, '%Y-%m-%d').date() + dt.timedelta(days=1)
else:
date = df.loc[pred_idx,'Date']
std_avg_predictions.append(np.mean(train_data[pred_idx-window_size:pred_idx]))
mse_errors.append((std_avg_predictions[-1]-train_data[pred_idx])**2)
std_avg_x.append(date)
print('MSE error for standard averaging: %.5f'%(0.5*np.mean(mse_errors)))
MSE error for standard averaging: 0.00418
नीचे एवरेज किए गए परिणामों पर नज़र डालें। ये स्टॉक के वास्तविक व्यवहार का काफी करीब से अनुसरण करते हैं। अगला, आप एक अधिक सटीक एक-स्टेप प्रेडिक्शन विधि की जाँच करेंगे।
plt.figure(figsize = (18,9)) plt.plot(range(df.shape[0]),all_mid_data,color='b',label='True') plt.plot(range(window_size,N),std_avg_predictions,color='orange',label='Prediction') #plt.xticks(range(0,df.shape[0],50),df['Date'].loc[::50],rotation=45) plt.xlabel('Date') plt.ylabel('Mid Price') plt.legend(fontsize=18) plt.show()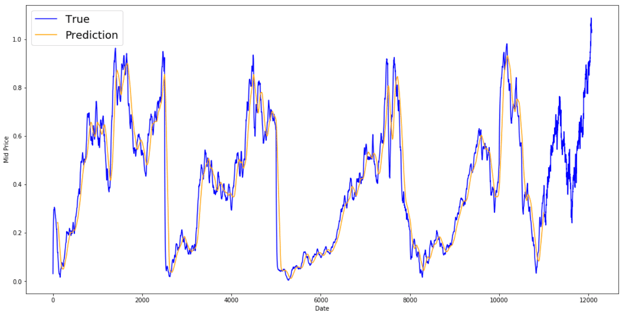
तो उपरोक्त ग्राफ़ (और MSE) क्या बताते हैं?
लगता है कि बहुत छोटे प्रेडिक्शंस (एक दिन आगे) के लिए यह बहुत बुरा मॉडल नहीं है। यह व्यवहार तर्कसंगत है क्योंकि स्टॉक कीमतें रातों-रात 0 से 100 नहीं बदलतीं। अब, आप एक अधिक उन्नत एवरेजिंग तकनीक, एक्स्पोनेंशियल मूविंग एवरेज, पर नज़र डालेंगे।
एक्स्पोनेंशियल मूविंग एवरेज
आपने इंटरनेट पर कुछ लेख देखे होंगे जो बहुत जटिल मॉडल्स का उपयोग करते हैं और स्टॉक मार्केट के लगभग सटीक व्यवहार की भविष्यवाणी करते हैं। लेकिन सावधान! ये सिर्फ ऑप्टिकल इल्यूज़न हैं, किसी उपयोगी चीज़ के सीखने की वजह से नहीं। आप नीचे देखेंगे कि एक साधारण एवरेजिंग विधि से आप उस व्यवहार की नकल कैसे कर सकते हैं।
एक्स्पोनेंशियल मूविंग एवरेज विधि में, आप $x_{t+1}$ को इस प्रकार निकालते हैं,
- $x\_{t+1} = EMA\_{t} = \gamma \times EMA_{t-1} + (1-\gamma) x_t$ जहाँ $EMA_0 = 0$ और $EMA$ वह एक्स्पोनेंशियल मूविंग एवरेज मान है जिसे आप समय के साथ बनाए रखते हैं।
उपरोक्त समीकरण मूलतः $t+1$ समय-चरण से एक्स्पोनेंशियल मूविंग एवरेज की गणना करता है और उसे एक-स्टेप-एहेड प्रेडिक्शन के रूप में उपयोग करता है। $\gamma$ यह तय करता है कि EMA में सबसे हालिया मान का योगदान कितना है। उदाहरण के लिए, $\gamma=0.1$ होने पर वर्तमान मान का केवल 10% EMA में आता है। क्योंकि आप हालिया मान का बहुत छोटा अंश लेते हैं, यह औसत में बहुत पहले देखे गए पुराने मानों को संरक्षित करने देता है। देखें कि एक-स्टेप-एहेड प्रेडिक्शन के लिए उपयोग किए जाने पर यह कितना अच्छा दिखता है।
window_size = 100
N = train_data.size
run_avg_predictions = []
run_avg_x = []
mse_errors = []
running_mean = 0.0
run_avg_predictions.append(running_mean)
decay = 0.5
for pred_idx in range(1,N):
running_mean = running_mean*decay + (1.0-decay)*train_data[pred_idx-1]
run_avg_predictions.append(running_mean)
mse_errors.append((run_avg_predictions[-1]-train_data[pred_idx])**2)
run_avg_x.append(date)
print('MSE error for EMA averaging: %.5f'%(0.5*np.mean(mse_errors)))
MSE error for EMA averaging: 0.00003
plt.figure(figsize = (18,9))
plt.plot(range(df.shape[0]),all_mid_data,color='b',label='True')
plt.plot(range(0,N),run_avg_predictions,color='orange', label='Prediction')
#plt.xticks(range(0,df.shape[0],50),df['Date'].loc[::50],rotation=45)
plt.xlabel('Date')
plt.ylabel('Mid Price')
plt.legend(fontsize=18)
plt.show()
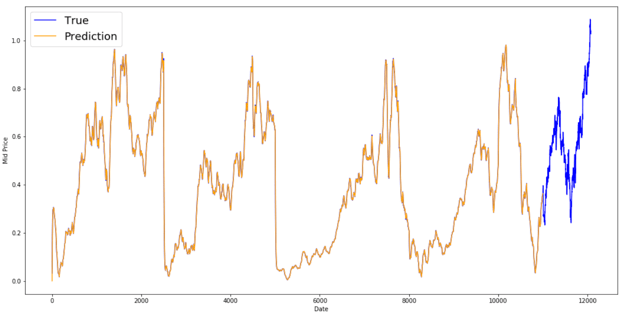
यदि एक्स्पोनेंशियल मूविंग एवरेज इतना अच्छा है, तो बेहतर मॉडल्स की आवश्यकता क्यों?
आप देखते हैं कि यह True वितरण का अनुसरण करती एक परफेक्ट रेखा फिट करता है (और बहुत कम MSE से भी पुष्टि होती है)। व्यवहारिक रूप से, आप केवल अगले दिन के स्टॉक मार्केट मूल्य से बहुत कुछ कर नहीं सकते। व्यक्तिगत रूप से, मुझे अगले दिन का सटीक स्टॉक मार्केट मूल्य नहीं चाहिए, बल्कि क्या अगले 30 दिनों में स्टॉक मार्केट की कीमतें ऊपर जाएँगी या नीचे? यह करने की कोशिश करें, और आप EMA विधि की अक्षमता उजागर कर देंगे।
अब आप विंडोज़ में प्रेडिक्शन करने की कोशिश करेंगे (मान लें आप सिर्फ अगले दिन की बजाय अगले 2 दिनों की विंडो का अनुमान लगाते हैं)। तब, आपको एहसास होगा कि EMA कितना गलत जा सकता है। यहाँ एक उदाहरण है:
भविष्य में एक से अधिक स्टेप आगे तक अनुमान लगाएँ
चीजों को ठोस बनाने के लिए, मान लें मान हैं, $x_t=0.4$, $EMA=0.5$ और $\gamma = 0.5$
- मान लें कि आपको निम्नलिखित समीकरण से आउटपुट मिलता है
- Xt+1 = EMAt = γ × EMAt-1 + (1 - γ)Xt
- तो आपके पास xt+1 = 0.5 × 0.5 + (1-0.5) × 0.4 = 0.45
- तो Xt+1 = EMAt = 0.45
- तो अगला प्रेडिक्शन Xt+2 बनता है,
- Xt+2 = γ × EMAt + (1-γ)Xt+1
- जो है Xt+2 = γ × EMA_t + (1-γ) EMAt = EMAt
- या इस उदाहरण में, Xt+2 = Xt+1 = 0.45
तो, भविष्य में आप कितने भी स्टेप का अनुमान लगाएँ, आपको सभी भविष्यवाणी स्टेप्स के लिए वही उत्तर मिलता रहेगा।
एक समाधान जो आपके पास है और उपयोगी जानकारी आउटपुट देगा, वह है मोमेंटम-आधारित एल्गोरिद्म देखना। वे सटीक मानों के बजाय इस आधार पर अनुमान लगाते हैं कि हाल के पिछले मान ऊपर जा रहे थे या नीचे। उदाहरण के लिए, यदि कीमतें पिछले कुछ दिनों से गिर रही हैं, तो वे कहेंगे कि अगले दिन की कीमत शायद कम होगी, जो उचित लगता है। हालाँकि, आप एक अधिक जटिल मॉडल उपयोग करेंगे: एक LSTM मॉडल।
इन मॉडलों ने टाइम सीरीज़ प्रेडिक्शन के क्षेत्र में इसलिए धूम मचा दी है क्योंकि वे टाइम सीरीज़ डेटा को मॉडल करने में बहुत अच्छे हैं। आप देखेंगे कि क्या डेटा में छिपे ऐसे पैटर्न हैं जिनका आप लाभ उठा सकते हैं।
LSTM का परिचय: भविष्य में बहुत आगे तक स्टॉक मूवमेंट प्रेडिक्शंस
लॉन्ग-शॉर्ट-टर्म मेमोरी मॉडल अत्यंत शक्तिशाली टाइम-सीरीज़ मॉडल हैं। वे भविष्य में मनमाने संख्या के स्टेप तक अनुमान लगा सकते हैं। एक LSTM मॉड्यूल (या सेल) में 5 आवश्यक घटक होते हैं, जो इसे लम्बी और अल्प अवधि दोनों तरह के डेटा को मॉडल करने देते हैं।
- सेल स्टेट (ct) - यह सेल की आंतरिक मेमोरी का प्रतिनिधित्व करता है, जो शॉर्ट-टर्म और लॉन्ग-टर्म दोनों मेमोरीज़ को स्टोर करता है।
- हिडन स्टेट (ht) - यह आउटपुट स्टेट सूचना है जो वर्तमान इनपुट, पिछले हिडन स्टेट और वर्तमान सेल इनपुट के संदर्भ में गणना की जाती है, जिसे आप अंततः भविष्य की स्टॉक मार्केट कीमतें प्रेडिक्ट करने के लिए उपयोग करते हैं। अतिरिक्त रूप से, हिडन स्टेट यह तय कर सकता है कि अगली भविष्यवाणी करने के लिए सेल स्टेट में स्टोर की गई केवल शॉर्ट- या लॉन्ग-टर्म मेमोरीज़ या दोनों प्रकार की मेमोरी को ही पुनः प्राप्त किया जाए।
- इनपुट गेट (it) - तय करता है कि वर्तमान इनपुट से कितनी जानकारी सेल स्टेट में प्रवाहित होती है।
- फॉरगेट गेट (ft) - तय करता है कि वर्तमान इनपुट और पिछले सेल स्टेट से कितनी जानकारी वर्तमान सेल स्टेट में प्रवाहित होती है।
- आउटपुट गेट (ot) - तय करता है कि वर्तमान सेल स्टेट से कितनी जानकारी हिडन स्टेट में प्रवाहित होती है ताकि जरूरत पड़ने पर LSTM केवल लॉन्ग-टर्म मेमोरीज़ या शॉर्ट-टर्म और लॉन्ग-टर्म दोनों मेमोरीज़ को ही चुन सके।
एक सेल को नीचे दर्शाया गया है:
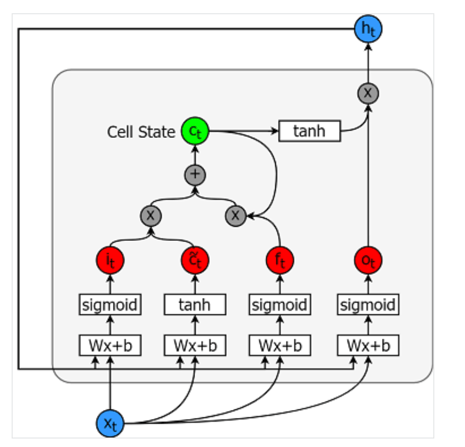
इन इकाइयों की गणना के समीकरण निम्नलिखित हैं।
- it = σ(WixXt + Wihht-1 + bi)
- $\tilde{c}\_t = \sigma(W\_{cx}x\_t + W\_{ch}h_{t-1} + b_c)$
- $f\_t = \sigma(W\_{fx}x\_t + W\_{fh}h_{t-1}+b_f)$
- $c_t = f\_t c\_{t-1} + i_t \tilde{c}_t$
- $o\_t = \sigma(W\_{ox}x\_t + W\_{oh}h_{t-1}+b_o)$
- $h_t = o_t tanh(c_t)$
आप LSTMs की बेहतर (अधिक तकनीकी) समझ के लिए इस लेख को देख सकते हैं।
TensorFlow टाइम सीरीज़ मॉडल्स को लागू करने के लिए एक अच्छा API (RNN API) प्रदान करता है। आप अपने इम्प्लीमेंटेशंस के लिए इसका उपयोग करेंगे।
डेटा जनरेटर
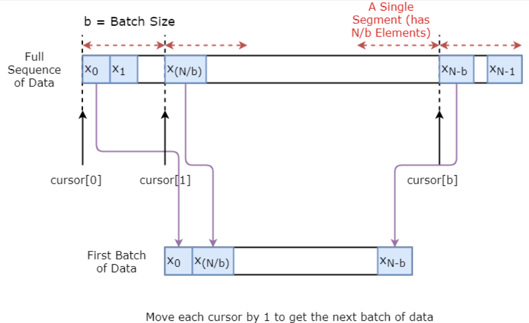
आप पहले अपने मॉडल को ट्रेन करने के लिए एक डेटा जनरेटर लागू करने जा रहे हैं। इस डेटा जनरेटर में .unroll_batches(...) नामक एक मेथड होगा जो क्रमिक रूप से प्राप्त num_unrollings इनपुट डेटा बैचों का सेट आउटपुट करेगा, जहाँ डेटा का एक बैच [batch_size, 1] आकार का होगा। तब, प्रत्येक इनपुट डेटा बैच का एक संबंधित आउटपुट डेटा बैच होगा।
उदाहरण के लिए यदि num_unrollings=3 और batch_size=4 हो, तो अनरोल्ड बैचों का सेट कुछ इस तरह दिख सकता है,
- इनपुट डेटा: $[x_0,x_10,x_20,x_30], [x_1,x_11,x_21,x_31], [x_2,x_12,x_22,x_32]$
- आउटपुट डेटा: $[x_1,x_11,x_21,x_31], [x_2,x_12,x_22,x_32], [x_3,x_13,x_23,x_33]$
डेटा ऑगमेंटेशन
साथ ही, अपने मॉडल को रॉबस्ट बनाने के लिए, आप $x\_t$ के लिए आउटपुट हमेशा $x\_{t+1}$ नहीं रखेंगे। बल्कि आप $x\_{t+1},x\_{t+2},\ldots,x_{t+N}$ के सेट से यादृच्छिक रूप से एक आउटपुट सैंपल करेंगे जहाँ $N$ एक छोटी विंडो साइज है।
यहाँ, आप निम्नलिखित मान्यता बना रहे हैं:
- $x\_{t+1},x\_{t+2},\ldots,x_{t+N}$ एक-दूसरे से बहुत दूर नहीं होंगे
व्यक्तिगत रूप से, मुझे लगता है कि स्टॉक मूवमेंट प्रेडिक्शंस के लिए यह एक उचित मान्यता है।
नीचे, आप दर्शाते हैं कि डेटा का एक बैच विज़ुअली कैसे बनाया जाता है।
class DataGeneratorSeq(object):
def __init__(self,prices,batch_size,num_unroll):
self._prices = prices
self._prices_length = len(self._prices) - num_unroll
self._batch_size = batch_size
self._num_unroll = num_unroll
self._segments = self._prices_length //self._batch_size
self._cursor = [offset * self._segments for offset in range(self._batch_size)]
def next_batch(self):
batch_data = np.zeros((self._batch_size),dtype=np.float32)
batch_labels = np.zeros((self._batch_size),dtype=np.float32)
for b in range(self._batch_size):
if self._cursor[b]+1>=self._prices_length:
#self._cursor[b] = b * self._segments
self._cursor[b] = np.random.randint(0,(b+1)*self._segments)
batch_data[b] = self._prices[self._cursor[b]]
batch_labels[b]= self._prices[self._cursor[b]+np.random.randint(0,5)]
self._cursor[b] = (self._cursor[b]+1)%self._prices_length
return batch_data,batch_labels
def unroll_batches(self):
unroll_data,unroll_labels = [],[]
init_data, init_label = None,None
for ui in range(self._num_unroll):
data, labels = self.next_batch()
unroll_data.append(data)
unroll_labels.append(labels)
return unroll_data, unroll_labels
def reset_indices(self):
for b in range(self._batch_size):
self._cursor[b] = np.random.randint(0,min((b+1)*self._segments,self._prices_length-1))
dg = DataGeneratorSeq(train_data,5,5)
u_data, u_labels = dg.unroll_batches()
for ui,(dat,lbl) in enumerate(zip(u_data,u_labels)):
print('\n\nUnrolled index %d'%ui)
dat_ind = dat
lbl_ind = lbl
print('\tInputs: ',dat )
print('\n\tOutput:',lbl)
Unrolled index 0
Inputs: [0.03143791 0.6904868 0.82829314 0.32585657 0.11600105]
Output: [0.08698314 0.68685144 0.8329321 0.33355275 0.11785509]
Unrolled index 1
Inputs: [0.06067836 0.6890754 0.8325337 0.32857886 0.11785509]
Output: [0.15261841 0.68685144 0.8325337 0.33421066 0.12106793]
Unrolled index 2
Inputs: [0.08698314 0.68685144 0.8329321 0.33078218 0.11946969]
Output: [0.11098009 0.6848606 0.83387965 0.33421066 0.12106793]
Unrolled index 3
Inputs: [0.11098009 0.6858036 0.83294916 0.33219692 0.12106793]
Output: [0.132895 0.6836884 0.83294916 0.33219692 0.12288672]
Unrolled index 4
Inputs: [0.132895 0.6848606 0.833369 0.33355275 0.12158521]
Output: [0.15261841 0.6836884 0.83383167 0.33355275 0.12230608]
हाइपरपैरामीटर्स परिभाषित करना
इस सेक्शन में, आप कई हाइपरपैरामीटर्स परिभाषित करेंगे। D इनपुट का आयाम है। यह सीधा है, क्योंकि आप पिछले स्टॉक प्राइस को इनपुट के रूप में लेते हैं और अगला प्रेडिक्ट करते हैं, जो 1 होना चाहिए।
फिर आपके पास num_unrollings है, यह बैकप्रोपेगेशन थ्रू टाइम (BPTT) से संबंधित एक हाइपरपैरामीटर है जिसका उपयोग LSTM मॉडल को ऑप्टिमाइज़ करने के लिए किया जाता है। यह दर्शाता है कि आप एक सिंगल ऑप्टिमाइज़ेशन स्टेप के लिए कितने लगातार समय-चरणों पर विचार करते हैं। आप इसे ऐसे सोच सकते हैं कि एक समय-चरण को देखकर मॉडल को ऑप्टिमाइज़ करने के बजाय, आप num_unrollings समय-चरणों को देखकर नेटवर्क को ऑप्टिमाइज़ करते हैं। जितना बड़ा उतना बेहतर।
फिर आपके पास batch_size है। बैच साइज यह है कि आप एक समय-चरण में कितने डेटा सैंपल पर विचार करते हैं।
अगला आप num_nodes परिभाषित करते हैं जो प्रत्येक सेल में छिपे हुए न्यूरॉन्स की संख्या का प्रतिनिधित्व करता है। आप देख सकते हैं कि इस उदाहरण में LSTMs की तीन लेयर्स हैं।
D = 1 # Dimensionality of the data. Since your data is 1-D this would be 1
num_unrollings = 50 # Number of time steps you look into the future.
batch_size = 500 # Number of samples in a batch
num_nodes = [200,200,150] # Number of hidden nodes in each layer of the deep LSTM stack we're using
n_layers = len(num_nodes) # number of layers
dropout = 0.2 # dropout amount
tf.reset_default_graph() # This is important in case you run this multiple times
इनपुट्स और आउटपुट्स परिभाषित करना
अगले चरण में, आप ट्रेनिंग इनपुट्स और लेबल्स के लिए प्लेसहोल्डर्स परिभाषित करते हैं। यह बहुत सीधा है क्योंकि आपके पास इनपुट प्लेसहोल्डर्स की एक सूची है, जिनमें से प्रत्येक में डेटा का एक सिंगल बैच होता है। और सूची में num_unrollings प्लेसहोल्डर्स होते हैं, जिनका एक बार में एक सिंगल ऑप्टिमाइज़ेशन स्टेप के लिए उपयोग किया जाएगा।
# Input data.
train_inputs, train_outputs = [],[]
# You unroll the input over time defining placeholders for each time step
for ui in range(num_unrollings):
train_inputs.append(tf.placeholder(tf.float32, shape=[batch_size,D],name='train_inputs_%d'%ui))
train_outputs.append(tf.placeholder(tf.float32, shape=[batch_size,1], name = 'train_outputs_%d'%ui))
LSTM और रिग्रेशन लेयर के पैरामीटर्स परिभाषित करना
आपके पास तीन लेयर्स के LSTMs और एक लीनियर रिग्रेशन लेयर होगा, जिसे w और b द्वारा दर्शाया गया है, जो अंतिम LSTM सेल के आउटपुट को लेता है और अगले समय-चरण के लिए प्रेडिक्शन आउटपुट करता है। आप TensorFlow में MultiRNNCell का उपयोग करके बनाए गए तीन LSTMCell ऑब्जेक्ट्स को एन्कैप्सुलेट कर सकते हैं। अतिरिक्त रूप से, आप ड्रॉपआउट इम्प्लीमेंटेड LSTM सेल्स रख सकते हैं, जो प्रदर्शन में सुधार और ओवरफिटिंग में कमी लाते हैं।
lstm_cells = [
tf.contrib.rnn.LSTMCell(num_units=num_nodes[li],
state_is_tuple=True,
initializer= tf.contrib.layers.xavier_initializer()
)
for li in range(n_layers)]
drop_lstm_cells = [tf.contrib.rnn.DropoutWrapper(
lstm, input_keep_prob=1.0,output_keep_prob=1.0-dropout, state_keep_prob=1.0-dropout
) for lstm in lstm_cells]
drop_multi_cell = tf.contrib.rnn.MultiRNNCell(drop_lstm_cells)
multi_cell = tf.contrib.rnn.MultiRNNCell(lstm_cells)
w = tf.get_variable('w',shape=[num_nodes[-1], 1], initializer=tf.contrib.layers.xavier_initializer())
b = tf.get_variable('b',initializer=tf.random_uniform([1],-0.1,0.1))
LSTM आउटपुट की गणना करना और अंतिम प्रेडिक्शन पाने के लिए उसे रिग्रेशन लेयर में फीड करना
इस सेक्शन में, आप पहले TensorFlow वेरिएबल्स (c और h) बनाएँगे जो LSTM सेल का सेल स्टेट और हिडन स्टेट होल्ड करेंगे। फिर आप train_inputs की सूची को [num_unrollings, batch_size, D] आकार में ट्रांसफ़ॉर्म करते हैं, जो tf.nn.dynamic_rnn फ़ंक्शन के साथ आउटपुट्स की गणना करने के लिए आवश्यक है। फिर आप tf.nn.dynamic_rnn फ़ंक्शन से LSTM आउटपुट्स की गणना करते हैं और आउटपुट को वापस num_unrolling टेन्सर्स की सूची में विभाजित करते हैं। the loss between the predictions and true stock prices.
# Create cell state and hidden state variables to maintain the state of the LSTM
c, h = [],[]
initial_state = []
for li in range(n_layers):
c.append(tf.Variable(tf.zeros([batch_size, num_nodes[li]]), trainable=False))
h.append(tf.Variable(tf.zeros([batch_size, num_nodes[li]]), trainable=False))
initial_state.append(tf.contrib.rnn.LSTMStateTuple(c[li], h[li]))
# Do several tensor transofmations, because the function dynamic_rnn requires the output to be of
# a specific format. Read more at: https://www.tensorflow.org/api_docs/python/tf/nn/dynamic_rnn
all_inputs = tf.concat([tf.expand_dims(t,0) for t in train_inputs],axis=0)
# all_outputs is [seq_length, batch_size, num_nodes]
all_lstm_outputs, state = tf.nn.dynamic_rnn(
drop_multi_cell, all_inputs, initial_state=tuple(initial_state),
time_major = True, dtype=tf.float32)
all_lstm_outputs = tf.reshape(all_lstm_outputs, [batch_size*num_unrollings,num_nodes[-1]])
all_outputs = tf.nn.xw_plus_b(all_lstm_outputs,w,b)
split_outputs = tf.split(all_outputs,num_unrollings,axis=0)
लॉस कैलकुलेशन और ऑप्टिमाइज़र
अब, आप लॉस की गणना करेंगे। हालाँकि, आपको ध्यान देना चाहिए कि लॉस की गणना करते समय एक विशिष्ट विशेषता होती है। प्रत्येक प्रेडिक्शंस और सच्चे आउटपुट्स के बैच के लिए, आप Mean Squared Error की गणना करते हैं। और आप इन सभी मीन स्क्वायर्ड लॉसेस को जोड़ते हैं (औसत नहीं लेते)। अंत में, आप ऑप्टिमाइज़र परिभाषित करते हैं जिसका उपयोग आप न्यूरल नेटवर्क को ऑप्टिमाइज़ करने के लिए करने जा रहे हैं। इस मामले में, आप Adam का उपयोग कर सकते हैं, जो एक बहुत हालिया और अच्छा प्रदर्शन करने वाला ऑप्टिमाइज़र है।
# When calculating the loss you need to be careful about the exact form, because you calculate
# loss of all the unrolled steps at the same time
# Therefore, take the mean error or each batch and get the sum of that over all the unrolled steps
print('Defining training Loss')
loss = 0.0
with tf.control_dependencies([tf.assign(c[li], state[li][0]) for li in range(n_layers)]+
[tf.assign(h[li], state[li][1]) for li in range(n_layers)]):
for ui in range(num_unrollings):
loss += tf.reduce_mean(0.5*(split_outputs[ui]-train_outputs[ui])**2)
print('Learning rate decay operations')
global_step = tf.Variable(0, trainable=False)
inc_gstep = tf.assign(global_step,global_step + 1)
tf_learning_rate = tf.placeholder(shape=None,dtype=tf.float32)
tf_min_learning_rate = tf.placeholder(shape=None,dtype=tf.float32)
learning_rate = tf.maximum(
tf.train.exponential_decay(tf_learning_rate, global_step, decay_steps=1, decay_rate=0.5, staircase=True),
tf_min_learning_rate)
# Optimizer.
print('TF Optimization operations')
optimizer = tf.train.AdamOptimizer(learning_rate)
gradients, v = zip(*optimizer.compute_gradients(loss))
gradients, _ = tf.clip_by_global_norm(gradients, 5.0)
optimizer = optimizer.apply_gradients(
zip(gradients, v))
print('\tAll done')
Defining training Loss
Learning rate decay operations
TF Optimization operations
All done
प्रेडिक्शन से संबंधित गणनाएँ
यहाँ आप प्रेडिक्शन से संबंधित TensorFlow ऑपरेशंस परिभाषित करते हैं। पहले, इनपुट फीड करने के लिए एक प्लेसहोल्डर (sample_inputs) परिभाषित करें, फिर ट्रेनिंग स्टेज के समान, आप प्रेडिक्शन के लिए स्टेट वेरिएबल्स (sample_c और sample_h) परिभाषित करते हैं। अंत में आप tf.nn.dynamic_rnn फ़ंक्शन से प्रेडिक्शन की गणना करते हैं और फिर आउटपुट को रिग्रेशन लेयर (w और b) से गुजारते हैं। आपको reset_sample_state ऑपरेशन भी परिभाषित करना चाहिए, जो सेल स्टेट और हिडन स्टेट को रीसेट करता है। हर बार जब आप प्रेडिक्शंस की एक श्रृंखला बनाते हैं, तो आपको शुरुआत में इस ऑपरेशन को निष्पादित करना चाहिए।
print('Defining prediction related TF functions')
sample_inputs = tf.placeholder(tf.float32, shape=[1,D])
# Maintaining LSTM state for prediction stage
sample_c, sample_h, initial_sample_state = [],[],[]
for li in range(n_layers):
sample_c.append(tf.Variable(tf.zeros([1, num_nodes[li]]), trainable=False))
sample_h.append(tf.Variable(tf.zeros([1, num_nodes[li]]), trainable=False))
initial_sample_state.append(tf.contrib.rnn.LSTMStateTuple(sample_c[li],sample_h[li]))
reset_sample_states = tf.group(*[tf.assign(sample_c[li],tf.zeros([1, num_nodes[li]])) for li in range(n_layers)],
*[tf.assign(sample_h[li],tf.zeros([1, num_nodes[li]])) for li in range(n_layers)])
sample_outputs, sample_state = tf.nn.dynamic_rnn(multi_cell, tf.expand_dims(sample_inputs,0),
initial_state=tuple(initial_sample_state),
time_major = True,
dtype=tf.float32)
with tf.control_dependencies([tf.assign(sample_c[li],sample_state[li][0]) for li in range(n_layers)]+
[tf.assign(sample_h[li],sample_state[li][1]) for li in range(n_layers)]):
sample_prediction = tf.nn.xw_plus_b(tf.reshape(sample_outputs,[1,-1]), w, b)
print('\tAll done')
Defining prediction related TF functions
All done
LSTM चलाना
यहाँ आप कई epochs के लिए स्टॉक प्राइस मूवमेंट्स को ट्रेन और प्रेडिक्ट करेंगे और देखेंगे कि समय के साथ प्रेडिक्शंस बेहतर होते हैं या बदतर। आप निम्नलिखित प्रक्रिया का पालन करते हैं।
- टाइम सीरीज़ पर मॉडल का मूल्यांकन करने के लिए एक टेस्ट सेट के प्रारंभिक बिंदु (
test_points_seq) परिभाषित करें - प्रत्येक epoch के लिए
- ट्रेनिंग डेटा की पूरी श्रृंखला लंबाई के लिए
num_unrollingsबैचों का एक सेट अनरोल करें- अनरोल्ड बैचों के साथ न्यूरल नेटवर्क को ट्रेन करें
- औसत ट्रेनिंग लॉस की गणना करें
- टेस्ट सेट में प्रत्येक प्रारंभिक बिंदु के लिए
- टेस्ट पॉइंट से पहले मिलने वाले पिछले
num_unrollingsडेटा पॉइंट्स को इटरेट करके LSTM स्टेट अपडेट करें n_predict_onceस्टेप्स के लिए लगातार प्रेडिक्शन करें, पिछली भविष्यवाणी को वर्तमान इनपुट के रूप में उपयोग करते हुए- प्रेडिक्ट किए गए
n_predict_onceपॉइंट्स और उन टाइम स्टैम्प्स पर वास्तविक स्टॉक कीमतों के बीच MSE लॉस की गणना करें
- टेस्ट पॉइंट से पहले मिलने वाले पिछले
- ट्रेनिंग डेटा की पूरी श्रृंखला लंबाई के लिए
epochs = 30
valid_summary = 1 # Interval you make test predictions
n_predict_once = 50 # Number of steps you continously predict for
train_seq_length = train_data.size # Full length of the training data
train_mse_ot = [] # Accumulate Train losses
test_mse_ot = [] # Accumulate Test loss
predictions_over_time = [] # Accumulate predictions
session = tf.InteractiveSession()
tf.global_variables_initializer().run()
# Used for decaying learning rate
loss_nondecrease_count = 0
loss_nondecrease_threshold = 2 # If the test error hasn't increased in this many steps, decrease learning rate
print('Initialized')
average_loss = 0
# Define data generator
data_gen = DataGeneratorSeq(train_data,batch_size,num_unrollings)
x_axis_seq = []
# Points you start your test predictions from
test_points_seq = np.arange(11000,12000,50).tolist()
for ep in range(epochs):
# ========================= Training =====================================
for step in range(train_seq_length//batch_size):
u_data, u_labels = data_gen.unroll_batches()
feed_dict = {}
for ui,(dat,lbl) in enumerate(zip(u_data,u_labels)):
feed_dict[train_inputs[ui]] = dat.reshape(-1,1)
feed_dict[train_outputs[ui]] = lbl.reshape(-1,1)
feed_dict.update({tf_learning_rate: 0.0001, tf_min_learning_rate:0.000001})
_, l = session.run([optimizer, loss], feed_dict=feed_dict)
average_loss += l
# ============================ Validation ==============================
if (ep+1) % valid_summary == 0:
average_loss = average_loss/(valid_summary*(train_seq_length//batch_size))
# The average loss
if (ep+1)%valid_summary==0:
print('Average loss at step %d: %f' % (ep+1, average_loss))
train_mse_ot.append(average_loss)
average_loss = 0 # reset loss
predictions_seq = []
mse_test_loss_seq = []
# ===================== Updating State and Making Predicitons ========================
for w_i in test_points_seq:
mse_test_loss = 0.0
our_predictions = []
if (ep+1)-valid_summary==0:
# Only calculate x_axis values in the first validation epoch
x_axis=[]
# Feed in the recent past behavior of stock prices
# to make predictions from that point onwards
for tr_i in range(w_i-num_unrollings+1,w_i-1):
current_price = all_mid_data[tr_i]
feed_dict[sample_inputs] = np.array(current_price).reshape(1,1)
_ = session.run(sample_prediction,feed_dict=feed_dict)
feed_dict = {}
current_price = all_mid_data[w_i-1]
feed_dict[sample_inputs] = np.array(current_price).reshape(1,1)
# Make predictions for this many steps
# Each prediction uses previous prediciton as it's current input
for pred_i in range(n_predict_once):
pred = session.run(sample_prediction,feed_dict=feed_dict)
our_predictions.append(np.asscalar(pred))
feed_dict[sample_inputs] = np.asarray(pred).reshape(-1,1)
if (ep+1)-valid_summary==0:
# Only calculate x_axis values in the first validation epoch
x_axis.append(w_i+pred_i)
mse_test_loss += 0.5*(pred-all_mid_data[w_i+pred_i])**2
session.run(reset_sample_states)
predictions_seq.append(np.array(our_predictions))
mse_test_loss /= n_predict_once
mse_test_loss_seq.append(mse_test_loss)
if (ep+1)-valid_summary==0:
x_axis_seq.append(x_axis)
current_test_mse = np.mean(mse_test_loss_seq)
# Learning rate decay logic
if len(test_mse_ot)>0 and current_test_mse > min(test_mse_ot):
loss_nondecrease_count += 1
else:
loss_nondecrease_count = 0
if loss_nondecrease_count > loss_nondecrease_threshold :
session.run(inc_gstep)
loss_nondecrease_count = 0
print('\tDecreasing learning rate by 0.5')
test_mse_ot.append(current_test_mse)
print('\tTest MSE: %.5f'%np.mean(mse_test_loss_seq))
predictions_over_time.append(predictions_seq)
print('\tFinished Predictions')
Initialized
Average loss at step 1: 1.703350
Test MSE: 0.00318
Finished Predictions
...
...
...
Average loss at step 30: 0.033753
Test MSE: 0.00243
Finished Predictions
प्रेडिक्शंस को विज़ुअलाइज़ करना
आप देख सकते हैं कि ट्रेनिंग के साथ MSE लॉस नीचे जा रहा है। यह इस बात का अच्छा संकेत है कि मॉडल कुछ उपयोगी सीख रहा है। अपनी खोजों को मापने के लिए, आप नेटवर्क के MSE लॉस की तुलना मानक एवरेजिंग (0.004) करते समय प्राप्त MSE लॉस से कर सकते हैं। आप देख सकते हैं कि LSTM मानक एवरेजिंग से बेहतर कर रहा है। और आप जानते हैं कि मानक एवरेजिंग (भले ही परफेक्ट न हो) वास्तविक स्टॉक कीमतों की मूवमेंट्स का उचित रूप से अनुसरण करता है।
best_prediction_epoch = 28 # replace this with the epoch that you got the best results when running the plotting code plt.figure(figsize = (18,18)) plt.subplot(2,1,1) plt.plot(range(df.shape[0]),all_mid_data,color='b') # Plotting how the predictions change over time # Plot older predictions with low alpha and newer predictions with high alpha start_alpha = 0.25 alpha = np.arange(start_alpha,1.1,(1.0-start_alpha)/len(predictions_over_time[::3])) for p_i,p in enumerate(predictions_over_time[::3]): for xval,yval in zip(x_axis_seq,p): plt.plot(xval,yval,color='r',alpha=alpha[p_i]) plt.title('Evolution of Test Predictions Over Time',fontsize=18) plt.xlabel('Date',fontsize=18) plt.ylabel('Mid Price',fontsize=18) plt.xlim(11000,12500) plt.subplot(2,1,2) # Predicting the best test prediction you got plt.plot(range(df.shape[0]),all_mid_data,color='b') for xval,yval in zip(x_axis_seq,predictions_over_time[best_prediction_epoch]): plt.plot(xval,yval,color='r') plt.title('Best Test Predictions Over Time',fontsize=18) plt.xlabel('Date',fontsize=18) plt.ylabel('Mid Price',fontsize=18) plt.xlim(11000,12500) plt.show()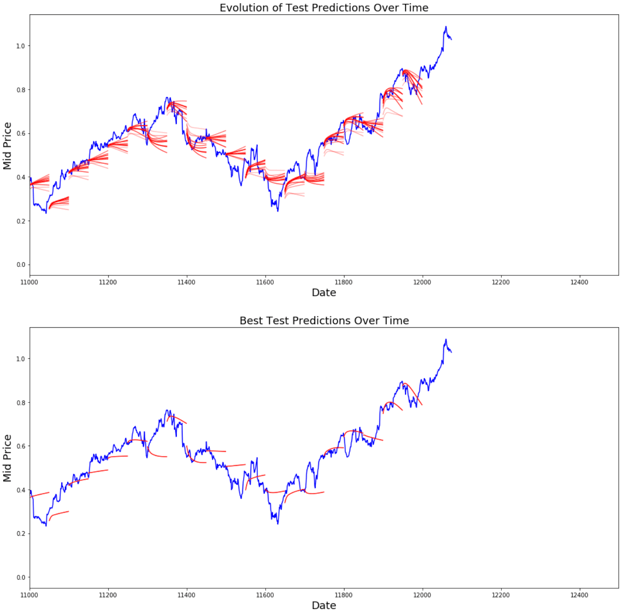
भले ही परफेक्ट न हो, LSTMs अधिकांश समय स्टॉक प्राइस व्यवहार का सही अनुमान लगाने में सक्षम लगते हैं। ध्यान दें कि आप लगभग 0 और 1.0 के रेंज में प्रेडिक्शन कर रहे हैं (यानी, वास्तविक स्टॉक कीमतें नहीं)। यह ठीक है क्योंकि आप कीमतों को नहीं, बल्कि स्टॉक प्राइस मूवमेंट को प्रेडिक्ट कर रहे हैं।
अंतिम टिप्पणी
आशा है कि आपको यह ट्यूटोरियल उपयोगी लगा होगा। मुझे उल्लेख करना चाहिए कि यह मेरे लिए एक पुरस्कृत अनुभव था। इस ट्यूटोरियल में, मैंने सीखा कि ऐसा मॉडल तैयार करना कितना कठिन हो सकता है जो स्टॉक प्राइस मूवमेंट्स का सही अनुमान लगा सके। आपने इस बात की प्रेरणा से शुरुआत की कि स्टॉक कीमतों को मॉडल करने की आवश्यकता क्यों है। इसके बाद डेटा डाउनलोड करने के लिए स्पष्टीकरण और कोड दिया गया। फिर, आपने दो एवरेजिंग तकनीकों को देखा जो आपको भविष्य में एक स्टेप तक प्रेडिक्शन करने देती हैं। आपने आगे देखा कि जब आपको भविष्य में एक से अधिक स्टेप तक अनुमान लगाना होता है, तो ये विधियाँ निष्फल हो जाती हैं। इसके बाद, आपने चर्चा की कि आप LSTMs का उपयोग करके भविष्य में कई स्टेप्स तक प्रेडिक्शंस कैसे कर सकते हैं। अंत में, आपने परिणामों को विज़ुअलाइज़ किया और देखा कि आपका मॉडल (भले ही परफेक्ट न हो) स्टॉक प्राइस मूवमेंट्स का सही अनुमान लगाने में काफ़ी अच्छा है।
यदि आप डीप लर्निंग के बारे में अधिक सीखना चाहें, तो हमारा Deep Learning in Python कोर्स ज़रूर देखें। इसमें बुनियादी बातें शामिल हैं, साथ ही Keras में अपना न्यूरल नेटवर्क कैसे बनाएं यह भी। यह TensorFlow से अलग पैकेज है, जिसका उपयोग इस ट्यूटोरियल में किया जाएगा, लेकिन विचार समान है।
यहाँ, मैं इस ट्यूटोरियल से कुछ निष्कर्ष दे रहा हूँ।
स्टॉक प्राइस/मूवमेंट प्रेडिक्शन एक अत्यंत कठिन कार्य है। व्यक्तिगत रूप से, मुझे नहीं लगता कि बाहर मौजूद किसी भी स्टॉक प्रेडिक्शन मॉडल को सहज मान लेना चाहिए और आँख मूँद कर उन पर निर्भर रहना चाहिए। हालाँकि, मॉडल अधिकांश समय स्टॉक प्राइस मूवमेंट का सही अनुमान लगा सकते हैं, पर हमेशा नहीं।
ऐसे लेखों से धोखा न खाएँ जो प्रेडिक्शन कर्व्स दिखाते हैं जो सच्ची स्टॉक कीमतों के साथ पूरी तरह ओवरलैप करते हैं। इसे एक साधारण एवरेजिंग तकनीक से भी दोहराया जा सकता है और व्यवहार में यह बेकार है। अधिक समझदारी की बात स्टॉक प्राइस मूवमेंट्स की भविष्यवाणी करना है।
मॉडल के हाइपरपैरामीटर्स आपके प्राप्त परिणामों के प्रति अत्यधिक संवेदनशील होते हैं। इसलिए, एक बहुत अच्छी बात यह होगी कि हाइपरपैरामीटर्स पर कुछ हाइपरपैरामीटर ऑप्टिमाइज़ेशन तकनीकें (जैसे, ग्रिड सर्च / रैंडम सर्च) चलाई जाएँ। नीचे, मैंने कुछ सबसे क्रिटिकल हाइपरपैरामीटर्स सूचीबद्ध किए हैं:
- ऑप्टिमाइज़र की लर्निंग रेट
- लेयर्स की संख्या और प्रत्येक लेयर में हिडन यूनिट्स की संख्या
- ऑप्टिमाइज़र। मुझे Adam सबसे अच्छा प्रदर्शन करता मिला
- मॉडल का प्रकार। आप GRU/ स्टैंडर्ड LSTM/ पीपहोल्स के साथ LSTM आज़मा सकते हैं और प्रदर्शन में अंतर का आकलन कर सकते हैं
इस ट्यूटोरियल में आपने कुछ त्रुटिपूर्ण किया (डेटा के छोटे आकार के कारण)! यानी आपने लर्निंग रेट को घटाने के लिए टेस्ट लॉस का उपयोग किया। यह अप्रत्यक्ष रूप से ट्रेनिंग प्रक्रिया में टेस्ट सेट की जानकारी लीक कर देता है। इसे संभालने का बेहतर तरीका यह है कि एक अलग वैलिडेशन सेट (टेस्ट सेट से अलग) हो और वैलिडेशन सेट के प्रदर्शन के संदर्भ में लर्निंग रेट घटाया जाए।
यदि आप मुझसे संपर्क करना चाहें, तो आप मुझे [email protected] पर ई-मेल कर सकते हैं या LinkedIn पर कनेक्ट कर सकते हैं।
संदर्भ
मैंने स्टॉक प्रेडिक्शंस के लिए LSTMs का उपयोग कैसे करें, यह समझने के लिए इस रिपोसिटरी का संदर्भ लिया। लेकिन विवरण संदर्भ में पाई गई इम्प्लीमेंटेशन से काफ़ी अलग हो सकते हैं।
FAQs
क्या LSTM मॉडल्स सटीक स्टॉक मार्केट प्रेडिक्शंस की गारंटी दे सकते हैं?
नहीं, LSTM मॉडल सटीक भविष्यवाणियों की गारंटी नहीं दे सकते क्योंकि स्टॉक मार्केट अत्यधिक अस्थिर है और ऐतिहासिक डेटा से परे कारकों से प्रभावित होता है। LSTM ट्रेंड्स और पैटर्न्स की पहचान करने में मदद कर सकते हैं, लेकिन वित्तीय निर्णयों के लिए केवल उन पर निर्भर नहीं होना चाहिए।
स्टॉक डेटा के लिए नॉर्मलाइज़ेशन LSTM प्रेडिक्शंस को कैसे बेहतर बनाता है?
नॉर्मलाइज़ेशन सुनिश्चित करता है कि डेटा मान समान रेंज में आएँ, जिससे आउटलिएर्स का प्रभाव घटता है और मॉडल का प्रदर्शन बेहतर होता है। यह LSTM को एब्सोल्यूट वैल्यूज़ के बजाय पैटर्न्स पर ध्यान केंद्रित करने में मदद करता है, जो ट्रेनिंग के लिए महत्वपूर्ण है।
LSTM से पहले एक्स्पोनेंशियल मूविंग एवरेज (EMA) का उपयोग क्यों करें?
एक्स्पोनेंशियल मूविंग एवरेज स्टॉक डेटा में उतार-चढ़ाव को स्मूद करता है, जिससे ट्रेंड्स का स्पष्ट दृश्य मिलता है। यह कदम तुलना के लिए एक बेसलाइन का काम करता है और LSTM के मुकाबले सरल तरीकों की सीमाएँ उजागर करता है।
इस ट्यूटोरियल में बताई गई पद्धति की कुछ सीमाएँ क्या हैं?
यह ट्यूटोरियल पर्याप्त और स्वच्छ ऐतिहासिक डेटा की उपलब्धता मानकर चलता है। मॉडल का प्रदर्शन चुने गए हाइपरपैरामीटर्स, डेटा प्रीप्रोसेसिंग स्टेप्स, और वास्तविक दुनिया के स्टॉक मूवमेंट्स की अप्रत्याशित प्रकृति से भी सीमित होता है।
क्या LSTM मॉडल व्यक्तिगत कंपनियों के लिए स्टॉक मूवमेंट्स का समान रूप से अनुमान लगा सकता है?
ज़रूरी नहीं। मॉडल की सटीकता स्टॉक डेटा की विशेषताओं, जैसे अस्थिरता और लिक्विडिटी, पर निर्भर करती है। प्रत्येक विशिष्ट स्टॉक के लिए सर्वोत्तम परिणाम पाने हेतु परीक्षण और फाइन-ट्यूनिंग की आवश्यकता होती है।

लेखक
Thushan Ganegedara
इस ट्यूटोरियल में, आप Long Short-Term Memory नामक एक टाइम-सीरीज़ मॉडल का उपयोग करना सीखेंगे। LSTM मॉडल खास तौर पर लंबे समय की मेमोरी बनाए रखने में, अपने डिज़ाइन की वजह से, बहुत शक्तिशाली होते हैं — जैसा कि आप आगे देखेंगे। आप इस ट्यूटोरियल में निम्नलिखित विषयों से निपटेंगे:
यदि आप डीप लर्निंग या न्यूरल नेटवर्क्स से अपरिचित हैं, तो हमारा Deep Learning in Python कोर्स देखें। इसमें बुनियादी बातें शामिल हैं, साथ ही Keras में अपना न्यूरल नेटवर्क कैसे बनाएं यह भी। यह पैकेज TensorFlow से अलग है, जिसका उपयोग इस ट्यूटोरियल में किया जाएगा, लेकिन अवधारणा वही है।
आपको टाइम सीरीज़ मॉडल्स की आवश्यकता क्यों है?
आप स्टॉक प्राइस को सही ढंग से मॉडल करना चाहेंगे ताकि एक स्टॉक खरीदार के रूप में, आप यह उचित निर्णय ले सकें कि कब स्टॉक खरीदना है और कब मुनाफे के लिए बेचना है। यहीं पर टाइम सीरीज़ मॉडलिंग काम आती है। आपको ऐसे अच्छे मशीन लर्निंग मॉडल्स चाहिए जो डेटा के किसी अनुक्रम के इतिहास को देखें और अनुक्रम के भविष्य के तत्वों का सही अनुमान लगा सकें।
चेतावनी: स्टॉक मार्केट की कीमतें अत्यधिक अप्रत्याशित और अस्थिर होती हैं। इसका मतलब है कि डेटा में ऐसे कोई सुसंगत पैटर्न नहीं होते जो आपको समय के साथ स्टॉक कीमतों को लगभग-परफेक्ट मॉडल करने दें। यह मेरी नहीं, बल्कि प्रिंसटन यूनिवर्सिटी के अर्थशास्त्री बर्टन मेल्किएल की बात है, जो 1973 की अपनी किताब "A Random Walk Down Wall Street" में तर्क देते हैं कि अगर बाजार सच में कुशल है और कोई शेयर मूल्य सभी कारकों को सार्वजनिक होते ही तुरंत प्रतिबिंबित कर देता है, तो अखबार के स्टॉक लिस्टिंग पर डार्ट फेंकता आँखों पर पट्टी बांधा हुआ बंदर भी किसी निवेश पेशेवर जितना अच्छा कर सकता है।
फिर भी, यह मान लेने की जरूरत नहीं कि यह केवल एक स्टोकेस्टिक या रैंडम प्रक्रिया है और मशीन लर्निंग के लिए कोई उम्मीद नहीं। देखें कि क्या आप कम से कम डेटा को इस तरह मॉडल कर सकते हैं कि आपकी भविष्यवाणियाँ डेटा के वास्तविक व्यवहार से सहसंबंधित हों। दूसरे शब्दों में, आपको भविष्य के सटीक स्टॉक मूल्य नहीं, बल्कि स्टॉक प्राइस मूवमेंट्स चाहिए (यानी निकट भविष्य में यह बढ़ेगा या गिरेगा)।
डेटा डाउनलोड करना
आप निम्नलिखित स्रोतों का डेटा उपयोग करेंगे:
Alpha Vantage Stock API। शुरू करने से पहले, आपको एक API कुंजी चाहिए होगी, जिसे आप यहाँ से निःशुल्क प्राप्त कर सकते हैं। उसके बाद, आप उस कुंजी को
api_keyवेरिएबल में असाइन कर सकते हैं। यह ट्यूटोरियल American Airlines स्टॉक के 20 वर्षों के ऐतिहासिक डेटा को प्राप्त करेगा। वैकल्पिक पठन के रूप में, आप ऐतिहासिक मार्केट डेटा के साथ काम करने के सर्वोत्तम तरीकों के लिए इस स्टॉक API स्टार्टर गाइड को देख सकते हैं।इस पेज का डेटा उपयोग करें। ज़िप फ़ाइल में मौजूद Stocks फ़ोल्डर को अपने प्रोजेक्ट होम फ़ोल्डर में कॉपी करें।
स्टॉक कीमतें कई रूपों में आती हैं। ये हैं,
Alpha Vantage से डेटा प्राप्त करना
आप पहले Alpha Vantage से डेटा लोड करेंगे। चूँकि आप अपनी भविष्यवाणियाँ करने के लिए American Airlines के स्टॉक मार्केट प्राइस का उपयोग करेंगे, आप टिकर को
"AAL"सेट करते हैं। साथ ही, आप एकurl_stringपरिभाषित करते हैं, जो American Airlines के पिछले 20 वर्षों के सभी स्टॉक मार्केट डेटा के साथ एक JSON फ़ाइल लौटाएगा, और एकfile_to_save, जो वह फ़ाइल है जिसमें आप डेटा सहेजेंगे। आप पहले से परिभाषितtickerवेरिएबल का उपयोग करके इस फ़ाइल का नाम रखने में मदद लेंगे।इसके बाद, आप एक शर्त निर्दिष्ट करने जा रहे हैं: यदि आपने पहले से डेटा सहेजा नहीं है, तो आप
url_stringमें सेट किए गए URL से डेटा ले आएँगे; आप दिनांक, low, high, volume, close, open मानों को एक pandas DataFramedfमें स्टोर करेंगे और इसेfile_to_saveपर सेव करेंगे। हालाँकि, यदि डेटा पहले से मौजूद है, तो आप इसे CSV से ही लोड कर लेंगे।Kaggle से डेटा प्राप्त करना
Kaggle पर मिलने वाला डेटा CSV फ़ाइलों का संग्रह है और आपको कोई प्रीप्रोसेसिंग नहीं करनी होती, इसलिए आप डेटा को सीधे Pandas DataFrame में लोड कर सकते हैं।
डेटा अन्वेषण
यहाँ, आप DataFrame में संकलित डेटा को प्रिंट करेंगे। आपको यह भी सुनिश्चित करना चाहिए कि डेटा दिनांक के अनुसार सॉर्टेड हो, क्योंकि टाइम सीरीज़ मॉडलिंग में डेटा का क्रम बेहद महत्वपूर्ण है।
डेटा विज़ुअलाइज़ेशन
अब देखें कि आपके पास किस तरह का डेटा है। आप ऐसे डेटा चाहते हैं जिसमें समय के साथ अलग-अलग पैटर्न दिखाई दें।
यह ग्राफ़ बहुत कुछ कहता है। मैंने इस कंपनी को दूसरों के बजाय इसलिए चुना है क्योंकि समय के साथ इसमें अलग-अलग तरह के स्टॉक प्राइस व्यवहार दिखते हैं। इससे लर्निंग अधिक मजबूत होगी और आपको विभिन्न स्थितियों में प्रेडिक्शंस की गुणवत्ता जाँचने का मौका मिलेगा।
एक और बात ध्यान देने लायक है कि 2017 के आस-पास के मान 1970 के दशक के पास के मानों की तुलना में काफी अधिक हैं और अधिक उतार-चढ़ाव भी दिखाते हैं। इसलिए, आपको सुनिश्चित करना होगा कि पूरा टाइम फ़्रेम में डेटा समान मान-सीमाओं में व्यवहार करे। आप इसका ध्यान डेटा नॉर्मलाइज़ेशन चरण में रखेंगे।