
कोर्स
Statistics परिचय
4 घंटा
162.2K
वैरिएंस, coefficient of variation, और confidence intervals जैसे कई महत्वपूर्ण सांख्यिकीय सिद्धांत और विधियाँ, परिवर्तनशीलता के एक बुनियादी माप के रूप में standard deviation पर निर्भर करती हैं। इसीलिए डेटा प्रोफेशनल्स के लिए सांख्यिकी में इसे महारत हासिल करना अत्यंत आवश्यक है।
यदि इस लेख को पढ़ते समय आपको लगे कि आप सांख्यिकी को फिर से दोहराना चाहते हैं, तो हमारा Introduction to Statistics कोर्स करें, जिसमें बिना कोडिंग के कई बुनियादी विषयों को कवर किया गया है।
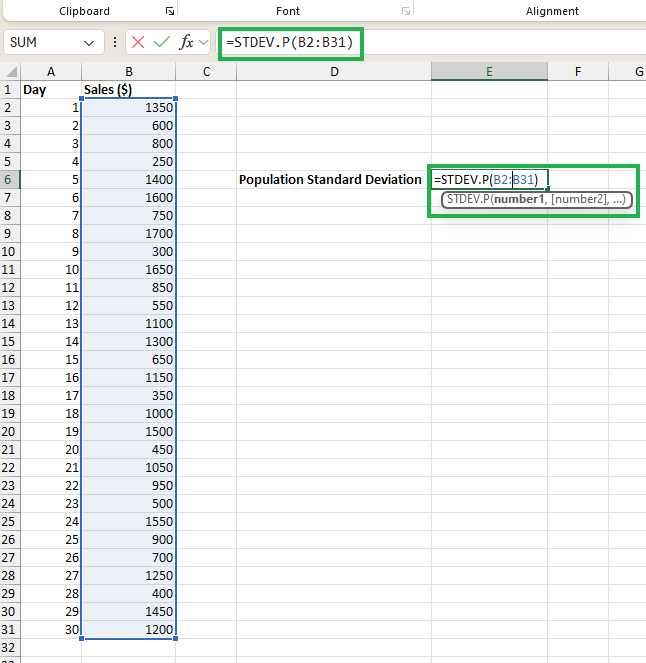
Excel में standard deviation निकालने के लिए, अपना डेटा एक कॉलम में दर्ज करें, फिर आबादी के लिए STDEV.P() फ़ंक्शन का उपयोग करें या नमूने के लिए STDEV.S() फ़ंक्शन का।
इन फ़ंक्शनों के बीच मुख्य अंतर यह है कि STDEV.P() कुल डेटा बिंदुओं की संख्या से भाग देता है, जबकि STDEV.S() नमूना परिवर्तनशीलता को ध्यान में रखते हुए डेटा बिंदुओं की संख्या माइनस एक (n-1) से भाग देता है।
Excel में standard deviation की त्वरित गणना। चित्र: लेखक द्वारा।
उदाहरण के लिए, यदि आपका डेटा B2 से B31 कोशिकाओं में है, तो आबादी का standard deviation निकालने के लिए =STDEV.P(B2:B31) टाइप करें या नमूने का standard deviation निकालने के लिए =STDEV.S(B2:B31) टाइप करें। Excel आपके डेटासेट के लिए standard deviation स्वतः गणना कर दिखा देगा।
Standard deviation एक सांख्यिकीय माप है जो संख्यात्मक मानों के सेट में परिवर्तन या प्रसार की मात्रा को मात्राबद्ध करता है। यह बताता है कि डेटासेट के मान, उसके माध्य (औसत) से कितने विचलित होते हैं।
यह डेटा के भीतर परिवर्तनशीलता की सीमा को समझने में मदद करता है—कम standard deviation दर्शाता है कि मान माध्य के क़रीब हैं, यानी स्थिरता अधिक है; जबकि अधिक standard deviation अधिक परिवर्तनशीलता दर्शाता है, यानी डेटा अधिक फैला हुआ है।
Standard deviation का सूत्र इस बात पर निर्भर करता है कि हम आबादी से निपट रहे हैं या नमूने से। आबादी का standard deviation (σ) का सूत्र इस प्रकार है:
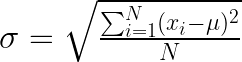
Population standard deviation. चित्र: लेखक द्वारा।
जहाँ:
N आबादी में कुल डेटा बिंदुओं की संख्या है।
x_i प्रत्येक व्यक्तिगत डेटा बिंदु का प्रतिनिधित्व करता है।
μ आबादी का माध्य (औसत) है।
यह सूत्र, माध्य से वर्गमूल विचलनों का औसत निकालता है और फिर इस औसत का वर्गमूल लेता है।
Excel में STDEV.P() फ़ंक्शन पूरी आबादी के लिए standard deviation की गणना करता है। यह मानता है कि दिए गए तर्कों में पूरी आबादी शामिल है। इस फ़ंक्शन का सिंटैक्स इस प्रकार है:
STDEV.P(number1, [number2], ...)पैरामीटर्स:
number1: पहला संख्या-तर्क, जो आबादी के अनुरूप है।
[number2], ...: वैकल्पिक अतिरिक्त संख्याएँ या संदर्भ, जो आबादी के अनुरूप हैं; अधिकतम 254 तर्क।
STDEV.P(), वही आबादी वाला सूत्र उपयोग करता है जिसे हमने पहले सीखा था। इससे गणना पूरी आबादी की विशेषताओं को ठीक से दर्शाती है।
हमें STDEV.P() तब उपयोग करना चाहिए जब हमारा डेटा पूरी आबादी का प्रतिनिधित्व करे। उदाहरण के लिए, किसी विशेष स्कूल के सभी छात्रों के टेस्ट स्कोर का विश्लेषण करते समय, STDEV.P() उपयुक्त है क्योंकि डेटासेट रुचि की पूरी आबादी को शामिल करता है।
नमूना standard deviation (s) का सूत्र इस प्रकार है। ध्यान दें कि नमूना standard deviation के लिए परंपरा से छोटे अक्षर n का उपयोग होता है।
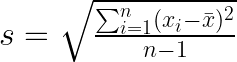
Sample standard deviation समीकरण। चित्र: लेखक द्वारा।
जहाँ:
n नमूने में कुल डेटा बिंदुओं की संख्या है।
x_i प्रत्येक व्यक्तिगत डेटा बिंदु का प्रतिनिधित्व करता है।
xˉ नमूने का माध्य (औसत) है।
यह सूत्र आबादी वाले सूत्र से मिलता-जुलता है, लेकिन हर में n - 1 (Bessel का सुधार) का उपयोग करता है क्योंकि हम आबादी के पैरामीटर का अनुमान लगाने के लिए नमूने का उपयोग कर रहे हैं। यह सुधार नमूना standard deviation को आबादी के standard deviation का अपक्षेप-रहित आकलक बनाता है।
Excel में STDEV.S() फ़ंक्शन आबादी के नमूने के लिए standard deviation निकालता है। यह मानता है कि दिए गए तर्क पूरी आबादी नहीं, बल्कि उसका नमूना हैं। इस फ़ंक्शन का सिंटैक्स इस प्रकार है:
STDEV.S(number1, [number2], ...)पैरामीटर्स:
number1: पहला संख्या-तर्क, जो आबादी के नमूने के अनुरूप है।
[number2], ...: वैकल्पिक अतिरिक्त संख्याएँ या संदर्भ, जो नमूने के अनुरूप हैं; अधिकतम 254 तर्क।
STDEV.S(), नमूना standard deviation के सूत्र का उपयोग करते हुए, जैसा हमने पहले सीखा, Bessel के सुधार को सम्मिलित करके गणना करता है।
व्यवहार में, जब हमारे पास डेटा का नमूना होता है, तो पूरी आबादी के standard deviation का अनुमान लगाने के लिए हम STDEV.S() का उपयोग करते हैं। मान लीजिए हम किसी स्कूल से यादृच्छिक रूप से चुने गए कुछ छात्रों के टेस्ट स्कोर का विश्लेषण कर रहे हैं। STDEV.S() उपयुक्त है क्योंकि हमारा डेटासेट कुल छात्र आबादी का केवल एक नमूना है।
अब जब हमने Excel में standard deviation निकालने के लिए उपलब्ध फ़ंक्शनों के बारे में सीख लिया है, तो एक उदाहरण के माध्यम से अपने ज्ञान को व्यवहार में लाएँ।
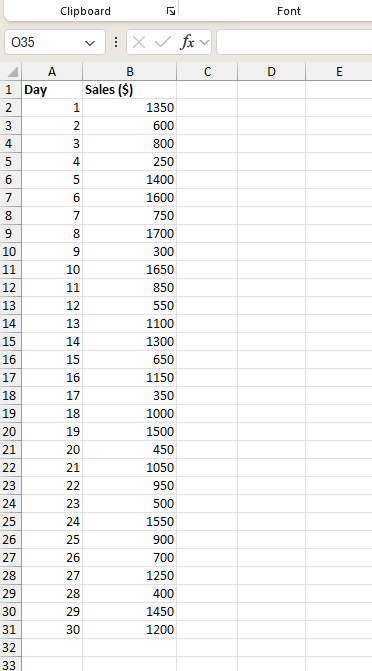
कल्पना कीजिए कि एक डेटा विश्लेषक के रूप में आपको एक छोटे रिटेल स्टोर के बिक्री प्रदर्शन का विश्लेषण करना है। स्टोर मालिक पिछले माह की दैनिक बिक्री में परिवर्तनशीलता को समझना चाहता है ताकि इन्वेंट्री और स्टाफिंग को बेहतर ढंग से प्रबंधित किया जा सके।
आपने 30 दिनों की दैनिक बिक्री का डेटा एकत्र किया है और इस परिवर्तनशीलता को मापने के लिए standard deviation निकालना आवश्यक है।
आइए रिकॉर्ड्स को Excel स्प्रेडशीट में एक कॉलम में, मान लें B2 से B31, दर्ज करके शुरू करें।
स्टोर्स बिक्री डेटासेट। चित्र: लेखक द्वारा।
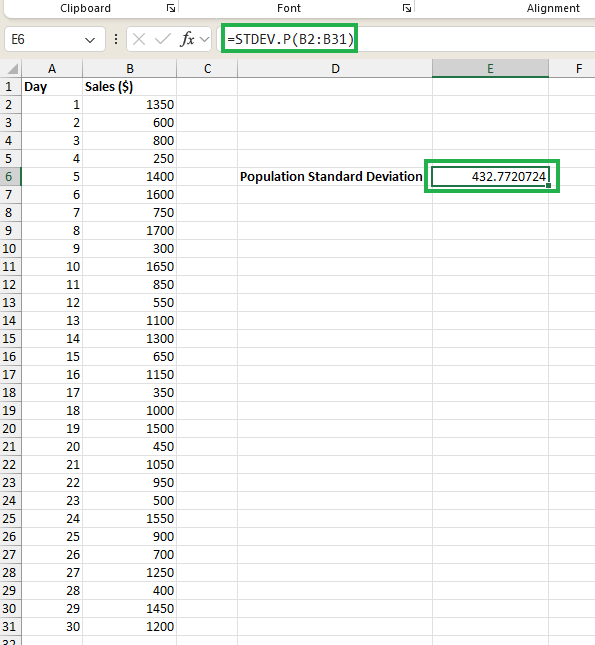
हम आबादी का standard deviation कोशिका E6 में निम्नलिखित समीकरण टाइप करके निकाल सकते हैं:
=STDEV.P(B2:B31)आपको कोशिका E6 में गणना किया गया आबादी का standard deviation इस प्रकार दिखाई देगा:
Population standard deviation की गणना। चित्र: लेखक द्वारा।
हमने STDEV.P() फ़ंक्शन का उपयोग किया क्योंकि हमारे परिदृश्य में, विश्लेषण के लिए पूरी आबादी पिछले महीने की बिक्री का डेटा है।
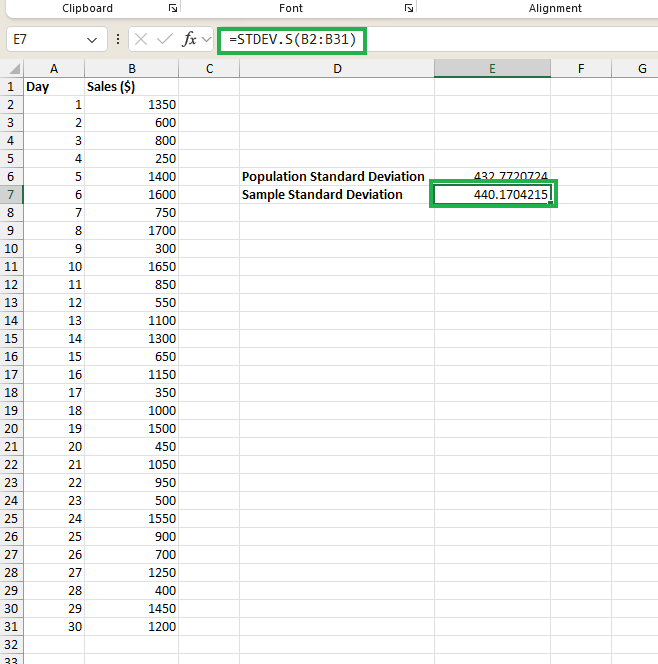
मान लीजिए हम पूरे वर्ष का विश्लेषण कर रहे हैं और पिछले 30 दिनों के डेटा को एक नमूने के रूप में ले रहे हैं; तब हम निम्नलिखित समीकरण के अनुसार STDEV.S() फ़ंक्शन का उपयोग करेंगे:
=STDEV.S(B2:B31)और हमें नीचे गणना किया गया नमूना standard deviation दिखाई देगा:
Standard deviation की गणना करने के बाद अगला कदम है परिणाम की व्यावसायिक संदर्भ में व्याख्या करना।
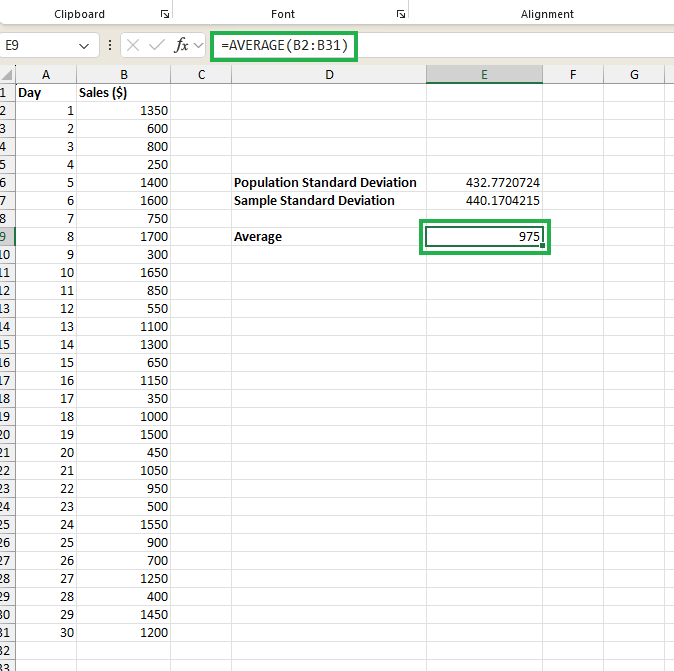
Standard deviation मानों की बेहतर व्याख्या और विश्लेषण को पूरक करने के लिए, हम नीचे दिए गए समीकरण से अपनी बिक्री के डेटा का औसत मान निकाल सकते हैं:
=AVERAGE(B2:B31)औसत मान, नीचे दिखाए अनुसार, कोशिका E7 पर $975 निकाला जा सकता है:
डेटासेट का औसत निकालना। चित्र: लेखक द्वारा।
प्राप्त औसत मान के साथ, हम standard deviation मानों की व्याख्या इस प्रकार कर सकते हैं:
चूँकि standard deviation मान दर्शाते हैं कि दैनिक बिक्री असंगत है और व्यापक रूप से बदलती है, किसी विशेष दिन की बिक्री का आकलन करने के लिए आगे विश्लेषण या कोई मशीन लर्निंग मॉडल बनाया जा सकता है।
स्टोर मालिक को इन्वेंट्री और स्टाफिंग की योजना बनाते समय इस परिवर्तनशीलता को ध्यान में रखना चाहिए ताकि ओवरस्टॉकिंग या अंडरस्टाफिंग से संबंधित संभावित समस्याओं से बचा जा सके।
Excel में हमारे चार्ट्स में standard deviation bars जोड़ना, हमारे डेटा की परिवर्तनशीलता को दृश्य रूप से दर्शाने का एक उपयोगी तरीका है।
हमारे उदाहरण से डेटा रेंज B2 से B31 चुनें और Insert टैब पर जाएँ। नीचे दी गई छवि के अनुसार अपनी इच्छित चार्ट टाइप (जैसे, लाइन चार्ट) चुनें और चार्ट इंसर्ट करें।
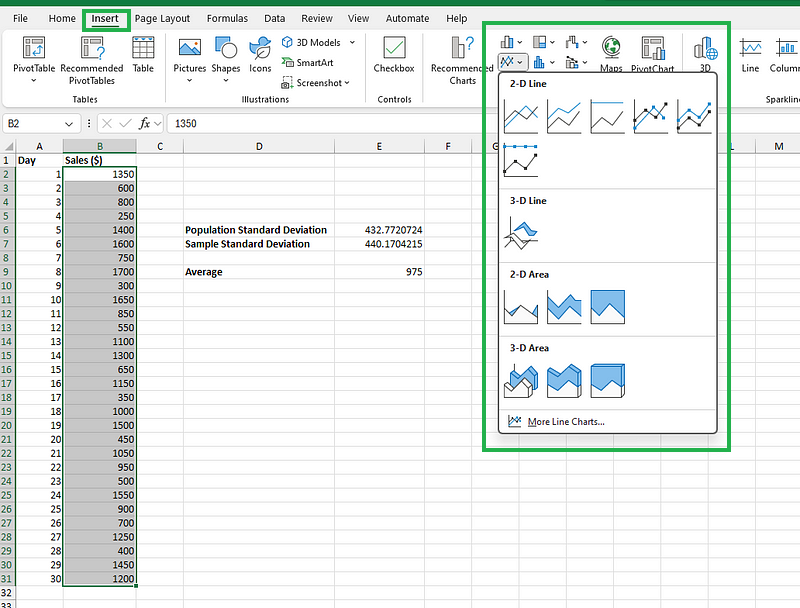
स्टोर बिक्री डेटा के लिए चार्ट जोड़ना। चित्र: लेखक द्वारा।
आप नीचे एक साधारण लाइन चार्ट देखेंगे:
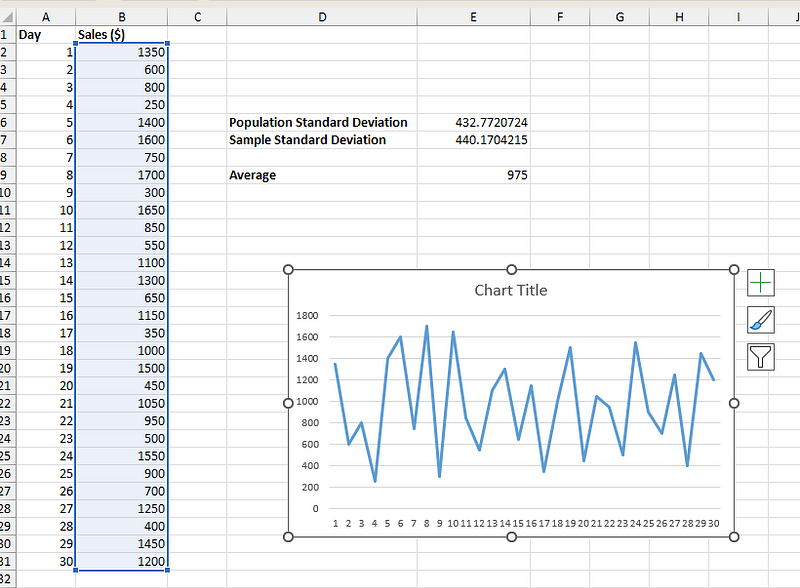
स्टोर बिक्री डेटा के लिए लाइन चार्ट। चित्र: लेखक द्वारा।
अपने चार्ट में डेटा श्रृंखला पर क्लिक करें ताकि वह हाइलाइट हो जाए। यह चरण चयनित डेटा श्रृंखला में error bars जोड़ने के लिए आवश्यक है। उस Chart Design टैब पर जाएँ जो चार्ट चुनने पर दिखाई देता है। Add Chart Element पर क्लिक करें (जो Chart Layouts समूह में मिलता है)।
इसके बाद Error Bars पर होवर करें और Standard Deviation चुनें ताकि लाइन चार्ट में standard deviation bars जुड़ जाएँ।
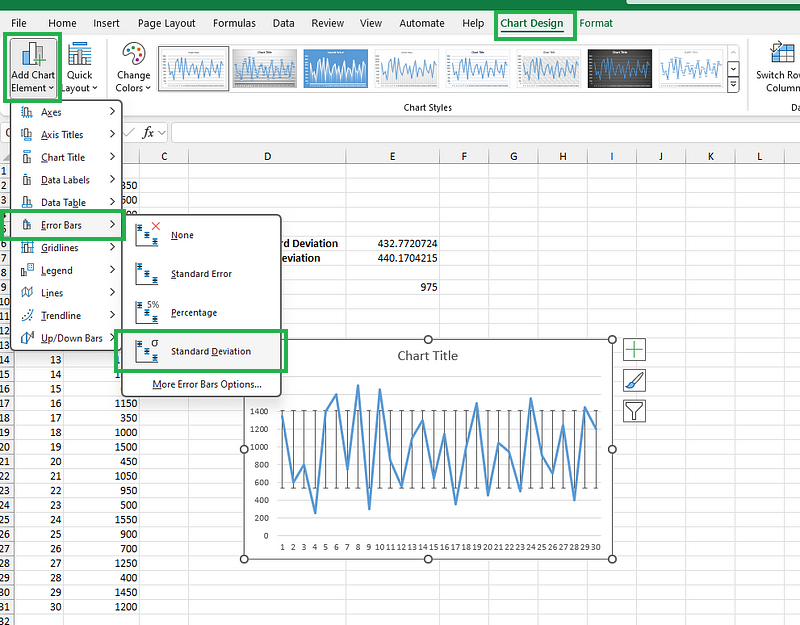
लाइन चार्ट में standard deviation bars जोड़ना। चित्र: लेखक द्वारा।
आप Error Bars पर होवर करके More Error Bars Options पर भी क्लिक कर सकते हैं, और error bars को आगे फ़ॉर्मैट करके उनके रंग, चौड़ाई और लाइन स्टाइल को अपने चार्ट की डिज़ाइन प्राथमिकताओं के अनुसार समायोजित कर सकते हैं। यह काम उसी पैनल में Format Error Bars विकल्पों के तहत किया जा सकता है। अपनी पसंद के अनुसार प्लॉट पाने तक चार्ट के साथ प्रयोग करने में संकोच न करें।
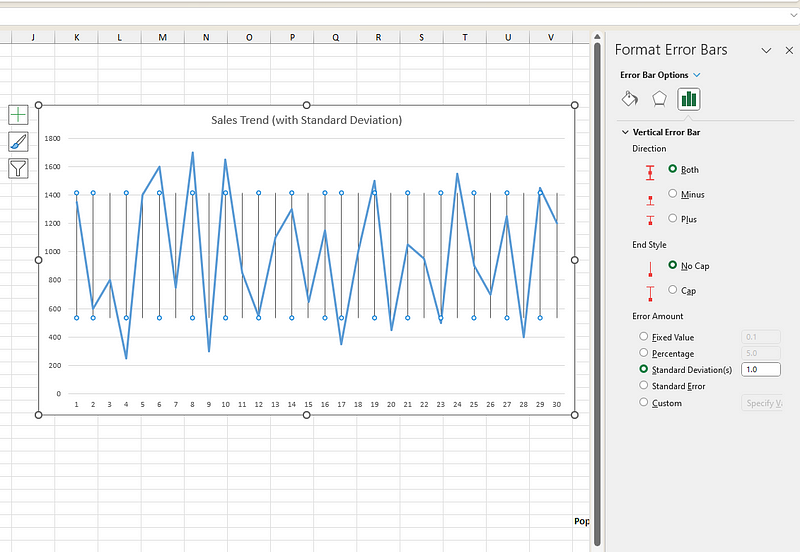
Standard deviation bars का फ़ॉर्मैटिंग। चित्र: लेखक द्वारा।
Excel में हमारे चार्ट्स में standard deviation bars जोड़ना, डेटा की परिवर्तनशीलता का एक स्पष्ट दृश्य प्रतिनिधित्व प्रदान करता है, जो प्रभावी डेटा विश्लेषण और निर्णय-निर्माण में मदद करता है।
Standard deviation एक बुनियादी और मूल्यवान उपकरण है जो हमें किसी डेटासेट की परिवर्तनशीलता समझने में मदद करता है। साथ ही, यह coefficient of variation, confidence intervals, और ANOVA जैसी कई अन्य विश्लेषणों में उपयोग होता है, जिससे यह सभी डेटा प्रोफेशनल्स के लिए सीखना आवश्यक तकनीक बन जाती है।
हम आपको सलाह देते हैं कि आप हमारे व्यापक, हैंड्स-ऑन Excel Fundamentals स्किल ट्रैक को देखें ताकि Excel और डेटा विश्लेषण कौशल को और बढ़ा सकें।
DataCamp के साथ सीखें
कोर्स
कोर्स
लर्निंग पाथ