
Cours
Introduction à BigQuery
4 h
12.8K
Si vous faites partie d’une équipe data, ce scénario vous est sans doute familier : votre backlog déborde de demandes ad hoc. Les utilisateurs métier réclament sans cesse de petites variantes de rapports existants : « Pouvez-vous regrouper par catégorie de produit ? » ou « Comment cela se compare-t-il au mois dernier ? ». Pendant qu’ils patientent, vos data engineers et analystes sont ensevelis sous des tâches SQL répétitives.
Avec l’analytique conversationnelle dans BigQuery, vous pouvez enfin déplacer le goulot d’étranglement. Cette fonctionnalité intègre un moteur de raisonnement propulsé par l’IA directement dans BigQuery Studio, permettant aux utilisateurs de poser des questions en langage naturel et d’obtenir immédiatement des données, des graphiques et du SQL généré.
Dans ce guide, vous apprendrez à configurer et utiliser l’analytique conversationnelle dans BigQuery. Vous allez créer, paramétrer et affiner vos propres agents de données pour que votre organisation puisse dialoguer en toute sécurité avec ses données.
L’analytique conversationnelle fait évoluer l’interaction avec les données des requêtes SQL manuelles vers des conversations en langage naturel. Au lieu d’écrire des instructions SELECT, vous discutez avec un agent de données qui comprend votre contexte métier et renvoie des réponses ancrées dans vos tables réelles.
Ce n’est pas un simple parseur texte-vers-SQL ; c’est une avancée majeure vers une véritable démocratisation de la donnée.
Elle permet aux non-spécialistes d’accéder seuls à des insights en temps réel, et offre aux professionnels de la data un moyen rapide d’explorer les jeux de données et d’automatiser le reporting.
Au cœur de l’analytique conversationnelle de BigQuery se trouve un moteur de raisonnement basé sur la famille de modèles Gemini. Les agents de données utilisent un pipeline structuré en plusieurs étapes pour garantir que les insights s’appuient sur votre contexte data spécifique :
Google Cloud propose l’analytique conversationnelle à différents niveaux de votre stack data. Le bon choix dépend de vos utilisateurs et de l’emplacement de votre logique métier :
|
Fonctionnalité |
Analytique conversationnelle BigQuery |
Analytique conversationnelle Looker |
Data Studio (via BigQuery Agents) |
|
Idéal pour |
Les équipes data, analystes et développeurs qui créent des applications personnalisées |
Les utilisateurs métier qui ont besoin d’insights gouvernés et prêts pour les tableaux de bord |
Les utilisateurs métier qui préfèrent un reporting BI léger |
|
Méthode d’ancrage |
Schémas de l’entrepôt, métadonnées de table et requêtes vérifiées |
LookML (couche sémantique) |
Connecté directement à des agents BigQuery préconfigurés |
|
Accès aux données |
Peut analyser des données structurées, prédictives (ML) et non structurées |
Données strictement structurées et modélisées |
Données structurées |
|
Statut de sortie |
Aperçu (mai 2026) |
Disponibilité générale |
Aperçu |
Quel chemin choisir ?
Ce tutoriel se concentre sur BigQuery, la voie la plus rapide pour les équipes data afin de prototyper et industrialiser des agents là où vivent les données.
Il est important de comprendre l’architecture d’un agent de données avant de le configurer. Dans Google Cloud, un agent de données est la couche d’abstraction centrale. Il combine les actifs BigQuery avec les capacités de raisonnement de la famille de modèles Gemini.
Plutôt que d’exposer directement des tables brutes, un agent de données paramètre tout ce dont le modèle a besoin pour interpréter les questions, générer du SQL sécurisé et renvoyer des réponses fiables. Cette combinaison de sources, d’instructions et de logique vérifiée rend l’analytique conversationnelle de BigQuery plus fiable que les outils standards de type texte-vers-SQL.
Les sources de connaissances constituent la couche fondatrice de tout agent de données. Elles définissent précisément à quelles données l’agent est autorisé à accéder et à interroger.
Types d’actifs : tables, vues et fonctions définies par l’utilisateur (UDF) peuvent être connectées comme sources.
Scalabilité : plusieurs sources de connaissances peuvent être liées à un même agent, ce qui permet de combiner des informations de différents domaines métiers.
Contrôle d’accès : définir des sources spécifiques garantit que l’agent n’opère que sur des données autorisées.
L’intelligence d’un agent dépend du contexte fourni. C’est la clé pour faire comprendre à un modèle générique le langage d’une entreprise.
En définissant des instructions personnalisées, des synonymes et des glossaires métiers, l’agent s’ancre dans un domaine spécifique. Par exemple, vous pouvez lui apprendre que « Top Customers » désigne des utilisateurs ayant une valeur vie (LTV) supérieure à 1 000 $.
Éléments d’ancrage clés :
Instructions personnalisées : fournissez des directives de haut niveau, par exemple « Excluez toujours les comptes de test internes des rapports de chiffre d’affaires. »
Glossaires métiers : mappez les termes techniques en langage naturel, par exemple store_id vers « Implantation ».
Métadonnées de champs : des descriptions qui aident l’agent à saisir les nuances de certaines variables, comme « chiffre d’affaires » vs « résultat net ».
Plus vos instructions et métadonnées sont précises, plus votre agent est fiable.
Les requêtes vérifiées, anciennement appelées Golden Queries, sont des paires question-réponse prédéfinies faisant office de référence. En reliant des questions spécifiques à du SQL validé par des experts, l’agent utilise les bons chemins de jointure et filtres pour les KPI critiques.
Ces requêtes peuvent inclure des fonctions BigQuery ML (BQML). L’agent peut ainsi gérer des demandes avancées, comme générer des prédictions de churn ou des prévisions de ventes, avec les paramètres définis par les data scientists. Une fois vérifiés, ces actifs sont gérés via le Dataplex Universal Catalog, garantissant la cohérence à l’échelle de l’organisation.
Maintenant que vous connaissez les briques de base, passons à la création et à la configuration de votre premier agent de données.
Pour suivre ce tutoriel, assurez-vous de disposer des prérequis suivants :
Avant de créer votre premier agent, vous devez configurer votre projet Google Cloud et vérifier que votre compte utilisateur dispose des autorisations nécessaires. Les Data Agents opèrent comme une couche au-dessus de vos données existantes ; une configuration IAM (Identity and Access Management) correcte est essentielle pour la sécurité et le bon fonctionnement.
Procédez ainsi :
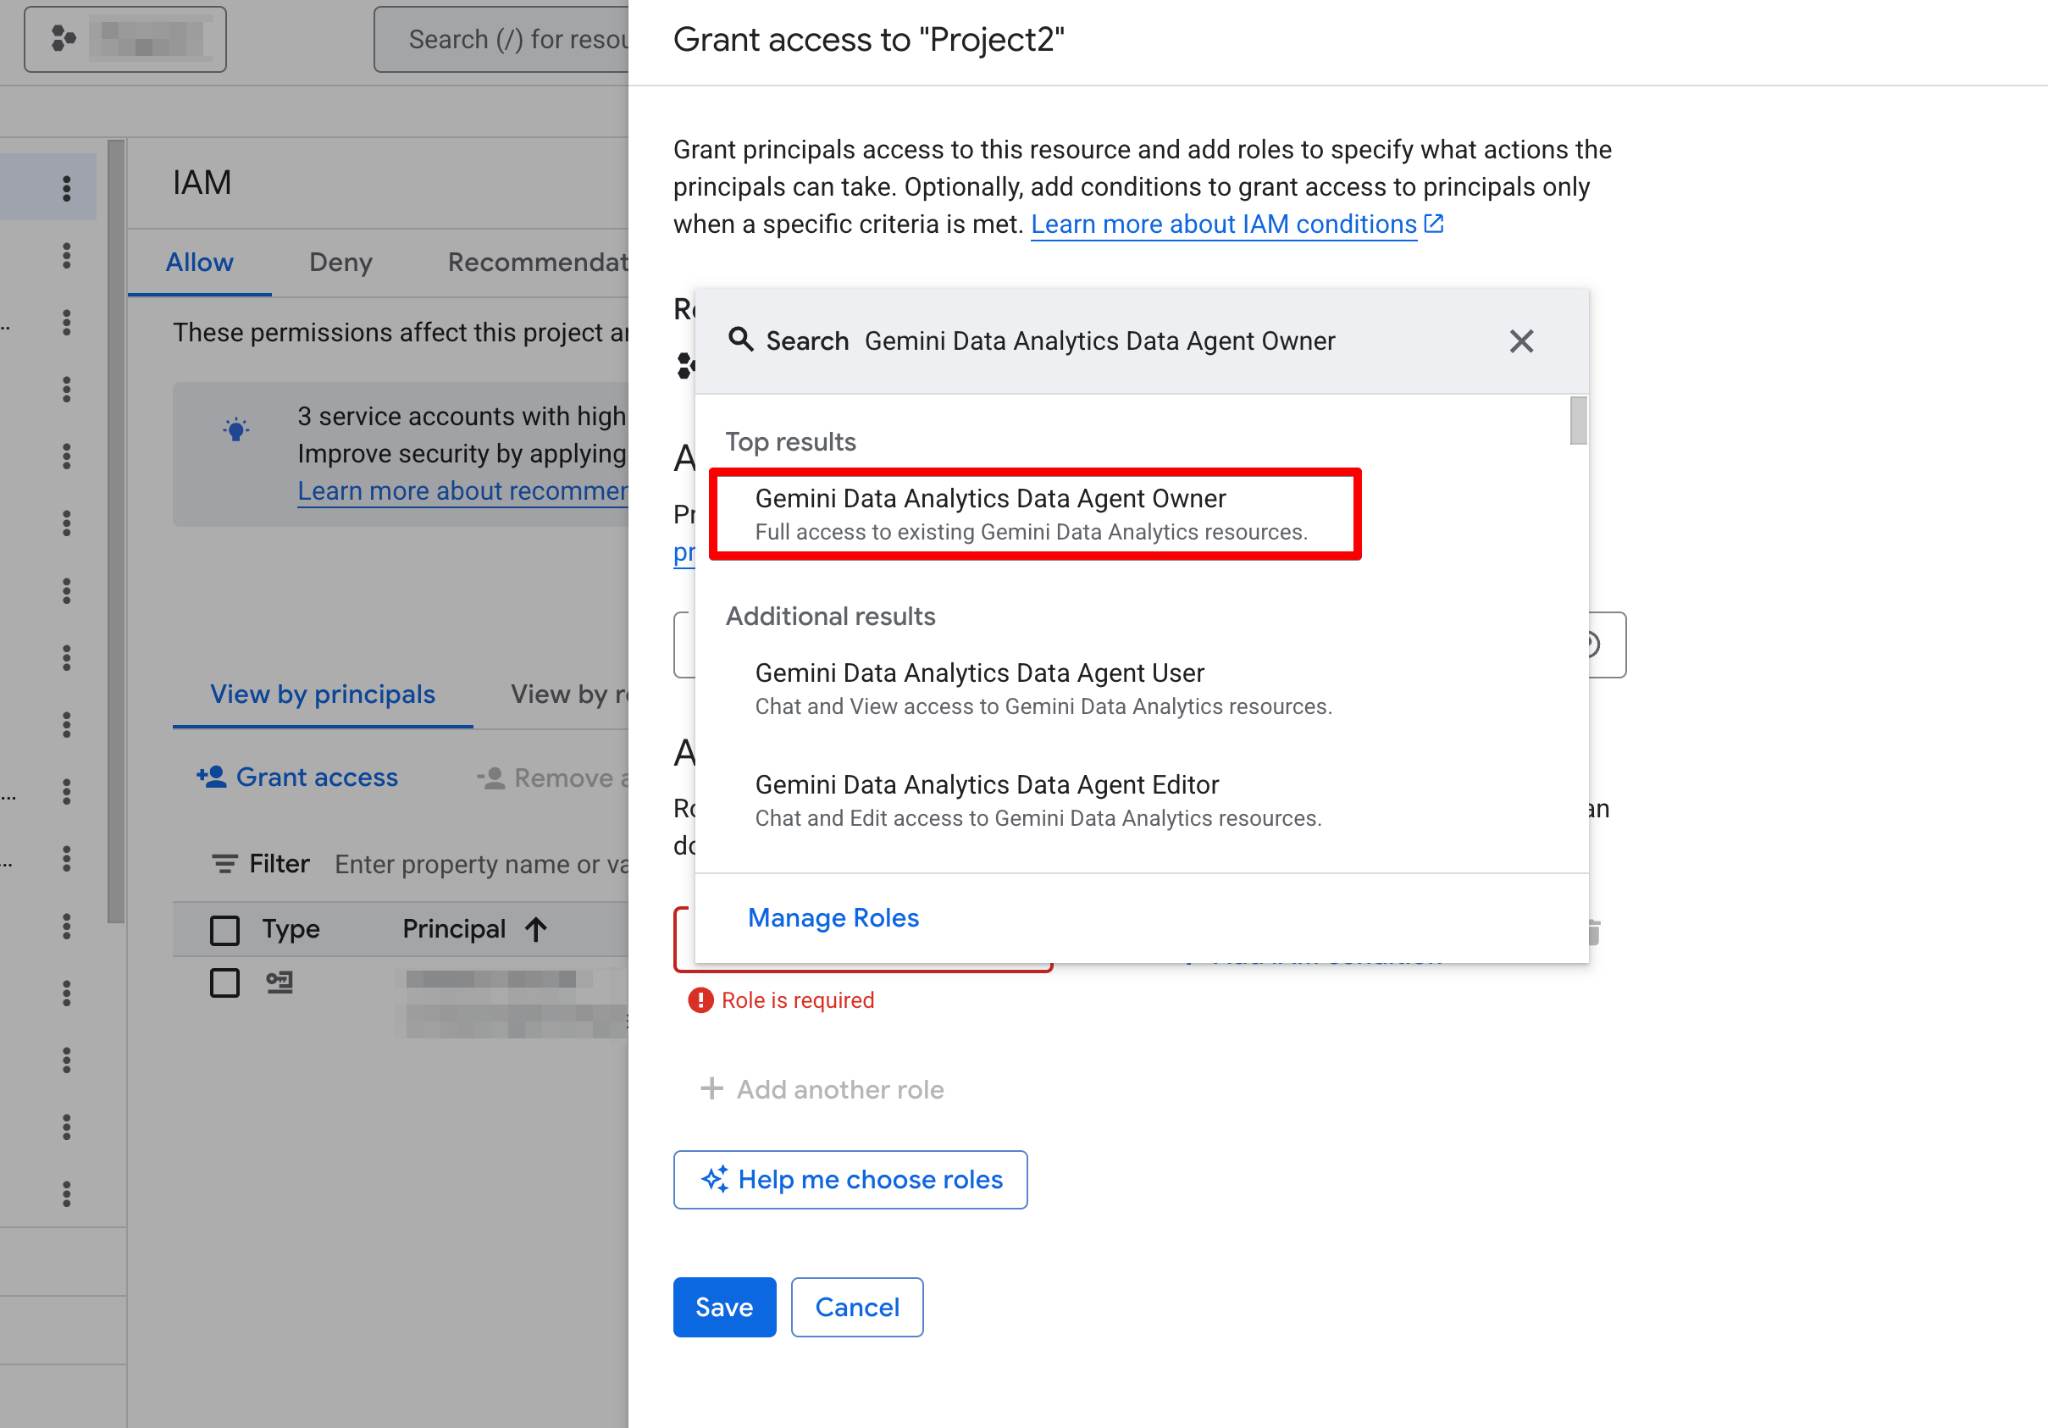
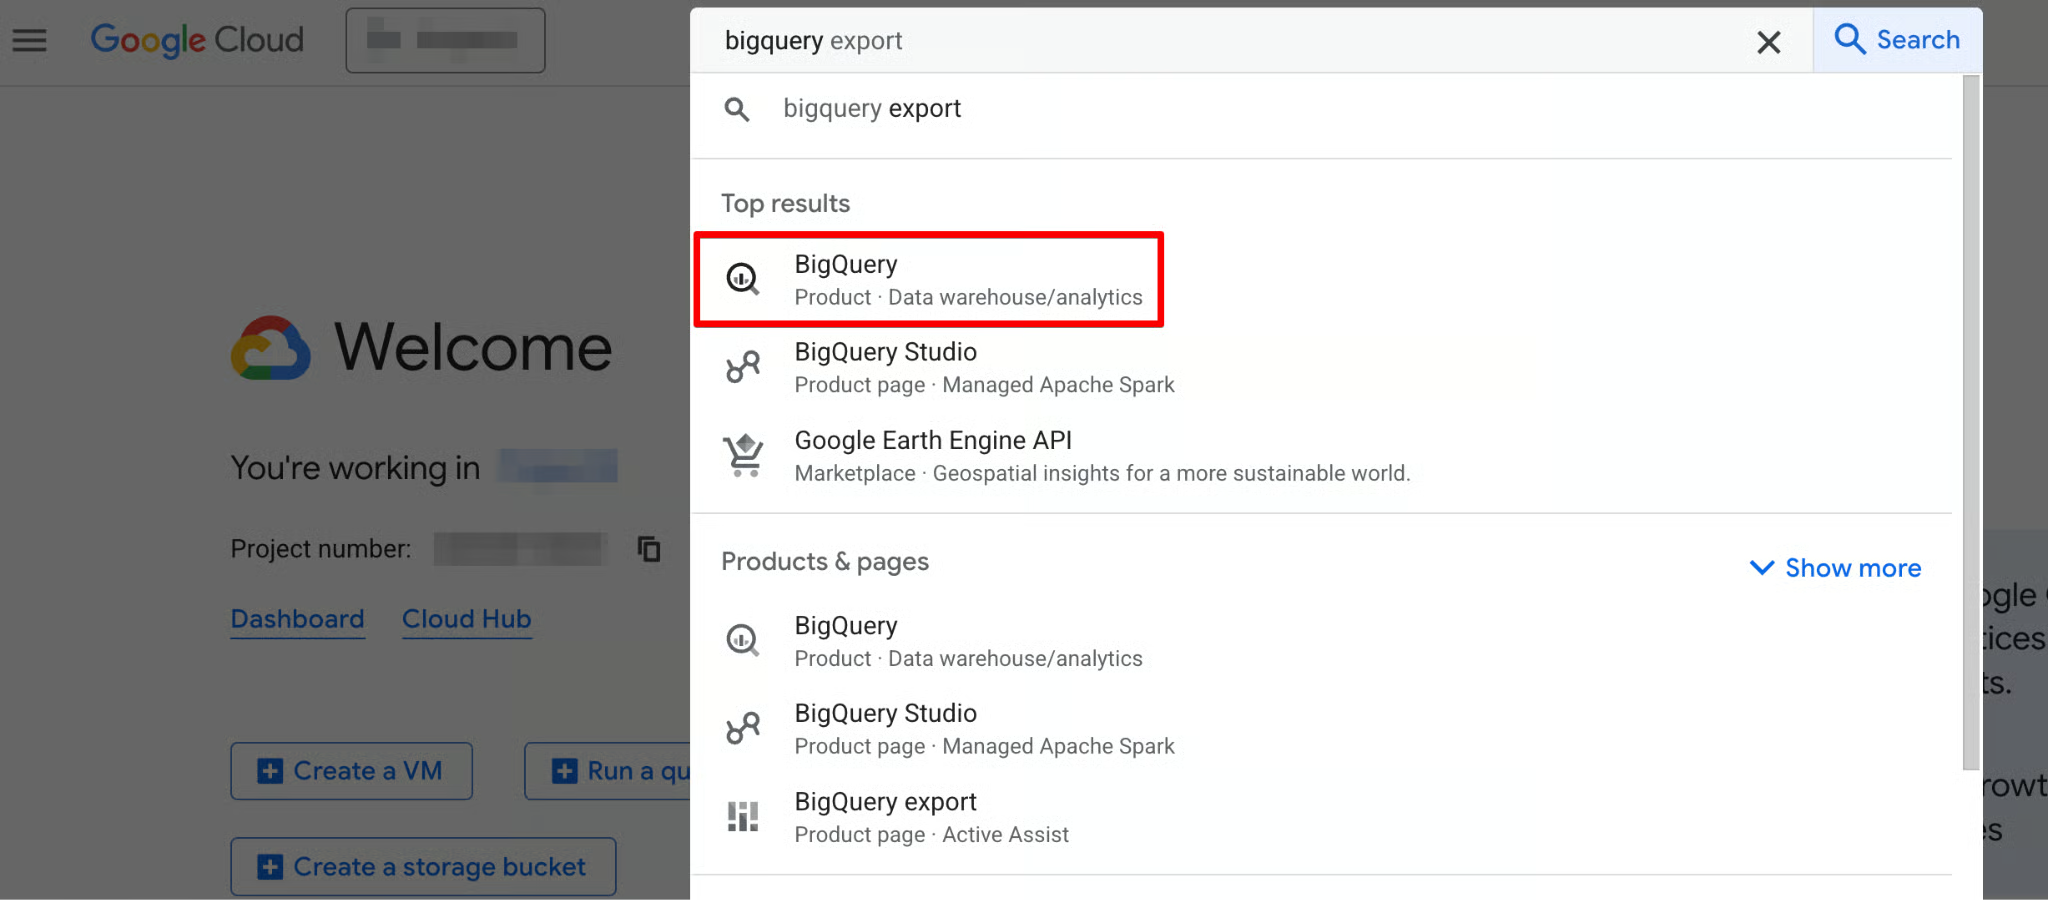
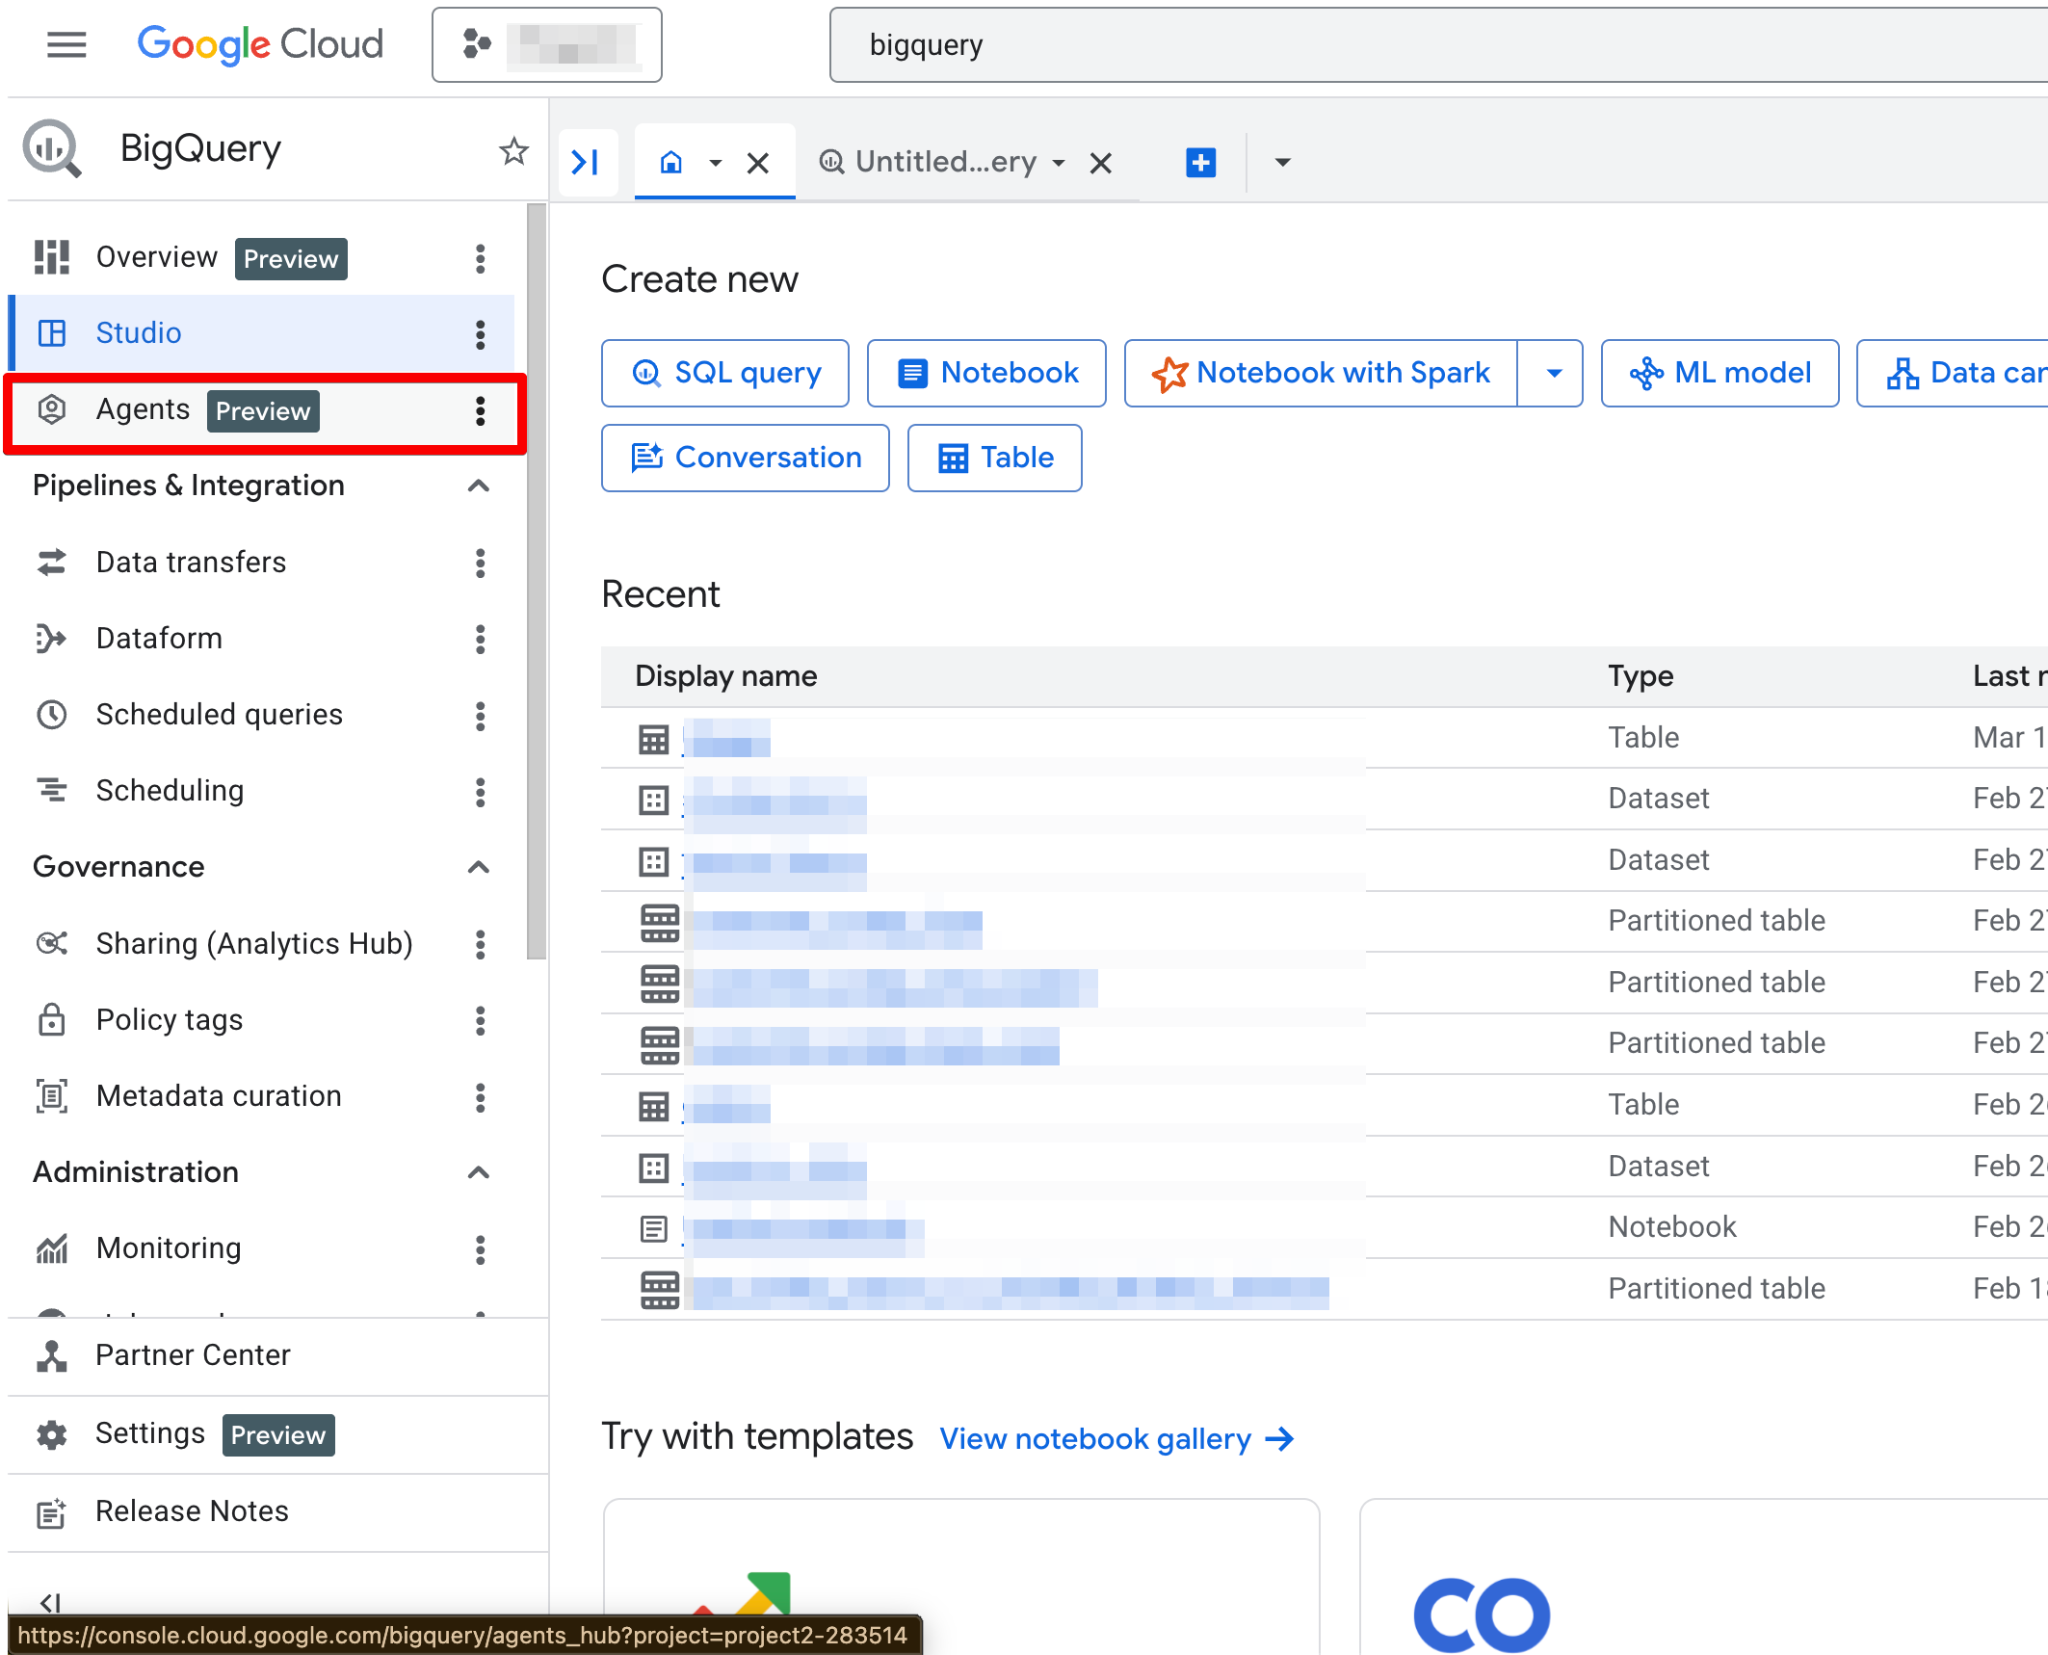
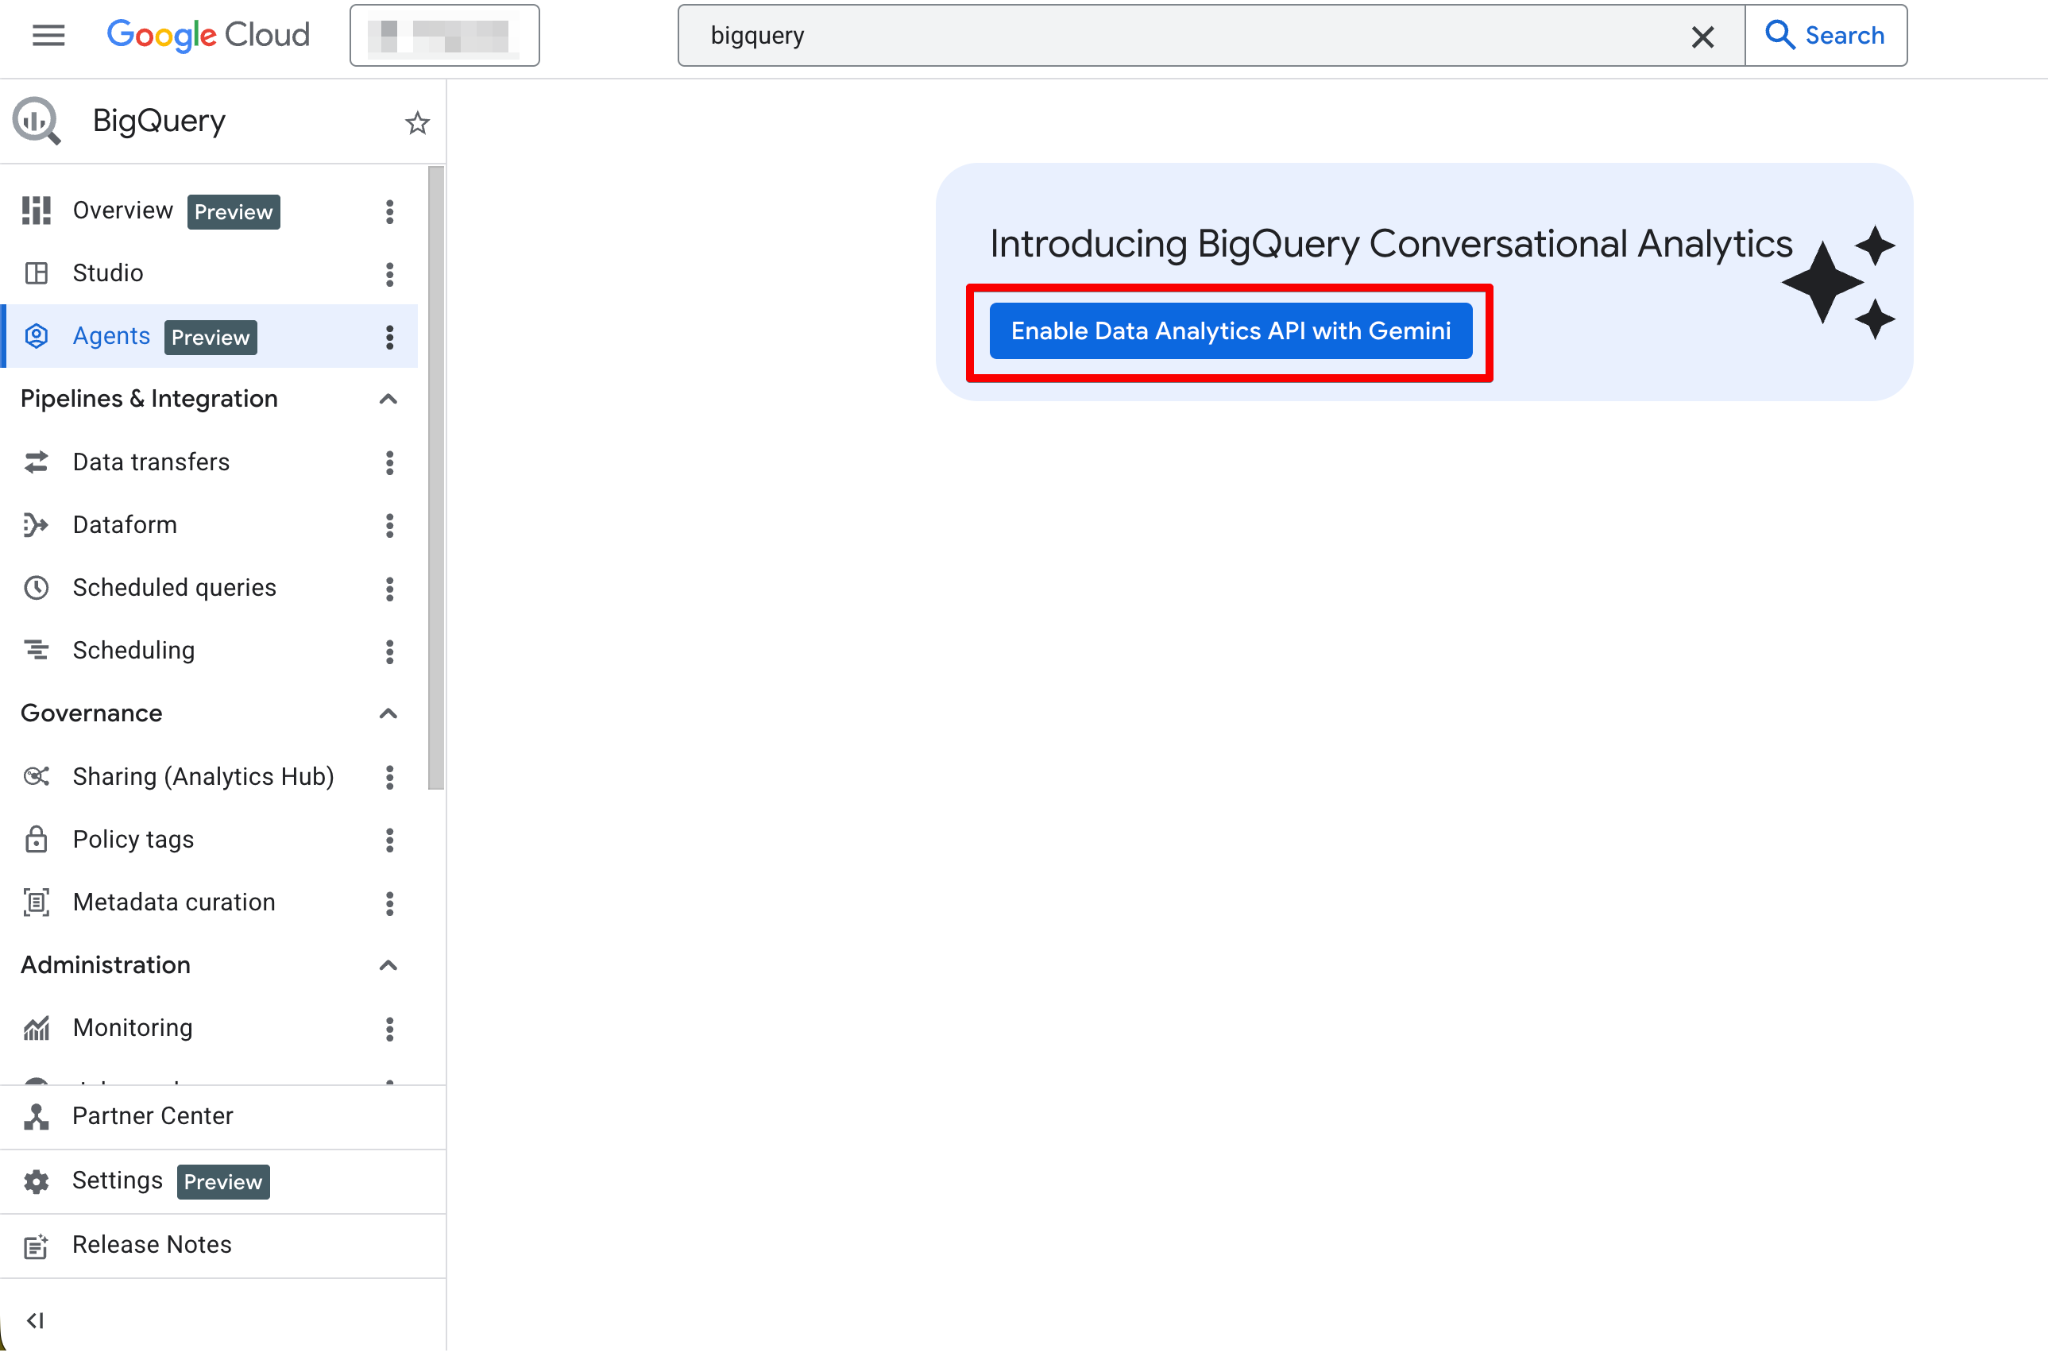
Une fois activée, la page Agents devient pleinement fonctionnelle. Vous devriez voir la nouvelle page d’agent :
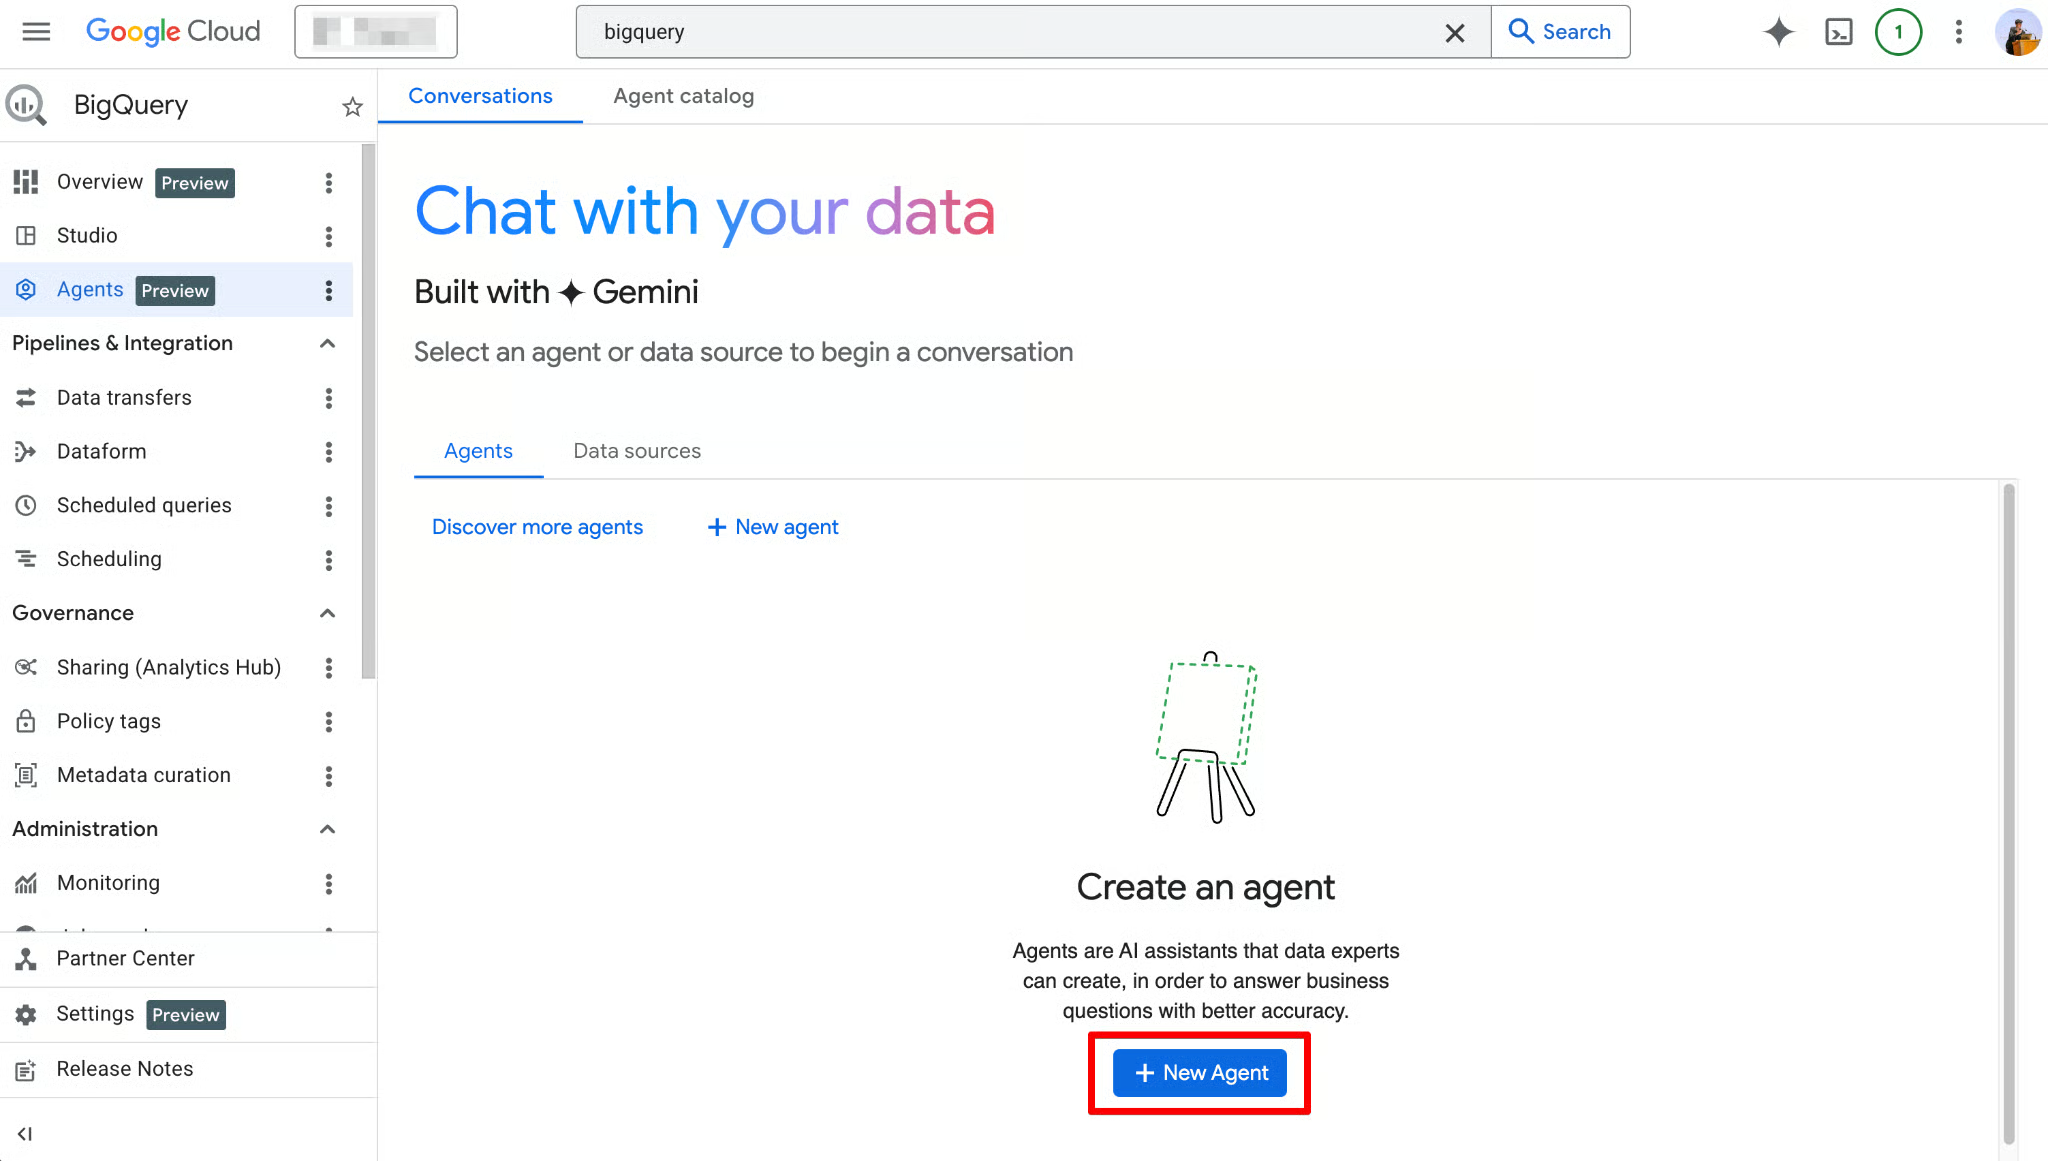
L’Agent Catalog sert à créer, gérer et versionner les agents de données dans BigQuery Studio.
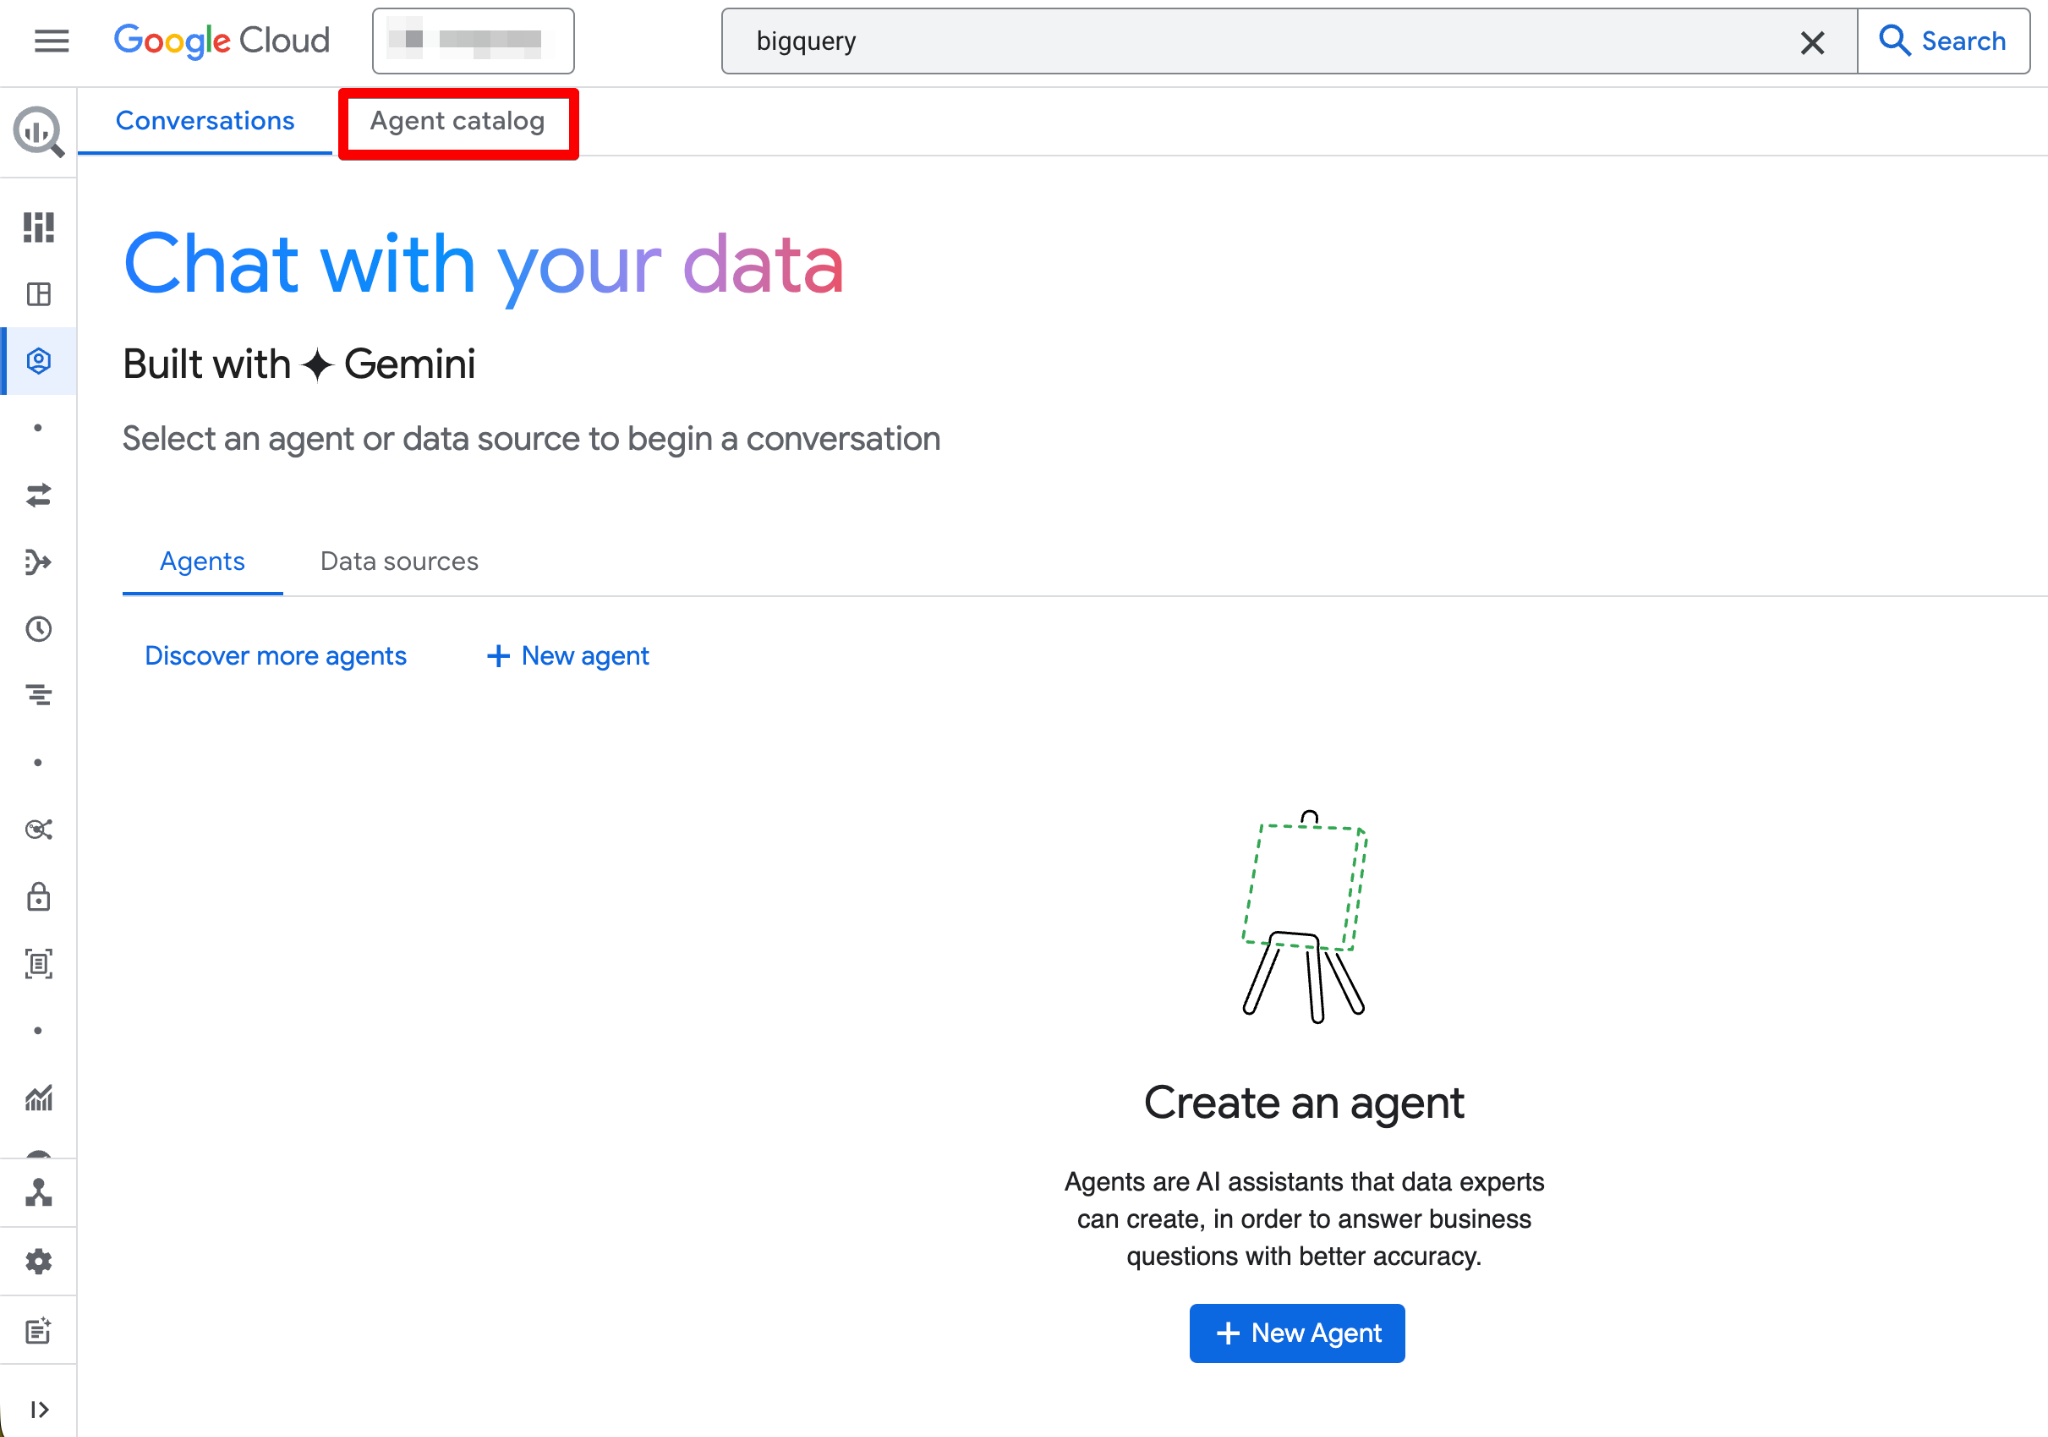
Voici ce que vous y trouverez :
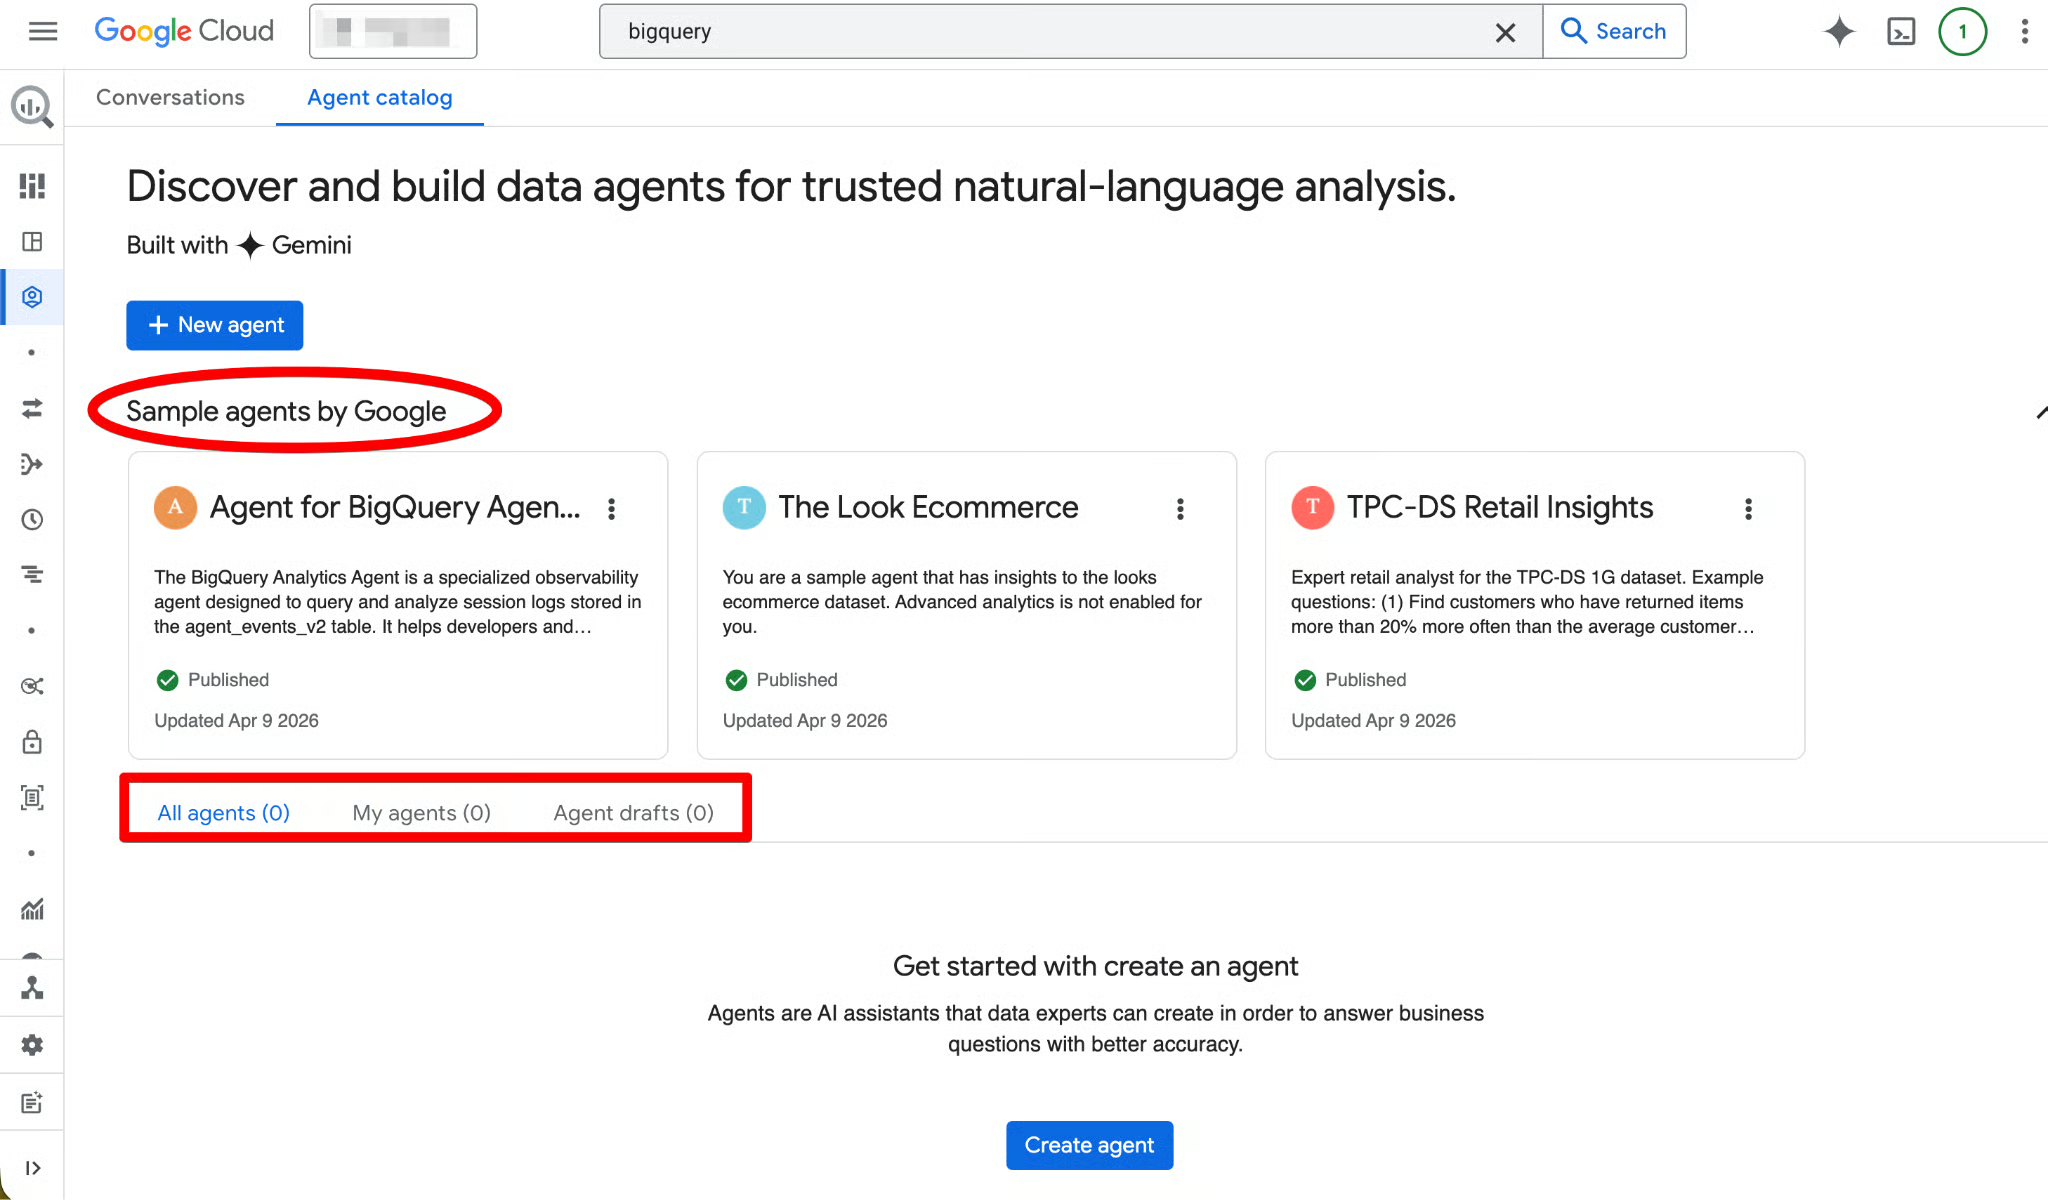
Le cycle de vie d’un agent suit la structure suivante (Brouillon → Créé → Publié) :
Cliquez sur une carte d’agent pour l’ouvrir, voir les détails, démarrer une conversation ou éditer (si vous avez les droits Owner). L’interface inclut aussi un onglet Conversations pour gérer les échanges passés avec des agents ou des sources.
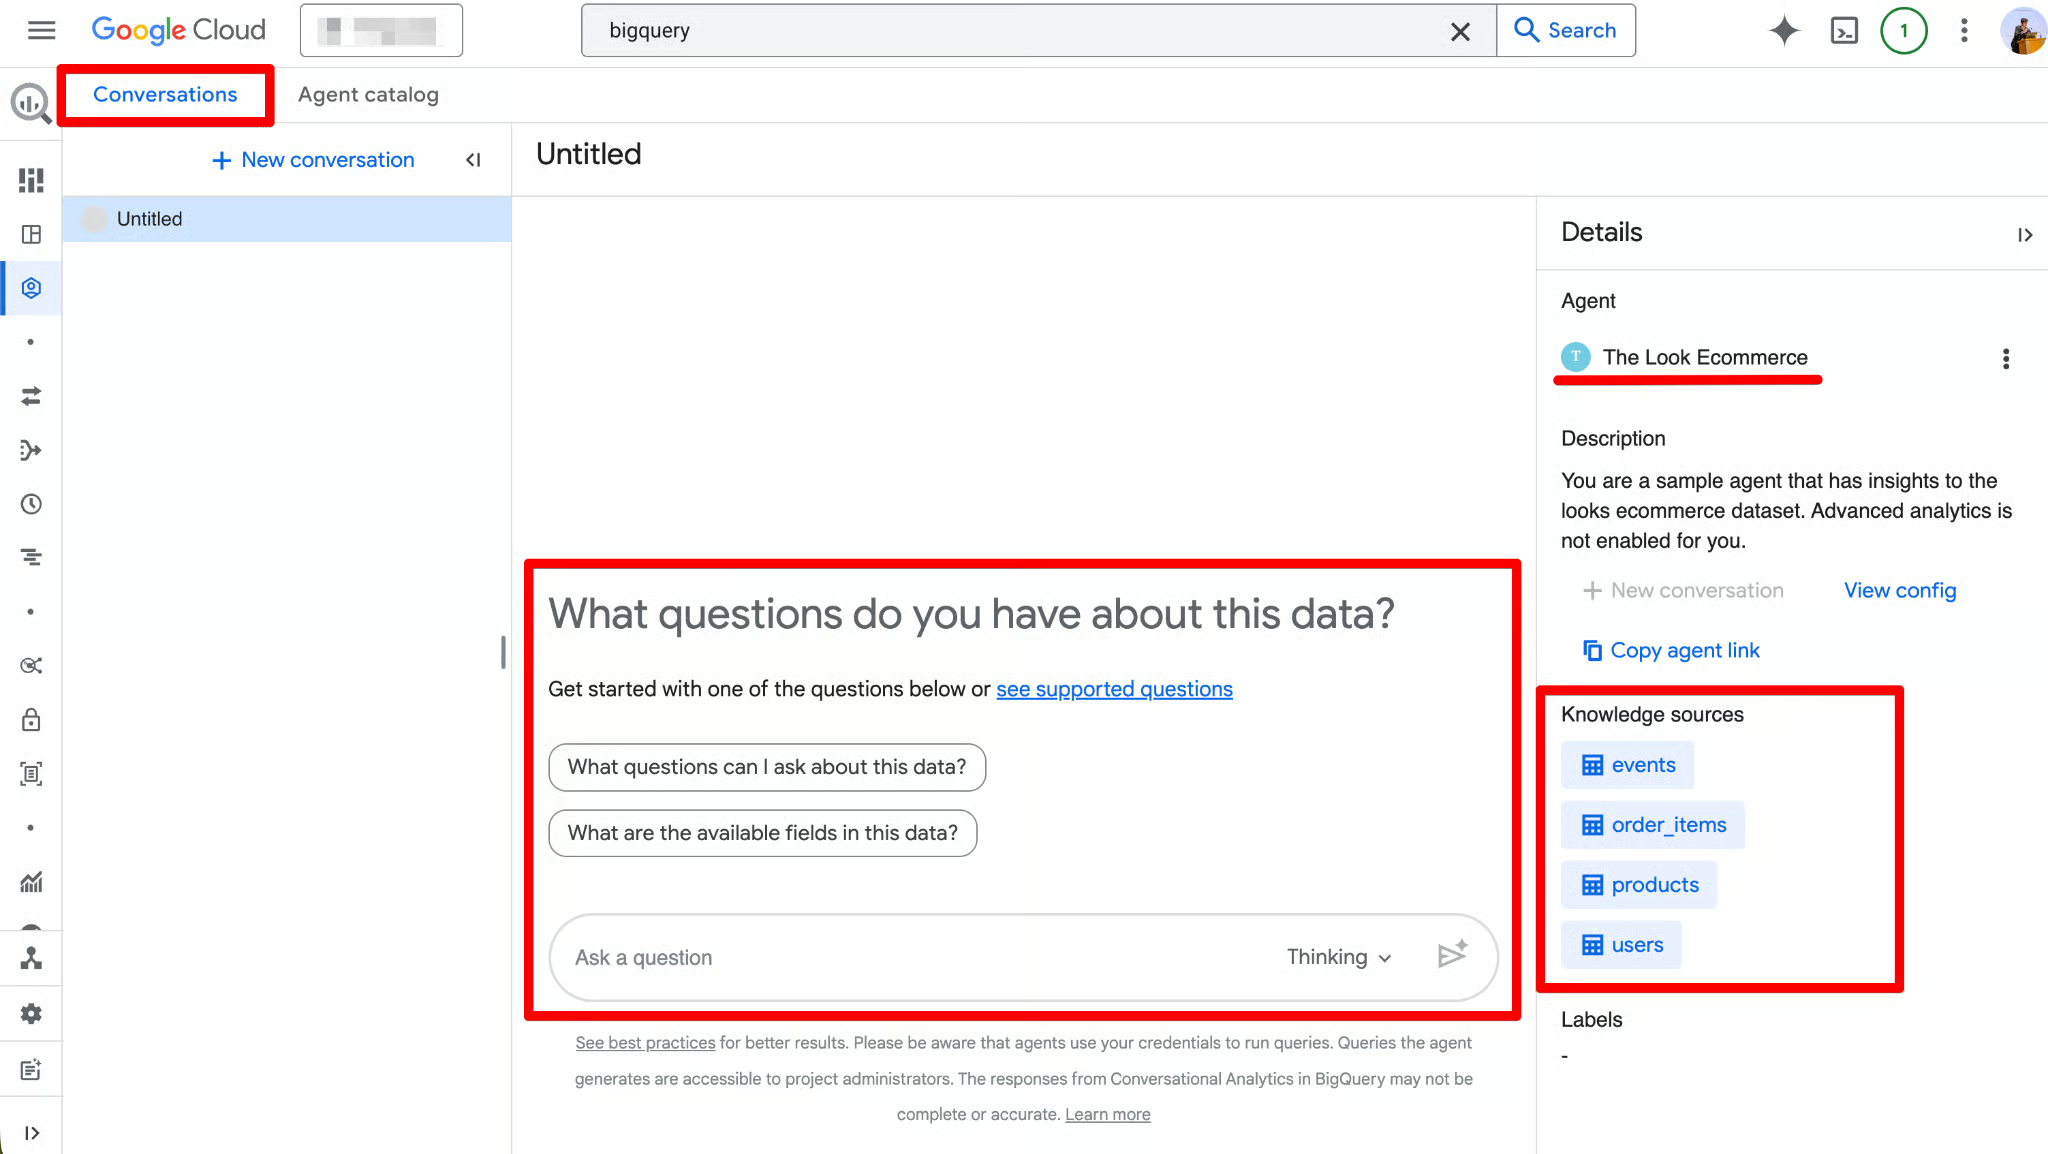
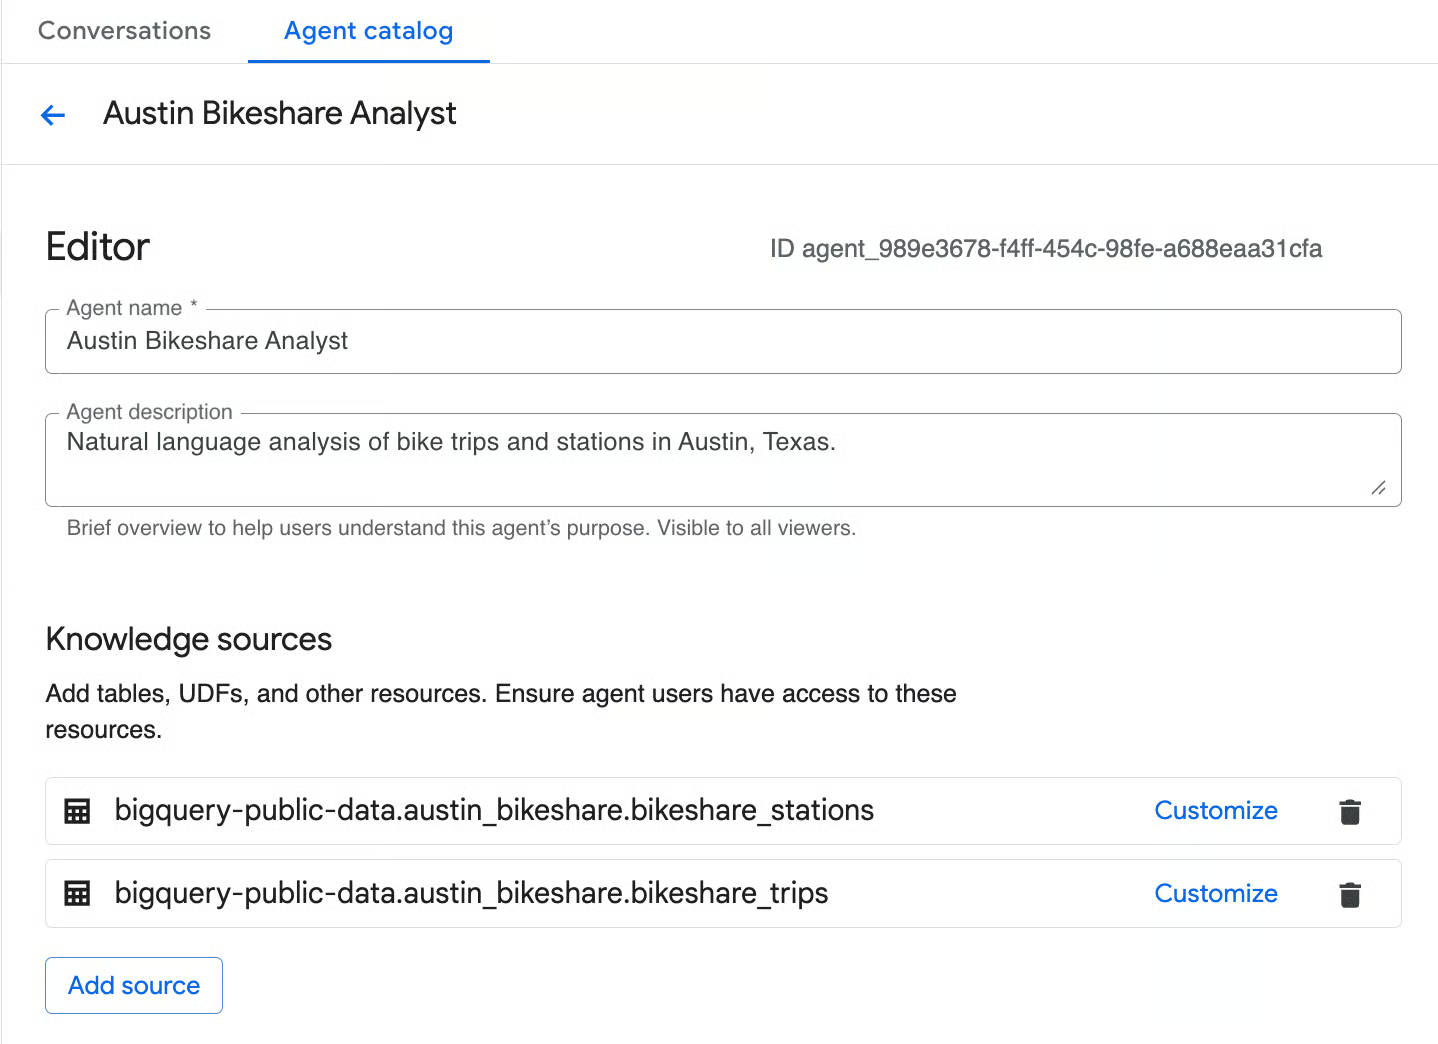
Maintenant que les bases sont posées, créons un agent de données de zéro. Nous utiliserons le jeu de données bigquery-public-data.austin_bikeshare pour transformer des données de trajets brutes en interface conversationnelle. Nous utiliserons deux tables :
bikeshare_trips — données détaillées au niveau du trajet
bikeshare_stations — métadonnées des stations
Démarrer la création de l’agent
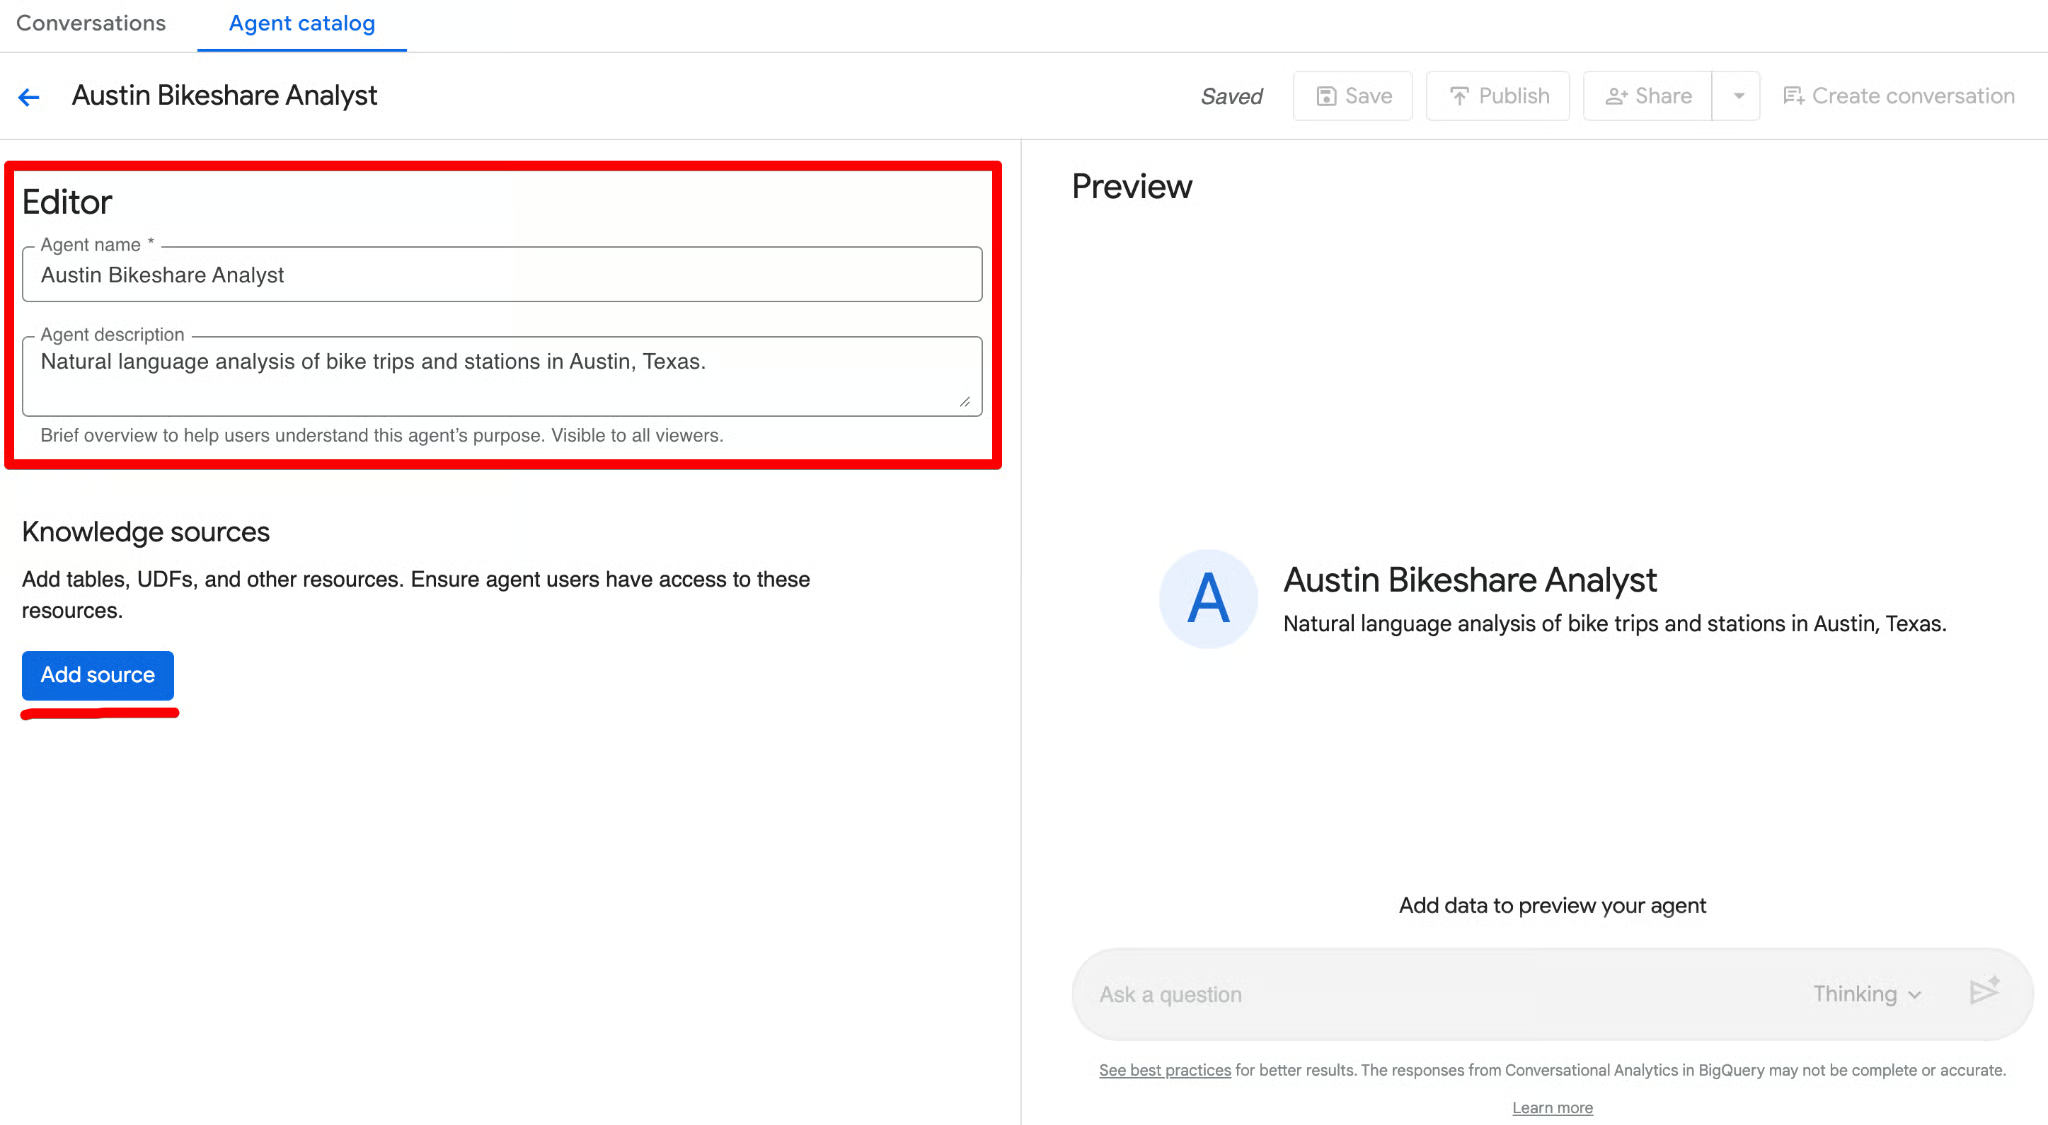
Ces deux champs vous aideront à identifier rapidement l’agent plus tard. Une fois définis, vous pouvez configurer les trois briques essentielles vues plus haut : sources de connaissances, instructions et (plus tard) requêtes vérifiées.
Les sources de connaissances définissent exactement les données accessibles à l’agent. Moins elles sont nombreuses et plus elles sont ciblées, meilleure est la précision et plus faibles sont les coûts. Dans la section Knowledge sources de l’éditeur, cliquez sur Add source. Recherchez austin_bikeshare et sélectionnez bikeshare_trips et bikeshare_stations comme sources.
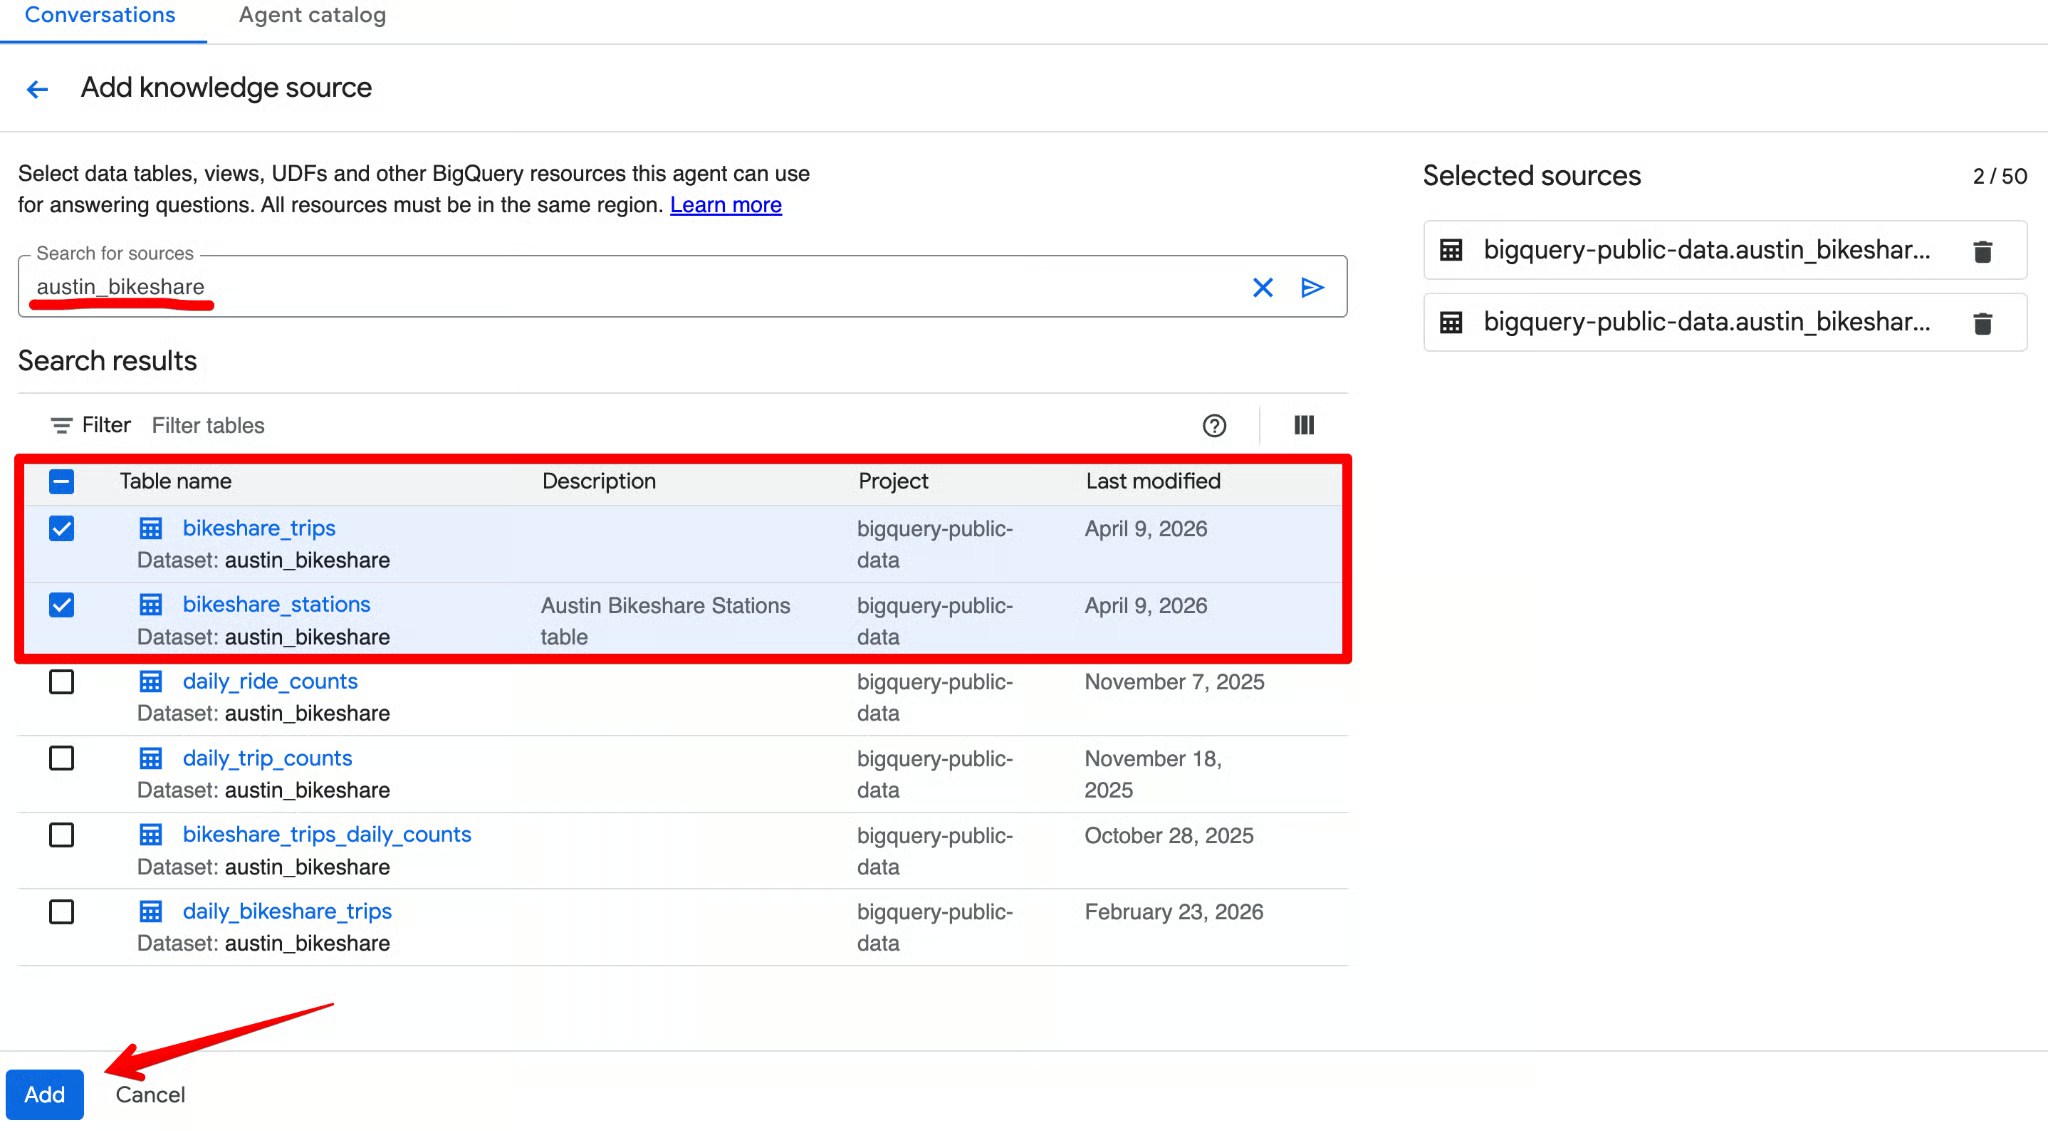
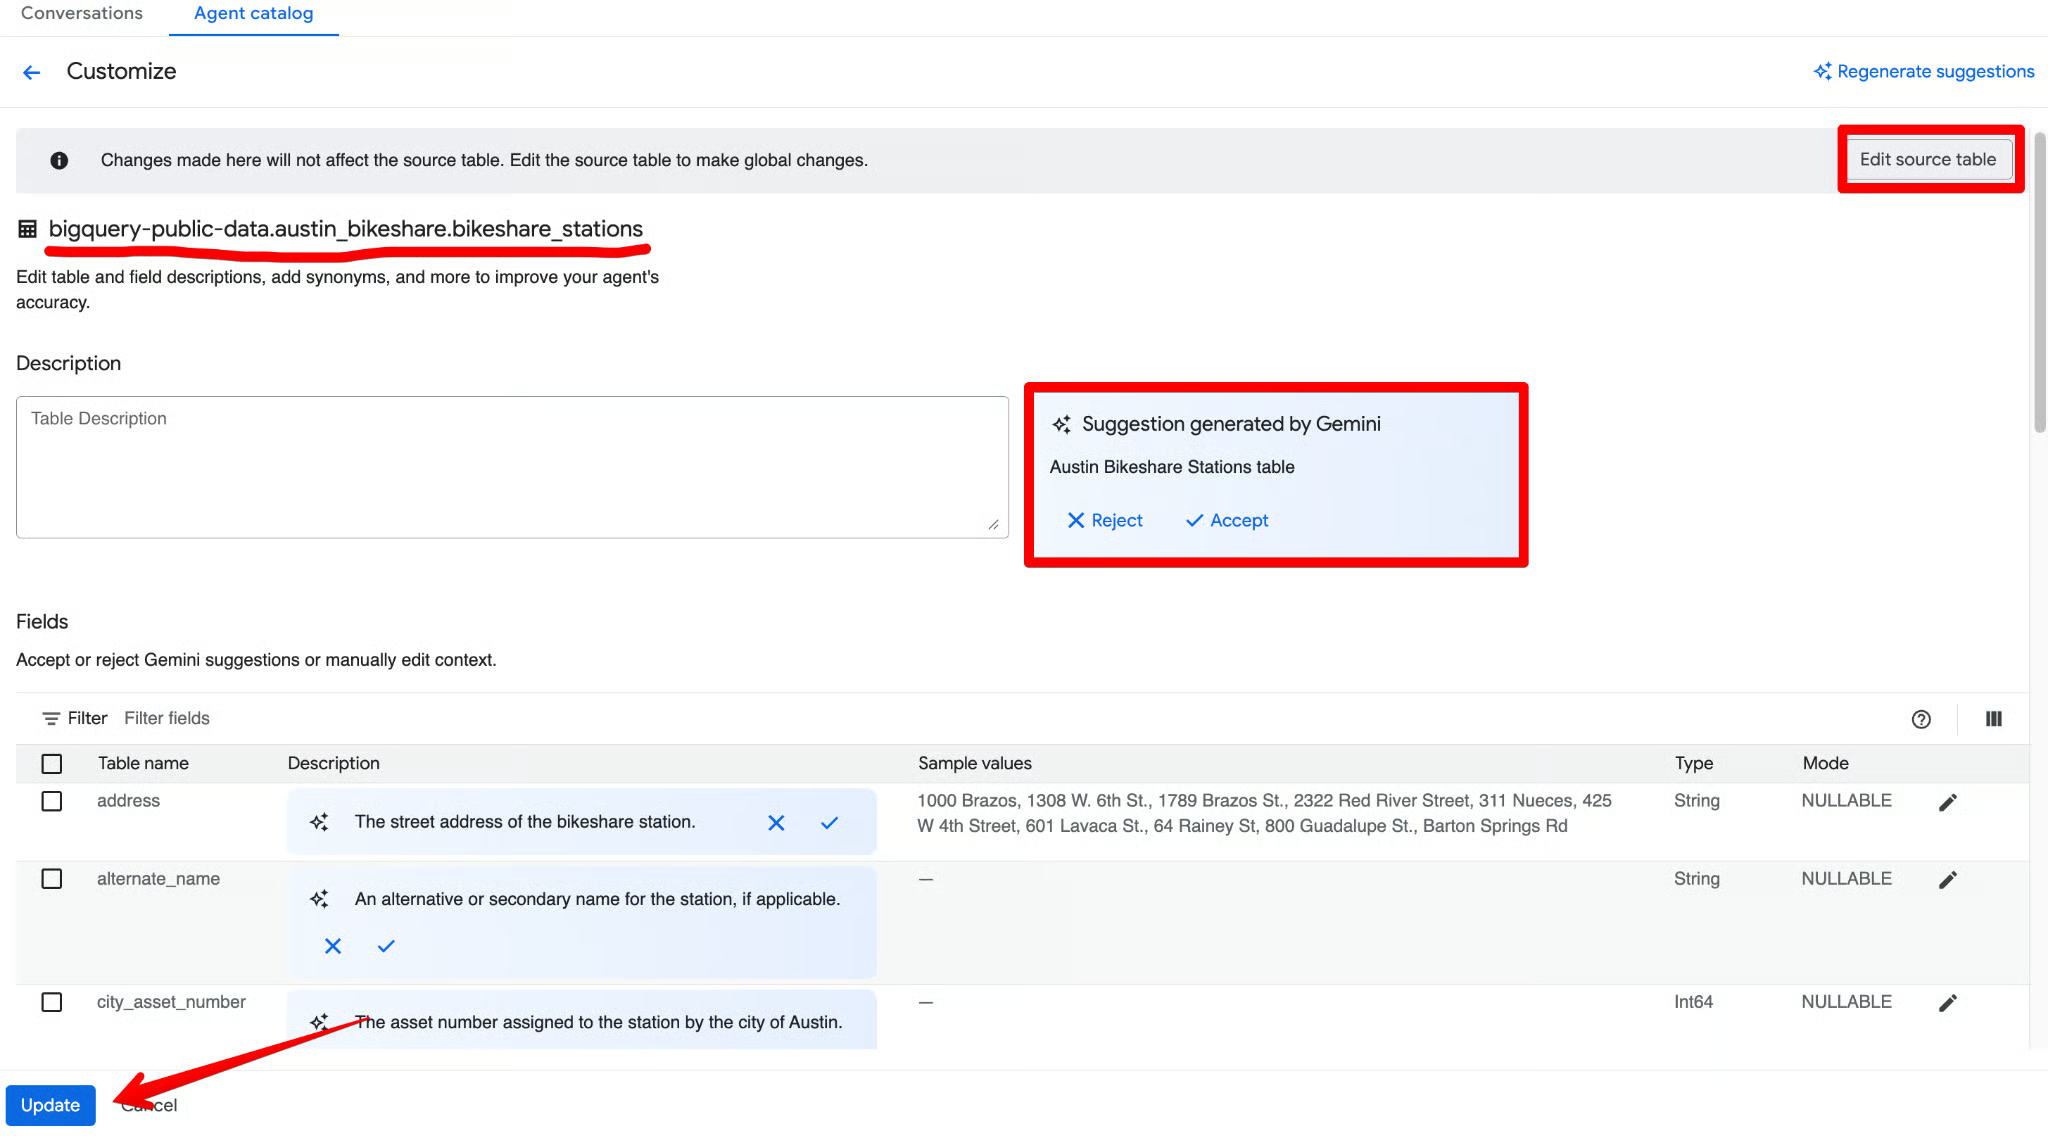
Pour chaque table ajoutée, cliquez sur Customize.
Gemini génère automatiquement une description et suggère des métadonnées de colonnes. Passez tout en revue, validez les propositions exactes, ajustez si besoin, puis cliquez sur Update.
Une erreur courante consiste à ajouter 50 tables d’un coup. Commencez par 2–3 tables cœur. Cela simplifie le débogage de la logique de l’agent. Vous pourrez toujours élargir le périmètre une fois les requêtes centrales fiables.
Ensuite, vous devez ancrer votre agent avec des instructions. Plutôt que de saisir une invite générique (par ex. : « Répondez aux questions sur les ventes »), l’interface de l’agent BigQuery vous permet de fournir un contexte hautement structuré pour guider la génération des requêtes par l’IA. Voyez cela comme l’onboarding d’un nouvel analyste avec votre dictionnaire de données interne.
Utilisez le champ Instructions pour fournir un contexte métier structuré. Voici un exemple complet, prêt à l’emploi :
Synonymes : définissez des termes alternatifs pour vos colonnes afin que l’agent comprenne les variations naturelles. Exemple : « Journey », « Ride » et « Commute » désignent un enregistrement de la table bikeshare_trips. « Dock », « Hub » ou « Station » désignent un enregistrement de la table bikeshare_stations.
Champs clés : mettez en avant les champs les plus importants pour l’analyse. Cela indique à l’agent quelles colonnes privilégier lorsque la question est large. Exemple : prioriser trip_id, start_station_name, end_station_name, subscriber_type, start_time et duration_minutes pour le reporting général.
Champs exclus : spécifiez les colonnes que l’agent doit éviter strictement. Très utile pour masquer des colonnes obsolètes ou non pertinentes. Exemple : ne pas utiliser la colonne bike_id de bikeshare_trips dans la plupart des analyses, car rarement utile aux questions métier.
Filtres et regroupements : indiquez à l’agent les façons standard de segmenter les données. Exemple : sauf indication contraire, exclure toujours les trajets où duration_minutes < 1 (faux départs ou essais). Par défaut, regrouper par start_station_name quand l’utilisateur demande « par station » ou « top stations ».
Relations de jointure : puisque notre agent exploite plusieurs tables, décrivez explicitement leurs liens. Cela évite les clés étrangères erronées. Exemple : joindre bikeshare_trips à bikeshare_stations via bikeshare_trips.start_station_id = bikeshare_stations.station_id (et de même pour end_station_id).
Vous pouvez regrouper tout cela dans un bloc clair dans le champ Instructions. Voici une version soignée, prête à coller, qui intègre ces recommandations structurées :
You are a senior transportation analyst for the Austin Bikeshare program.
Core rules and defaults:
- Always filter on start_time unless the user specifies a different time field.
- Default time range for any "trend", "recent", "last month", or similar = last 30 days.
- "Top stations" means stations with the highest ridership (highest number of trips started).
- Exclude false start rides/test rides: never include trips where duration_minutes < 1.
- Display station names in final results; use station_id only for joins.
- Prefer clear, readable visualizations: bar charts for rankings, line charts for time-based trends.
Key fields: Prioritize trip_id, start_station_name, end_station_name, subscriber_type, start_time, and duration_minutes for most analyses.
Join relationships: Join bikeshare_trips to bikeshare_stations on bikeshare_trips.start_station_id = bikeshare_stations.station_id (and similarly for end_station_id).
Persona framework (very effective): Begin your instructions with a clear persona statement. This sets the tone, depth of analysis, and output style (e.g., “You are a senior transportation analyst…”).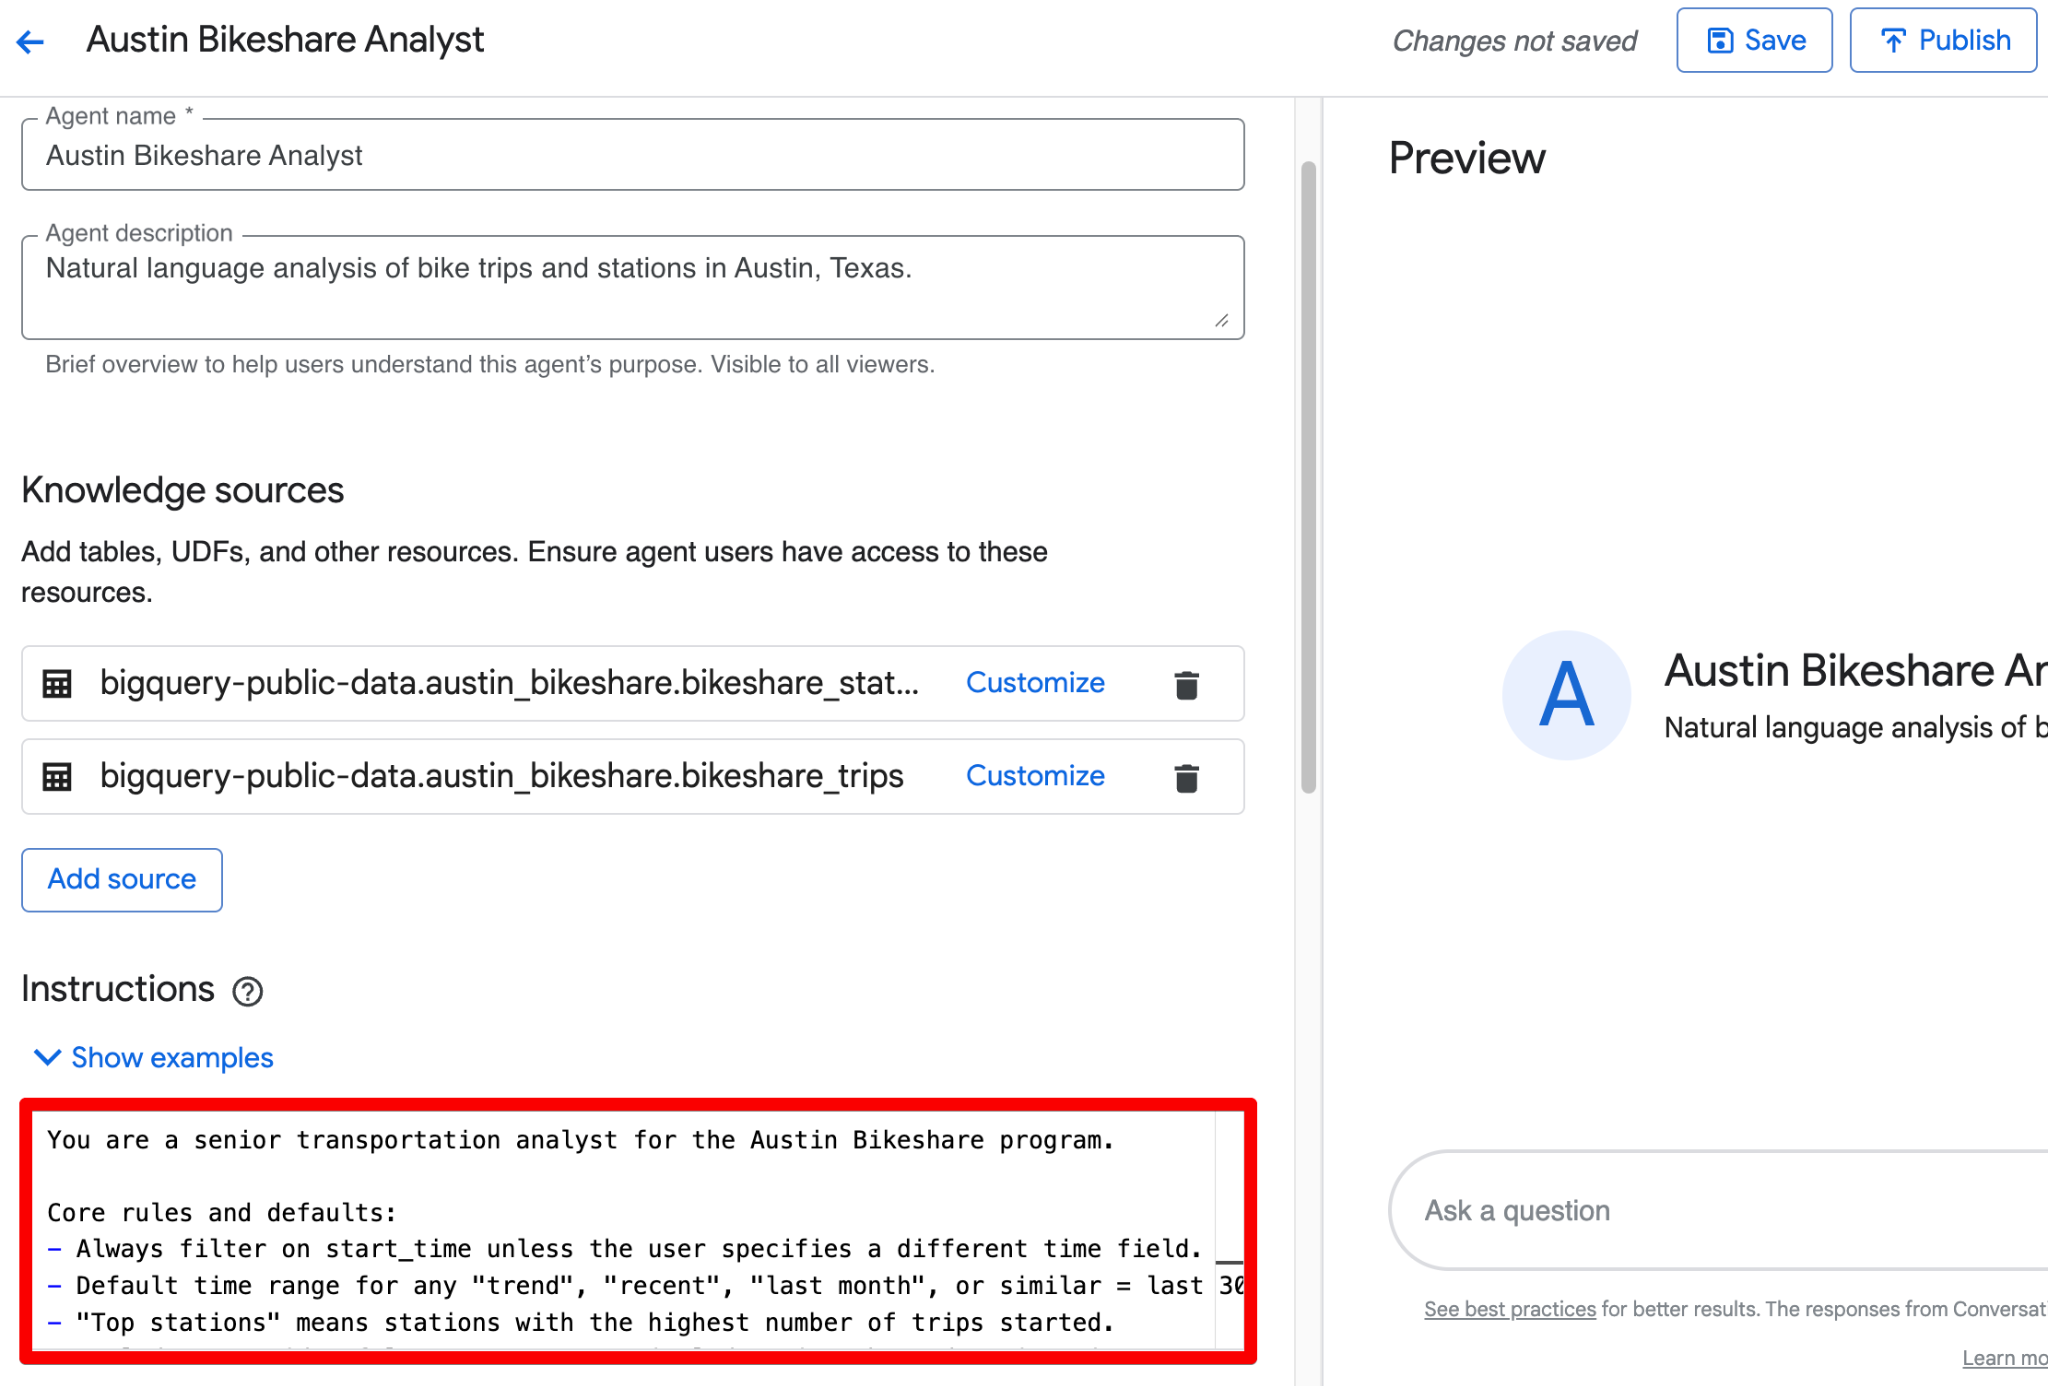
Pourquoi c’est important : si vous laissez ces champs vides, une question ambiguë comme « Quels ont été nos meilleures ventes ? » peut amener l’agent à joindre les mauvaises tables, à puiser dans des comptes inactifs ou à inclure des données dépréciées. En structurant vos instructions selon ces cinq catégories, vous garantissez que le SQL généré respecte strictement votre logique métier.
En plus des instructions, vous pouvez (et devriez) définir des termes de glossaire directement dans l’agent. Ils aident à interpréter de manière cohérente le jargon métier, les abbréviations et les concepts dérivés.
Cliquez Add term dans la section Glossary (généralement près des Instructions) et créez des entrées avec un terme, une définition et des synonymes (séparés par des virgules).
Voici des termes recommandés pour le jeu de données Austin Bikeshare :
| Terme | Définition | Synonymes |
duration_minutes |
Durée du trajet en minutes. Toujours utiliser pour les réponses et calculs destinés aux utilisateurs | temps de trajet, durée du parcours, durée, durée de trajet |
ridership |
Nombre total (comptage) de trajets à vélo démarrés | trajets, courses, parcours, utilisation des vélos, nombre de trajets |
peak_hours |
Heures de pointe du matin (7–9 h) ou du soir (16–19 h) selon l’heure extraite de start_time |
heures de pointe, heures chargées, période de forte demande |
subscriber_type |
Type d’utilisateur — abonné (titulaire d’un pass mensuel ou annuel) ou client (trajet à l’unité | type d’utilisateur, type d’abonnement, pass holder, membre, utilisateur occasionnel |
false_start |
Un trajet très court (généralement < 1 min), sans doute un essai ou un déverrouillage accidentel. À exclure normalement de l’analyse | essai, trajet invalide, trajet court |
Vous pouvez ajouter d’autres termes si besoin (par exemple pour start_station_name, end_station_name ou des indicateurs dérivés comme « durée moyenne de trajet » ou « long trajet »).
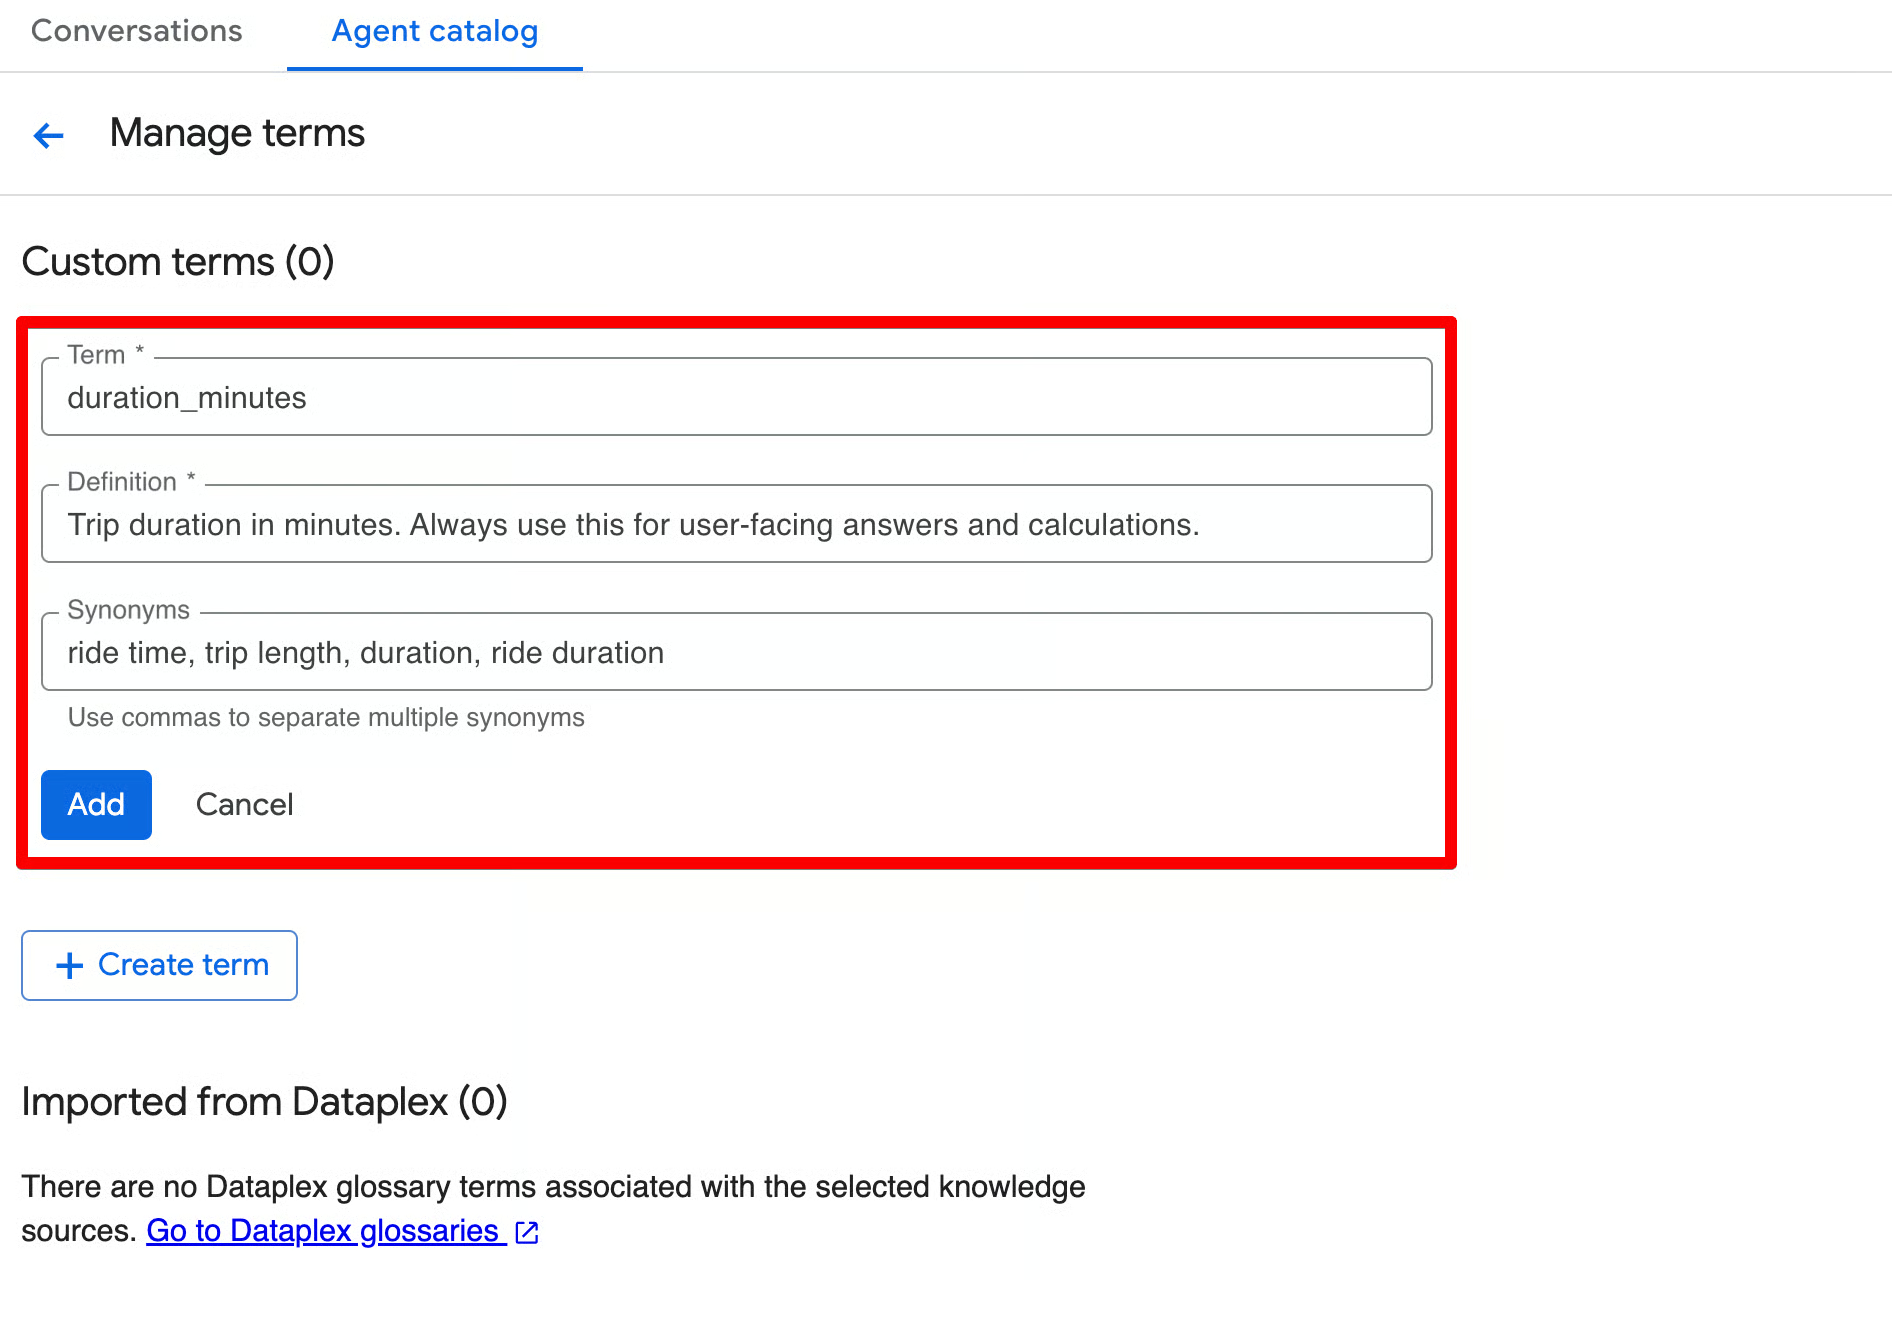
Avec les glossaires, si la direction décide de faire évoluer la définition officielle d’un « long trajet » à 45 minutes le trimestre prochain, votre équipe de gouvernance des données n’a qu’à mettre à jour Dataplex. Tous les Data Agents connectés adopteront immédiatement la nouvelle logique pour une cohérence globale.
Une fois les sources, instructions et termes du glossaire configurés, testez votre agent avant publication.
Sur la droite, ouvrez le volet Preview. Cette interface de chat en direct vous permet d’interagir avec l’agent en temps réel durant la construction. Vous pouvez poser des questions, examiner le raisonnement de l’agent, inspecter le SQL généré et itérer rapidement.
Le volet Preview affiche :
Essayez ces quatre requêtes de difficulté croissante (adaptées à l’étendue des données jusqu’en 2024) :
Ce que vous verrez dans la réponse de l’agent :
Résumé — une explication en langage naturel des résultats.
Résultat de la requête — un tableau propre (par ex. : total des trajets, top stations, durée moyenne).
Insights — des points clés interprétant les résultats dans un contexte métier.
SQL généré — cliquez sur Open in Editor pour voir la requête SQL complète (vous noterez le filtre sur start_time et duration_minutes >= 1 pour exclure les faux départs).
Relances suggérées — des invites utiles en bas (par ex. : « Quelles sont les 10 stations de départ les plus fréquentées en juin 2024 ? », « Prévoyez le nombre quotidien de trajets… », etc.).
Visualisation — un graphique généré automatiquement (diagramme en barres pour les classements, comme dans l’exemple des 5 meilleures stations).
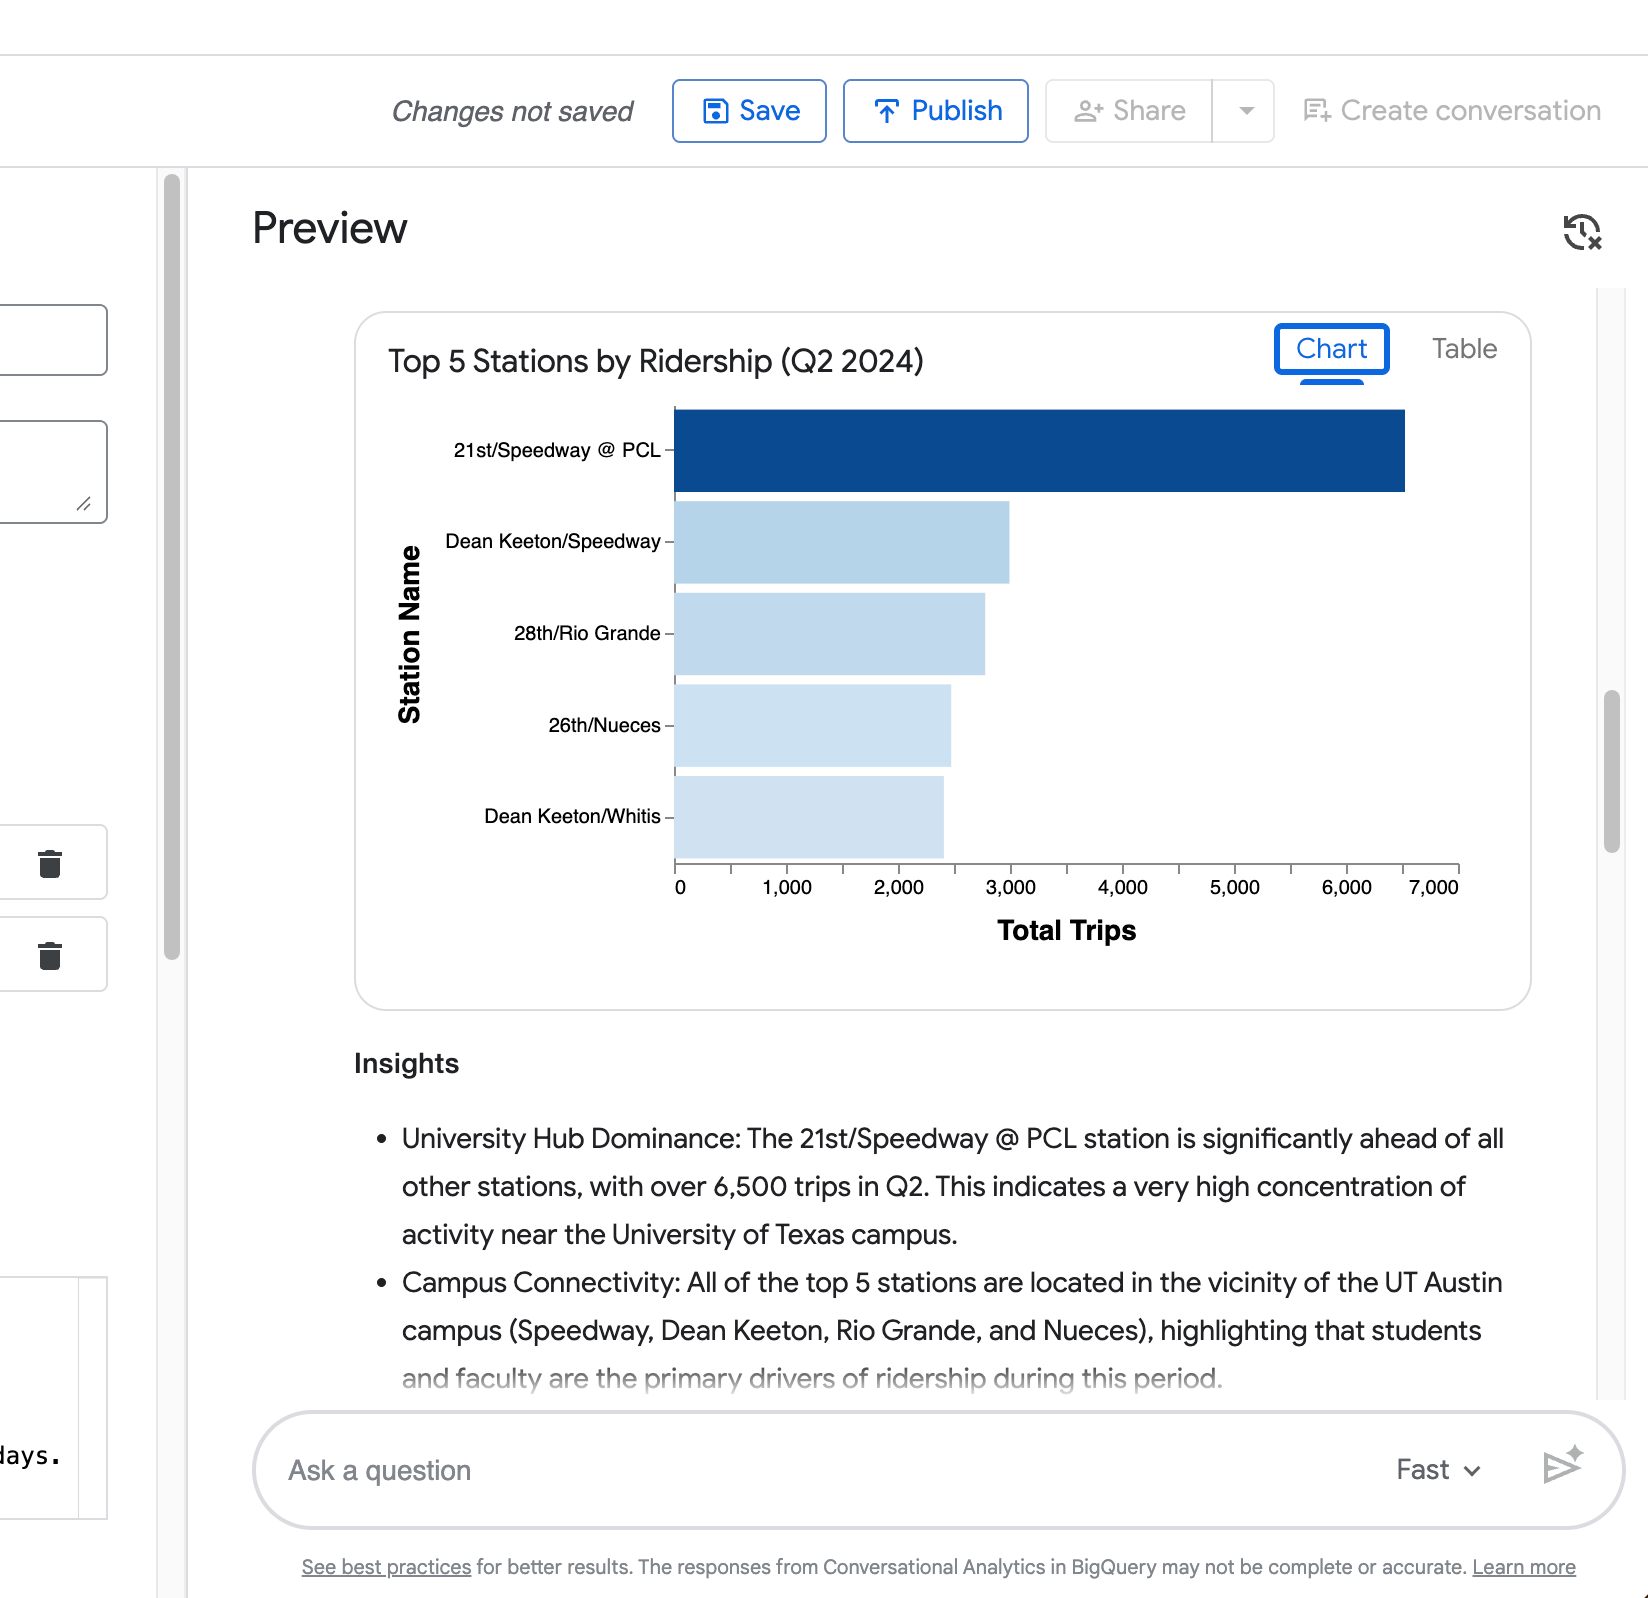
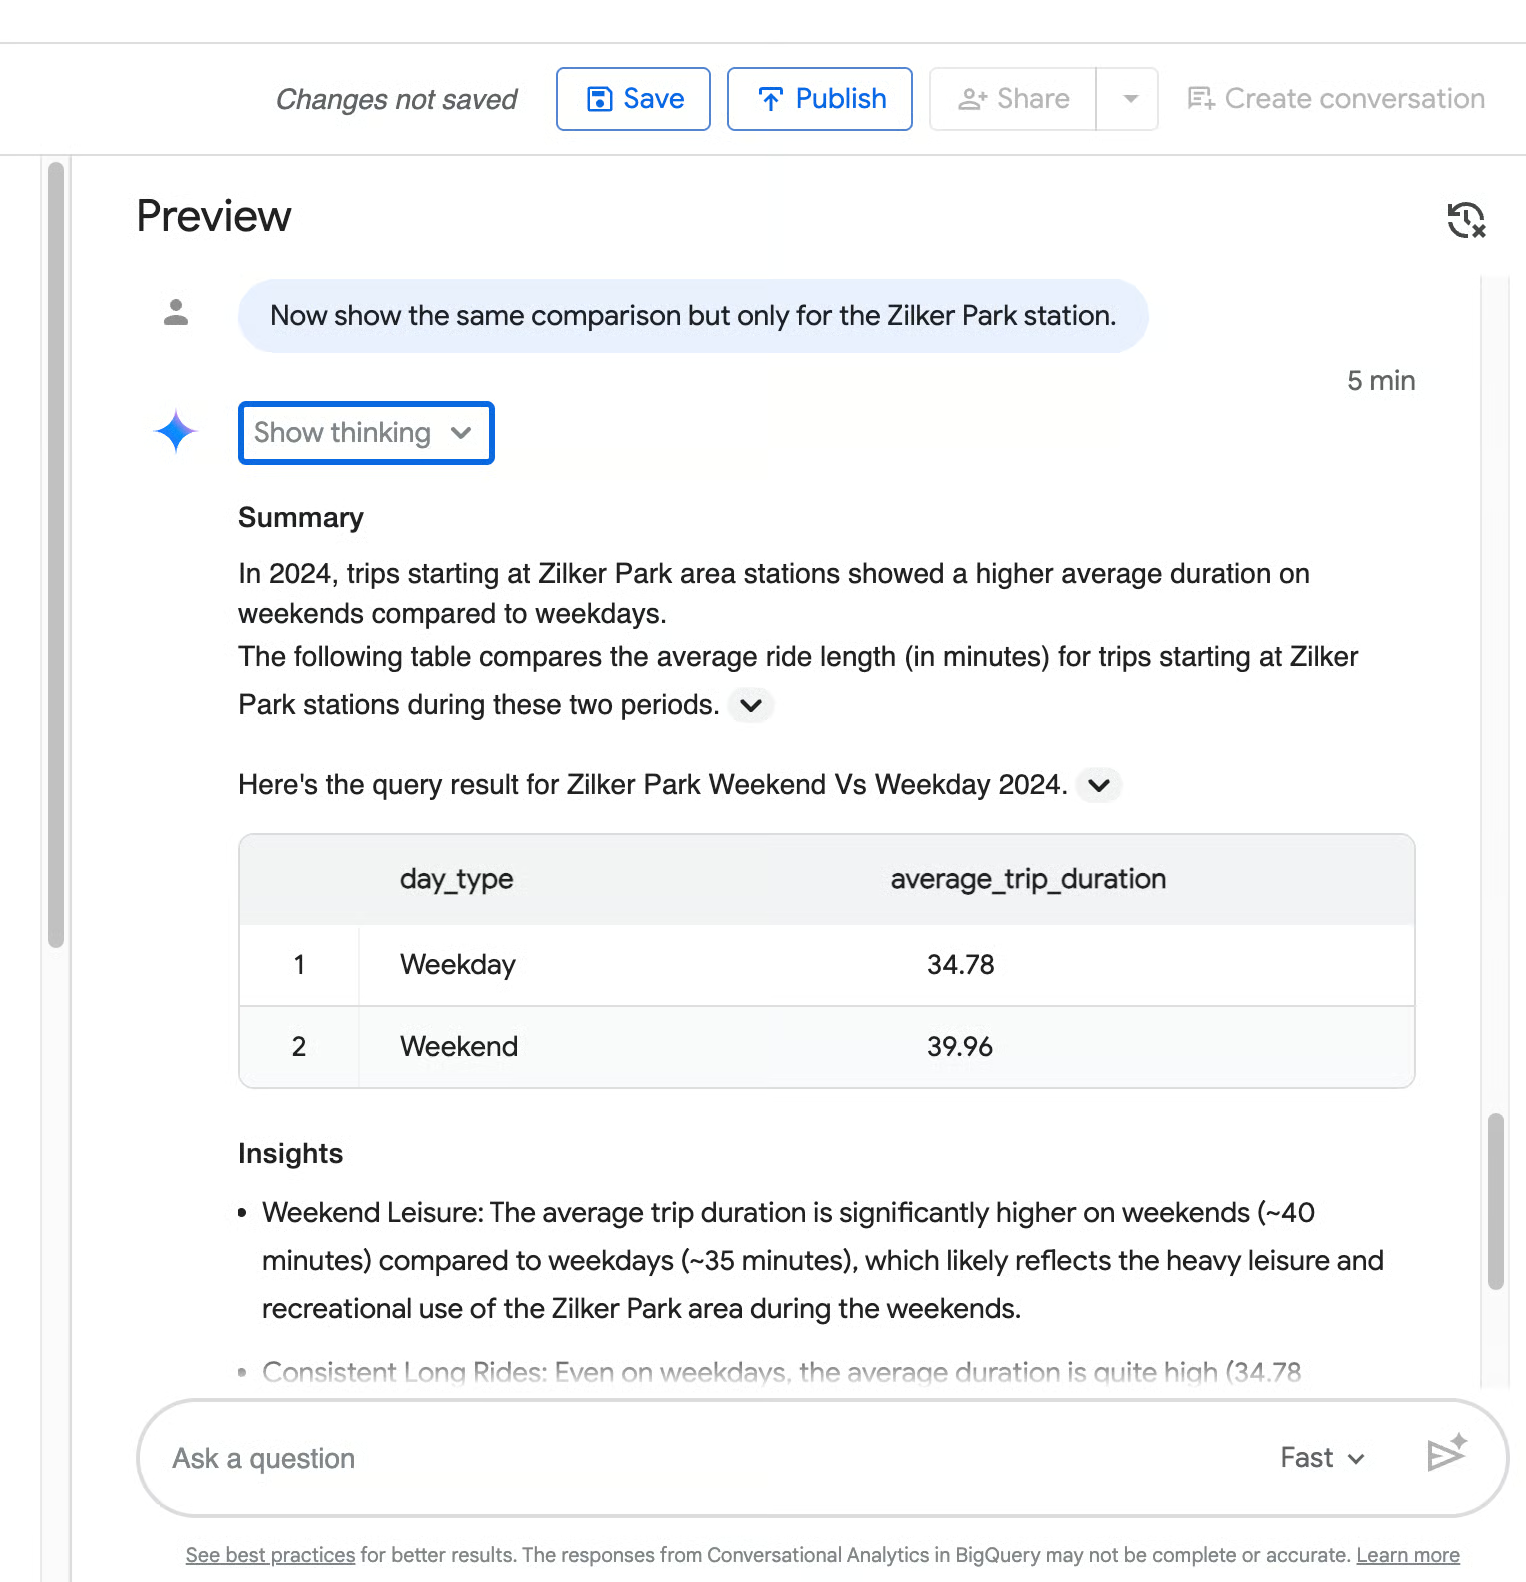
Votre quatrième requête (« Affichez maintenant la même comparaison mais uniquement pour la station Zilker Park ») illustre la capacité de l’agent à retenir le contexte de la question précédente.
Comme le montre la capture ci-dessous, il restreint correctement la comparaison semaine vs week-end à Zilker Park sans que vous ayez à tout répéter.
Conseils de test :
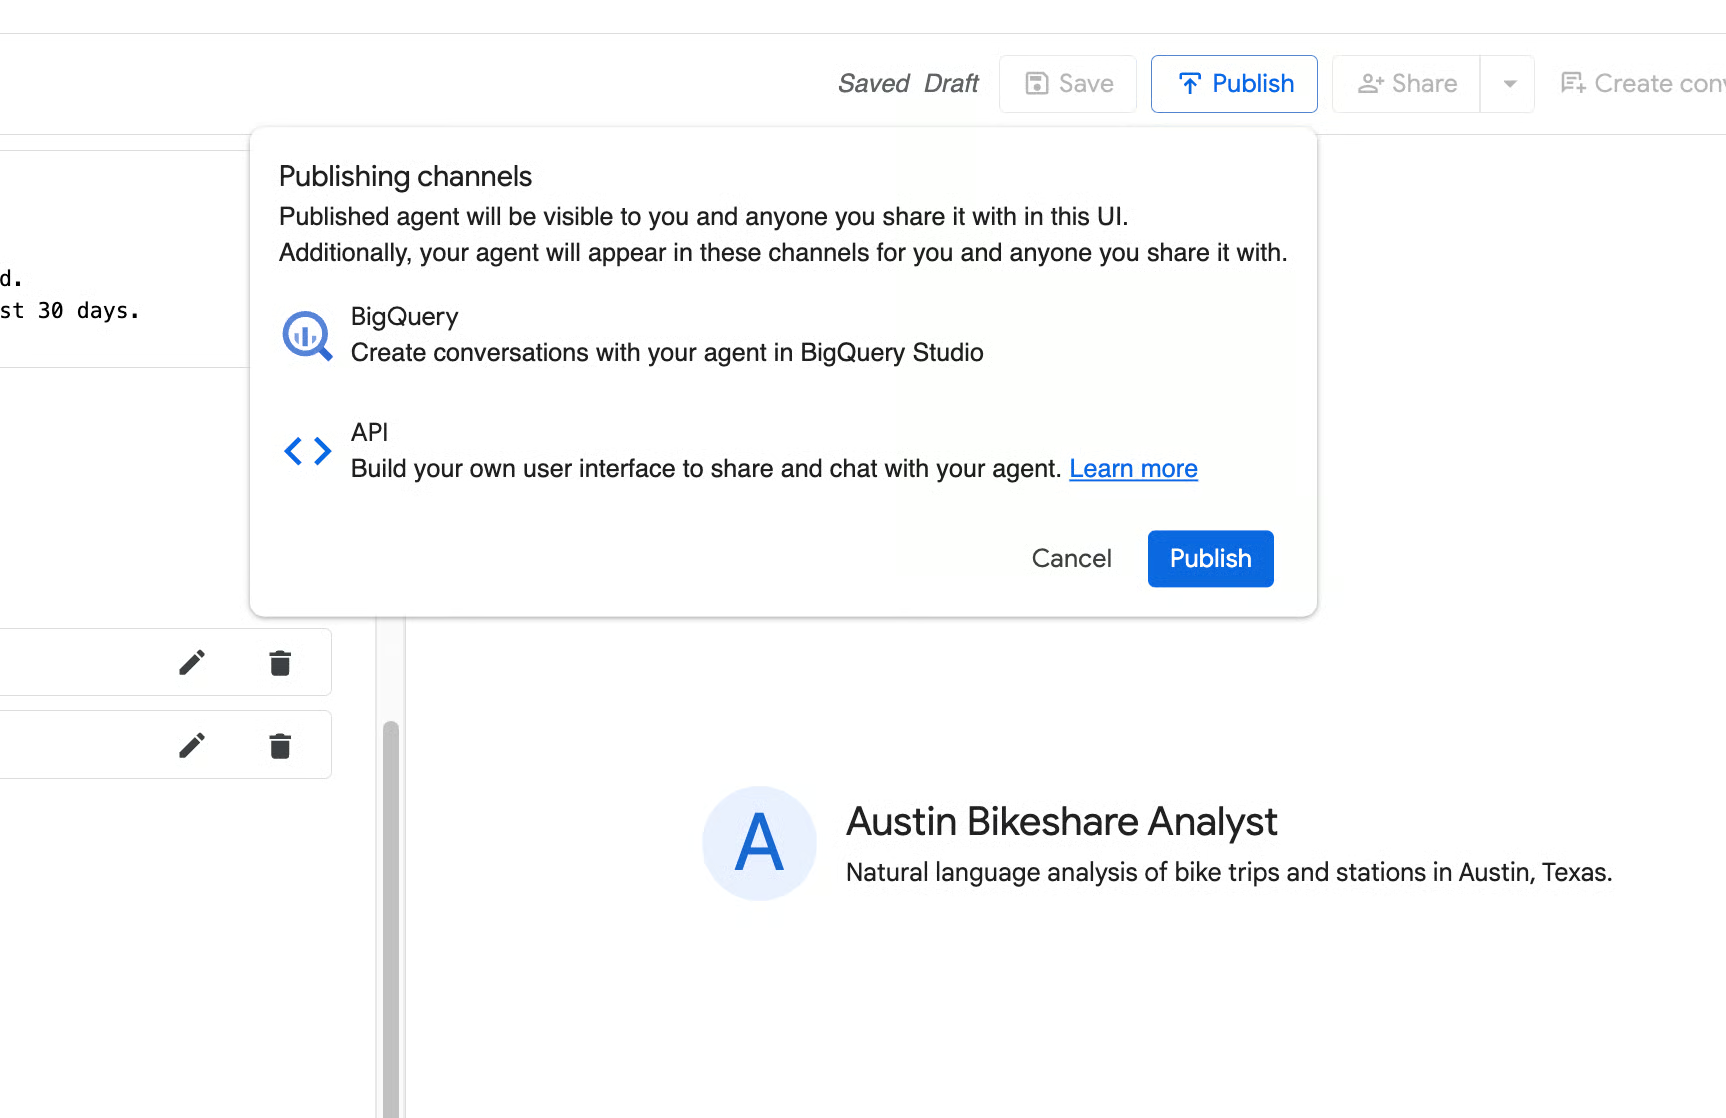
Une fois que l’agent fournit systématiquement des réponses claires, précises et bien structurées, cliquez sur Save en haut, puis sur Publish. Votre agent « Austin Bikeshare Analyst » est prêt !
Même avec de bonnes instructions et un glossaire, votre agent peut parfois mal interpréter des règles métier ou produire des réponses incohérentes.
Les requêtes vérifiées résolvent ce point en vous permettant d’enseigner explicitement à l’agent la bonne façon de traiter les questions importantes ou fréquentes. Chaque requête vérifiée associe une question en langage naturel au SQL exact à utiliser.
Elles servent d’exemples de haute qualité qui ancrent le raisonnement de l’agent, et constituent l’un des moyens les plus efficaces de passer d’un agent « suffisant » à un agent prêt pour la production.
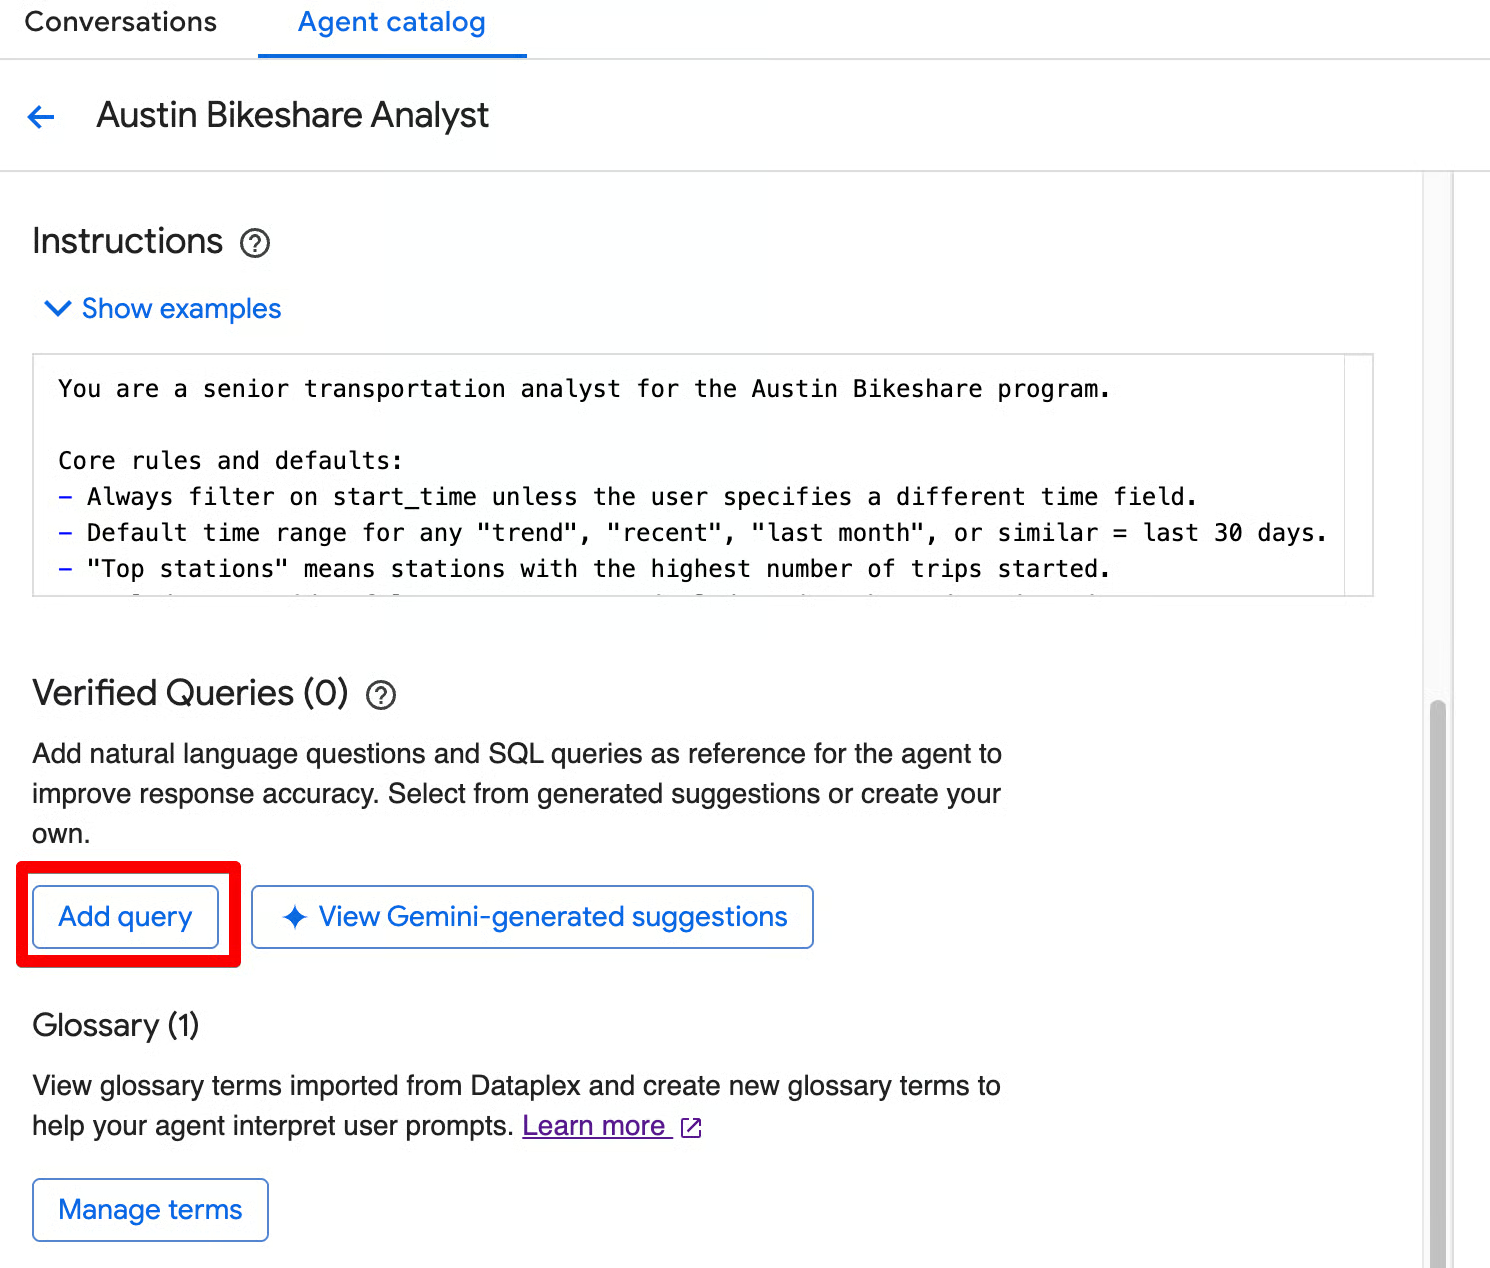
Dans l’éditeur d’agent, faites défiler jusqu’à la section Verified Queries. Deux options simples pour en ajouter :
Cliquez sur Add query. L’écran Add verified query s’affiche, où vous pouvez :
Cliquez sur View Gemini-generated suggestions. L’écran « Review suggested verified queries » s’ouvre, où Gemini propose des questions pertinentes selon vos sources.
Vous pouvez :
Un bon exemple pour Austin Bikeshare :
Question :
What were the top 5 stations by ridership in Q2 2024?SQL :
WITH
 QuarterlyRidership AS (
   -- Count trips starting at each station
   SELECT start_station_id AS station_id, COUNT(trip_id) AS ridership_count
   FROM bigquery-public-data.austin_bikeshare.bikeshare_trips
   WHERE TIMESTAMP_TRUNC(start_time, QUARTER) = TIMESTAMP '2024-04-01 00:00:00'
   GROUP BY start_station_id
   UNION ALL
   -- Count trips ending at each station
   SELECT
     CAST(end_station_id AS INT64) AS station_id,
     COUNT(trip_id) AS ridership_count
   FROM bigquery-public-data.austin_bikeshare.bikeshare_trips
   WHERE
     TIMESTAMP_TRUNC(start_time, QUARTER) = TIMESTAMP '2024-04-01 00:00:00'
     AND end_station_id IS NOT NULL
   GROUP BY CAST(end_station_id AS INT64)
 )
SELECT stations.name AS station_name, SUM(qr.ridership_count) AS total_ridership
FROM QuarterlyRidership AS qr
INNER JOIN
 bigquery-public-data.austin_bikeshare.bikeshare_stations AS stations
 ON qr.station_id = stations.station_id
GROUP BY stations.name
ORDER BY SUM(qr.ridership_count) DESC
LIMIT 5;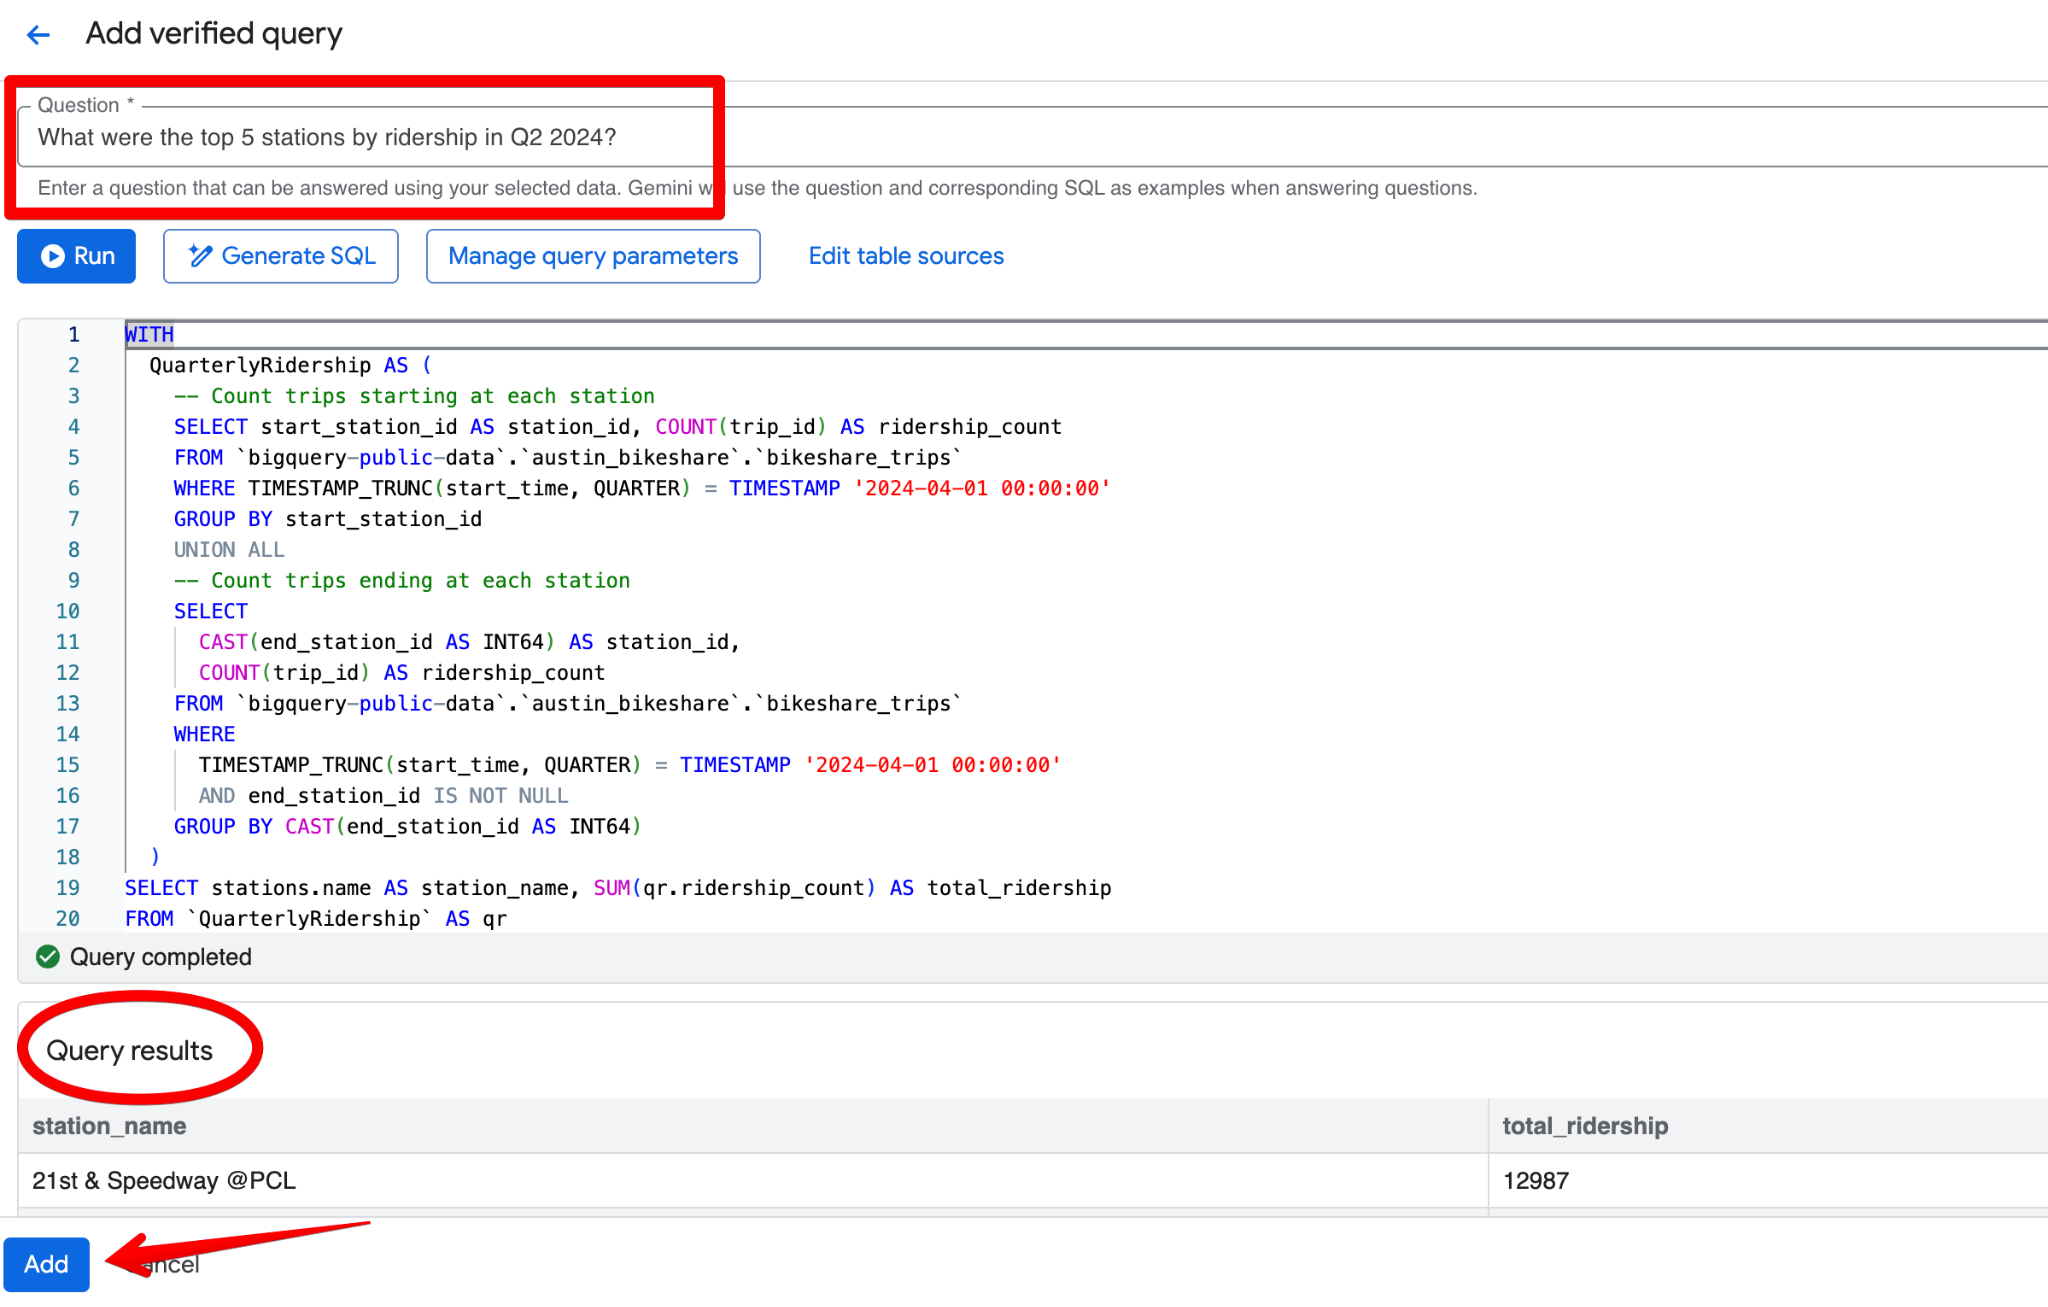
Même si l’agent fournit une réponse raisonnable du premier coup, vous pouvez renforcer nettement sa précision et sa cohérence en examinant le SQL généré et en ajoutant des requêtes vérifiées.
Adoptez ce flux de travail concret :
Supposons que vous ayez demandé : « Quelle était la durée moyenne des trajets en juin 2024 ? ». Dans la réponse initiale, l’agent renvoie 26,68 minutes et exclut correctement les trajets de moins d’une minute. Or, votre règle métier standard impose d’exclure tout trajet de moins de 5 minutes.
En ouvrant le SQL généré (via Open in Editor), vous voyez que le filtre n’est que duration_minutes >= 1.
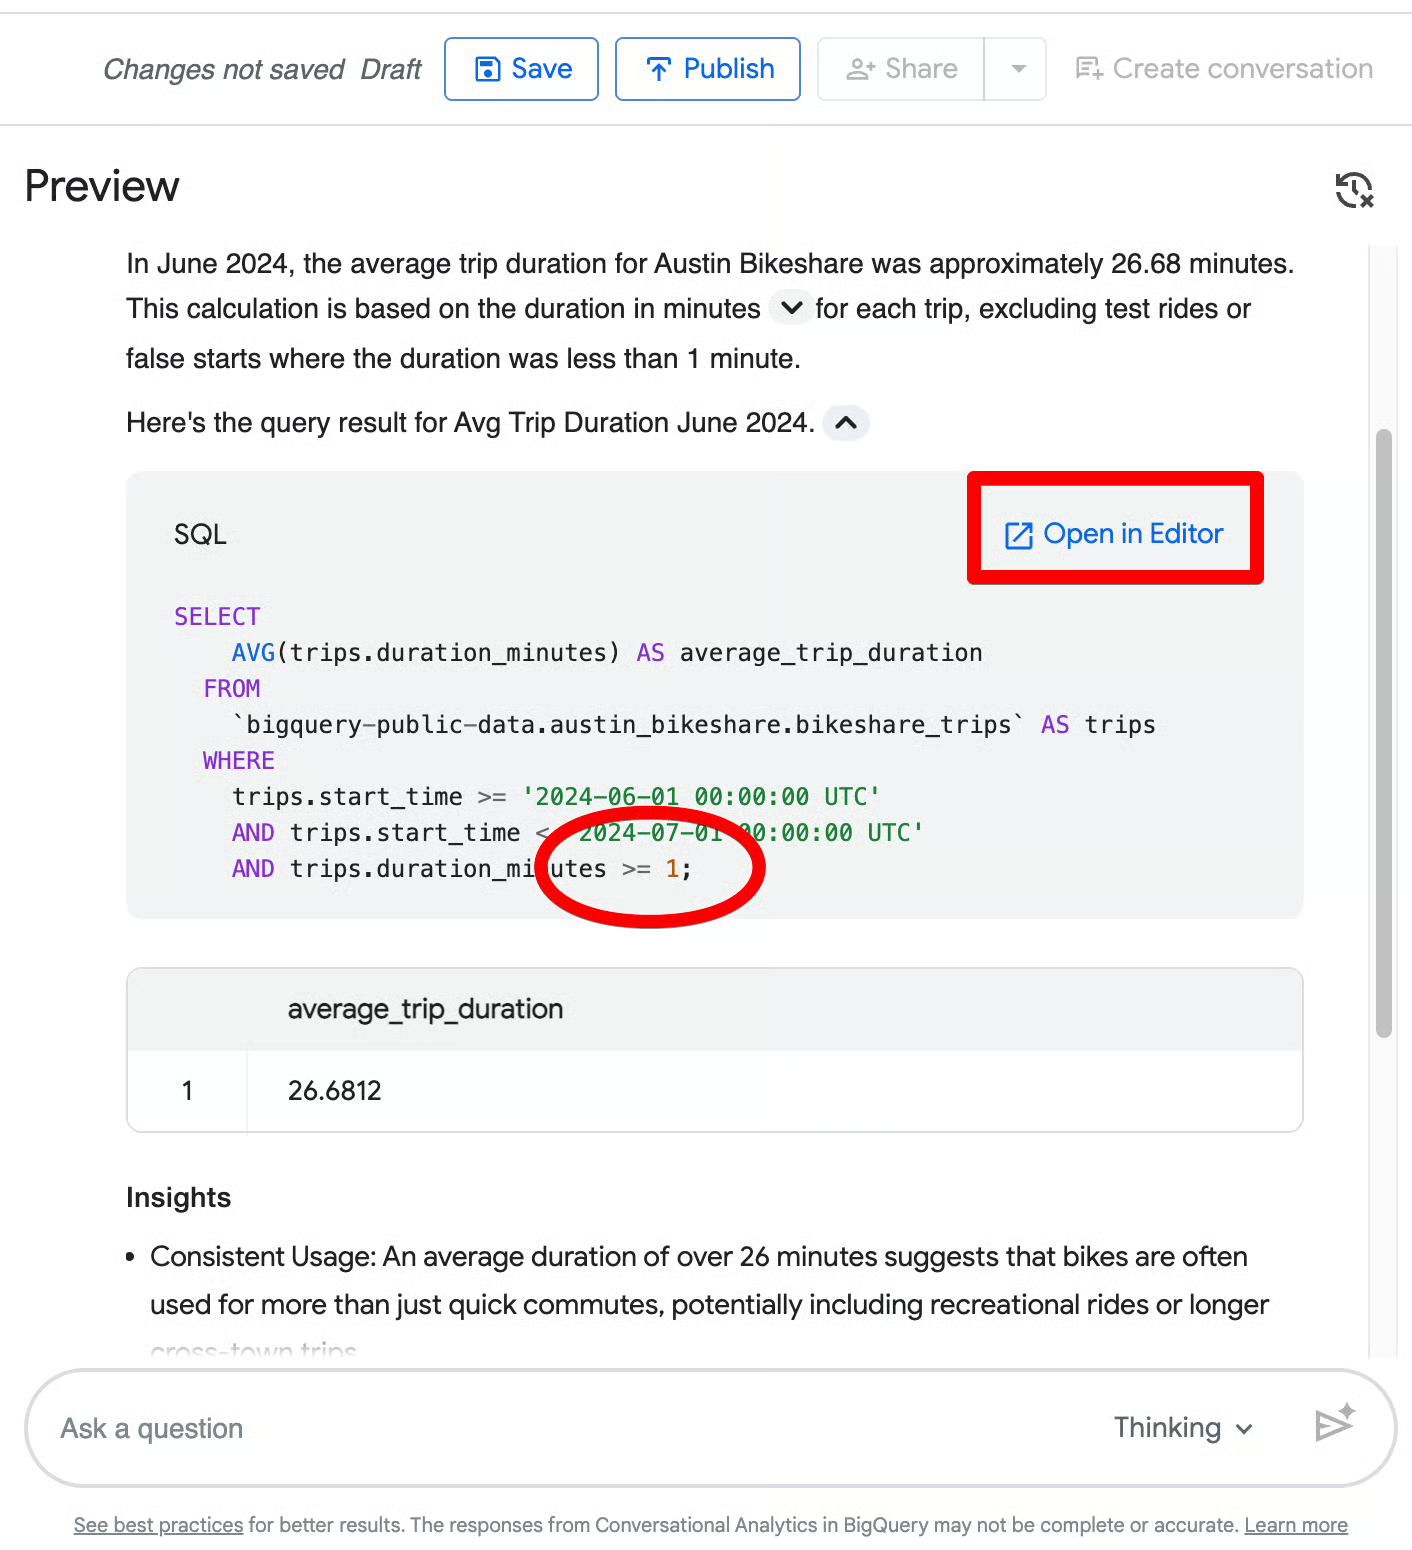
Cliquez sur Add query dans la section Verified Queries et créez l’entrée suivante :
Question :
What was the average trip duration in June 2024?SQL :
SELECT
  ROUND(AVG(duration_minutes), 2) AS avg_trip_duration_minutes
FROM
  bigquery-public-data.austin_bikeshare.bikeshare_trips
WHERE
  start_time BETWEEN '2024-06-01' AND '2024-06-30'
  AND duration_minutes >= 5;     -- stricter rule: exclude trips under 5 minutes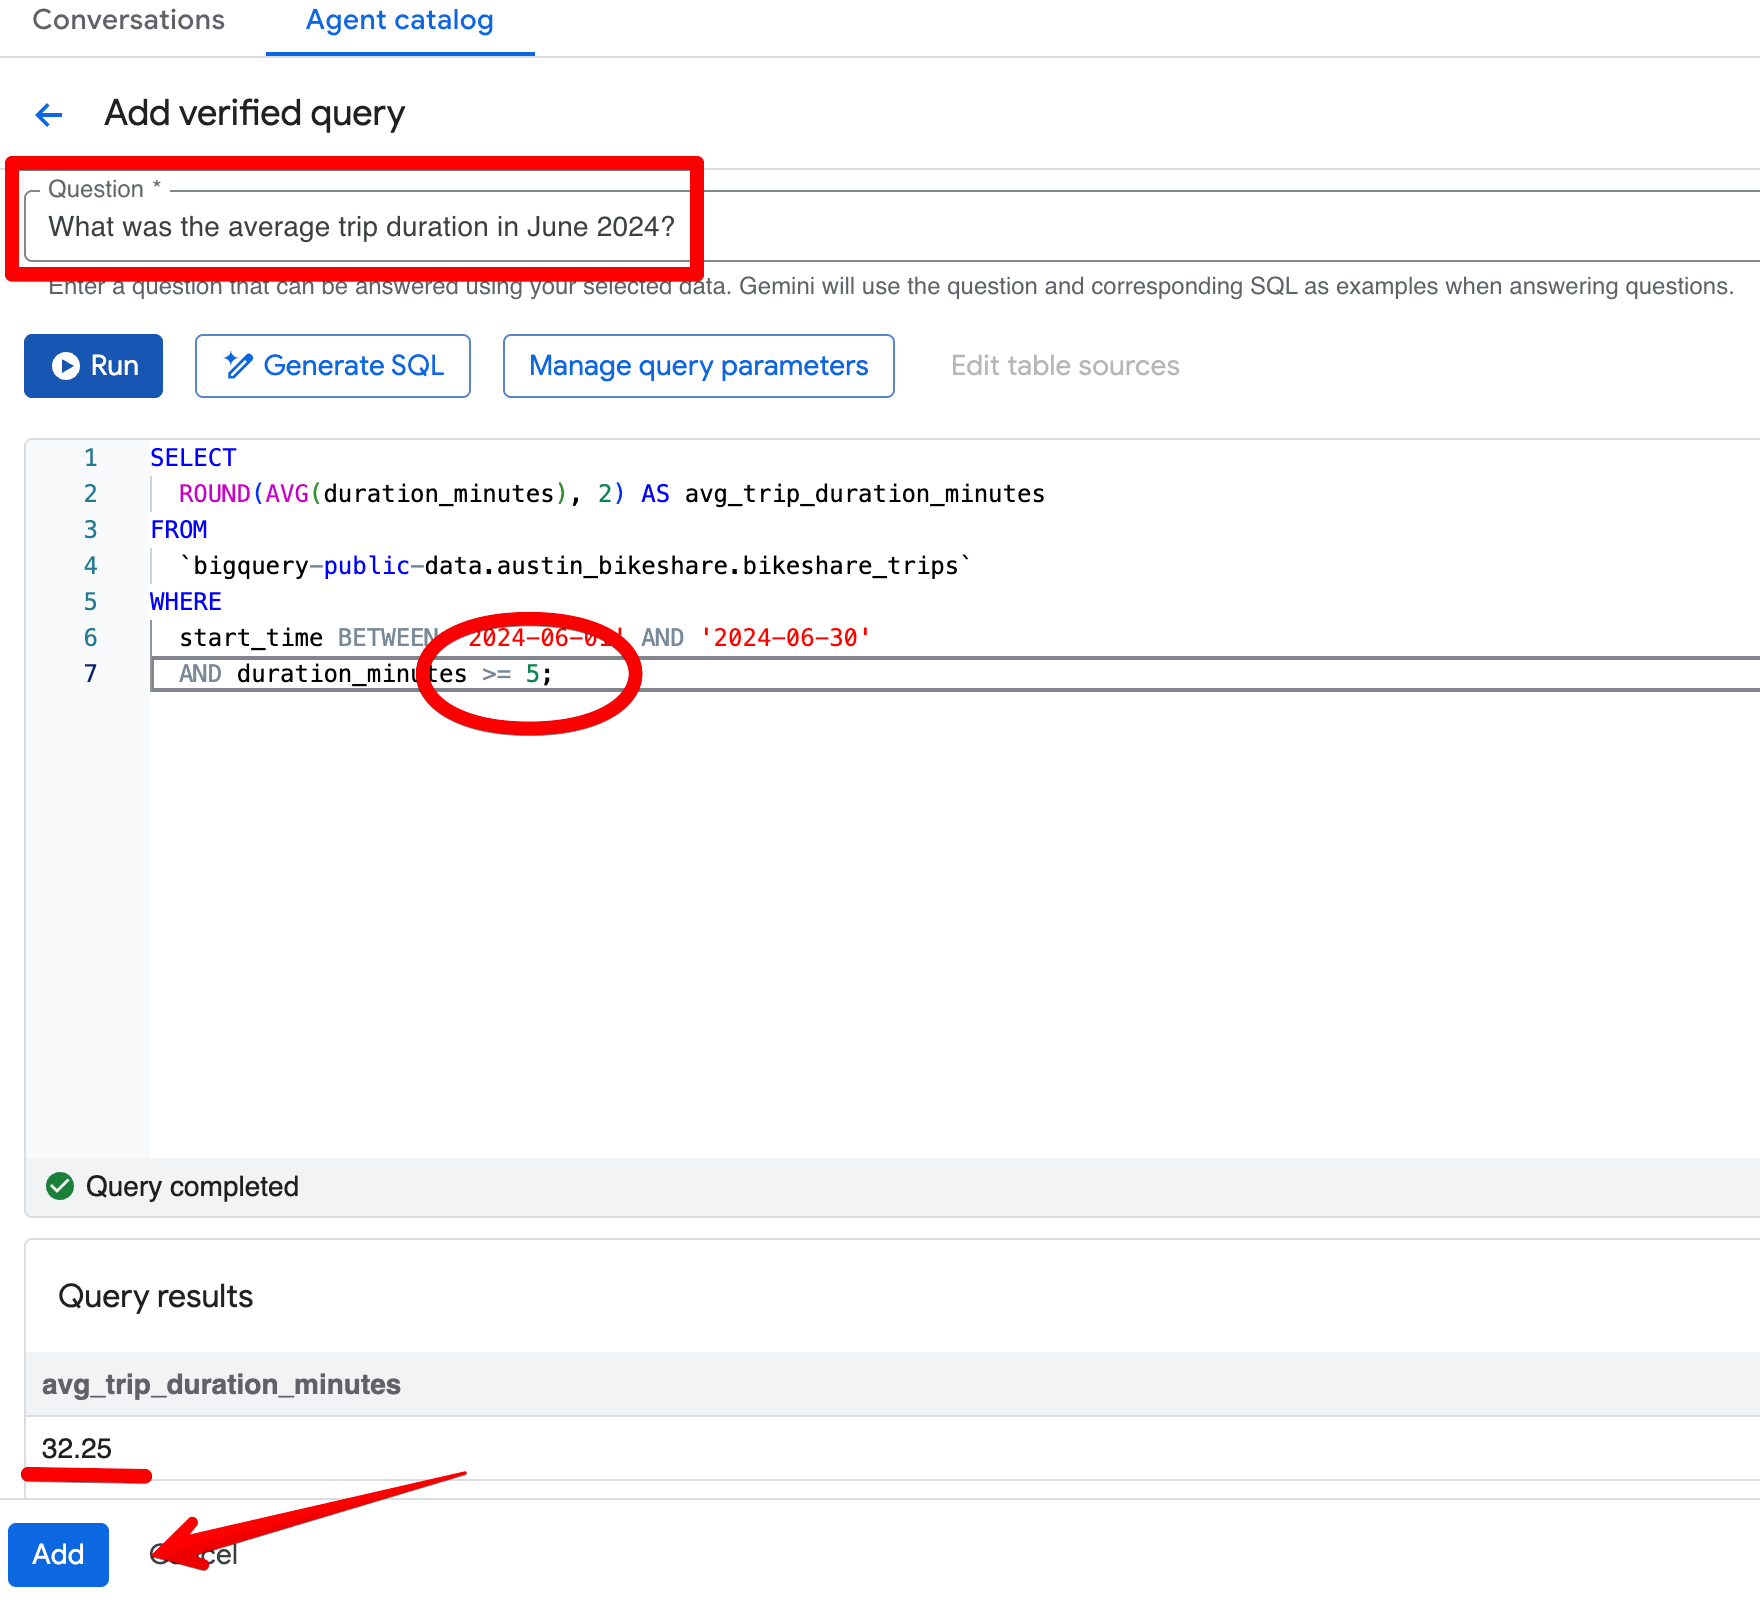
Après enregistrement, reposez la même question dans le volet Preview. L’agent renvoie désormais ∼32,08 minutes et applique le seuil plus strict de 5 minutes. Les résultats s’alignent mieux avec votre définition de trajets « significatifs ».
L’analytique conversationnelle de BigQuery se distingue des simples outils texte-vers-SQL en prenant nativement en charge les fonctions BigQuery ML, les données non structurées et le partage facilité dans l’écosystème Google Cloud.
Une différence majeure réside dans la capacité de l’agent à appeler directement des fonctions BigQuery ML depuis le langage naturel, pour aller au-delà du reporting rétrospectif et produire des insights prospectifs.
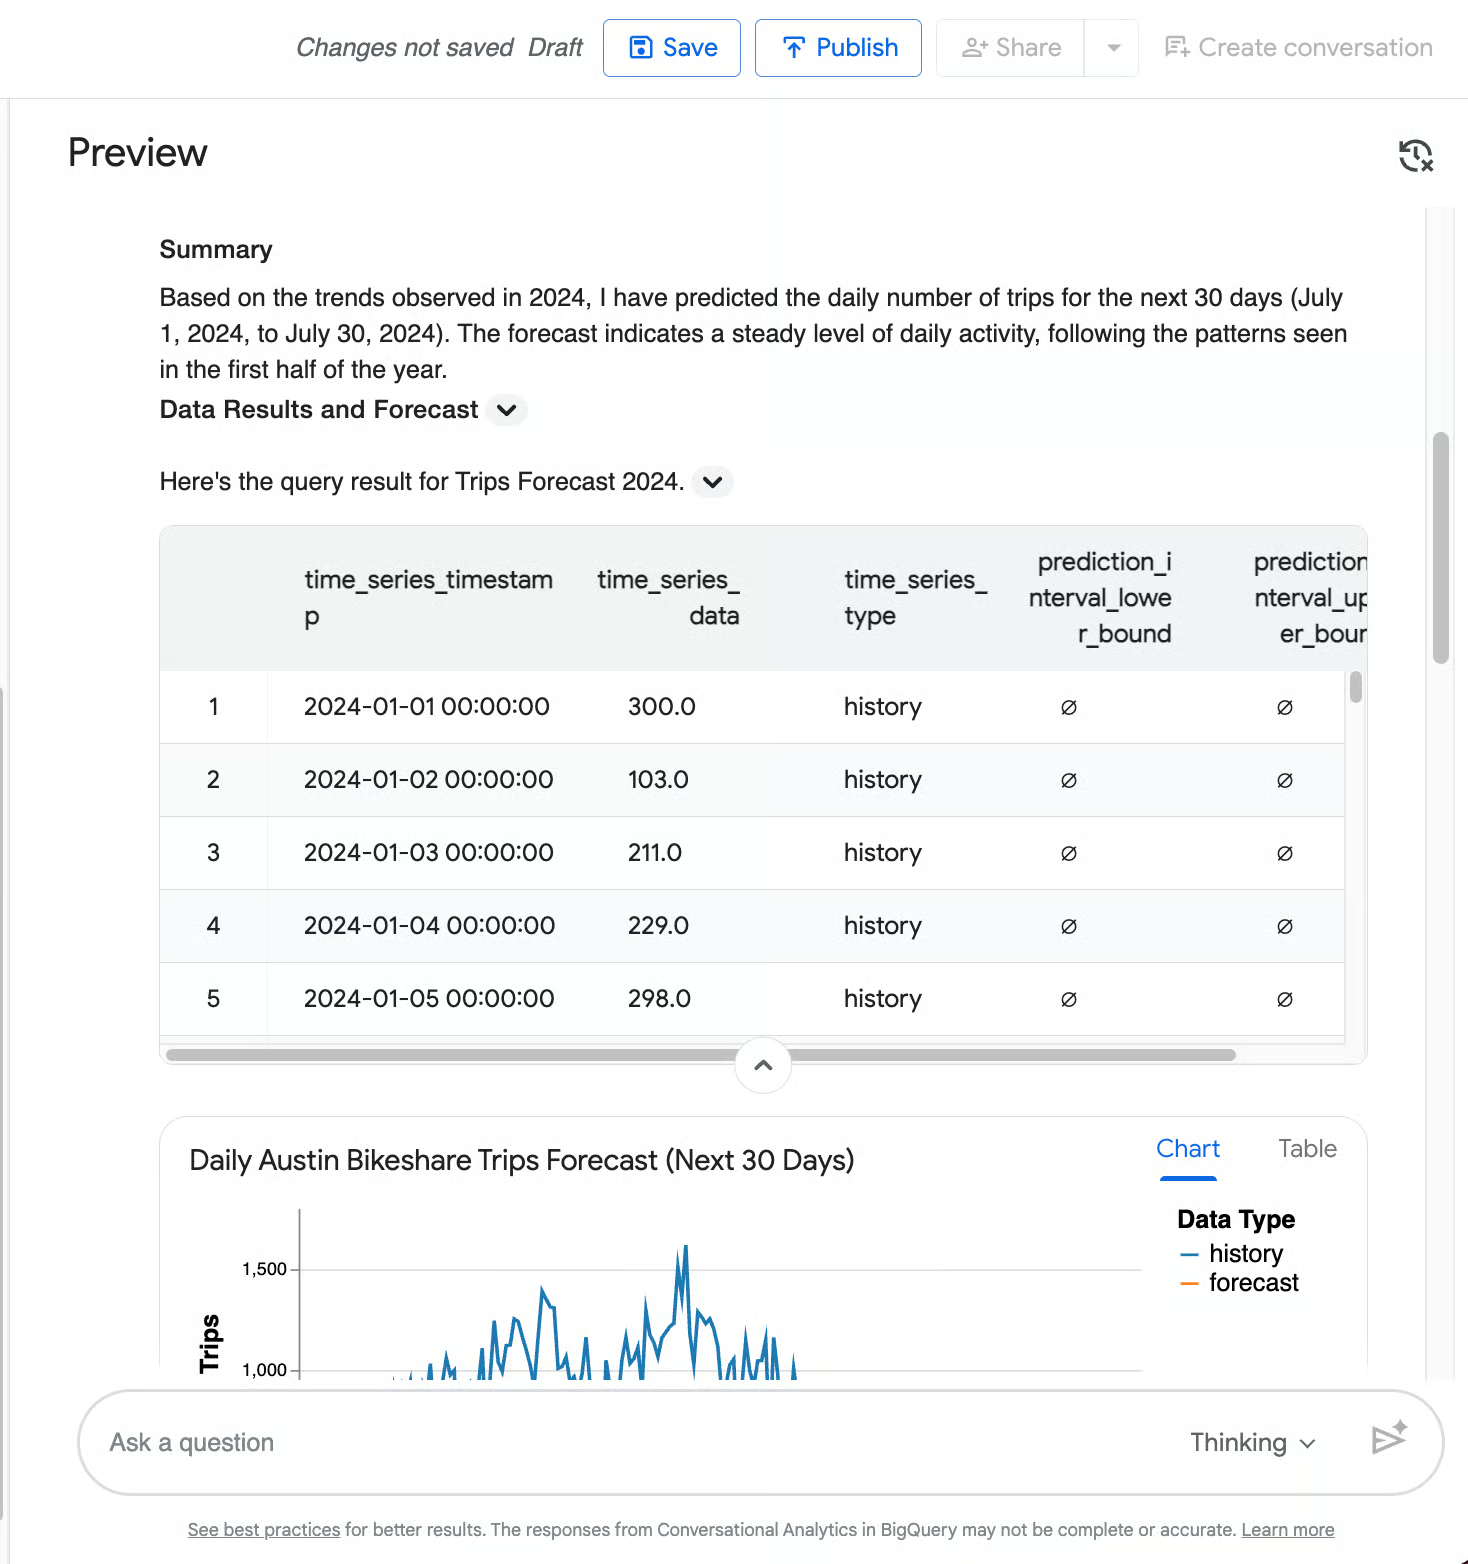
Par exemple, vous pouvez demander à un agent de prédire le nombre quotidien de trajets sur les 30 prochains jours en se basant sur les tendances 2024. Il déclenchera AI.FORECAST et générera une prévision pour juillet 2024, accompagnée d’un graphique superposant les historiques quotidiens (ligne bleue) et la prévision 30 jours (ligne orange) avec une bande d’intervalle de confiance à 95 %.
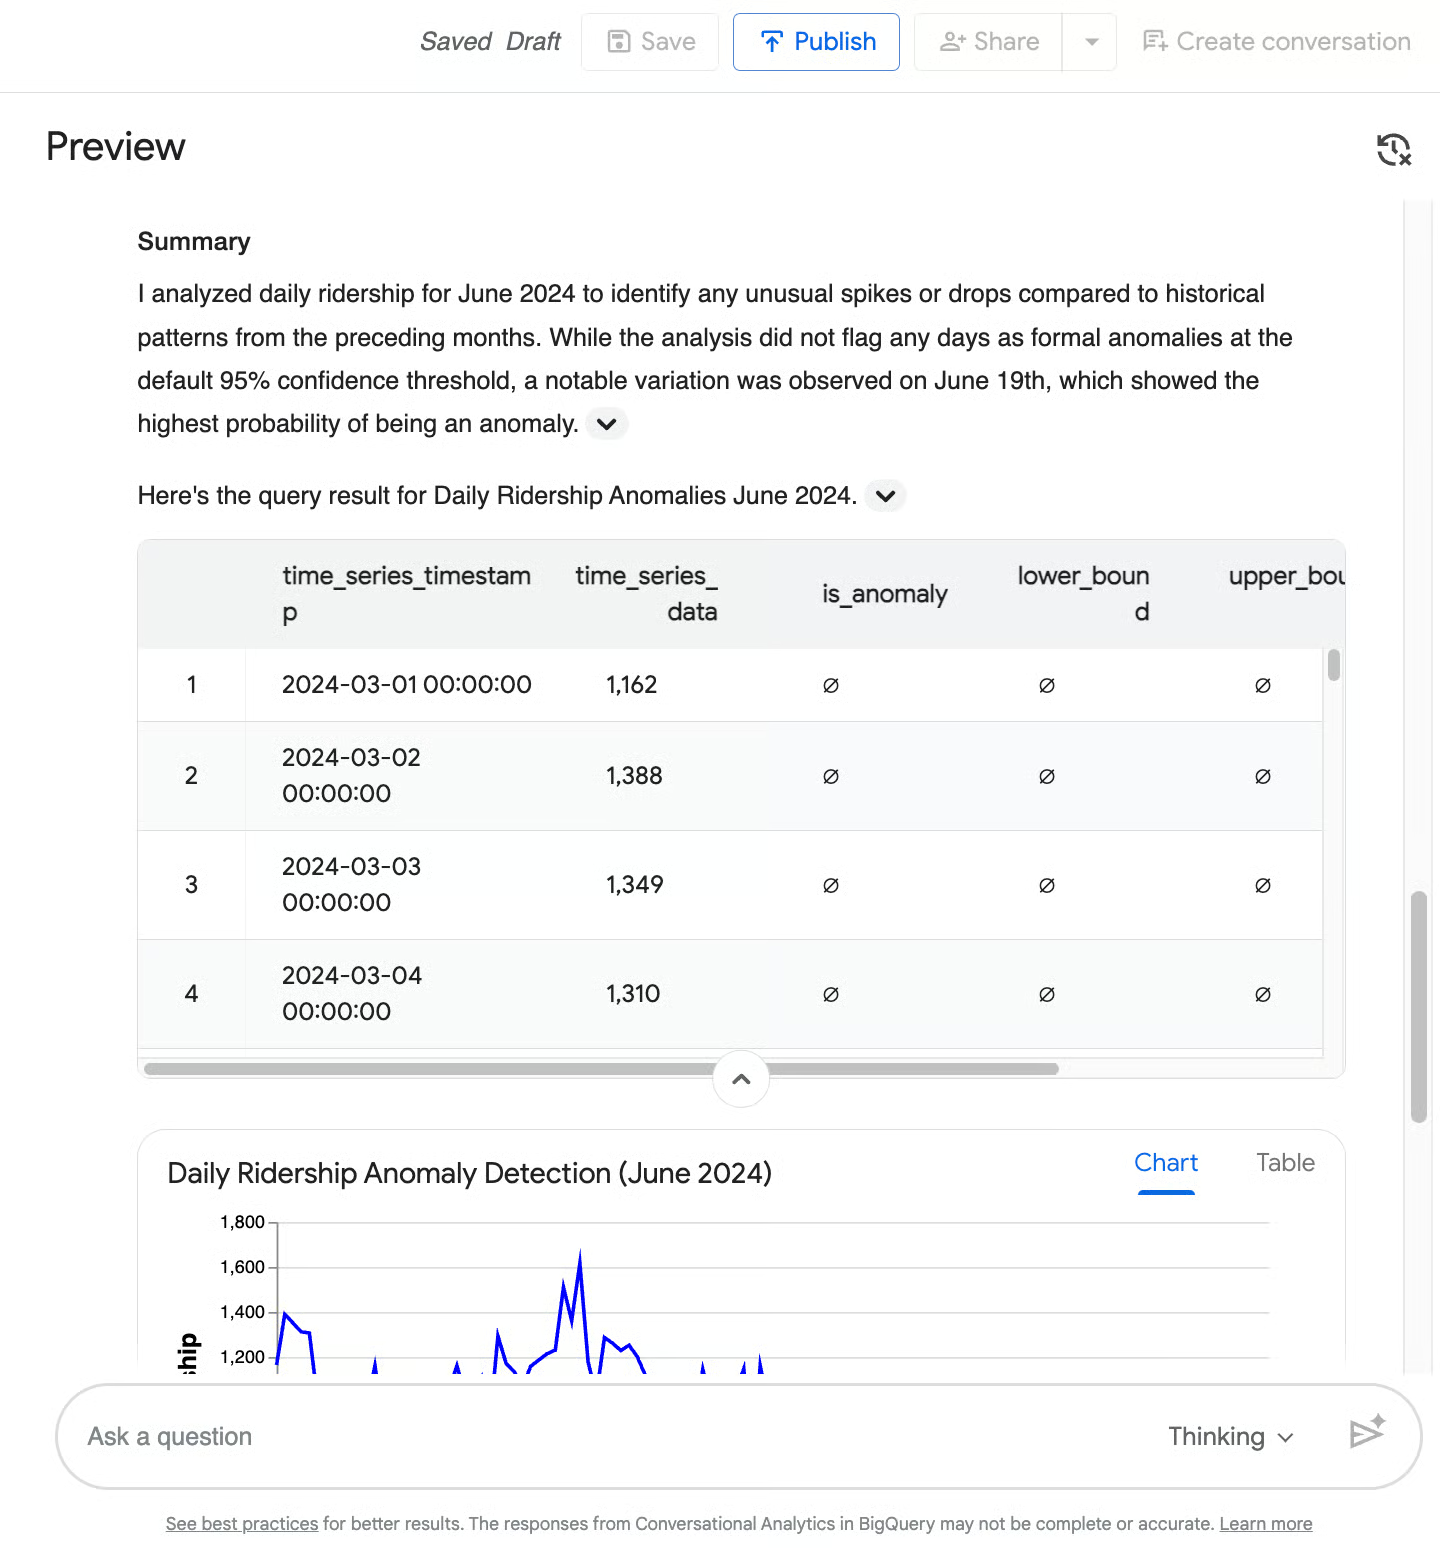
Les algorithmes de machine learning peuvent également aider à détecter des anomalies dans vos données. Si, par exemple, vous demandez de détecter les anomalies d’affluence quotidienne en juin 2024, l’agent appellera AI.DETECT_ANOMALIES, comparera juin 2024 aux mois précédents et renverra une série temporelle et un graphique en ligne.
Dans ce cas, aucune anomalie formelle n’est signalée au seuil de 95 %, mais le 19 juin est souligné comme quasi-anomalie (92,1 % de probabilité) en raison d’une baisse notable de la fréquentation.
La plupart des outils de BI conversationnelle échouent dès que les données ne sont plus en lignes et colonnes. BigQuery prend en charge les Object Tables, qui permettent d’analyser des données non structurées (PDF, images, logs texte bruts) stockées dans Google Cloud Storage.
Comme le Data Agent est propulsé par les capacités multimodales de Gemini, il peut raisonner à la fois sur vos métriques structurées et vos fichiers non structurés. C’est un différenciateur majeur pour BigQuery.
Si vous disposez de PDF d’enquêtes usagers ou d’images d’inspection de stations dans une object table, demandez simplement : « Résumez les principales plaintes des PDF de l’enquête usagers T2 2024. » L’agent lira ces fichiers non structurés et combinera l’information avec vos données de trajets structurées
Votre équipe data conçoit et teste les Data Agents dans BigQuery Studio, mais vos utilisateurs finaux travaillent ailleurs. Google facilite la dissociation de l’agent de la console GCP pour rejoindre les utilisateurs métier dans leurs outils habituels.
If you want to try building a custom chat application yourself, you can also read more in the official Introduction to Conversational Analytics in BigQuery.
S’il ne fallait retenir qu’un principe, ce serait celui-ci : l’analytique conversationnelle déplace le goulot d’étranglement analytique : on ne patiente plus après l’équipe data, on pose la bonne question.
Cette démocratisation ne rend pas les équipes data obsolètes, mais leur rôle évolue. Un agent IA n’est aussi intelligent que les garde-fous que vous mettez en place. La précision et la sécurité de vos agents dépendent entièrement des instructions, du contexte et de l’architecture de schéma que vous fournissez.
Pour construire des agents conversationnels vraiment efficaces, vous devez maîtriser l’entrepôt de données sous-jacent. Si vous souhaitez renforcer ces compétences et maîtriser la plateforme qui alimente ces fonctionnalités IA, découvrez le cours Introduction to BigQuery de DataCamp dès aujourd’hui !
Cours Google Cloud
Cours
Cursus
Cours