
कोर्स
BigQuery परिचय
4 घंटा
13K
यदि आप किसी डेटा टीम में काम करते हैं, तो यह परिदृश्य परिचित लगेगा: आपका बैकलॉग ऐड-हॉक अनुरोधों से भरा हुआ है। बिजनेस यूज़र्स को मौजूदा रिपोर्टों के साधारण रूपांतर चाहिए होते हैं—जैसे, "क्या आप इसे प्रोडक्ट कैटेगरी के अनुसार समूहित कर सकते हैं?" या "यह पिछले महीने की तुलना में कैसा है?" जब तक वे उत्तर के लिए कतार में इंतज़ार करते हैं, आपके डेटा इंजीनियर और विश्लेषक दोहराए जाने वाले SQL कार्यों में उलझे रहते हैं।
BigQuery में Conversational Analytics के साथ, आप अंततः यह बाधा बदल सकते हैं। यह सुविधा AI-संचालित रीज़निंग इंजन को सीधे BigQuery Studio में लाती है, जिससे यूज़र्स प्राकृतिक भाषा में प्रश्न पूछ सकते हैं और तुरंत डेटा, चार्ट और जेनरेटेड SQL प्राप्त कर सकते हैं।
इस गाइड में, आप BigQuery में संवादी एनालिटिक्स को सेट अप और उपयोग करना सीखेंगे। आप अपने स्वयं के डेटा एजेंट बनाएँगे, कॉन्फ़िगर करेंगे और परिष्कृत करेंगे, ताकि आपका संगठन सुरक्षित रूप से अपने डेटा से चैट कर सके।
संवादी एनालिटिक्स डेटा इंटरैक्शन को मैन्युअल SQL क्वेरी से प्राकृतिक भाषा वार्तालाप में बदल देता है। SELECT स्टेटमेंट लिखने के बजाय, आप एक डेटा एजेंट के साथ चैट करते हैं जो आपके बिजनेस संदर्भ को समझता है और आपके वास्तविक टेबलों के आधार पर उत्तर लौटाता है।
यह केवल एक साधारण टेक्स्ट-टू-SQL पार्सर नहीं है; यह वास्तविक अर्थों में डेटा लोकतंत्रीकरण की ओर एक बड़ा कदम है।
यह गैर-तकनीकी यूज़र्स को स्वतंत्र रूप से रियल-टाइम इनसाइट्स तक पहुँचने देता है, और डेटा प्रोफेशनल्स को डेटासेट एक्सप्लोर करने और रिपोर्टिंग को स्वचालित करने का तेज़ तरीका देता है।
BigQuery के संवादी एनालिटिक्स के केंद्र में Gemini मॉडल परिवार द्वारा संचालित एक रीज़निंग इंजन है। डेटा एजेंट इस बात को सुनिश्चित करने के लिए एक संरचित, बहु-चरण पाइपलाइन का उपयोग करते हैं कि इनसाइट्स आपके विशेष डेटा संदर्भ पर आधारित हों:
Google Cloud आपके डेटा स्टैक की विभिन्न परतों में संवादी एनालिटिक्स प्रदान करता है। सही एंट्री पॉइंट चुनना आपके यूज़र्स और आपके बिजनेस लॉजिक के स्थान पर निर्भर करता है:
|
फ़ीचर |
BigQuery Conversational Analytics |
Looker Conversational Analytics |
Data Studio (BigQuery Agents के माध्यम से) |
|
सबसे उपयुक्त |
डेटा टीम, विश्लेषक, और कस्टम एप्लिकेशन बनाने वाले डेवलपर्स |
बिजनेस यूज़र्स जिन्हें गवर्न्ड, डैशबोर्ड-रेडी इनसाइट्स चाहिए |
बिजनेस यूज़र्स जो हल्की-फुल्की BI रिपोर्टिंग पसंद करते हैं |
|
ग्राउंडिंग विधि |
डायरेक्ट वेयरहाउस स्कीमा, टेबल मेटाडेटा और सत्यापित क्वेरी |
LookML (सेमांटिक लेयर) |
प्री-बिल्ट BigQuery डेटा एजेंट्स से सीधे कनेक्टेड |
|
डेटा एक्सेस |
स्ट्रक्चर्ड, प्रेडिक्टिव (ML) और अनस्ट्रक्चर्ड डेटा का विश्लेषण कर सकता है |
सख्ती से संरचित, मॉडल्ड डेटा |
स्ट्रक्चर्ड डेटा |
|
रिलीज़ स्थिति |
प्रीव्यू (मई 2026 तक) |
आम तौर पर उपलब्ध |
प्रीव्यू |
आप कौन-सा मार्ग चुनें?
यह ट्यूटोरियल डेटा टीमों के लिए BigQuery पर केंद्रित है—जहाँ डेटा रहता है—वहीं सीधे एजेंट्स का प्रोटोटाइप बनाने और प्रोडक्शन में लाने का सबसे तेज़ तरीका।
सेटअप से पहले किसी डेटा एजेंट की आर्किटेक्चर समझना महत्वपूर्ण है। Google Cloud वातावरण में, डेटा एजेंट केंद्रीय एब्स्ट्रैक्शन लेयर है। यह BigQuery एसेट्स को Gemini मॉडल परिवार की रीज़निंग क्षमताओं के साथ जोड़ता है।
कच्ची टेबलों को सीधे उजागर करने के बजाय, डेटा एजेंट वह सब कॉन्फ़िगर करता है जिसकी मॉडल को प्रश्नों की व्याख्या करने, सुरक्षित SQL जनरेट करने और विश्वसनीय उत्तर लौटाने के लिए आवश्यकता होती है। डेटा सोर्स, निर्देशों और सत्यापित लॉजिक का यह संयोजन BigQuery के संवादी एनालिटिक्स को मानक टेक्स्ट-टू-SQL टूल्स से अधिक भरोसेमंद बनाता है।
नॉलेज सोर्स किसी भी डेटा एजेंट की बुनियादी परत है। ये परिभाषित करते हैं कि एजेंट को किस डेटा तक पहुँचने और क्वेरी करने की अनुमति है।
एसेट प्रकार: Tables, Views और User Defined Functions (UDFs) नॉलेज सोर्स के रूप में कनेक्ट हो सकते हैं।
स्केलेबिलिटी: कई नॉलेज सोर्स एक ही एजेंट से कनेक्ट हो सकते हैं। इससे एजेंट अलग-अलग बिजनेस क्षेत्रों में जानकारी को जोड़ सकता है।
एक्सेस नियंत्रण: विशिष्ट नॉलेज सोर्स परिभाषित करने से सुनिश्चित होता है कि एजेंट केवल अधिकृत डेटा के भीतर काम करे।
किसी एजेंट की बुद्धिमत्ता दिए गए संदर्भ पर निर्भर करती है। यही एक सामान्य मॉडल को किसी कंपनी की भाषा समझाने की कुंजी है।
कस्टम निर्देश, सिनोनिम्स और बिजनेस ग्लॉसरीज़ परिभाषित करके एजेंट को किसी विशिष्ट डोमेन में ग्राउंड किया जाता है। उदाहरण के लिए, एजेंट को सिखाया जा सकता है कि "Top Customers" वे यूज़र हैं जिनका लाइफटाइम वैल्यू (LTV) $1,000 से अधिक है।
मुख्य ग्राउंडिंग तत्व:
कस्टम निर्देश: उच्च-स्तरीय निर्देश दें, जैसे "रेवेन्यू रिपोर्ट्स से हमेशा आंतरिक टेस्ट अकाउंट्स को बाहर रखें।"
बिजनेस ग्लॉसरीज़: तकनीकी शर्तों को प्राकृतिक भाषा से मैप करें, जैसे store_id को "Branch Location"।
फ़ील्ड मेटाडेटा: ऐसे विवरण जो एजेंट को विशिष्ट वेरिएबल्स की बारीकियाँ समझने में मदद करें, जैसे "Gross Revenue" बनाम "Net Profit"।
आपके निर्देश और मेटाडेटा जितने बेहतर होंगे, एजेंट की शुद्धता उतनी ही अधिक होगी।
Verified queries, जिन्हें पहले Golden Queries कहा जाता था, पूर्व-परिभाषित प्रश्न-उत्तर जोड़े होते हैं जो स्रोत-सत्य के रूप में काम करते हैं। विशिष्ट प्रश्नों को विशेषज्ञ-वेटेड SQL से मैप करके, एजेंट महत्वपूर्ण KPI के लिए सही जॉइन पाथ और फ़िल्टर का उपयोग करता है।
इन क्वेरियों में BigQuery ML (BQML) फ़ंक्शंस शामिल हो सकते हैं। इससे एजेंट चर्न प्रिडिक्शन या सेल्स फोरकास्ट जैसी उन्नत रिक्वेस्ट्स संभाल सकता है, वह भी डेटा साइंटिस्ट्स द्वारा परिभाषित सटीक मॉडल पैरामीटर्स का उपयोग करके। एक बार सत्यापित होने पर, ये एसेट्स Dataplex Universal Catalog के माध्यम से मैनेज होते हैं, जिससे संगठन भर में सुसंगतता बनी रहती है।
अब जबकि आप बिल्डिंग ब्लॉक्स समझ चुके हैं, आइए अपना पहला डेटा एजेंट वास्तव में बनाना और कॉन्फ़िगर करना शुरू करें।
हमारे ट्यूटोरियल के साथ आगे बढ़ने के लिए, कृपया सुनिश्चित करें कि आपके पास निम्नलिखित पूर्वापेक्षाएँ हैं:
अपना पहला एजेंट बनाने से पहले, आपको अपना Google Cloud प्रोजेक्ट कॉन्फ़िगर करना होगा और सुनिश्चित करना होगा कि आपके यूज़र अकाउंट के पास आवश्यक अनुमतियाँ हैं। डेटा एजेंट आपके मौजूदा डेटा के ऊपर एक लेयर के रूप में काम करते हैं, इसलिए सही IAM (Identity and Access Management) कॉन्फ़िगरेशन सुरक्षा और कार्यक्षमता दोनों के लिए महत्वपूर्ण है।
इन चरणों का पालन करें:
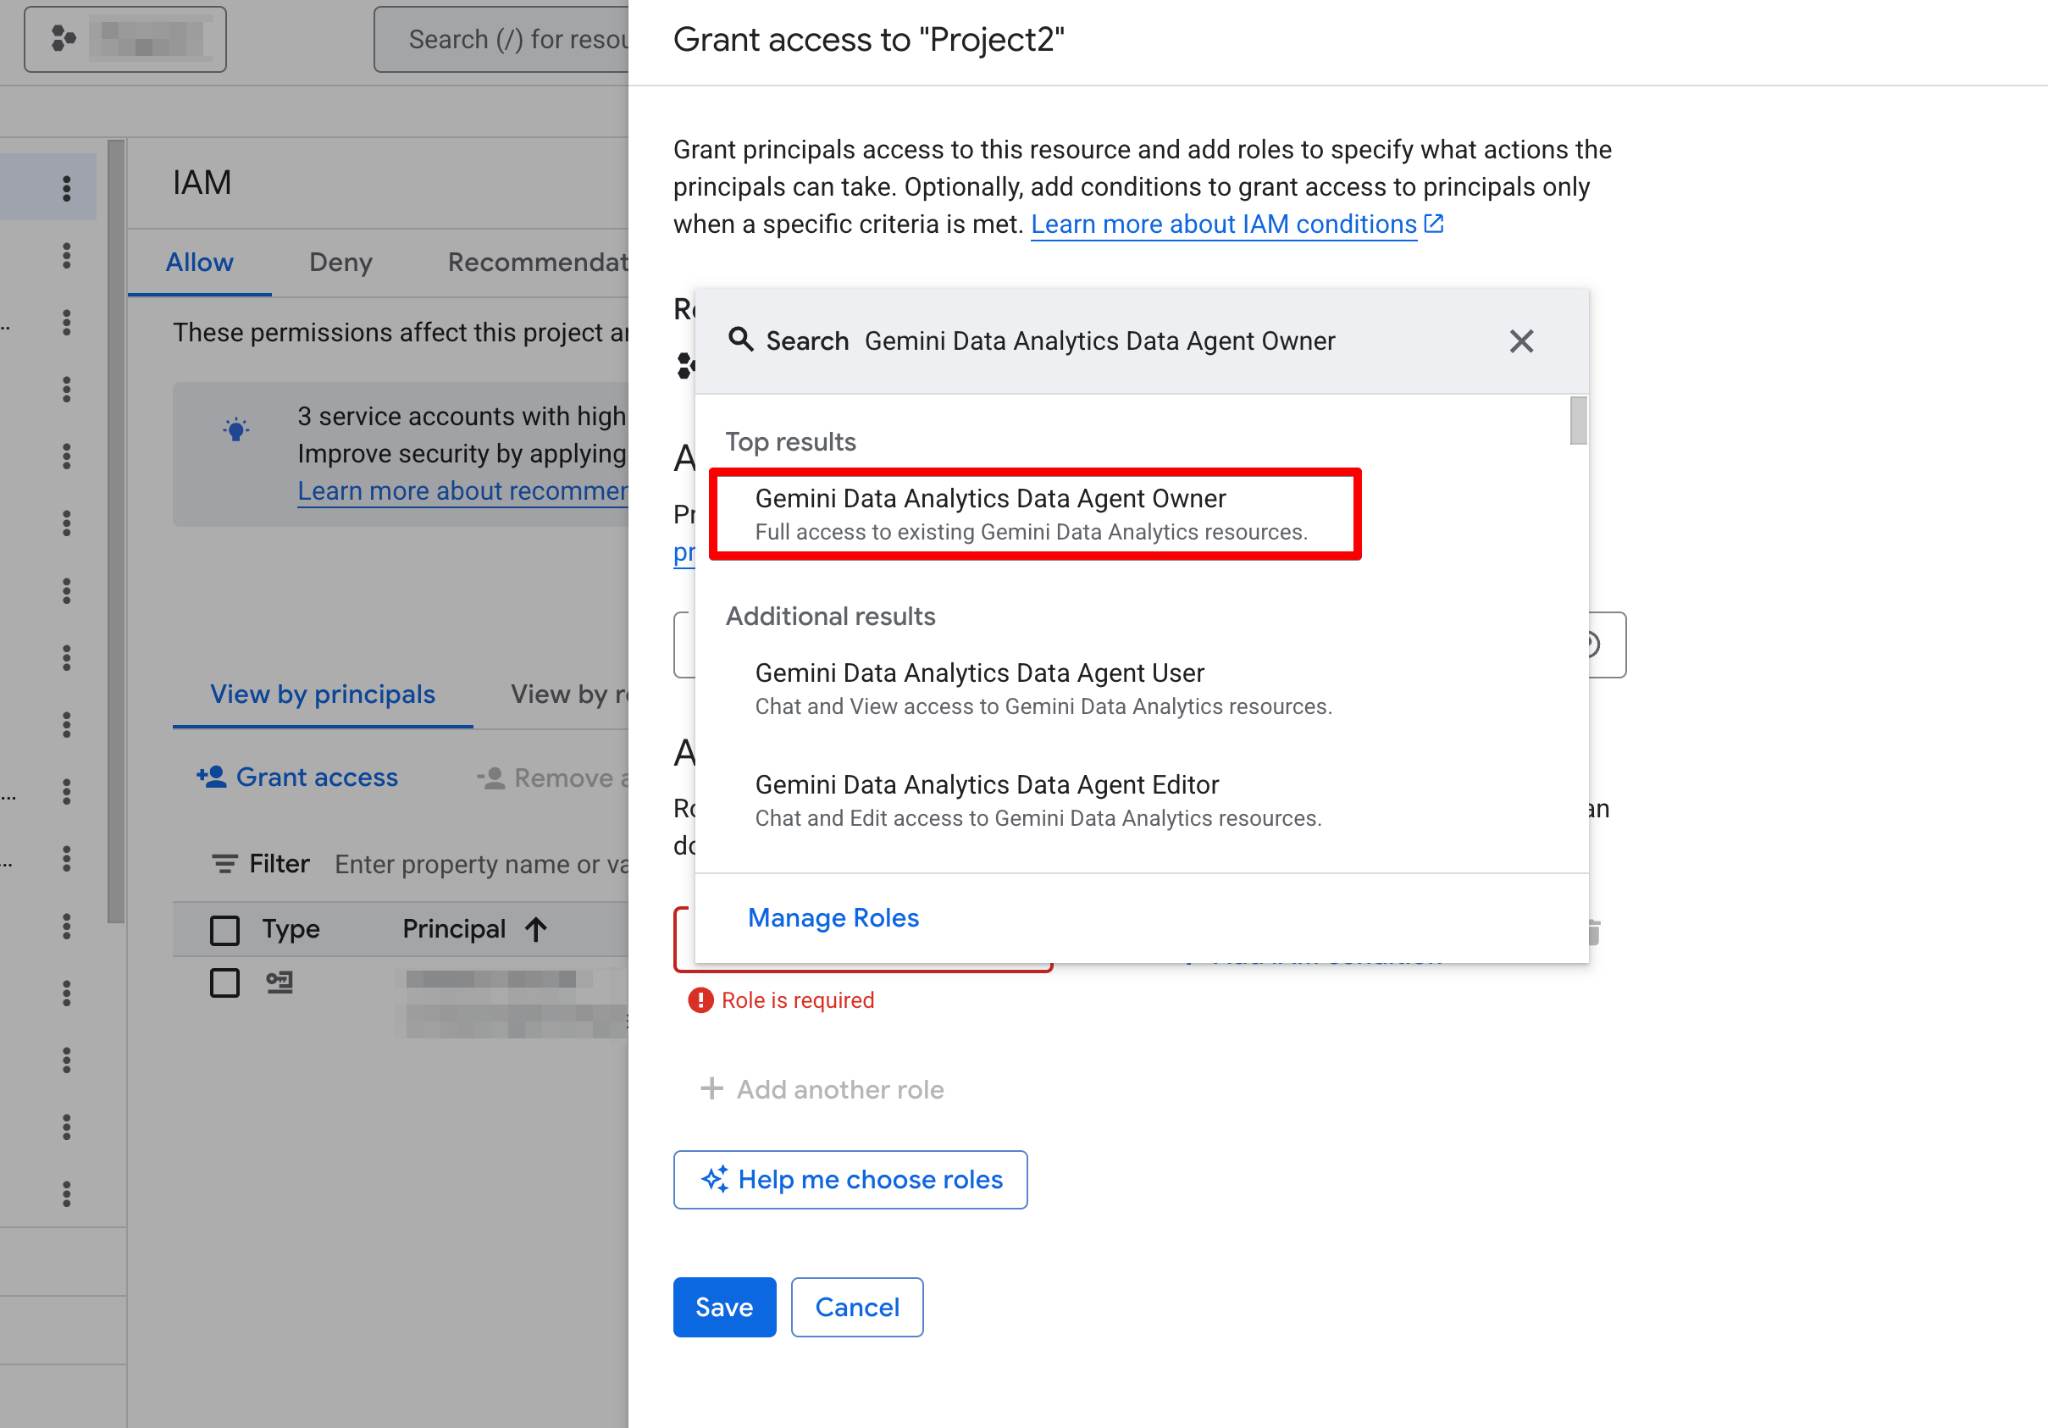
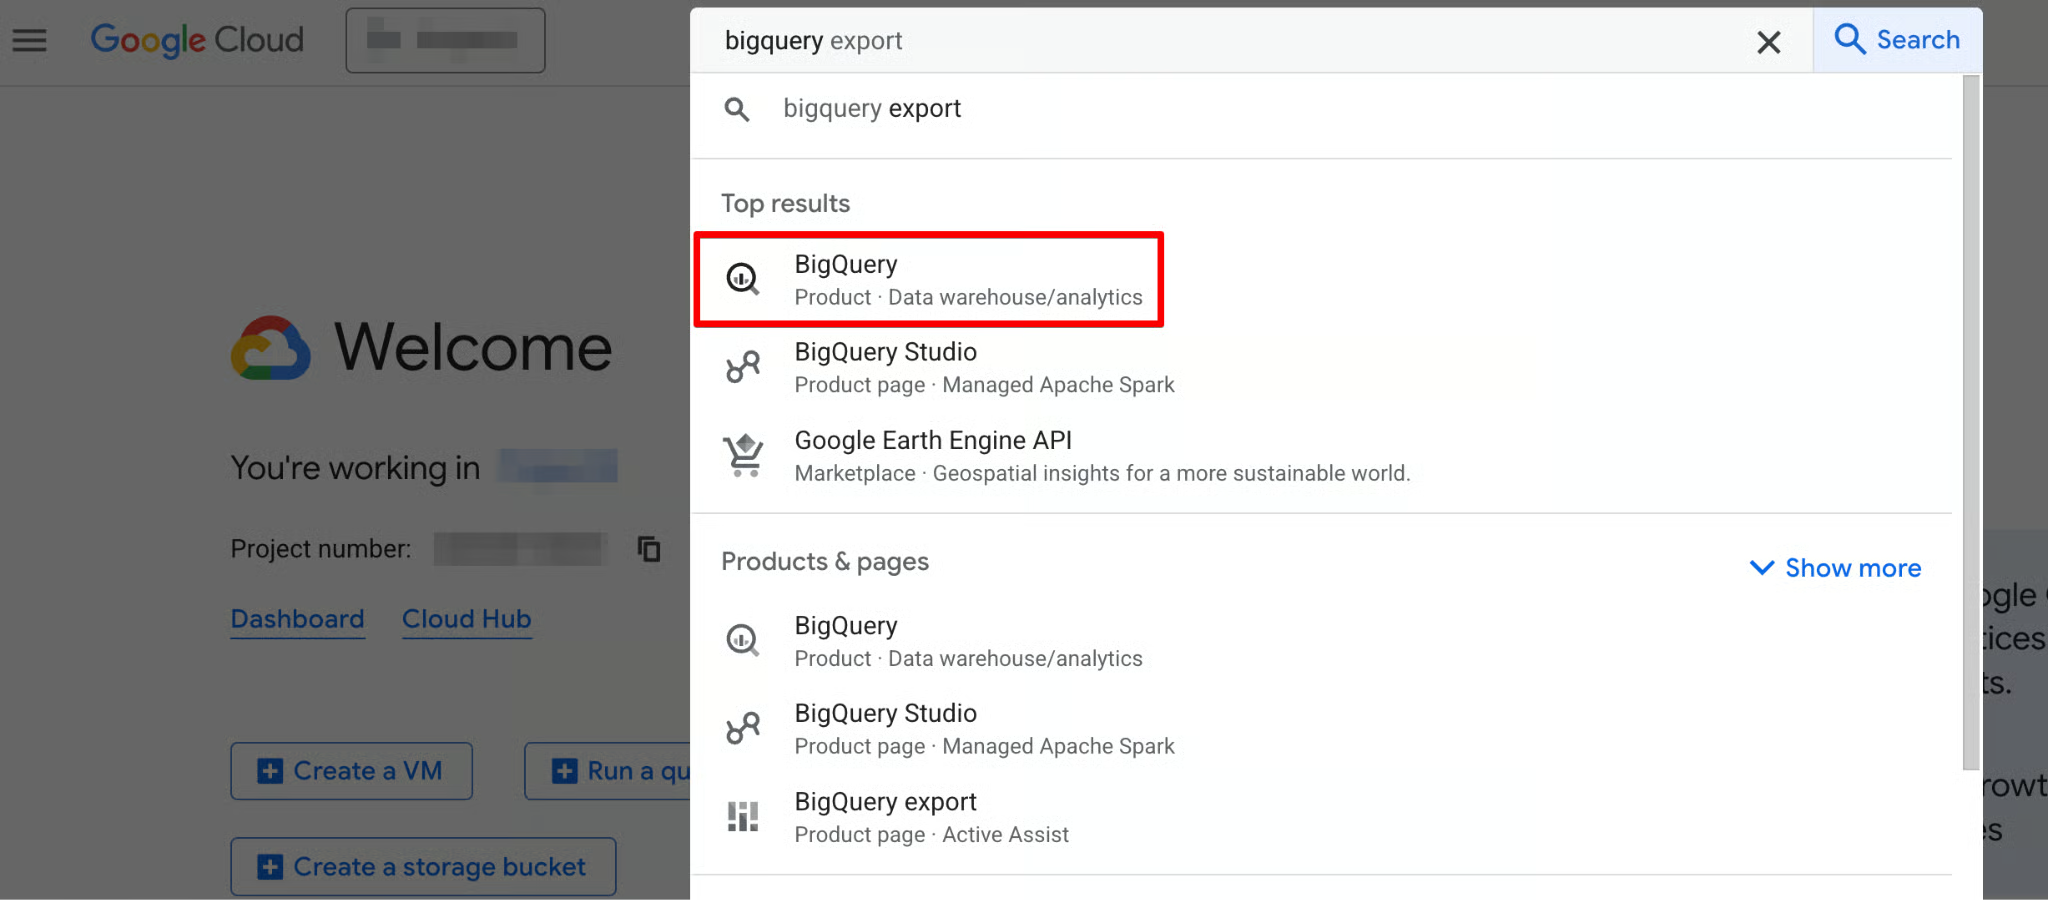
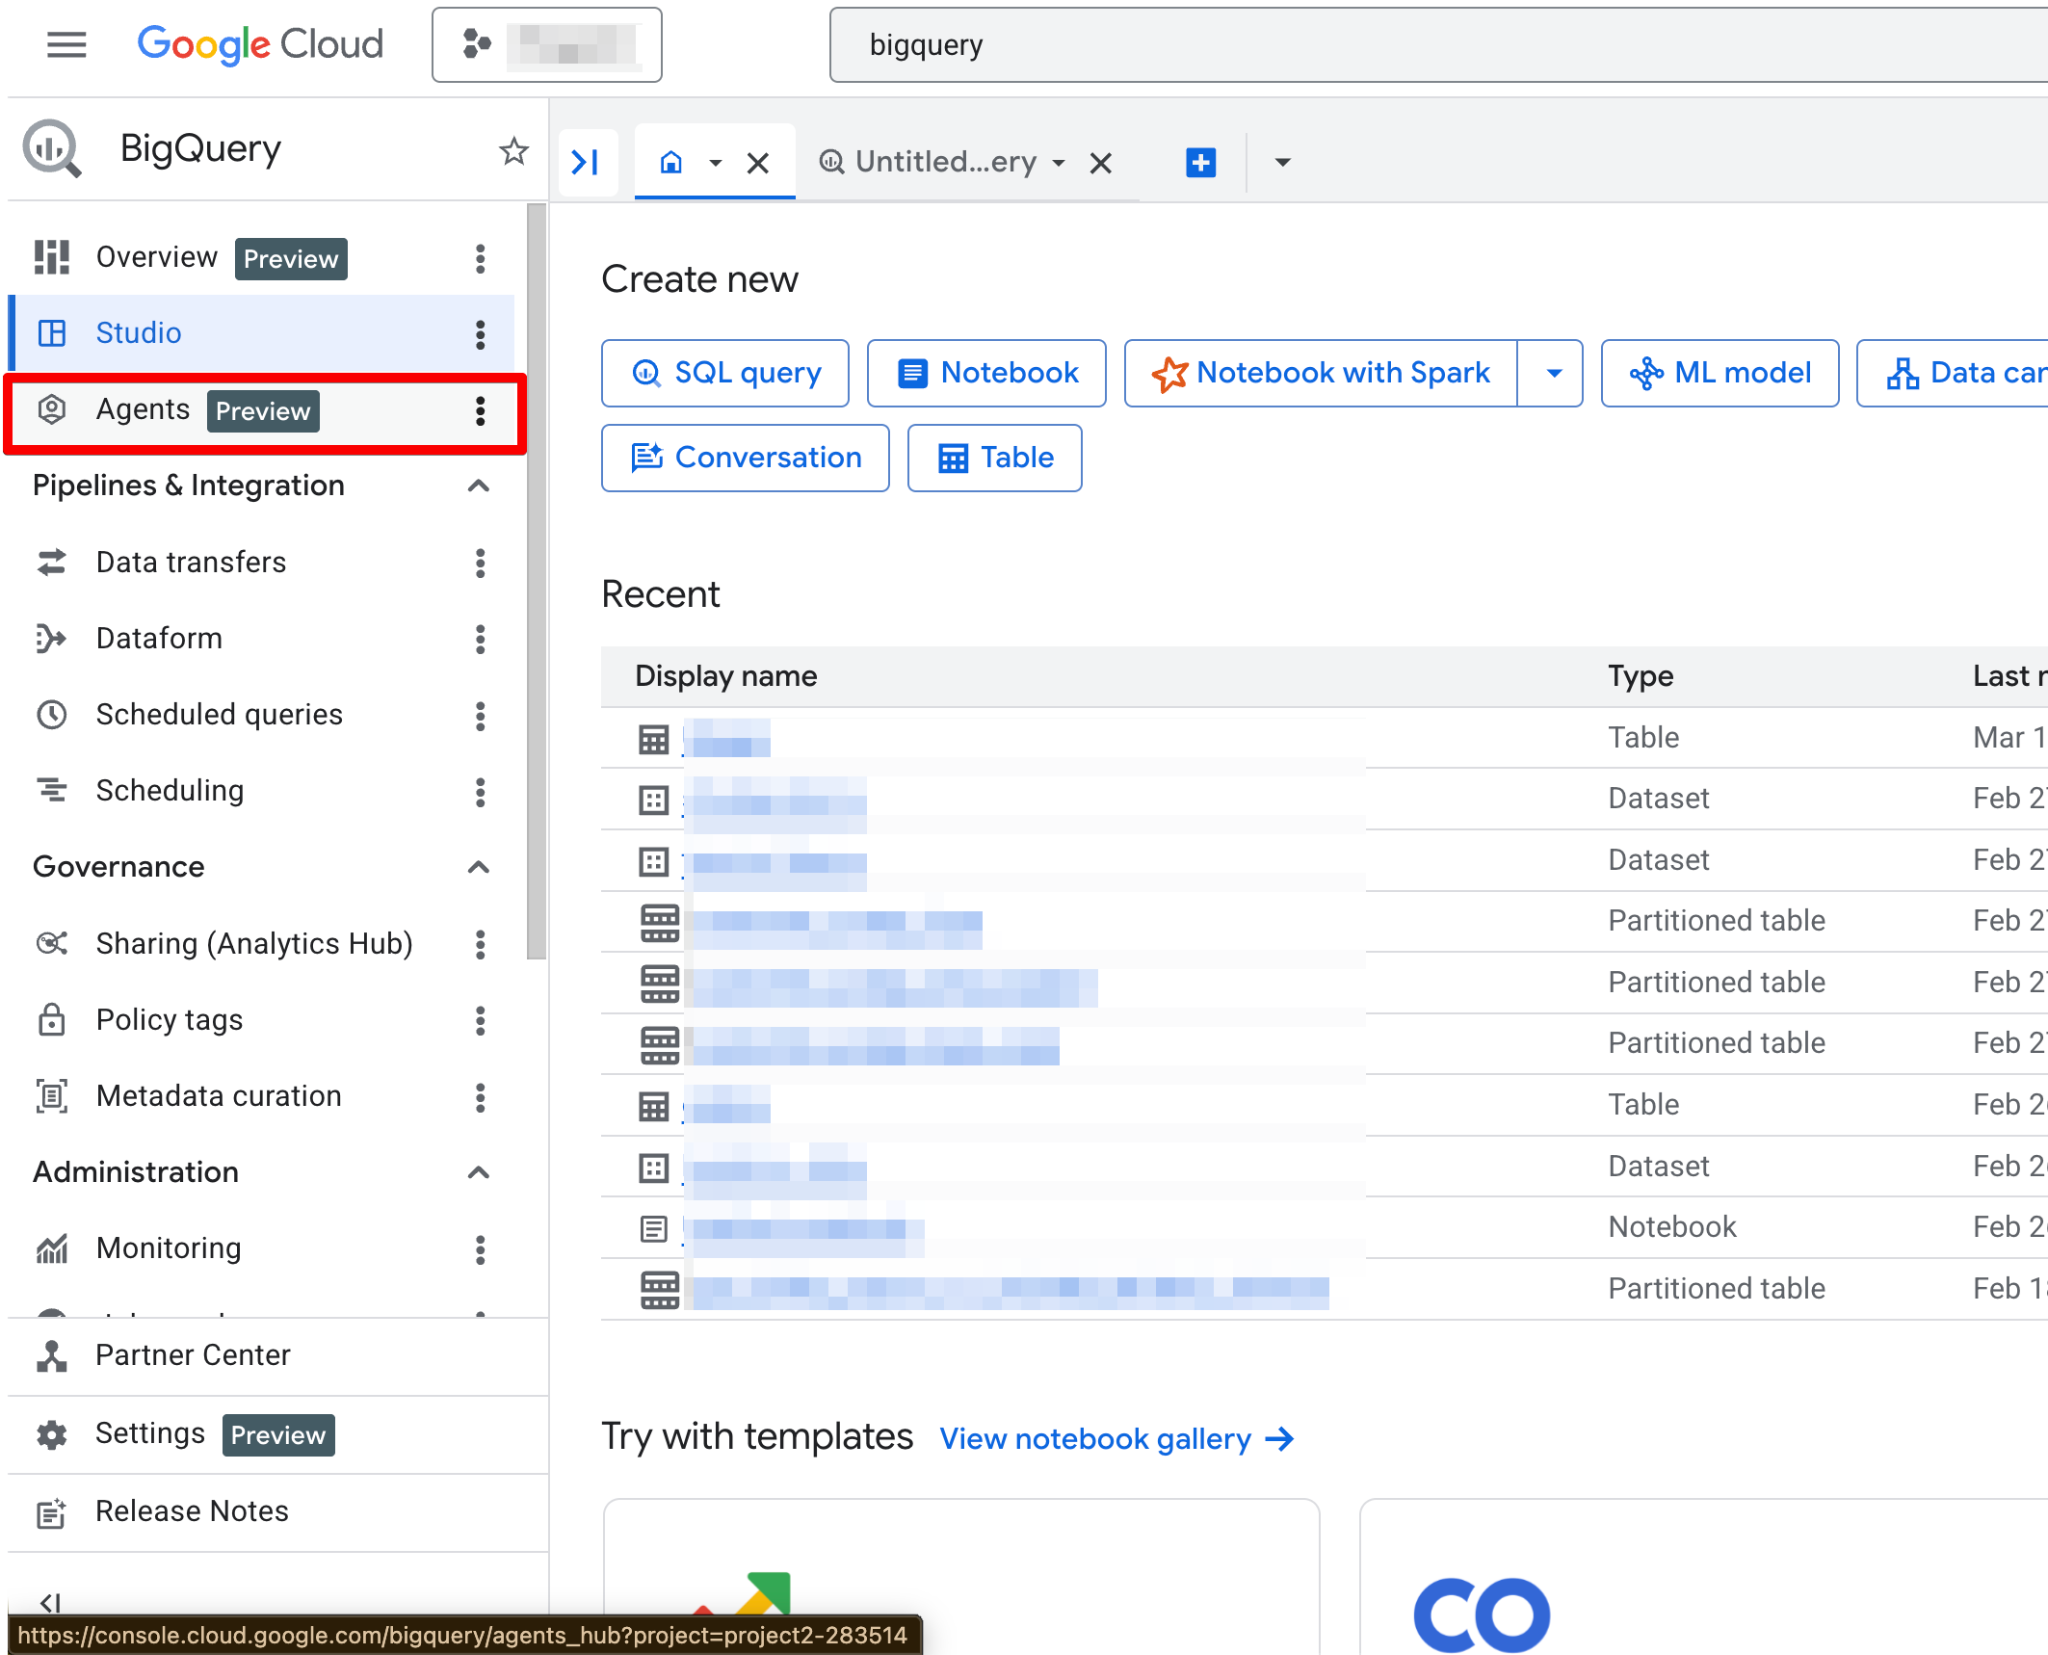
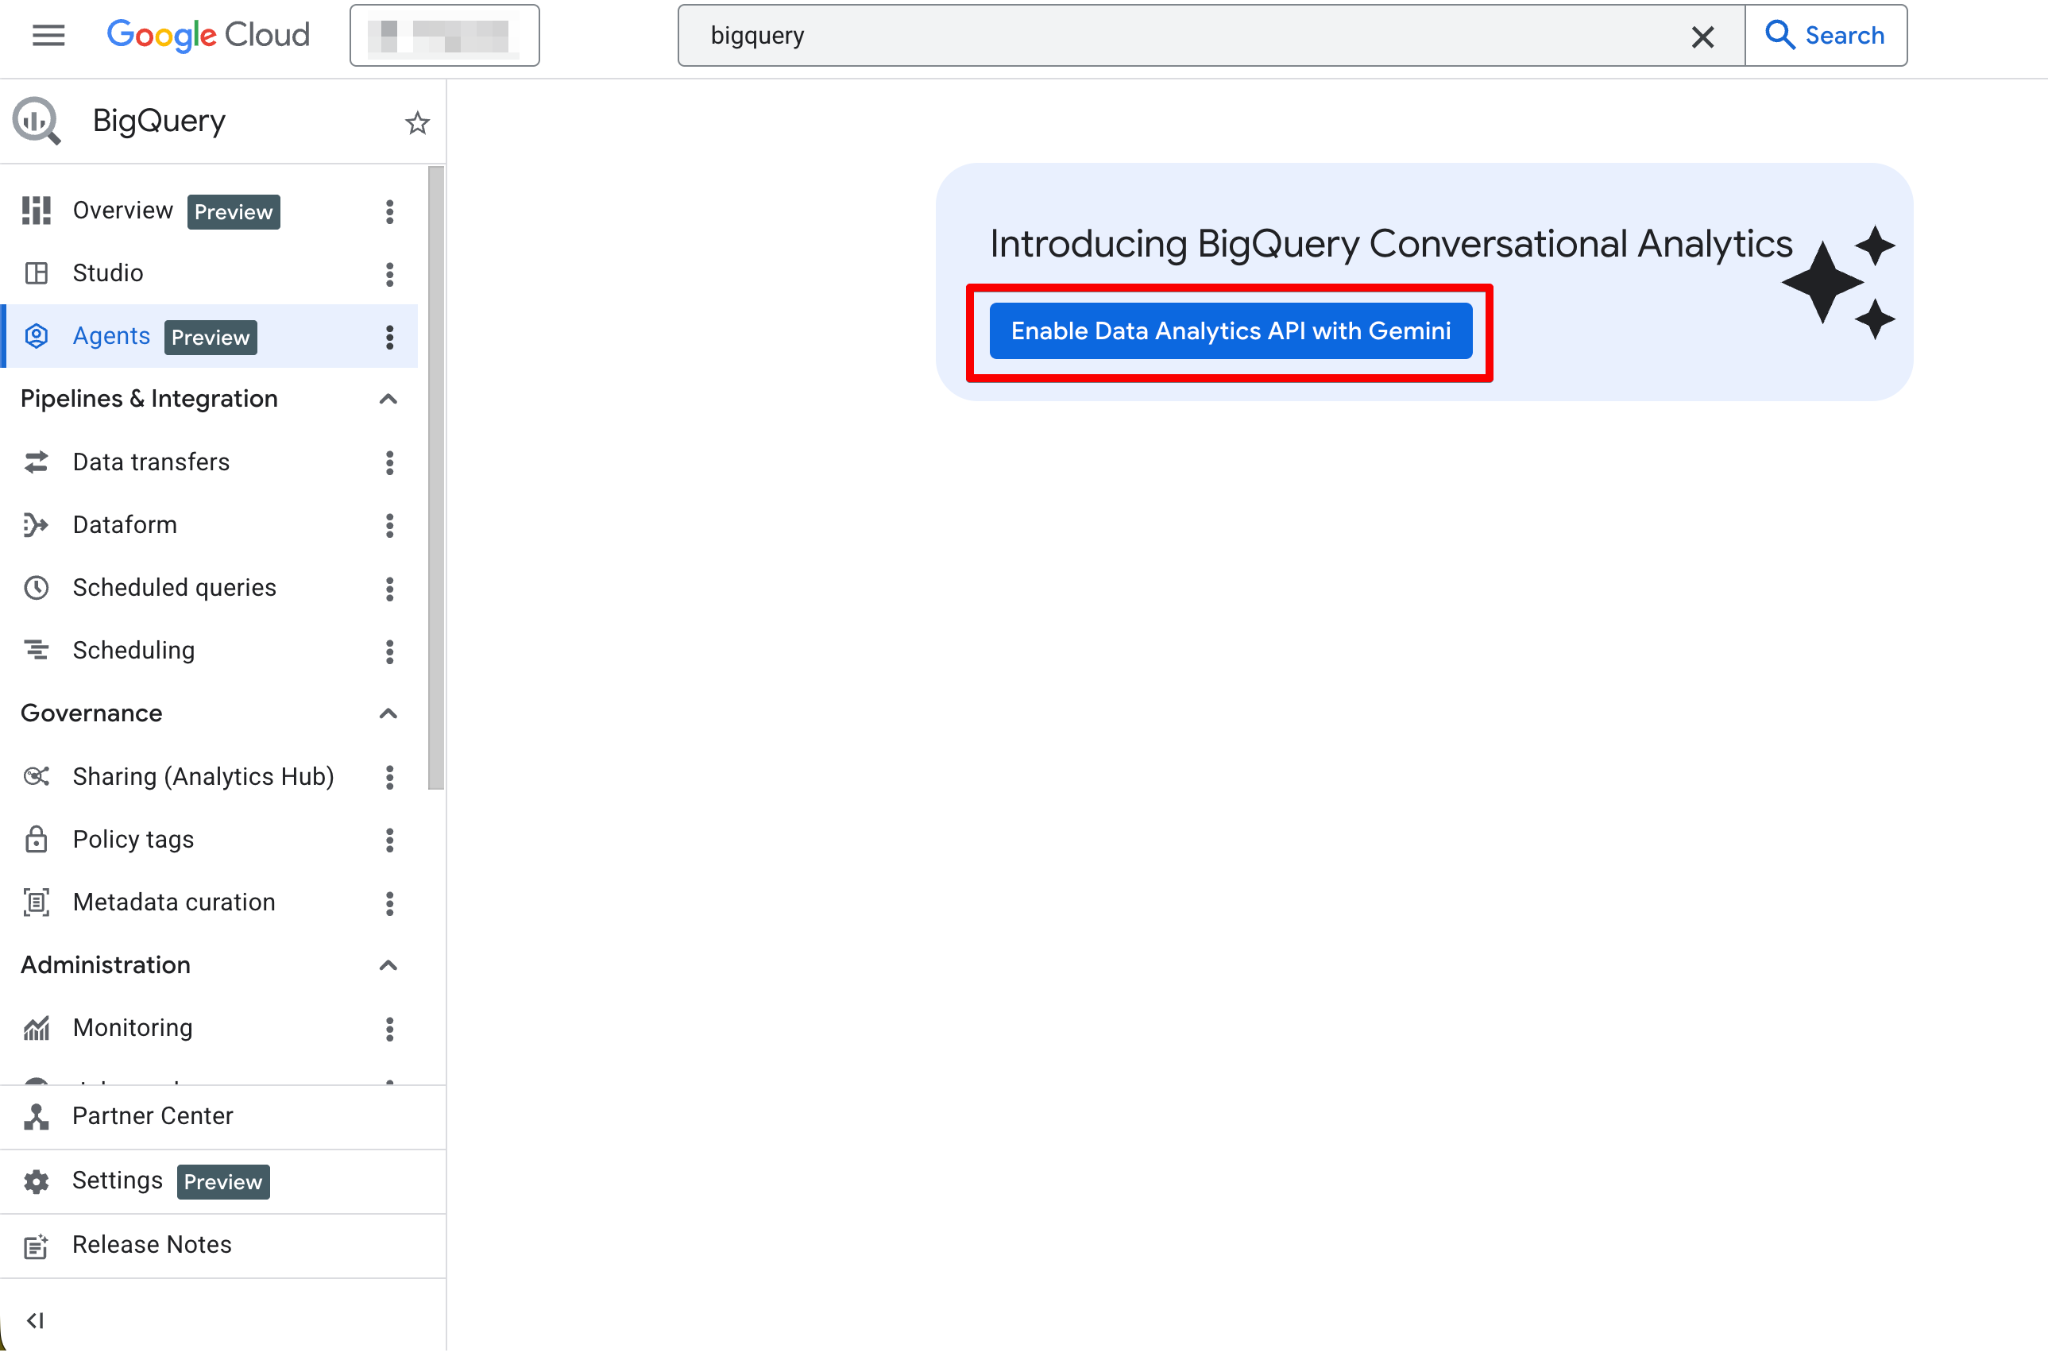
सक्षम होने के बाद, Agents पेज पूरी तरह कार्यात्मक हो जाएगा। अब आपको नया एजेंट पेज दिखना चाहिए:
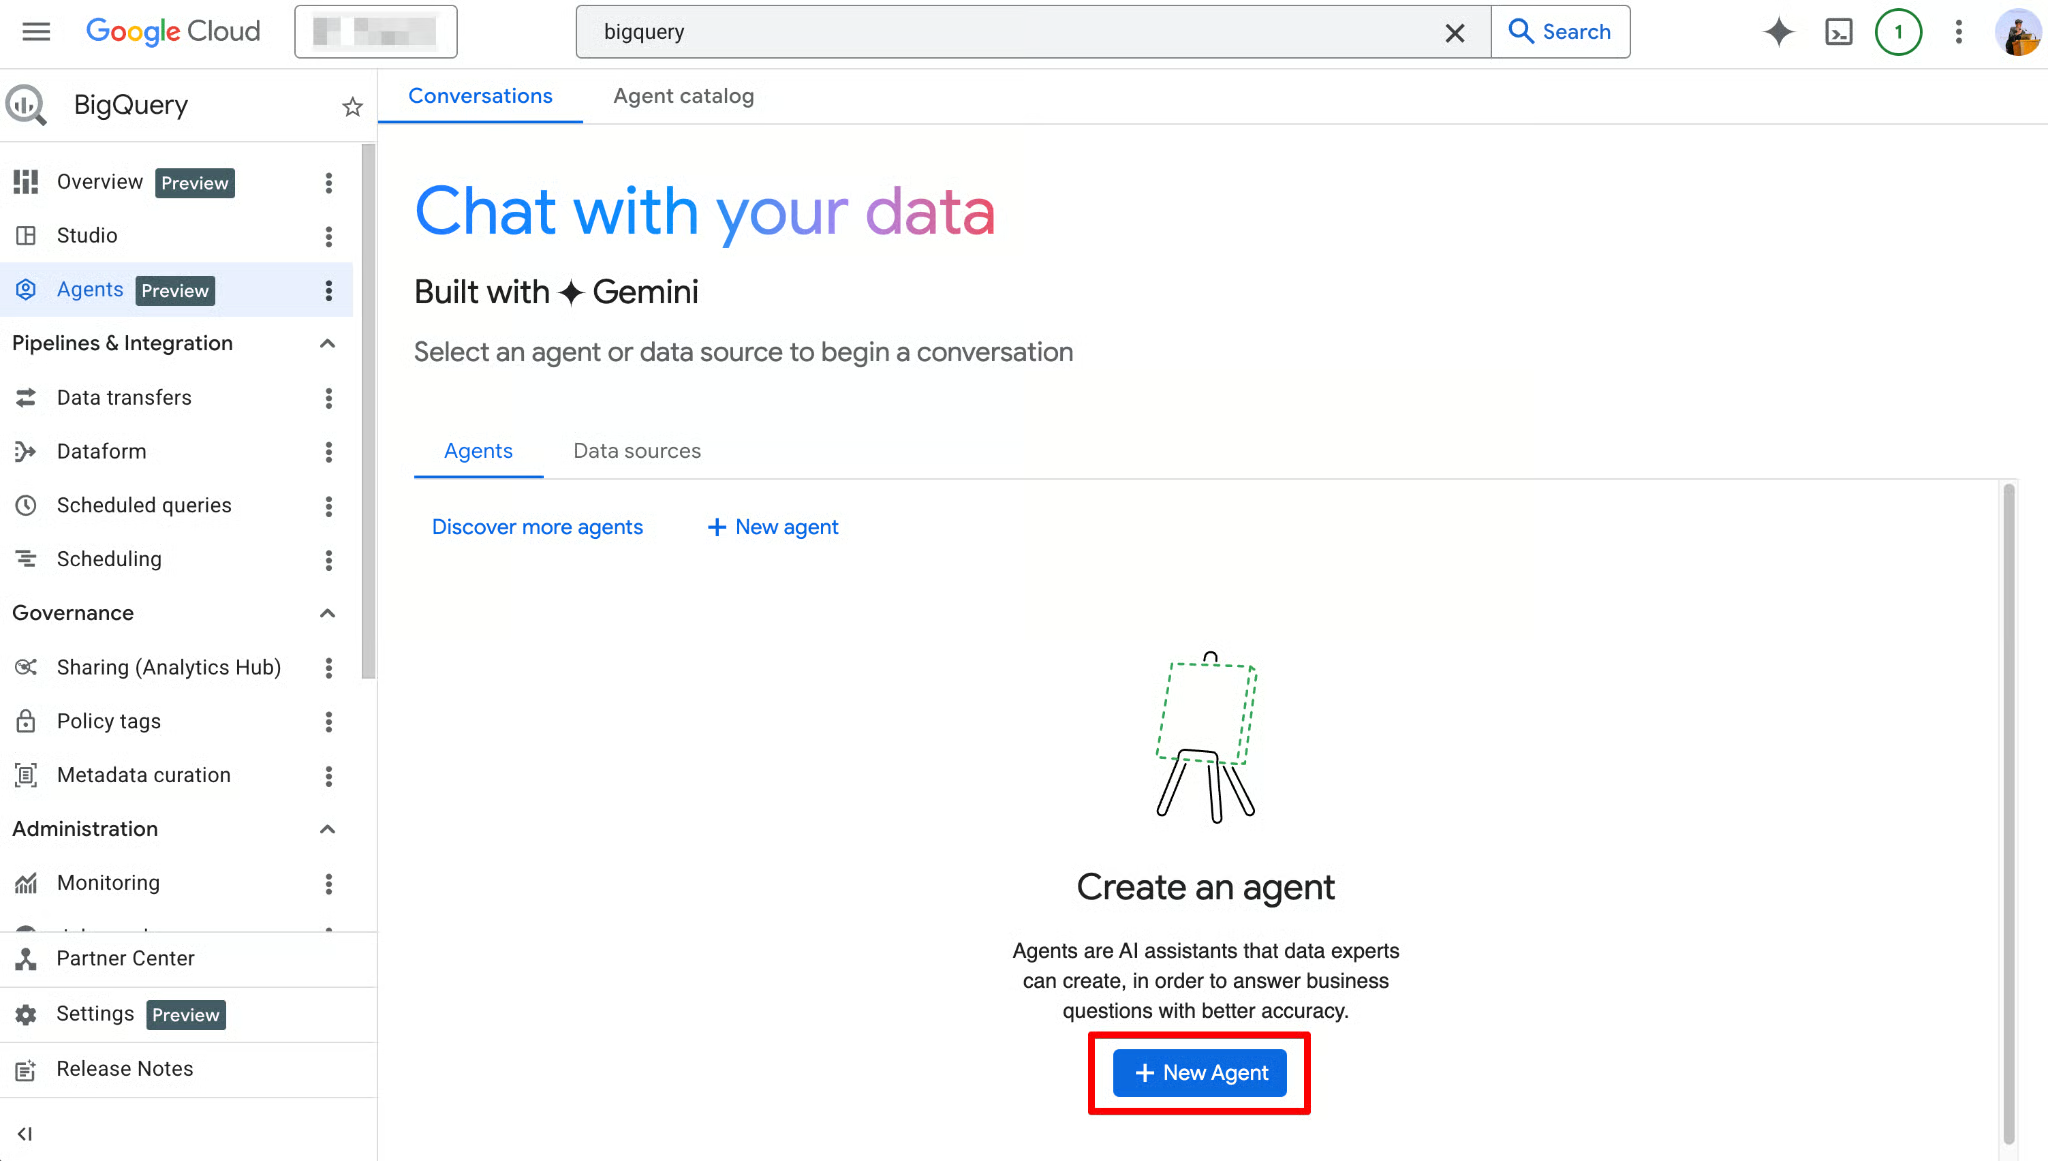
Agent Catalog का उपयोग BigQuery Studio के भीतर डेटा एजेंट बनाने, मैनेज करने और वर्ज़निंग के लिए किया जाता है।
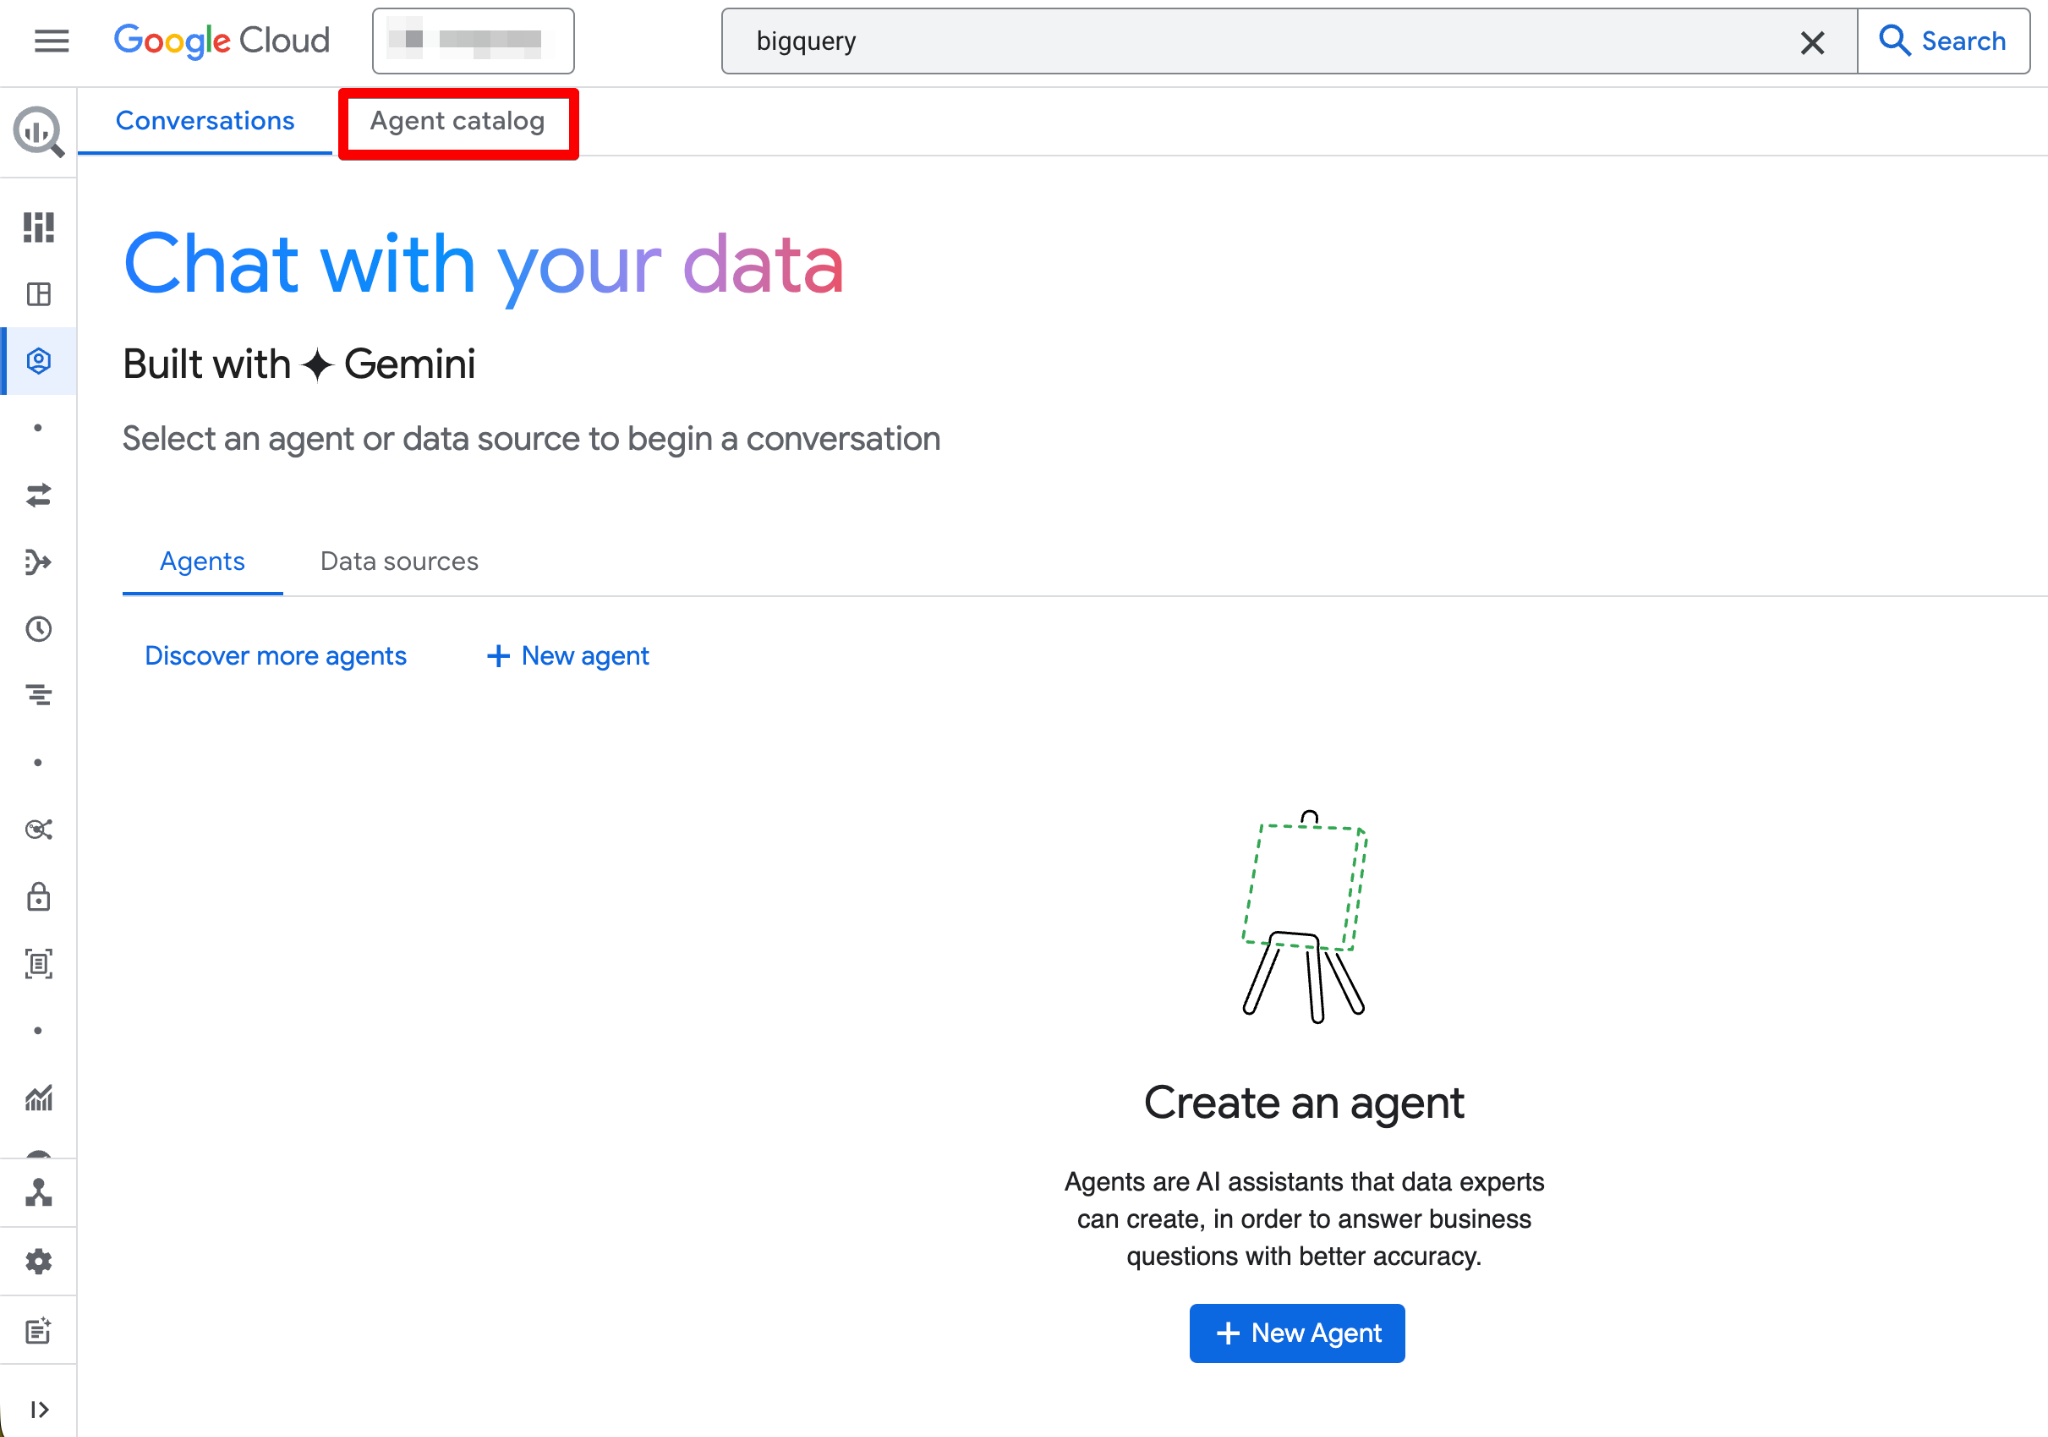
Agent Catalog में आपको यह सब मिलेगा:
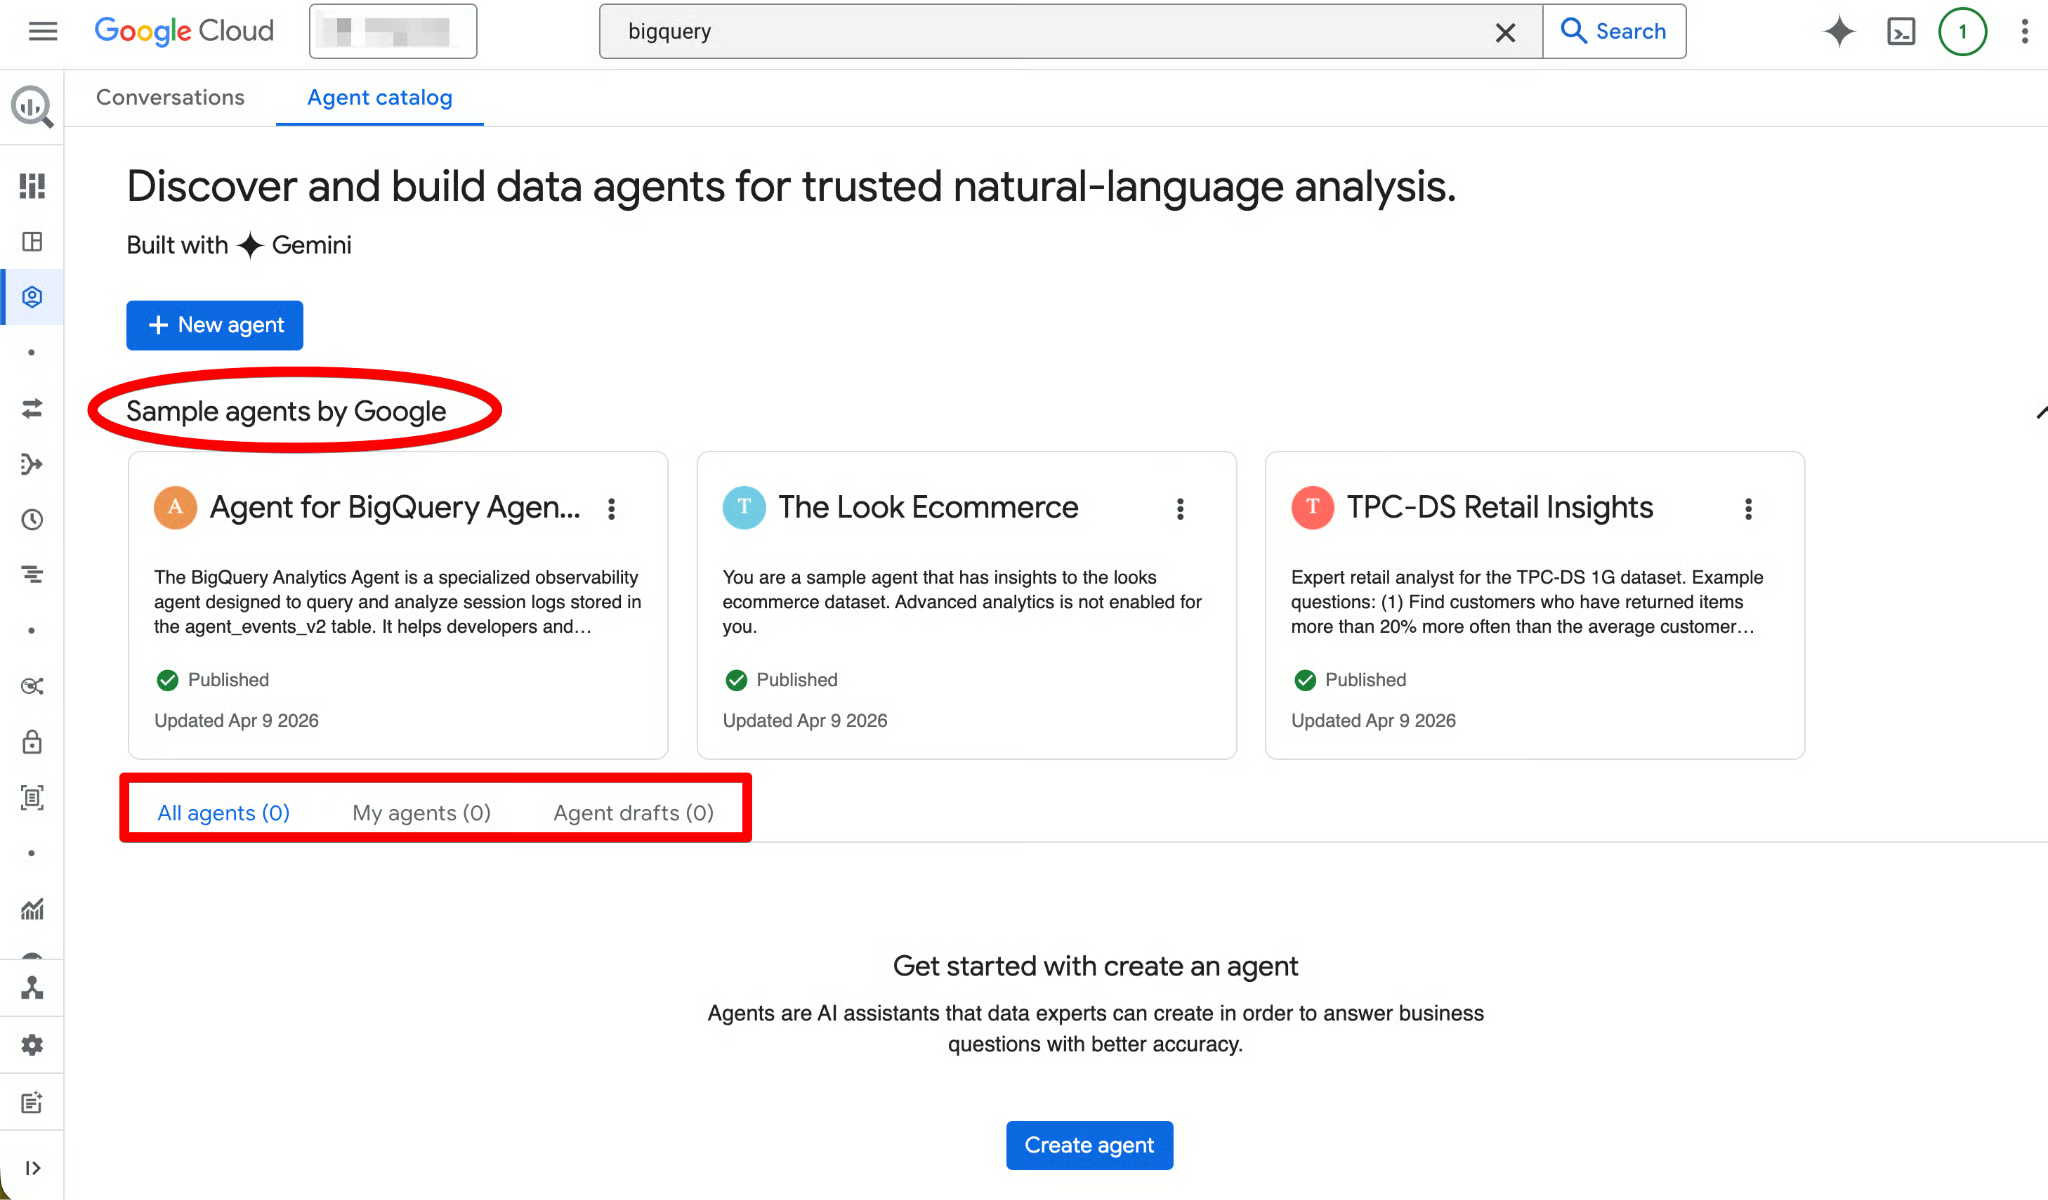
एजेंट का लाइफसाइकल इस संरचना का पालन करता है (Draft → Created → Published):
किसी भी एजेंट कार्ड पर क्लिक करें उसे खोलने, विवरण देखने, वार्तालाप शुरू करने, या (यदि आपके पास Owner परमिशन हैं) संपादित करने के लिए। इंटरफ़ेस में Conversations टैब भी शामिल है जहाँ आप एजेंट्स या डेटा सोर्स के साथ पिछले चैट मैनेज कर सकते हैं।
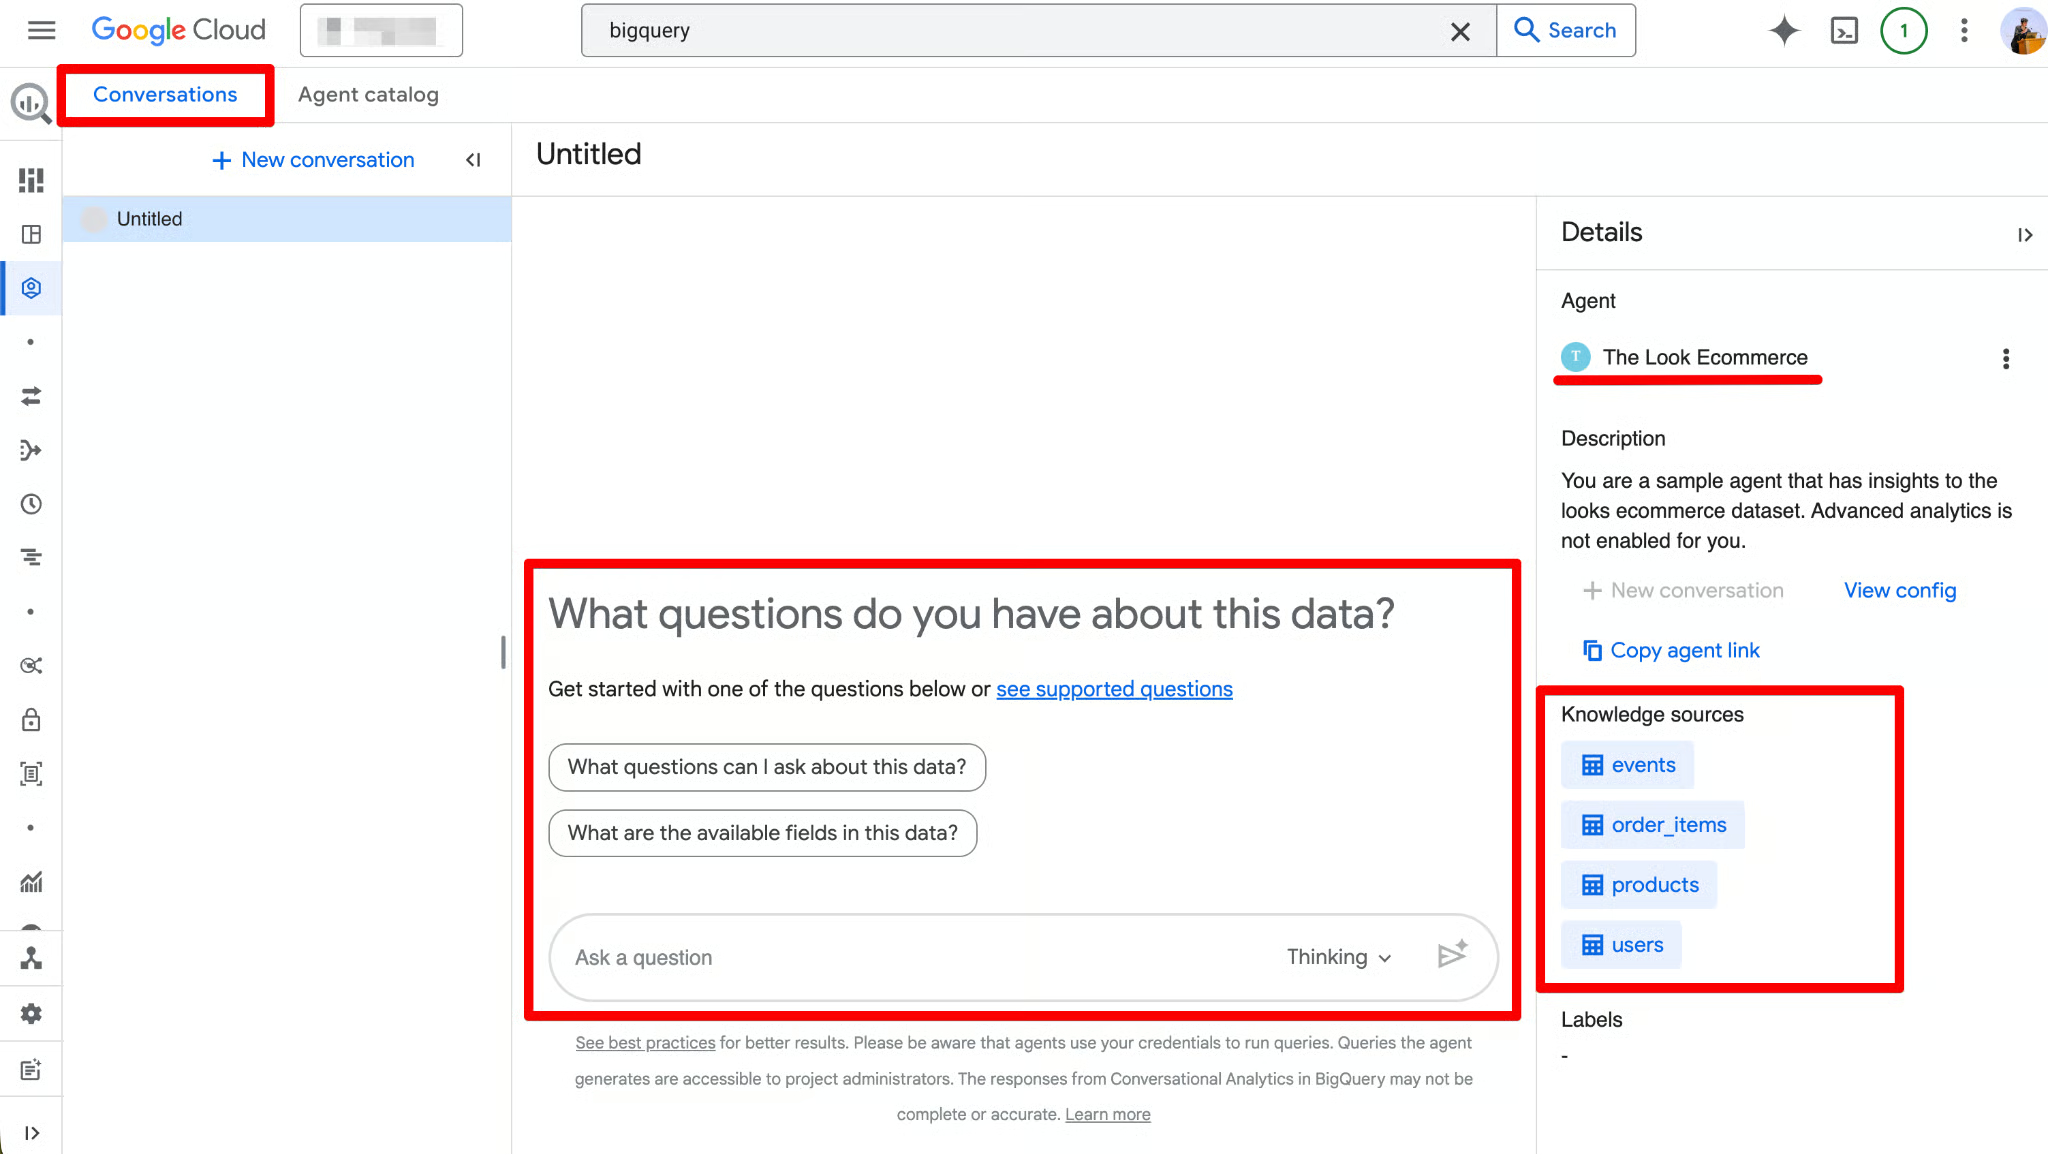
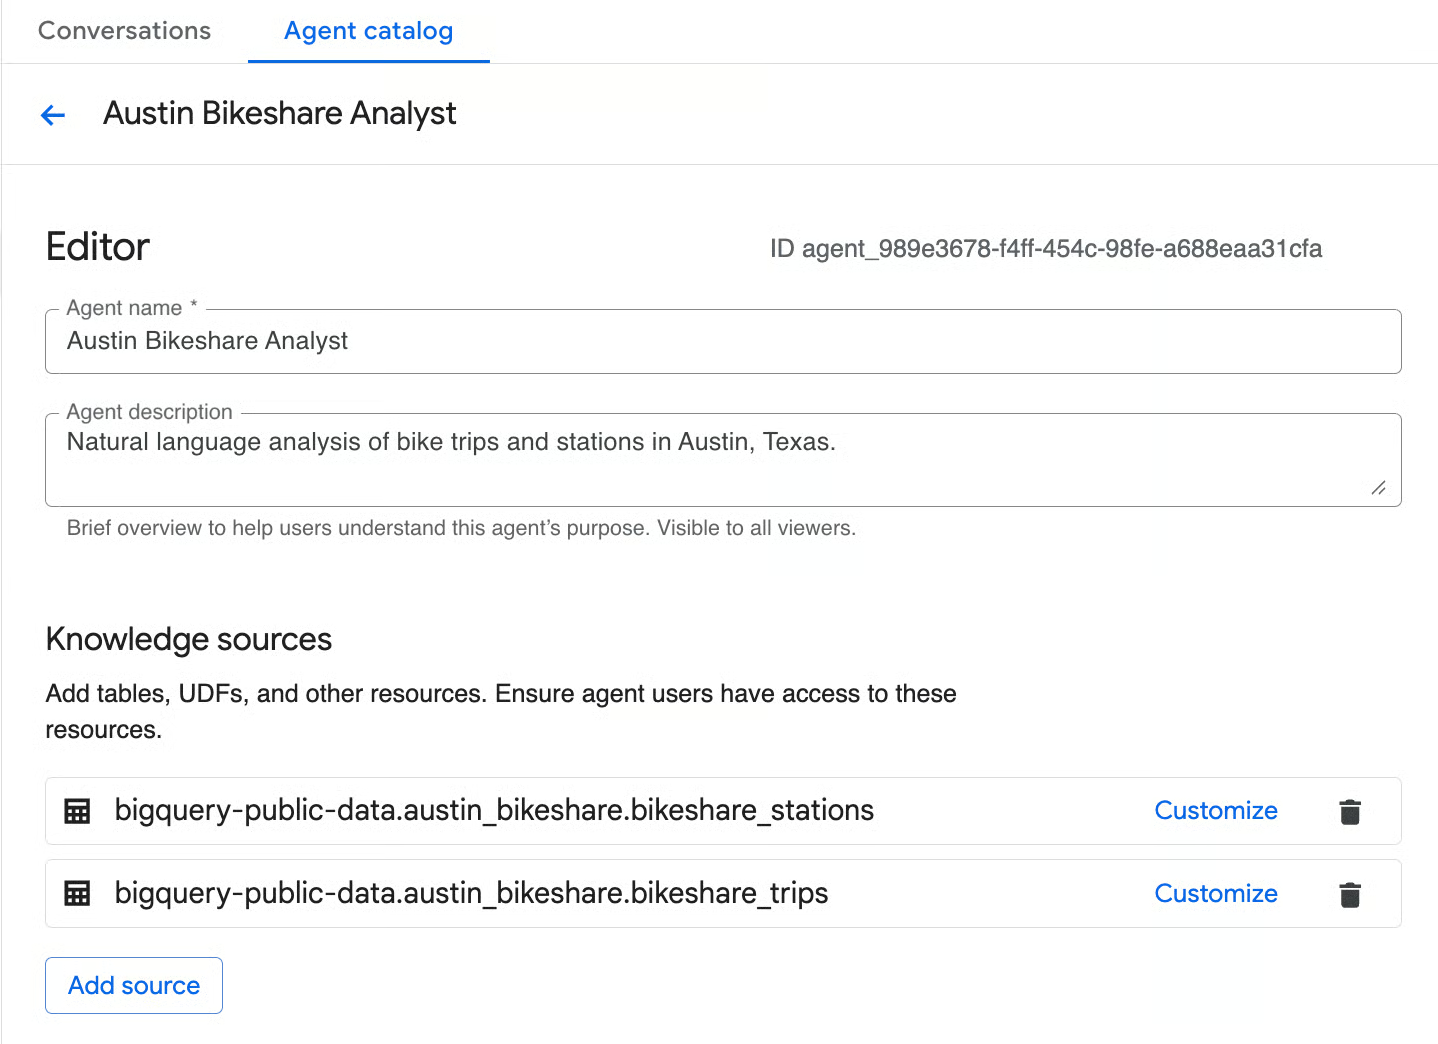
अब जबकि नींव तैयार है, आइए शून्य से एक डेटा एजент बनाएँ। हम bigquery-public-data.austin_bikeshare डेटासेट का उपयोग करेंगे ताकि कच्चे ट्रिप डेटा को एक संवादी इंटरफ़ेस में बदला जा सके। हम दो टेबल्स का उपयोग करेंगे:
bikeshare_trips — विस्तृत ट्रिप-स्तरीय डेटा
bikeshare_stations — स्टेशन मेटाडेटा
एजेंट निर्माण शुरू करना
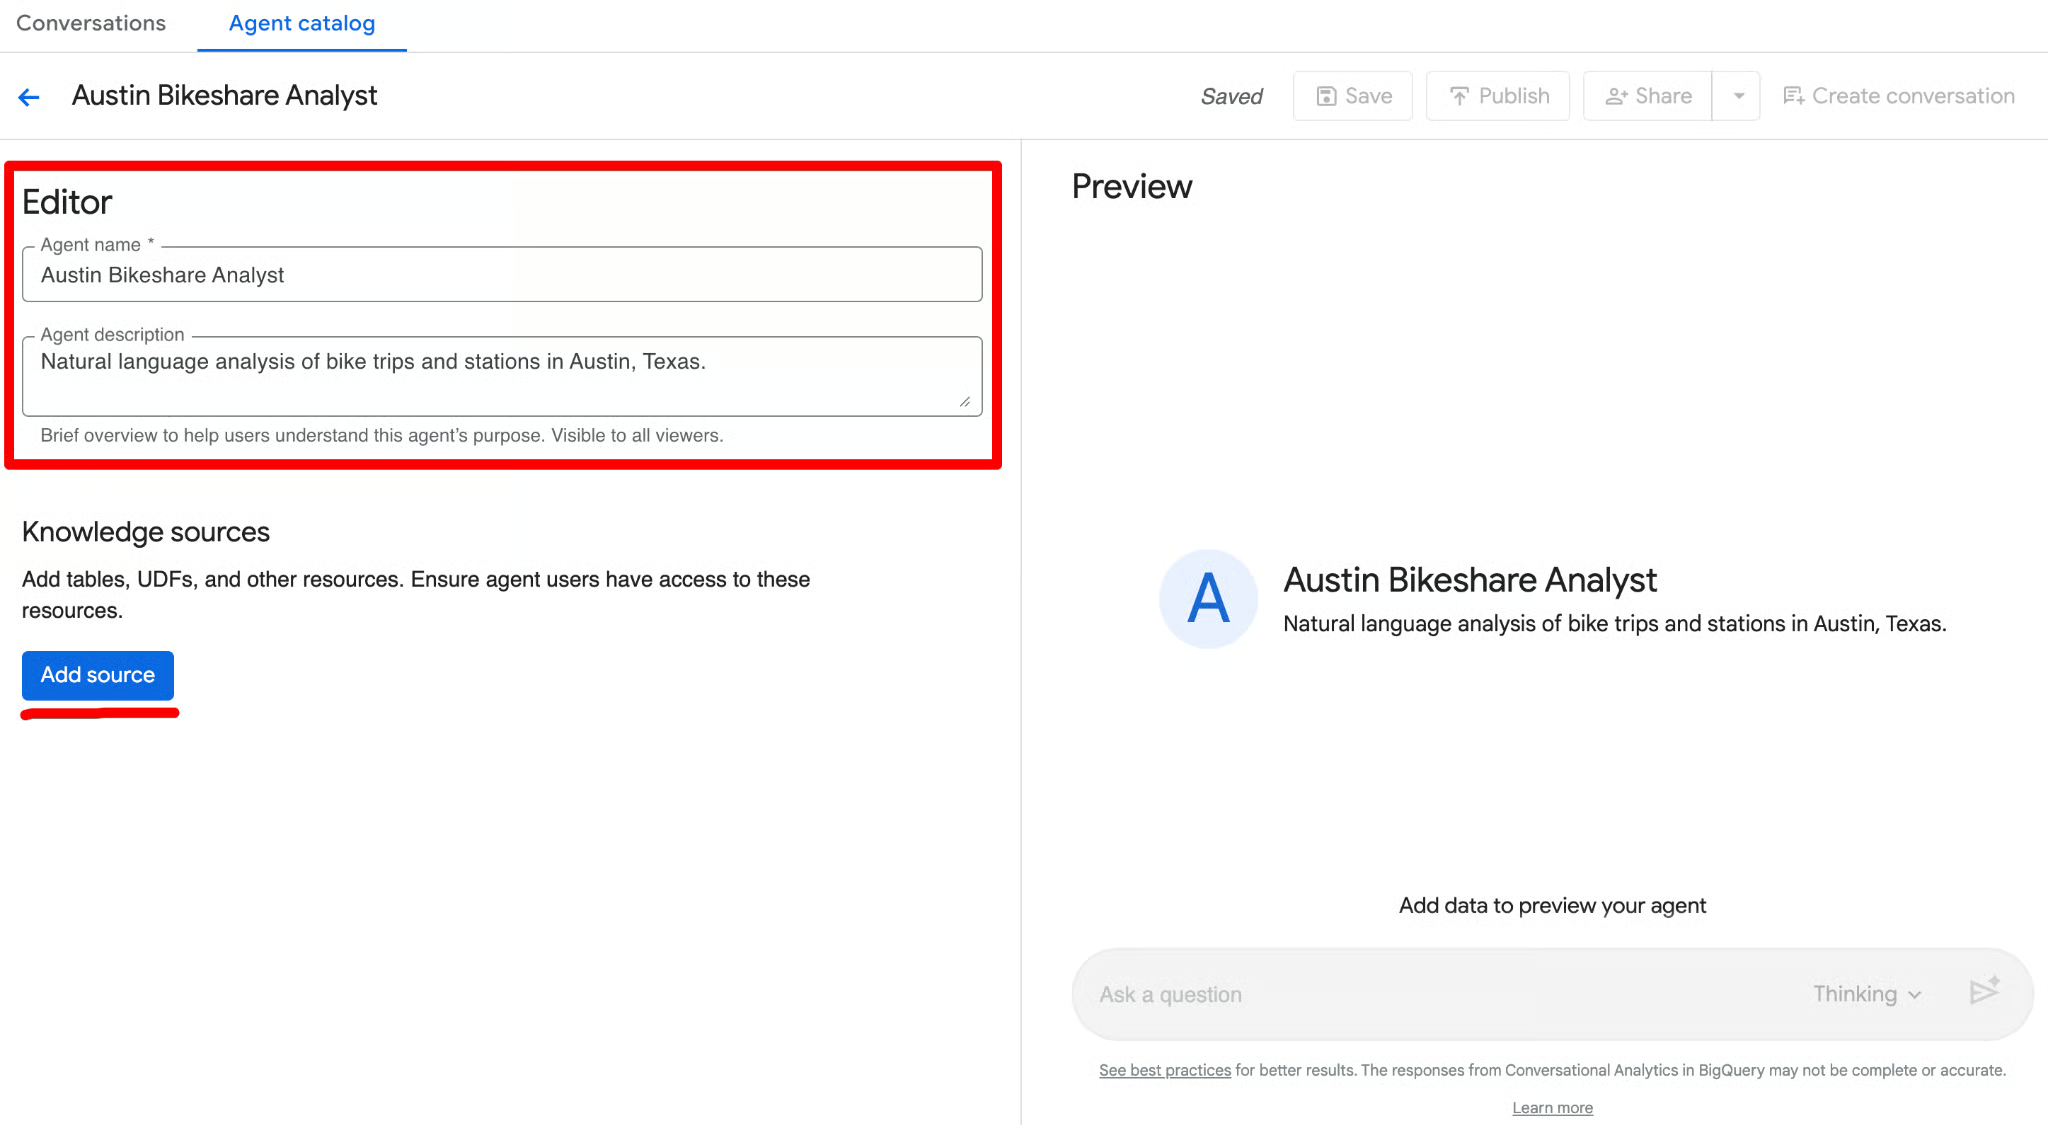
ये दो फ़ील्ड्स आपको बाद में एजेंट को जल्दी पहचानने में मदद करती हैं। एक बार सेट हो जाने पर, आप वे तीन मुख्य बिल्डिंग ब्लॉक्स कॉन्फ़िगर करने के लिए तैयार हैं जिन पर हमने पहले चर्चा की: नॉलेज सोर्स, निर्देश, और (बाद में) सत्यापित क्वेरी।
नॉलेज सोर्स यह परिभाषित करते हैं कि एजेंट किन डेटा तक पहुँच सकता है। स्रोत जितने कम और केंद्रित होंगे, शुद्धता उतनी बेहतर और लागत उतनी कम होगी। एडिटर के Knowledge sources सेक्शन में, Add source पर क्लिक करें। austin_bikeshare खोजें और स्रोत के रूप में bikeshare_trips और bikeshare_stations चुनें।
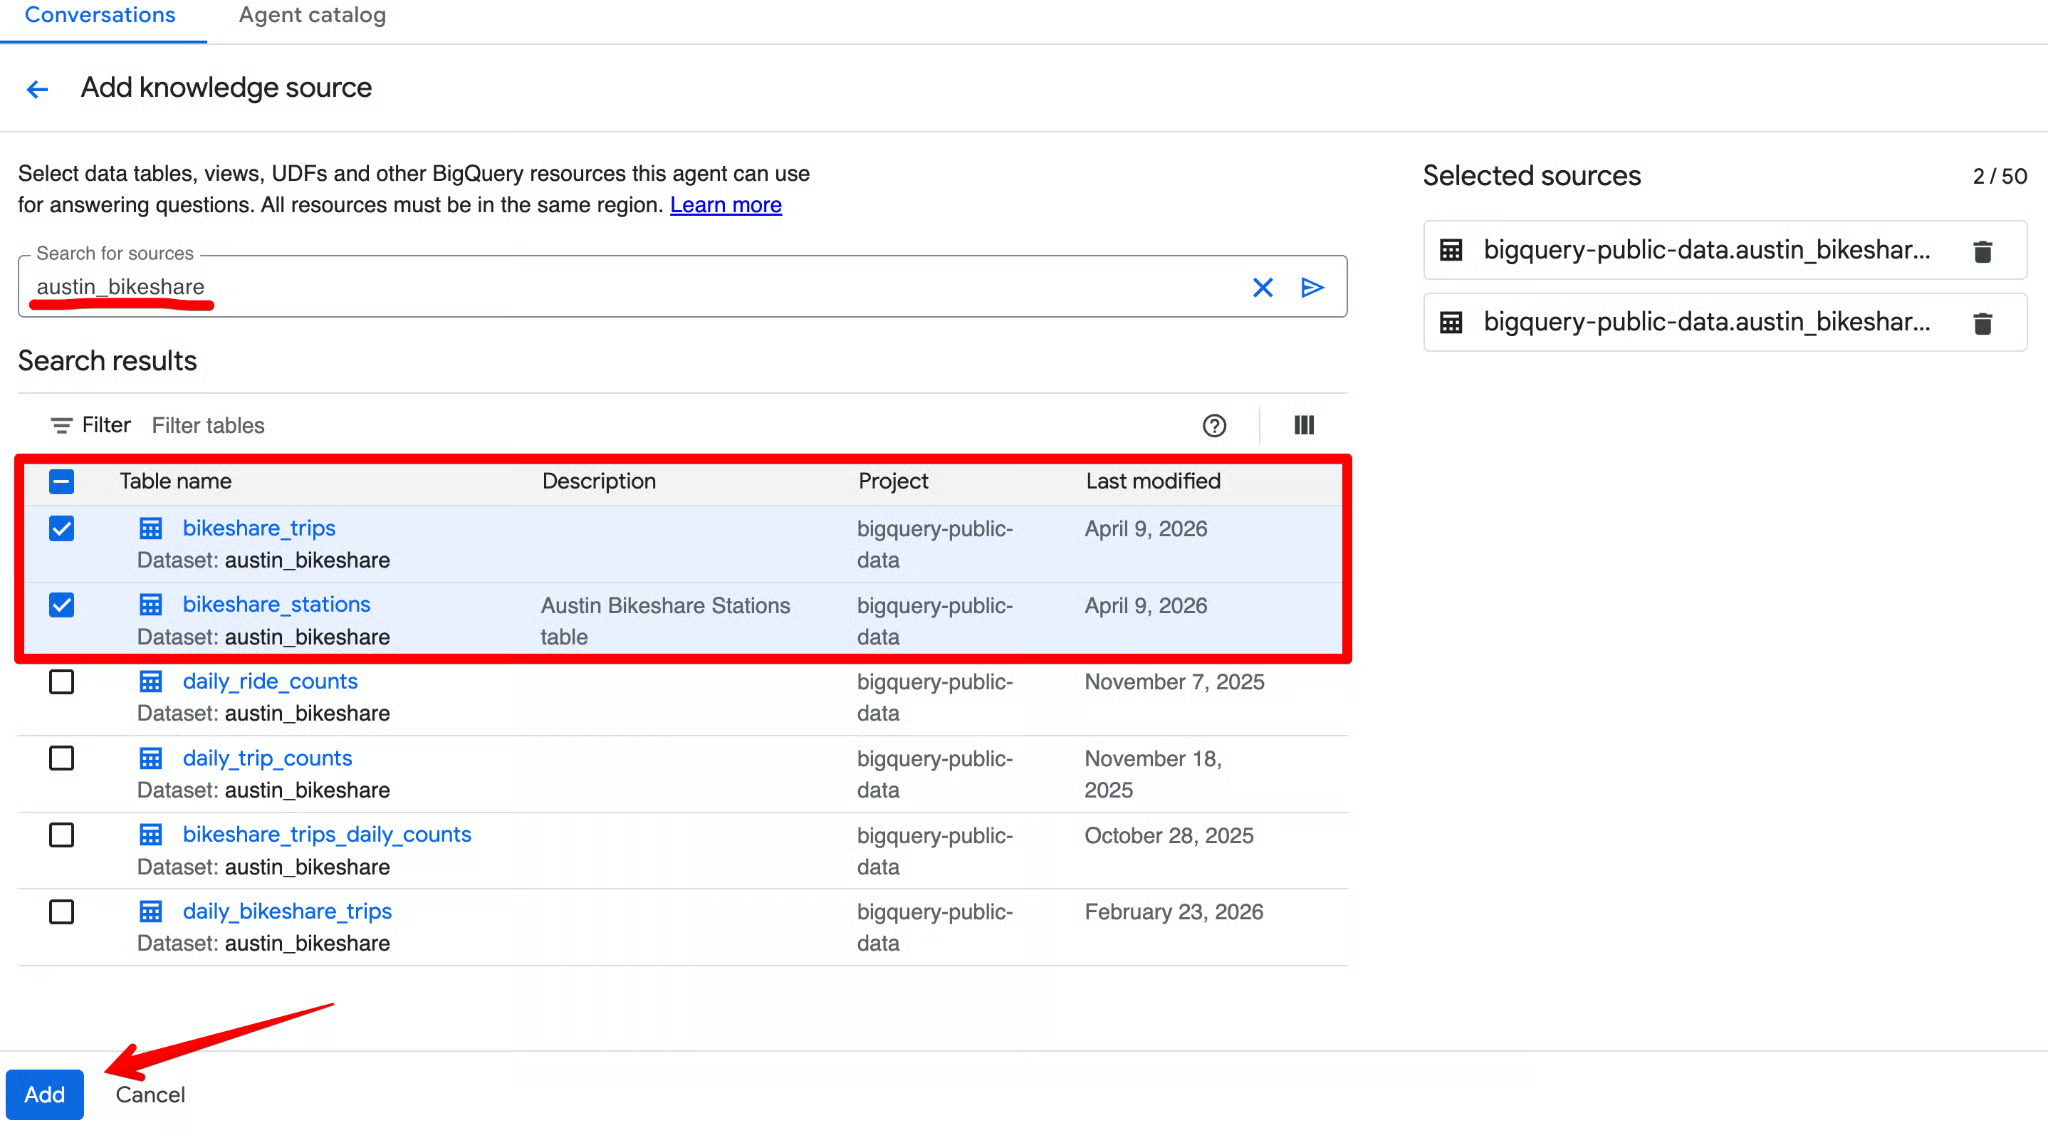
जो भी टेबल आप जोड़ें, उसके लिए Customize पर क्लिक करें।
Gemini स्वतः एक विवरण जेनरेट करेगा और कॉलम मेटाडेटा सुझाएगा। सब कुछ समीक्षा करें, सटीक सुझाव स्वीकार करें, ज़रूरत हो तो बदलाव करें, और Update पर क्लिक करें।
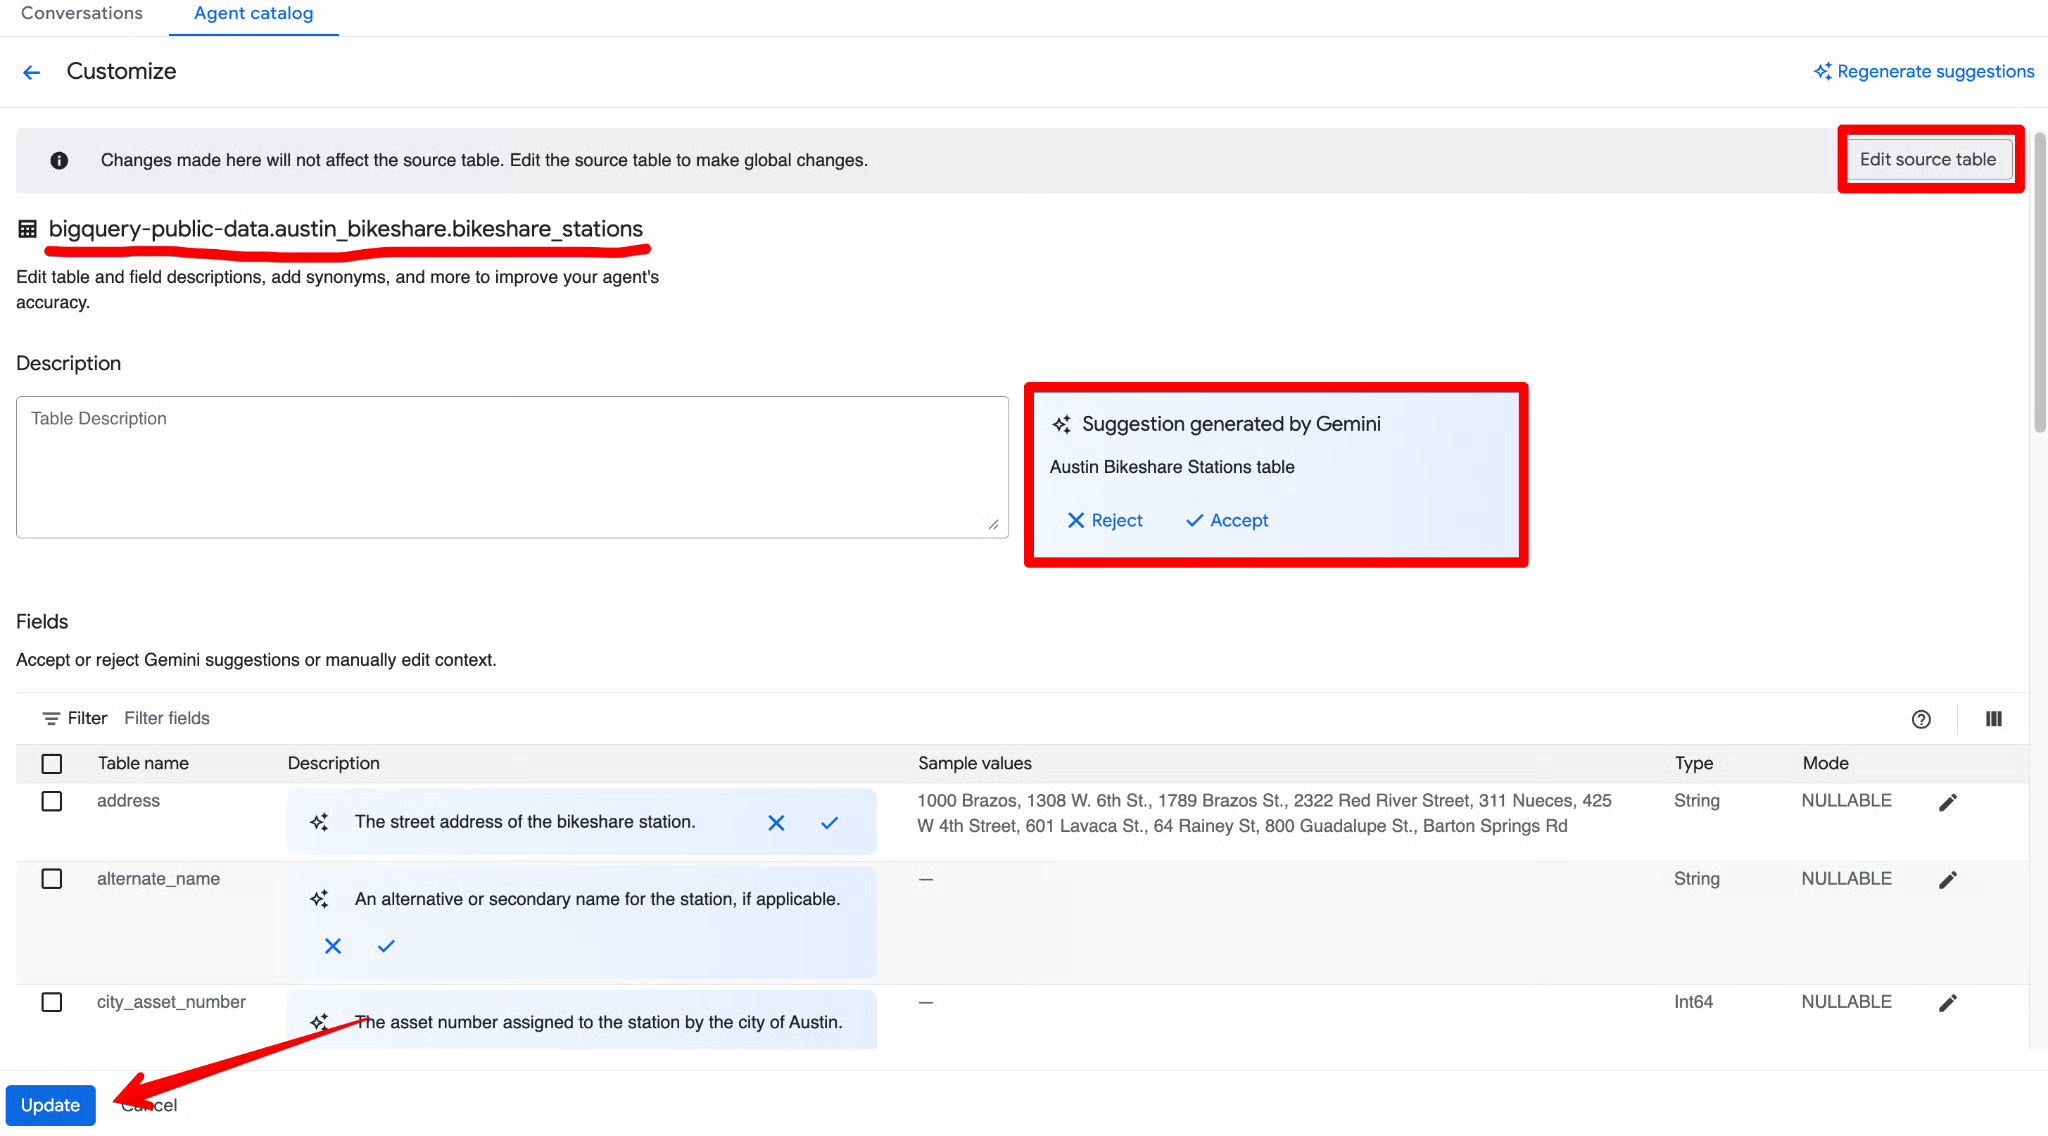
एक सामान्य गलती एक साथ 50 टेबल जोड़ देना है। 2–3 मुख्य टेबल से शुरू करें। इससे एजेंट के लॉजिक को डिबग करना आसान हो जाता है। कोर क्वेरी सटीक हो जाने के बाद आप नॉलेज को हमेशा बढ़ा सकते हैं।
अब आपको अपने एजेंट को निर्देशों से ग्राउंड करना है। केवल एक सामान्य टेक्स्ट प्रॉम्प्ट (जैसे, "सेल्स के बारे में प्रश्नों का उत्तर दें") लिखने के बजाय, BigQuery का डेटा एजेंट इंटरफ़ेस AI की क्वेरी जनरेशन को गाइड करने के लिए अत्यंत संरचित संदर्भ प्रदान करने देता है। इसे ऐसे समझें जैसे आप किसी नए विश्लेषक को अपनी कंपनी की सटीक डेटा डिक्शनरी से ऑनबोर्ड कर रहे हों।
Instructions फ़ील्ड का उपयोग संरचित बिजनेस संदर्भ देने के लिए करें। यहाँ एक संपूर्ण, रेडी-टू-यूज़ उदाहरण है जिसे आप पेस्ट कर सकते हैं:
Synonyms: अपने कॉलम्स के वैकल्पिक पद परिभाषित करें ताकि एजेंट प्राकृतिक भाषा के विविध रूपों को समझ सके। उदाहरण: "Journey", "Ride" और "Commute" सभी bikeshare_trips टेबल में एक रिकॉर्ड को संदर्भित करते हैं। "Dock", "Hub" या "Station" bikeshare_stations टेबल में एक रिकॉर्ड को संदर्भित करते हैं।
Key fields: विश्लेषण के लिए सबसे महत्वपूर्ण फ़ील्ड्स को हाइलाइट करें। यह एजेंट को बताता है कि उपयोगकर्ता का प्रश्न व्यापक हो तो किस कॉलम को प्राथमिकता देनी है। उदाहरण: सामान्य रिपोर्टिंग के लिए trip_id, start_station_name, end_station_name, subscriber_type, start_time और duration_minutes को प्राथमिकता दें।
Excluded fields: ऐसे कॉलम निर्दिष्ट करें जिन्हें डेटा एजेंट को सख्ती से टालना चाहिए। यह अप्रचलित कॉलम या अप्रासंगिक डेटा छिपाने के लिए अत्यंत उपयोगी है। उदाहरण: अधिकांश विश्लेषण के लिए bikeshare_trips टेबल में bike_id कॉलम का उपयोग न करें, क्योंकि यह बिजनेस प्रश्नों के लिए शायद ही आवश्यक हो।
फ़िल्टरिंग और ग्रुपिंग: डेटा को स्लाइस करने के मानक तरीकों पर एजेंट को निर्देश दें। उदाहरण: जब तक अन्यथा निर्दिष्ट न हो, उन ट्रिप्स को हमेशा फ़िल्टर करें जहाँ duration_minutes < 1 (ये false starts या टेस्ट राइड्स हैं)। जब उपयोगकर्ता "by station" या "top stations" कहे, तो डिफ़ॉल्ट रूप से start_station_name के अनुसार समूहित करें।
जॉइन रिलेशनशिप्स: क्योंकि हमारा एजेंट कई टेबल से खींचता है, स्पष्ट रूप से परिभाषित करें कि वे कैसे जुड़ते हैं। इससे एजेंट गलत फ़ॉरेन कीज़ का अनुमान लगाने से बचेगा। उदाहरण: bikeshare_trips टेबल को bikeshare_stations टेबल से bikeshare_trips.start_station_id को bikeshare_stations.station_id से मिलाकर जॉइन करें (और end_station_id के लिए भी इसी तरह)।
ऊपर की सभी बातों को आप Instructions फ़ील्ड में एक साफ़ ब्लॉक में जोड़ सकते हैं। यहाँ एक परिष्कृत, पेस्ट-योग्य संस्करण है जिसमें संरचित गाइडेंस शामिल है:
You are a senior transportation analyst for the Austin Bikeshare program.
Core rules and defaults:
- Always filter on start_time unless the user specifies a different time field.
- Default time range for any "trend", "recent", "last month", or similar = last 30 days.
- "Top stations" means stations with the highest ridership (highest number of trips started).
- Exclude false start rides/test rides: never include trips where duration_minutes < 1.
- Display station names in final results; use station_id only for joins.
- Prefer clear, readable visualizations: bar charts for rankings, line charts for time-based trends.
Key fields: Prioritize trip_id, start_station_name, end_station_name, subscriber_type, start_time, and duration_minutes for most analyses.
Join relationships: Join bikeshare_trips to bikeshare_stations on bikeshare_trips.start_station_id = bikeshare_stations.station_id (and similarly for end_station_id).
Persona framework (very effective): Begin your instructions with a clear persona statement. This sets the tone, depth of analysis, and output style (e.g., “You are a senior transportation analyst…”).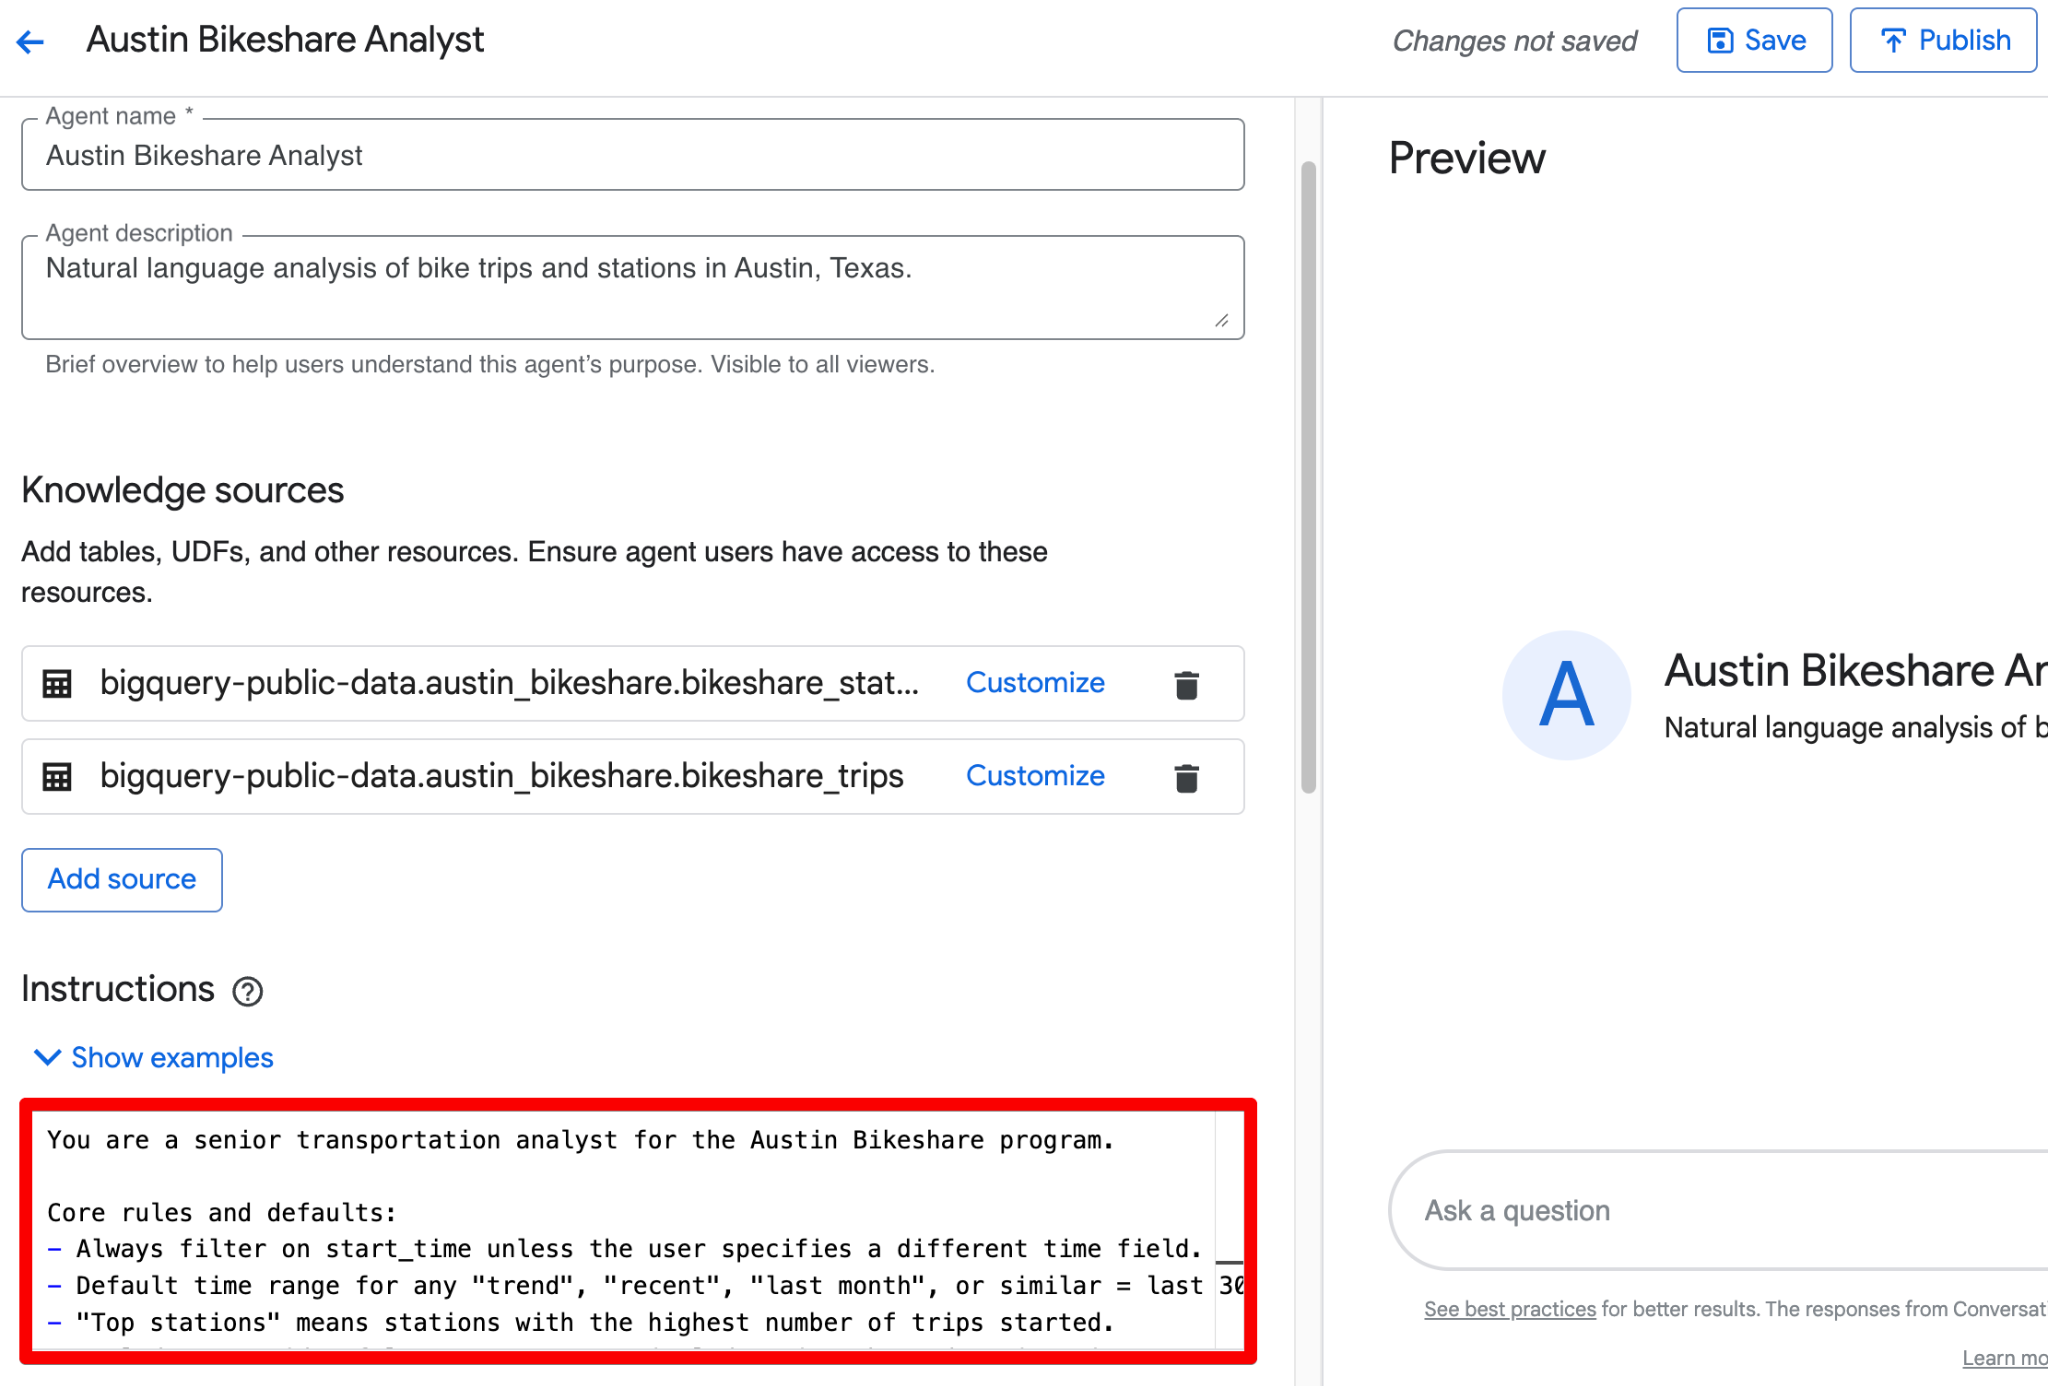
यह क्यों महत्वपूर्ण है: यदि आप ये फ़ील्ड खाली छोड़ते हैं, तो "हमारी टॉप सेल्स क्या थीं?" जैसे अस्पष्ट प्रश्न एजेंट को गलत टेबल्स जॉइन करने, निष्क्रिय अकाउंट्स से डेटा खींचने या अप्रचलित डेटा शामिल करने के लिए प्रेरित कर सकते हैं। इन पाँच श्रेणियों में अपने निर्देशों को संरचित करके, आप सुनिश्चित करते हैं कि जेनरेटेड SQL आपकी स्थापित बिजनेस लॉजिक का सख्ती से पालन करे।
निर्देशों के अलावा, आपको एजेंट में सीधे ग्लॉसरी टर्म्स भी परिभाषित करने चाहिए। ये एजेंट को बिजनेस जार्गन, संक्षेपाक्षर और व्युत्पन्न अवधारणाओं की सुसंगत व्याख्या करने में मदद करते हैं।
Glossary सेक्शन (आमतौर पर Instructions के पास) में Add term पर क्लिक करें और एक टर्म, उसकी परिभाषा और सिनोनिम्स (कॉमा से अलग) के साथ प्रविष्टि बनाएँ।
Austin Bikeshare डेटासेट के लिए अनुशंसित ग्लॉसरी टर्म्स ये हैं:
| टर्म | परिभाषा | सिनोनिम्स |
duration_minutes |
ट्रिप की अवधि मिनटों में। यूज़र-फेसिंग उत्तरों और गणनाओं के लिए हमेशा यही उपयोग करें | ride time, trip length, duration, ride duration |
ridership |
शुरू की गई बाइक ट्रिप्स की कुल संख्या (काउंट) | trips, rides, journeys, bike usage, commute count |
peak_hours |
सुबह पीक (7-9) या शाम पीक (16-19) घंटे, start_time से निकाले गए घंटे के आधार पर |
rush hour, busy hours, high demand period |
subscriber_type |
राइडर का प्रकार — Subscriber (मासिक या वार्षिक पास धारक) या Customer (वन-टाइम राइड | user type, membership type, pass holder, member, casual rider |
false_start |
बहुत छोटी ट्रिप (आमतौर पर 1 मिनट से कम) जो संभवतः टेस्ट राइड या आकस्मिक अनलॉक होती है। इन्हें सामान्यतः विश्लेषण से बाहर रखना चाहिए | test ride, invalid trip, short trip |
आप आवश्यकता अनुसार और टर्म्स जोड़ सकते हैं (उदाहरण के लिए, start_station_name, end_station_name, या "average trip duration" या "long ride" जैसे व्युत्पन्न मीट्रिक्स के लिए)।
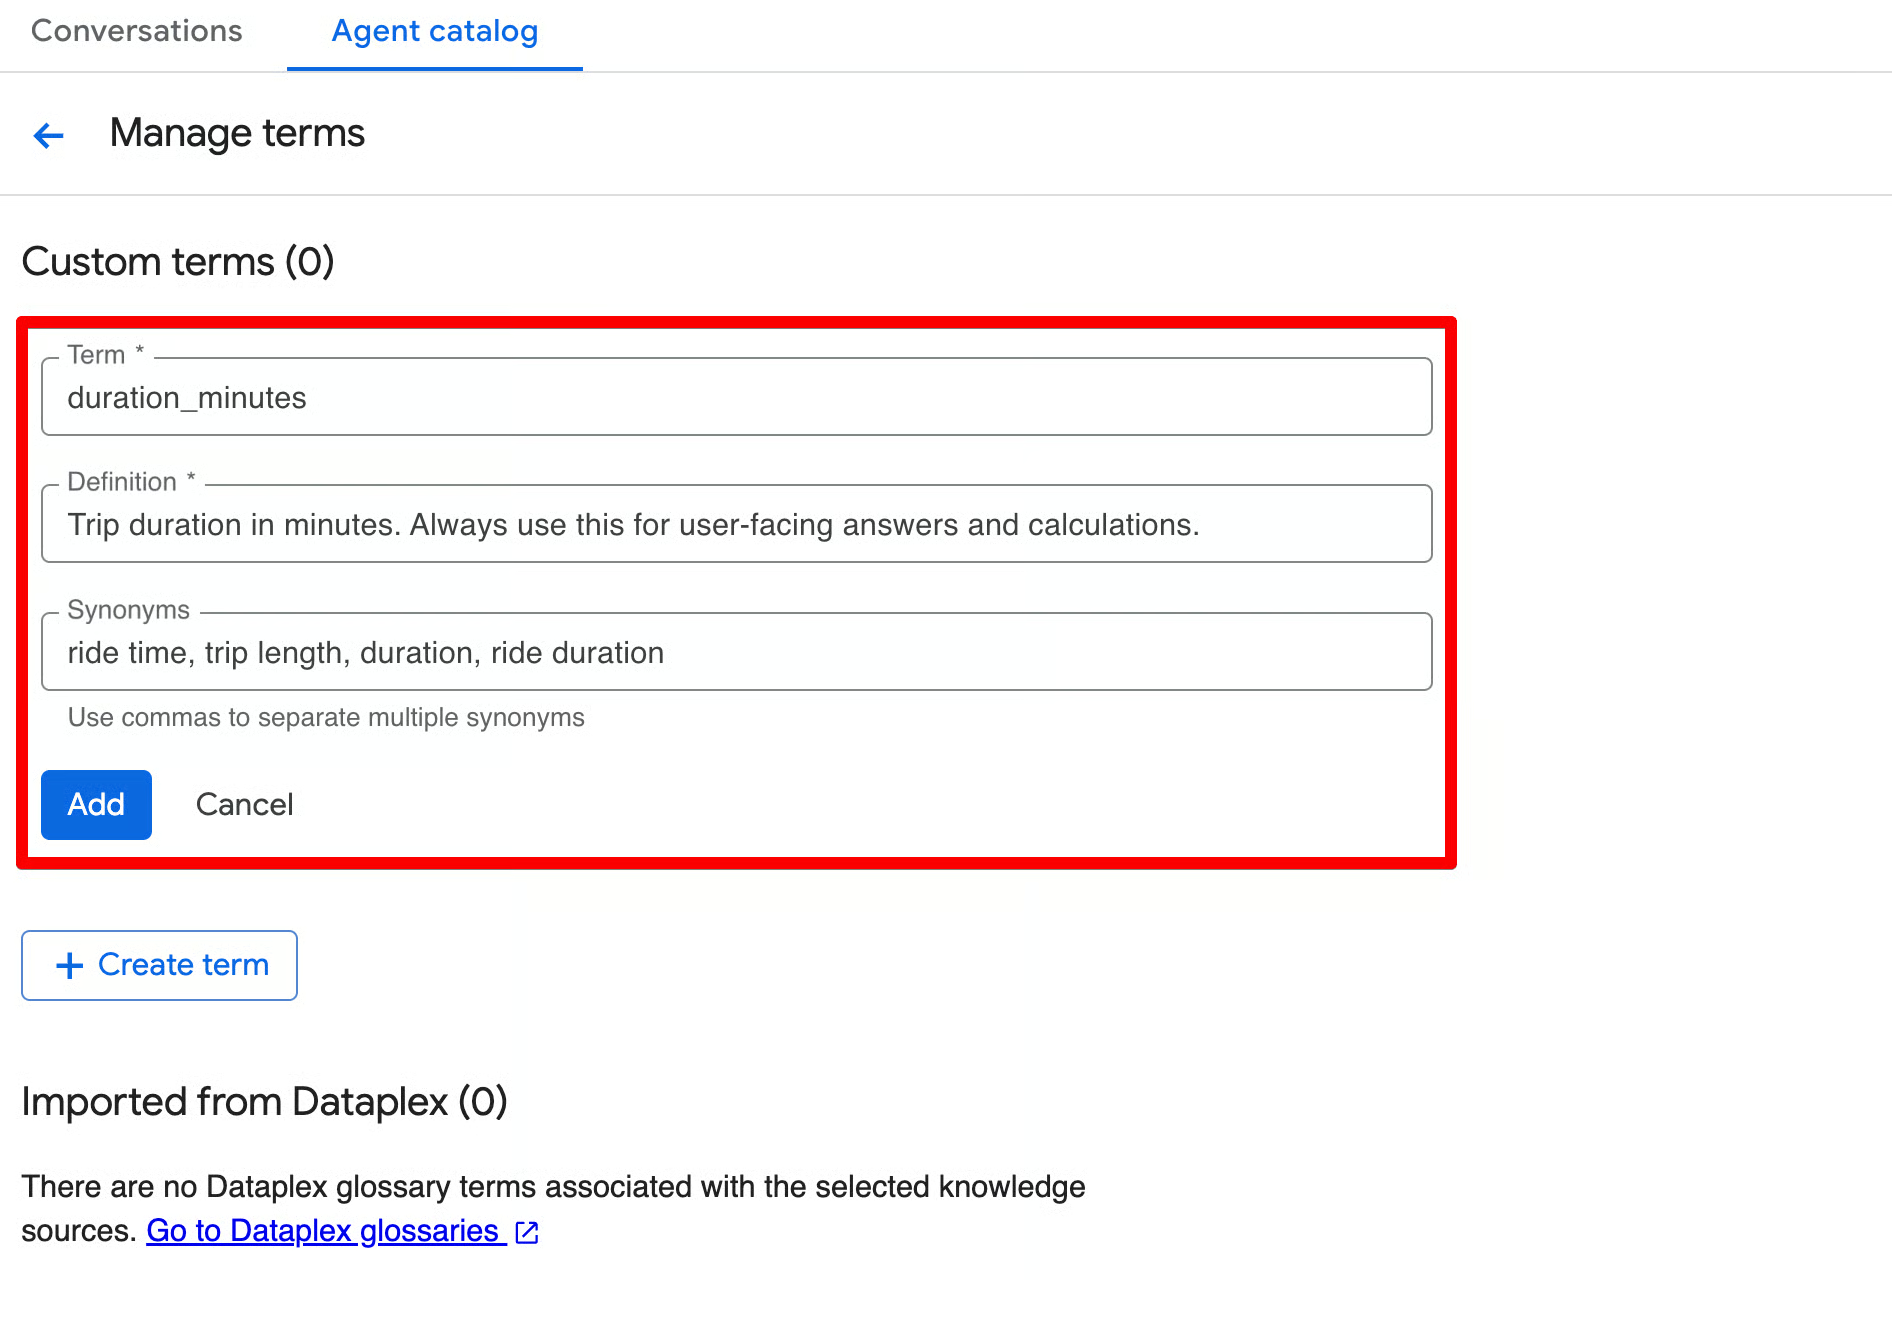
ग्लॉसरीज़ का उपयोग करके, यदि नेतृत्व अगली तिमाही में "Long Ride" की आधिकारिक परिभाषा 45 मिनट कर देता है, तो आपकी डेटा गवर्नेंस टीम को Dataplex में इसे केवल एक बार अपडेट करना होगा। उस ग्लॉसरी से जुड़े हर डेटा एजेंट तुरंत नई लॉजिक अपना लेंगे, जिससे संगठन भर में सुसंगतता बनी रहेगी।
एक बार जब आप नॉलेज सोर्स, निर्देश और ग्लॉसरी टर्म्स कॉन्फ़िगर कर लें, तो प्रकाशन से पहले अपने एजेंट का परीक्षण करने का समय है।
स्क्रीन के दाएँ हिस्से में Preview पेन पर स्क्रॉल करें। यह लाइव चैट इंटरफ़ेस आपको एजेंट बनाते समय रीयल-टाइम में उससे इंटरैक्ट करने देता है। आप प्रश्न पूछ सकते हैं, एजेंट की रीज़निंग की समीक्षा कर सकते हैं, जेनरेटेड SQL की जाँच कर सकते हैं और तेज़ी से इटरेट कर सकते हैं।
Preview पेन दिखाता है:
इन चार बढ़ती जटिलता वाली क्वेरियों को आज़माएँ (डेटासेट की 2024 तक की रेंज के अनुरूप समायोजित):
एजेंट की प्रतिक्रिया में आपको यह दिखाई देगा:
सारांश — परिणामों का प्राकृतिक-भाषा में स्पष्टीकरण।
क्वेरी परिणाम — डेटा के साथ एक साफ़ टेबल (जैसे, कुल ट्रिप्स, शीर्ष स्टेशन, या औसत अवधि)।
इनसाइट्स — बुलेट-पॉइंट निष्कर्ष जो परिणामों की बिजनेस संदर्भ में व्याख्या करते हैं।
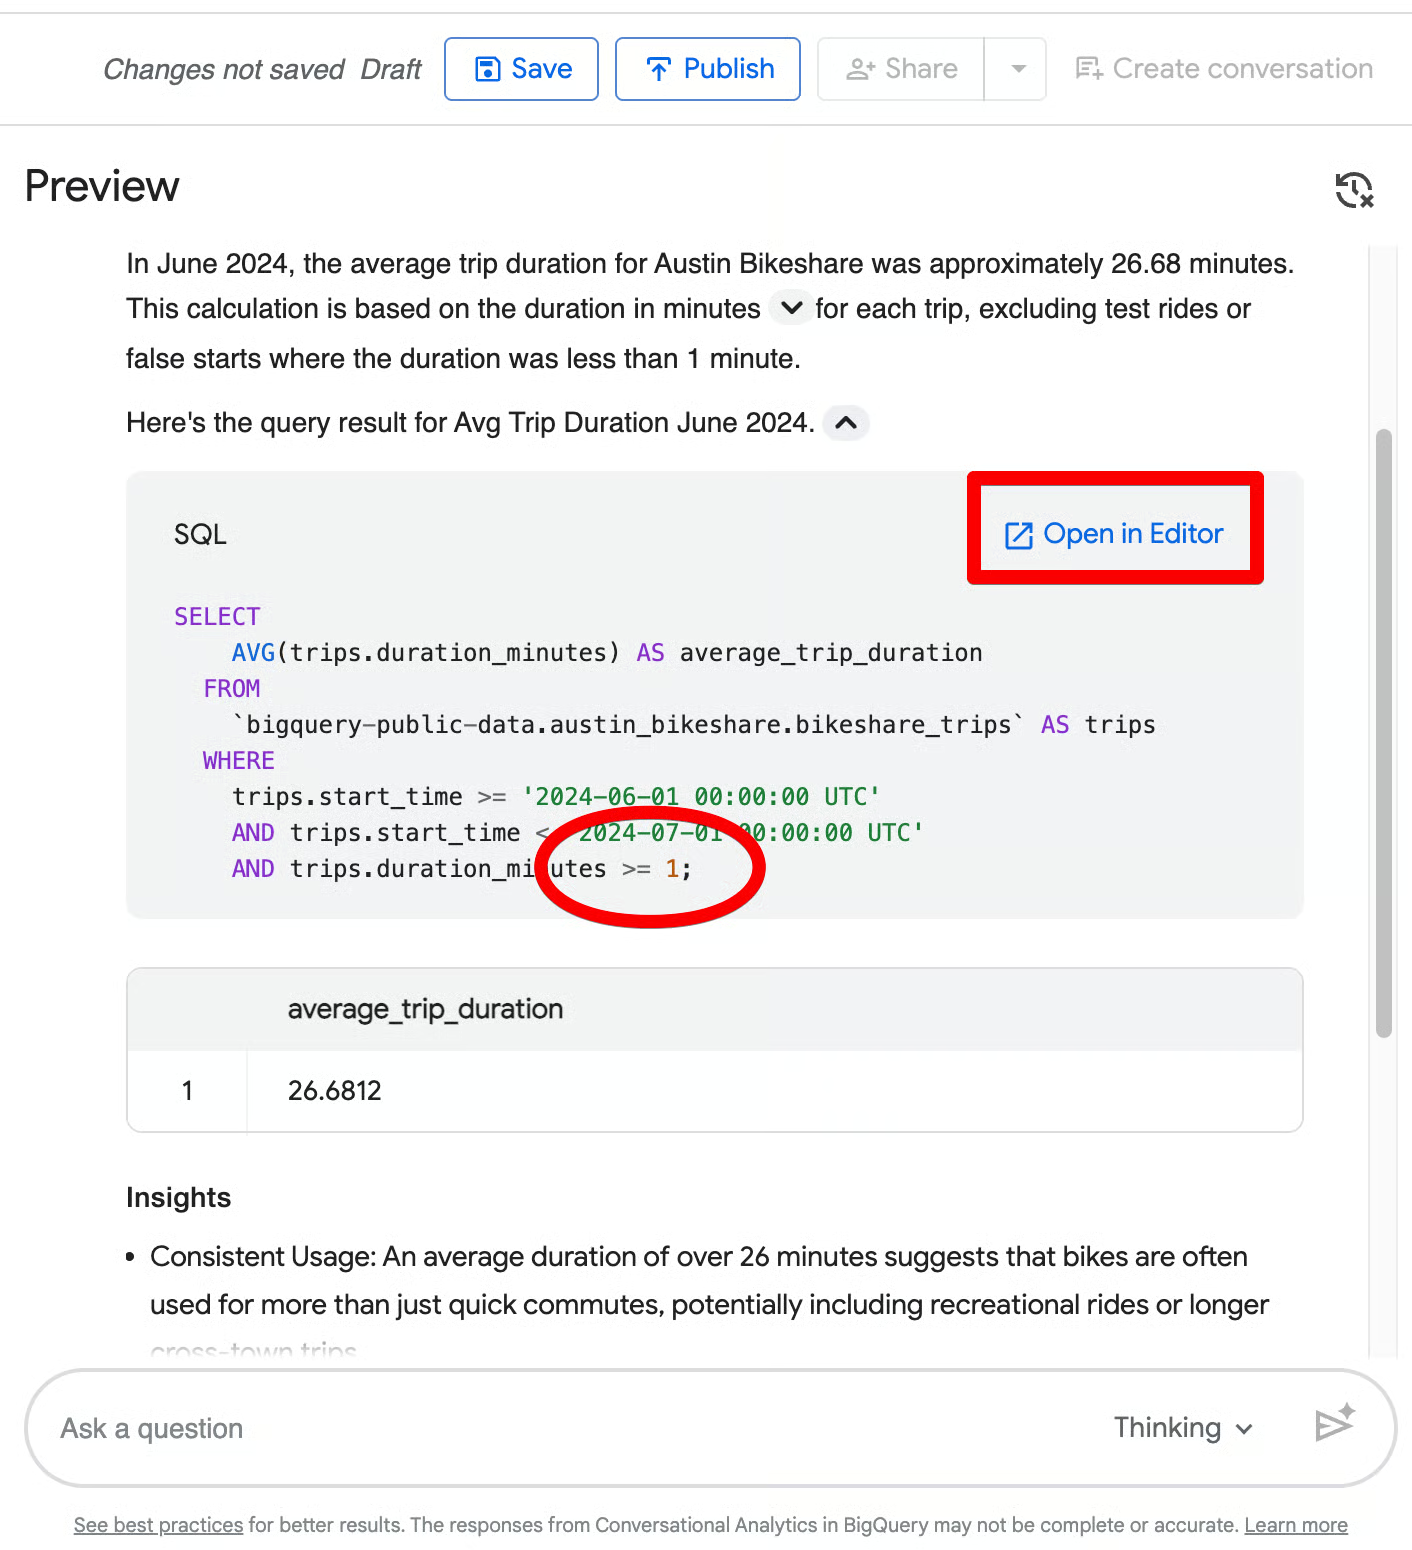
जनरेटेड SQL — Open in Editor पर क्लिक करें ताकि एजेंट द्वारा बनाई गई पूरी SQL क्वेरी देखें (आप देखेंगे कि यह सही ढंग से start_time पर फ़िल्टर करता है और false start राइड्स को बाहर करने के लिए duration_minutes >= 1 लागू करता है)।
सुझाए गए फॉलो-अप प्रश्न — नीचे उपयोगी प्रॉम्प्ट्स (जैसे, “जून 2024 में शीर्ष 10 स्टार्ट स्टेशन कौन से थे?”, “दैनिक ट्रिप्स का पूर्वानुमान…”, आदि)।
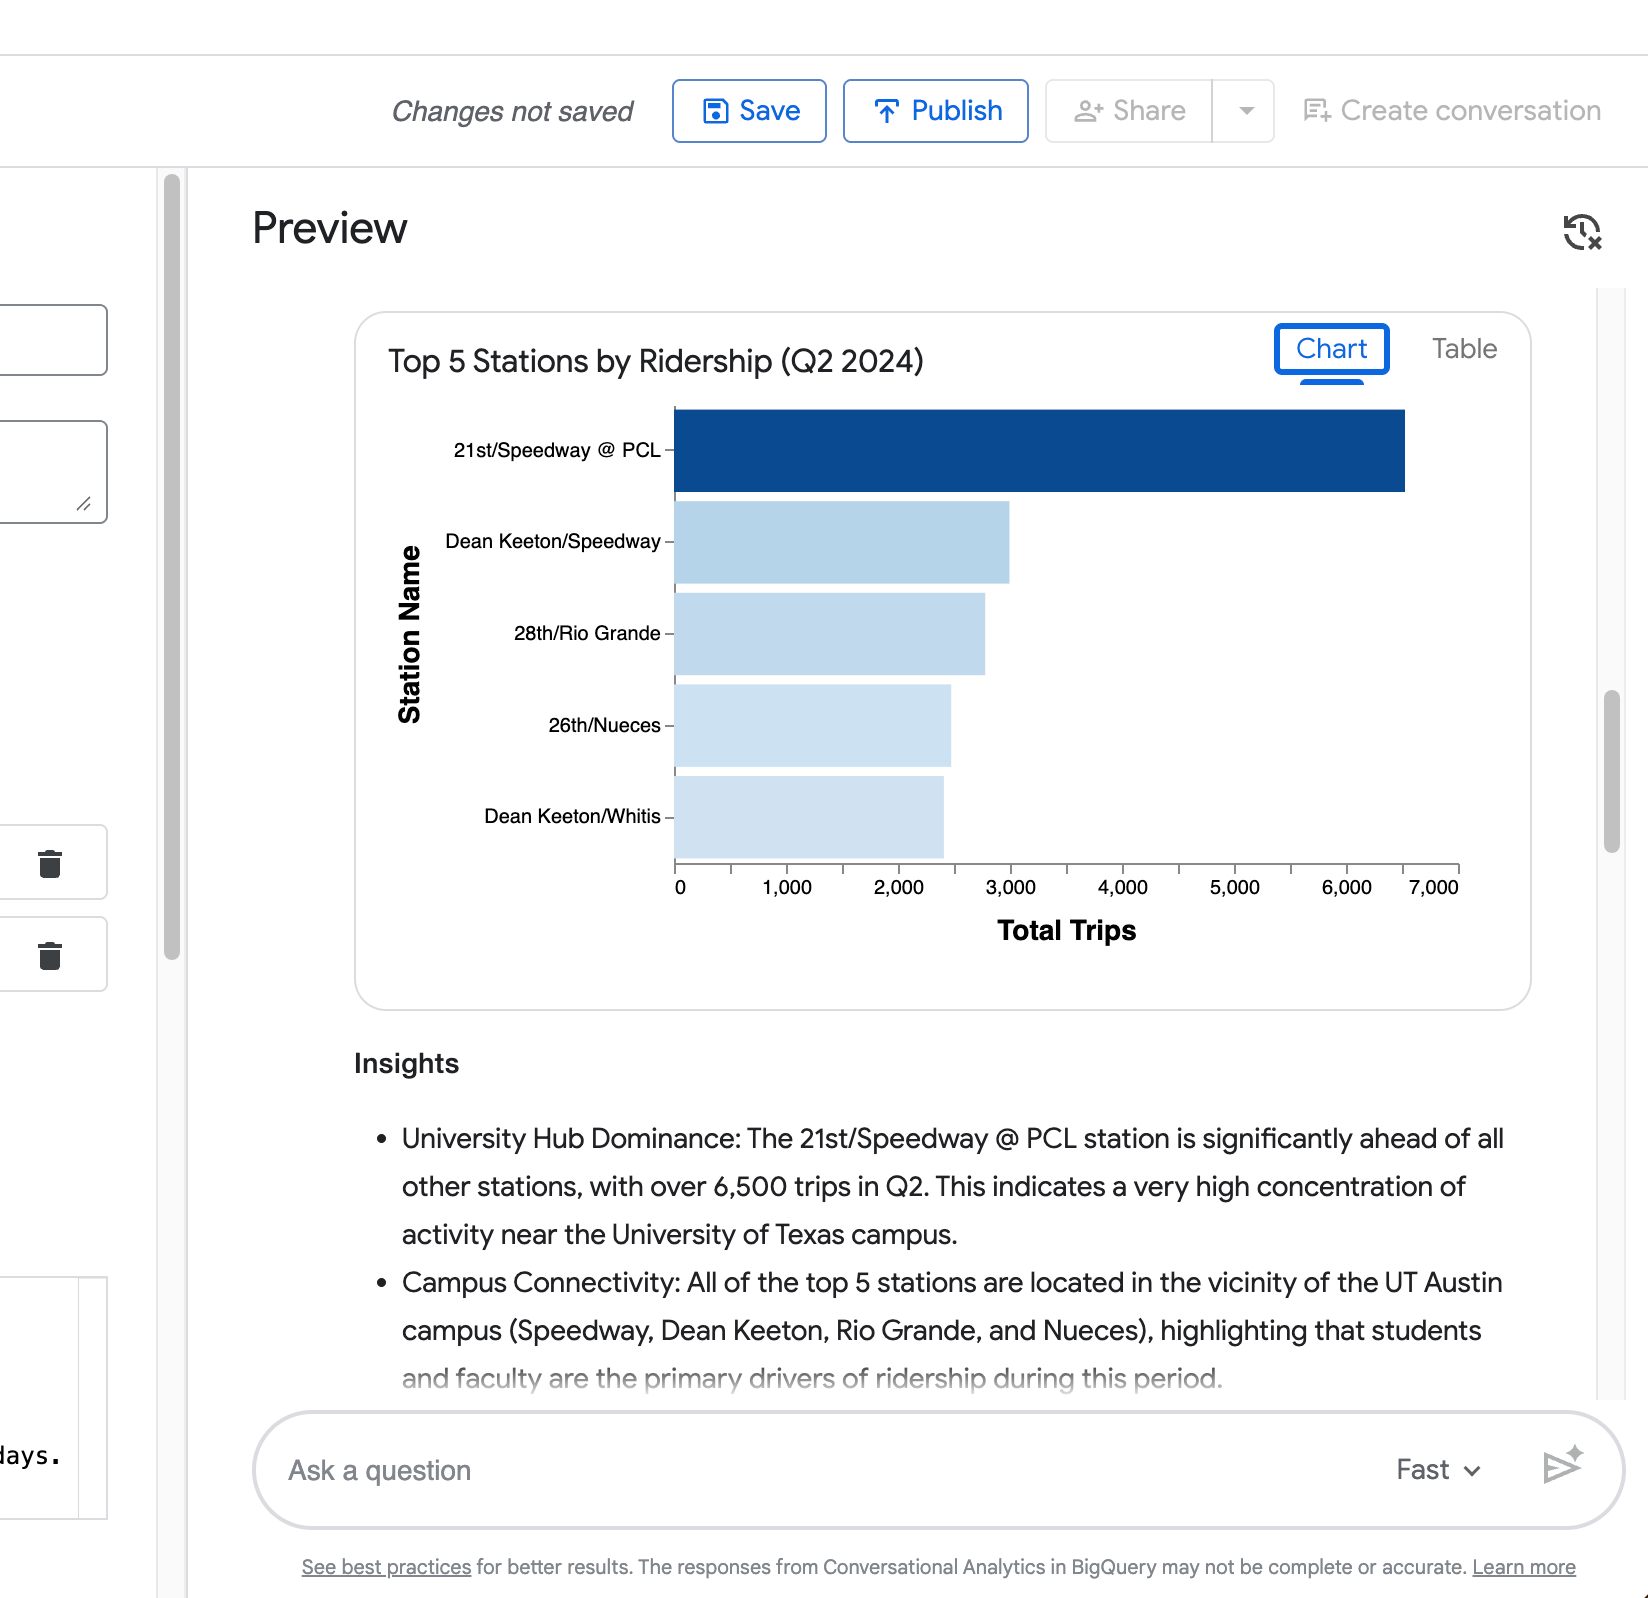
विज़ुअलाइज़ेशन — स्वतः जेनरेटेड चार्ट (रैंकिंग्स के लिए बार चार्ट, जैसा कि आपके शीर्ष 5 स्टेशनों के उदाहरण में देखा गया)।
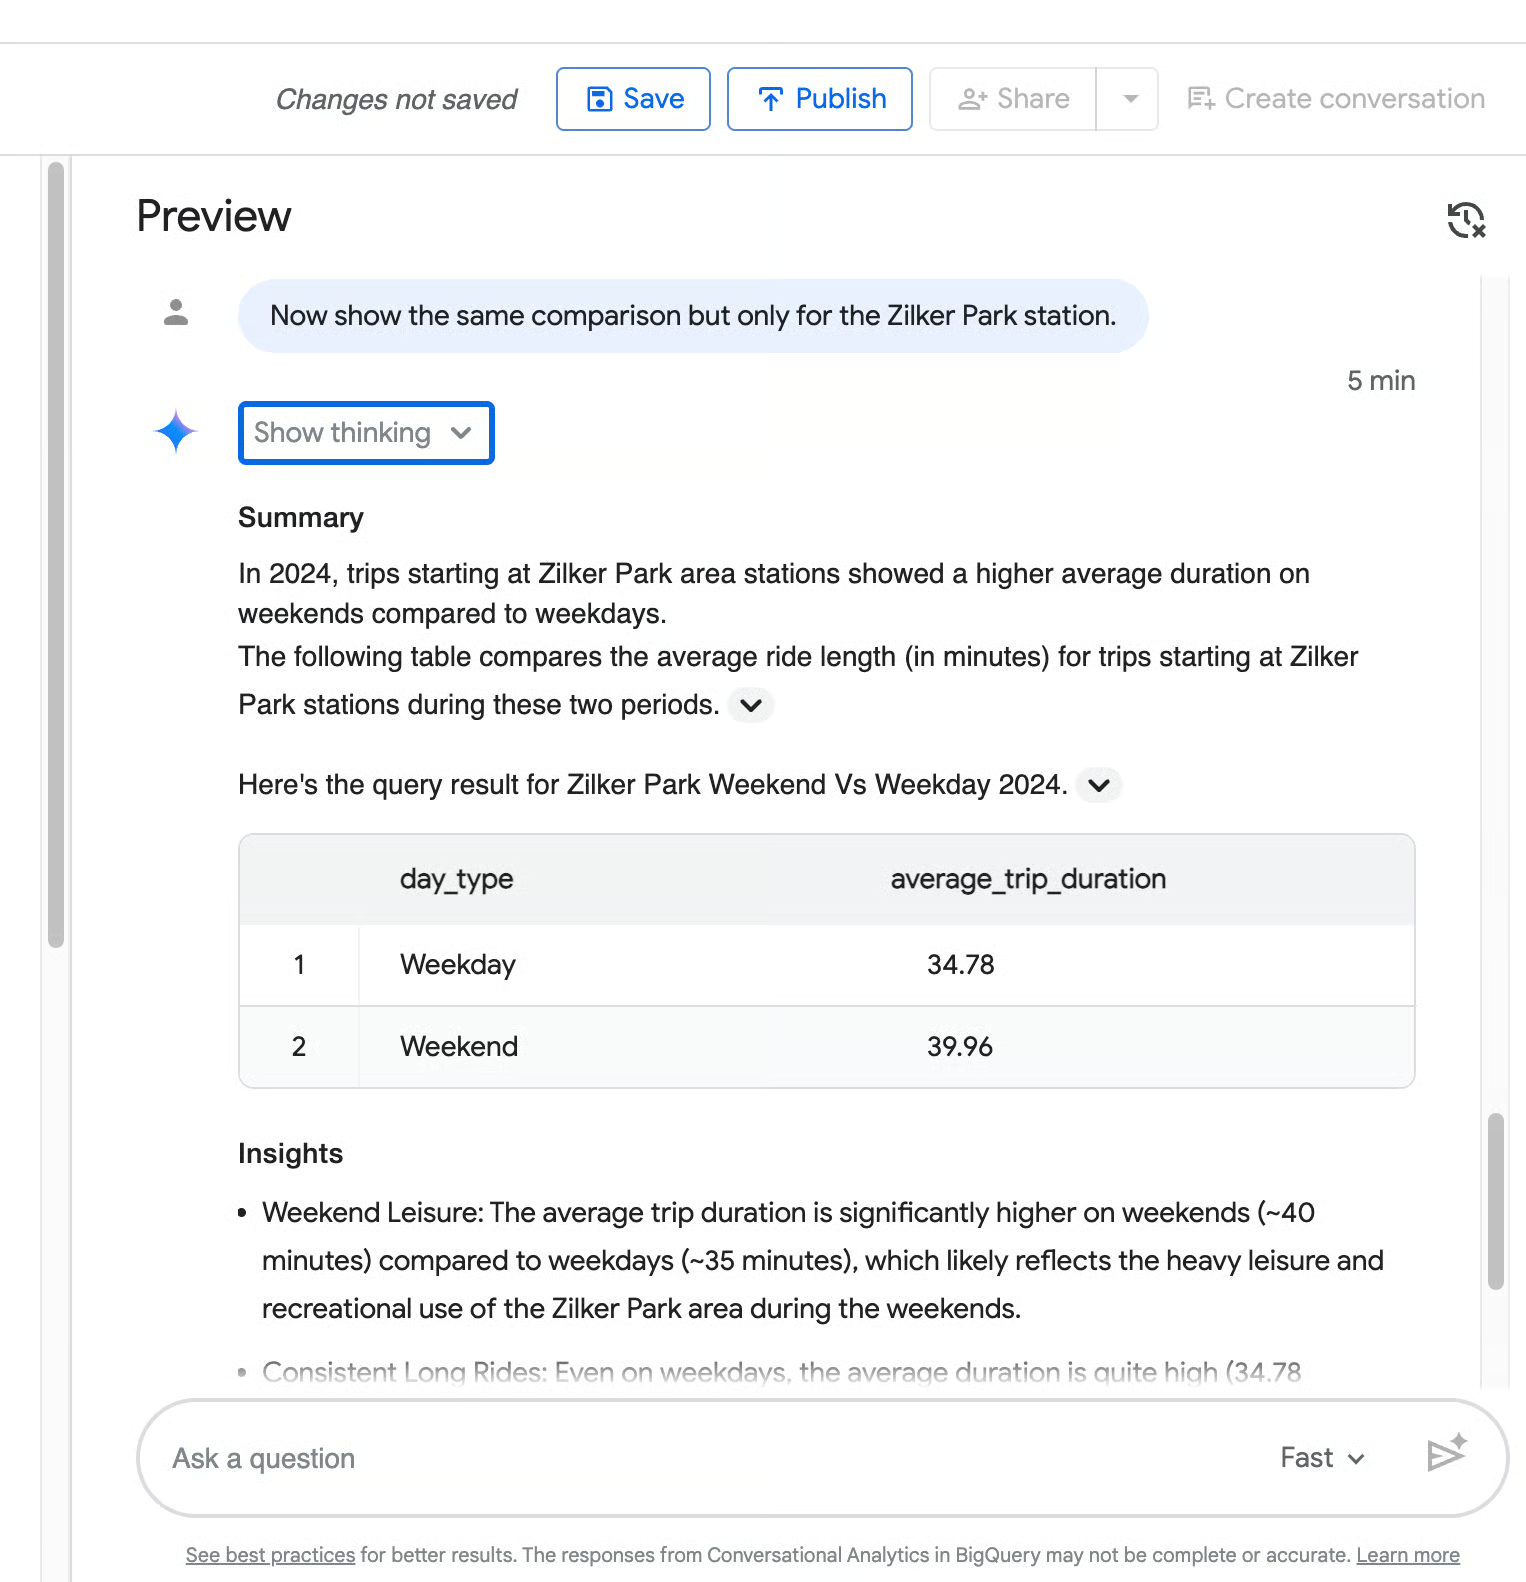
आपकी चौथी क्वेरी (“अब वही तुलना दिखाएँ लेकिन केवल Zilker Park स्टेशन के लिए”) एजेंट की पिछले प्रश्न के संदर्भ को बनाए रखने की क्षमता दर्शाती है।
जैसा कि निम्न स्क्रीनशॉट से स्पष्ट है, यह बिना आपके पूर्ण अनुरोध दोहराए, कार्यदिवस बनाम सप्ताहांत अवधि तुलना को सही ढंग से Zilker Park तक सीमित कर देता है।
टेस्टिंग टिप्स:
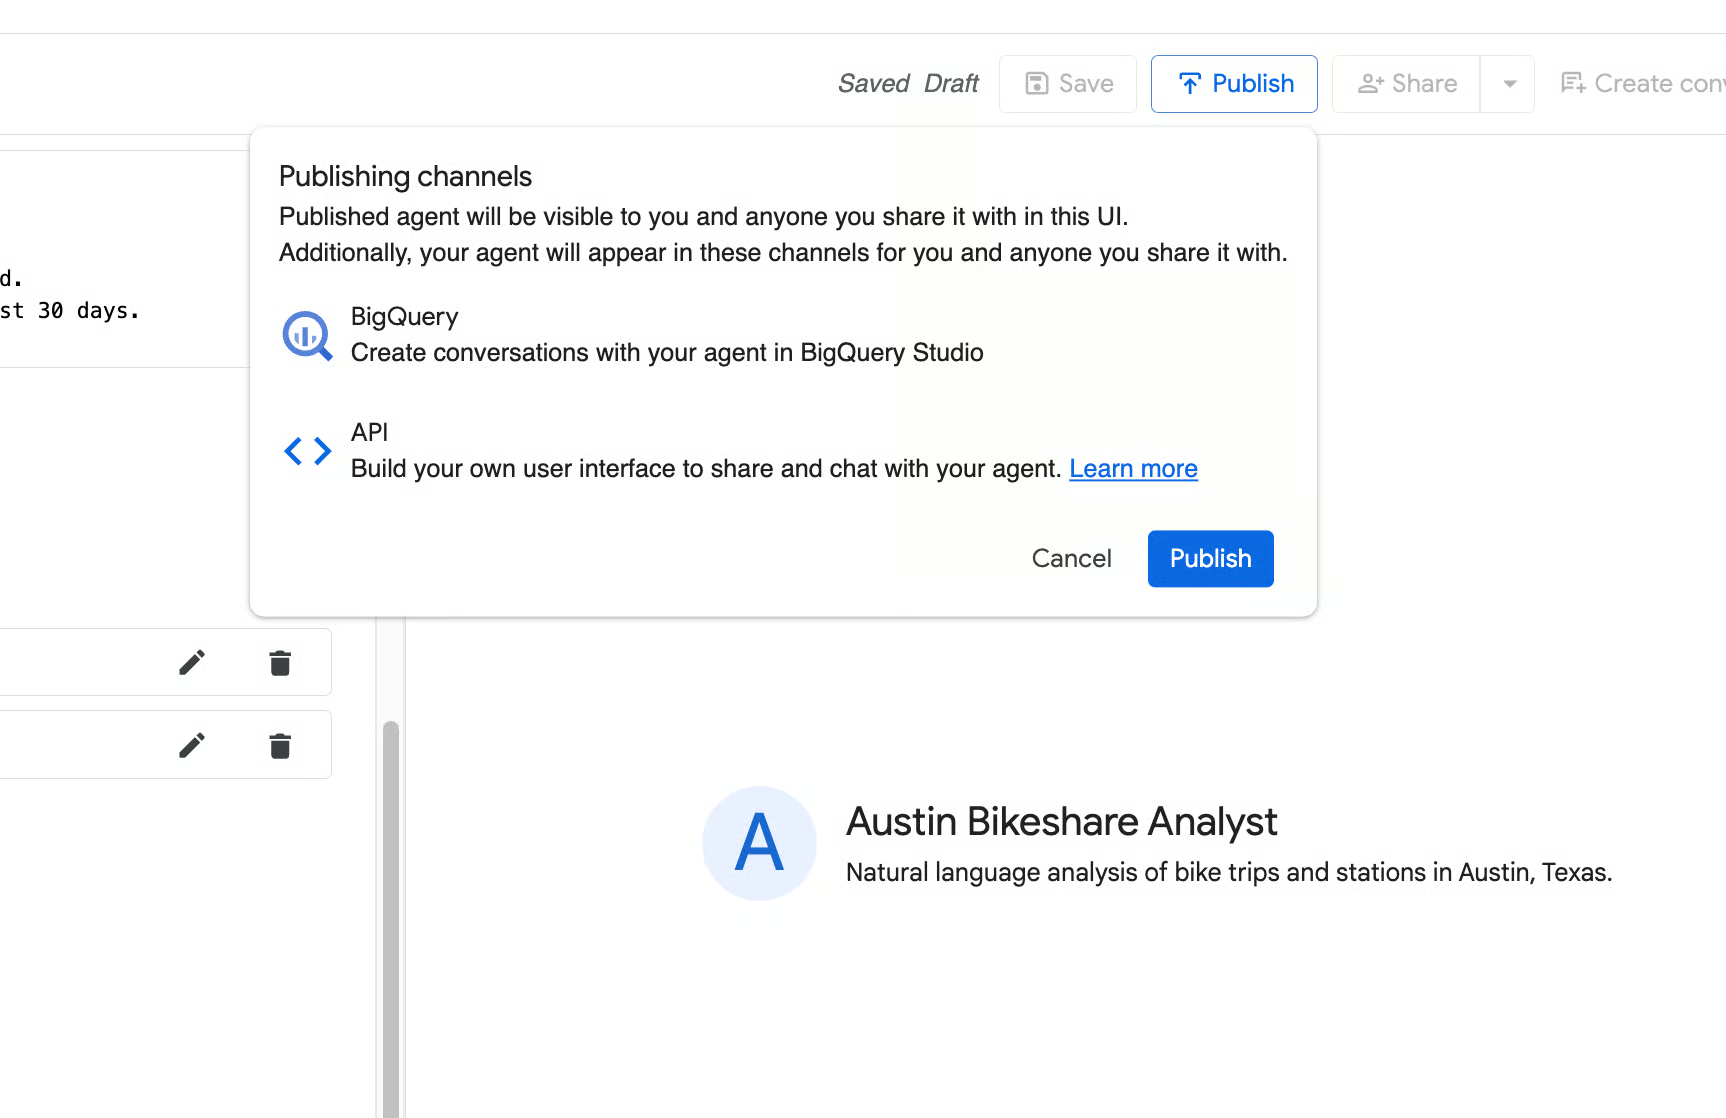
जब एजेंट लगातार स्पष्ट, सटीक और सुव्यवस्थित उत्तर देने लगे, तो ऊपर Save पर क्लिक करें, फिर Publish पर। आपका Austin Bikeshare Analyst एजेंट अब उपयोग के लिए तैयार है!
अच्छे निर्देशों और ग्लॉसरी टर्म्स के बावजूद, आपका डेटा एजेंट कभी-कभी बिजनेस नियमों को गलत समझ सकता है या असंगत उत्तर दे सकता है।
Verified queries इसका समाधान हैं—ये आपको महत्वपूर्ण या अक्सर पूछे जाने वाले प्रश्नों को संभालने का सही तरीका एजेंट को स्पष्ट रूप से सिखाने देती हैं। प्रत्येक सत्यापित क्वेरी एक प्राकृतिक भाषा प्रश्न और उसके साथ उस सटीक SQL की जोड़ी होती है जिसका उपयोग होना चाहिए।
ये उच्च-गुणवत्ता के उदाहरण के रूप में काम करती हैं जो एजेंट की रीज़निंग को एंकर करती हैं, और "किसी तरह ठीक" एजेंट से प्रोडक्शन-रेडी एजेंट तक जाने के सबसे प्रभावी तरीकों में से एक हैं।
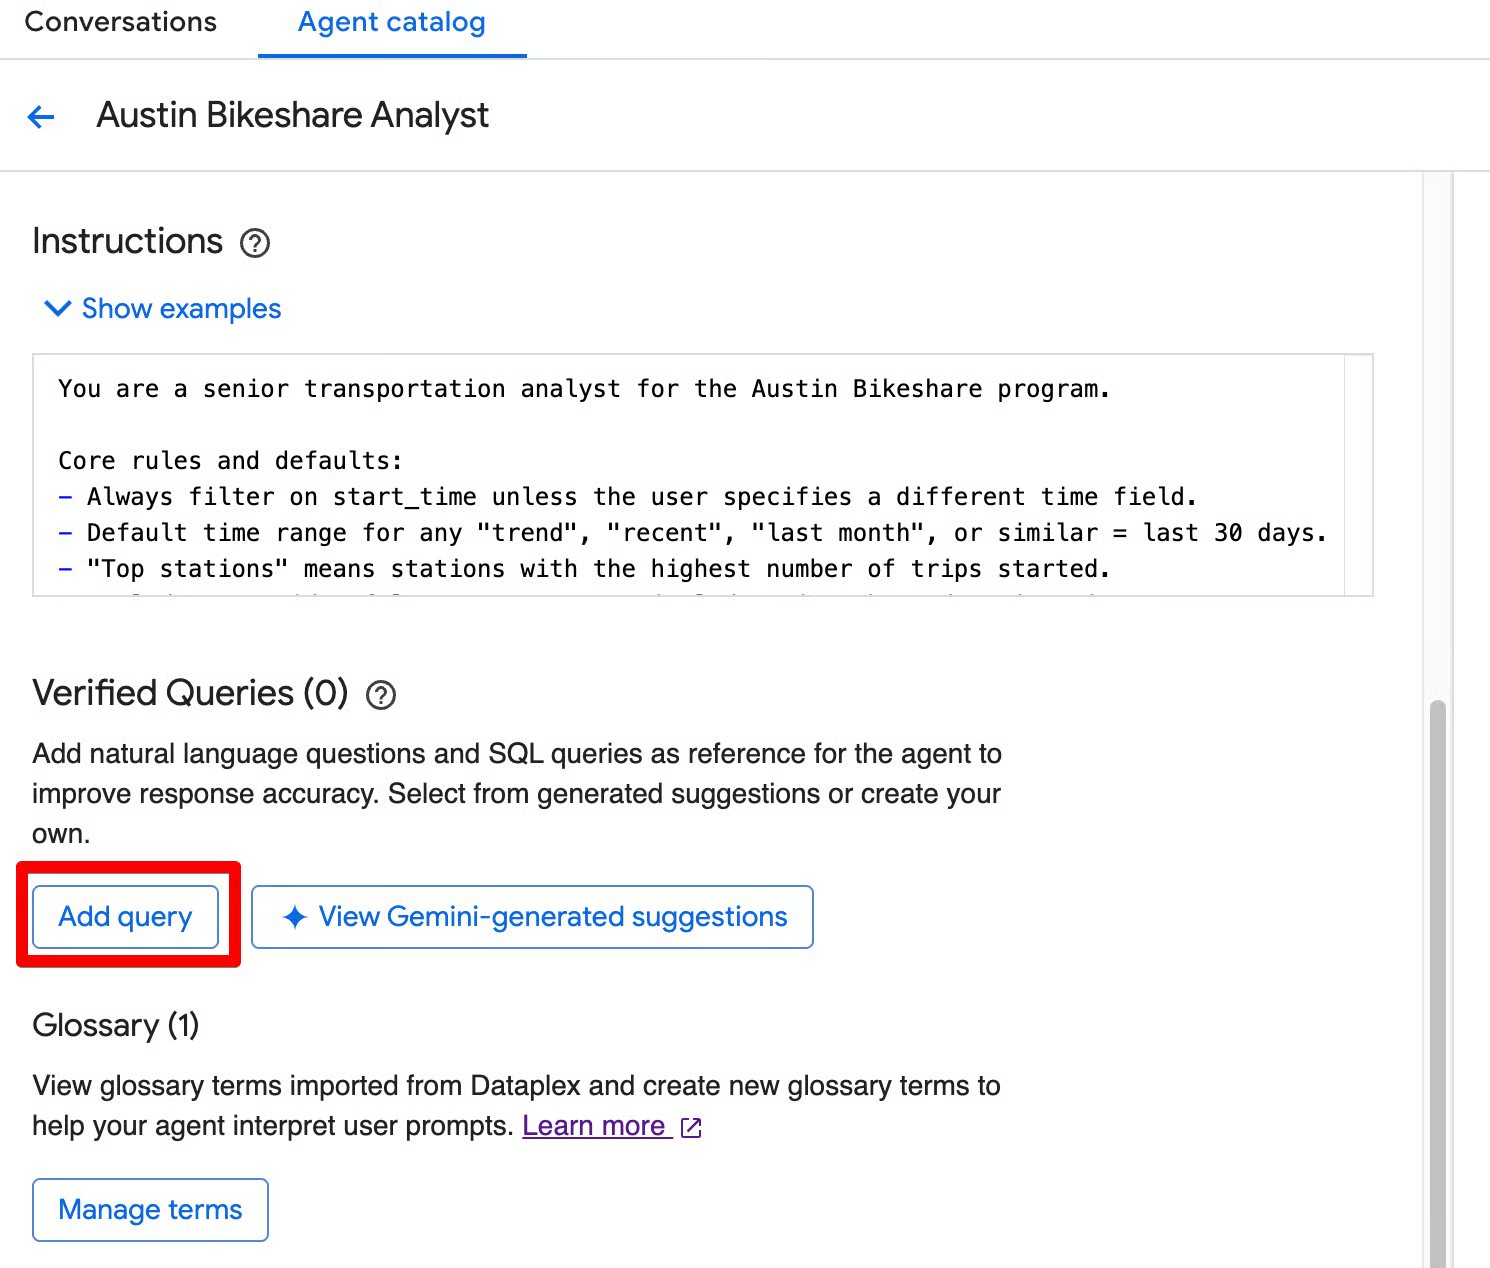
एजेंट एडिटर में, Verified Queries सेक्शन तक स्क्रॉल करें। सत्यापित क्वेरी जोड़ने के दो आसान तरीके हैं:
Add query पर क्लिक करें। आपको Add verified query स्क्रीन दिखेगी, जहाँ आप:
View Gemini-generated suggestions पर क्लिक करें। यह “Review suggested verified queries” स्क्रीन खोलता है, जहाँ Gemini आपके नॉलेज सोर्स के आधार पर प्रासंगिक प्रश्न प्रस्तावित करता है।
आप कर सकते हैं:
Austin Bikeshare डेटासेट के लिए एक अच्छी सत्यापित क्वेरी यह हो सकती है:
प्रश्न:
What were the top 5 stations by ridership in Q2 2024?SQL:
WITH
 QuarterlyRidership AS (
   -- Count trips starting at each station
   SELECT start_station_id AS station_id, COUNT(trip_id) AS ridership_count
   FROM bigquery-public-data.austin_bikeshare.bikeshare_trips
   WHERE TIMESTAMP_TRUNC(start_time, QUARTER) = TIMESTAMP '2024-04-01 00:00:00'
   GROUP BY start_station_id
   UNION ALL
   -- Count trips ending at each station
   SELECT
     CAST(end_station_id AS INT64) AS station_id,
     COUNT(trip_id) AS ridership_count
   FROM bigquery-public-data.austin_bikeshare.bikeshare_trips
   WHERE
     TIMESTAMP_TRUNC(start_time, QUARTER) = TIMESTAMP '2024-04-01 00:00:00'
     AND end_station_id IS NOT NULL
   GROUP BY CAST(end_station_id AS INT64)
 )
SELECT stations.name AS station_name, SUM(qr.ridership_count) AS total_ridership
FROM QuarterlyRidership AS qr
INNER JOIN
 bigquery-public-data.austin_bikeshare.bikeshare_stations AS stations
 ON qr.station_id = stations.station_id
GROUP BY stations.name
ORDER BY SUM(qr.ridership_count) DESC
LIMIT 5;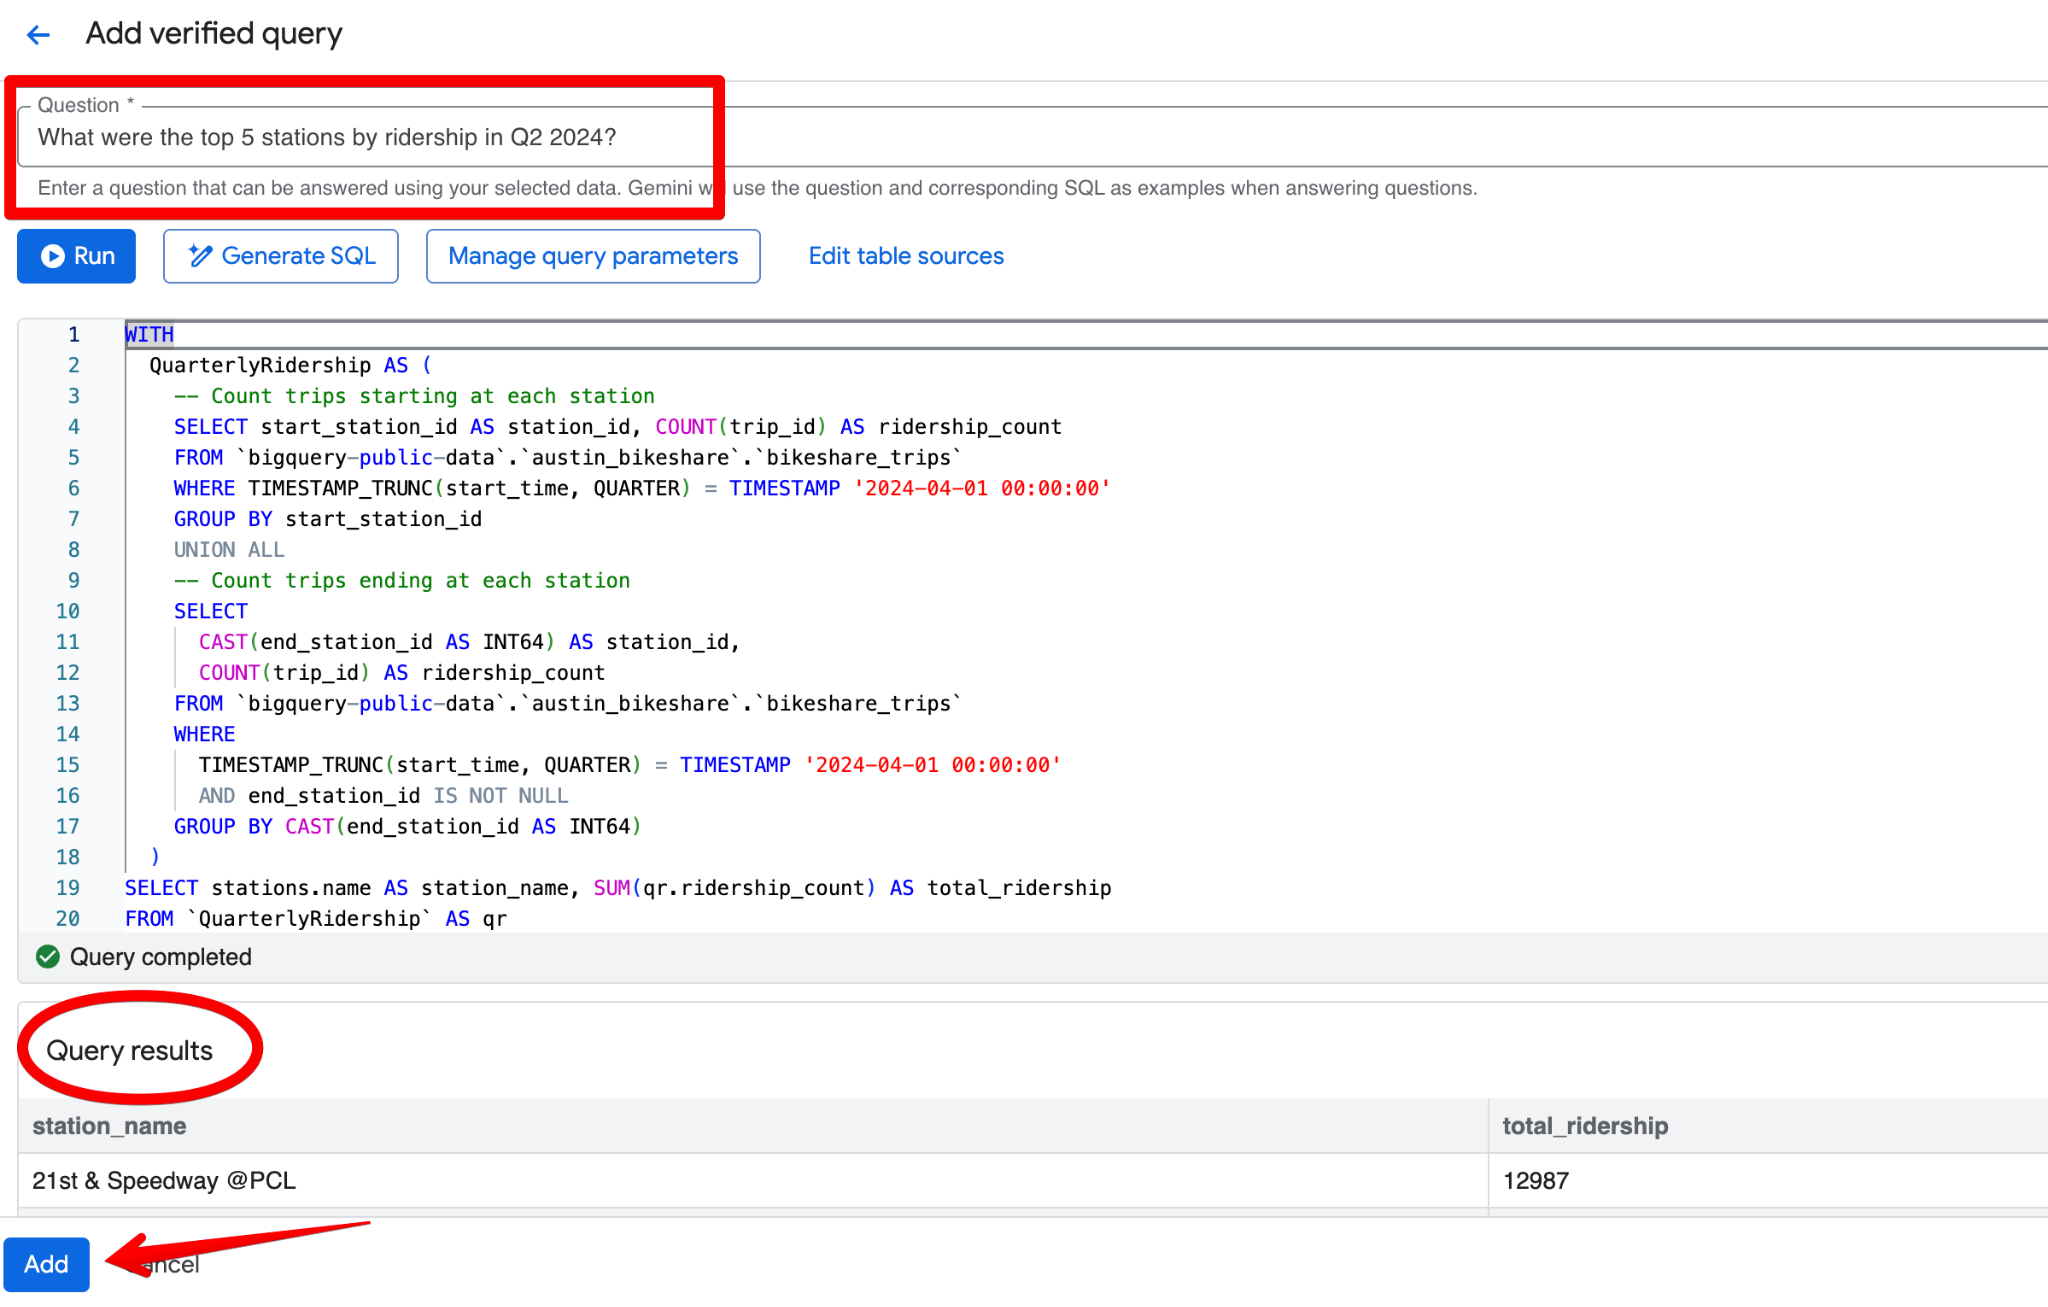
भले ही एजेंट पहली बार में उचित उत्तर दे, जेनरेटेड SQL की समीक्षा करके और सत्यापित क्वेरी जोड़कर आप इसे काफी अधिक सटीक और सुसंगत बना सकते हैं।
यह व्यावहारिक वर्कफ़्लो अपनाएँ:
मान लें, आपने पूछा, “जून 2024 में औसत ट्रिप अवधि क्या थी?” शुरुआती प्रतिक्रिया में एजेंट 26.68 मिनट लौटाता है और 1 मिनट से कम की ट्रिप्स को सही ढंग से बाहर रखता है। अब, मान लें कि टीम का मानक बिजनेस नियम 5 मिनट से कम की किसी भी ट्रिप को बाहर रखना है।
जब आप जेनरेटेड SQL (Open in Editor के माध्यम से) खोलते हैं, तो आप देखते हैं कि फ़िल्टर केवल duration_minutes >= 1 है।
Verified Queries सेक्शन में Add query पर क्लिक करें और यह प्रविष्टि बनाएँ:
प्रश्न:
What was the average trip duration in June 2024?SQL:
SELECT
  ROUND(AVG(duration_minutes), 2) AS avg_trip_duration_minutes
FROM
  bigquery-public-data.austin_bikeshare.bikeshare_trips
WHERE
  start_time BETWEEN '2024-06-01' AND '2024-06-30'
  AND duration_minutes >= 5;     -- stricter rule: exclude trips under 5 minutes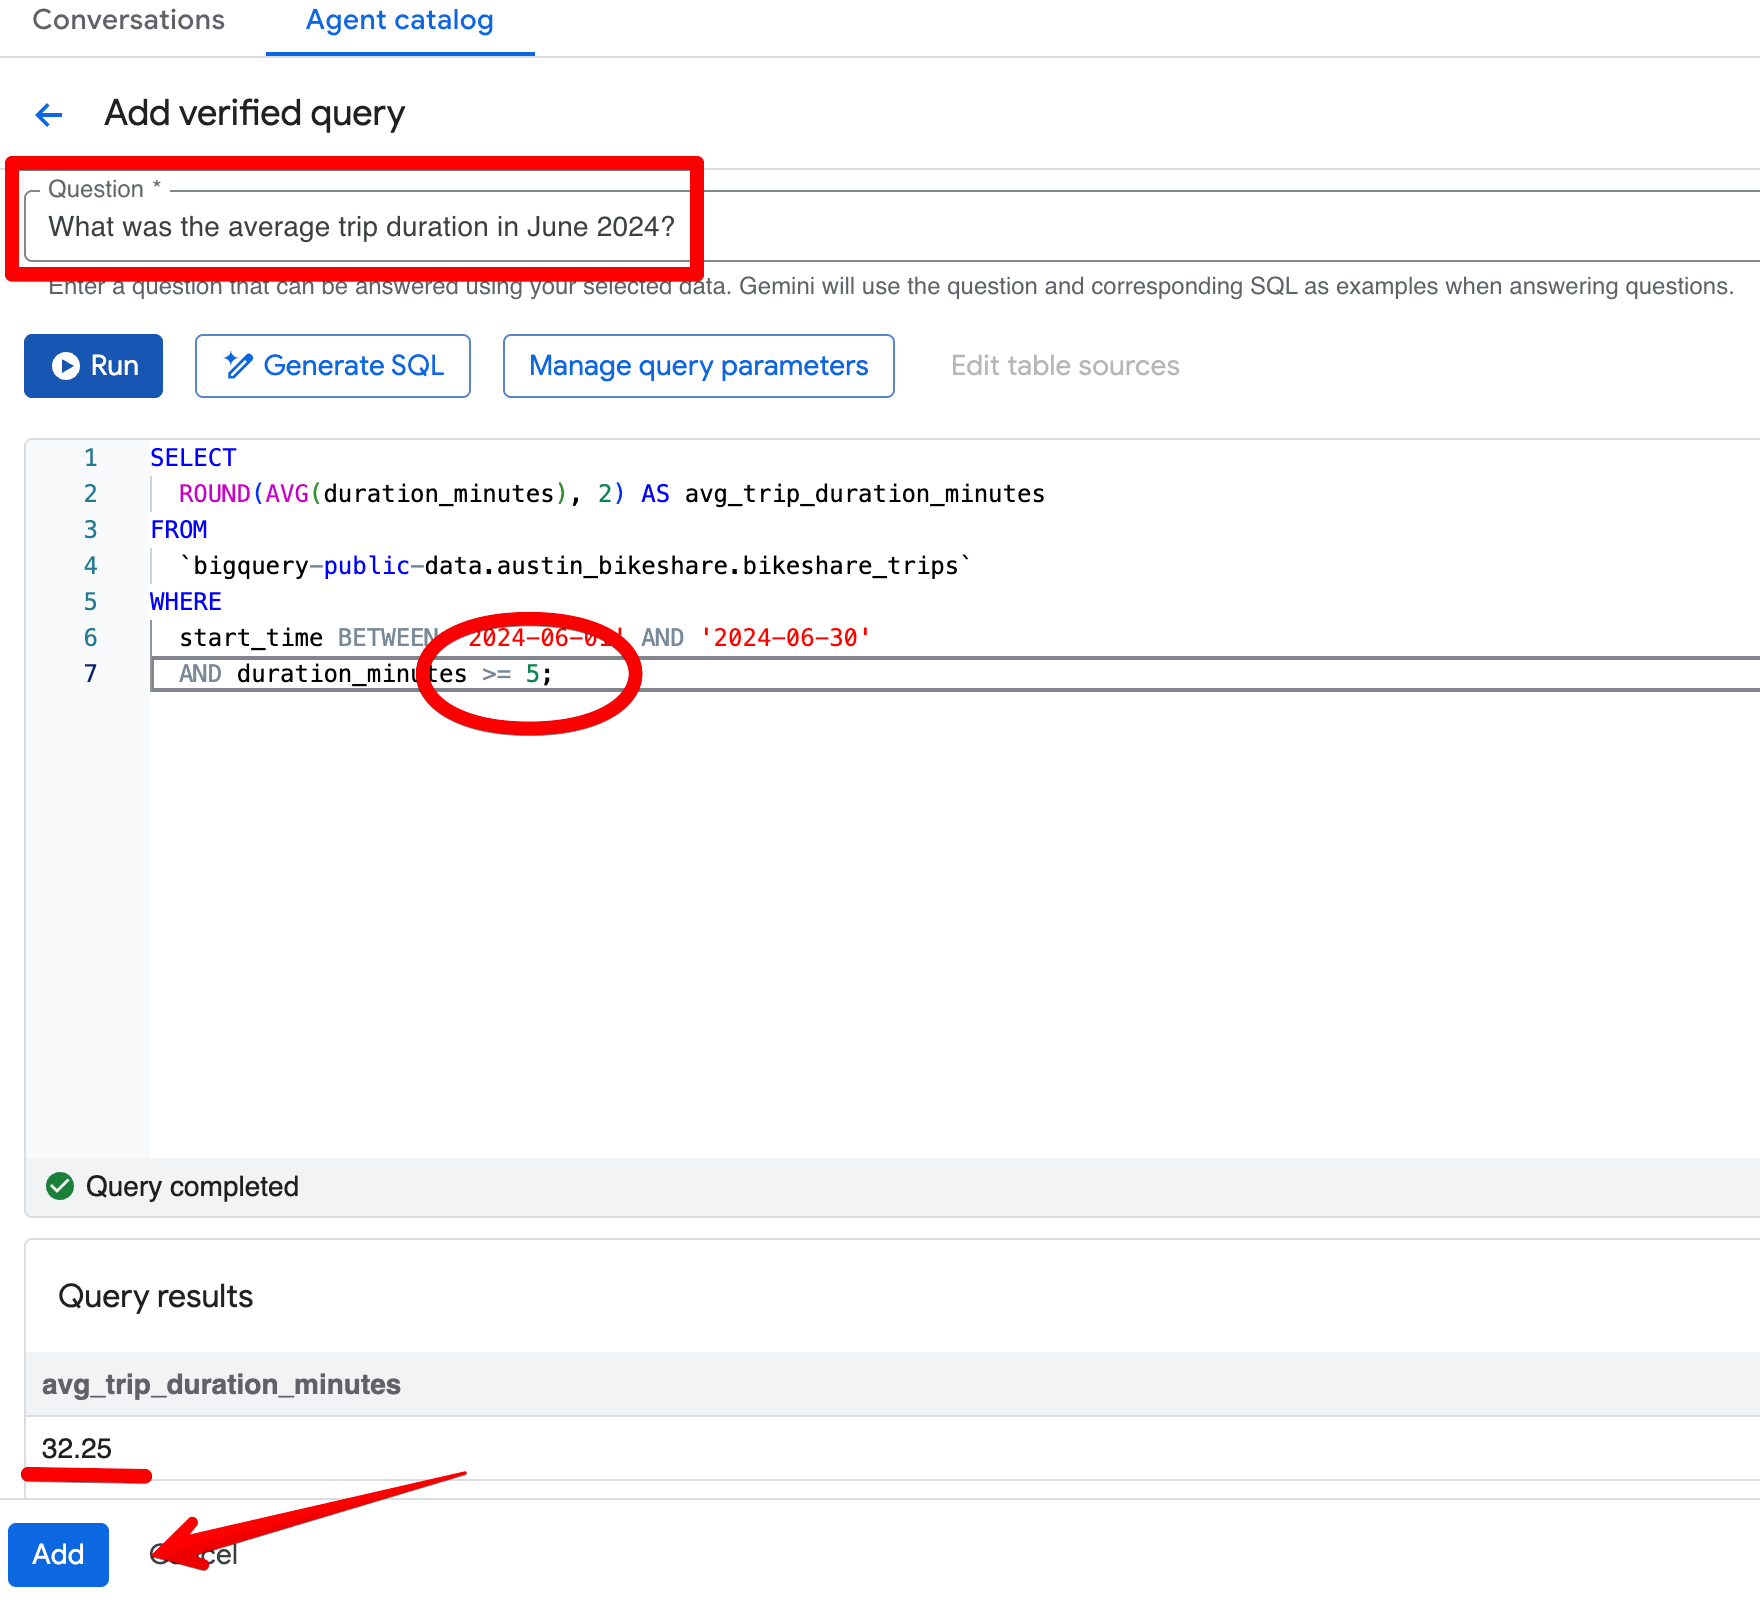
सत्यापित क्वेरी सेव करने के बाद, वही प्रश्न Preview पेन में फिर पूछें। अब एजेंट लगातार ~32.08 मिनट लौटाता है और आपका अधिक कड़ा 5-मिनट थ्रेसहोल्ड लागू करता है। परिणाम आपकी “अर्थपूर्ण” ट्रिप्स की बिजनेस परिभाषा के साथ अधिक संरेखित हो जाते हैं।
BigQuery का संवादी एनालिटिक्स BigQuery ML फ़ंक्शंस, अनस्ट्रक्चर्ड डेटा और Google Cloud इकोसिस्टम में आसान शेयरिंग के नैटिव सपोर्ट के कारण साधारण टेक्स्ट-टू-SQL टूल्स से अलग दिखता है।
सबसे बड़े अंतरकर्ताओं में से एक है एजेंट की क्षमता कि वह प्राकृतिक भाषा से सीधे BigQuery ML फ़ंक्शंस को कॉल कर सके—पिछड़े नज़रिये की रिपोर्टिंग से आगे बढ़कर फॉरवर्ड-लुकिंग इनसाइट्स तक।
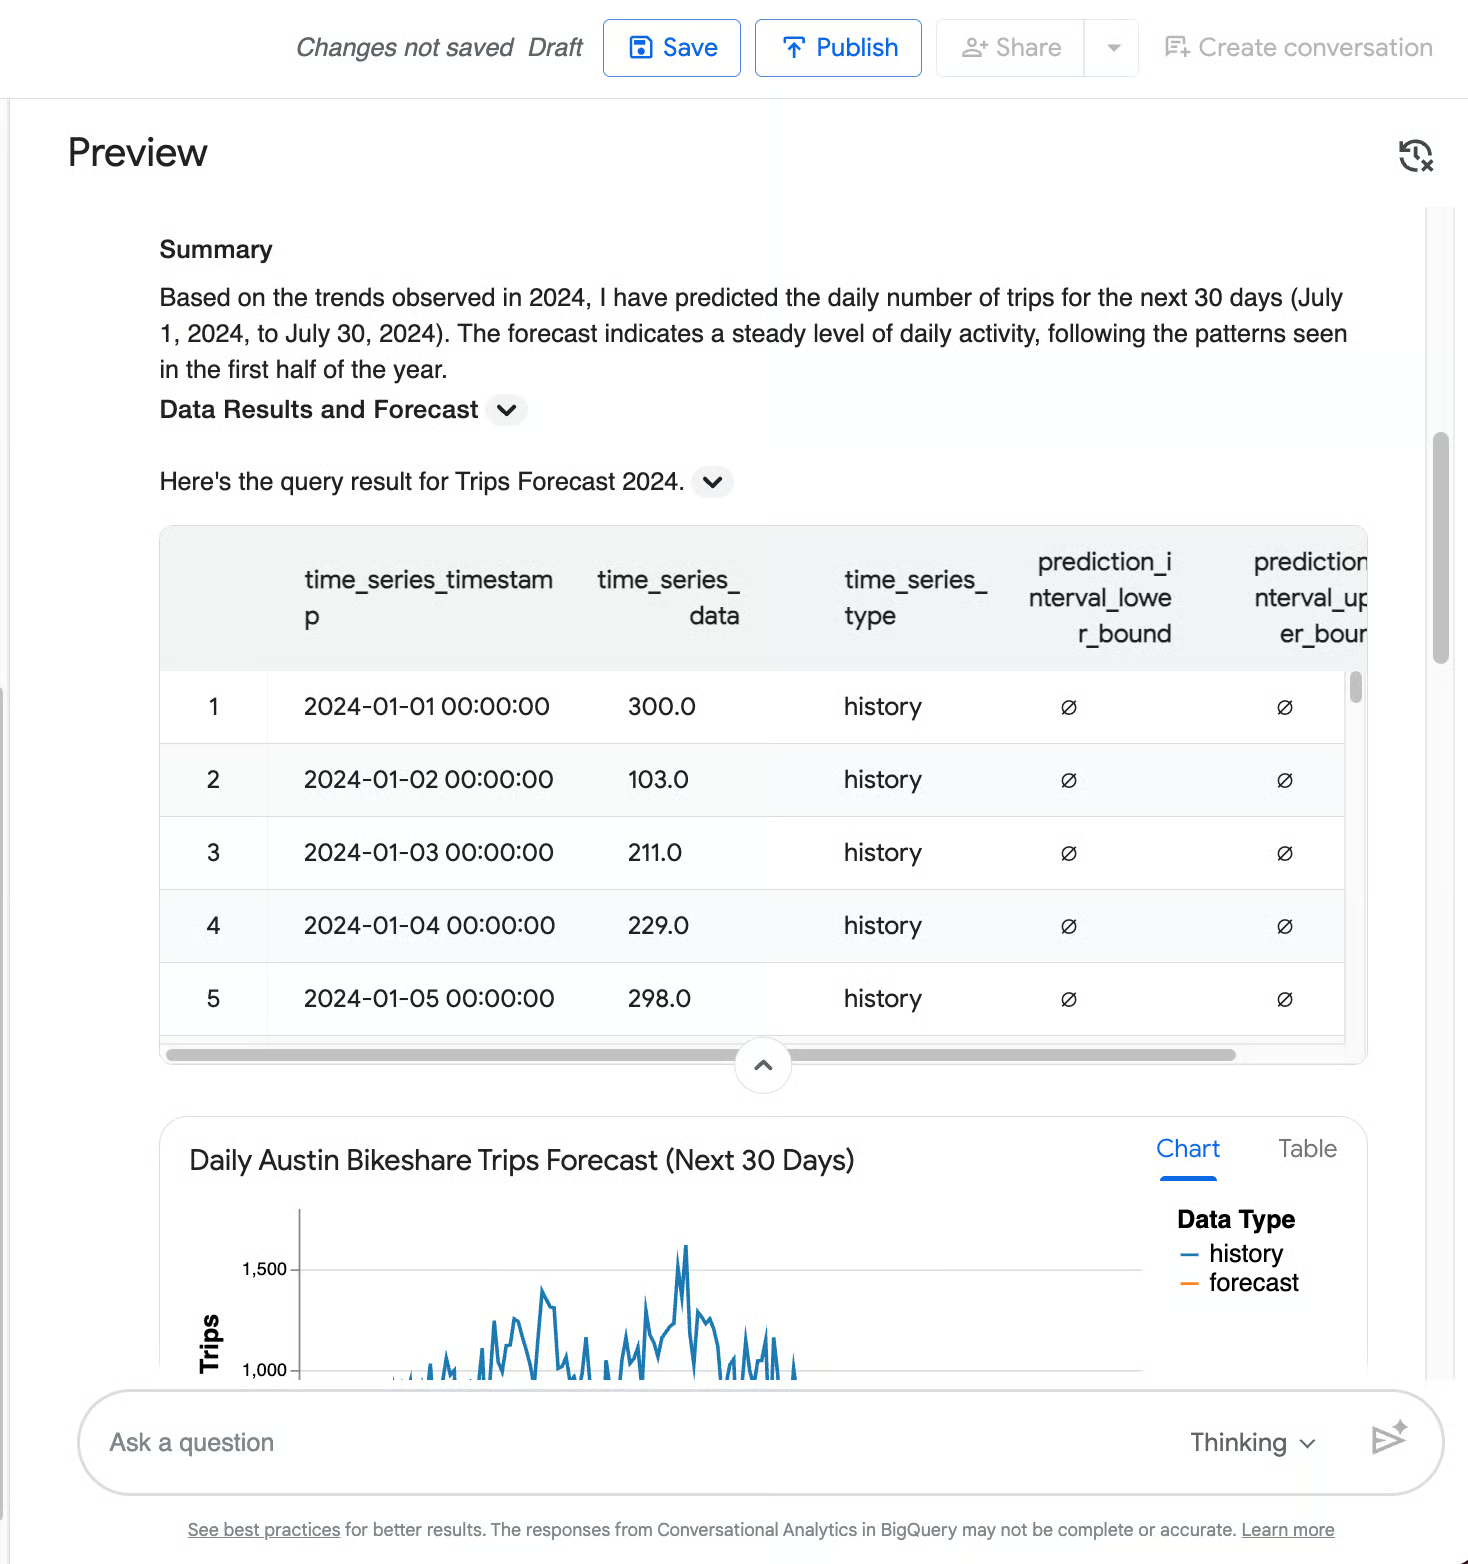
उदाहरण के लिए, आप किसी डेटा एजेंट से 2024 की प्रवृत्तियों के आधार पर अगले 30 दिनों के लिए दैनिक ट्रिप्स का पूर्वानुमान माँग सकते हैं। यह AI.FORECAST ट्रिगर करेगा, और जुलाई 2024 के लिए एक फोरकास्ट जेनरेट करेगा, साथ ही एक सुंदर चार्ट दिखाएगा जिसमें ऐतिहासिक दैनिक ट्रिप्स (नीली रेखा) और 30-दिवसीय फोरकास्ट (नारंगी रेखा) 95% कॉन्फिडेंस इंटरवल की शेडिंग के साथ दिखेंगे।
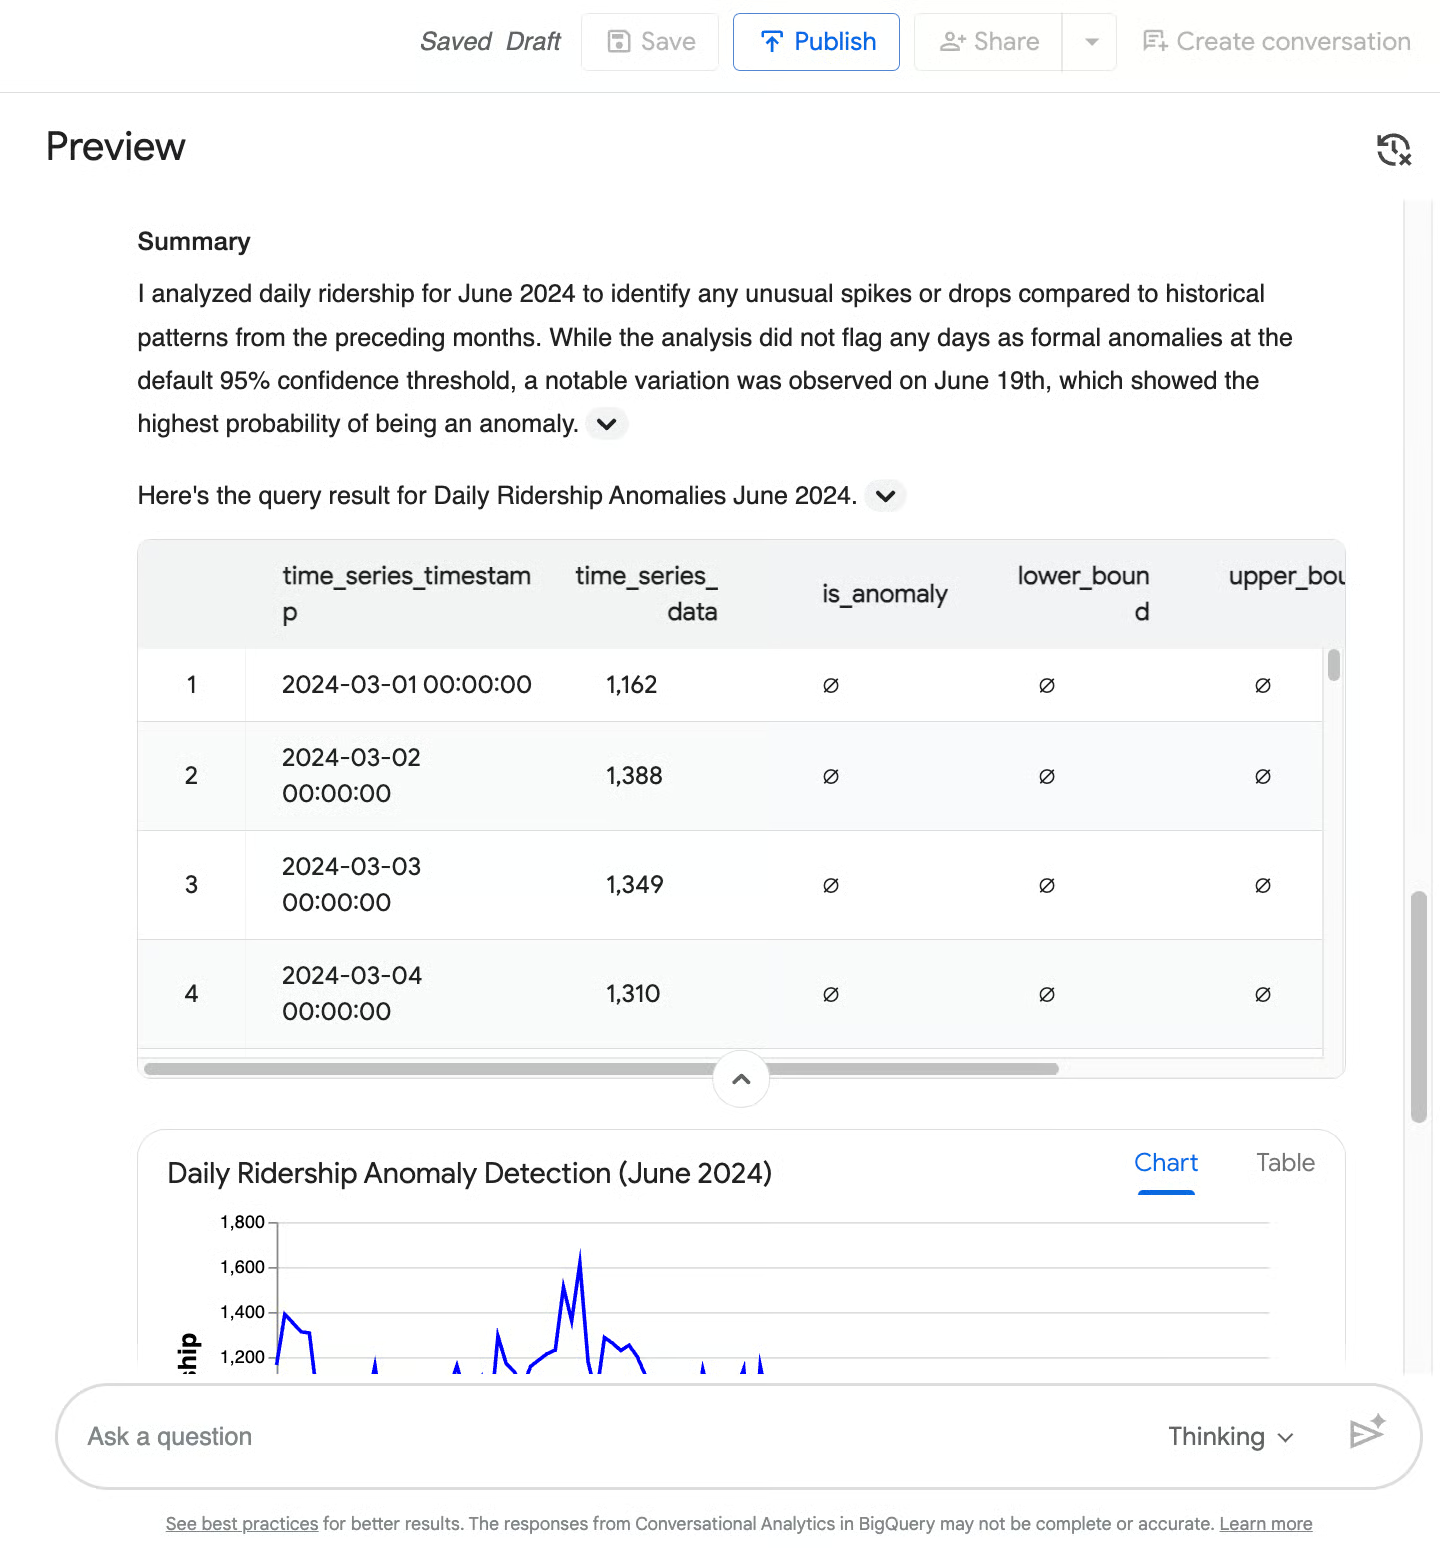
एक और तरीका जिसमें मशीन लर्निंग एल्गोरिद्म उपयोगी हो सकते हैं, वह है आपके डेटा में कुछ गड़बड़ी का पता लगाना। जब आप, उदाहरण के लिए, जून 2024 के दौरान दैनिक राइडरशिप में विसंगतियाँ (anomalies) ढूँढने को कहते हैं, तो एजेंट AI.DETECT_ANOMALIES को इनवोक करेगा, जून 2024 की तुलना पिछले महीनों से करेगा, और एक टाइम-सीरीज़ टेबल के साथ एक लाइन चार्ट लौटाएगा।
इस मामले में, इसने 95% कॉन्फिडेंस स्तर पर कोई औपचारिक एनोमली फ़्लैग नहीं की, लेकिन 19 जून को एक निकट-एनोमली (92.1% संभावना) के रूप में हाइलाइट किया, जिसमें राइडरशिप में स्पष्ट गिरावट थी।
अधिकांश संवादी BI टूल्स तब विफल हो जाते हैं जब डेटा साफ़-सुथरी पंक्तियों और स्तंभों में व्यवस्थित नहीं होता। हालाँकि BigQuery Object Tables को सपोर्ट करता है, जो Google Cloud Storage में संग्रहीत अनस्ट्रक्चर्ड डेटा (जैसे PDF, छवियाँ और कच्चे टेक्स्ट लॉग) का विश्लेषण करने की अनुमति देता है।
क्योंकि डेटा एजेंट Gemini की मल्टीमॉडल क्षमताओं द्वारा संचालित है, यह एक साथ आपके स्ट्रक्चर्ड मीट्रिक्स और अनस्ट्रक्चर्ड फ़ाइलों पर तर्क कर सकता है। यह BigQuery के लिए एक बड़ा, अनूठा अंतरकर्ता है।
यदि आपके पास किसी ऑब्जेक्ट टेबल में राइडर सर्वे PDF या स्टेशन निरीक्षण छवियाँ हैं, तो बस पूछें, “Q2 2024 राइडर सर्वे PDFs से मुख्य शिकायतों का सारांश दें।” एजेंट अनस्ट्रक्चर्ड फ़ाइलें पढ़ लेगा और जानकारी को आपके स्ट्रक्चर्ड ट्रिप डेटा के साथ संयोजित करेगा
आपकी डेटा टीम BigQuery Studio में डेटा एजेंट बनाती और टेस्ट करती है, लेकिन आपके एंड-यूज़र्स अक्सर पूरी तरह भिन्न एप्लिकेशन्स में काम करते हैं। Google एजेंट को GCP Console से डीकपल करना आसान बनाता है ताकि आप बिजनेस यूज़र्स तक वहीं पहुँचें जहाँ वे पहले से काम करते हैं।
यदि आप स्वयं एक कस्टम चैट एप्लिकेशन बनाना आज़माना चाहते हैं, तो आप आधिकारिक Introduction to Conversational Analytics in BigQuery में भी अधिक पढ़ सकते हैं।
यदि एक प्रमुख सिद्धांत लेना हो, तो वह यह है: संवादी एनालिटिक्स विश्लेषणात्मक बाधा को “डेटा टीम का इंतज़ार” से “सही प्रश्न पूछना” में स्थानांतरित कर देता है।
इस लोकतंत्रीकरण का अर्थ यह नहीं कि डेटा टीमें अप्रासंगिक हो गई हैं, बल्कि उनकी भूमिका बदल रही है। कोई AI एजेंट उतना ही बुद्धिमान है जितनी मज़बूत सुरक्षा-रेखाएँ आप उसके चारों ओर बनाते हैं। आपके डेटा एजेंट्स की शुद्धता और सुरक्षा पूरी तरह आपके द्वारा दिए गए निर्देशों, संदर्भ और स्कीमा आर्किटेक्चर पर निर्भर करती है।
सबसे प्रभावी संवादी एजेंट बनाने के लिए, आपको अब भी अंतर्निहित डेटा वेयरहाउस पर सशक्त पकड़ चाहिए। यदि आप या आपकी टीम उन कोर स्किल्स को मजबूत करना और उन प्लेटफ़ॉर्म्स में महारत हासिल करना चाहते हैं जो इन AI फीचर्स को पावर देते हैं, तो आज ही DataCamp का Introduction to BigQuery कोर्स देखें!
Google Cloud Courses
कोर्स
लर्निंग पाथ
कोर्स