
कोर्स
SQL में डेटा जॉइन करना
4 घंटा
340.4K
रिलेशनल डेटाबेस में, पंक्तियाँ प्रायः परस्पर निर्भर होती हैं, और जटिल प्रश्नों के उत्तर देने के लिए अक्सर क्वेरी को उसी टेबल की ओर वापस देखना पड़ता है जिसे वह वर्तमान में प्रोसेस कर रही है।
ऐसी टेबल्स पर क्वेरी करने के लिए, SQL correlated subqueries की अनुमति देता है, जो एक विशिष्ट संबंध परिभाषित करती हैं जहाँ inner query, outer query के मानों पर निर्भर होती है। एक सामान्य subquery एक बार चलती है और समाप्त हो जाती है, जबकि correlated subquery गतिशील होती है—मुख्य क्वेरी द्वारा मूल्यांकित प्रत्येक पंक्ति के लिए बार-बार निष्पादित होती है।
इसकी तुलना में, non-correlated subquery outer query से स्वतंत्र रूप से चलती है। यह एक बार निष्पादित होती है, एक परिणाम सेट या मान लौटाती है, और outer query उस परिणाम का प्रयोग करती है—बिना प्रत्येक पंक्ति के लिए subquery को पुनः चलाए।
Correlated subquery, subquery का वह प्रकार है जो चलने के लिए outer query के मानों पर निर्भर करती है।
एक बार चलकर स्थिर परिणाम लौटाने के बजाय, subquery को outer query द्वारा प्रोसेस की गई हर पंक्ति के लिए एक बार मूल्यांकित किया जाता है। ऐसा इसलिए होता है क्योंकि inner query, outer query के किसी कॉलम का संदर्भ देती है, जिससे दोनों क्वेरी के बीच सीधा संबंध बनता है।
इसके विपरीत, non-correlated subquery outer query से स्वतंत्र रहती है। यह एक बार चलती है, कोई परिणाम या मान लौटाती है, और outer query उस परिणाम का उपयोग करती है।
SQL में एक सामान्य correlated subquery का वर्कफ़्लो इस प्रकार होता है:
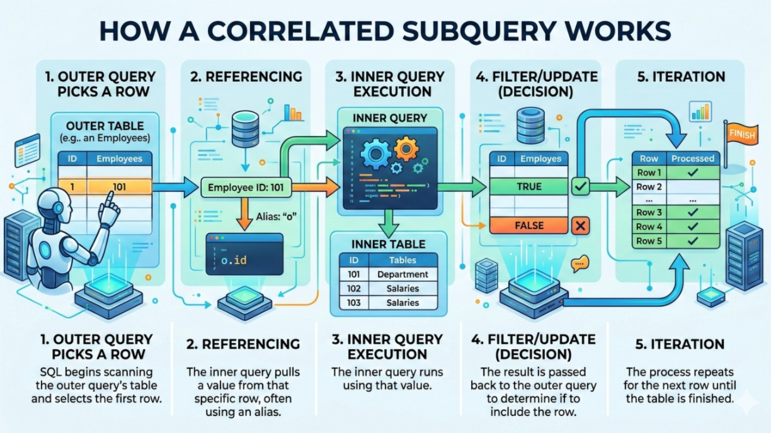
Correlated subquery कैसे काम करती है। चित्र: Gemini द्वारा।
अभी तक की चर्चा अवधारणात्मक थी। सीखने का सबसे अच्छा तरीका उदाहरणों से होकर गुजरना है।
मान लें कि आपके पास employees टेबल है जिसमें कर्मचारी वेतन और विभाग IDs हैं। आप ऐसे कर्मचारियों को ढूँढना चाहते हैं जो अपने विभाग के औसत वेतन से अधिक कमाते हों।
इसके लिए आप नीचे दी गई क्वेरी का उपयोग करेंगे, जहाँ:
Outer query, employees टेबल से कर्मचारियों का चयन करती है।
Subquery उसी विभाग के लिए औसत वेतन की गणना करती है।
शर्त e2.department_id = e.department_id outer query के उपनाम e का संदर्भ देती है।
 -- Fetch employees earning more than the average salary in dept
SELECT
    e.employee_id,
    e.employee_name,
    e.salary,
    e.department_id
FROM employees e
WHERE e.salary > (
    SELECT AVG(e2.salary)                 -- Calculate the average salary
    FROM employees e2
    WHERE e2.department_id = e.department_id
    -- Correlation: references the outer query's department_id
);आप EXISTS() ऑपरेटर का उपयोग correlated subquery के साथ कर सकते हैं ताकि यह जाँचा जा सके कि किसी अन्य टेबल में संबंधित रिकॉर्ड मौजूद हैं या नहीं।
मान लें कि आपके पास customers और orders टेबल में रिकॉर्ड हैं। आप ऐसे ग्राहकों की सूची बनाना चाहते हैं जिन्होंने कम से कम एक ऑर्डर दिया हो। इसके लिए आप नीचे दी गई क्वेरी का उपयोग करेंगे, जहाँ:
Outer query customers टेबल की पंक्तियों को स्कैन करती है।
Subquery यह जाँचती है कि उस ग्राहक के लिए कम से कम एक ऑर्डर मौजूद है या नहीं।
शर्त o.customer_id = c.customer_id subquery को outer query से जोड़ती है।
-- Fetch customers with at least one order
SELECT
    c.customer_id,
    c.customer_name
FROM customers c
WHERE EXISTS (
    SELECT 1
    FROM orders o
    WHERE o.customer_id = c.customer_id
    -- Correlation: references the outer query customer_id
);
ऊपर दी गई क्वेरी में, SQL यह जाँचता है कि orders टेबल में कोई मेल खाती पंक्ति मौजूद है या नहीं। यदि है, तो EXISTS() ऑपरेटर true लौटाता है, और ग्राहक परिणाम में शामिल हो जाता है।
जैसा कि हमने पहले सीखा, SQL में subqueries या तो non-correlated होती हैं या correlated। प्रमुख अंतर यह है कि inner query outer query पर निर्भर करती है या नहीं।
Non-correlated subquery के लिए, डेटाबेस इसे एक बार चलाता है और फिर outer query में उसके परिणाम का उपयोग करता है।
उदाहरण के लिए, नीचे दी गई क्वेरी उन कर्मचारियों को ढूँढती है जो समग्र औसत वेतन से अधिक कमाते हैं।
-- Query employees who earn more than the overall average salary
SELECT
    employee_id,
    employee_name,
    salary
FROM employees
WHERE salary > (
    SELECT AVG(salary)
    FROM employees
);
ऊपर की क्वेरी में, subquery पूरी टेबल के लिए औसत वेतन की गणना करती है, और यह केवल एक बार चलती है। इसके बाद outer query प्रत्येक कर्मचारी के वेतन की तुलना उसी एक मान से करती है।
क्योंकि non-correlated subqueries एक बार चलती हैं, जब परिणाम पुन: उपयोग किया जा सकता है तो वे सामान्यतः तेज़ होती हैं। ये समग्र तुलना—जैसे कुल औसत और योग—के लिए सर्वोत्तम होती हैं।
हालाँकि, बड़े टेबल्स पर correlated subqueries धीमी हो सकती हैं। वे तब उपयोगी होती हैं जब शर्तों का मूल्यांकन प्रत्येक पंक्ति के सापेक्ष करना हो—जैसे विभाग-स्तरीय तुलना या अस्तित्व जाँच।
मैं आपको हमारा Introduction to SQL Server कोर्स लेने की सलाह देता/देती हूँ ताकि आप grouping, data aggregation और tables को join करना और बेहतर सीख सकें।
कई correlated subqueries को JOINs का उपयोग करके पुनर्लिखा जा सकता है। रिलेशनल डेटाबेस में, JOINs बेहतर प्रदर्शन करते हैं क्योंकि डेटाबेस रिश्तों को row-by-row के बजाय set-by-set प्रोसेस कर सकता है।
नीचे दी गई क्वेरी पर विचार करें, जो correlated subquery का उपयोग करती है। यह क्वेरी उन कर्मचारियों की सूची बनाती है जिन्हें अपने विभाग के औसत वेतन से अधिक भुगतान किया जाता है।
-- Use subquery to fetch employees earning more than the average salary in dept
SELECT
    e.employee_id,
    e.employee_name,
    e.salary,
    e.department_id
FROM employees e
WHERE e.salary > (
    SELECT AVG(e2.salary)
    FROM employees e2
    WHERE e2.department_id = e.department_id
);
आप JOIN क्लॉज़ का उपयोग करके क्वेरी को पुनर्लिख सकते हैं और वही परिणाम प्राप्त कर सकते हैं।
-- Use JOIN to fetch employees earning more than the average salary in dept
SELECT
    e.employee_id,
    e.employee_name,
    e.salary,
    e.department_id
FROM employees e
JOIN (
    SELECT
        department_id,
        AVG(salary) AS avg_salary
    FROM employees
    GROUP BY department_id
    -- Precompute the department average once per department
) dept_avg
ON e.department_id = dept_avg.department_id
-- Match employees with their department averages
WHERE e.salary > dept_avg.avg_salary;
-- Compare salary with the computed department average
नीचे दी गई तालिका SQL में correlated subqueries और JOIN के बीच अंतर का सार प्रस्तुत करती है।
|
फ़ीचर |
Correlated Subquery |
JOIN |
|
Readability |
अक्सर पढ़ने में आसान, क्योंकि तर्क सीधे |
थोड़ा अधिक जटिल हो सकता है, क्योंकि इसमें derived tables या CTEs की आवश्यकता पड़ सकती है। |
|
Logic Expression |
शर्तें स्वाभाविक रूप से व्यक्त करता है। उदाहरण: “वेतन विभागीय औसत से अधिक।” |
पहले समेकित (aggregated) मानों की गणना करनी पड़ती है और फिर उन्हें मुख्य टेबल से जोड़ना पड़ता है। |
|
Execution Behavior |
Subquery outer query की प्रत्येक पंक्ति के लिए चल सकती है। |
समेकित परिणाम सामान्यतः एक बार गणना होकर पुन: उपयोग किए जाते हैं। |
|
Performance |
बार-बार निष्पादन के कारण बड़े डेटासेट पर धीमी हो सकती है। |
आम तौर पर बड़े टेबल्स के लिए अधिक कुशल। |
|
Common Use Cases |
पंक्ति-विशिष्ट शर्तें जाँचना, |
रिपोर्टिंग क्वेरियाँ, aggregations, और performance-संवेदनशील वर्कलोड। |
मैं अनुशंसा करता/करती हूँ कि आप हमारा Joining Data in SQL कोर्स लें, ताकि आप SQL में विभिन्न प्रकार के joins और डेटाबेस में संबंधित टेबल्स के साथ काम करना सीख सकें।
आधुनिक SQL में, Window functions जैसे AVG() और OVER (PARTITION BY) एक ही स्कैन में प्रति पंक्ति aggregates की गणना कर सकती हैं।
उदाहरण के लिए, नीचे दी गई क्वेरी उन कर्मचारियों को लौटाती है जिनका वेतन उनके विभाग के औसत वेतन से अधिक है। Subquery के अंदर, OVER () का उपयोग aggregate को window function में बदलने के लिए और PARTITION BY department_id का उपयोग टेबल को विभाग के अनुसार समूहों (partitions) में बाँटने के लिए किया गया है।
-- Use window function to get employees earning more than dept average salary
SELECT
    employee_id,
    employee_name,
    salary,
    department_id
FROM (
    SELECT
        employee_id,
        employee_name,
        salary,
        department_id,
        AVG(salary) OVER (PARTITION BY department_id) AS dept_avg_salary
        -- Window function calculates department average once per partition
    FROM employees
) t
WHERE salary > dept_avg_salary;
फिर भी, correlated subqueries तब उपयोगी रहती हैं जब आप टेबल्स के बीच संबंधों का परीक्षण करने के लिए EXISTS() या NOT EXISTS() का उपयोग करना चाहते हैं। आप correlated subqueries का उपयोग तब भी कर सकते हैं जब आप ऐसे डेटाबेस या परिस्थितियों में काम कर रहे हों जहाँ window functions उपलब्ध न हों।
हालाँकि correlated subqueries शक्तिशाली हैं, वे अक्सर कुछ प्रदर्शन-संबंधी चुनौतियों के साथ आती हैं।
क्योंकि क्वेरी outer query की प्रत्येक पंक्ति के लिए एक बार चलती है, यह inner डेटा को कई बार पुन: स्कैन करके बड़े टेबल्स पर क्वेरियों को धीमा कर सकती है। यदि आपकी outer टेबल में 100,000 पंक्तियाँ हैं, तो डेटाबेस 100,000 उप-कार्यों का निष्पादन करेगा।
यदि आप उचित अनुकूलन नहीं करते हैं, तो correlated क्वेरियाँ उच्च CPU उपयोग और लंबे प्रतीक्षा समय का कारण बन सकती हैं, विशेषकर तब जब inner query जटिल गणनाएँ कर रही हो या बड़े टेबल्स स्कैन कर रही हो।
Correlation में उपयोग किए गए कॉलम्स का indexing करने से डेटाबेस संबंधित पंक्तियाँ लगभग तुरंत ढूँढ सकता है, बजाय हर बार पूरे inner टेबल को स्कैन करने के।
आधुनिक डेटाबेस अक्सर correlated subqueries को आंतरिक रूप से अनुकूलित कर देते हैं। Query planner क्वेरी को अधिक कुशल रूप, जैसे JOIN या cached aggregation, में रूपांतरित कर सकता है और क्वेरी समय में उल्लेखनीय कमी ला सकता है।
आप correlated subqueries का उपयोग तब कर सकते हैं जब आप निम्न करना चाहते हों:
पंक्ति-विशिष्ट aggregates के आधार पर फ़िल्टर: जब आपको प्रत्येक पंक्ति के सापेक्ष मान की तुलना करनी हो, जैसे विभागीय औसत से ऊपर कमाने वाले कर्मचारी।
EXISTS() के साथ संबंधित डेटा जाँचना: आप संबंधित पंक्तियों के अस्तित्व का परीक्षण करने के लिए correlated subqueries को EXISTS() के साथ उपयोग कर सकते हैं।
जटिल nested logic को व्यक्त करना: लंबी JOIN चेन की तुलना में correlated subqueries जटिल शर्तों को पढ़ने और व्यक्त करने में सहायक हो सकती हैं।
हालाँकि, correlated subqueries से बचें जब:
एक साधारण JOIN काम कर जाता है: यदि आप LEFT JOIN या INNER JOIN से वही परिणाम पा सकते हैं, तो उसे ही उपयोग करें—वह हमेशा तेज़ होगा।
बड़े डेटा के साथ काम करते समय: यदि correlated शर्त बड़े, बिना इंडेक्स वाले टेबल्स का संदर्भ देती है, तो बार-बार मूल्यांकन क्वेरी को उल्लेखनीय रूप से धीमा कर सकता है।
नीचे कुछ सामान्य समस्याएँ दी गई हैं जिनका सामना आप correlated subqueries का उपयोग करते समय कर सकते हैं, और उन्हें कैसे सुलझाएँ:
यह सीखना कि correlated subqueries का उपयोग कब और कैसे करें, और उन्हें अन्य तकनीकों से कब बदलें, स्पष्ट और कुशल SQL क्वेरियाँ लिखने के लिए एक महत्वपूर्ण कौशल है।
अगले कदम के रूप में, मैं हमारी SQL Associate Certification प्राप्त करने की सलाह देता/देती हूँ ताकि आप डेटा विश्लेषण के लिए SQL में अपनी महारत दिखा सकें और अन्य डेटा प्रोफेशनल्स के बीच अलग नज़र आएँ। अंत में, मैं हमारा Database Design कोर्स करने की सिफारिश करता/करती हूँ, जहाँ आप डेटाबेस बनाना और प्रबंधित करना तथा अपनी आवश्यकताओं के अनुरूप उपयुक्त DBMS चुनना सीखेंगे।
DataCamp के साथ SQL सीखें
कोर्स
कोर्स
कोर्स