कोर्स
SQL में डेटा जॉइन करना
4 घंटा
341.7K
जब आप SQL के साथ काम करते हैं, तो डेटा को सॉर्ट करना सीधा होता है क्योंकि आप आसानी से ORDER BY का उपयोग करके पंक्तियों को व्यवस्थित कर सकते हैं। हालांकि, केवल परिणामों को ऑर्डर करने से आपको उस क्रम में प्रत्येक पंक्ति की स्थिति पता नहीं चलती। यहीं रैंकिंग उपयोगी होती है। केवल सॉर्ट किया हुआ डेटा देखने की बजाय, आप विशिष्ट मानदंडों के आधार पर प्रत्येक पंक्ति को 1st, 2nd, या 3rd जैसी स्थिति देना चाह सकते हैं।
RANK() फ़ंक्शन इस समस्या का समाधान करता है, क्योंकि यह परिभाषित क्रम के अनुसार प्रत्येक पंक्ति को एक संख्यात्मक रैंक प्रदान करता है। RANK() SQL विंडो फ़ंक्शंस का हिस्सा है, जो आपको पंक्तियों के एक सेट पर गणनाएँ करने की अनुमति देता है, जबकि व्यक्तिगत पंक्ति परिणाम लौटाए जाते हैं।
इस ट्यूटोरियल में, मैं आपको RANK() का सिंटैक्स, व्यावहारिक उदाहरण, यह टाई को कैसे संभालता है, और DENSE_RANK() तथा ROW_NUMBER() जैसे समान फ़ंक्शंस से इसकी तुलना दिखाऊंगा।
यदि आप SQL में नए हैं, तो हमारे Introduction to SQL कोर्स से शुरुआत करें, या यदि आपको कुछ अनुभव है तो Intermediate SQL कोर्स करें।
SQL RANK() फ़ंक्शन एक विंडो फ़ंक्शन है जो किसी निर्दिष्ट क्रम के आधार पर प्रत्येक पंक्ति को एक रैंक देता है। रैंकिंग पूरी तरह से विंडो फ़ंक्शन के अंदर दिए गए ORDER BY पर निर्भर होती है। इसलिए, यह प्रत्येक पंक्ति को ORDER BY क्लॉज़ के अनुसार 1, 2, 3, और आगे की स्थिति देता है।
ध्यान रखें कि जब आप RANK() का उपयोग करते हैं:
RANK() फ़ंक्शन का बुनियादी सिंटैक्स इस प्रकार है:
RANK() OVER (ORDER BY column)जहाँ:
OVER क्लॉज़: वह विंडो (पंक्तियों का सेट) परिभाषित करता है जिस पर फ़ंक्शन कार्य करता है।
ORDER BY: यह निर्धारित करता है कि रैंकिंग कैसे लागू होगी, जैसे उच्चतम से निम्नतम।
PARTITION BY (वैकल्पिक): डेटा को समूहों में विभाजित करता है, जिससे प्रत्येक समूह के भीतर अलग से रैंकिंग होती है।
नीचे PARTITION BY क्लॉज़ के साथ RANK() फ़ंक्शन का सिंटैक्स दिया गया है:
RANK() OVER (PARTITION BY column1 ORDER BY column2)SQL RANK() फ़ंक्शन प्रमुख डेटाबेस में व्यापक रूप से समर्थित है। इनमें PostgreSQL, MySQL (8.0+), Microsoft SQL Server, और Oracle Database शामिल हैं। सिंटैक्स अधिकतर इन प्रणालियों में समान है, क्योंकि यह मानक ANSI SQL विनिर्देश का हिस्सा है।
अब जब आपने RANK() फ़ंक्शन का सिंटैक्स समझ लिया है, तो मैं आपको एक साधारण उदाहरण दिखाता हूँ कि यह कैसे काम करता है।
मान लें कि आपके पास employees तालिका है जिसमें प्रत्येक कर्मचारी की वेतन जानकारी है।
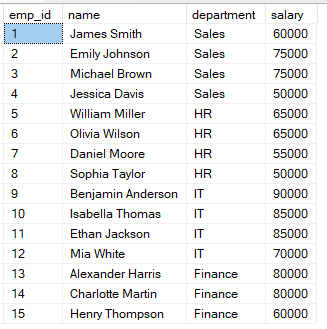
आप निम्नलिखित क्वेरी का उपयोग करके कर्मचारियों को उनके वेतन के अनुसार रैंक कर सकते हैं।
-- Rank employees by salary
SELECT
    name,
    salary,
    RANK() OVER (ORDER BY salary DESC) AS rank_position
FROM employees;
ऊपर दी गई क्वेरी में, पंक्तियाँ वेतन के अनुसार उच्चतम से ऑर्डर की गई हैं, इसलिए सबसे अधिक वेतन को रैंक 1 मिलता है। जब दो पंक्तियों का वेतन समान होता है, तो उन्हें समान रैंक मिलती है।
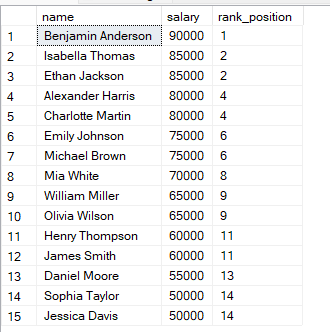
आप देखेंगे कि यदि दो पंक्तियों के मान समान हैं, तो उन्हें समान रैंक मिलती है।
फिर अगली रैंक छोड़ दी जाती है। SQL टाई को ध्यान में रखते हुए अगला रैंक मान छोड़ देता है।
समूहकरण और डेटा एग्रीगेशन के बारे में अधिक जानने के लिए मैं हमारा Introduction to SQL Server कोर्स करने की सलाह देता हूँ।
जैसा कि हमने पहले सीखा, PARTITION BY क्लॉज़ आपको पूरे डेटासेट के बजाय समूहों के भीतर रैंकिंग लागू करने देता है।
नीचे दिए गए उदाहरण में, कर्मचारियों को department के अनुसार समूहित किया गया है, और प्रत्येक विभाग के भीतर रैंकिंग नई शुरू होती है। इसलिए, प्रत्येक समूह का अपना स्वतंत्र रैंकिंग अनुक्रम होता है।
-- Rank employees within each department
SELECT
    name,
    department,
    salary,
    RANK() OVER (PARTITION BY department ORDER BY salary DESC) AS dept_rank
FROM employees;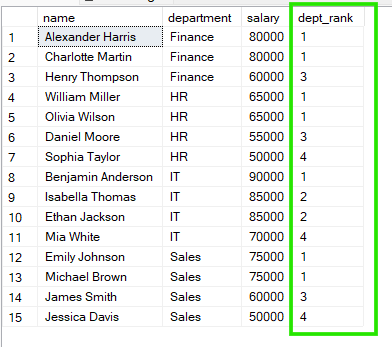
ऊपर दिए गए परिणामों से, हम देख सकते हैं कि “Sales” में Emily Johnson और Michael Brown दोनों रैंक 1 साझा करते हैं, जबकि “HR” में William Miller और Olivia Wilson भी रैंक 1 साझा करते हैं।
SQL में डेटा रैंक करते समय, आप RANK(), DENSE_RANK(), या ROW_NUMBER() का उपयोग चुन सकते हैं। ये फ़ंक्शंस देखने में समान लग सकते हैं, लेकिन उनका व्यवहार इस प्रकार है:
RANK(): टाई के मामले में समान रैंक दी जाती है, इसलिए टाई के बाद रैंक में गैप आते हैं।
DENSE_RANK(): टाई के मामले में समान रैंक दी जाती है, इसलिए रैंकिंग में कोई गैप नहीं होता।
ROW_NUMBER(): हर पंक्ति को एक अद्वितीय संख्या मिलती है, भले ही मान समान हों—टाई नहीं होती।
इन अंतरों को बेहतर समझने के लिए, आइए नीचे दी गई क्वेरी का उपयोग करके साइड-बाय-साइड तुलना करें:
-- Compare RANK() vs DENSE_RANK() vs ROW_NUMBER()
SELECT
    name,
    salary,

    RANK() OVER (ORDER BY salary DESC) AS rank_val,          -- allows gaps after ties

    DENSE_RANK() OVER (ORDER BY salary DESC) AS dense_rank1,  -- no gaps, consecutive ranks

    ROW_NUMBER() OVER (ORDER BY salary DESC) AS row_num      -- always unique sequence

FROM employees;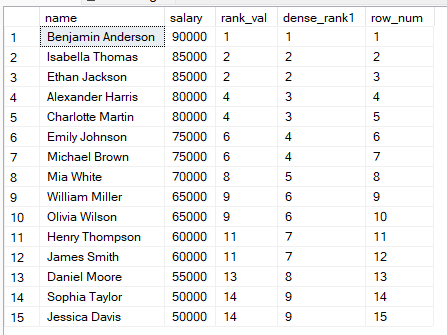
ऊपर दिए गए परिणामों से, आप यह चुन सकते हैं:
RANK() का उपयोग तब करें जब स्थिति महत्व रखती है और गैप स्वीकार्य हैं।
DENSE_RANK() का उपयोग तब करें जब आप निरंतर रैंकिंग चाहते हों।
ROW_NUMBER() का उपयोग तब करें जब हर पंक्ति के लिए एक अद्वितीय संख्या चाहिए, जैसे डेटा पेजिनेशन में।
SQL RANK() फ़ंक्शन तब सबसे उपयोगी होता है जब आप डेटा को ऑर्डर करना चाहते हैं और टाई को स्वाभाविक रूप से संभालना चाहते हैं। मुझे यह निम्नलिखित उपयोग मामलों के लिए भी महत्वपूर्ण लगता है:
यहाँ कुछ गलतियाँ हैं जिनका मैंने SQL RANK() फ़ंक्शन का उपयोग करते समय सामना किया है, और आप इन्हें कैसे टाल सकते हैं:
ORDER BY भूल जाना: ORDER BY क्लॉज़ के बिना, रैंकिंग की कोई परिभाषित लॉजिक नहीं होती और अप्रत्याशित परिणाम मिल सकते हैं।
टाई व्यवहार को गलत समझना: एक शुरुआती के रूप में, आप 1, 2, 2, 3 की अपेक्षा कर सकते हैं, लेकिन RANK() रैंकों में गैप (1, 2, 2, 4) पैदा करता है।
जब ROW_NUMBER() चाहिए तब RANK() का उपयोग करना: यदि आपको अद्वितीय अनुक्रमिक मान चाहिए, तो ROW_NUMBER() बेहतर विकल्प है।
जहाँ ज़रूरत हो वहाँ PARTITION BY का उपयोग न करना: बिना पार्टिशनिंग के, रैंकिंग समूहों के भीतर होने के बजाय वैश्विक रूप से लागू होती है।
अपनी क्वेरियों को साफ़ रखने और अपेक्षित परिणाम सुनिश्चित करने के लिए, मैं सुझाव देता हूँ कि SQL RANK() फ़ंक्शन का उपयोग करते समय ये सर्वोत्तम प्रथाएँ अपनाएँ:
हमेशा स्पष्ट ऑर्डरिंग परिभाषित करें: ORDER BY क्लॉज़ के साथ स्पष्ट रहें, जैसे DESC, ताकि रैंकिंग अस्पष्ट न हो।
उचित रैंकिंग फ़ंक्शन चुनें: टाई को आप कैसे संभालना चाहते हैं, इसके आधार पर RANK(), DENSE_RANK(), या ROW_NUMBER() चुनें।
टाई परिदृश्यों का परीक्षण करें: प्रोडक्शन में भेजने से पहले, जाँचें कि डुप्लीकेट मान होने पर आपका डेटा कैसा व्यवहार करता है।
फ़िल्टरिंग के साथ संयोजन करें: चूँकि आप RANK() को सीधे WHERE क्लॉज़ में उपयोग नहीं कर सकते, इसलिए जब आप “Top N” को फ़िल्टर करना चाहें, तो अपनी रैंकिंग क्वेरी को Subquery या CTE में रैप करें।
RANK() SQL में क्रमबद्ध तुलना करने का एक उपयोगी टूल है, खासकर जब आपको वास्तविक दुनिया के परिदृश्यों जैसे समान मानों को प्रतिबिंबित करने वाले परिणाम चाहिए। यह समझना महत्वपूर्ण है कि यह टाई को कैसे संभालता है और क्यों रैंक दोहर सकते हैं तथा संख्याएँ छोड़ सकते हैं। एक बार जब आप इस व्यवहार में निपुण हो जाते हैं, तो आप जान पाएँगे कि अपने विशिष्ट उपयोग मामले के अनुसार इसे DENSE_RANK() और ROW_NUMBER() जैसे विकल्पों के साथ कब चुनना है।
अब जब आपने SQL में डेटा को रैंक करना सीख लिया है, तो मैं सुझाव देता हूँ कि यदि आप एक दक्ष डेटा विश्लेषक बनना चाहते हैं तो हमारा Associate Data Analyst in SQL करियर ट्रैक देखें, ताकि आवश्यक कौशल सीखे जा सकें। यदि आप SQL का उपयोग करके प्रोफेशनल डैशबोर्ड बनाना सीखना चाहते हैं, तो हमारा Reporting in SQL कोर्स भी उपयुक्त है।
DataCamp के साथ SQL सीखें
कोर्स
कोर्स
कोर्स