A verdade é que você usa resultados de equações diferenciais toda vez que treina uma rede neural ou mesmo ajusta um modelo de regressão. A matemática por baixo disso é cálculo, e as equações diferenciais estão no centro. Se você já se perguntou por que o gradiente descendente funciona ou como um filtro de Kalman acompanha um objeto em movimento, as equações diferenciais são a resposta.
Equações diferenciais permitem modelar como as coisas mudam ao longo do tempo — e é exatamente disso que ciência de dados trata. Quando você entende as ideias centrais, começa a enxergá-las em todo lugar: nas funções de perda que você minimiza, nas séries temporais que você prevê e nas simulações que executa.
Neste artigo, vou explicar o que são equações diferenciais, os principais tipos que você vai encontrar, como resolvê-las e — mais importante — como elas aparecem no dia a dia da ciência de dados e do machine learning.
O que são equações diferenciais?
Uma equação diferencial é uma equação que relaciona uma função às suas próprias derivadas.
Em termos simples, uma derivada diz o quão rápido algo está mudando em um determinado instante. Uma equação diferencial diz que a taxa de variação de uma quantidade depende da própria quantidade, do tempo, ou de ambos.
Suponha que você esteja modelando uma população de bactérias. Quanto mais bactérias existem, mais rápido elas se reproduzem. Logo, a taxa de crescimento depende do tamanho atual da população. Escreva isso como uma equação e você terá uma equação diferencial.
Formalmente, fica assim:
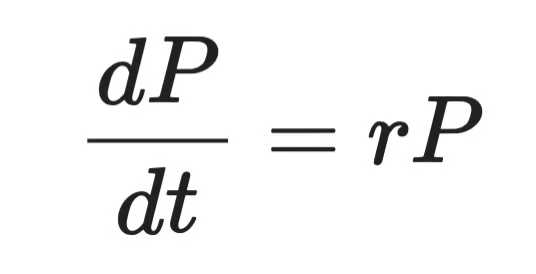
Representação de uma equação diferencial
Onde P é a população, t é o tempo e r é a taxa de crescimento. O lado esquerdo é a derivada — a velocidade com que P muda ao longo do tempo. O lado direito diz que essa mudança é proporcional à própria P.
Essa é a ideia central por trás de toda equação diferencial que você vai ver.
Equações diferenciais aparecem em física, biologia e engenharia — em qualquer lugar onde um sistema evolui ao longo do tempo. Calor se espalhando por uma barra de metal, um pêndulo oscilando, um vírus se disseminando por uma população. Tudo isso é modelado com equações diferenciais.
Para cientistas de dados, você vai ver equações diferenciais em funções de perda, gradiente descendente, modelos de séries temporais, Neural ODEs — há equações diferenciais por baixo de tudo isso. Nem sempre aparecem explicitamente, mas estão lá.
Quando você as entende, passa a ter um modelo mental mais claro de por que e como as ferramentas que usa todos os dias funcionam.
A história das equações diferenciais
No fim do século XVII, Isaac Newton e Gottfried Wilhelm Leibniz desenvolveram o cálculo de forma independente. Ambos precisavam descrever como quantidades físicas mudavam ao longo do tempo, e as equações diferenciais foram o resultado. Newton as usou para modelar movimento e gravidade. Leibniz nos deu boa parte da notação usada até hoje, incluindo o d/dt que aparece em todo livro de cálculo.
Os séculos XVIII e XIX trouxeram uma onda de novas técnicas.
Leonhard Euler desenvolveu métodos para resolver EDOs numericamente — o mesmo Euler por trás do método de Euler que você verá mais adiante. Joseph-Louis Lagrange e Pierre-Simon Laplace ampliaram a teoria para sistemas mais complexos. Jean-Baptiste Joseph Fourier introduziu uma forma de decompor funções em componentes seno e cosseno, tornando-se base na solução de equações diferenciais parciais.
No século XX, equações diferenciais estavam em tudo: dinâmica dos fluidos, mecânica quântica, engenharia elétrica. Muitas equações do mundo real não tinham solução analítica elegante. Foi aí que os métodos numéricos assumiram o protagonismo, e os computadores os tornaram práticos em escala.
Hoje, a área continua avançando. Neural ordinary differential equations (Neural ODEs) tratam as camadas de uma rede neural como um processo contínuo descrito por uma equação diferencial. É um desenvolvimento recente que aproxima o deep learning da matemática clássica. Também é uma das áreas mais empolgantes na pesquisa moderna em ML.
Dito isso, a ideia central permanece: modele como as coisas mudam e você consegue prever para onde estão indo.
Tipos de equações diferenciais
Nem toda equação diferencial é igual. A primeira coisa é saber diferenciá-las.
A divisão principal é entre equações diferenciais ordinárias (EDOs) e equações diferenciais parciais (EDPs). A diferença está em quantas variáveis independentes a função depende.
Equações diferenciais ordinárias (EDOs)
Uma equação diferencial ordinária envolve uma função de uma única variável independente e suas derivadas.
O exemplo da população de bactérias é uma EDO. A população P depende apenas do tempo t — uma variável. Logo, a equação tem apenas derivadas ordinárias, escritas como dP/dt.
EDOs são a ferramenta certa quando seu sistema evolui ao longo de uma única dimensão, geralmente o tempo. Alguns exemplos clássicos:
- Crescimento populacional — a taxa de variação de uma população depende do tamanho atual
- Decaimento radioativo — a taxa de decaimento de uma substância depende de quanto ainda resta
- Segunda lei de Newton — a aceleração de um objeto depende das forças que atuam sobre ele
Em todos os casos, uma variável conduz a mudança. É isso que a torna ordinária.
Equações diferenciais parciais (EDPs)
Uma equação diferencial parcial envolve uma função de múltiplas variáveis independentes e suas derivadas parciais.
Suponha que você queira modelar como o calor se espalha por uma barra de metal. A temperatura em qualquer ponto depende de onde você está na barra e do instante. São duas variáveis independentes: posição x e tempo t. Ao escrever a equação, surgem derivadas parciais — uma em relação a x e outra em relação a t.
Isso é uma EDP. A equação do calor é um dos exemplos mais conhecidos:
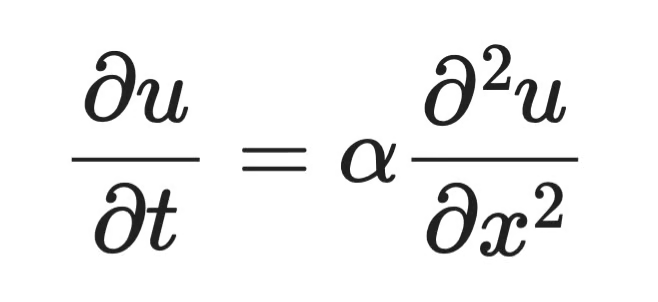
Exemplo de equação diferencial parcial
Onde u(x, t) é a temperatura na posição x e no tempo t, α é a difusividade térmica do material, ∂u/∂t indica quão rápido a temperatura muda ao longo do tempo, e ∂²u/∂x² mostra a curvatura do perfil de temperatura no espaço. A equação diz que onde a curva de temperatura entorta bastante, o calor se redistribui rápido. Onde é plana, pouca coisa acontece.
EDPs aparecem sempre que um sistema varia no espaço e no tempo:
- Distribuição de calor — temperatura varia com posição e tempo
- Propagação de ondas — ondas sonoras ou de luz se espalham no espaço ao longo do tempo
- Dinâmica dos fluidos — a velocidade do fluido depende da posição no espaço 3D e do tempo
EDPs são mais difíceis de resolver do que EDOs. Soluções analíticas existem apenas para formas específicas; métodos numéricos costumam ser o caminho prático.
Na maior parte do trabalho em ciência de dados, você verá EDOs com mais frequência. Mas EDPs aparecem em processamento de imagens, simulações físicas e algumas arquiteturas de deep learning, então é importante saber as diferenças.
Ordem e grau das equações diferenciais
Toda equação diferencial tem duas características que indicam sua complexidade: sua ordem e seu grau.
Elas determinam quais métodos de solução se aplicam, então você precisa identificá-las antes de tentar resolver qualquer coisa.
Entendendo a ordem
A ordem de uma equação diferencial é a ordem da derivada de maior grau presente na equação.
Se a maior derivada é de primeira ordem (dy/dx), é uma equação de primeira ordem. Se a maior é uma segunda derivada (d²y/dx²), é de segunda ordem. E assim por diante.
Aqui está a equação de crescimento bacteriano de antes:
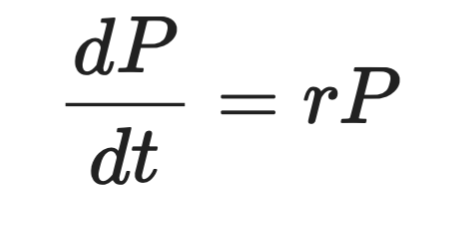
Equação de crescimento bacteriano
A maior derivada aqui é dP/dt — uma primeira derivada. Portanto, é uma EDO de primeira ordem.
Agora compare com a equação que descreve um pêndulo oscilando:
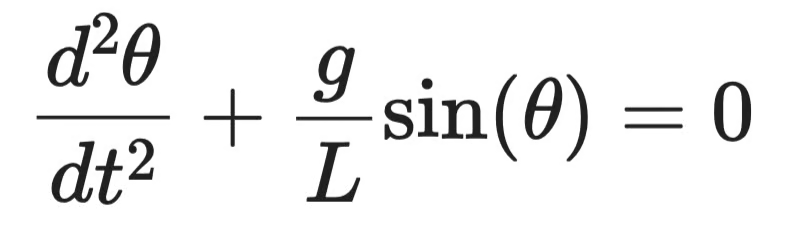
Equação do pêndulo oscilante
A maior derivada é d²θ/dt² — uma segunda derivada. Isso a torna uma EDO de segunda ordem.
Ordem mais alta significa mais complexidade. Equações de segunda ordem precisam de duas condições iniciais para serem resolvidas, em vez de uma. Na prática, a maioria dos sistemas físicos — movimento mecânico, circuitos elétricos, dinâmica orbital — é modelada com equações de segunda ordem.
Entendendo o grau
O grau de uma equação diferencial é a potência da derivada de maior ordem, uma vez que a equação esteja em forma polinomial (sem radicais ou frações envolvendo derivadas).
Considere esta equação:
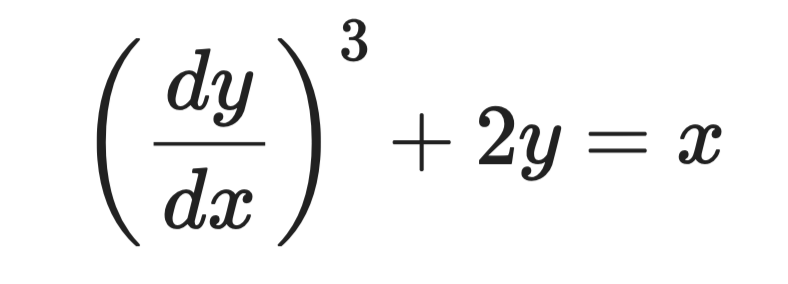
Exemplo de equação diferencial
A maior derivada é dy/dx, elevada à potência 3. Portanto, a ordem é 1 e o grau é 3.
Agora veja esta outra:
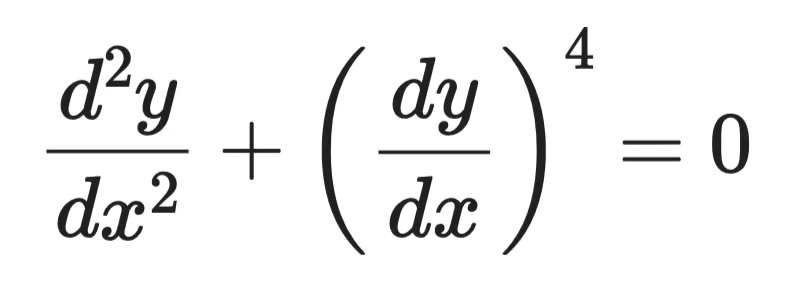
Exemplo de equação diferencial (2)
A derivada de maior ordem é d²y/dx², elevada à potência 1. O grau é 1, mesmo que uma derivada de ordem inferior apareça com potência maior.
O grau sempre segue a derivada de maior ordem, não a maior potência da equação.
Um caso à parte é quando a equação contém termos como sin(dy/dx) ou e^(d²y/dx²). Nesse caso, o grau é indefinido — essas formas não podem ser expressas como polinômios nas derivadas.
Métodos para resolver equações diferenciais
Não existe um único método que funcione para toda equação diferencial. A abordagem certa depende do tipo, da ordem e de existir (ou não) uma solução exata.
De forma ampla, há duas categorias: métodos analíticos e métodos numéricos.
Métodos analíticos
Métodos analíticos oferecem uma solução exata em forma fechada — uma fórmula que você pode avaliar em qualquer ponto. Eles são preferidos quando se aplicam, porque o resultado é preciso e revela a estrutura da solução.
Mas só funcionam para formas específicas de equação. Quando a equação fica complexa demais, os métodos analíticos esbarram num limite.
Separação de variáveis
A separação de variáveis funciona em equações nas quais você consegue isolar todos os termos envolvendo y de um lado e todos os termos envolvendo x (ou t) do outro.
Considere esta EDO de primeira ordem:
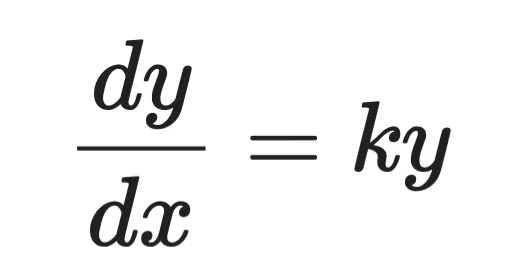
Equação diferencial simples
Passo 1 — separe as variáveis:
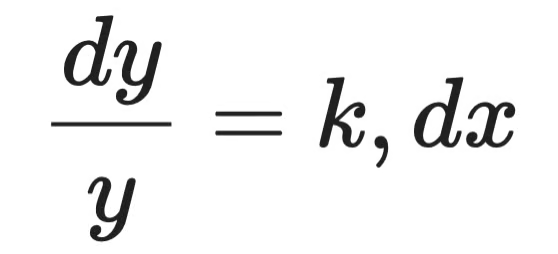
Solução analítica (passo 1)
Passo 2 — integre ambos os lados:
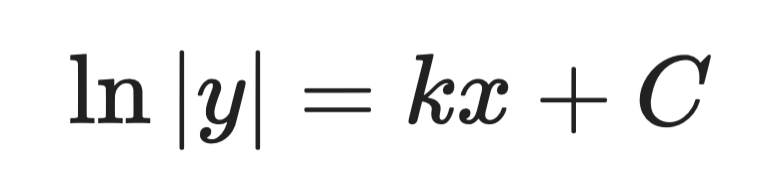
Solução analítica (passo 2)
Passo 3 — isole y:
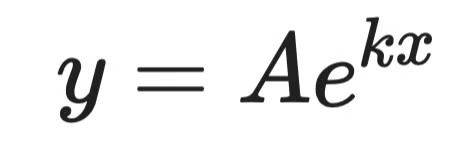
Solução analítica (passo 3)
Onde A é uma constante determinada pelas condições iniciais. Essa é a solução geral.
Essa é a mesma forma da equação de crescimento bacteriano. Ela mostra que populações — e qualquer coisa com taxa de crescimento proporcional ao seu tamanho — crescem exponencialmente.
Fatores integrantes
Fatores integrantes resolvem EDOs lineares de primeira ordem neste formato:
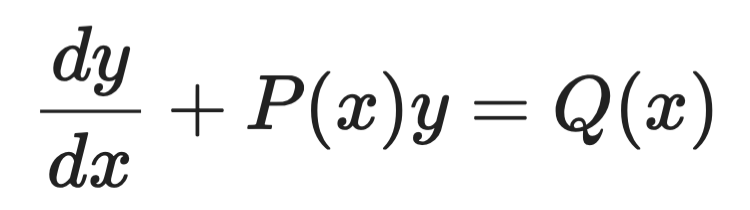
Exemplo de fator integrante (1)
A ideia é multiplicar ambos os lados por uma função escolhida a dedo — o fator integrante μ(x) — que transforma o lado esquerdo em uma derivada exata, integrável diretamente.
O fator integrante é sempre:
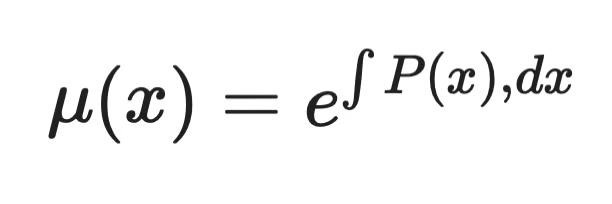
Exemplo de fator integrante (2)
Após multiplicar, a equação vira:
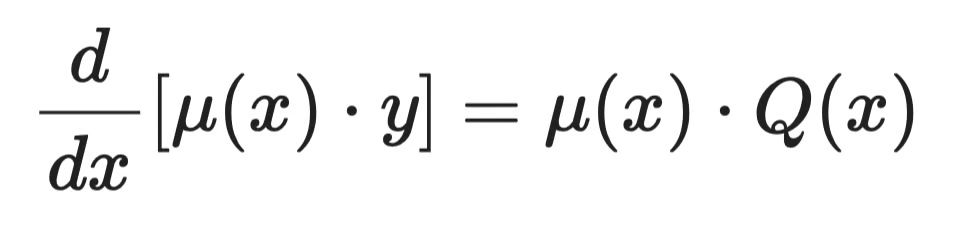
Exemplo de fator integrante (3)
Depois é só integrar ambos os lados e isolar y. O lado esquerdo sempre se simplifica por causa de como μ(x) foi escolhido — esse é o ponto central do método.
Métodos numéricos
A maior parte das equações diferenciais do mundo real não tem solução analítica limpa. Métodos numéricos aproximam a solução passo a passo, calculando valores em pontos discretos.
Eles trocam exatidão por generalidade. E, na prática, é justamente o que você precisa muitas vezes.
Método de Euler
O método de Euler é a abordagem numérica mais simples. A ideia é começar de um ponto conhecido, usar a derivada para estimar a inclinação, dar um pequeno passo nessa direção e repetir.
Dada uma EDO de primeira ordem dy/dx = f(x, y) com condição inicial y(x₀) = y₀, cada passo fica assim:
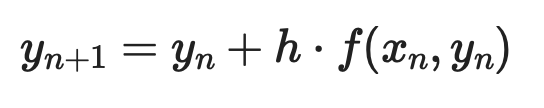
Exemplo do método de Euler (1)
Onde h é o tamanho do passo. Passos menores significam mais precisão — mas mais computação.
Aqui vai uma implementação em Python resolvendo dy/dx = y com y(0) = 1 (a solução exata é y = eˣ):
import numpy as np
import matplotlib.pyplot as plt

def euler_method(f, x0, y0, h, n_steps):
    x = np.zeros(n_steps + 1)
    y = np.zeros(n_steps + 1)
    x[0], y[0] = x0, y0

    for i in range(n_steps):
        y[i+1] = y[i] + h * f(x[i], y[i])
        x[i+1] = x[i] + h

    return x, y

f = lambda x, y: y  # dy/dx = y

x_euler, y_euler = euler_method(f, x0=0, y0=1, h=0.2, n_steps=20)
x_exact = np.linspace(0, 4, 200)
y_exact = np.exp(x_exact)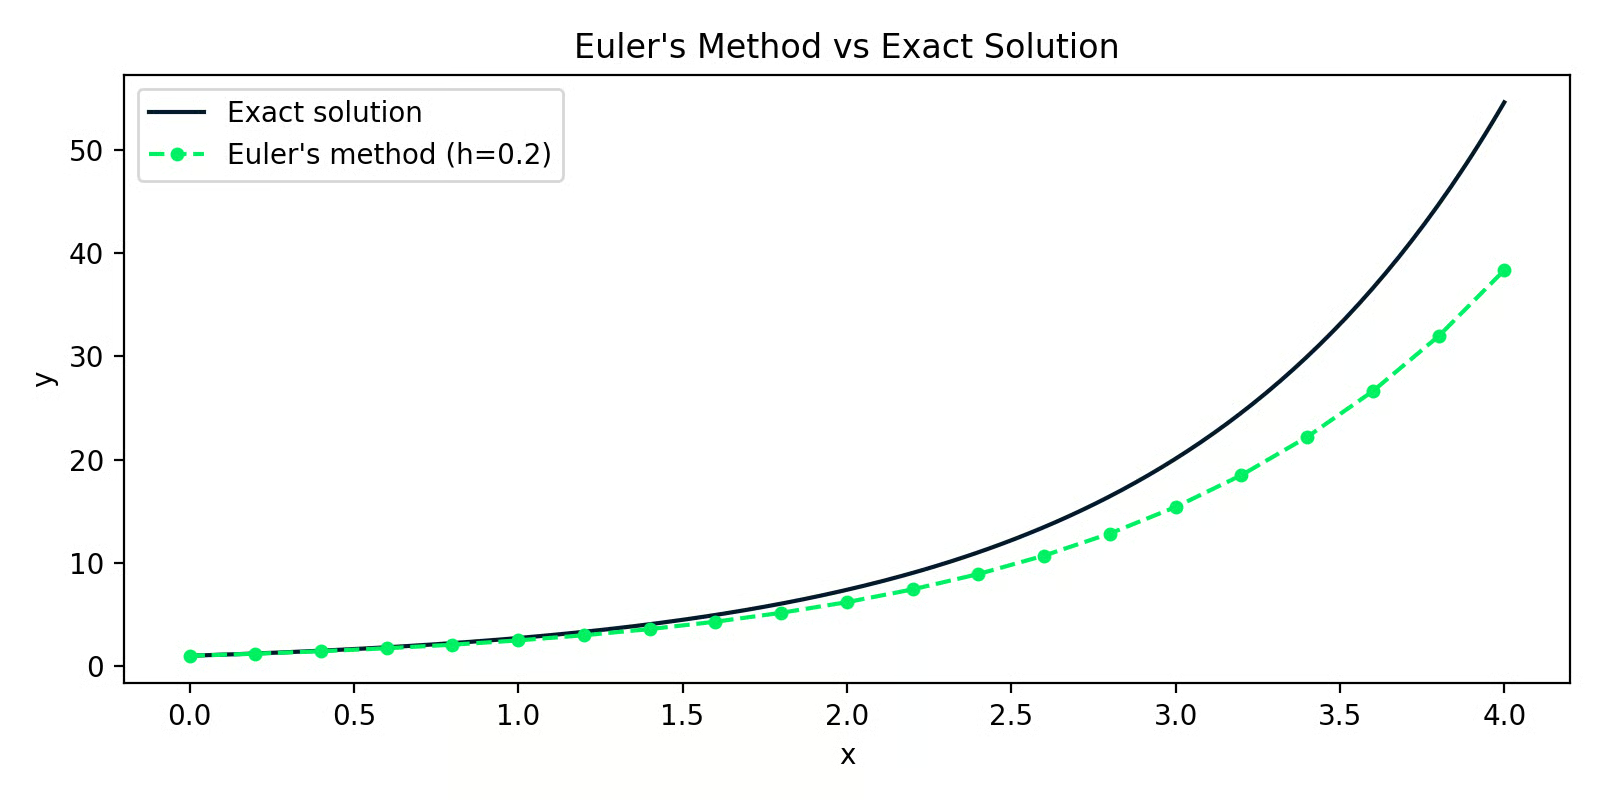
Método de Euler versus solução exata
A lacuna entre as duas linhas é o erro de aproximação. Com h=0.2, o erro é pequeno no início, mas se acumula a cada passo — essa é a principal fraqueza do método de Euler.
Métodos de Runge-Kutta
Os métodos de Runge-Kutta reduzem esse acúmulo de erro ao amostrar a inclinação em vários pontos dentro de cada passo e fazer uma média ponderada. A versão mais comum é RK4 — o método de Runge-Kutta de quarta ordem.
Em vez de uma única estimativa de inclinação por passo, como no Euler, o RK4 calcula quatro:
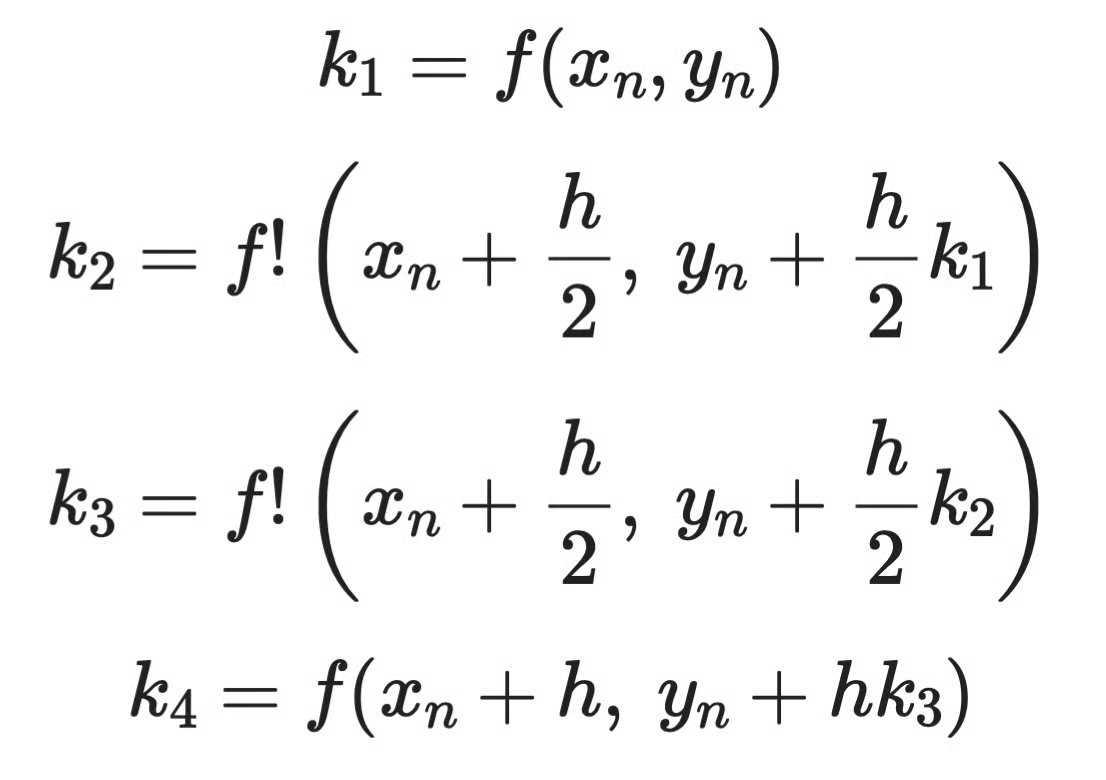
Exemplo de método de Runge-Kutta (1)
E depois combina tudo:
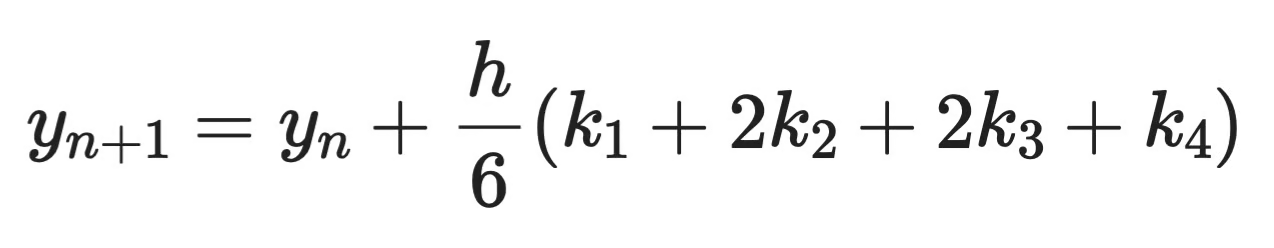
Exemplo de método de Runge-Kutta (2)
Na prática, você não implementa o RK4 na mão. O solve_ivp do SciPy cuida disso:
from scipy.integrate import solve_ivp
import numpy as np
import matplotlib.pyplot as plt

f = lambda x, y: y  # dy/dx = y

sol = solve_ivp(f, t_span=[0, 4], y0=[1], max_step=0.2)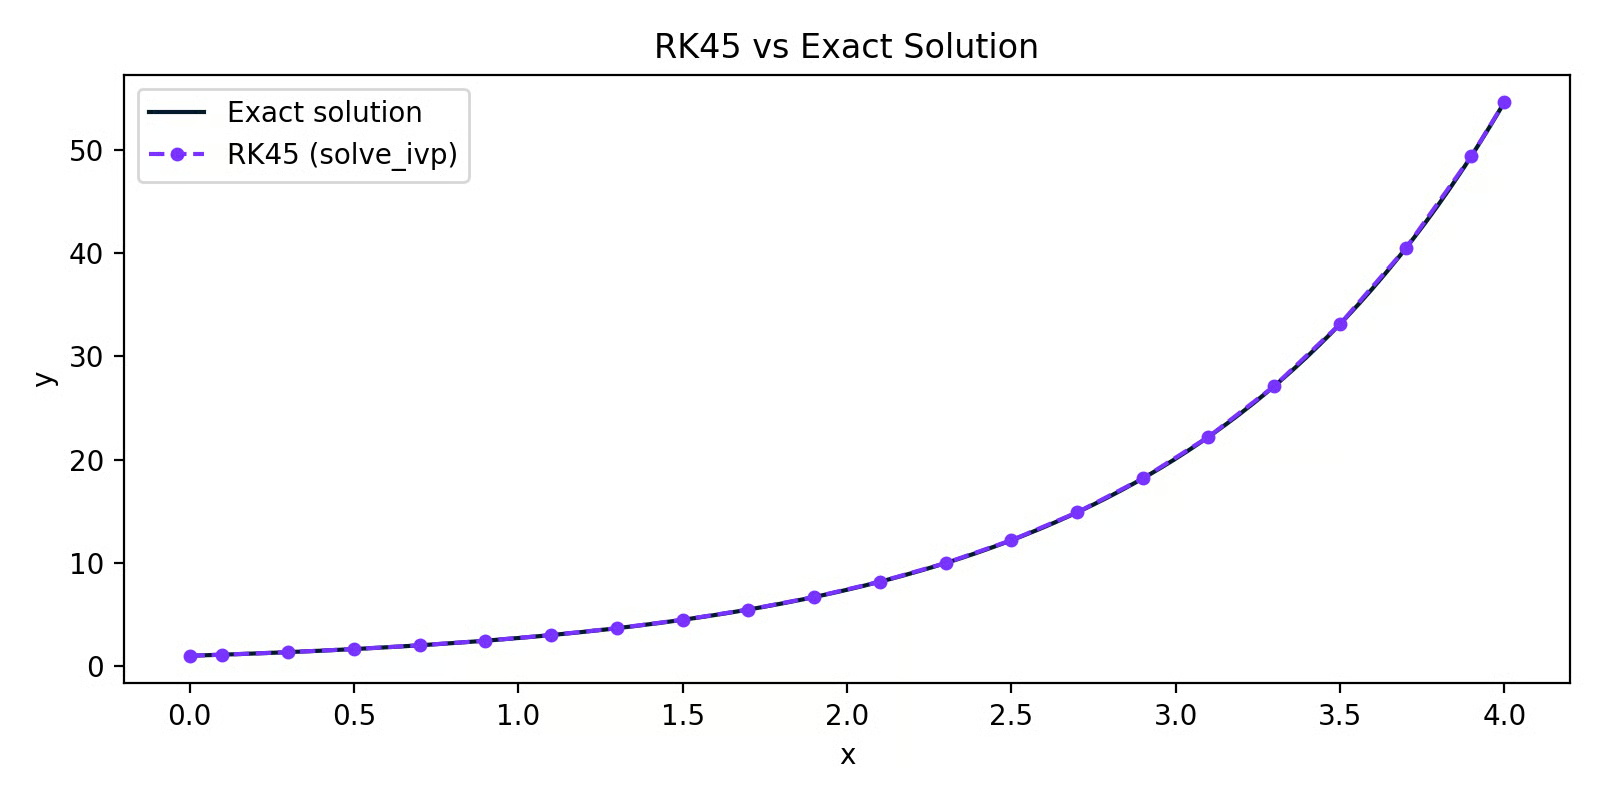
RK45 versus solução exata
A linha do RK45 fica praticamente em cima da solução exata. Mesmo tamanho de passo do exemplo com Euler, mas com precisão muito maior — essa é a diferença que a amostragem ponderada da inclinação faz.
Para a maior parte do trabalho prático em Python, solve_ivp com o solver padrão RK45 é a melhor escolha. O método de Euler é útil para entender como os solvers numéricos funcionam, mas não é o que você usaria em produção.
Aplicações de equações diferenciais em ciência de dados e machine learning
Engenheiros usam equações diferenciais para modelar circuitos elétricos e sistemas mecânicos. Biólogos as usam para acompanhar dinâmica populacional e disseminação de doenças. Físicos as usam para descrever de transferência de calor a mecânica quântica.
Mas você está aqui por ciência de dados, então vamos ao que interessa.
Machine learning e otimização
A conexão mais direta entre equações diferenciais e ML é o gradiente descendente — o algoritmo por trás do treinamento de quase todo modelo que você constrói.
Ao treinar um modelo, você está minimizando uma função de perda L. Para isso, precisa saber como L muda conforme ajusta cada parâmetro. Essa taxa de variação é uma derivada. Quando seu modelo tem vários parâmetros, você calcula uma derivada parcial para cada um — juntas, elas formam o gradiente.
O gradiente descendente usa essas derivadas para atualizar os parâmetros passo a passo:
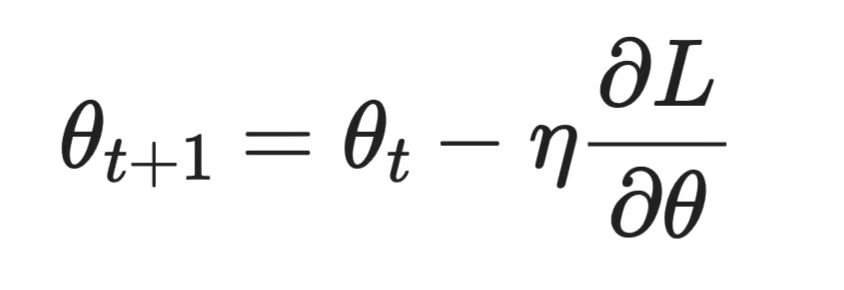
Gradiente descendente
Onde θ é o parâmetro, η é a taxa de aprendizado e ∂L/∂θ é a derivada parcial da perda em relação a esse parâmetro.
Aqui vai um exemplo simples em Python ajustando uma reta aos dados com gradiente descendente:
import numpy as np
import matplotlib.pyplot as plt

np.random.seed(42)
X = np.linspace(0, 10, 100)
y = 2.5 * X + np.random.randn(100) * 2

# Initialize parameters
theta = 0.0
bias = 0.0
eta = 0.001
n = len(X)
losses = []

for _ in range(500):
    y_pred = theta * X + bias
    loss = np.mean((y_pred - y) ** 2)
    losses.append(loss)

    # Partial derivatives
    d_theta = (2/n) * np.sum((y_pred - y) * X)
    d_bias  = (2/n) * np.sum(y_pred - y)

    theta -= eta * d_theta
    bias  -= eta * d_bias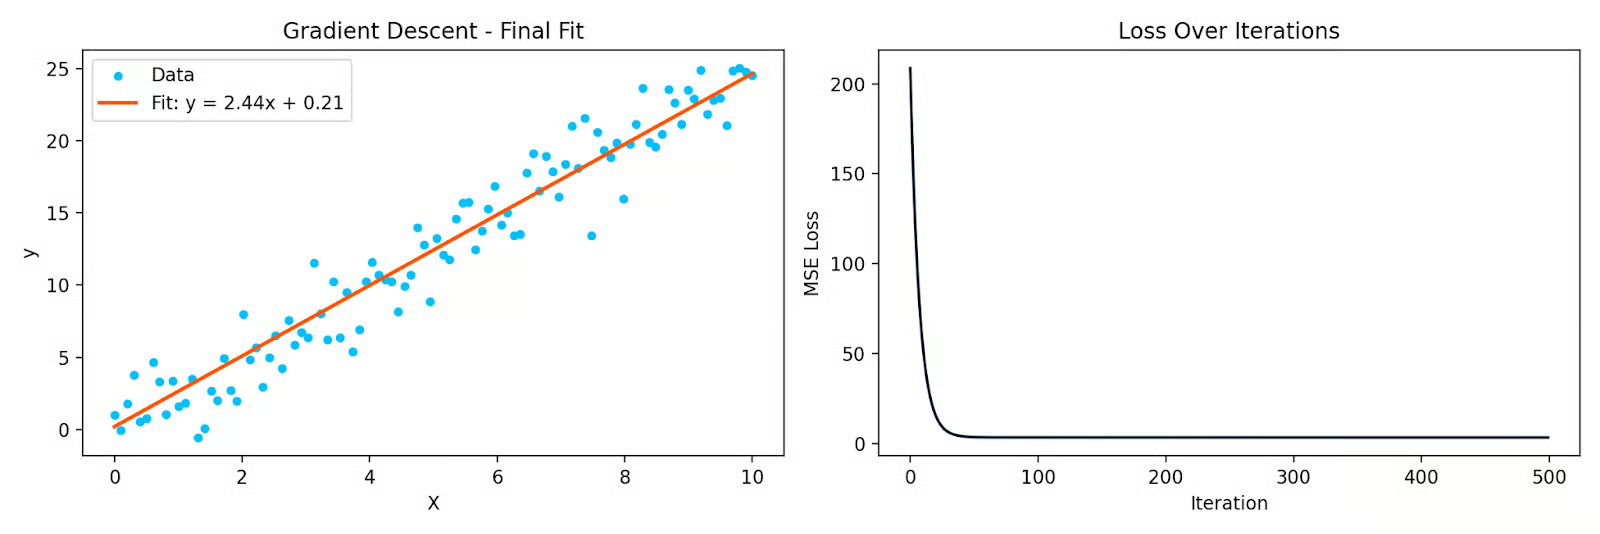
Ajuste de uma reta com gradiente descendente e a curva de perda ao longo das iterações
Cada iteração move os parâmetros na direção que reduz a perda. As derivadas parciais indicam qual é essa direção. Sem elas, o gradiente descendente não funciona — e o mesmo vale para o backpropagation em redes neurais, que é apenas a regra da cadeia aplicada repetidamente pelas camadas.
Análise de séries temporais
Muitos sistemas de séries temporais são dinâmicos — o valor atual depende dos valores passados e de como as coisas estão mudando. Equações diferenciais permitem descrever isso.
O filtro de Kalman, amplamente usado em rastreamento e previsão, é construído sobre um sistema de equações diferenciais que modela como um estado oculto evolui ao longo do tempo e como observações ruidosas se relacionam a esse estado. Ele é usado em sistemas de GPS, finanças e previsão do tempo.
Modelos ARIMA são usados para previsão em séries temporais e se conectam às equações diferenciais pelo conceito de diferenciação. Tomar primeiras ou segundas diferenças de uma série é uma aproximação discreta de derivadas de primeira e segunda ordem. Ao diferenciar uma série para torná-la estacionária, você está perguntando: como essa série está mudando ao longo do tempo?
Modelagem estatística e regressão
Aqui vai uma que surpreende muita gente: resolver um sistema de equações diferenciais é uma das formas de derivar os coeficientes de regressão linear.
Ao ajustar um modelo de regressão linear, você minimiza a soma dos quadrados dos resíduos. Tome a derivada parcial dessa perda em relação a cada coeficiente, iguale a zero e resolva. Isso te dá a equação normal:
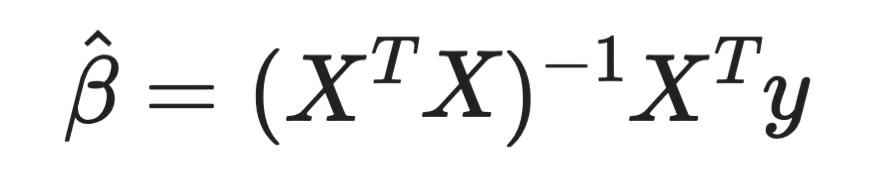
Equação normal
Todo coeficiente de regressão que você já calculou veio de zerar uma derivada e resolver. Isso é cálculo — e é o mesmo princípio por trás de todo modelo paramétrico que você ajusta.
Para regressão logística, a função de perda não é quadrática, então não há solução fechada. Você precisa usar métodos iterativos como o gradiente descendente, que novamente dependem de derivadas parciais a cada passo.
A conexão vai além. A decomposição QR, um dos métodos numéricos padrão para resolver a equação normal, é fundamentada em álgebra linear, que se conecta diretamente a como sistemas de equações — inclusive diferenciais — são resolvidos na prática.
Simulação de sistemas dinâmicos
Quando você precisa modelar como um sistema evolui ao longo do tempo — e não existe solução analítica —, a saída é simular numericamente.
Isso é comum em negócios e operações. Churn de clientes, níveis de estoque e dinâmica de cadeia de suprimentos envolvem quantidades que mudam com base no estado atual. Você pode escrever essas relações como equações diferenciais e simulá-las com solve_ivp.
Veja um exemplo simulando um sistema simples de oferta e demanda em que o estoque I se esgota a uma taxa proporcional à demanda D, e a demanda varia ao longo do tempo:
import numpy as np
from scipy.integrate import solve_ivp
import matplotlib.pyplot as plt

def supply_chain(t, y):
    I, D = y
    dD_dt = 0.1 * np.sin(0.5 * t)   # demand fluctuates over time
    dI_dt = -D                      # inventory depletes at the demand rate
    return [dI_dt, dD_dt]

sol = solve_ivp(
    supply_chain,
    t_span=[0, 20],
    y0=[100, 5],  # initial inventory=100, demand=5
    max_step=0.1
)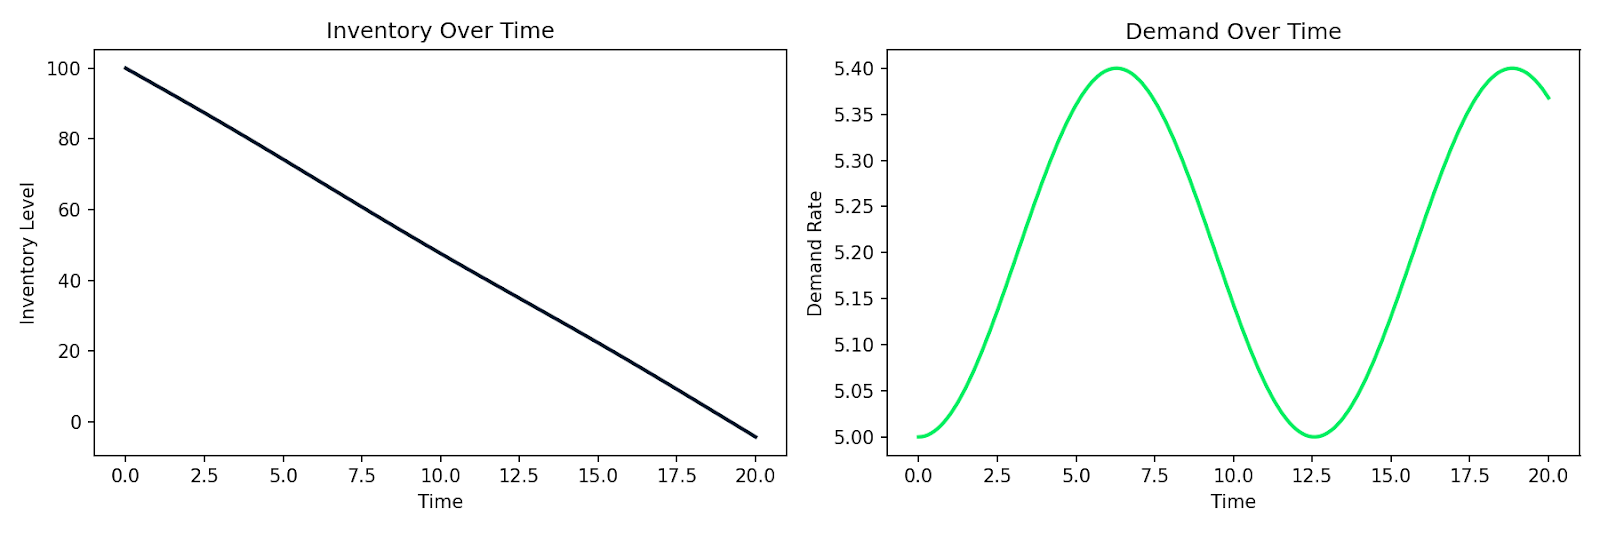
Esgotamento simulado de estoque ao lado da demanda flutuante ao longo do tempo
O mesmo padrão se aplica à modelagem de comportamento de clientes, à propagação de epidemias em uma base de usuários ou a qualquer sistema em que a taxa de mudança dependa do estado atual. Você escreve as relações, entrega a um solver numérico e recebe uma simulação de volta.
E essa é a força prática das equações diferenciais na ciência de dados. É uma ferramenta direta para modelar sistemas que mudam.
Conclusão
Por trás do gradiente descendente, há derivadas parciais. Por trás da previsão em séries temporais, há sistemas dinâmicos. Por trás dos coeficientes de regressão linear, há derivadas igualadas a zero. Você só precisa saber onde olhar.
Neste artigo, expliquei o que são equações diferenciais, a diferença entre EDOs e EDPs, como ordem e grau as classificam e os principais métodos para resolvê-las — analíticos e numéricos. Depois vimos onde elas realmente aparecem no dia a dia da ciência de dados e do machine learning.
Isso é só a base. Se quiser explorar mais tópicos de matemática, o curso Linear Algebra for Data Science in R é um bom próximo passo. Para praticar aplicando esses conceitos a problemas reais, confira nosso curso Quantitative Analyst in R.