
LLMs के संदर्भ में फाइन-ट्यूनिंग क्या है, और यह क्यों महत्वपूर्ण है?
फाइन-ट्यूनिंग का अर्थ है एक प्री-ट्रेन मॉडल को लेना और उसे एक छोटे, कार्य-विशिष्ट डेटासेट पर आगे प्रशिक्षित करना। यह प्रक्रिया मॉडल को विशिष्ट अनुप्रयोग की बारीकियों के अनुरूप अपने सामान्य भाषा-ज्ञान को ढालने में मदद करती है, जिससे प्रदर्शन बेहतर होता है।
यह एक महत्वपूर्ण तकनीक है क्योंकि यह प्री-ट्रेनिंग के दौरान अर्जित व्यापक भाषा-ज्ञान का लाभ उठाते हुए मॉडल को भावना विश्लेषण, पाठ संक्षेपण या प्रश्न-उत्तर जैसे विशिष्ट अनुप्रयोगों में अच्छा प्रदर्शन करने के लिए अनुकूलित करती है।
LLMs के उपयोग से जुड़ी कुछ सामान्य चुनौतियाँ क्या हैं?
LLMs का उपयोग कई चुनौतियों के साथ आता है, जिनमें शामिल हैं:
- संगणनात्मक संसाधन: LLMs को महत्वपूर्ण कंप्यूटिंग शक्ति और मेमोरी चाहिए, जिससे प्रशिक्षण और परिनियोजन संसाधन-गहन हो जाते हैं।
- पक्षपात और निष्पक्षता: LLMs प्रशिक्षण डेटा में मौजूद पक्षपात को अनजाने में सीख और फैला सकते हैं, जिससे अनुचित या पक्षपाती आउटपुट हो सकते हैं।
- व्याख्यात्मकता: LLMs द्वारा लिए गए निर्णयों को समझना और समझाना इनके जटिल और अपारदर्शी स्वरूप के कारण कठिन हो सकता है।
- डेटा गोपनीयता: प्रशिक्षण के लिए बड़े डेटासेट का उपयोग डेटा गोपनीयता और सुरक्षा से जुड़ी चिंताएँ पैदा कर सकता है।
- लागत: LLMs का विकास, प्रशिक्षण और परिनियोजन महंगा हो सकता है, जिससे छोटे संगठनों के लिए पहुँच सीमित हो जाती है।
LLMs शब्दकोश से बाहर (OOV) शब्दों या टोकन को कैसे संभालते हैं?
LLMs OOV शब्दों या टोकन को subword tokenization (जैसे Byte Pair Encoding या BPE, और WordPiece) जैसी तकनीकों से संभालते हैं। ये तकनीकें अज्ञात शब्दों को छोटे, ज्ञात सबवर्ड यूनिट्स में तोड़ती हैं जिन्हें मॉडल प्रोसेस कर सकता है।
यह तरीका सुनिश्चित करता है कि भले ही कोई शब्द प्रशिक्षण के दौरान न दिखा हो, मॉडल उसके घटक भागों के आधार पर टेक्स्ट को समझ और जनरेट कर सके, जिससे लचीलापन और मजबूती बढ़ती है।
Embedding लेयर्स क्या हैं, और LLMs में वे क्यों महत्वपूर्ण हैं?
Embedding लेयर्स LLMs का एक महत्वपूर्ण घटक हैं, जिनका उपयोग श्रेणीबद्ध डेटा, जैसे शब्दों, को घने वेक्टर प्रतिनिधित्वों में बदलने के लिए किया जाता है। ये एम्बेडिंग्स शब्दों के बीच के अर्थगत संबंधों को पकड़ते हैं, उन्हें एक सतत वेक्टर स्पेस में दर्शाकर जहाँ समान शब्द अधिक निकटता दिखाते हैं। LLMs में embedding लेयर्स का महत्व इसमें है:
- आयाम में कमी: वे इनपुट डेटा के आयाम को कम करते हैं, जिससे मॉडल के लिए प्रोसेस करना अधिक सुगम हो जाता है।
- अर्थगत समझ: एम्बेडिंग्स शब्दों के सूक्ष्म अर्थ और संबंधों को पकड़ती हैं, जिससे मॉडल की मानव-समान टेक्स्ट समझने और जनरेट करने की क्षमता बढ़ती है।
- ट्रांसफर लर्निंग: प्री-ट्रेन एम्बेडिंग्स को विभिन्न मॉडलों और कार्यों में उपयोग किया जा सकता है, जो विशेष अनुप्रयोगों के लिए फाइन-ट्यूनिंग हेतु भाषा-समझ का मजबूत आधार देती हैं।
आधुनिक LLM positional encodings कैसे काम करते हैं, और Rotary Position Embeddings (RoPE) मानक क्यों बन गए?
Positional encodings ट्रांसफॉर्मरों को बताते हैं कि अनुक्रम में प्रत्येक टोकन कहाँ स्थित है।
पारंपरिक साइनुसॉयडल positional encodings (Vaswani et al., 2017) स्थिर गणितीय फलनों से स्थितियों को स्थैतिक रूप से एन्कोड करते थे। हाल में प्रस्तुत Rotary Position Embeddings (RoPE) आधुनिक LLMs में मानक बन गए हैं क्योंकि वे मौलिक रूप से श्रेष्ठ गुण प्रदान करते हैं।
RoPE स्थितियों को कॉम्प्लेक्स वेक्टर स्पेस में घूर्णन कोणों के रूप में दर्शाकर काम करता है, जहाँ टोकन एम्बेडिंग्स को उनकी स्थिति के अनुपात में एक कोण से घुमाया जाता है। यह ज्यामितीय दृष्टिकोण अधिक कुशल है और प्रशिक्षण के दौरान देखी गई लंबाइयों से भी लंबी श्रृंखलाओं तक प्राकृतिक रूप से इंटरपोलेशन का समर्थन करता है, जो context window बढ़ाने के लिए नितांत आवश्यक क्षमता है। GPT-5.2 और Gemini 3 जैसे मॉडल RoPE को अपने positional encoding के रूप में उपयोग करते हैं।
इंटरमीडिएट LLM इंटरव्यू प्रश्न
बुनियादी अवधारणाओं पर आगे बढ़ते हुए, मध्यम-स्तर के प्रश्न LLM प्रदर्शन को अनुकूलित करने के लिए प्रयुक्त व्यावहारिक तकनीकों पर केंद्रित होते हैं और संगणनात्मक दक्षता तथा मॉडल व्याख्यात्मकता से जुड़ी चुनौतियों को संबोधित करते हैं।
LLMs में attention की अवधारणा समझाएँ और यह कैसे लागू होती है।
LLMs में attention की अवधारणा एक ऐसी विधि है जो मॉडल को भविष्यवाणी करते समय इनपुट अनुक्रम के विभिन्न भागों पर ध्यान केंद्रित करने देती है। यह इनपुट के अन्य टोकनों को गतिशील रूप से वज़न सौंपती है, ताकि वर्तमान कार्य के लिए सबसे प्रासंगिक टोकन उभरकर आएँ।
इसे self-attention के माध्यम से लागू किया जाता है, जहाँ मॉडल अनुक्रम में प्रत्येक टोकन के लिए सभी अन्य टोकनों के सापेक्ष attention स्कोर गणना करता है, जिससे दूरी की परवाह किए बिना निर्भरताओं को पकड़ना संभव होता है।
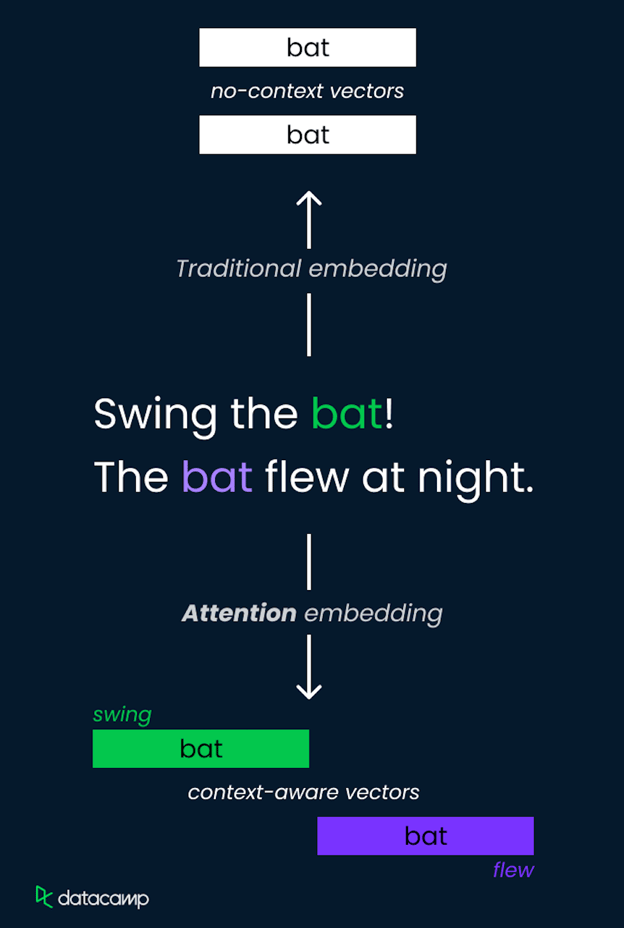
Self-attention तंत्र Transformer आर्किटेक्चर का मुख्य घटक है, जो सूचना को कुशलता से प्रोसेस करने और लंबी दूरी के संबंधों को पकड़ने में सक्षम बनाता है।
LLM प्रोसेसिंग में tokenization की भूमिका क्या है?
Tokenization कच्चे टेक्स्ट को छोटे-छोटे यूनिट्स में बदलती है जिन्हें टोकन कहा जाता है, जो शब्द, सबवर्ड या अक्षर हो सकते हैं।
LLM प्रोसेसिंग में tokenization की भूमिका महत्वपूर्ण है क्योंकि यह टेक्स्ट को ऐसे प्रारूप में बदलती है जिसे मॉडल समझ और प्रोसेस कर सके।
प्रभावी tokenization सुनिश्चित करती है कि मॉडल दुर्लभ शब्दों और विभिन्न भाषाओं सहित विविध इनपुट को संभाल सके, उन्हें प्रबंधनीय हिस्सों में तोड़कर। यह चरण प्रशिक्षण और अनुमान (inference) दोनों के लिए आवश्यक है, क्योंकि यह इनपुट को मानकीकृत करता है और मॉडल को डेटा में सार्थक पैटर्न सीखने में सहायता करता है।
आप LLM के प्रदर्शन को कैसे मापते हैं?
शोधकर्ताओं और प्रैक्टिशनरों ने LLM के प्रदर्शन का आकलन करने के लिए अनेक मूल्यांकन मीट्रिक्स विकसित किए हैं। पारंपरिक मीट्रिक्स में शामिल हैं:
- Perplexity: यह मापता है कि मॉडल किसी नमूने की कितनी अच्छी भविष्यवाणी करता है; भाषा मॉडलिंग कार्यों में सामान्य।
- Accuracy: टेक्स्ट वर्गीकरण जैसे कार्यों में सही भविष्यवाणियों के अनुपात को मापने के लिए।
- F1 Score: precision और recall का हार्मोनिक माध्य; नामित इकाई मान्यता जैसे कार्यों में।
- BLEU (Bilingual Evaluation Understudy) स्कोर: मशीन-जनित टेक्स्ट की गुणवत्ता को संदर्भ अनुवादों के विरुद्ध मापता है; मशीन अनुवाद में सामान्य।
- ROUGE (Recall-Oriented Understudy for Gisting Evaluation): मेट्रिक्स का एक सेट जो जनरेट किए गए टेक्स्ट और संदर्भ टेक्स्ट के बीच ओवरलैप का मूल्यांकन करता है; संक्षेपण कार्यों में प्रचलित। ये मॉडल की प्रभावशीलता को मापने और आगे सुधार का मार्गदर्शन करने में मदद करते हैं।
पारंपरिक मीट्रिक्स से आगे बढ़कर, अब प्रैक्टिशनर अलग-अलग उद्देश्यों के लिए मानकीकृत benchmarks का उपयोग करते हैं, जैसे MMLU (57-टास्क नॉलेज टेस्ट), MMMU-Pro (मल्टीमॉडल रीजनिंग), और HumanEval (कोड जनरेशन)। इसके अलावा, LMArena जैसी लीडरबोर्ड्स LLMs को मानवीय वरीयता के आधार पर रैंक करती हैं। परिनियोजित सिस्टमों के लिए, वास्तविक दुनिया के hallucination दर, विलंबता, और टोकन दक्षता का मापन आवश्यक हो गया है।
LLM के आउटपुट को नियंत्रित करने की कुछ तकनीकें क्या हैं?
LLM के आउटपुट को नियंत्रित करने के लिए कई तकनीकें उपयोग की जा सकती हैं, जिनमें शामिल हैं:
- Temperature: सैंपलिंग के दौरान इस पैरामीटर को समायोजित करने से आउटपुट की रैंडमनेस नियंत्रित होती है। कम तापमान अधिक निर्धारक आउटपुट देता है, जबकि अधिक मान अधिक विविध परिणाम लौटाते हैं।
- Top-K sampling: सैंपलिंग पूल को सबसे संभावित K टोकनों तक सीमित करता है, जिससे कम प्रासंगिक या निरर्थक टेक्स्ट जनरेट होने की संभावना घटती है।
- Top-P (nucleus) sampling: उन सबसे छोटे टोकन-समूह से चयन करता है जिनकी संचयी प्रायिकता सीमा P से अधिक हो, जिससे विविधता और सुसंगति में संतुलन रहता है।
- Prompt engineering: विशिष्ट प्रॉम्प्ट तैयार करना ताकि संदर्भ या उदाहरण देकर मॉडल को वांछित आउटपुट की ओर निर्देशित किया जा सके।
- Control tokens: विशेष टोकन का उपयोग करके मॉडल को किसी विशिष्ट शैली, प्रारूप या सामग्री प्रकार में टेक्स्ट जनरेट करने का संकेत देना।
LLMs की संगणनात्मक लागत कम करने के कुछ तरीके क्या हैं?
LLMs की संगणनात्मक लागत कम करने के लिए हम निम्नलिखित अपना सकते हैं:
- Model pruning: कम महत्वपूर्ण वेट्स या न्यूरॉन्स हटाकर मॉडल का आकार और संगणनात्मक आवश्यकताएँ घटाना।
- Quantization: मॉडल वेट्स को उच्च-सटीकता (जैसे 32-बिट फ्लोट) से कम-सटीकता (जैसे 8-बिट इंटेजर) में बदलना, जिससे मेमोरी उपयोग घटता है और इन्फरेंस तेज होता है।
- Distillation: छोटे मॉडल (student) को बड़े, प्री-ट्रेन मॉडल (teacher) के व्यवहार की नकल करना सिखाना, ताकि कम संसाधनों में समान प्रदर्शन मिल सके।
- Sparse attention: sparse transformers जैसी तकनीकों का उपयोग कर attention तंत्र को टोकनों के उपसमुच्चय तक सीमित करना, जिससे संगणनात्मक भार घटे।
- कुशल आर्किटेक्चर: ऐसे कुशल मॉडल आर्किटेक्चर विकसित और उपयोग करना जो प्रदर्शन बनाए रखते हुए संगणनात्मक माँग को न्यूनतम रखने के लिए डिज़ाइन किए गए हों, जैसे Reformer या Longformer।
LLMs में मॉडल व्याख्यात्मकता का महत्व क्या है, और इसे कैसे हासिल किया जा सकता है?
मॉडल व्याख्यात्मकता यह समझने के लिए आवश्यक है कि LLM फैसले कैसे लेता है, जो भरोसा बनाने, जवाबदेही सुनिश्चित करने, और पक्षपात पहचानने व कम करने के लिए महत्वपूर्ण है। व्याख्यात्मकता हासिल करने के लिए अलग-अलग तरीकों का सहारा लिया जा सकता है, जैसे:
- Attention visualization: यह विश्लेषण करना कि मॉडल इनपुट के किन भागों पर ध्यान केंद्रित करता है।
- Saliency maps: उन इनपुट फीचर्स को हाइलाइट करना जिनका मॉडल के आउटपुट पर सबसे बड़ा प्रभाव है।
- Model-Agnostic तरीके: LIME (Local Interpretable Model-agnostic Explanations) जैसी तकनीकों का उपयोग कर व्यक्तिगत भविष्यवाणियों की व्याख्या करना।
- Layer-wise relevance propagation: मॉडल की भविष्यवाणियों को प्रत्येक लेयर या न्यूरॉन के योगदान में विभाजित करना।
LLMs टेक्स्ट में long-term निर्भरताओं को कैसे संभालते हैं?
LLMs अपनी आर्किटेक्चर, विशेष रूप से self-attention तंत्र, के माध्यम से long-term निर्भरताओं को संभालते हैं, जो उन्हें इनपुट अनुक्रम के सभी टोकनों पर एक साथ विचार करने देता है। दूरस्थ टोकनों पर ध्यान देने की यह क्षमता LLMs को लंबे संदर्भों में संबंधों और निर्भरताओं को पकड़ने में मदद करती है।
इसके अलावा, Transformer-XL और Longformer जैसे उन्नत मॉडल विशेष रूप से context window का विस्तार करने और लंबी श्रृंखलाओं को अधिक प्रभावी ढंग से संभालने के लिए डिज़ाइन किए गए हैं, जिससे long-term निर्भरताओं का बेहतर प्रबंधन सुनिश्चित होता है।
आधुनिक प्रोडक्शन मॉडल लंबी अवधि की निर्भरताओं को संभालने और context window के विस्तार के साथ प्रदर्शन में गिरावट का मुकाबला करने के लिए अधिक उन्नत रणनीतियाँ अपनाते हैं, जैसे:
- बेहतर length extrapolation और श्रेष्ठ position encoding के लिए Rotary Position Embeddings (RoPE)।
- लंबी श्रृंखलाओं के लिए अनुकूलित attention पैटर्न, जिनमें grouped-query और multi-head attention वेरिएंट शामिल हैं।
- सिर्फ context window क्षमता पर निर्भर रहने के बजाय RAG के माध्यम से सावधानीपूर्वक नॉलेज इंटीग्रेशन।
Retrieval-Augmented Generation (RAG) क्या है और यह कैसे विकसित हुआ है?
RAG जनरेशन के दौरान बाहरी स्रोतों से प्रासंगिक जानकारी लाने के लिए रिट्रीवल तंत्रों को जनरेटिव मॉडलों के साथ जोड़ता है। यह दृष्टिकोण LLMs की दो महत्वपूर्ण सीमाओं—hallucination और जानकारी की नवीनता—को सीधे संबोधित करता है। पारंपरिक RAG अपेक्षाकृत सरल रिट्रीवल और जनरेशन पाइपलाइनों का उपयोग करता था, लेकिन "RAG 2.0" में विकसित होकर यह काफी अधिक परिष्कृत हो गया है।
RAG 2.0 की प्रमुख विशेषताएँ:
- Recursive retrieval: मॉडल्स प्राप्त जानकारी में कमी पर विचार करते हैं और ज्ञान-अंतर भरने के लिए एकल रिट्रीवल पास पर निर्भर रहने के बजाय द्वितीयक या तृतीयक खोजें सक्रिय रूप से करते हैं
- Multimodal retrieval: विविध प्रारूपों—टेक्स्ट, इमेज, PDFs, वीडियो, और यहाँ तक कि API कॉल्स—में एकीकरण, जिससे अधिक समृद्ध संदर्भ-संग्रह संभव होता है
- Hybrid indexing: BM25 (कीवर्ड-आधारित) और वेक्टर (सीमांतिक) सर्च को मिलाकर शब्दावलीगत और अर्थगत प्रासंगिकता दोनों को कैप्चर करना
- Re-ranking लेयर्स: प्रारंभिक रिट्रीवल परिणामों का स्मार्ट फ़िल्टरिंग ताकि शोर और अप्रासंगिक जानकारी घटे
- Agentic adaptation: डायनेमिक रणनीति चयन, जहाँ सिस्टम क्वेरी की जटिलता और डोमेन के आधार पर रिट्रीवल तरीकों का चयन करता है
RAG 2.0, LLMs के साथ मिलकर, बेस मॉडलों की तुलना में प्रोडक्शन सिस्टम्स में hallucination दर को 40-60% तक प्रभावी रूप से घटाता है।
एडवांस्ड LLM इंटरव्यू प्रश्न
LLMs में उन्नत अवधारणाएँ समझना उन पेशेवरों के लिए उपयोगी है जो इन मॉडलों की क्षमताओं की सीमाओं को आगे बढ़ाना चाहते हैं। यह अनुभाग जटिल विषयों और क्षेत्र में आने वाली सामान्य चुनौतियों की पड़ताल करता है।
LLMs में "few-shot learning" की अवधारणा समझाएँ और इसके लाभ बताइए।
Few-shot learning से तात्पर्य है कि मॉडल केवल कुछ उदाहरणों के आधार पर नए कार्य सीखकर पूरा कर सके। यह क्षमता LLM के व्यापक प्री-ट्रेन ज्ञान का लाभ उठाती है, जिससे यह कम उदाहरणों से सामान्यीकरण कर पाता है।
Few-shot learning के प्रमुख लाभों में शामिल हैं: डेटा आवश्यकताओं में कमी, क्योंकि बड़े कार्य-विशिष्ट डेटासेट की ज़रूरत घटती है; लचीलापन बढ़ना, जिससे मॉडल न्यूनतम फाइन-ट्यूनिंग के साथ विभिन्न कार्यों के अनुरूप ढल पाता है; और लागत दक्षता, क्योंकि कम डेटा आवश्यकताओं और घटे प्रशिक्षण समय से डेटा संग्रह तथा संगणन संसाधनों में उल्लेखनीय बचत होती है।
Autoregressive और masked language मॉडलों में क्या अंतर है?
Autoregressive और masked language मॉडल मुख्यतः अपनी भविष्यवाणी पद्धति और कार्य-उपयुक्तता में भिन्न होते हैं। Autoregressive मॉडल, जैसे GPT-5.2, Claude 4.5 Opus, और Gemini 3, अनुक्रम में पिछले शब्दों के आधार पर अगले शब्द की भविष्यवाणी करते हैं और एक-एक टोकन करके टेक्स्ट जनरेट करते हैं।
ये मॉडल विशेष रूप से टेक्स्ट-जनरेशन कार्यों के लिए उपयुक्त हैं। इसके विपरीत, masked language मॉडल, जैसे BERT, वाक्य में शब्दों को यादृच्छिक रूप से मास्क करते हैं और आस-पास के संदर्भ के आधार पर इन शब्दों की भविष्यवाणी के लिए मॉडल को प्रशिक्षित करते हैं। यह द्विदिश दृष्टिकोण मॉडल को दोनों दिशाओं से संदर्भ समझने में मदद करता है, जो टेक्स्ट वर्गीकरण और प्रश्न-उत्तर जैसे कार्यों के लिए आदर्श है।
आप LLM में बाहरी ज्ञान को कैसे सम्मिलित कर सकते हैं?
बाहरी ज्ञान को LLM में शामिल करने के कई तरीके हैं:
- Knowledge graph एकीकरण: मॉडल के इनपुट को संरचित नॉलेज ग्राफ़ से जानकारी के साथ समृद्ध करना ताकि संदर्भ उपलब्ध हो।
- Retrieval-Augmented Generation (RAG): जनरेशन के दौरान बाहरी स्रोतों से प्रासंगिक जानकारी लाने के लिए रिट्रीवल तरीकों को जनरेटिव मॉडलों के साथ जोड़ता है। आधुनिक RAG 2.0 सिस्टम सरल रिट्रीवल तरीकों की तुलना में बेहतर नॉलेज इंटीग्रेशन के लिए recursive retrieval, hybrid indexing और re-ranking का उपयोग करते हैं।
- डोमेन-विशिष्ट डेटा के साथ फाइन-ट्यूनिंग: अतिरिक्त डेटासेट्स पर मॉडल को प्रशिक्षित करना जिनमें आवश्यक ज्ञान हो, ताकि विशिष्ट कार्यों या डोमेनों के लिए इसे विशेषज्ञ बनाया जा सके।
- Prompt engineering: ऐसे प्रॉम्प्ट डिज़ाइन करना जो इन्फरेंस के दौरान मॉडल को बाहरी ज्ञान का प्रभावी उपयोग करने के लिए निर्देशित करें।
प्रोडक्शन में LLMs को परिनियोजित करने से जुड़ी कुछ चुनौतियाँ क्या हैं?
प्रोडक्शन में LLMs का परिनियोजन कई चुनौतियों के साथ आता है:
- स्केलेबिलिटी: यह सुनिश्चित करना कि मॉडल बड़े अनुरोध-भार को कुशलतापूर्वक संभाल सके—अक्सर इसके लिए महत्वपूर्ण कंप्यूटिंग संसाधन और अनुकूलित इंफ्रास्ट्रक्चर चाहिए।
- विलंबता (Latency): चैटबॉट्स और वर्चुअल असिस्टेंट जैसी ऐप्स के लिए वास्तविक-समय या लगभग वास्तविक-समय आउटपुट हेतु प्रतिक्रिया समय को न्यूनतम रखना अत्यंत महत्वपूर्ण है।
- निगरानी और मेंटेनेंस: मॉडल प्रदर्शन की सतत निगरानी और विकसित होते डेटा व कार्यों को संभालने के लिए नियमित अपडेट; इसके लिए सुदृढ़ मॉनिटरिंग सिस्टम चाहिए।
- नैतिक और कानूनी विचार: पक्षपात, गोपनीयता और विनियमों के अनुपालन से जुड़े मुद्दों का समाधान आवश्यक है ताकि नैतिक जोखिमों और कानूनी परिणामों से बचा जा सके।
- संसाधन प्रबंधन: इन्फरेंस के लिए आवश्यक बड़े संगणनात्मक संसाधनों का प्रबंधन, लागत-प्रभावशीलता सुनिश्चित करने हेतु हार्डवेयर और सॉफ्टवेयर कॉन्फ़िगरेशन का अनुकूलन।
परिनियोजित LLMs में समय के साथ होने वाले मॉडल-क्षय (degradation) को आप कैसे संभालते हैं?
जब समय के साथ अंतर्निहित डेटा-वितरण बदलता है, तो LLM का प्रदर्शन घट सकता है—इसे मॉडल-क्षय कहते हैं। इसे संभालने के लिए अद्यतन डेटा के साथ नियमित री-ट्रेनिंग आवश्यक है। सतत मॉनिटरिंग करके मॉडल के प्रदर्शन को ट्रैक करना और क्षय के संकेतों का पता लगाना ज़रूरी है।
इंक्रीमेंटल लर्निंग तकनीकें मॉडल को नए डेटा से सीखने देती हैं बिना पहले सीखी बातों को भुलाए। साथ ही, A/B परीक्षण वर्तमान मॉडल के प्रदर्शन की नई वर्ज़नों से तुलना करता है और पूर्ण परिनियोजन से पहले संभावित सुधार पहचानने में मदद करता है।
LLMs के नैतिक उपयोग को सुनिश्चित करने की कुछ तकनीकें क्या हैं?
LLMs के नैतिक उपयोग को सुनिश्चित करने के लिए कई तकनीकें लागू की जा सकती हैं:
- पक्षपात शमन: संतुलित डेटासेट और बायस डिटेक्शन टूल्स का उपयोग करके प्रशिक्षण डेटा और मॉडल आउटपुट में पक्षपात की पहचान व कमी करना।
- पारदर्शिता और व्याख्यात्मकता: ऐसे मॉडल विकसित करना जिनके आउटपुट व्याख्यायोग्य हों, ताकि भरोसा और जवाबदेही बढ़े; इसमें attention visualization और saliency maps का उपयोग शामिल है।
- उपयोगकर्ता सहमति और गोपनीयता: प्रशिक्षण और इन्फरेंस में प्रयुक्त डेटा का गोपनीयता विनियमों के अनुरूप होना और जहाँ आवश्यक हो, उपयोगकर्ता की सहमति प्राप्त करना।
- Fairness audits: मॉडल के व्यवहार की निष्पक्षता और नैतिक प्रभावों का मूल्यांकन करने हेतु नियमित ऑडिट करना।
- जिम्मेदार परिनियोजन: जिम्मेदार AI परिनियोजन के लिए दिशा-निर्देश और नीतियाँ निर्धारित करना, जिसमें मॉडल द्वारा जनरेट किए गए हानिकारक या अनुपयुक्त कंटेंट को संभालना शामिल है।
LLMs के साथ प्रयुक्त डेटा की सुरक्षा आप कैसे सुनिश्चित करते हैं?
LLMs के साथ प्रयुक्त डेटा की सुरक्षा के लिए कई उपायों का कार्यान्वयन आवश्यक है। इनमें अनधिकृत पहुँच से बचाव के लिए स्थिर (at rest) और ट्रांज़िट में डेटा का एन्क्रिप्शन शामिल है। संवेदनशील डेटा तक केवल अधिकृत कर्मियों की पहुँच सुनिश्चित करने के लिए कड़े एक्सेस कंट्रोल ज़रूरी हैं।
प्रशिक्षण या इन्फरेंस से पहले व्यक्तिगत रूप से पहचान योग्य जानकारी (PII) हटाने हेतु डेटा का अनामीकरण भी महत्वपूर्ण है। इसके अतिरिक्त, GDPR या CCPA जैसे डेटा संरक्षण विनियमों का अनुपालन कानूनी समस्याओं से बचने के लिए आवश्यक है।
ये उपाय डेटा की अखंडता, गोपनीयता और उपलब्धता की रक्षा करते हैं। यह सुरक्षा उपयोगकर्ता के भरोसे को बनाए रखने और नियामक मानकों का पालन करने के लिए नितांत आवश्यक है।
मानव प्रतिक्रिया से सुदृढीकरण शिक्षण (RLHF) LLM के आउटपुट की गुणवत्ता और सुरक्षा कैसे सुधारता है, और यह DPO तथा RLAIF जैसी नई अलाइनमेंट विधियों की तुलना में कैसा है?
RLHF एक तकनीक है जिसमें मानव मूल्यांकनकर्ताओं से प्राप्त प्रतिक्रिया को शामिल करके LLM को मानवीय वरीयताओं के अनुरूप आउटपुट देने के लिए प्रशिक्षित किया जाता है। यह आवर्ती प्रक्रिया मॉडल को न केवल सटीक बल्कि सुरक्षित, निष्पक्ष और सहायक प्रतिक्रियाएँ जनरेट करना सिखाती है।
हालाँकि, RLHF के साथ चुनौतियाँ भी हैं। एक चुनौती मानव प्रतिक्रिया में संभावित पक्षपात है, क्योंकि विभिन्न मूल्यांकनकर्ताओं की वरीयताएँ और व्याख्याएँ भिन्न हो सकती हैं।
दूसरी चुनौती फीडबैक प्रक्रिया की स्केलेबिलिटी है, क्योंकि बड़े पैमाने पर मानव प्रतिक्रिया इकट्ठा करना और शामिल करना समय-साध्य और महंगा हो सकता है। इसके अतिरिक्त, RLHF में प्रयुक्त रिवॉर्ड मॉडल से वांछित व्यवहारों और मूल्यों का सही-सही प्रतिनिधित्व कराना भी मुश्किल हो सकता है। PPO (Proximal Policy Optimization) अनुकूलन चरण जटिलता जोड़ता है और प्रशिक्षण में अस्थिरता ला सकता है।
आधुनिक विकल्प उभरे हैं जो RLHF की कई सीमाओं को संबोधित करते हैं:
- DPO (Direct Preference Optimization): अलग रिवॉर्ड मॉडल की आवश्यकता पूरी तरह समाप्त कर देता है और वरीयता-युग्मों से सीधे प्राप्त निहित रिवॉर्ड संकेतों का उपयोग करता है। यह तरीका PPO-आधारित RLHF की तुलना में सरल, अधिक स्थिर और संगणनात्मक रूप से कुशल है। DPO अब प्रमुख AI लैब्स द्वारा पारंपरिक RLHF के विकल्प या परिशिष्ट के रूप में व्यापक रूप से अपनाया गया है।
- GRPO (Gradient-based Reward Policy Optimization): एक वैरिएंट जो DPO की सादगी को PPO-शैली के शिक्षण के पहलुओं के साथ जोड़ता है और संतुलित ट्रेड-ऑफ देता है।
- RLAIF (Reinforcement Learning from AI Feedback): मानव मूल्यांकनकर्ताओं के स्थान पर AI प्रतिक्रिया (जैसे अधिक सक्षम मॉडलों या विशेष मूल्यांकनकर्ताओं से रेटिंग) का उपयोग करता है। यह तरीका स्केलेबिलिटी चुनौतियों और लागत को काफी घटाता है क्योंकि AI प्रतिक्रिया जनरेट करना मानव प्रतिक्रिया इकट्ठा करने से सस्ता और तेज़ है।
अधिकांश प्रोडक्शन मॉडल शुद्ध PPO-आधारित RLHF की बजाय DPO, RLAIF या हाइब्रिड संयोजनों का उपयोग करते हैं।
State-space मॉडल (जैसे Mamba) की तुलना Transformers से करें। इनके बीच क्या ट्रेड-ऑफ हैं, और आप किसे कब उपयोग करेंगे?
ज्ञान-आधारित hallucinations तब होती हैं जब मॉडल के पास सही तथ्य नहीं होते (या पुराने होते हैं), तो वह संभावित लगने वाली जानकारी गढ़ देता है। इनके समाधान आमतौर पर शामिल करते हैं:
- रिट्रीवल (RAG) के साथ मॉडल को ग्राउंड करना
- सत्यापित स्रोत जोड़ना
- डोमेन-विशिष्ट फाइन-ट्यूनिंग
तर्क-आधारित hallucinations तब होती हैं जब मॉडल के पास प्रासंगिक जानकारी होती है लेकिन वह गलत तरीके से तर्क करता है या असंगतियाँ पैदा करता है। सामान्य समाधान हैं:
- संरचित प्रॉम्प्टिंग
- सत्यापन/स्वयं-जांच चरण (अक्सर agentic वर्कफ़्लोज़ के माध्यम से
- लक्षित मूल्यांकन
LLMs में knowledge-based और logic-based hallucinations में क्या अंतर है, और आप प्रत्येक को कैसे संबोधित करते हैं?
आज LLMs में Transformers का वर्चस्व है, फिर भी Mamba जैसे state-space मॉडल (SSMs) मूल रूप से अलग संगणनात्मक और प्रदर्शन गुणों के साथ एक प्रतिस्पर्धी आर्किटेक्चरल प्रतिरूप के रूप में उभरे हैं। दोनों को समझना आधुनिक LLM पेशेवरों के लिए बढ़ती आवश्यकता है।
Transformers:
- ताकतें: सूचना पुनर्प्राप्ति, कॉपी/पेस्ट कार्य और in-context लर्निंग में उत्कृष्ट। बड़े पैमाने पर प्रमाणित आर्किटेक्चर, व्यापक टूलिंग और इंफ्रास्ट्रक्चर के साथ। कोड जनरेशन और विविध बेंचमार्क्स पर मजबूत व्यावहारिक प्रदर्शन।
- कमज़ोरियाँ: O(N²) attention जटिलता, जो मेमोरी और संगणना की द्विघात आवश्यकताएँ पैदा करती है। यह बहुत लंबी श्रृंखलाओं (>100K टोकन) पर प्रदर्शन में गिरावट और long-context अनुप्रयोगों के लिए उच्च विलंबता के रूप में प्रकट होती है।
- उपयोग के मामले और सिफारिशें: आज अधिकांश प्रोडक्शन LLMs (GPT, Claude, Gemini, Llama)। वर्तमान वास्तविक-world अनुप्रयोगों और निकट भविष्य के लिए अनुशंसित।
State-Space Models (Mamba, Mamba-2):
- ताकतें: O(N) जटिलता के साथ रैखिक मेमोरी स्केलिंग। लंबी श्रृंखलाओं (>50K टोकन) पर 5-10x तेज़ इन्फरेंस। सिग्नल प्रोसेसिंग के लिए बेहतर सैद्धांतिक आधार। अधिक पूर्वानुमेय स्केलिंग व्यवहार।
- कमज़ोरियाँ: तुलनीय प्रदर्शन पाने के लिए Transformers से 10x अधिक प्रशिक्षण डेटा की आवश्यकता। सूचना पुनर्प्राप्ति और कॉपीिंग कार्यों में अपेक्षाकृत कमजोर। कम परिपक्व इकोसिस्टम—कम टूल्स, लाइब्रेरीज़ और प्रशिक्षित मॉडल।
- उपयोग के मामले और सिफारिशें: विशेष अनुप्रयोगों के लिए उभरते हुए—लंबे दस्तावेज़ प्रोसेसिंग, विलंबता प्रतिबंधों वाले रियल-टाइम सिस्टम, स्ट्रीमिंग एप्लिकेशंस, और वे डोमेन्स जहाँ O(N) स्केलिंग महत्वपूर्ण है।
हालिया शोध से पता चलता है कि Transformers और SSMs परस्पर पूरक हैं, सीधे प्रतिस्पर्धी नहीं—अलग-अलग उपयोग के मामले और बाधाएँ अलग-अलग आर्किटेक्चर के पक्ष में जाती हैं। सामान्य-उद्देश्य LLMs के लिए Transformers व्यावहारिक विकल्प बने हुए हैं और निकट भविष्य में वर्चस्व बनाए रखने की संभावना है। एक हाइब्रिड भविष्य संभावित है, जहाँ अलग-अलग संगणनात्मक और कार्य-आवश्यकताओं के लिए विशेष मॉडल होंगे।
प्रॉम्प्ट इंजीनियरों के लिए LLM इंटरव्यू प्रश्न
Prompt engineering LLMs का उपयोग करने का एक महत्वपूर्ण पहलू है। इसमें सटीक और प्रभावी प्रॉम्प्ट तैयार करना शामिल है ताकि मॉडल से वांछित प्रतिक्रियाएँ प्राप्त की जा सकें। यह अनुभाग उन प्रमुख प्रश्नों की जाँच करता है जिनका सामना प्रॉम्प्ट इंजीनियरों को हो सकता है।
Prompt engineering क्या है, और LLMs के साथ काम करने में यह क्यों महत्वपूर्ण है?
Prompt engineering में ऐसे प्रॉम्प्ट डिज़ाइन और परिमार्जित करना शामिल है जो LLMs को सटीक और प्रासंगिक आउटपुट जनरेट करने के लिए निर्देशित करें। यह इसलिए महत्वपूर्ण है क्योंकि प्रॉम्प्ट की गुणवत्ता सीधे मॉडल के प्रदर्शन को प्रभावित करती है।
प्रभावी प्रॉम्प्ट मॉडल की कार्य-समझ को बढ़ा सकते हैं, सटीक और प्रासंगिक प्रतिक्रियाएँ जनरेट करवा सकते हैं, और त्रुटियों की संभावना घटा सकते हैं।
प्रॉम्प्ट इंजीनियरिंग टेक्स्ट जनरेशन से लेकर जटिल समस्या-समाधान कार्यों तक विभिन्न अनुप्रयोगों में LLMs की उपयोगिता अधिकतम करने के लिए आवश्यक है।
क्या आप विभिन्न प्रॉम्प्टिंग तकनीकों (zero-shot, few-shot, chain-of-thought) के उदाहरण दे सकते हैं और बता सकते हैं कि इन्हें कब उपयोग करें?
- Zero-shot prompting: मॉडल को बिना किसी उदाहरण के केवल कार्य-वर्णन दिया जाता है। तब उपयोगी, जब उदाहरण उपलब्ध न हों या जब हम मॉडल की सामान्य समझ और लचीलापन जाँचना चाहते हों।
- Few-shot prompting: कार्य-वर्णन के साथ कुछ उदाहरण भी दिए जाते हैं ताकि मॉडल बेहतर समझ सके। जब मॉडल को कार्य समझने के लिए संदर्भ या उदाहरण चाहिए हों, तब उपयोगी।
- Chain-of-Thought prompting: जटिल कार्य को छोटे, क्रमिक चरणों में तोड़ना ताकि मॉडल उनका पालन कर सके। तर्क और बहु-चरणीय समस्या-समाधान की आवश्यकता वाले कार्यों में लाभदायक।
- Agentic prompting: ऐसे प्रॉम्प्ट बनाना जो मॉडलों को स्वायत्त एजेंट की तरह कार्य करने दें—टूल्स/APIs कॉल करना, जानकारी इकट्ठा करना, और कई चरणों में तर्क करना। प्रॉम्प्ट में एक्शन-स्पेस परिभाषाएँ, टूल विवरण और स्पष्ट तर्क आवश्यकताएँ शामिल होती हैं।
आप किसी प्रॉम्प्ट की प्रभावशीलता का मूल्यांकन कैसे करते हैं?
किसी प्रॉम्प्ट की प्रभावशीलता का मूल्यांकन करने में शामिल हैं:
- आउटपुट गुणवत्ता: मॉडल की प्रतिक्रियाओं की प्रासंगिकता, सुसंगति और सटीकता का आकलन।
- स्थिरता: क्या मॉडल अलग-अलग इनपुट पर लगातार उच्च-गुणवत्ता आउटपुट देता है।
- कार्य-विशिष्ट मीट्रिक्स: अनुवाद के लिए BLEU या संक्षेपण के लिए ROUGE जैसे मीट्रिक्स से प्रदर्शन मापना।
- मानव मूल्यांकन: मानव समीक्षकों से मॉडल आउटपुट पर गुणात्मक प्रतिक्रिया लेना।
- A/B परीक्षण: विभिन्न प्रॉम्प्ट्स की तुलना कर यह निर्धारित करना कि कौन-सा बेहतर प्रदर्शन देता है।
प्रॉम्प्ट डिज़ाइन में सामान्य त्रुटियों (जैसे, मार्गदर्शक प्रश्न, अस्पष्ट निर्देश) से बचने की कुछ रणनीतियाँ क्या हैं?
- मार्गदर्शक प्रश्नों से बचें: सुनिश्चित करें कि प्रॉम्प्ट किसी विशिष्ट उत्तर का संकेत न दें, जो मॉडल की प्रतिक्रिया को पक्षपाती कर सकते हैं।
- स्पष्ट और संक्षिप्त निर्देश: अस्पष्टता रहित और सीधे निर्देश दें ताकि भ्रम कम हो।
- संदर्भ प्रदान करना: प्रासंगिक संदर्भ शामिल करें ताकि मॉडल कार्य समझ सके, लेकिन अनावश्यक जानकारी से ओवरलोड न करें।
- आवर्ती परीक्षण: मॉडल के आउटपुट और प्रदर्शन के आधार पर प्रॉम्प्ट्स का सतत परीक्षण और परिष्कार करें।
LLM प्रदर्शन सुधारने के लिए आप आवर्ती प्रॉम्प्ट परिष्कार (iterative refinement) कैसे अपनाते हैं?
आवर्ती प्रॉम्प्ट परिष्कार में शामिल हैं:
- प्रारंभिक डिज़ाइन: कार्य-आवश्यकताओं के आधार पर एक बुनियादी प्रॉम्प्ट से शुरू करें।
- परीक्षण और मूल्यांकन: विभिन्न मीट्रिक्स से प्रॉम्प्ट के प्रदर्शन का आकलन करें और फीडबैक प्राप्त करें।
- विश्लेषण: प्रॉम्प्ट की कमजोरियाँ या सुधार के क्षेत्र पहचानें।
- परिष्कार: पहचानी गई समस्याओं को संबोधित करने के लिए प्रॉम्प्ट में समायोजन करें।
- दोहराएँ: इच्छित प्रदर्शन प्राप्त होने तक परीक्षण और परिष्कार प्रक्रिया को दोहराएँ।
प्रॉम्प्ट इंजीनियरिंग प्रक्रिया को सुव्यवस्थित करने के लिए आप किन टूल्स या फ्रेमवर्क्स का उपयोग करते हैं?
कई टूल्स और फ्रेमवर्क्स प्रॉम्प्ट इंजीनियरिंग प्रक्रिया को सुव्यवस्थित कर सकते हैं:
- LLM-विशिष्ट प्लेटफ़ॉर्म: प्रॉम्प्ट चेइनिंग और एजेंटिक सिस्टम बनाने के लिए LangChain और LlamaIndex; तेज़ प्रोटोटाइपिंग और परिनियोजन के लिए Vercel AI SDK।
- प्रॉम्प्ट परीक्षण और ऑप्टिमाइज़ेशन: PromptFoo (विभिन्न परिदृश्यों में स्वचालित प्रॉम्प्ट परीक्षण), DSPy (प्रोग्रामैटिक प्रॉम्प्ट ऑप्टिमाइज़ेशन), Haystack (RAG पाइपलाइन निर्माण)।
- इंटरैक्टिव डेवलपमेंट एन्वायरनमेंट (IDEs): प्रयोग के लिए Jupyter Notebook, VS Code LLM एक्सटेंशन्स (GitHub Copilot, Cursor) के साथ, और इंटरैक्टिव UI प्रोटोटाइप बनाने के लिए Streamlit।
- APIs और SDKs: OpenAI API, Anthropic SDK, Together AI, और लोकल मॉडल परिनियोजन के लिए LM Studio।
- वर्ज़न कंट्रोल और सहयोग: Git-आधारित प्रॉम्प्ट वर्ज़निंग, प्रयोग ट्रैकिंग और तुलना के लिए Weights & Biases, मॉडल्स और प्रॉम्प्ट साझा करने के लिए HuggingFace Hub।
- Agentic फ्रेमवर्क्स: AutoGPT, OpenAI Assistants API, LangGraph—जटिल बहु-चरणीय agentic वर्कफ़्लोज़ बनाने के लिए।
- मूल्यांकन और मॉनिटरिंग: Ragas (RAG मूल्यांकन मीट्रिक्स), LangSmith (ट्रेसिंग, डीबगिंग, और प्रोडक्शन मॉनिटरिंग), Braintrust (एंड-टू-एंड LLM ऑब्ज़र्वेबिलिटी)।
प्रॉम्प्ट इंजीनियरिंग के माध्यम से आप LLM आउटपुट में hallucination या बायस जैसी चुनौतियों को कैसे संभालते हैं?
यह प्रश्न LLM-जनित सामग्री के नैतिक और व्यावहारिक मुद्दों को संबोधित करता है। एक सशक्त उत्तर इन समस्याओं के प्रति जागरूकता दिखाएगा और निम्न जैसी तकनीकों पर चर्चा करेगा।
Hallucination शमन तकनीकें:
- तथ्य-सत्यापन प्रॉम्प्ट्स: ऐसे प्रॉम्प्ट शामिल करें जो मॉडल को अपनी जानकारी को विश्वसनीय स्रोतों के विरुद्ध जाँचने और स्पष्ट रूप से प्रमाण उद्धृत करने के लिए प्रेरित करें।
- Retrieval इंटीग्रेशन: RAG या RAG 2.0 सिस्टम का उपयोग कर प्रतिक्रियाओं को वास्तविक दस्तावेज़ों में ग्राउंड करें, ताकि मॉडल को प्राप्त जानकारी का संदर्भ देना पड़े और मनगढ़ंत तथ्यों में कमी आए।
- Agentic verification loops: प्रॉम्प्ट्स को इस प्रकार संरचना दें कि मॉडल प्रतिक्रिया देने से पहले अपने काम की बहु-चरणीय जाँच करे—अर्थात स्वयं-सत्यापन एजेंट बनाएँ।
- Constraint-आधारित प्रॉम्प्ट्स: ऐसा आउटपुट प्रारूप और तार्किक बाधाएँ परिभाषित करें जिनसे असंगतियाँ या बिना समर्थन के दावे स्पष्ट हो जाएँ।
बायस शमन तकनीकें:
- विविध दृष्टिकोण प्रॉम्प्ट्स: निष्कर्ष पर पहुँचने से पहले मॉडल को अनेक दृष्टिकोणों और हितधारक-परिप्रेक्ष्यों पर विचार करने हेतु मार्गदर्शन करें।
- बायस डिटेक्शन प्रॉम्प्ट्स: मॉडल से अपने तर्क और आउटपुट में संभावित पक्षपात की पहचान करने के लिए कहें।
- Counterfactual प्रॉम्प्ट्स: प्रारंभिक मान्यताओं को चुनौती देने और तर्क की मज़बूती जाँचने के लिए वैकल्पिक परिदृश्यों या दृष्टिकोणों का अनुरोध करें।
- निर्देशों की स्पष्टता: स्पष्ट रूप से निर्दिष्ट करें कि प्रतिक्रियाएँ संतुलित हों, सीमाएँ स्वीकारें, और भेदभावपूर्ण भाषा से बचें।
प्रॉम्प्ट टेम्प्लेट्स की भूमिका समझाएँ और इन्हें प्रॉम्प्ट इंजीनियरिंग में कैसे उपयोग किया जाता है?
प्रॉम्प्ट टेम्प्लेट्स प्रॉम्प्ट्स के लिए एक संरचित प्रारूप देते हैं, जिनमें अक्सर विशिष्ट जानकारी या निर्देशों के लिए प्लेसहोल्डर्स शामिल होते हैं। इन्हें विभिन्न कार्यों और परिदृश्यों में पुन: उपयोग किया जा सकता है, जिससे प्रॉम्प्ट डिज़ाइन में स्थिरता और दक्षता बढ़ती है।
एक अच्छा उत्तर बताएगा कि प्रॉम्प्ट टेम्प्लेट्स सर्वोत्तम पद्धतियों को समाहित करने, डोमेन-विशिष्ट ज्ञान जोड़ने और विभिन्न अनुप्रयोगों के लिए प्रभावी प्रॉम्प्ट्स जनरेट करने की प्रक्रिया को कैसे सुगम बनाते हैं।
Tokenizer का चयन प्रॉम्प्ट इंजीनियरिंग और मॉडल प्रदर्शन को कैसे प्रभावित करता है?
Tokenizer यह निर्धारित करने में महत्वपूर्ण भूमिका निभाता है कि LLM इनपुट प्रॉम्प्ट की व्याख्या और प्रोसेस कैसे करता है। अलग-अलग tokenizers की शब्दावली-आकार अलग होते हैं और वे OOV शब्दों को अलग तरीकों से संभालते हैं। Byte Pair Encoding (BPE) जैसे subword tokenizer OOV शब्दों को छोटे सबवर्ड यूनिट्स में तोड़कर संभाल सकते हैं, जबकि word-आधारित tokenizer उन्हें अज्ञात टोकन के रूप में ले सकता है।
Tokenizer का चयन कई तरह से मॉडल प्रदर्शन को प्रभावित कर सकता है। उदाहरण के लिए, subword tokenizer दुर्लभ या तकनीकी शब्दों के अर्थ को पकड़ने में अधिक प्रभावी हो सकता है, जबकि word-आधारित tokenizer सामान्य-उद्देश्य भाषा कार्यों के लिए सरल और तेज़ हो सकता है।
प्रॉम्प्ट इंजीनियरिंग में, tokenizer का चयन इस बात को प्रभावित कर सकता है कि आप अपने प्रॉम्प्ट्स को कैसे संरचना करते हैं। उदाहरण के लिए, यदि आप subword tokenizer का उपयोग कर रहे हैं, तो आपको इस बात पर अधिक ध्यान देने की आवश्यकता हो सकती है कि शब्द सबवर्ड्स में कैसे विभाजित होते हैं, ताकि मॉडल अभिप्रेत अर्थ को पकड़ सके।
Agentic prompting क्या है, और यह पारंपरिक prompt engineering से कैसे भिन्न है?
Agentic prompting एक प्रॉम्प्ट डिज़ाइन दृष्टिकोण है जिसमें मॉडल को एक “एजेंट” की तरह कार्य करने का निर्देश दिया जाता है—जो योजना बना सके, क्रियाएँ कर सके (उदा., टूल्स/APIs कॉल करना या दस्तावेज़ रिट्रीव करना), परिणामों का अवलोकन कर सके, और उद्देश्य पूरा होने तक दोहराव कर सके।
पारंपरिक prompt engineering, जो मुख्यतः स्पष्ट निर्देशों, उदाहरणों और फ़ॉर्मेटिंग बाधाओं के ज़रिये एक ही प्रयास में सर्वश्रेष्ठ प्रतिक्रिया पाने की कोशिश करता है, से अलग, agentic prompting बहु-चरणीय नियंत्रण चक्र (योजना → क्रिया → अवलोकन → परिष्कार) पर बल देता है।
यह विशेष रूप से उन कार्यों में उपयोगी है जहाँ शुद्धता बाहरी सिस्टमों (डाटाबेस, सर्च, कोड निष्पादन) के साथ अंतःक्रिया करने या मध्यवर्ती परिणामों का सत्यापन करने पर निर्भर करती है, न कि केवल मॉडल के आंतरिक ज्ञान पर।
अच्छे agentic प्रॉम्प्ट प्रायः उद्देश्य, उपलब्ध टूल्स/क्रियाएँ, कौन-सी क्रिया कब चुननी है, और कब रुकना है—ये परिभाषित करते हैं। hallucinations घटाने और विश्वसनीयता बढ़ाने के लिए स्पष्ट सत्यापन चरण (जैसे “प्राप्त स्रोत जाँचें” या “अंतिम उत्तर से पहले पुनर्गणना करें”) जोड़ना भी सामान्य है।
निष्कर्ष
इस गाइड ने LLMs पर चर्चाओं की तैयारी में आपकी मदद के लिए इंटरव्यू प्रश्नों का एक सेट प्रदान किया, जो बुनियादी सिद्धांतों से लेकर उन्नत रणनीतियों तक फैला है।
चाहे आप इंटरव्यू की तैयारी कर रहे हों या अपनी समझ पुख्ता करना चाहते हों, ये अंतर्दृष्टियाँ आपको कृत्रिम बुद्धिमत्ता के क्षेत्र में आगे बढ़ने के लिए आवश्यक ज्ञान से लैस करेंगी।
यदि आप AI और LLMs में नवीनतम पढ़ना चाहते हैं, तो मैं इन विषयों की सिफारिश करता हूँ:

हाल ही में स्नातकोत्तर (MSc) उत्तीर्ण, विशेषता: कृत्रिम बुद्धिमत्ता
लार्ज लैंग्वेज मॉडल (LLMs) कृत्रिम बुद्धिमत्ता में लगातार अधिक महत्वपूर्ण हो गए हैं, और इनका उपयोग विभिन्न उद्योगों में होता है।
LLM विशेषज्ञता वाले पेशेवरों की माँग बढ़ने के साथ, यह लेख इंटरव्यू प्रश्नों और उत्तरों का एक व्यापक सेट प्रस्तुत करता है, जो बुनियादी अवधारणाओं, उन्नत तकनीकों और व्यावहारिक अनुप्रयोगों को कवर करता है।
यदि आप नौकरी के इंटरव्यू की तैयारी कर रहे हैं या केवल अपना ज्ञान बढ़ाना चाहते हैं, तो यह लेख उपयोगी रहेगा।
बेसिक LLM इंटरव्यू प्रश्न
LLMs को समझने के लिए बुनियादी अवधारणाओं से शुरू करना महत्वपूर्ण है। ये नींव रखने वाले प्रश्न आर्किटेक्चर, प्रमुख तंत्रों और सामान्य चुनौतियों जैसे आवश्यक पहलुओं को कवर करते हैं और उन्नत विषयों को सीखने के लिए ठोस आधार प्रदान करते हैं।
Transformer आर्किटेक्चर क्या है, और LLMs में इसका उपयोग कैसे होता है?
The Transformer architecture एक डीप लर्निंग मॉडल है जिसे Vaswani et al द्वारा 2017 में पेश किया गया था, जिसे पुनरावर्ती न्यूरल नेटवर्क (RNNs) और लॉन्ग शॉर्ट-टर्म मेमोरी (LSTMs) जैसे पूर्ववर्ती मॉडलों की तुलना में बेहतर दक्षता और प्रदर्शन के साथ अनुक्रमिक डेटा संभालने के लिए डिज़ाइन किया गया है।
यह self-attention तंत्र पर निर्भर करता है जो इनपुट डेटा को समानांतर में प्रोसेस करता है, जिससे यह अत्यधिक स्केलेबल बनता है और लंबी दूरी की निर्भरताएँ पकड़ने में सक्षम होता है।
LLMs में, Transformer आर्किटेक्चर रीढ़ की हड्डी के रूप में काम करता है, जो मॉडलों को बड़े पैमाने पर पाठ डेटा को कुशलतापूर्वक प्रोसेस करने और संदर्भानुकूल और सुसंगत टेक्स्ट आउटपुट जनरेट करने में सक्षम बनाता है।
Transformer मॉडल आर्किटेक्चर। स्रोत
LLMs में "context window" की अवधारणा समझाएँ और इसका महत्व बताइए।
LLMs में context window उस टेक्स्ट-रेंज (टोकन या शब्दों के रूप में) को संदर्भित करता है जिसे मॉडल एक बार में भाषा को समझते या जनरेट करते समय विचार कर सकता है। context window का महत्व इस बात में है कि यह मॉडल की तार्किक और प्रासंगिक प्रतिक्रियाएँ बनाने की क्षमता को प्रभावित करता है।
आम तौर पर, बड़ा context window मॉडल को अधिक संदर्भ पर विचार करने देता है, जिससे विशेषकर जटिल या लंबी बातचीत में समझ और टेक्स्ट जनरेशन बेहतर होती है। हालाँकि, इससे संगणनात्मक आवश्यकताएँ भी बढ़ती हैं, इसलिए प्रदर्शन और दक्षता के बीच संतुलन बनाना पड़ता है।
इसके अतिरिक्त, हालिया शोध से पता चलता है कि अधिकांश मॉडल अपने विज्ञापित सीमाओं से काफी पहले ही प्रदर्शन में गिरावट दिखाते हैं। मॉडल "बीच में खो जाना" (lost in the middle) जैसा परिघटन प्रदर्शित कर सकते हैं, जहाँ संदर्भ के मध्य की जानकारी अनदेखी या कम महत्व की हो जाती है। इसलिए, क्यूरेटेड, प्रासंगिक संदर्भ वाले छोटे विंडो अक्सर शोर से भरी बड़ी विंडो की तुलना में बेहतर प्रदर्शन करते हैं।
LLMs के लिए कुछ सामान्य प्री-ट्रेनिंग उद्देश्यों क्या हैं, और वे कैसे काम करते हैं?
LLMs के सामान्य प्री-ट्रेनिंग उद्देश्यों में masked language modeling (MLM) और autoregressive language modeling शामिल हैं। MLM में, वाक्य के कुछ यादृच्छिक शब्दों को मास्क किया जाता है, और मॉडल को आस-पास के संदर्भ के आधार पर मास्क किए गए शब्दों की भविष्यवाणी करने के लिए प्रशिक्षित किया जाता है। इससे मॉडल द्विदिश संदर्भ को समझना सीखता है।
Autoregressive language modeling में क्रम में अगले शब्द की भविष्यवाणी शामिल होती है और मॉडल को एक-एक टोकन करके टेक्स्ट जनरेट करने के लिए प्रशिक्षित किया जाता है। दोनों उद्देश्य मॉडल को बड़े कॉर्पस से भाषा के पैटर्न और अर्थविज्ञान सीखने में सक्षम बनाते हैं, जो विशेष कार्यों के लिए फाइन-ट्यूनिंग का मजबूत आधार प्रदान करते हैं।