
बेसिक जेनरेटिव एआई इंटरव्यू प्रश्न
आइए कुछ बुनियादी जेनरेटिव एआई इंटरव्यू प्रश्नों से शुरुआत करें। ये आपके मूल सिद्धांतों और अवधारणाओं की समझ को परखेंगे।
डिस्क्रिमिनेटिव और जेनरेटिव मॉडलों के बीच मुख्य अंतर क्या हैं?
डिस्क्रिमिनेटिव मॉडल क्लासेस के बीच निर्णय-सीमा और उन्हें अलग करने वाले पैटर्न सीखते हैं। वे P(y|x) का आकलन करते हैं, यानी दिए गए इनपुट डेटा x के लिए किसी विशेष लेबल y की प्रायिकता। ये मॉडल विभिन्न श्रेणियों के बीच भेद करने पर केंद्रित होते हैं (उदा., ‘क्या यह ईमेल स्पैम है?’).
जेनरेटिव मॉडल डेटा के संयुक्त प्रायिकता P(x,y) को मॉडलिंग करके स्वयं डेटा-वितरण सीखते हैं, जिसमें इस वितरण से डेटा बिंदुओं का सैम्पलिंग शामिल होता है। उदाहरण के लिए, हजारों अंकों की छवियों पर प्रशिक्षित होने के बाद, यह सैम्पलिंग किसी नए अंक की छवि उत्पन्न कर सकती है।
इस ब्लॉग में और पढ़ें: Generative vs Discriminative Models: Differences & Use Cases.
Large Language Models (LLMs) के संदर्भ में टोकन और एम्बेडिंग क्या हैं?
टोकन वह मूल पाठ-इकाइयाँ हैं जिन्हें एक LLM प्रोसेस करता है; ये संपूर्ण शब्द, अक्षर-समूह या यहाँ तक कि एकल अक्षर भी हो सकते हैं (उदाहरण के लिए, "generative" शब्द को "gener", "at", "ive" में बाँटा जा सकता है)।
एम्बेडिंग उन्हीं टोकनों के संख्यात्मक वेक्टर रूपांतरण हैं जो उनके अर्थ के आधार पर उन्हें बहु-आयामी स्पेस में स्थित करते हैं। यह रूपांतरण मॉडल को अर्थगत संबंध पकड़ने और शब्दों के बीच संबंध समझने में सक्षम बनाता है, जैसे यह पहचानना कि "king" "queen" के क़रीब है।
क्या आप Generative Adversarial Networks (GANs) के बुनियादी सिद्धांत समझा सकते हैं?
GANs दो न्यूरल नेटवर्क्स से मिलकर बनते हैं जो एक-दूसरे के खिलाफ प्रतिस्पर्धा करते हैं (इसीलिए Adversarial): एक जनरेटर और एक डिस्क्रिमिनेटर।
जनरेटर नकली डेटा सैम्पल बनाता है जबकि डिस्क्रिमिनेटर उन्हें वास्तविक प्रशिक्षण डेटा के मुकाबले परखता है। दोनों नेटवर्क साथ-साथ प्रशिक्षित होते हैं:
- जनरेटर का लक्ष्य ऐसी छवियाँ बनाना है जो वास्तविक डेटा से इतनी मिलती-जुलती हों कि डिस्क्रिमिनेटर फर्क न कर पाए।
- डिस्क्रिमिनेटर का लक्ष्य यह सही-सही पहचानना है कि दी गई छवि वास्तविक है या जनरेट की गई।
इस प्रतिस्पर्धी सीख के ज़रिए जनरेटर प्रशिक्षण डेटा से मिलते-जुलते अत्यंत यथार्थपरक डेटा उत्पन्न करने में दक्ष हो जाता है।
वास्तविक दुनिया में जेनरेटिव एआई के कुछ लोकप्रिय उपयोग क्या हैं?
- टेक्स्ट जनरेशन: चैटबॉट्स, कंटेंट निर्माण या अनुवाद में उपयोग (ChatGPT, Claude, Gemini).
- इमेज जनरेशन: कला या डिज़ाइन के लिए यथार्थपरक छवियाँ बनाना (उदा., ChatGPT Images, Nano Banana Pro, Stable Diffusion).
- कोडिंग एजेंट्स: सॉफ्टवेयर इंजीनियरिंग में प्रयुक्त, संपूर्ण कोड मॉड्यूल लिखना।
- Retrieval-Augmented Generation (RAG): एंटरप्राइज़ नॉलेज रिट्रीवल, कस्टमर सर्विस या इंटरनल विकी के लिए।
- दवा खोज: दवाओं के लिए नए आणविक ढांचे डिज़ाइन करना।
- डेटा ऑग्मेंटेशन: मशीन लर्निंग के लिए कम-डेटा वाले डेटासेट्स का विस्तार।
जेनरेटिव एआई मॉडलों के प्रशिक्षण और मूल्यांकन से जुड़े कुछ चुनौतियाँ क्या हैं?
- कम्प्यूटेशनल लागत: जटिल मॉडलों के प्रशिक्षण के लिए उच्च कम्प्यूटेशनल शक्ति और हार्डवेयर की आवश्यकता।
- ट्रेनिंग की जटिलता: जेनरेटिव मॉडलों को प्रशिक्षित करना चुनौतीपूर्ण और बारीकियों से भरा हो सकता है।
- मूल्यांकन मैट्रिक्स: मॉडल के आउटपुट की गुणवत्ता और विविधता का मात्रात्मक आकलन करना कठिन होता है।
- डेटा आवश्यकताएँ: जेनरेटिव मॉडल प्रायः अत्यधिक बड़ी, उच्च-गुणवत्ता और विविधता वाली डेटा-मात्रा चाहते हैं। ऐसे डेटा का संग्रहण समय-साध्य और महँगा हो सकता है।
- बायस और निष्पक्षता: बिना जाँचे-परखे मॉडल प्रशिक्षण डेटा में मौजूद पूर्वाग्रह को बढ़ा सकते हैं, जिससे अन्यायपूर्ण आउटपुट उत्पन्न होते हैं।
जेनरेटिव एआई के उपयोग के आसपास कुछ नैतिक विचार क्या हैं?
GenAI के व्यापक उपयोग और उसके उपयोग-परिदृश्यों के चलते उनके एथिक्स के संदर्भ में प्रदर्शन का विस्तृत मूल्यांकन आवश्यक है। कुछ उदाहरण:
- डीपफेक्स: नकली परंतु अति-यथार्थ मीडिया बनाना, जो गलत सूचना फैला सकता है या व्यक्तियों की मानहानि कर सकता है।
- पक्षपाती जनरेशन: प्रशिक्षण डेटा में मौजूद ऐतिहासिक और सामाजिक पूर्वाग्रहों को बढ़ाना।
- बौद्धिक संपदा: डेटा में कॉपीराइटेड सामग्री का अनधिकृत उपयोग।
मानव रचनात्मकता को बढ़ाने या सशक्त करने के लिए जेनरेटिव एआई का उपयोग कैसे किया जा सकता है?
हालाँकि एआई मॉडलों का हॉलुसिनेशन त्रुटिपूर्ण आउटपुट दे सकता है, फिर भी ये जेनरेटिव मॉडल अनेक तरीकों और उपयोगों में सहायक हैं। इन्हें विभिन्न क्षेत्रों के विशेषज्ञों के लिए रचनात्मक प्रेरणा के रूप में इस्तेमाल किया जा सकता है:
- कला और डिज़ाइन: कला और डिज़ाइन में प्रेरणा देना।
- लेखन सहायत: शीर्षक, लेखन विचार या टेक्स्ट की पूर्ति सुझाना।
- संगीत: बीट्स और हार्मोनी कम्पोज़ करना।
- प्रोग्रामिंग: मौजूदा कोड का अनुकूलन या किसी इम्प्लीमेंटेशन समस्या से निपटने के तरीके सुझाना।
फाउंडेशन मॉडल और फाइन-ट्यून किए गए मॉडल में क्या अंतर है?
फाउंडेशन मॉडल (जैसे GPT-5.2) को सामान्य पैटर्न, तर्क और भाषा-संरचना सीखने के लिए व्यापक इंटरनेट डेटा की विशाल मात्रा पर प्रशिक्षित किया जाता है।
फाइन-ट्यून किया गया मॉडल इसी जनरलिस्ट बेस को लेकर किसी छोटे, चुने हुए डेटासेट पर आगे प्रशिक्षित करता है ताकि किसी विशिष्ट कार्य में महारत हासिल हो सके, जैसे चिकित्सीय निदान या किसी विशिष्ट कोडिंग भाषा में बोलना। फाइन-ट्यूनिंग व्यापक बहुमुखी प्रतिभा का आदान-प्रदान किसी विशेष क्षेत्र में गहरी विशेषज्ञता से करती है।
इंटरमीडिएट जेनरेटिव एआई इंटरव्यू प्रश्न
अब जब हम मूल बातें कवर कर चुके हैं, तो आइए कुछ इंटरमीडिएट जेनरेटिव एआई इंटरव्यू प्रश्न देखते हैं।
GANs में "मोड कोलैप्स" क्या है, और इसे कैसे संबोधित करें?
जैसे कोई कंटेंट क्रिएटर यह पाता है कि किसी खास प्रारूप से अधिक पहुंच और इंटरैक्शन मिलते हैं, वैसे ही GAN का जनरेटिव मॉडल सीमित विविधता वाले ऐसे आउटपुट पर अटक सकता है जो डिस्क्रिमिनेटर को धोखा दे देते हैं। इसका नतीजा यह होता है कि जनरेटर बहुत कम प्रकार के आउटपुट पैदा करता है, जिससे जनरेटेड डेटा की विविधता और लचीलेपन में कमी आती है।
संभावित समाधान में प्रशिक्षण तकनीकों पर ध्यान देना—हाइपरपैरामीटर और विभिन्न ऑप्टिमाइज़ेशन एल्गोरिद्म समायोजित करना, विविधता को बढ़ावा देने वाले रेगुलराइज़ेशन लगाना, या विभिन्न मोड्स को कवर करने के लिए एक से अधिक जनरेटरों का संयोजन—शामिल हो सकता है।
एक Variational Autoencoder (VAE) कैसे काम करता है?
एक Variational Autoencoder (VAE) एक प्रकार का जेनरेटिव मॉडल है जो इनपुट डेटा को एक लेटेंट स्पेस में एन्कोड करना और फिर मूल इनपुट डेटा को पुनर्निर्मित करने के लिए उसे डिकोड करना सीखता है। VAE एन्कोडर-डिकोडर मॉडल होते हैं:
- एन्कोडर इनपुट डेटा को लेटेंट स्पेस पर एक वितरण में मैप करता है।
- डिकोडर इस लेटेंट स्पेस वितरण से सैम्पल लेकर इनपुट डेटा का पुनर्निर्माण करता है।
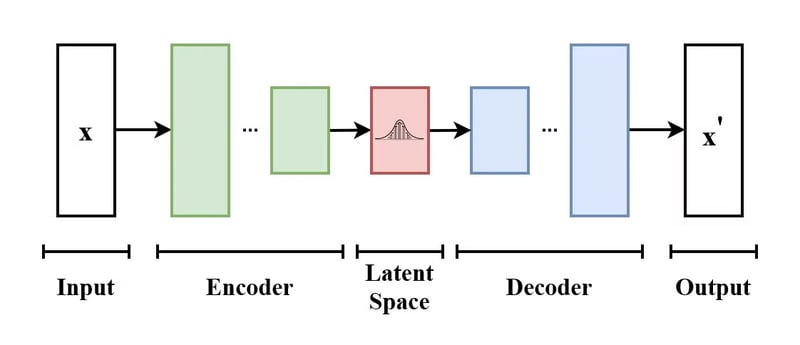
एक Variational Autoencoder की संरचना। (स्रोत: Wikimedia Commons)
VAE को पारंपरिक ऑटोएन्कोडर्स से अलग यह बनाता है कि VAE लेटेंट स्पेस को किसी ज्ञात वितरण (जैसे Gaussian) का पालन करने के लिए प्रेरित करता है। इससे लेटेंट स्पेस से सैम्पल लेकर नया डेटा उत्पन्न करना अधिक उपयोगी हो जाता है।
Retrieval-Augmented Generation (RAG) और फाइन-ट्यूनिंग में अंतर समझाइए। आप कब किसका उपयोग करेंगे?
RAG मॉडल को बाहरी डेटा स्रोतों (जैसे आपकी कंपनी की विकी) से जोड़ता है ताकि बिना मॉडल को पुनः प्रशिक्षित किए नवीनतम तथ्य प्राप्त किए जा सकें। मॉडल के पैरामीटर्स वही रहते हैं; उसे बस अतिरिक्त डेटा तक पहुँच मिलती है।
फाइन-ट्यूनिंग मॉडल के आंतरिक वेट्स में बदलाव करती है ताकि वह कैसे बोलता, व्यवहार करता या तर्क करता है, यह बदला जा सके, पर यह नए तथ्यात्मक ज्ञान जोड़ने के लिए उपयुक्त नहीं है।
जब आपको ताज़ा तथ्य (समाचार, निजी कंपनी डेटा) या विशिष्ट उद्धरण चाहिए हों तो RAG उपयोग करें। जब आपको मॉडल में नया "व्यवहार", भाषा या विशिष्ट आउटपुट फ़ॉर्मेट (उदा., SQL कोड में बोलना) सिखाना हो, तो फाइन-ट्यूनिंग अपनाएँ।
आप किसी LLM एप्लिकेशन का मूल्यांकन कैसे करेंगे? 'LLM-as-a-Judge' समझाइए।
जनरेटेड सैम्पलों का आकलन एक जटिल कार्य है जो डेटा मोडैलिटी (इमेज, टेक्स्ट, वीडियो आदि) पर निर्भर करता है। पारंपरिक टेक्स्ट मैट्रिक्स, जैसे एक्युरेसी, रचनात्मक कार्यों के लिए अपर्याप्त हैं क्योंकि वे केवल शब्द-समानता जाँचते हैं, अर्थ नहीं।
LLM बेंचमार्क्स और लीडरबोर्ड्स मानकीकृत परीक्षणों का उपयोग करते हैं ताकि यह मापा जा सके कि कोई मॉडल किसी दिए गए कार्य को कितना अच्छी तरह संभालता है। ये मॉडलों की तुलना करने और मोडैलिटी के भीतर या पार प्रगति ट्रैक करने में सहायक होते हैं।
LLM-as-a-Judge एक आधुनिक मूल्यांकन ढाँचा है जिसमें एक अत्यधिक सक्षम "शिक्षक" मॉडल (जैसे Gemini 3) छोटे मॉडल के आउटपुट को विशिष्ट मानदंडों—जैसे तथ्यनिष्ठता, सहायतापूर्णता और टोन—के आधार पर ग्रेड करता है। इससे धीमी और महँगी मानवीय समीक्षा के बिना मानव प्राथमिकताओं का बड़े पैमाने पर अनुमानीकरण संभव होता है।
GAN प्रशिक्षण की स्थिरता और कन्वर्जेन्स सुधारने की कुछ तकनीकें क्या हैं?
GAN प्रशिक्षण की स्थिरता और कन्वर्जेन्स में सुधार मोड कोलैप्स से बचने, कुशल प्रशिक्षण और अच्छे परिणाम पाने के लिए महत्वपूर्ण है। यहाँ कुछ तकनीकें दी गई हैं:
- Wasserstein GAN (WGAN): लॉस फ़ंक्शन के रूप में वासरस्टीन दूरी का उपयोग, प्रशिक्षण स्थिरता और स्मूथ ग्रेडिएंट्स देता है।
- Two-Timescale Update Rule (TTUR): जनरेटर और डिस्क्रिमिनेटर के लिए अलग-अलग लर्निंग रेट्स का उपयोग।
- लेबल स्मूदिंग: ओवरकॉन्फिडेंस रोकने के लिए लेबल्स को सौम्य बनाना।
- एडेप्टिव लर्निंग रेट्स: Adam जैसे ऑप्टिमाइज़र्स का प्रयोग कर लर्निंग रेट को गतिशील रूप से प्रबंधित करना।
- ग्रेडिएंट पेनल्टी: डिस्क्रिमिनेटर में बड़े ग्रेडिएंट्स को दंडित करना ताकि Lipschitz निरंतरता सुनिश्चित हो और प्रशिक्षण अधिक स्थिर हो।
जेनरेटिव एआई मॉडलों से जनरेटेड कंटेंट की शैली या गुणों को कैसे नियंत्रित किया जा सकता है?
GenAI आउटपुट की शैली को नियंत्रित करने के लिए कई सामान्य तकनीकें हैं:
- प्रॉम्प्ट इंजीनियरिंग: वांछित आउटपुट शैली को निर्दिष्ट करने के लिए विस्तृत प्रॉम्प्ट दें जो शैली या टोन पर रोशनी डालें। यह टेक्स्ट-टू-टेक्स्ट और टेक्स्ट-टू-इमेज दोनों मॉडलों में प्रभावी और सरल है—विशेषकर तब जब इसे संबंधित मॉडल के डॉक्यूमेंटेशन/आवश्यकताओं के अनुरूप किया जाए।
- टेम्परेचर और सैम्पलिंग नियंत्रण: टेम्परेचर पैरामीटर आउटपुट की रैंडमनेस नियंत्रित करता है। कम टेम्परेचर का अर्थ है अधिक संयत और पूर्वानुमेय टोकन चयन; अधिक टेम्परेचर अधिक रचनात्मक जनरेशन की अनुमति देता है। अन्य पैरामीटर जैसे टॉप-k और टॉप-p भी यह नियंत्रित कर सकते हैं कि मॉडल अगला टोकन कितनी रचनात्मकता से चुने।
- स्ट्रक्चर्ड आउटपुट्स: संरचितता के लिए, आधुनिक मॉडल "JSON Mode" या "Structured Outputs" का उपयोग करते हैं, जो मॉडल को फ्री-टेक्स्ट के बजाय सख्ती से वैध JSON या XML स्कीमा जनरेट करने के लिए बाध्य करते हैं।
- सिस्टम प्रॉम्प्ट्स: सिस्टम प्रॉम्प्ट हर नए संदेश के साथ मॉडल को भेजे जाते हैं। इन्हें स्थायी व्यवहारात्मक निर्देश सेट करने के लिए उपयोग किया जा सकता है जो विशिष्ट पर्सोना या नियम बनाये रखने हेतु यूज़र इनपुट्स पर वरीयता पाते हैं।
- स्टाइल ट्रांसफ़र (इमेजेज): जिन मॉडलों में सपोर्ट हो, उनमें इन्फ़्रेन्स के समय किसी एक संदर्भ छवि की शैली को इनपुट छवि पर लागू किया जा सकता है।
- फाइन-ट्यूनिंग: किसी प्रीट्रेंड मॉडल को उस विशिष्ट शैली/टोन वाले डेटासेट पर फाइन-ट्यून किया जा सकता है जिसकी इच्छा है। यानी अतिरिक्त विशिष्ट शैलियाँ या विशेषताएँ सीखने हेतु मॉडल को और डेटा पर आगे प्रशिक्षित करना।
- रीइन्फ़ोर्समेंट लर्निंग: फीडबैक देकर मॉडल को कुछ आउटपुट्स को प्राथमिकता देने और अन्य से दूर रहने हेतु मार्गदर्शित किया जा सकता है। इस फीडबैक से रीइन्फ़ोर्समेंट लर्निंग के माध्यम से मॉडल संशोधित होता है। समय के साथ, मॉडल यूज़र्स या प्रेफरेंस डेटासेट्स की प्राथमिकताओं के अनुरूप संरेखित हो जाता है। LLMs के संदर्भ में इसका एक उदाहरण है मानव फीडबैक से रीइन्फ़ोर्समेंट लर्निंग (RLHF)।
जेनरेटिव एआई मॉडलों में बायस की समस्या को संबोधित करने के कुछ तरीके क्या हैं?
मॉडल को निष्पक्ष और निर्पेक्ष बनाए रखना हर चरण में आवर्तक समायोजन और मॉनिटरिंग चाहता है।
सबसे पहले, डेटा संदूषण से बचना ज़रूरी है—यह सुनिश्चित करके कि कोई टेस्ट डेटा ट्रेनिंग डेटा में लीक न हो। वरना मॉडल सामान्यीकरण के बजाय डेटा रटाने लगता है।
आगे, हमें प्रशिक्षण डेटा को यथासंभव विविध और समावेशी बनाना चाहिए। प्रशिक्षण के दौरान, लॉस फ़ंक्शन में निष्पक्षता उद्देश्यों को शामिल करके मॉडल को अधिक निष्पक्ष जनरेशन की ओर निर्देशित किया जा सकता है।
मॉडल के आउटपुट्स को बायस के लिए नियमित रूप से मॉनिटर करना चाहिए। सार्वजनिक विश्वास बनाने के लिए, मॉडल की निर्णय-प्रक्रिया, डेटासेट विवरण, और प्रीप्रोसेसिंग चरणों को यथासंभव पारदर्शी रखना सहायक होता है।
जेनरेटिव मॉडलों में "लेटेंट स्पेस" की अवधारणा और उसका महत्व बताइए।
जेनरेटिव मॉडलों के संदर्भ में, लेटेंट स्पेस एक निम्न-आयामी स्पेस है जो डेटा की आवश्यक विशेषताओं को इस प्रकार कैद करता है कि समान इनपुट एक-दूसरे के क़रीब मैप हों। इस लेटेंट स्पेस से सैम्पलिंग करके मॉडल नया डेटा जनरेट कर सकते हैं और विशिष्ट गुणों/फ़ीचर्स में हेरफेर कर सकते हैं (छवियों के वैरिएशन बनाना)।
लेटेंट स्पेसेज़ नियंत्रित, प्रशिक्षण डेटा के प्रति सत्यनिष्ठ और विविध आउटपुट जनरेट करने की कुंजी हैं।
जेनरेटिव एआई मॉडलों के विकास में सेल्फ-सुपरवाइज़्ड लर्निंग की क्या भूमिका है?
सेल्फ-सुपरवाइज़्ड लर्निंग का मुख्य विचार विशाल बिना-लेबल वाले डेटा-संग्रह का लाभ उठाकर बिना मैनुअल लेबलिंग के उपयोगी रिप्रेज़ेंटेशन सीखना है। BERT और GPT जैसे मॉडल्स को नेक्स्ट-टोकन प्रेडिक्शन जैसी सेल्फ-सुपरवाइज़्ड विधियों से, और भाषाओं की संरचना व अर्थ-व्यवस्था सीखकर प्रशिक्षित किया जाता है। इससे महँगे और समय-लेवा लेबल्ड डेटा पर निर्भरता घटती है और मॉडल्स को व्यापक अनलेबल्ड डेटासेट्स का लाभ प्रशिक्षण हेतु मिल जाता है।
Low-Rank Adaptation (LoRA) क्या है?
70-बिलियन पैरामीटर वाले विशाल मॉडल को फिर से प्रशिक्षित करना अधिकांश संगठनों के लिए अत्यधिक महँगा और धीमा है। Low-Rank Adaptation (LoRA) इसे मुख्य मॉडल वेट्स को फ्रीज़ करके और केवल एक छोटे "एडेप्टर" लेयर (अक्सर कुल पैरामीटर्स का 1% से भी कम) को प्रशिक्षित करके हल करता है, जो ऊपर बैठता है। इससे आप एक ही बेस मॉडल से दर्जनों अलग-अलग "कस्टम" मॉडल सर्व कर सकते हैं, कम्प्यूटेशनल लागत और स्टोरेज आवश्यकताओं को नाटकीय रूप से घटाते हुए।
एडवांस्ड जेनरेटिव एआई इंटरव्यू प्रश्न
जो लोग वरिष्ठ भूमिकाएँ चाहते हैं या जेनरेटिव एआई की गहरी समझ दिखाना चाहते हैं, उनके लिए आइए कुछ उन्नत इंटरव्यू प्रश्नों का अन्वेषण करें।
"डिफ्यूज़न मॉडल्स" की अवधारणा समझाइए और यह पुराने आर्किटेक्चर से कैसे भिन्न हैं।
डिफ्यूज़न मॉडल प्रमुखतः किसी छवि में क्रमशः शोर जोड़ते हुए तब तक काम करते हैं जब तक केवल शोर ही न रह जाए—और फिर इस प्रक्रिया को उलटकर शोर से नए सैम्पल जनरेट करना सीखते हैं। इस प्रक्रिया को डिफ्यूज़न कहा जाता है। ये मॉडल उच्च-गुणवत्ता और अत्यधिक विस्तृत छवियाँ आउटपुट करने की क्षमता के कारण लोकप्रिय हुए हैं।
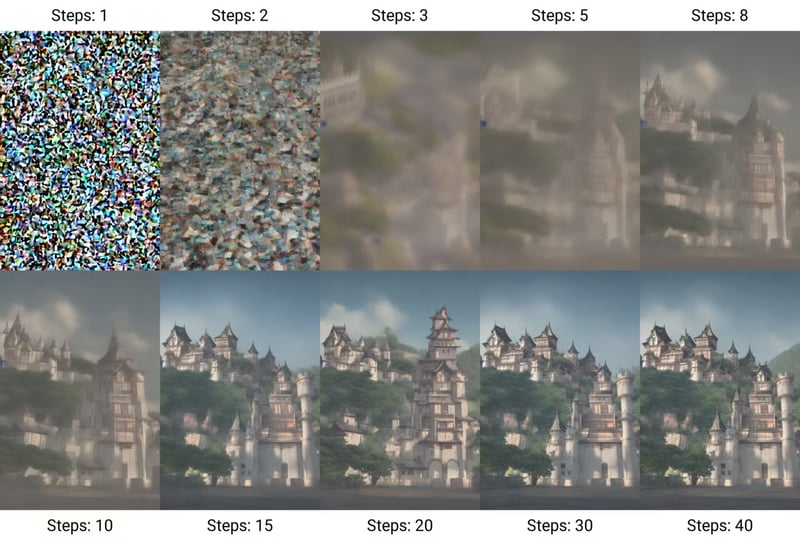
डिफ्यूज़न स्टेप्स के माध्यम से किसी छवि का जनरेशन। (स्रोत: Wikimedia Commons)
इन मॉडलों का प्रशिक्षण दो चरणों में होता है:
- फ़ॉरवर्ड प्रक्रिया (डिफ्यूज़न): इनपुट छवि लेकर बहु-चरणों में क्रमशः शोर जोड़ना, जब तक डेटा पूर्ण शोर में न बदल जाए।
- रिवर्स प्रक्रिया (डीनॉइज़िंग): शोर से मूल डेटा पुनर्प्राप्त करना सीखना। यह एक न्यूरल नेटवर्क को यह भविष्यवाणी करने के लिए प्रशिक्षित करके किया जाता है कि शोर क्या है, और फिर छवि को चरण-दर-चरण डीनॉइज़ करना जब तक मूल डेटा शोर से उभर न आए।
पुराने GANs, जो अक्सर प्रशिक्षण-अस्थिरता से ग्रस्त रहते थे, के विपरीत डिफ्यूज़न मॉडल अधिक स्थिर और स्केलेबल हैं, हालाँकि वे अपने आवर्तक स्वभाव के कारण धीमे हो सकते हैं।
आधुनिक वेरिएंट्स जैसे लेटेंट डिफ्यूज़न, जनरेशन को तेज़ करने के लिए संकुचित "लेटेंट स्पेस" में काम करते हैं, और फ्लो मैचिंग आर्किटेक्चर अब मानक डिफ्यूज़न की जगह लेकर और भी बेहतर प्रदर्शन दे रहे हैं।
ट्रांसफ़ॉर्मर आर्किटेक्चर कैसे काम करता है, और उसका मुख्य बॉटलनेक क्या है?
ट्रांसफ़ॉर्मर आर्किटेक्चर, जिसे “Attention is All You Need” पेपर में प्रस्तुत किया गया, ने जेनरेटिव एआई—विशेषकर NLP—में क्रांति ला दी।
पारंपरिक रिकरेंट न्यूरल नेटवर्क्स (RNNs), जो डेटा को अनुक्रमिक रूप से प्रोसेस करते हैं, के विपरीत, ट्रांसफ़ॉर्मर सेल्फ-अटेंशन मैकेनिज़्म का उपयोग कर इनपुट के विभिन्न भागों को एकसाथ वेट देता है। इससे मॉडल को सन्दर्भगत संबंध प्रभावी ढंग से पकड़ने में मदद मिलती है और अनुक्रमों का पैरेलल प्रोसेसिंग संभव होता है, जो प्रशिक्षण को काफी तेज़ करता है।
मुख्य बॉटलनेक यह है कि अटेंशन मैकेनिज़्म अनुक्रम-लंबाई के साथ वर्गानुपाती रूप से स्केल करता है—कॉन्टेक्स्ट विंडो दोगुनी करने पर कम्प्यूट चार गुना चाहिए। इससे “अनंत कॉन्टेक्स्ट” सैद्धांतिक रूप से तो संभव है, पर कम्प्यूटेशनली महँगा—और यही अधिक कुशल अटेंशन विधियों पर शोध को प्रेरित करता है।
"रीज़निंग मॉडल" (सिस्टम 2 थिंकिंग) क्या है, और यह एक मानक LLM से कैसे भिन्न है?
मानक LLMs "सिस्टम 1" विचारक की तरह काम करते हैं, सतही पैटर्न के आधार पर तुरंत अगला शब्द भविष्यवाणी करते हैं।
रीज़निंग मॉडल (जैसे Gemini 3 या DeepSeek-R1) उत्तर देने से पहले एक छिपी "Chain of Thought" जनरेट करने के लिए प्रशिक्षित होते हैं, जिससे वे "सोच" पाते हैं, योजना बना पाते हैं और अपनी गलतियाँ स्वयं सुधार पाते हैं। इससे वे जटिल गणित, कोडिंग और लॉजिक पहेलियों में काफी बेहतर हो जाते हैं, हालांकि इन्हें चलाना धीमा और महँगा होता है।
जेनरेटिव एआई के साथ उच्च-रेज़ोल्यूशन या लंबी-फ़ॉर्म सामग्री जनरेट करने की चुनौतियाँ क्या हैं?
जैसे-जैसे एआई जनरेशन की जटिलता बढ़ती है, आपको इनसे भी निपटना चाहिए:
- कम्प्यूटेशनल लागत: हाई-रेज़ोल्यूशन आउटपुट बड़े नेटवर्क और अधिक कम्प्यूट की माँग करते हैं।
- मल्टी-GPU प्रशिक्षण: बड़े मॉडल एक GPU में फिट नहीं होते, मल्टी-GPU प्रशिक्षण चाहिए। ऑनलाइन प्लेटफ़ॉर्म ऐसे सिस्टम्स के कार्यान्वयन की जटिलता घटा सकते हैं।
- ट्रेनिंग स्थिरता: बड़े नेटवर्क और जटिल आर्किटेक्चर स्थिर प्रशिक्षण बनाए रखना चुनौतीपूर्ण बनाते हैं।
- डेटा गुणवत्ता: उच्च रेज़ोल्यूशन और लंबी-फ़ॉर्म कंटेंट के लिए उच्च गुणवत्ता वाला डेटा चाहिए।
जेनरेटिव एआई के क्षेत्र में उभरते रुझान और शोध-दिशाएँ क्या हैं?
GenAI का क्षेत्र तेज़ी से विकसित और पुनर्रचना कर रहा है। इसमें शामिल हैं:
- मल्टीमोडल मॉडल्स: टेक्स्ट, ऑडियो, और इमेज जैसी कई डेटा-फ़ॉर्मैट्स का एकीकरण।
- स्मॉल लैंग्वेज मॉडल्स (SLMs): बड़े भाषा मॉडलों के विपरीत, SLMs दक्षता और अनुकूलता के कारण लोकप्रिय हो रहे हैं। ये कम कम्प्यूट संसाधन माँगते हैं, जिससे सीमित क्षमताओं वाले वातावरण में परिनियोजन उपयुक्त होता है—इस ब्लॉग में और पढ़ें edge AI पर।
- एथिकल एआई: जेनरेटिव मॉडलों के संरेखित प्रदर्शन को सुनिश्चित करने के लिए ढाँचे विकसित करना।
- वीडियो के लिए जेनरेटिव मॉडल: GenAI के माध्यम से अति-यथार्थ और सुसंगत वीडियो जनरेट करने में प्रगति। नवीनतम उदाहरण हैं Sora AI, Meta Movie Gen, और Runway Act-One।
आप स्वास्थ्य-सेवा जैसे किसी विशिष्ट उद्योग में वैयक्तिकृत कंटेंट बनाने हेतु जेनरेटिव एआई का उपयोग करने के लिए सिस्टम कैसे डिज़ाइन करेंगे?
उद्योग-विशिष्ट उपयोग मामलों के लिए जेनरेटिव एआई का उपयोग करने वाला सिस्टम डिज़ाइन करना एक व्यापक दृष्टिकोण है। सामान्य दिशानिर्देश अन्य उद्योगों में भी समायोजित/संशोधित किए जा सकते हैं।
- उद्योग की आवश्यकताएँ समझना: उद्योग का डोमेन-ज्ञान ऐसे सिस्टम के डिज़ाइन से जुड़े निर्णयों पर बड़ा प्रभाव डालता है। पहला कदम है उद्योग, उसके मूलभूत सिद्धांतों, अवधारणाओं, लक्ष्यों और आवश्यकताओं की सामान्य और व्यावहारिक समझ अर्जित करना।
- डेटा संग्रहण और प्रबंधन: संभावित डेटा प्रदाताओं की पहचान करें। हेल्थकेयर में, इसका अर्थ है उपचार-विवरण, रोगी-जानकारी, चिकित्सा दिशानिर्देश आदि के संबंध में प्रदाताओं से डेटा एकत्र करना। उद्योग-विशिष्ट डेटा गोपनीयता और सुरक्षा के गार्डरेल्स की पहचान और पालन करें। सुनिश्चित करें कि डेटा उच्च-गुणवत्ता, सटीक, अद्यतन और विविध समूहों का प्रतिनिधि हो।
- मॉडल चयन: तय करें कि प्री-ट्रेंड मॉडलों को फाइन-ट्यून करना है या शून्य से अपनी आर्किटेक्चर लानी है। परियोजना के प्रकार पर निर्भर करते हुए, इष्टतम जेनरेटिव एआई मॉडल बदल सकते हैं। GPT-4o जैसा मॉडल प्लग-एंड-प्ले विकल्प हो सकता है। कुछ डोमेन गोपनीयता कारणों से लोकल-होस्टेड मॉडल चाहते हैं—ऐसे में ओपन-सोर्स मॉडल उपयुक्त हैं। पहले एकत्र किए गए उद्योग-विशिष्ट डेटा पर इन मॉडलों को फाइन-ट्यून करने पर विचार करें।
- आउटपुट वैलिडेशन: एक सघन मूल्यांकन प्रक्रिया लागू करें जिसमें विशेषज्ञ और प्रोफेशनल्स, व्यवहार में लाने से पहले जनरेटेड कंटेंट को वैलिडेट करें।
- स्केलेबिलिटी: आवश्यक लोड्स को प्रदर्शन से समझौता किए बिना संभालने के लिए एक स्केलेबल क्लाउड-आधारित इन्फ्रास्ट्रक्चर डिज़ाइन करें।
- कानूनी और नैतिक विचार: एआई उपयोग के लिए स्पष्ट नैतिक दिशा-निर्देश सेट करें और अपने मॉडल की संभावित सीमाओं का पारदर्शी संप्रेषण करें। बौद्धिक संपदा अधिकारों का सम्मान करें और उनसे संबंधित मुद्दों का समाधान करें।
- निरंतर सुधार: सिस्टम के प्रदर्शन और विशेषज्ञों द्वारा जनरेटेड कंटेंट के मूल्यांकन की नियमित समीक्षा करें। और अधिक अंतर्दृष्टि और डेटा जुटाएँ ताकि मॉडल को बेहतर के लिए संशोधित किया जा सके।
LLMs के संदर्भ में "इन-कॉन्टेक्स्ट लर्निंग" की अवधारणा समझाइए।
इन-कॉन्टेक्स्ट लर्निंग का मतलब है कि LLMs बिना अतिरिक्त फाइन-ट्यूनिंग के, दिए गए कॉन्टेक्स्ट के आधार पर अपनी शैली और आउटपुट्स में बदलाव कर सकें।
इसे फ्यू-शॉट लर्निंग या प्रॉम्प्ट इंजीनियरिंग भी कहा जा सकता है। यह वांछित प्रतिक्रिया के एक या अनेक उदाहरण देकर, या यह स्पष्ट रूप से बताकर हासिल किया जा सकता है कि मॉडल को कैसे व्यवहार करना चाहिए।
इन-कॉन्टेक्स्ट लर्निंग की सीमाएँ भी हैं। यह अल्पकालिक और कार्य-विशिष्ट है, क्योंकि मॉडल वास्तव में अन्य सत्रों में कोई ज्ञान बरकरार नहीं रखता।
इसके अलावा, यदि आवश्यक आउटपुट जटिल है, तो मॉडल को बड़ी संख्या में उदाहरणों की ज़रूरत पड़ सकती है। यदि दिए गए उदाहरण पर्याप्त स्पष्ट नहीं हैं या कार्य मॉडल की क्षमता से कठिन है, तो कभी-कभी यह गलत या असंगत आउटपुट जनरेट कर सकता है।
मॉडल से वांछित व्यवहार या आउटपुट पाने के लिए प्रॉम्प्ट्स को रणनीतिक रूप से कैसे डिज़ाइन किया जा सकता है? प्रभावी प्रॉम्प्ट इंजीनियरिंग के कुछ सर्वोत्तम अभ्यास क्या हैं?
विशिष्ट कार्यों के लिए LLMs को निर्देशित करने में प्रॉम्प्टिंग महत्वपूर्ण है। प्रभावी प्रॉम्प्ट्स, फ्यू-शॉट लर्निंग, टास्क डीकॉम्पोज़िशन और प्रॉम्प्ट टेम्पलेट्स जैसी तकनीकों के माध्यम से, मॉडलों को फाइन-ट्यून करने की आवश्यकता भी कम कर सकते हैं।
प्रभावी प्रॉम्प्ट इंजीनियरिंग के कुछ सर्वोत्तम अभ्यास हैं:
- स्पष्ट और संक्षिप्त रहें: विशिष्ट निर्देश दें ताकि मॉडल को ठीक-ठीक पता हो कि आप उससे क्या कार्य कराना चाहते हैं। सीधा और सारगर्भित रहें।
- उदाहरणों का उपयोग करें: इन-कॉन्टेक्स्ट लर्निंग के लिए, कुछ इनपुट-आउटपुट युग्म दिखाने से मॉडल को आपका वांछित कार्य-समझ बेहतर मिलती है।
- जटिल कार्यों को तोड़ें: यदि कार्य जटिल है, तो उसे छोटे चरणों में तोड़ना उत्तर की गुणवत्ता सुधार सकता है।
- बाधाएँ या फ़ॉर्मैट सेट करें: यदि आपको विशिष्ट आउटपुट शैली, फ़ॉर्मैट या लंबाई चाहिए, तो इन आवश्यकताओं को प्रॉम्प्ट में साफ़-साफ़ बताएँ।
इस ब्लॉग में और पढ़ें: Prompt Optimization Techniques.
जेनरेटिव एआई मॉडलों की इन्फ़्रेन्स स्पीड ऑप्टिमाइज़ करने की कुछ तकनीकें क्या हैं?
- मॉडल प्रूनिंग: अनावश्यक वेट्स/लेयर्स हटाकर मॉडल आकार घटाना।
- क्वांटाइज़ेशन: मॉडल वेट्स की प्रिसिशन को fp16/int8 तक घटाना।
- नॉलेज डिस्टिलेशन: एक छोटे मॉडल को बड़े मॉडल की नकल करना सिखाना।
- GPU एक्सेलेरेशन: विशिष्ट हार्डवेयर का उपयोग।
"कंडीशनल जनरेशन" की अवधारणा समझाइए और यह Conditional GANs (cGANs) जैसे मॉडलों में कैसे लागू होती है?
कंडीशनल जनरेशन में मॉडल कुछ शर्तों या संदर्भों के आधार पर आउटपुट जनरेट करता है। इससे जनरेटेड कंटेंट पर अधिक नियंत्रण मिलता है। cGANs में जनरेटर और डिस्क्रिमिनेटर दोनों को अतिरिक्त जानकारी, जैसे क्लास लेबल्स, पर कंडीशन किया जाता है। यह इस प्रकार काम करता है:
- जनरेटर: शोर और कंडीशनल जानकारी (उदा., क्लास लेबल) दोनों लेकर उसी शर्त के अनुरूप डेटा उत्पन्न करता है।
- डिस्क्रिमिनेटर: कंडीशनल जानकारी को ध्यान में रखते हुए जनरेटेड डेटा की प्रामाणिकता का मूल्यांकन करता है।
Mixture of Experts (MoE) आर्किटेक्चर समझाइए। बड़े मॉडलों के लिए यह क्यों पसंद किया जाता है?
Mixture of Experts (MoE) एकल डेंस न्यूरल नेटवर्क की जगह कई विशिष्ट "एक्सपर्ट" उप-नेटवर्क रखता है। किसी भी दिए गए टोकन के लिए, एक राउटर केवल सबसे प्रासंगिक एक्सपर्ट्स का चयन करता है, यानी किसी मॉडल में 100 बिलियन पैरामीटर्स हो सकते हैं लेकिन इन्फ़्रेन्स के समय केवल 10 बिलियन सक्रिय हों।
यह आर्किटेक्चर मॉडलों को अत्यंत बुद्धिमान बनाता है (कुल पैरामीटर्स अधिक) जबकि उन्हें तेज़ और सस्ता चलाना संभव रखता है (सक्रिय पैरामीटर्स कम)।
एआई इंजीनियर के लिए जेनरेटिव एआई इंटरव्यू प्रश्न
यदि आप जेनरेटिव एआई पर केंद्रित एआई इंजीनियरिंग भूमिका के लिए इंटरव्यू दे रहे हैं, तो ऐसे प्रश्नों की अपेक्षा करें जो आपकी जेनरेटिव मॉडल्स को डिज़ाइन, इम्प्लीमेंट और डिप्लॉय करने की क्षमता का आकलन करें।
एजेंटिक वर्कफ़्लो बनाम स्टैण्डर्ड चैटबॉट क्या है?
एक स्टैण्डर्ड चैटबॉट निष्क्रिय होता है: यह क्वेरी प्राप्त करता है और अपने प्रशिक्षण के आधार पर एक टेक्स्ट उत्तर देता है।
एक एजेंटिक वर्कफ़्लो LLM को टूल्स (जैसे वेब ब्राउज़र, कोड इंटरप्रेटर या API) तक पहुँच और किसी लक्ष्य को सुलझाने हेतु बहु-चरणीय प्रक्रिया की योजना बनाने की स्वायत्तता देता है। एजेंट वेब खोजने, Python कोड से डेटा विश्लेषण करने और फिर रिपोर्ट लिखने की योजना बना सकता है—और कार्य पूर्ण होने तक लूप कर सकता है।
Guardrails का उपयोग करके LLM तैनाती में सुरक्षा और मजबूती कैसे सुनिश्चित करते हैं?
LLMs की सुरक्षा और मजबूती सुनिश्चित करना कई चुनौतियों के साथ आता है। एक प्रमुख चुनौती हानिकारक या पक्षपाती आउटपुट का संभावित जनरेशन है, क्योंकि ये मॉडल विशाल, कभी-कभी अनफ़िल्टर्ड, डेटा स्रोतों पर प्रशिक्षित होते हैं और विषैला या भ्रामक कंटेंट दे सकते हैं।
LLM-जनरेटेड कंटेंट से जुड़ी दूसरी बड़ी समस्या हॉलुसिनेशन है, जहाँ मॉडल आत्मविश्वास से भरा परन्तु वास्तव में गलत कंटेंट जनरेट करता है। एक और चुनौती है एडवर्सेरियल प्रॉम्प्ट्स के विरुद्ध सुरक्षा, जो मॉडल की सेफ़्टी मेज़र को दरकिनार कर हानिकारक या अनैतिक प्रतिक्रियाएँ उत्पन्न कर सकते हैं—ऐसा कई मॉडलों के संदर्भ में अनेक बार सिद्ध हुआ है।
सेफ़्टी फ़िल्टर्स और मॉडरेशन लेयर्स को शामिल करना जनरेट हो रहे हानिकारक कंटेंट की पहचान और हटाने में मदद कर सकता है। सतत मानव-इन-द-लूप निरीक्षण मॉडल की सुरक्षा को और बढ़ाता है।
इसके अतिरिक्त, इंजीनियर्स को स्पष्ट Guardrails (जैसे NeMo Guardrails या Llama Guard) लागू करने चाहिए जो यूज़र और मॉडल के बीच बैठते हैं। ये सिस्टम इनपुट्स को स्कैन कर प्रॉम्प्ट इंजेक्शन प्रयासों या PII (व्यक्तिगत पहचान योग्य जानकारी) के रिसाव को रोकते हैं और आउटपुट्स को स्कैन कर विषैला या हॉलुसिनेटरी उत्तर यूज़र तक पहुँचने से पहले पकड़ते हैं। यह मॉडल की प्रायिकतात्मक प्रकृति से स्वतंत्र एक नियतात्मक सेफ़्टी लेयर बनाता है।
जेनरेटिव एआई से जुड़ा कोई चुनौतीपूर्ण प्रोजेक्ट बताइए जिस पर आपने काम किया हो। प्रमुख चुनौतियाँ क्या थीं, और आपने उन्हें कैसे सुलझाया?
इस प्रश्न का उत्तर आपके प्रोजेक्ट्स और अनुभवों पर निर्भर है। फिर भी, उत्तर देते समय ये बिंदु ध्यान में रख सकते हैं:
- किसी विशिष्ट प्रोजेक्ट का चयन करें जिसमें स्पष्ट एआई चुनौतियाँ हों—जैसे बायस, मॉडल एक्युरेसी, या हॉलुसिनेशन।
- चुनौती स्पष्ट करें और तकनीकी/ऑपरेशनल कठिनाई समझाएँ।
- अपना दृष्टिकोण दिखाएँ —बताएँ कि आपने कौन-सी प्रमुख रणनीतियाँ अपनाईं, जैसे डेटा ऑग्मेंटेशन, मॉडल ट्यूनिंग, या विशेषज्ञों के साथ सहयोग।
- परिणाम उजागर करें और प्रभाव को मात्रात्मक बनाएं—एक्युरेसी में सुधार, बेहतर यूज़र एंगेजमेंट, या किसी व्यावसायिक समस्या का समाधान।
उत्पादन वातावरण में जेनरेटिव एआई मॉडलों को लागू और तैनात करने के अपने अनुभव पर चर्चा करें।
उपरोक्त प्रश्न की तरह, इसका उत्तर भी आपके अनुभव पर आधारित होगा, पर यह ध्यान रखते हुए:
- डिप्लॉयमेंट पर फोकस करें: इन्फ्रास्ट्रक्चर (क्लाउड सेवाएँ, MLOps टूल्स) और प्रमुख डिप्लॉयमेंट कार्य (स्केलिंग, लो-लेटेंसी ऑप्टिमाइज़ेशन) का उल्लेख करें। विवरण में जाने की आवश्यकता नहीं—यह दिखाना पर्याप्त है कि आप विषय के जानकार हैं।
- किसी चुनौती का उल्लेख करें: एक-दो सामान्य चुनौतियों का ज़िक्र करें जिनसे बचना चाहिए—यह आपकी विशेषज्ञता दिखाता है।
- पोस्ट-डिप्लॉयमेंट कवर करें: सुसंगत प्रदर्शन सुनिश्चित करने हेतु मॉनिटरिंग और मेंटेनेंस रणनीतियाँ शामिल करें।
- सेफ़्टी को संबोधित करें: रोलआउट के दौरान बायस या सेफ़्टी संभालने के लिए उठाए गए कदमों का उल्लेख करें।
लंबे टेक्स्ट विंडोज़ में "लॉस्ट इन द मिडल" फेनोमेना को आप कैसे हैंडल करते हैं?
भले ही कॉन्टेक्स्ट विंडो बहुत बड़ी हो (उदा., 1 मिलियन टोकन), LLMs प्रॉम्प्ट के बीच में दबी जानकारी को निकालने में अक्सर संघर्ष करते हैं, और शुरुआत व अंत को प्राथमिकता देते हैं।
इंजीनियर्स इसे बुद्धिमान री-रैंकिंग एल्गोरिद्म से कम करते हैं, जो सबसे महत्वपूर्ण प्राप्त चंक्स को कॉन्टेक्स्ट विंडो की शुरुआत या अंत में ले जाते हैं। एक और रणनीति "मैप-रिड्यूस" एल्गोरिद्म है, जिसमें मॉडल लंबे दस्तावेज़ के खंडों का स्वतंत्र रूप से सार बनाता है और फिर अंतिम उत्तर के लिए उन्हें संयोजित करता है।
आप एंड-टू-एंड RAG सिस्टम बनाने का कार्य कैसे अप्रोच करेंगे?
RAG सिस्टम बनाना एक व्यवस्थित अप्रोच चाहता है। पाइपलाइन इस प्रकार दिख सकती है:
- प्रभावी चंकिंग: मनमाने कैरेक्टर काउंट्स के बजाय, सन्दर्भ सुरक्षित रखते हुए दस्तावेज़ों को सार्थक खंडों में बाँटने हेतु सैमांटिक या रिकर्सिव रणनीतियाँ अपनाएँ।
- वेक्टर स्टोरेज: इन चंक्स को हाई-परफ़ॉर्मेंस एम्बेडिंग मॉडल से एम्बेड करें और उन्हें वेक्टर डेटाबेस में समृद्ध मेटाडेटा (जैसे तारीखें, लेखक) के साथ स्टोर करें ताकि प्री-फ़िल्टरिंग हो सके।
- हाइब्रिड सर्च: रिट्रीवल लेयर लागू करें जो कीवर्ड सर्च (BM25) को वेक्टर सर्च (सैमांटिक समानता) के साथ मिलाए ताकि विशिष्ट टर्म्स और व्यापक अवधारणाएँ दोनों कवर हो सकें।
- री-रैंकिंग: शीर्ष रिट्रीव्ड परिणामों को फिर से स्कोर करने के लिए क्रॉस-एन्कोडर मॉडल लगाएँ, ताकि अप्रासंगिक "नॉइज़" चंक्स LLM तक पहुँचने से पहले ही आक्रामक रूप से फ़िल्टर हो जाएँ।
- साइटेशन और जनरेशन: LLM को केवल दिए गए कॉन्टेक्स्ट के आधार पर उत्तर जनरेट करने के लिए प्रॉम्प्ट करें और हॉलुसिनेशन रोकने हेतु विशिष्ट स्रोत दस्तावेज़ों का हवाला देना आवश्यक करें।
जेनरेटिव एआई के क्षेत्र में कौन से खुले शोध-प्रश्न या क्षेत्र आपको सबसे रोमांचक लगते हैं?
यह उत्तर भी आपकी व्यक्तिगत रुचियों पर निर्भर है, पर आप इनमें से कुछ विषयों का उल्लेख कर सकते हैं:
- मॉडल इंटरप्रेटेबिलिटी में सुधार: जेनरेटिव मॉडलों को अधिक पारदर्शी और व्याख्यायोग्य बनाना।
- एथिकल फ़्रेमवर्क्स: जिम्मेदार एआई के लिए दिशा-निर्देश विकसित करना।
- क्रॉस-मोडल जनरेशन: अनेक डेटा-प्रकारों (इमेज, टेक्स्ट, आदि) के माध्यम से कंटेंट जनरेट करना।
- एडवर्सेरियल रॉबस्टनेस: मॉडलों को एडवर्सेरियल हमलों के प्रति प्रतिरोधी बनाना।
- रीज़निंग क्षमताएँ: LLMs की तर्क-शक्ति बढ़ाना।
निष्कर्ष
जैसे-जैसे जेनरेटिव एआई हमारे जीवन और करियर के विभिन्न पहलुओं को प्रभावित करने के तरीके खोज रहा है, आवश्यक विषयों पर जिज्ञासु नज़र बनाए रखना महत्वपूर्ण है। हालाँकि इंटरव्यू में पूछे जाने वाले संभावित GenAI प्रश्न विशिष्ट भूमिका और कंपनी पर निर्भर करते हैं, मैंने आपकी इंटरव्यू तैयारी यात्रा शुरू कराने हेतु 30 प्रश्न और उत्तरों का नमूना प्रस्तुत करने का प्रयास किया है।
और अधिक इंटरव्यू प्रश्नों का अन्वेषण करने के लिए, मैं ये ब्लॉग्स सुझाता/सुझाती हूँ:

कृत्रिम बुद्धिमत्ता में मास्टर'स छात्र और एआई तकनीकी लेखक। मैं नवीनतम एआई तकनीक पर अंतर्दृष्टि साझा करता/करती हूँ, एमएल शोध को सुलभ बनाता/बनाती हूँ, और जटिल एआई विषयों को सरल करता/करती हूँ ताकि आप हमेशा अग्रिम पंक्ति में बने रहें।
जेनरेटिव आर्टिफिशियल इंटेलिजेंस (जिसे Generative AI या GenAI भी कहा जाता है) एआई की एक उपश्रेणी है जो विभिन्न एआई तकनीकों का उपयोग करके नया कंटेंट—जैसे पाठ, छवि या वीडियो—बनाने पर केंद्रित होती है।
जैसे-जैसे GenAI आगे बढ़ रहा है, वह सॉफ्टवेयर विकास जैसे कई अन्य तकनीकी क्षेत्रों में भी समा रहा है। इसके मूल सिद्धांतों का व्यापक ज्ञान इन क्षेत्रों में लगातार अधिक प्रासंगिक होता जाएगा।
जैसे डेटा वैज्ञानिक, मशीन लर्निंग प्रैक्टिशनर और एआई इंजीनियर जैसे रोल्स के लिए, जेनरेटिव एआई को सही ढंग से समझना अत्यंत आवश्यक है।
यहाँ 30 GenAI इंटरव्यू प्रश्न दिए गए हैं जो आपसे इंटरव्यू में पूछे जा सकते हैं।